问题排查调试工具使用手册

当前端发起对应用的访问时,如果出现错误,那么我们可以通过以下方式进行简易排查,如果排查不出来,则也可以把排查工具给出的信息发送给Oinone官方售后进行进一步分析。本文将通过模拟异常信息,来介绍排查工具,提供了哪些辅助信息帮我们来快速定位问题。

排查工具基础介绍

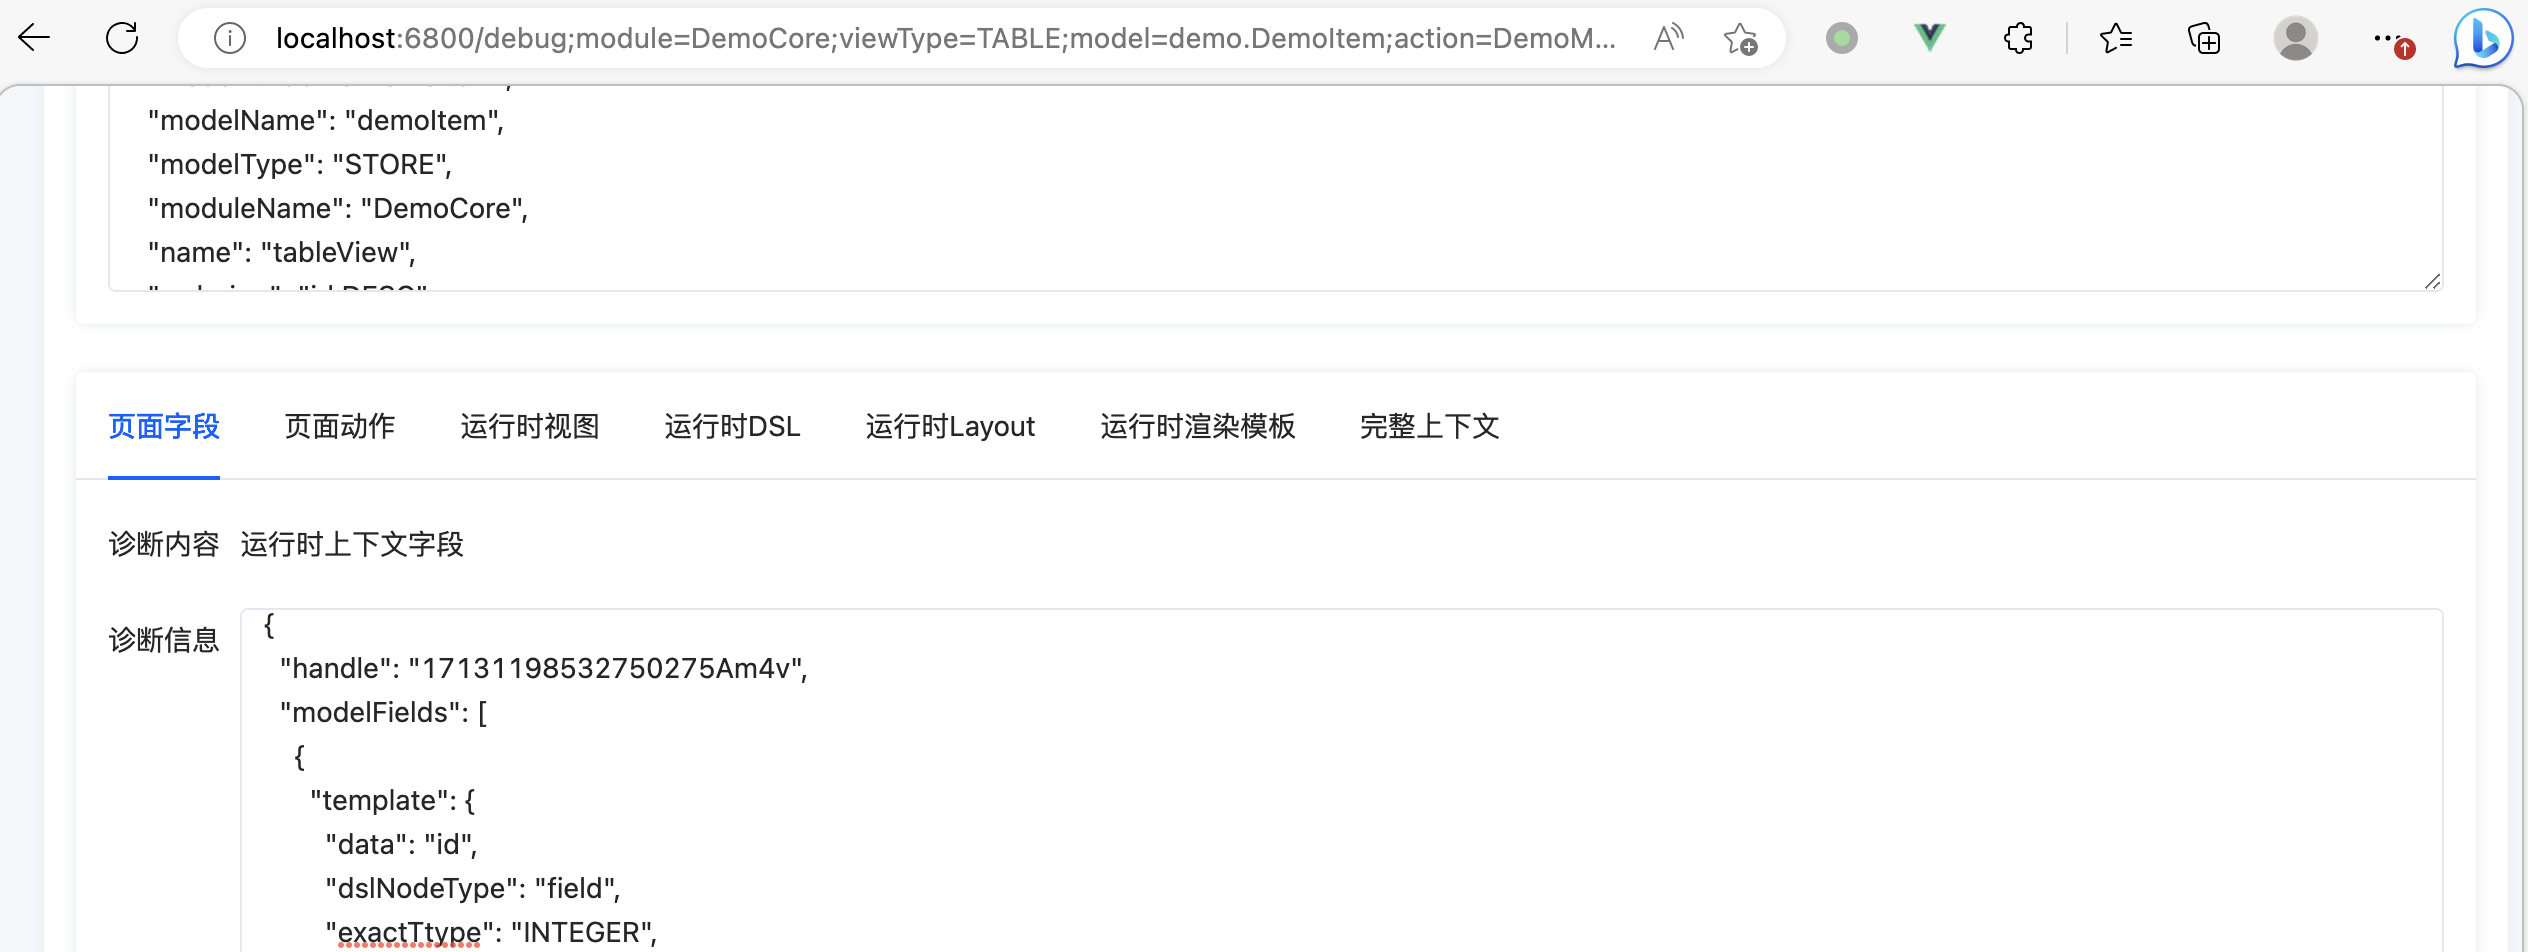
通过前端页面的 /debug 路由路径访问调试工具的页面,假设我们的前端页面访问地址为http://localhost:6800,那么我们的排查工具请求路径就是 http://localhost:6800/debug
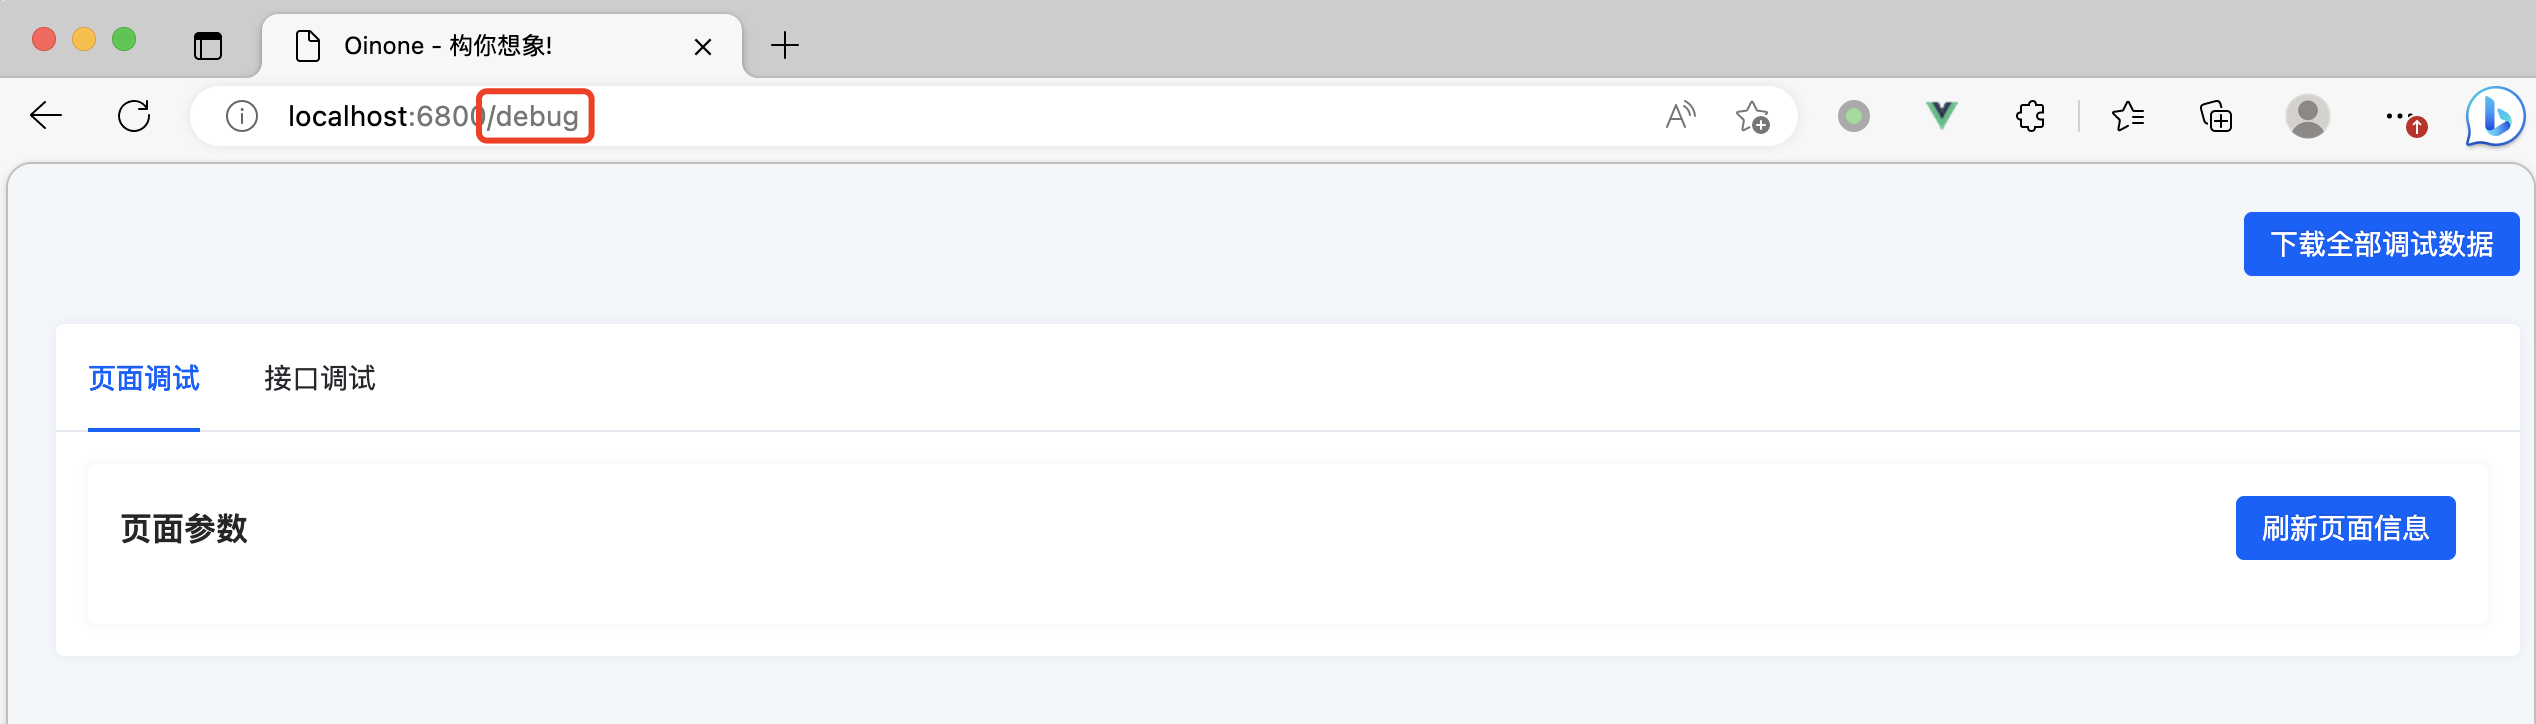
image.png
排查工具可以帮我们排查前端页面元数据异常和后端接口的异常

排查前端页面元数据

将问题页面浏览器地址栏内 page 后的部分复制到调试工具的 debug 路由后重新发起请求,如图可以看到调试工具展示的信息,可以根据这些信息排查问题。
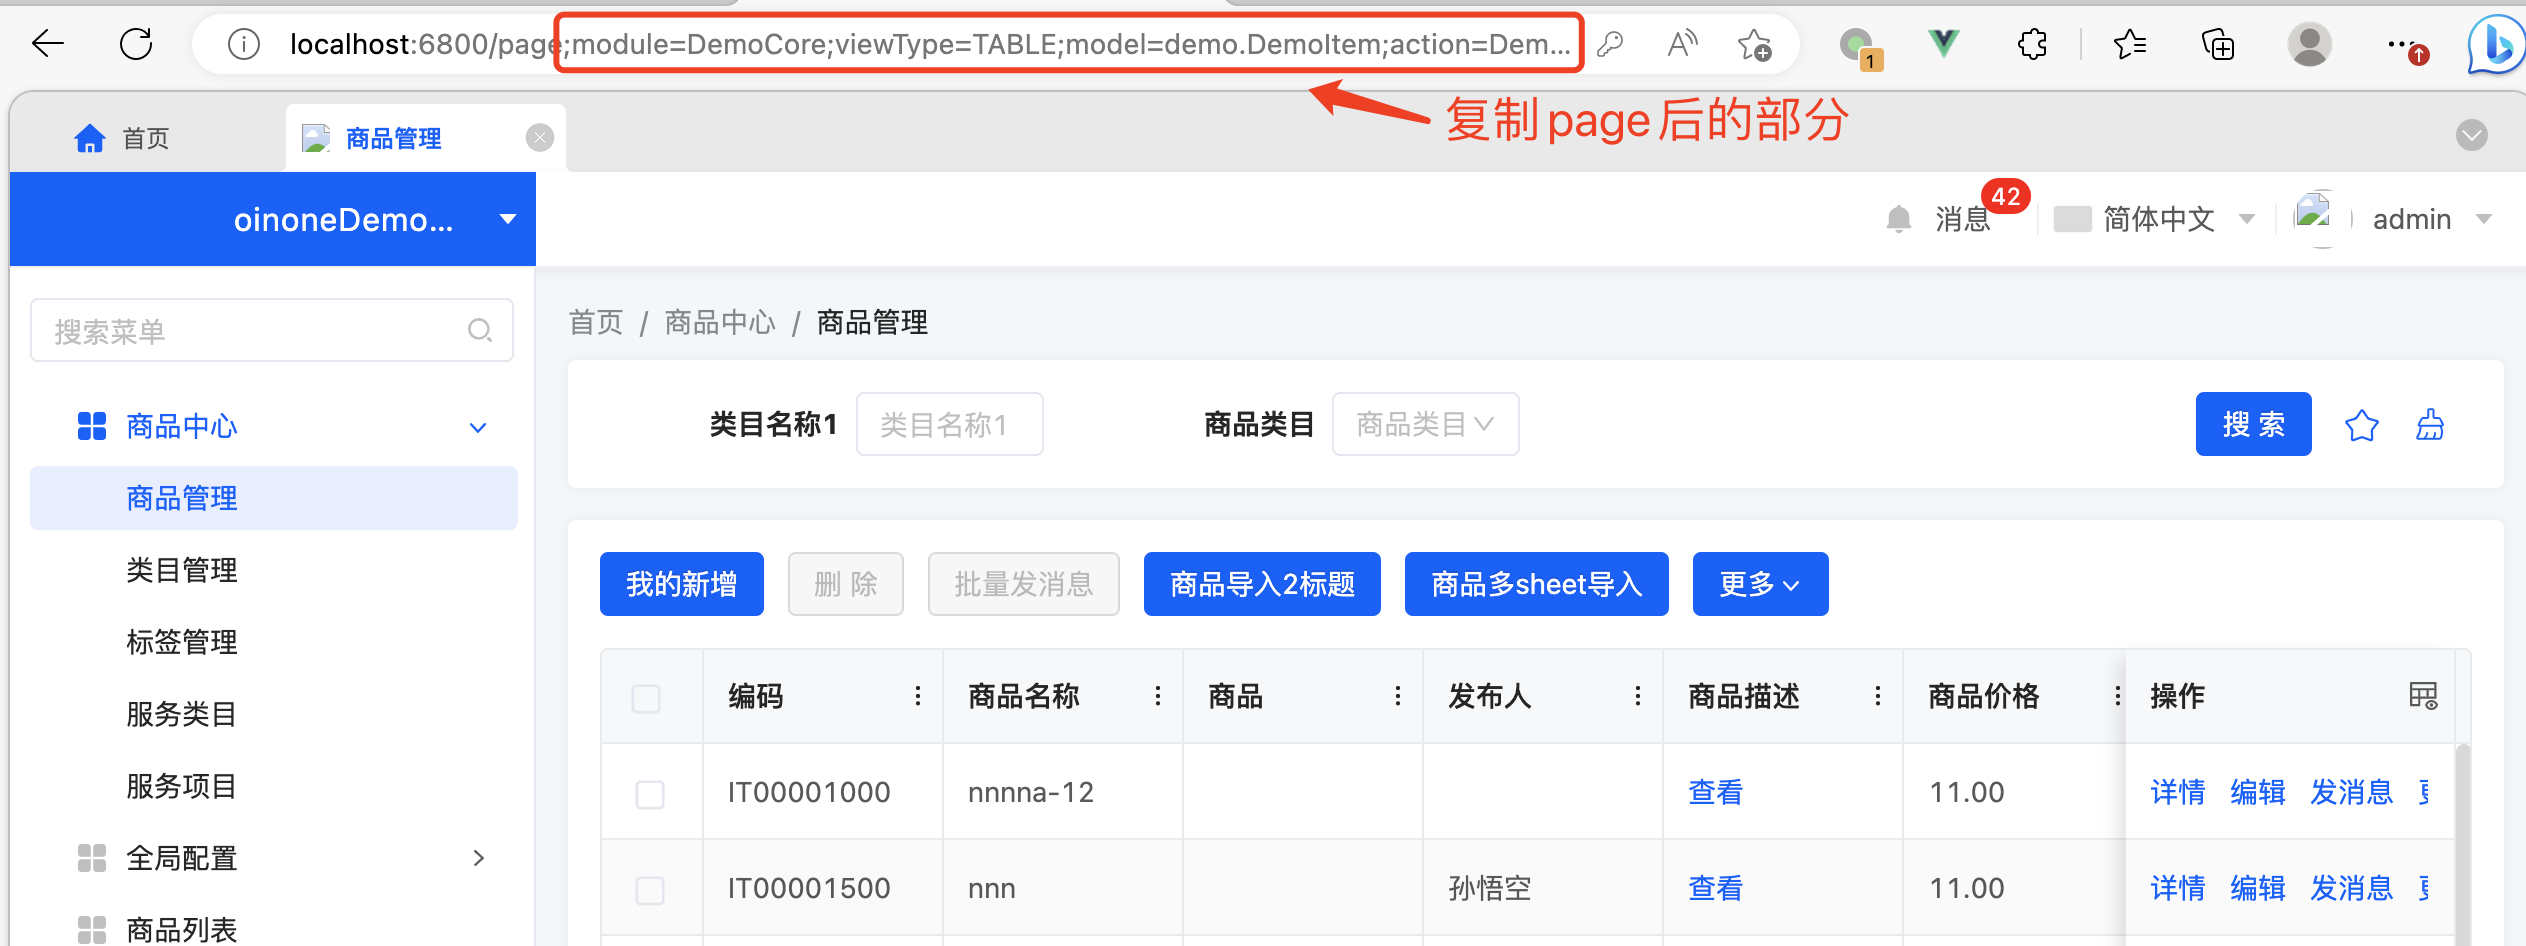
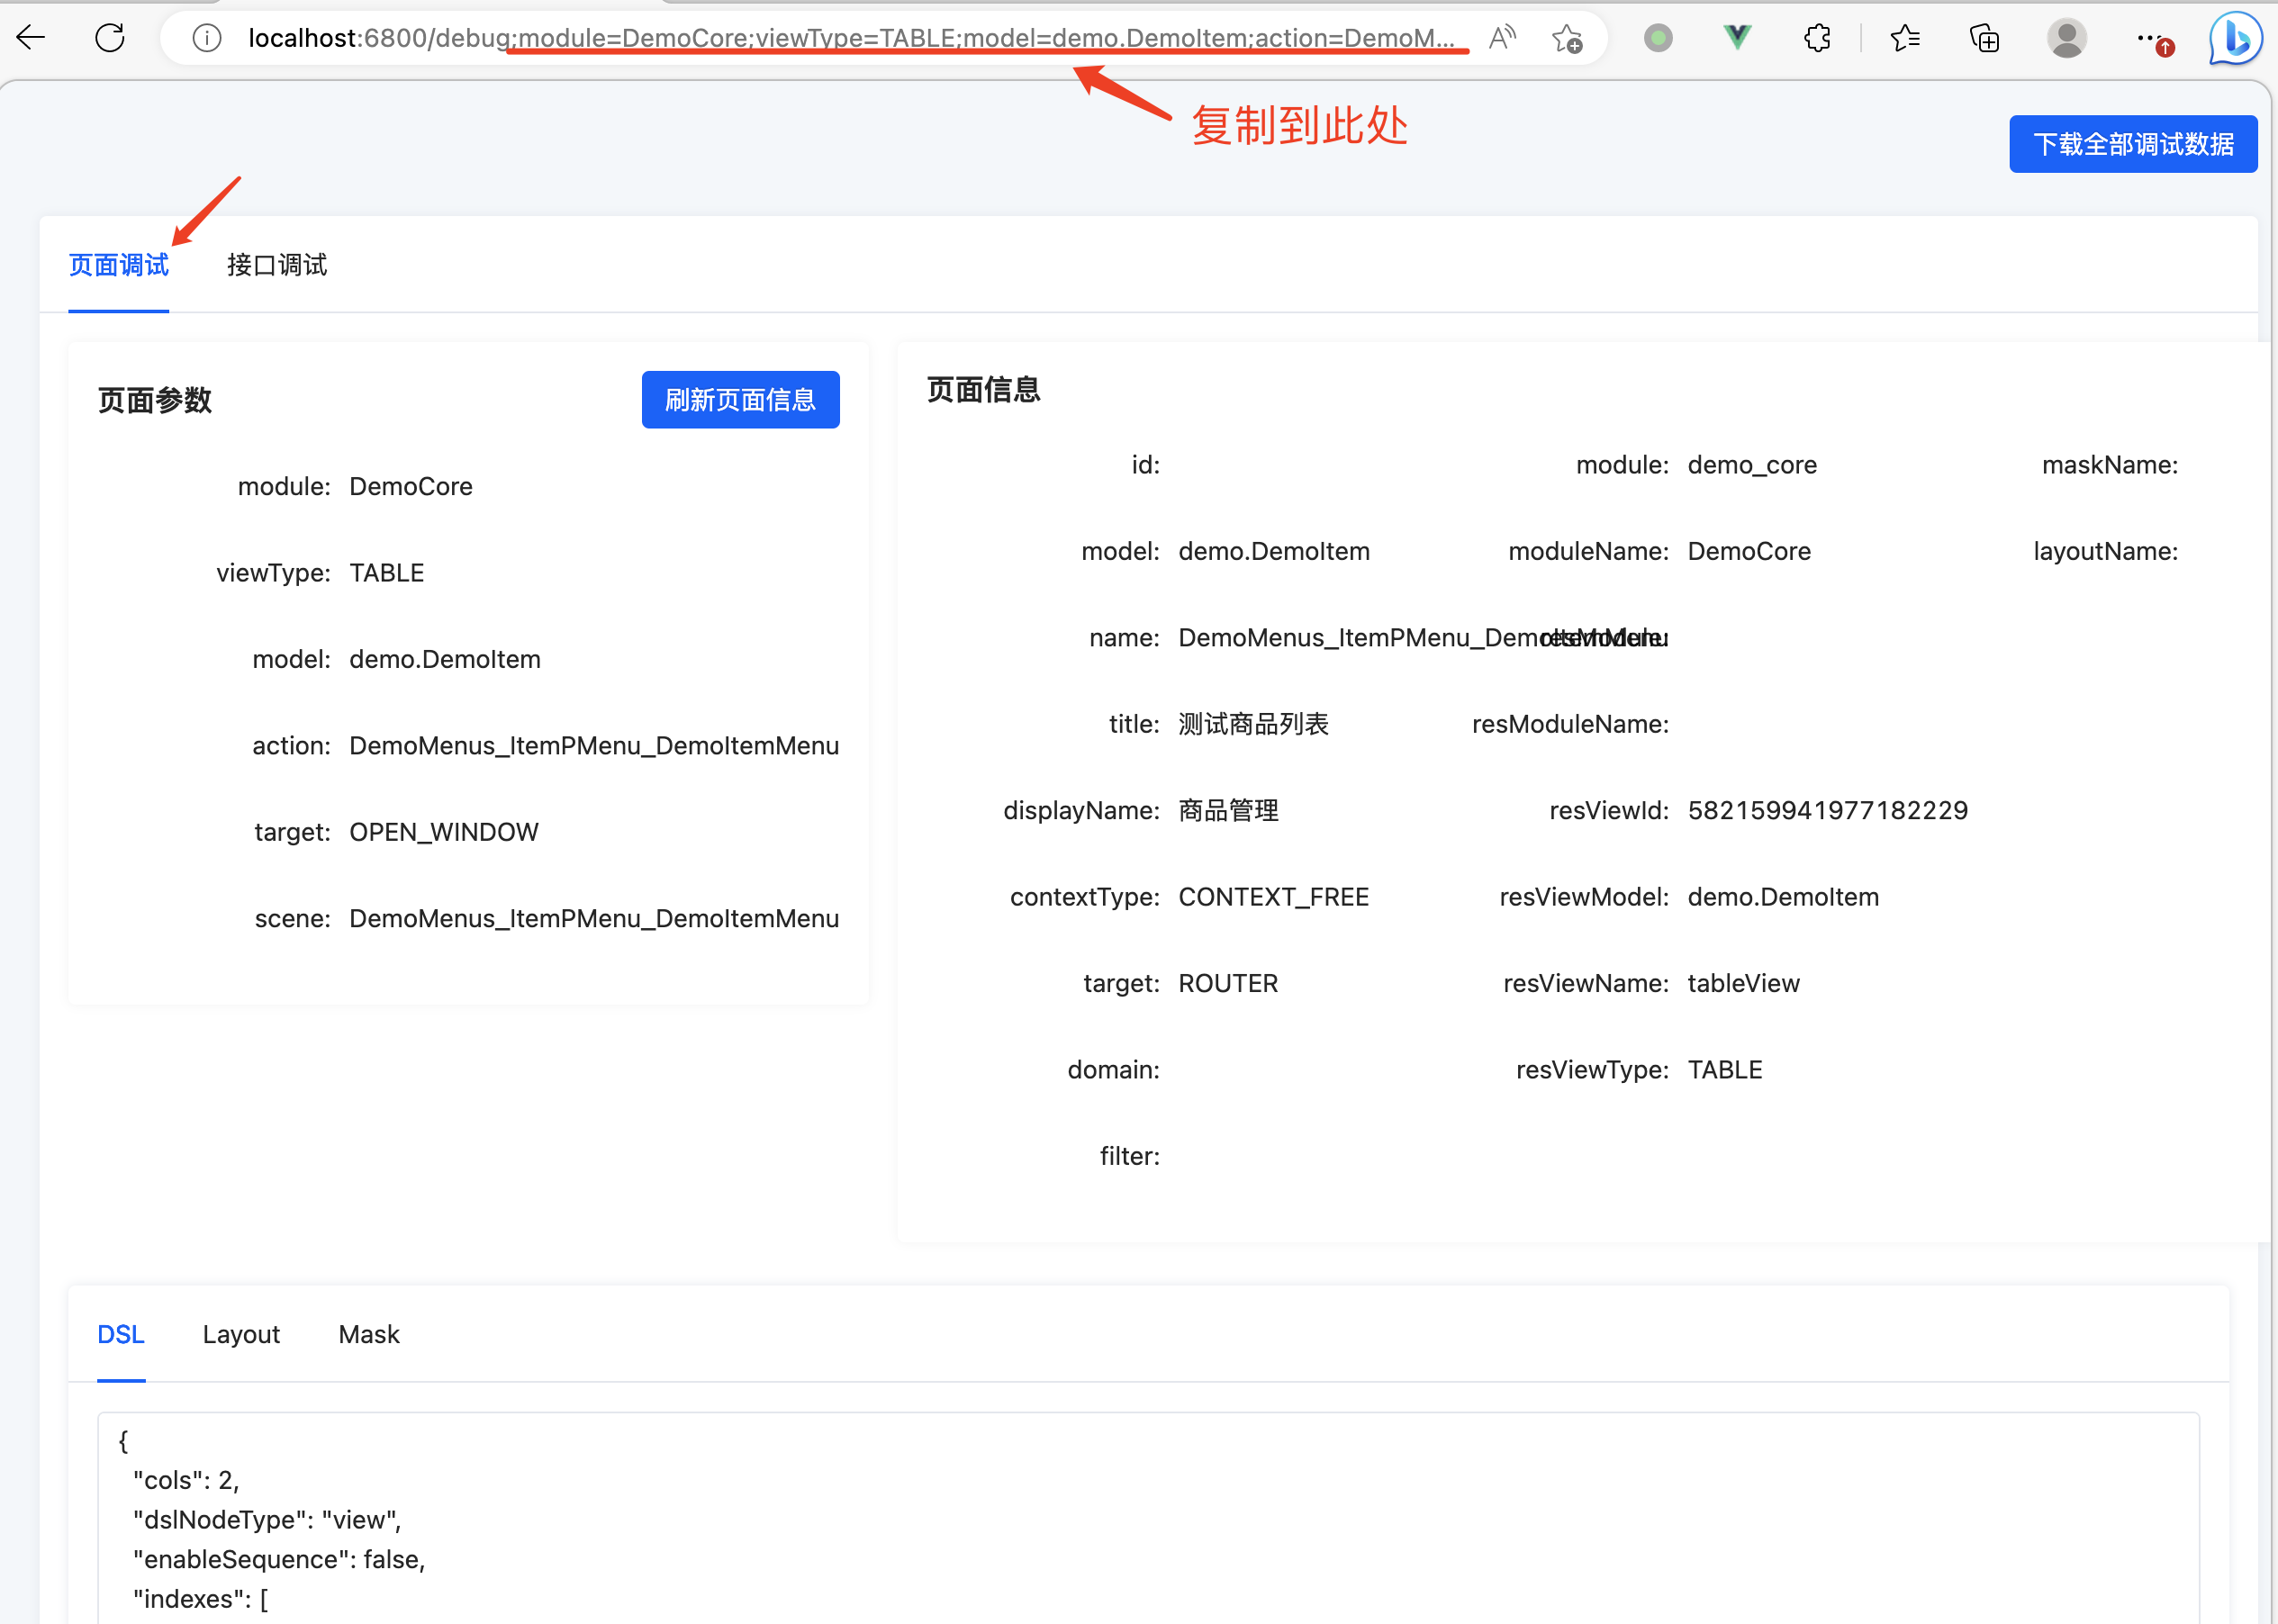
image.png
image.png
image.png

排查后端接口

  1. 后端接口出现问题后,打开(在原页面)浏览器的调试工具,切换到“网络”的标签页,在左侧的历史请求列表中找到需要调试的请求,右键会弹出菜单,点击菜单中的 “复制”,再次展开该菜单,点击二级菜单中的“以 fetch 格式复制”,这样可以复制到调试所需要的信息
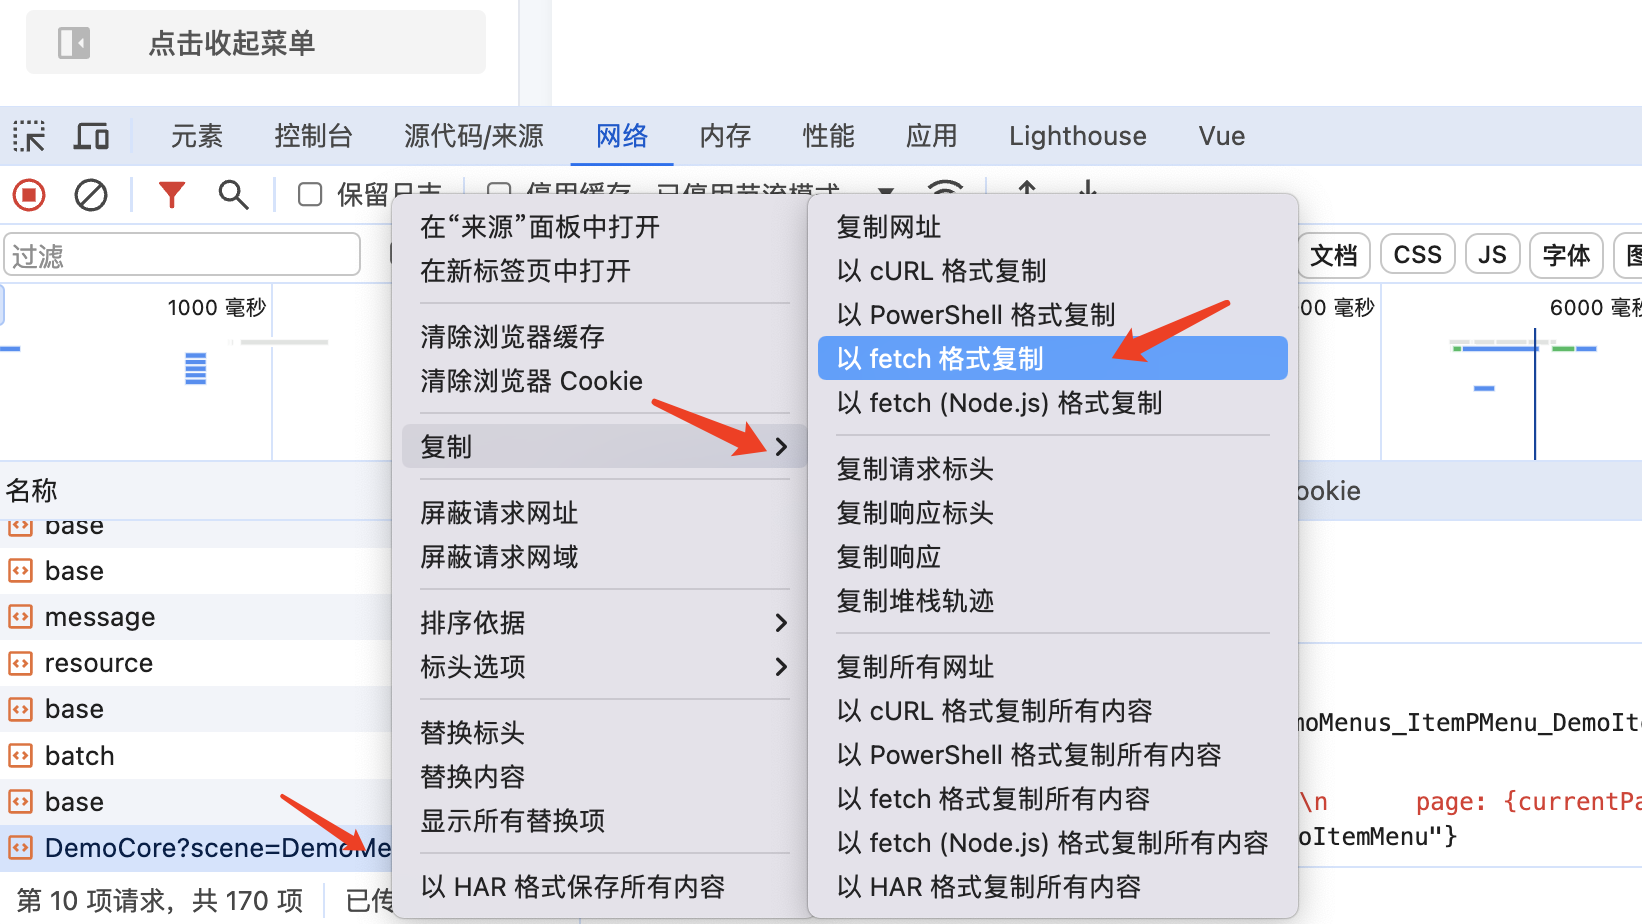
image.png
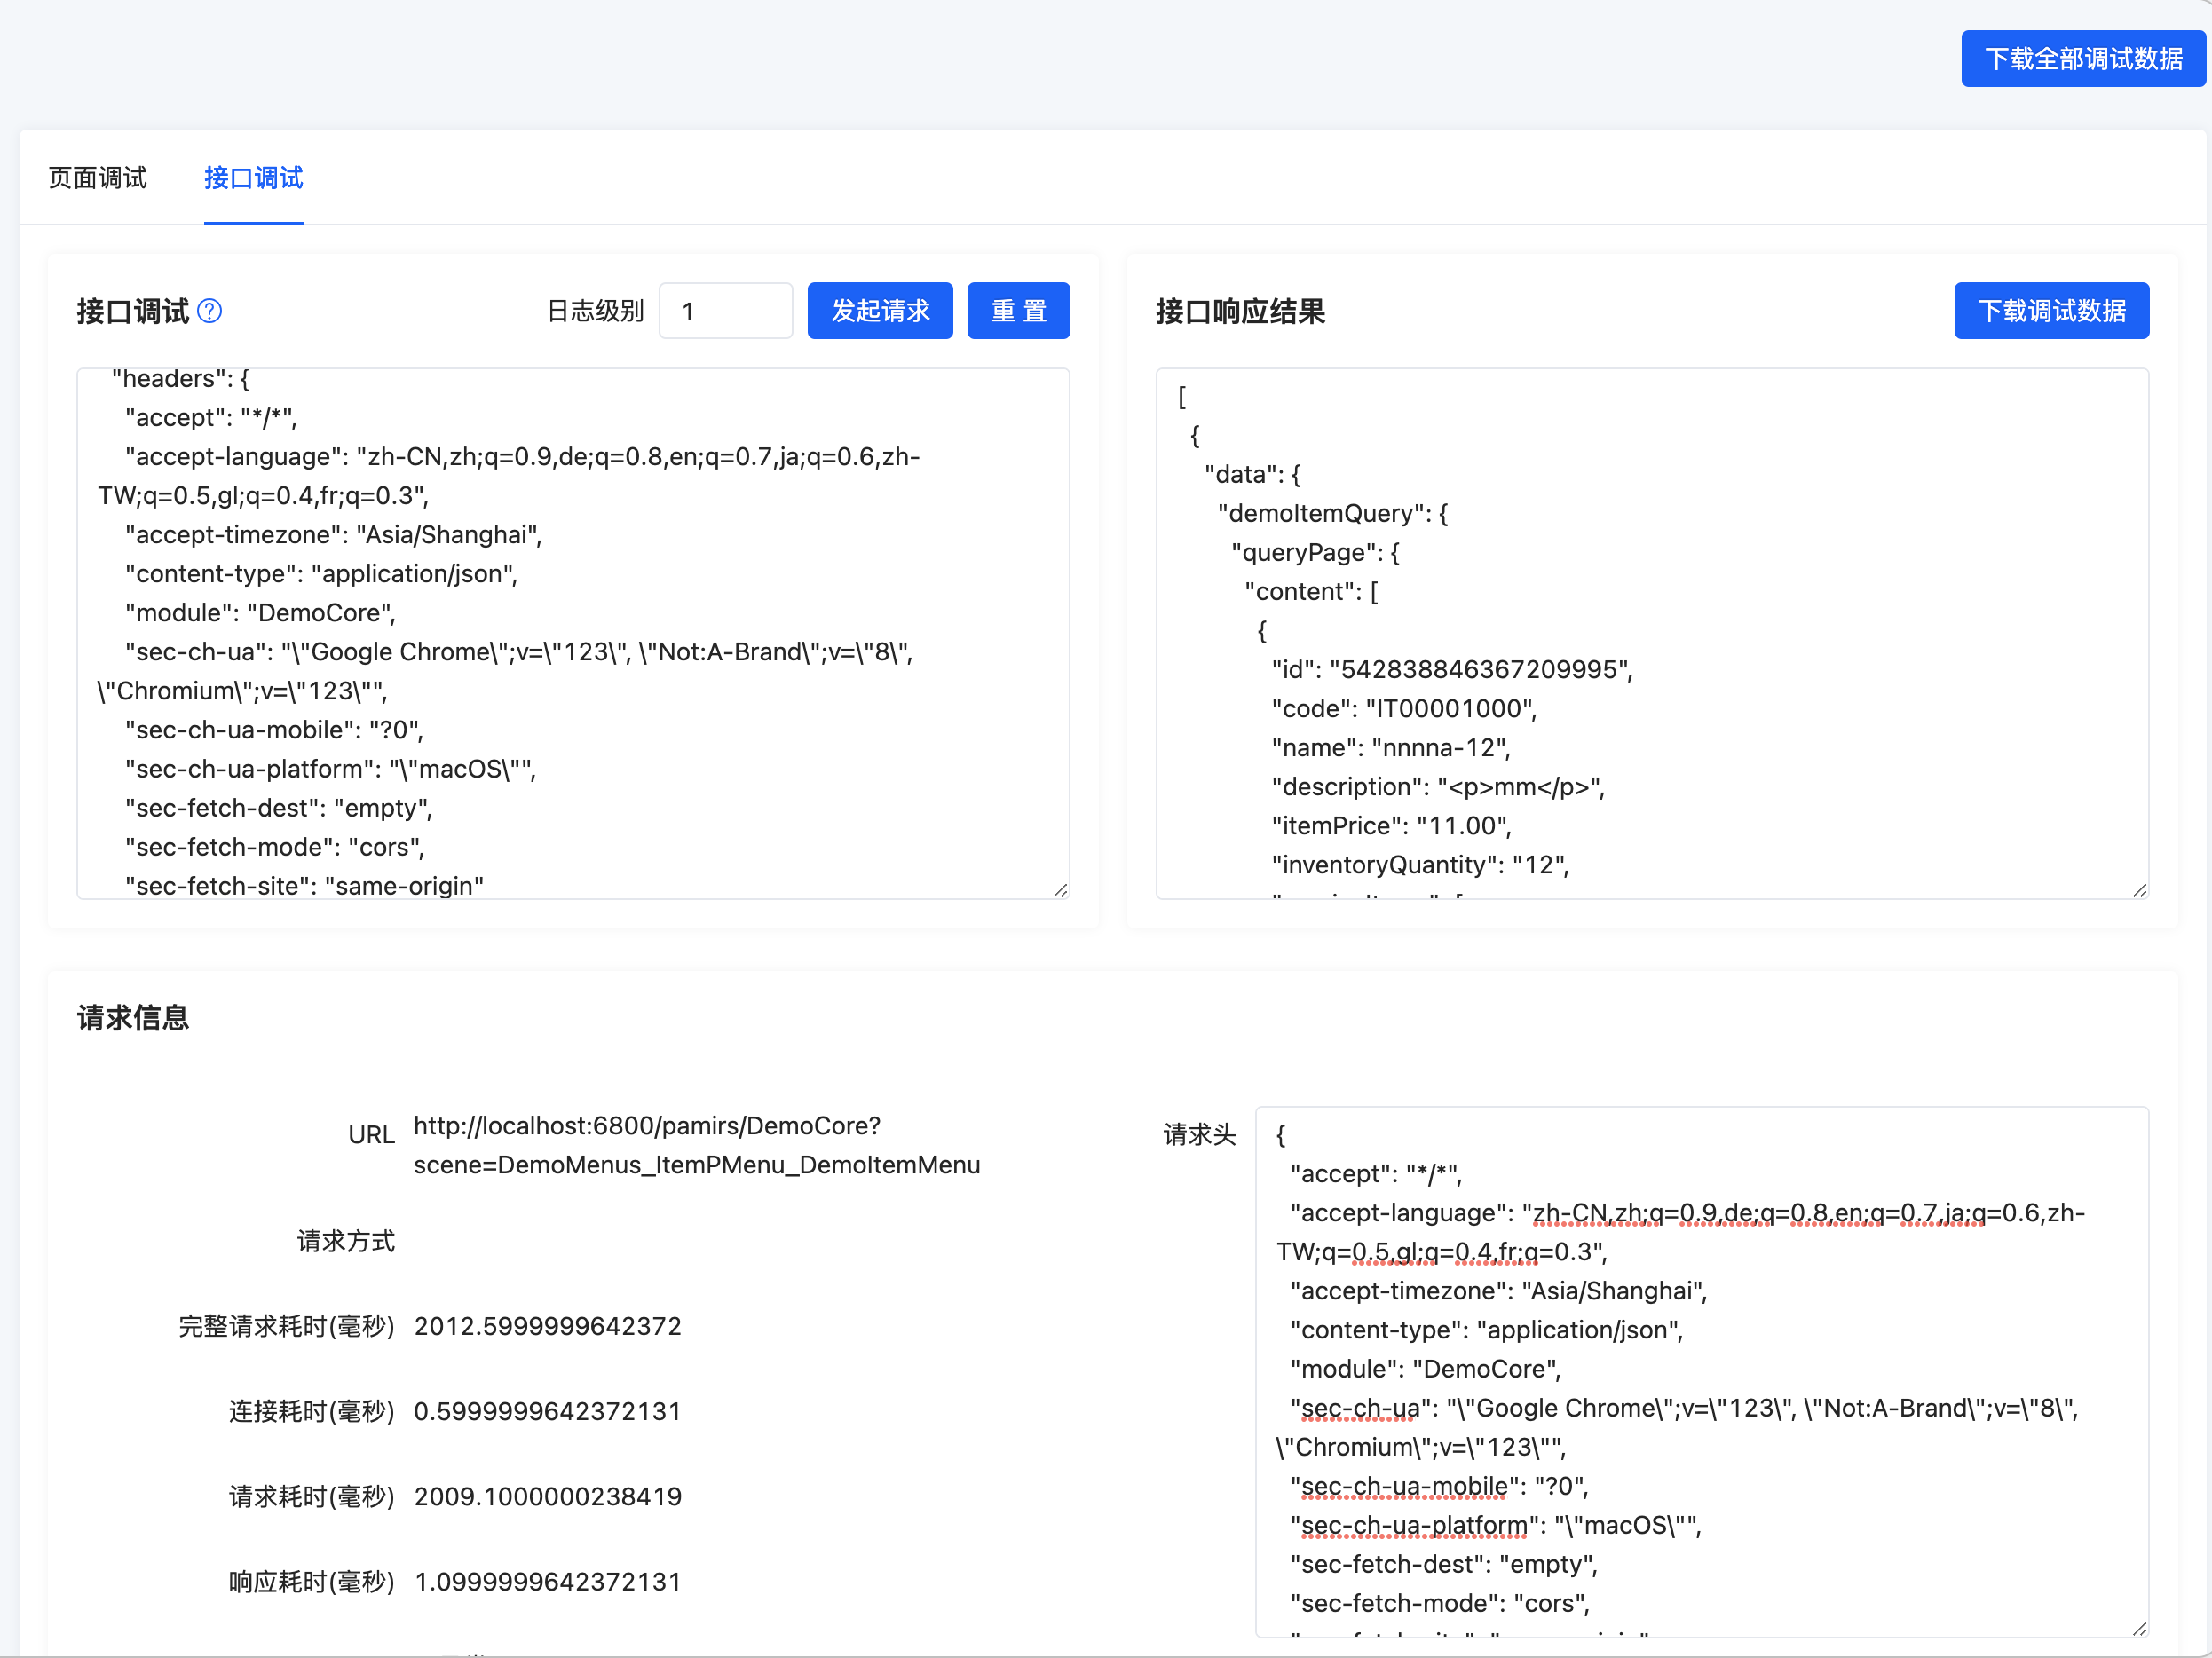
2.复制调试信息到“接口调试”标签页内的文本框内,点击“发起请求”按钮获取调试结果
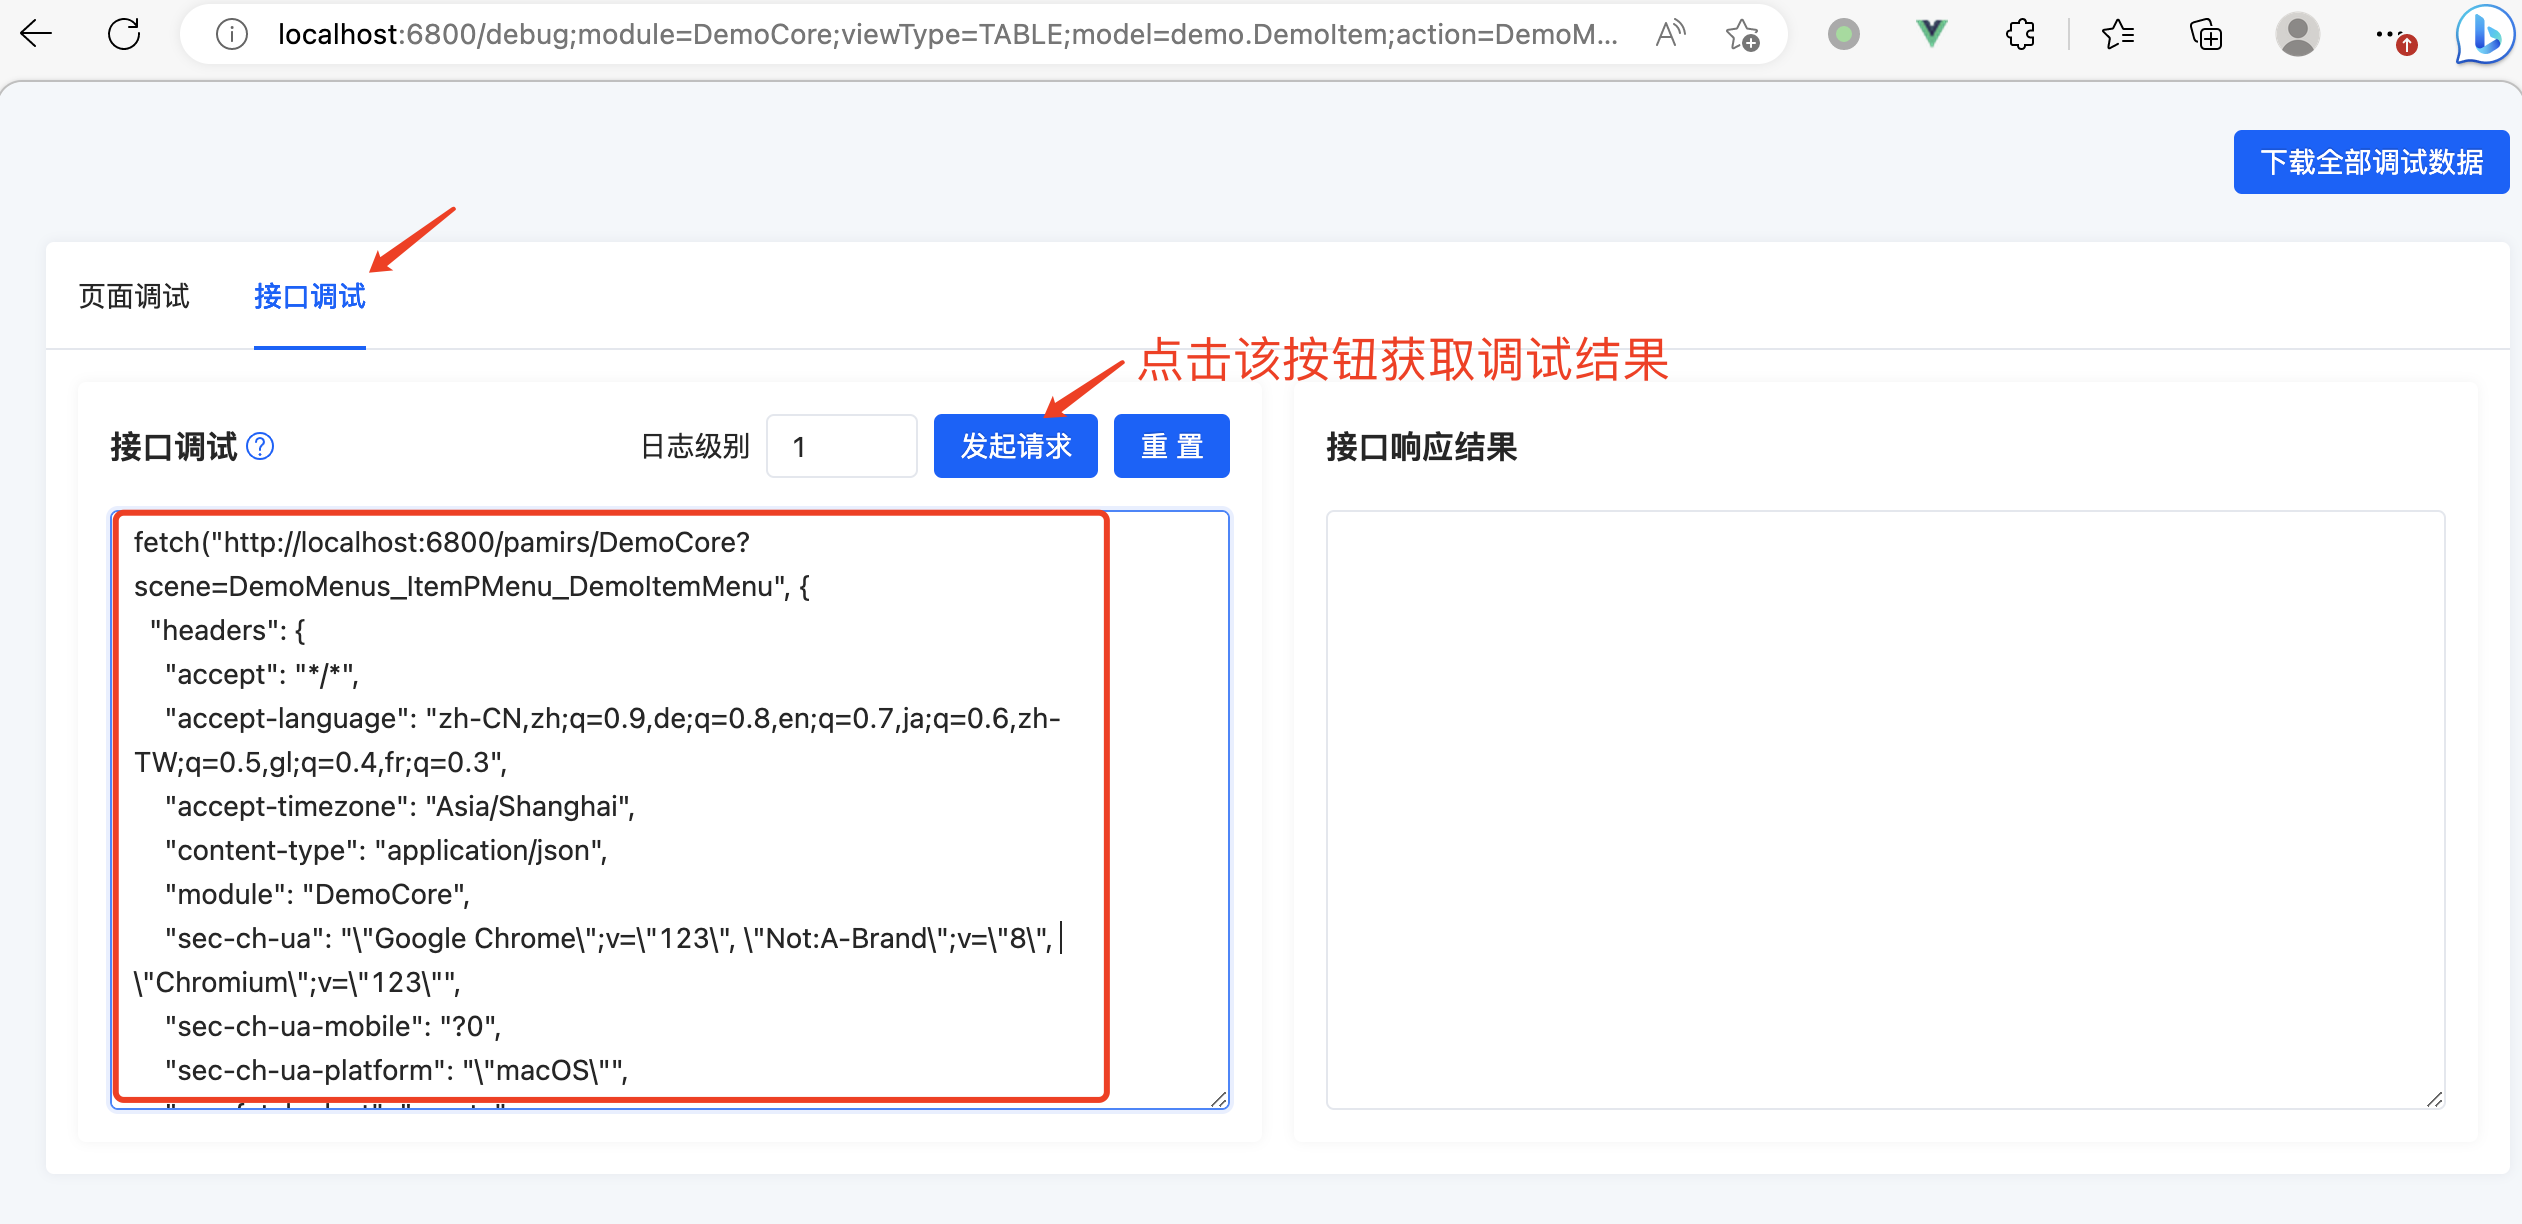
image.png
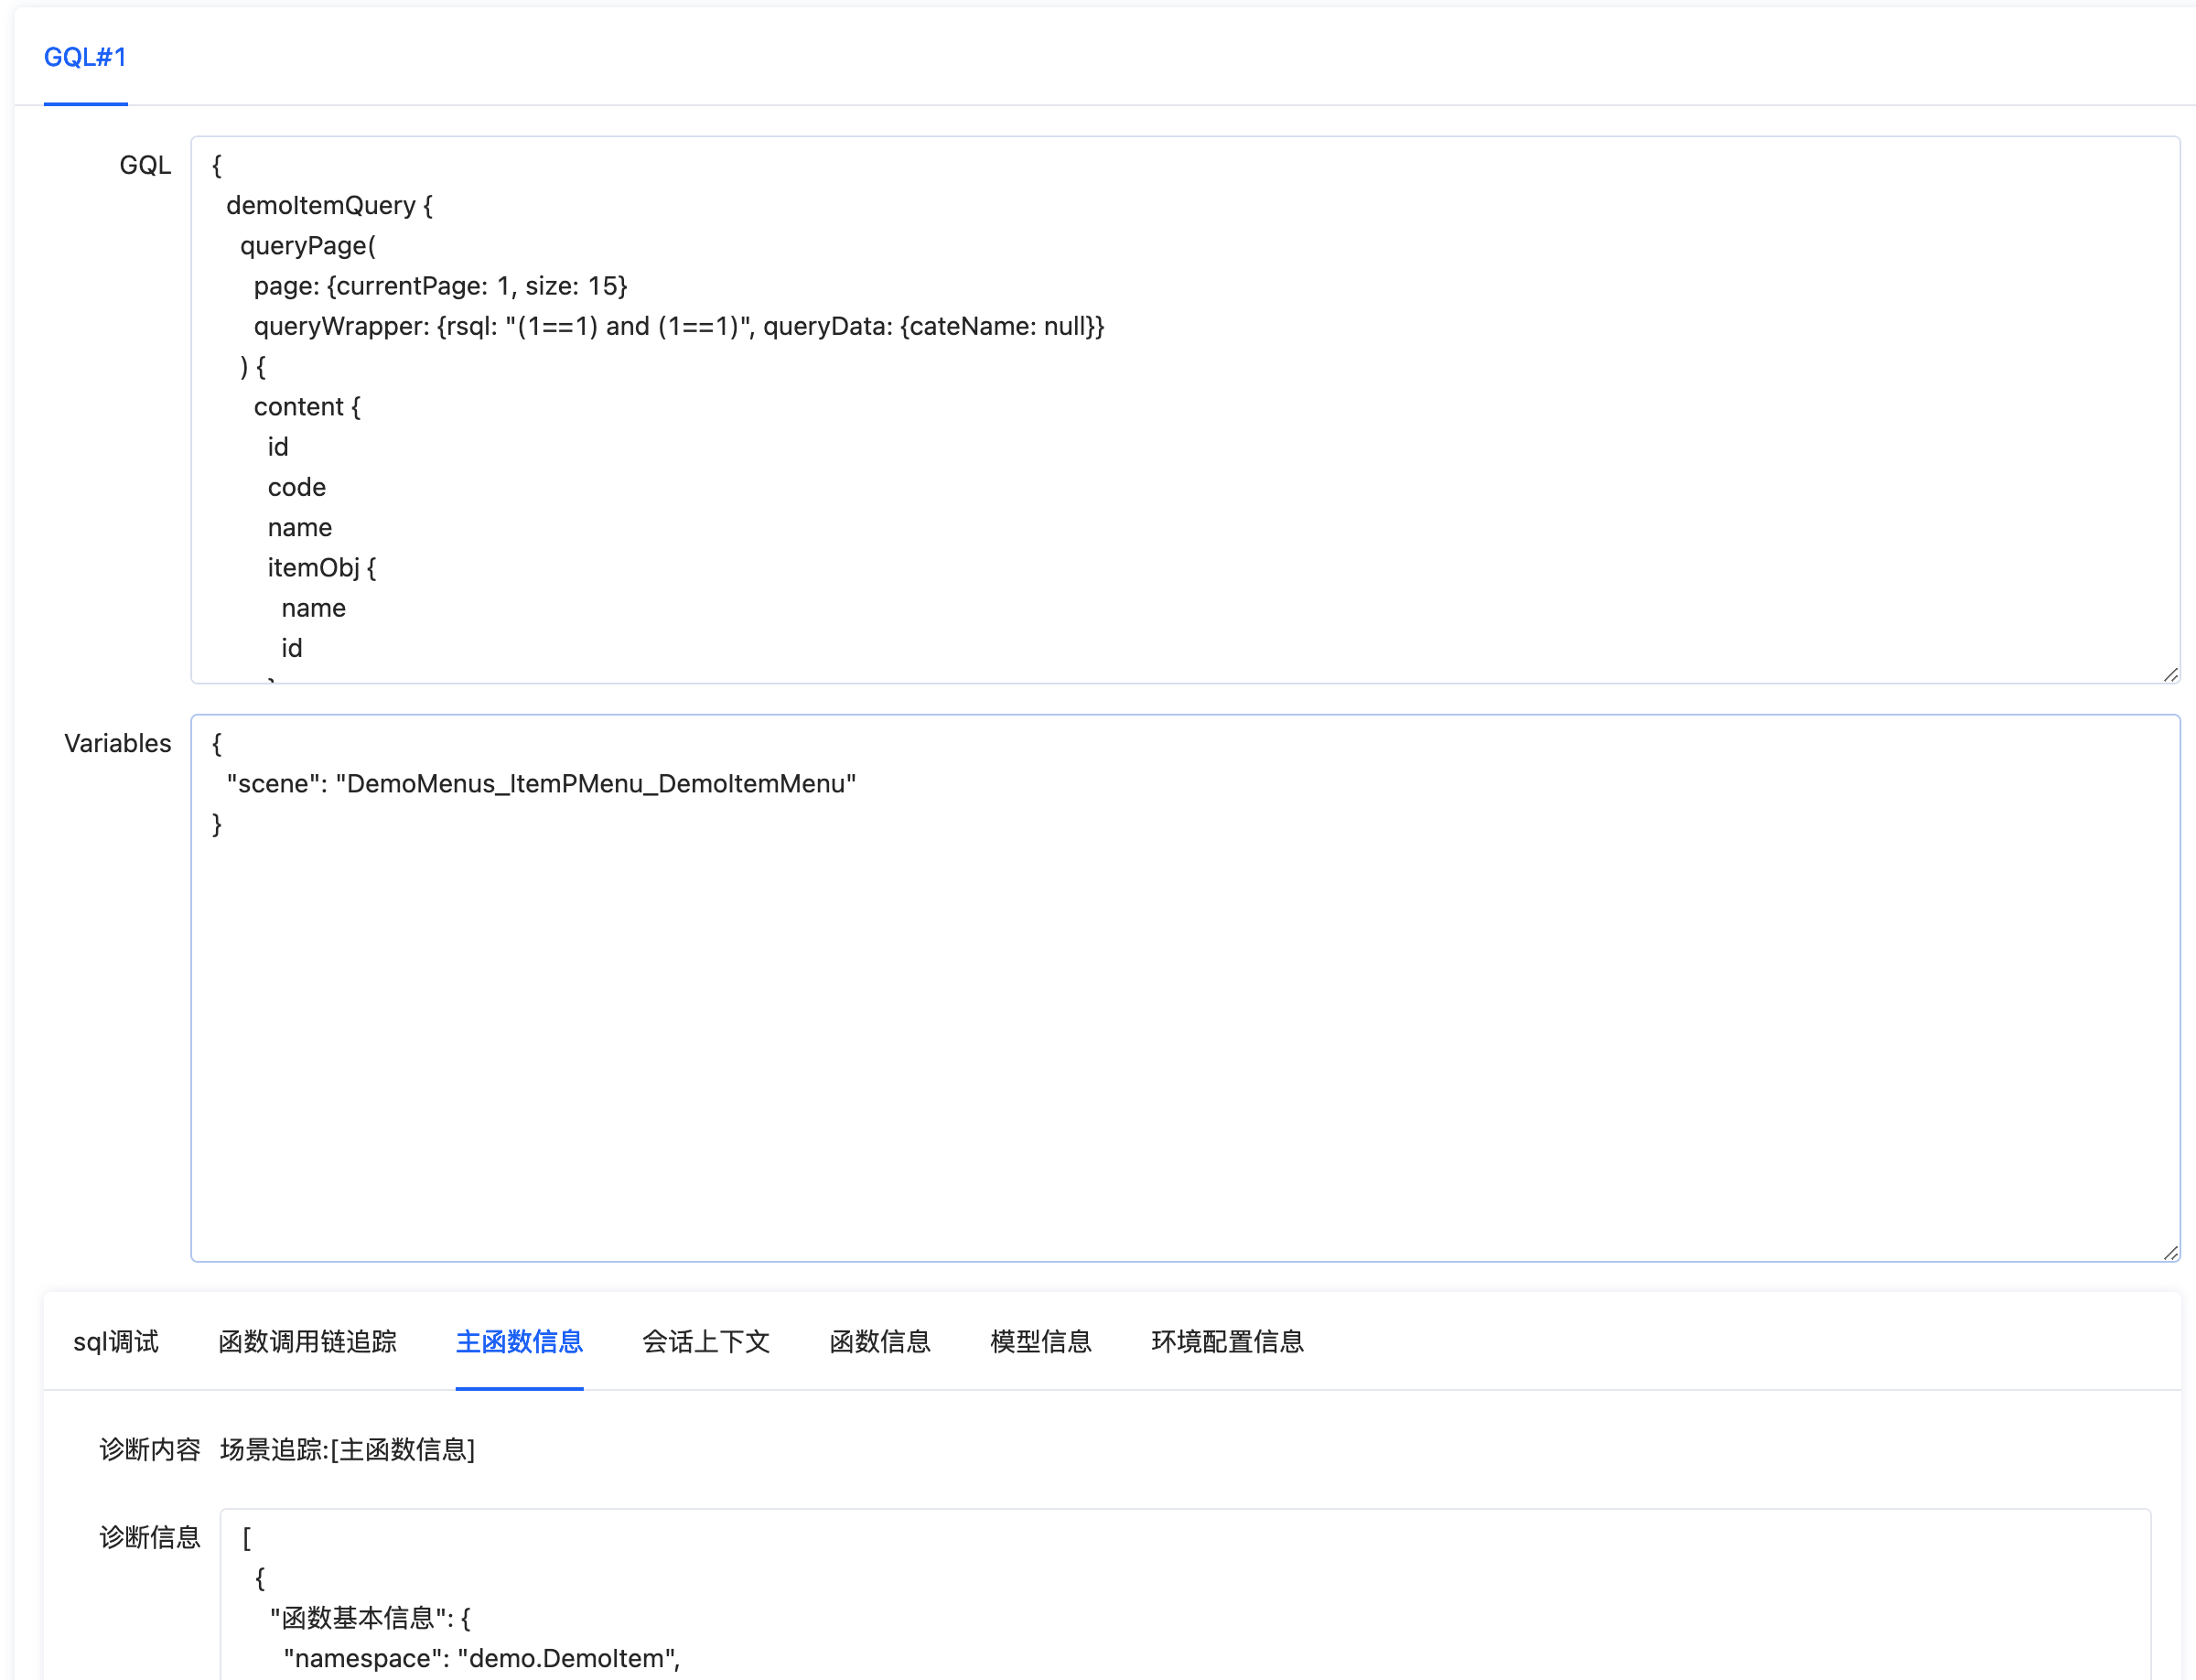
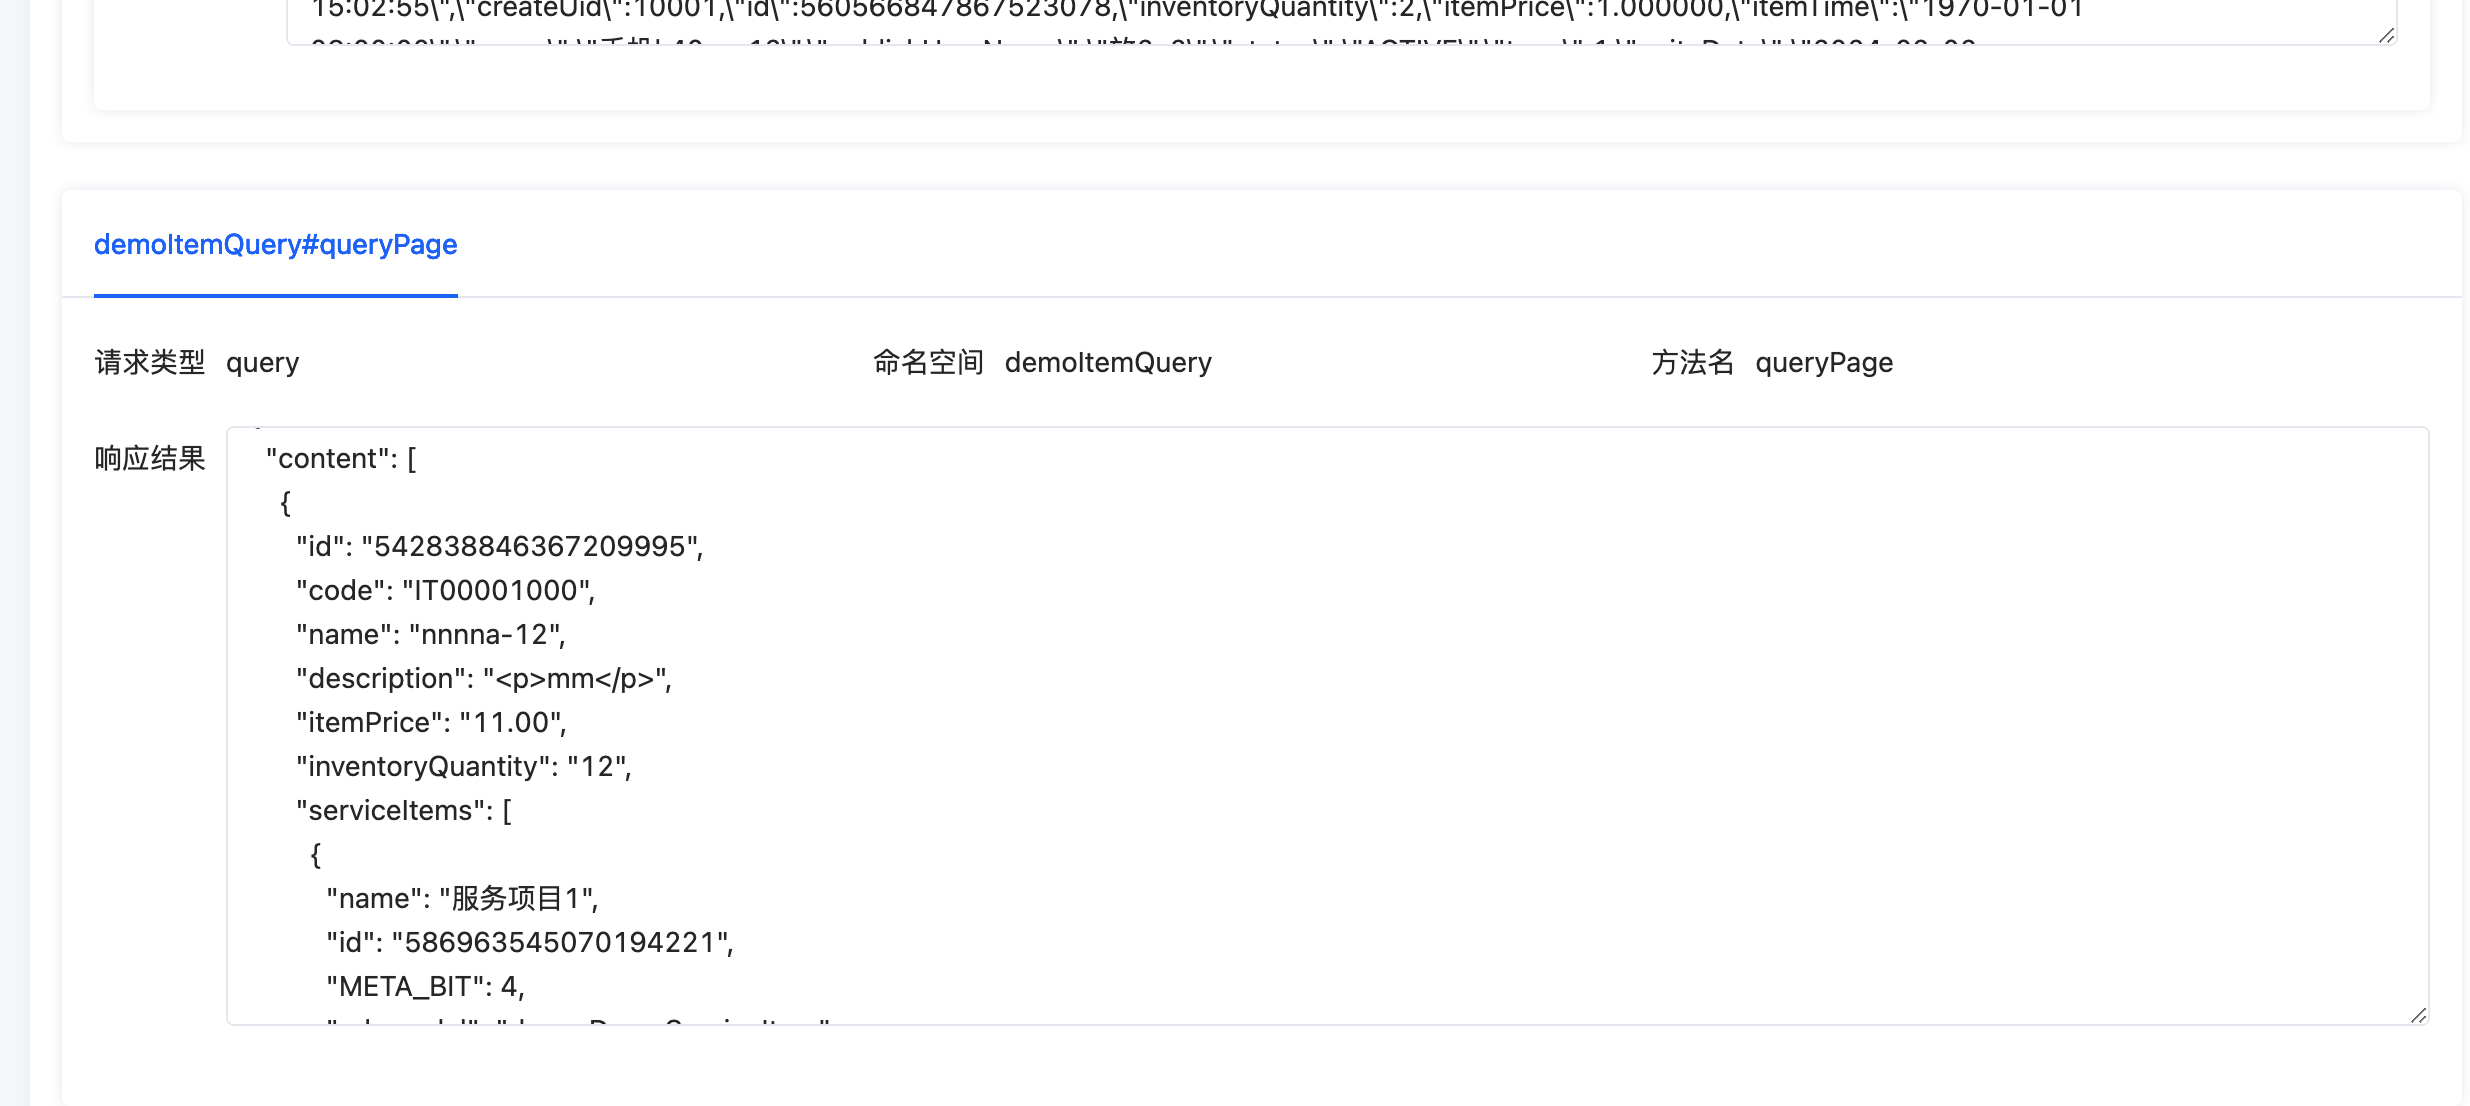
我们可以看到页面展示了该接口的各种调试信息,我们可以据此排查问题。
image.png
image.png
image.png

场景化的排查思路

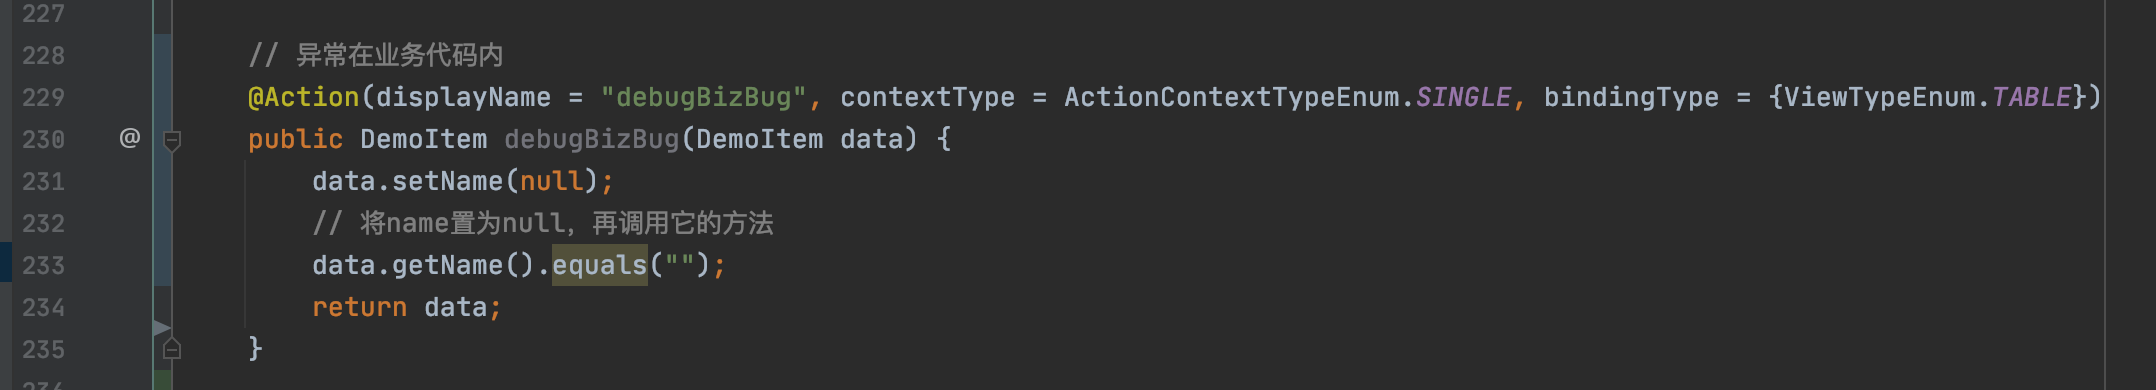
业务代码中存在代码bug

image.png
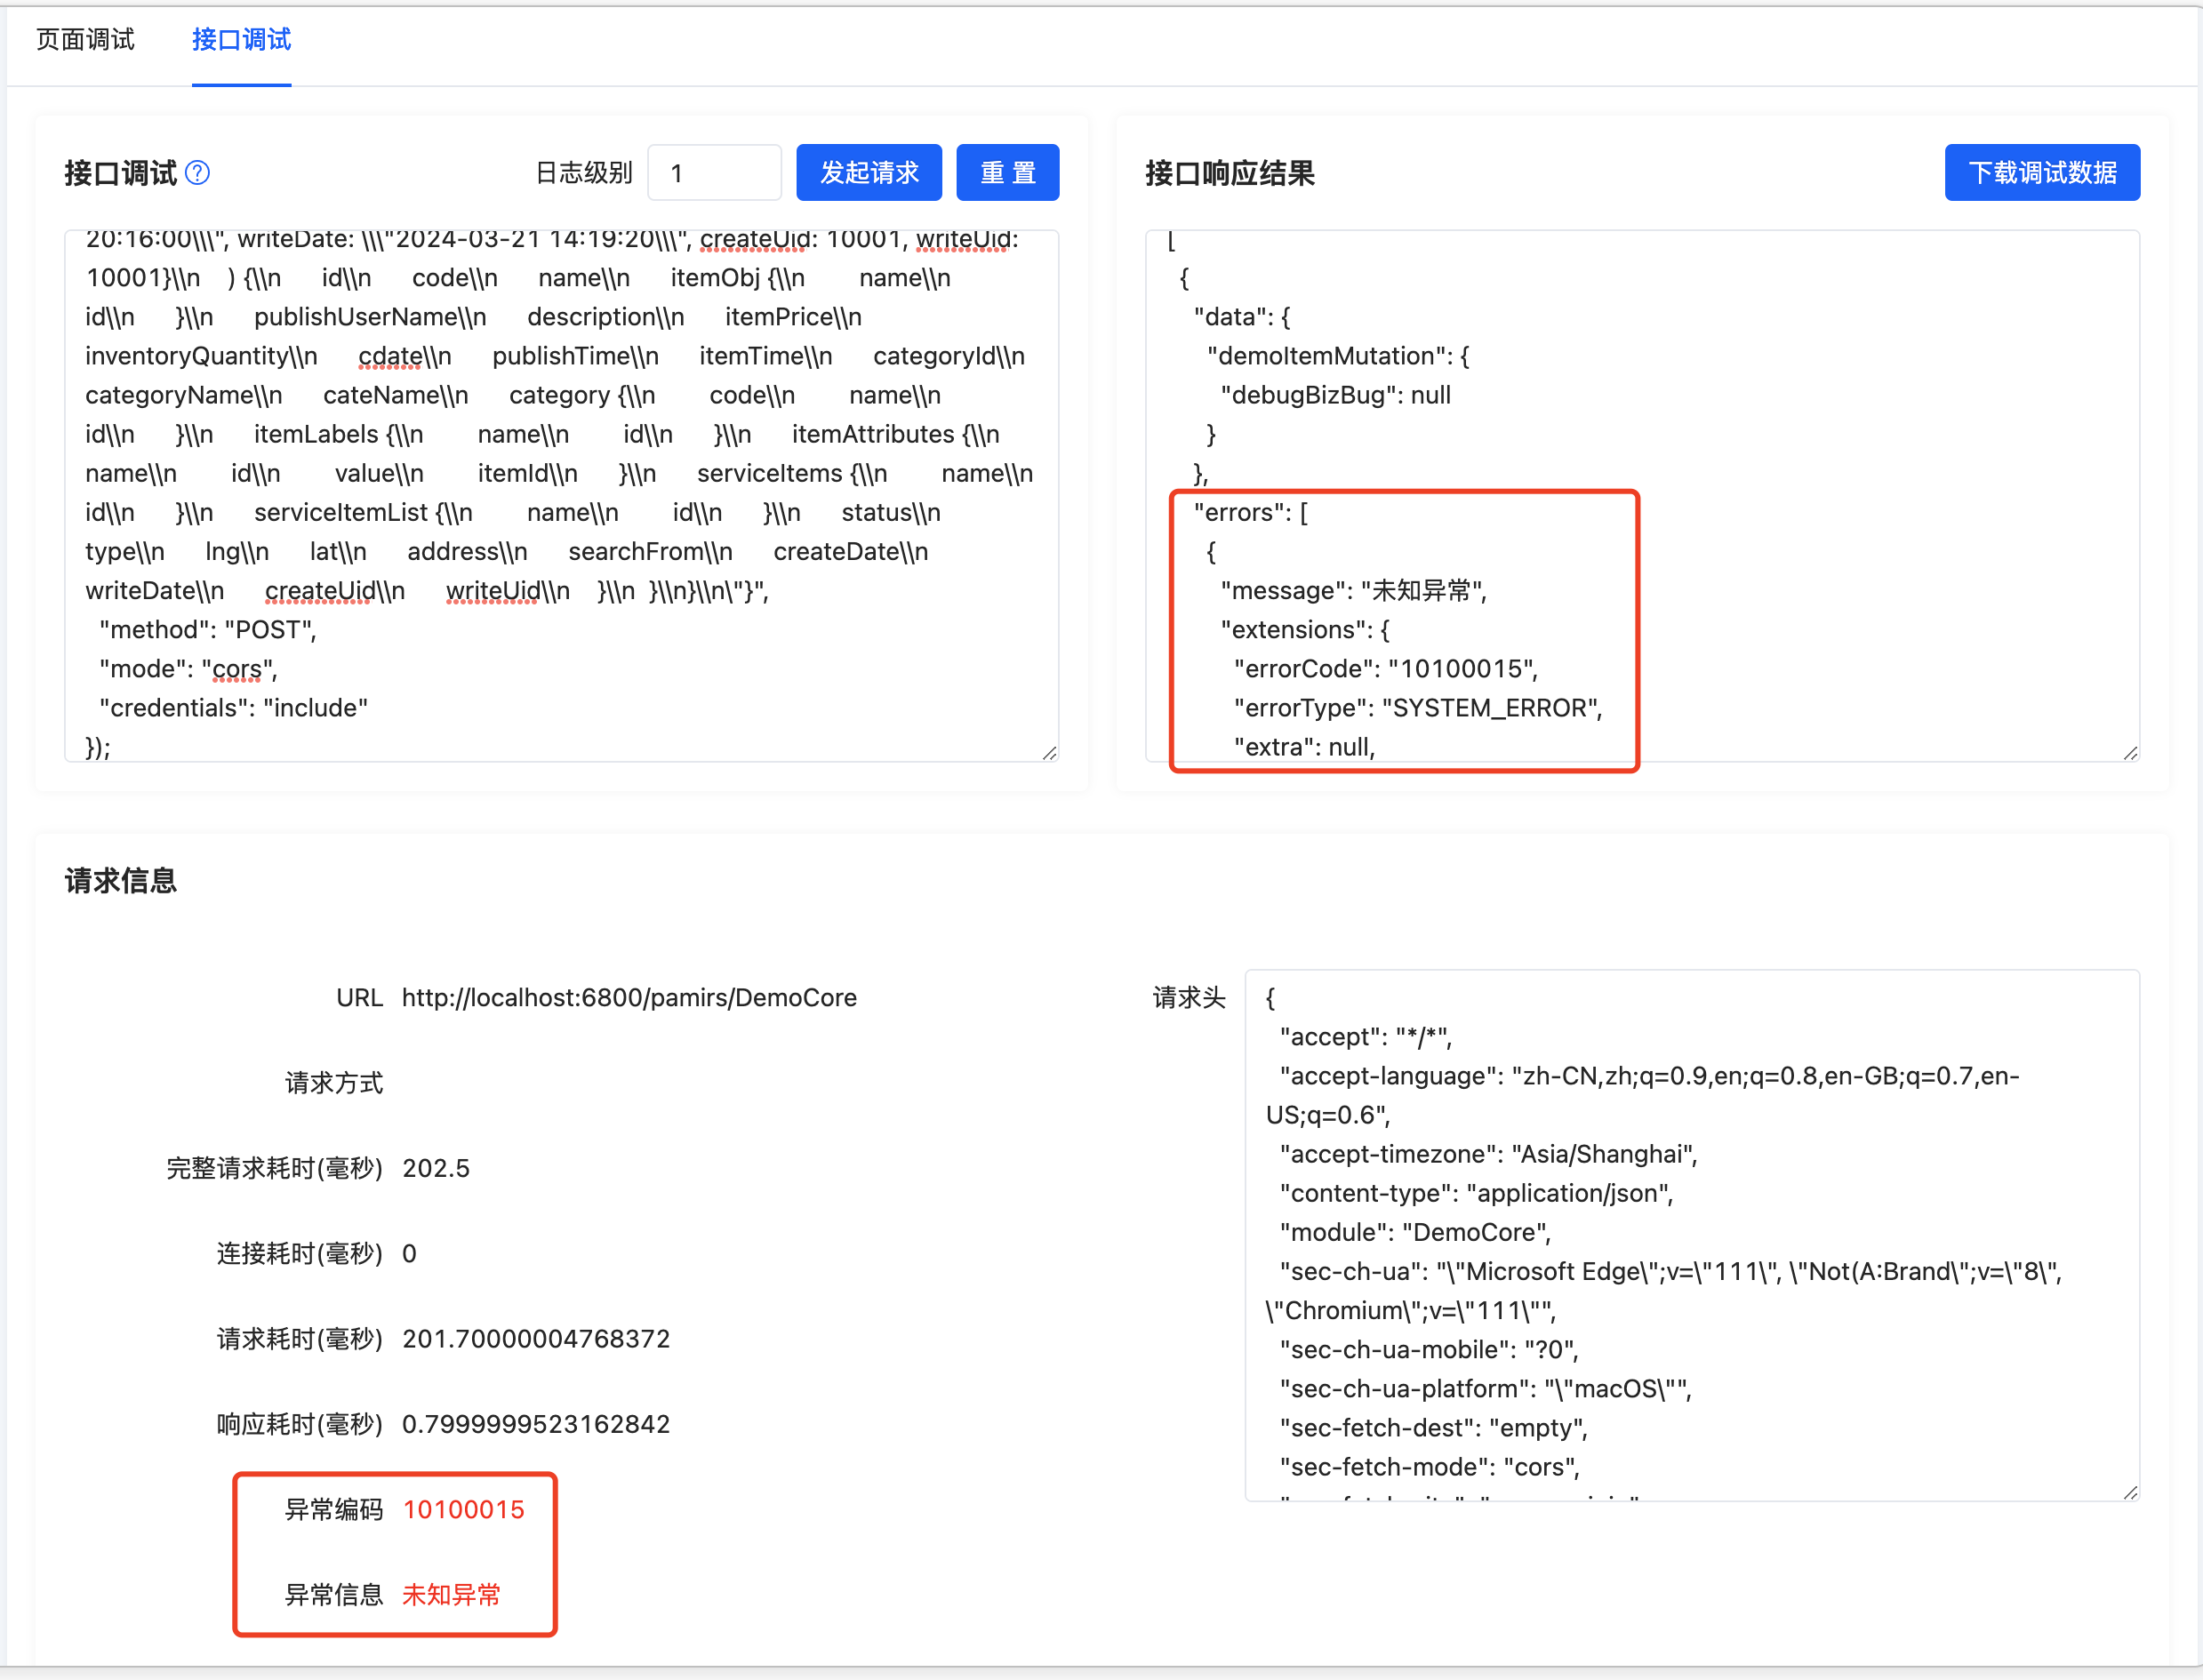
报错后发起调试请求,
image.png
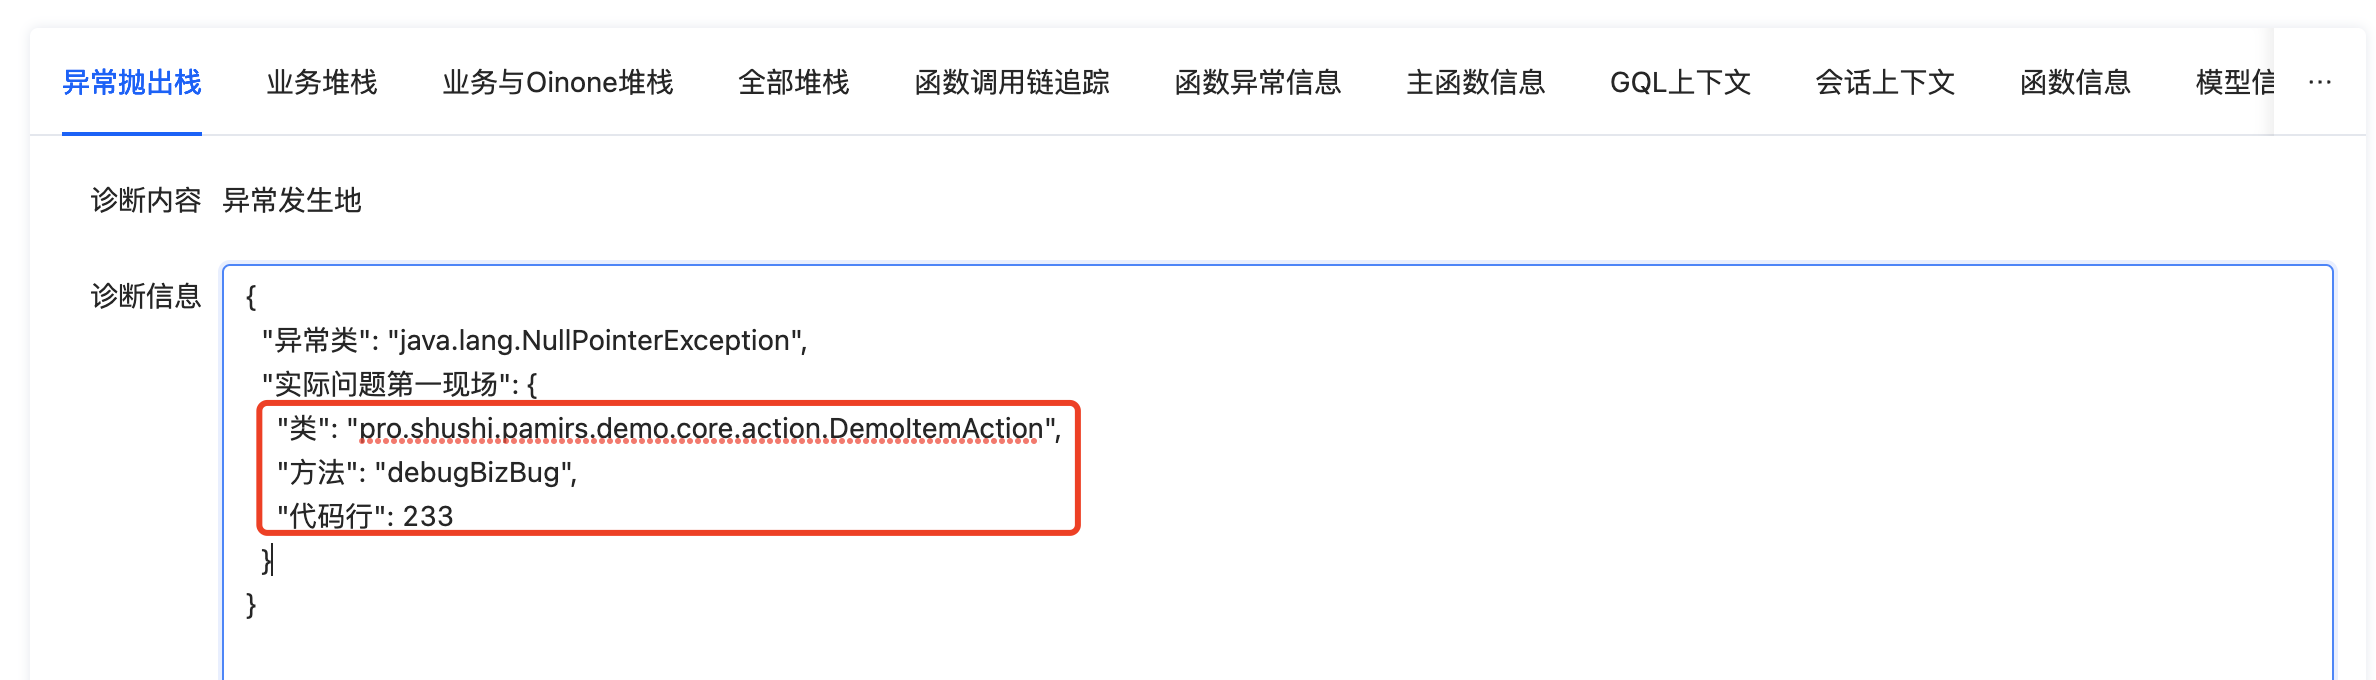
我们可以看到,调试工具直接给出了异常抛出的具体代码所在位置,
image.png
此时再切换到“全部堆栈”下,可以看到是业务类的233行导致的空指针异常,查看代码后分析可得是data.getName().eqauls方法在调用前未做条件判断
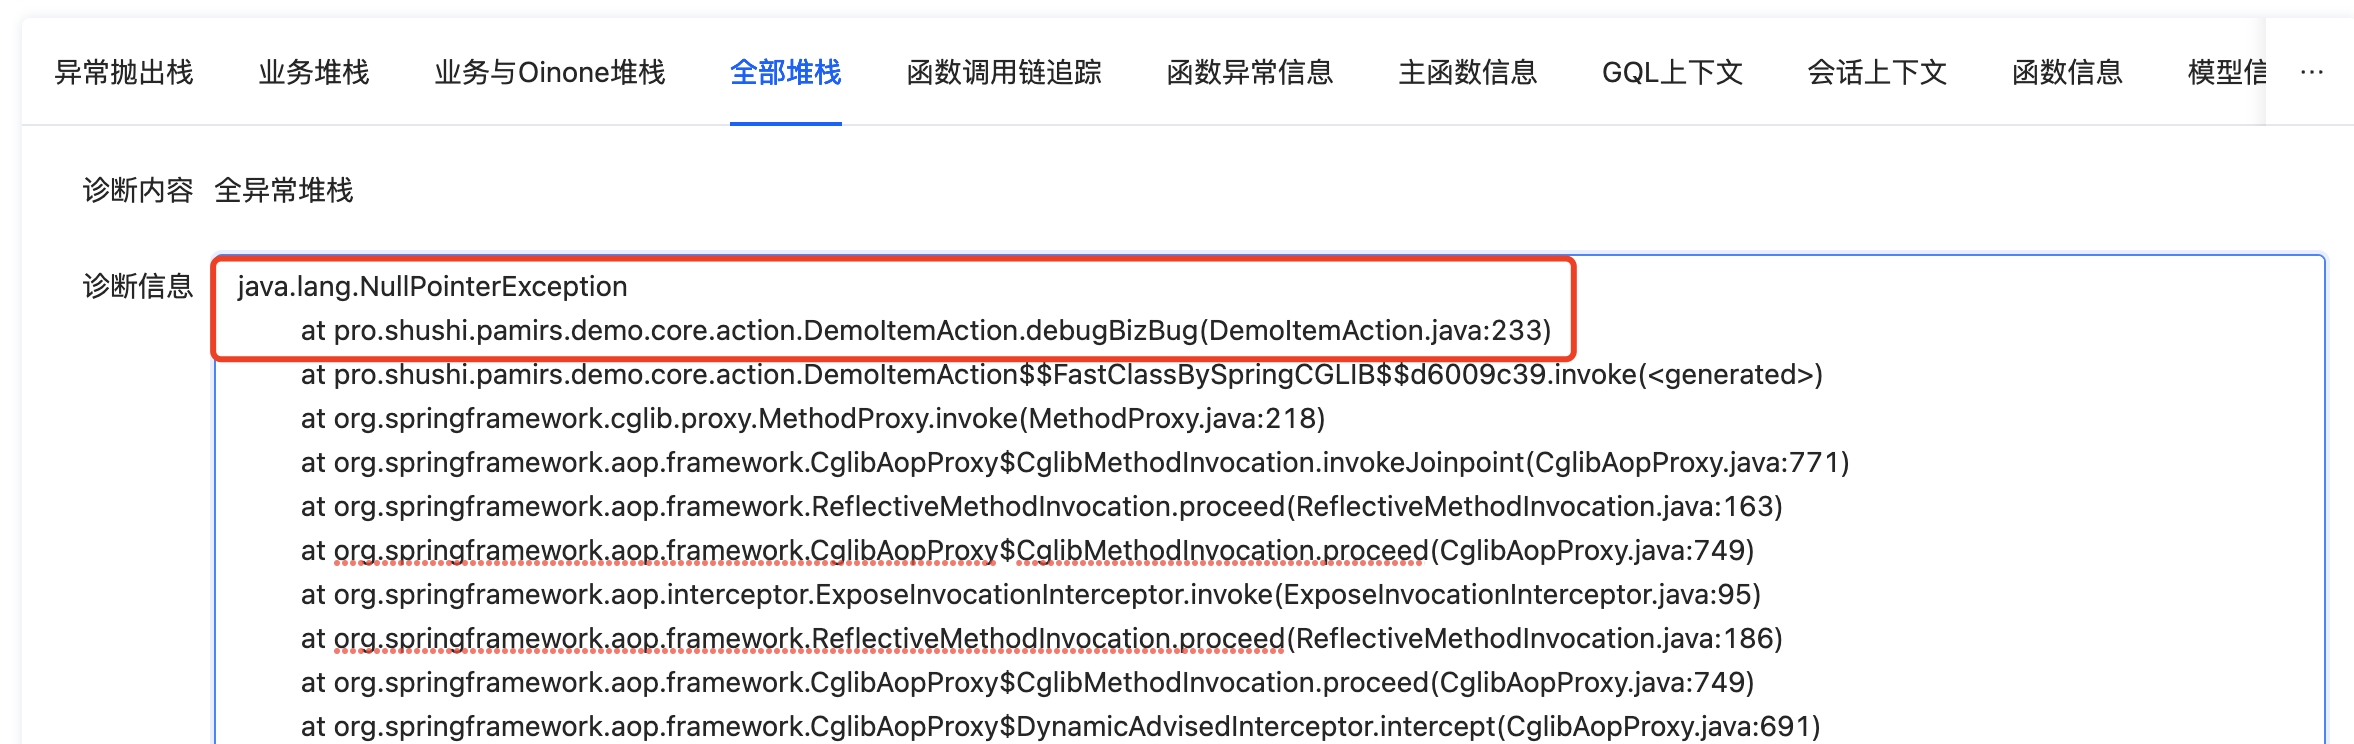
image.png
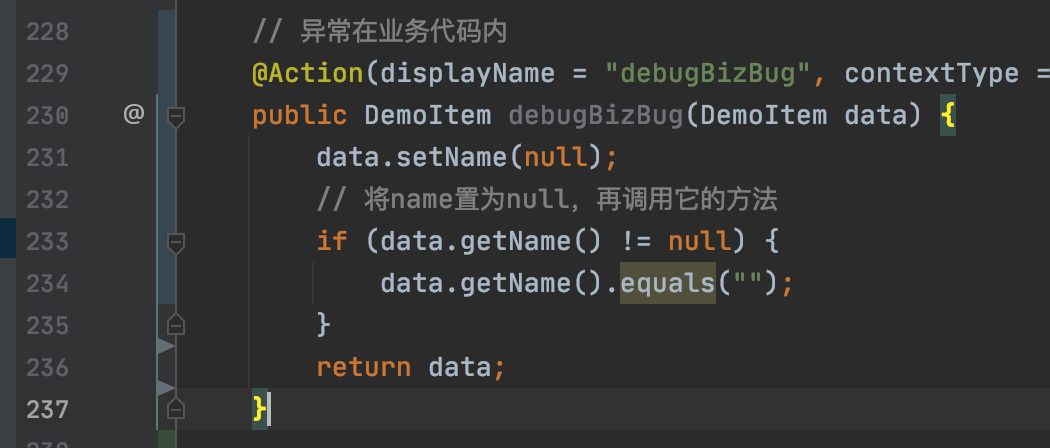
补全该判断后代码可以正常执行
image.png

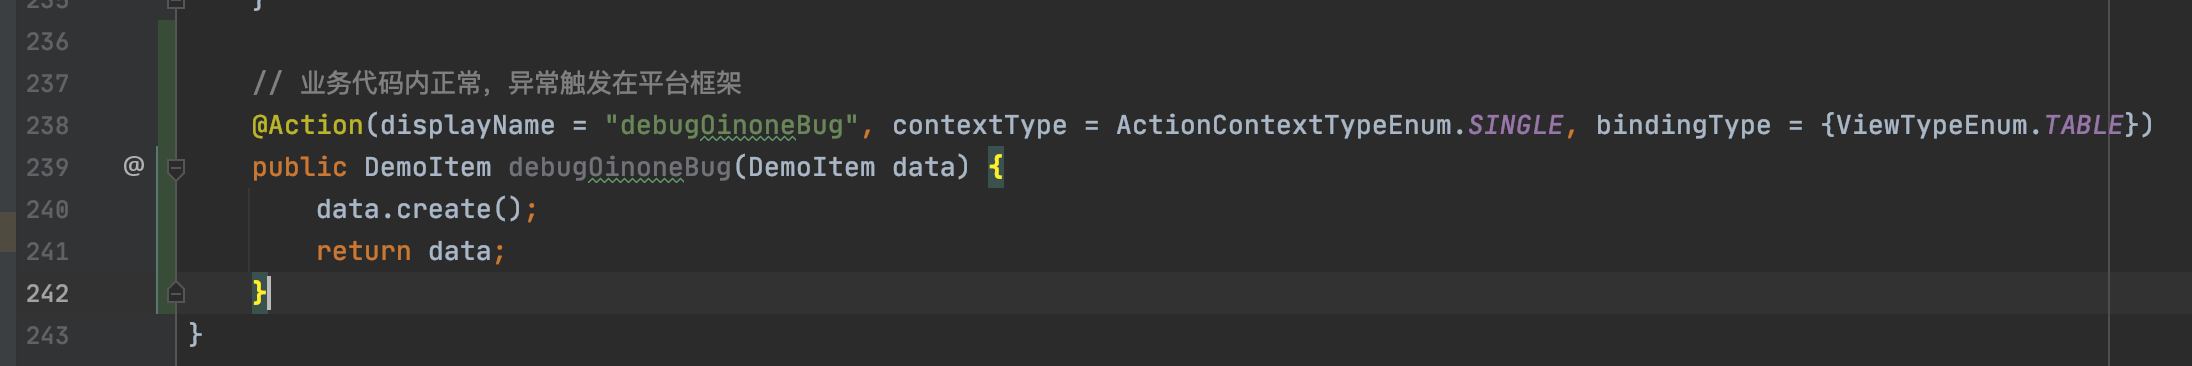
业务代码中没有直接的错误,异常在平台代码中抛出

image.png
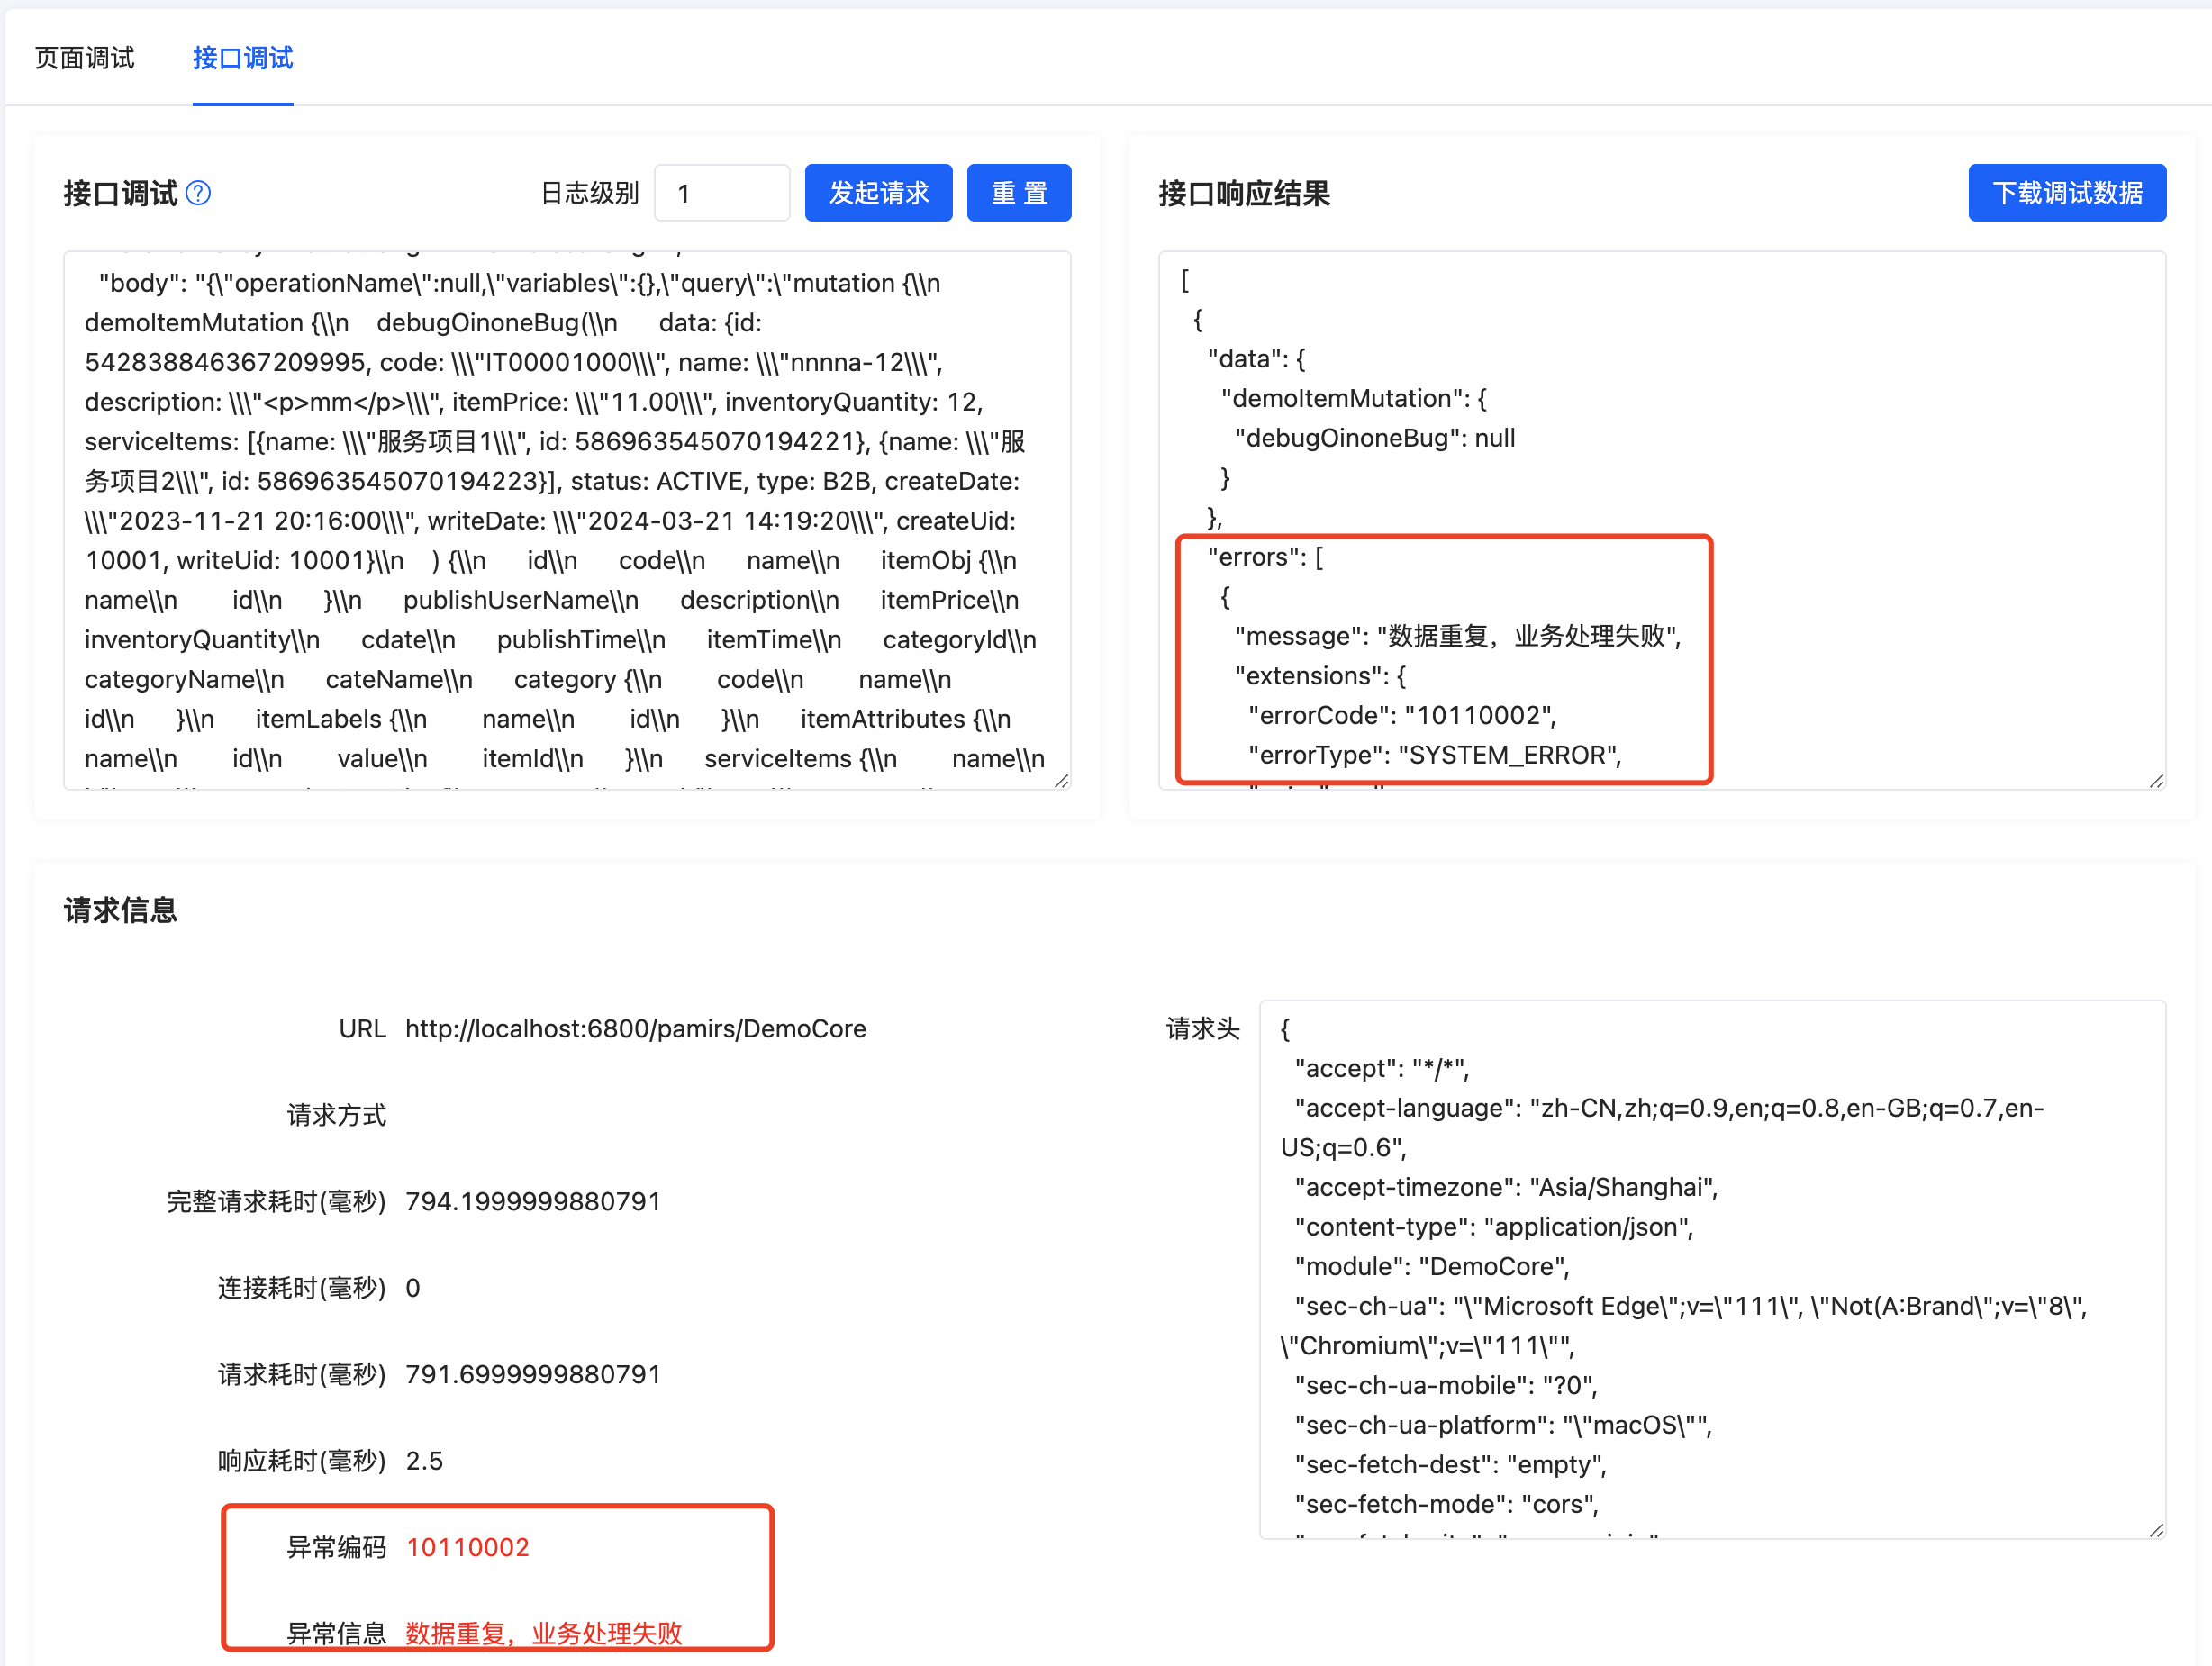
报错后发起调试请求
image.png
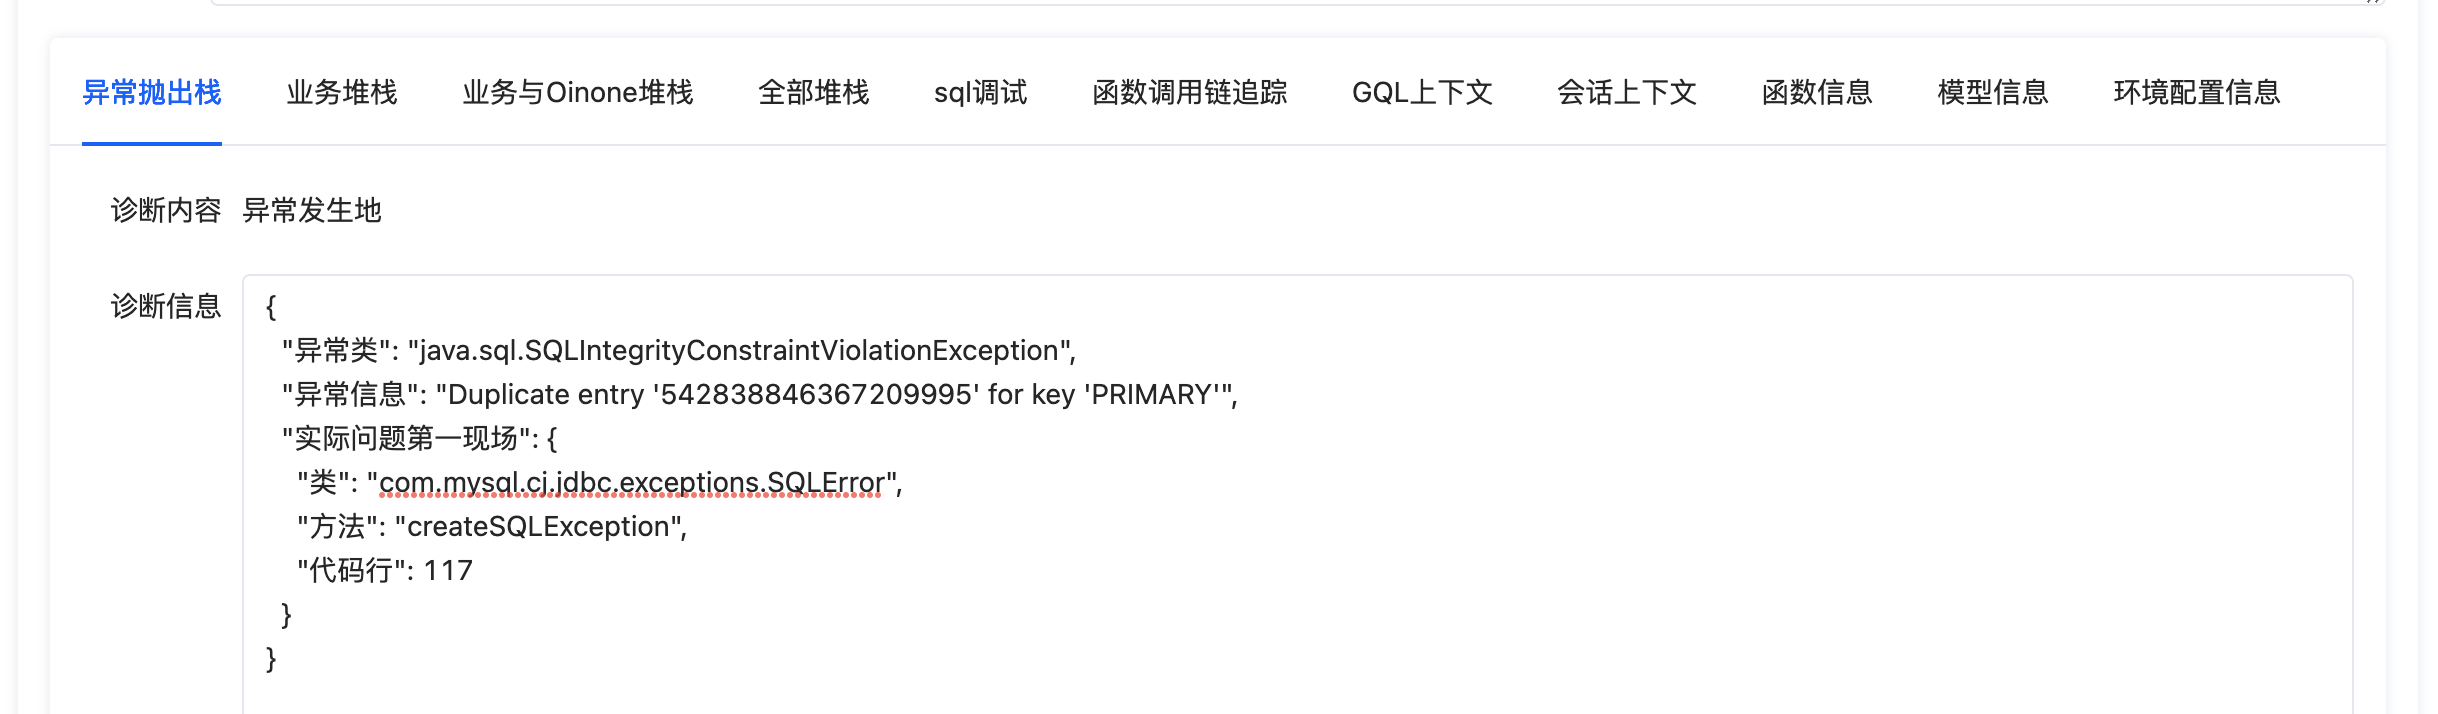
可以看到异常不在业务代码内
image.png
再切换到“全部堆栈”,可以看到具体异常信息,提示core_demo_item表出现了重复的主键,该表是DemoItem模型的
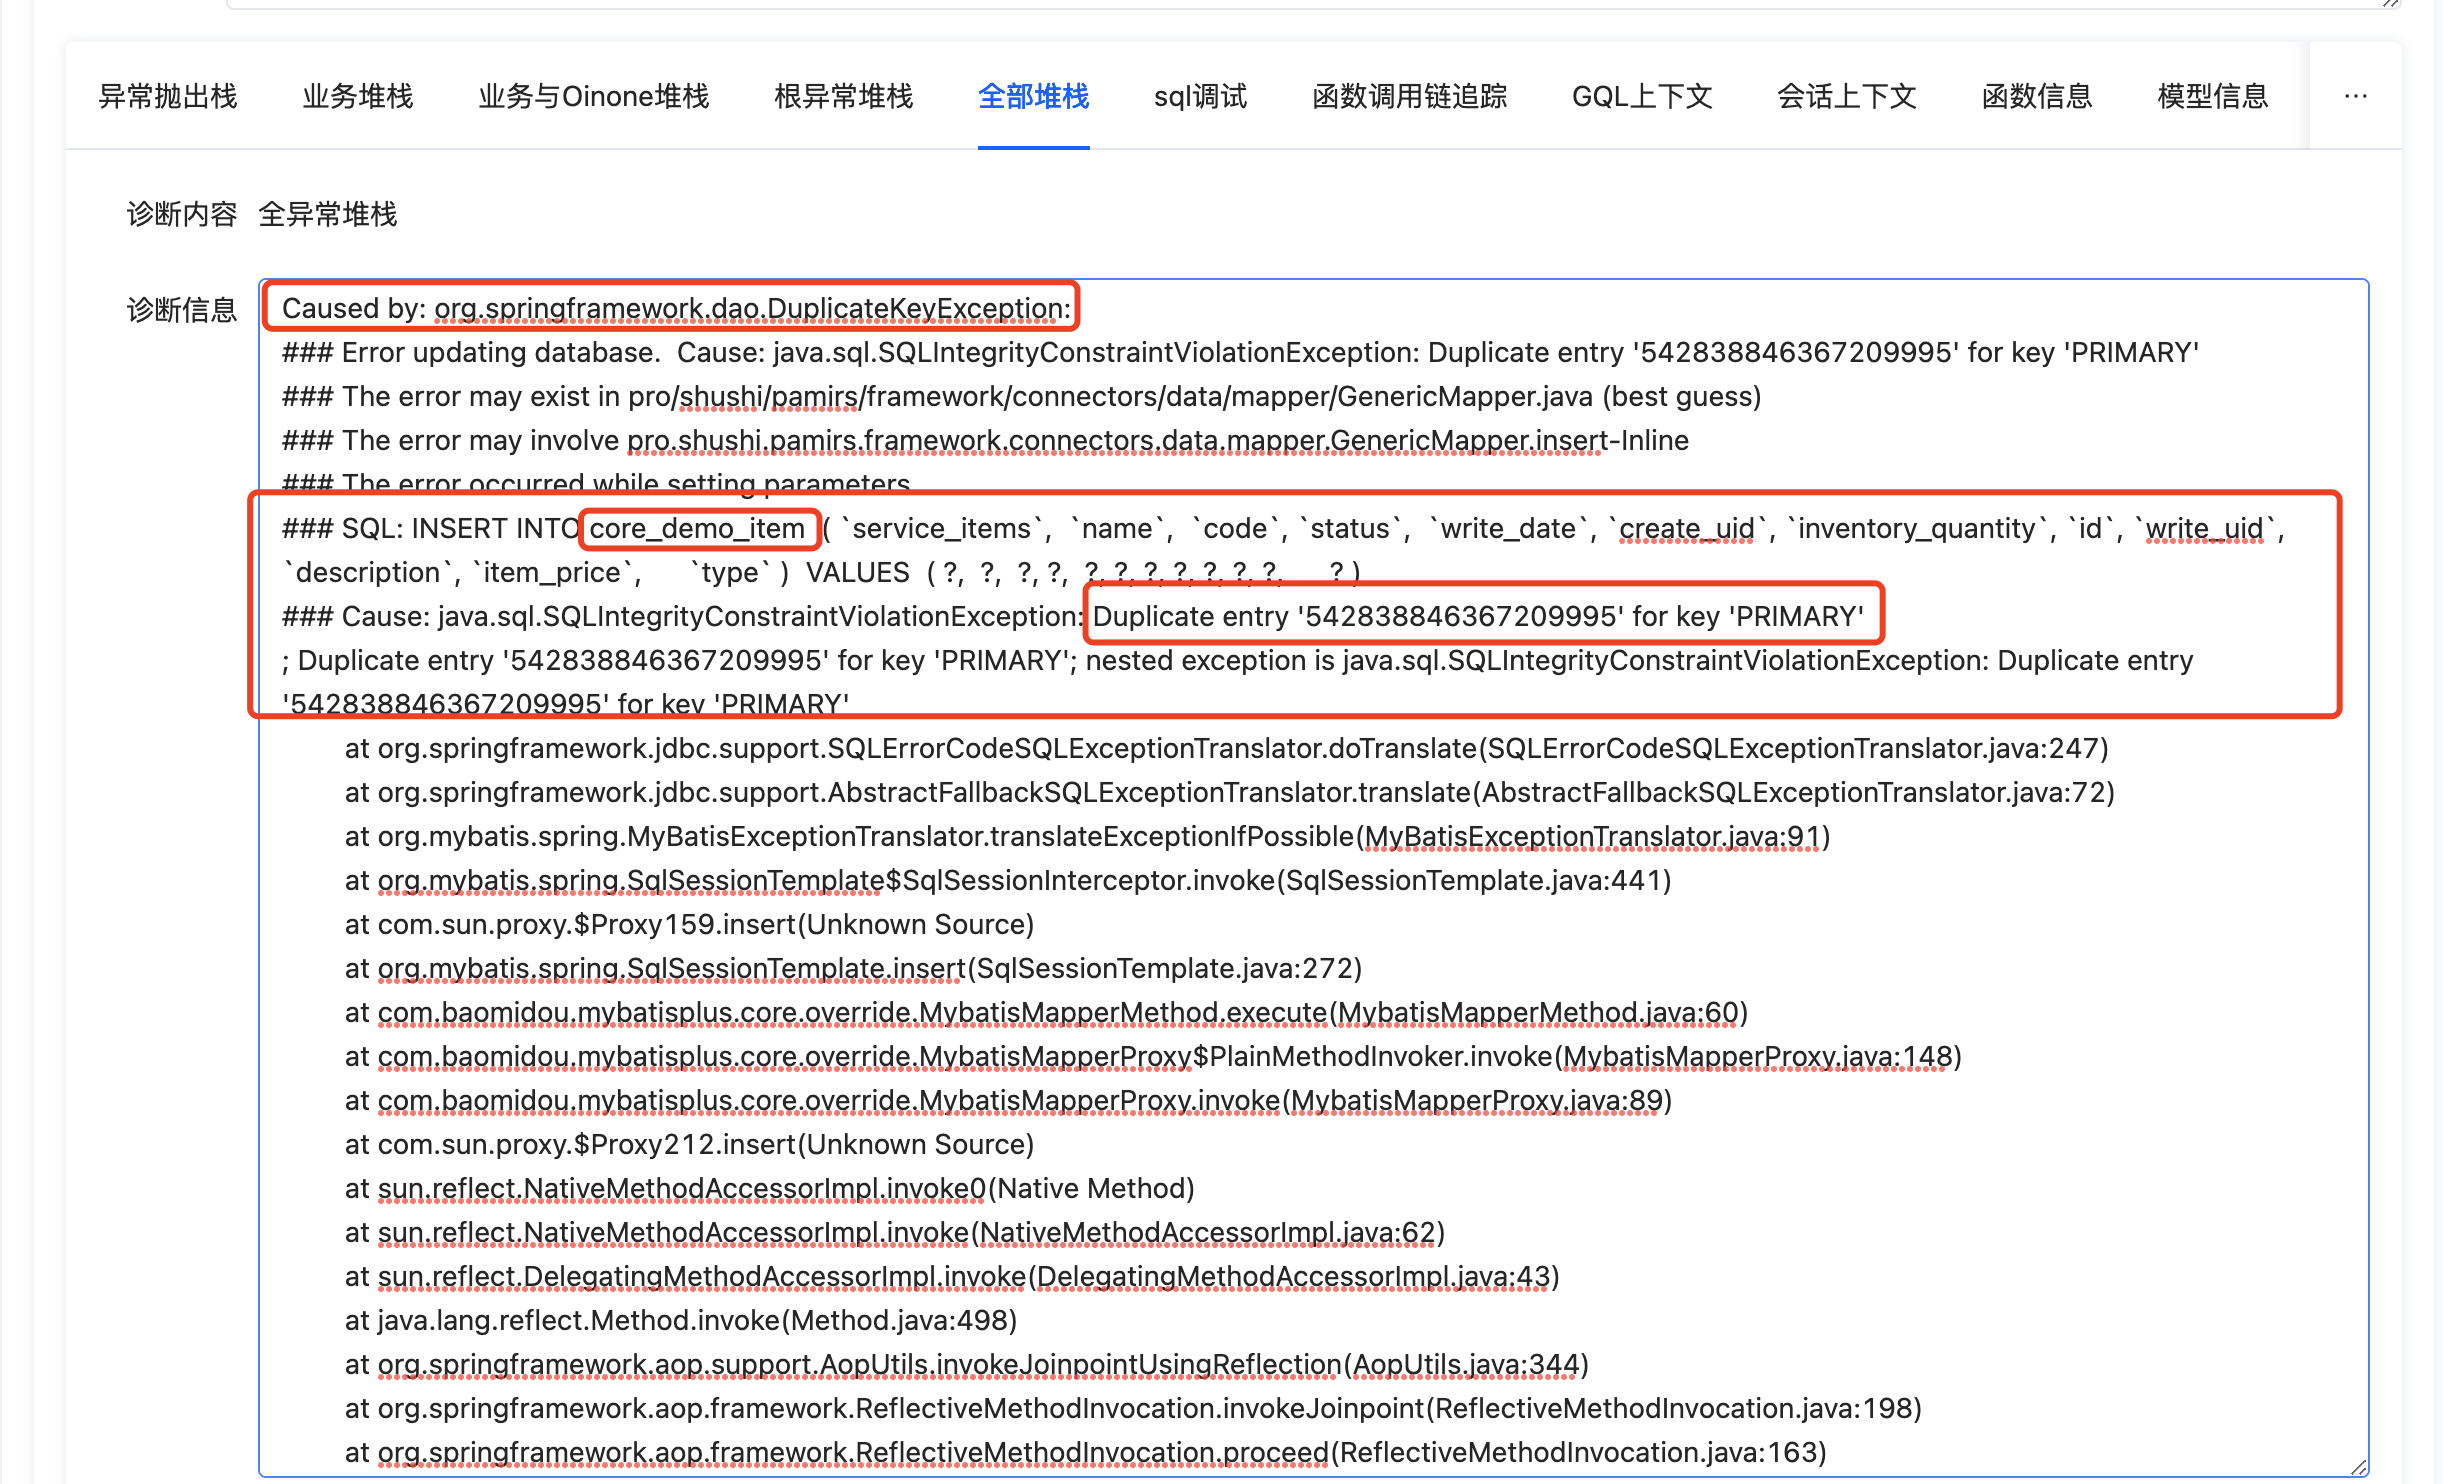
image.png
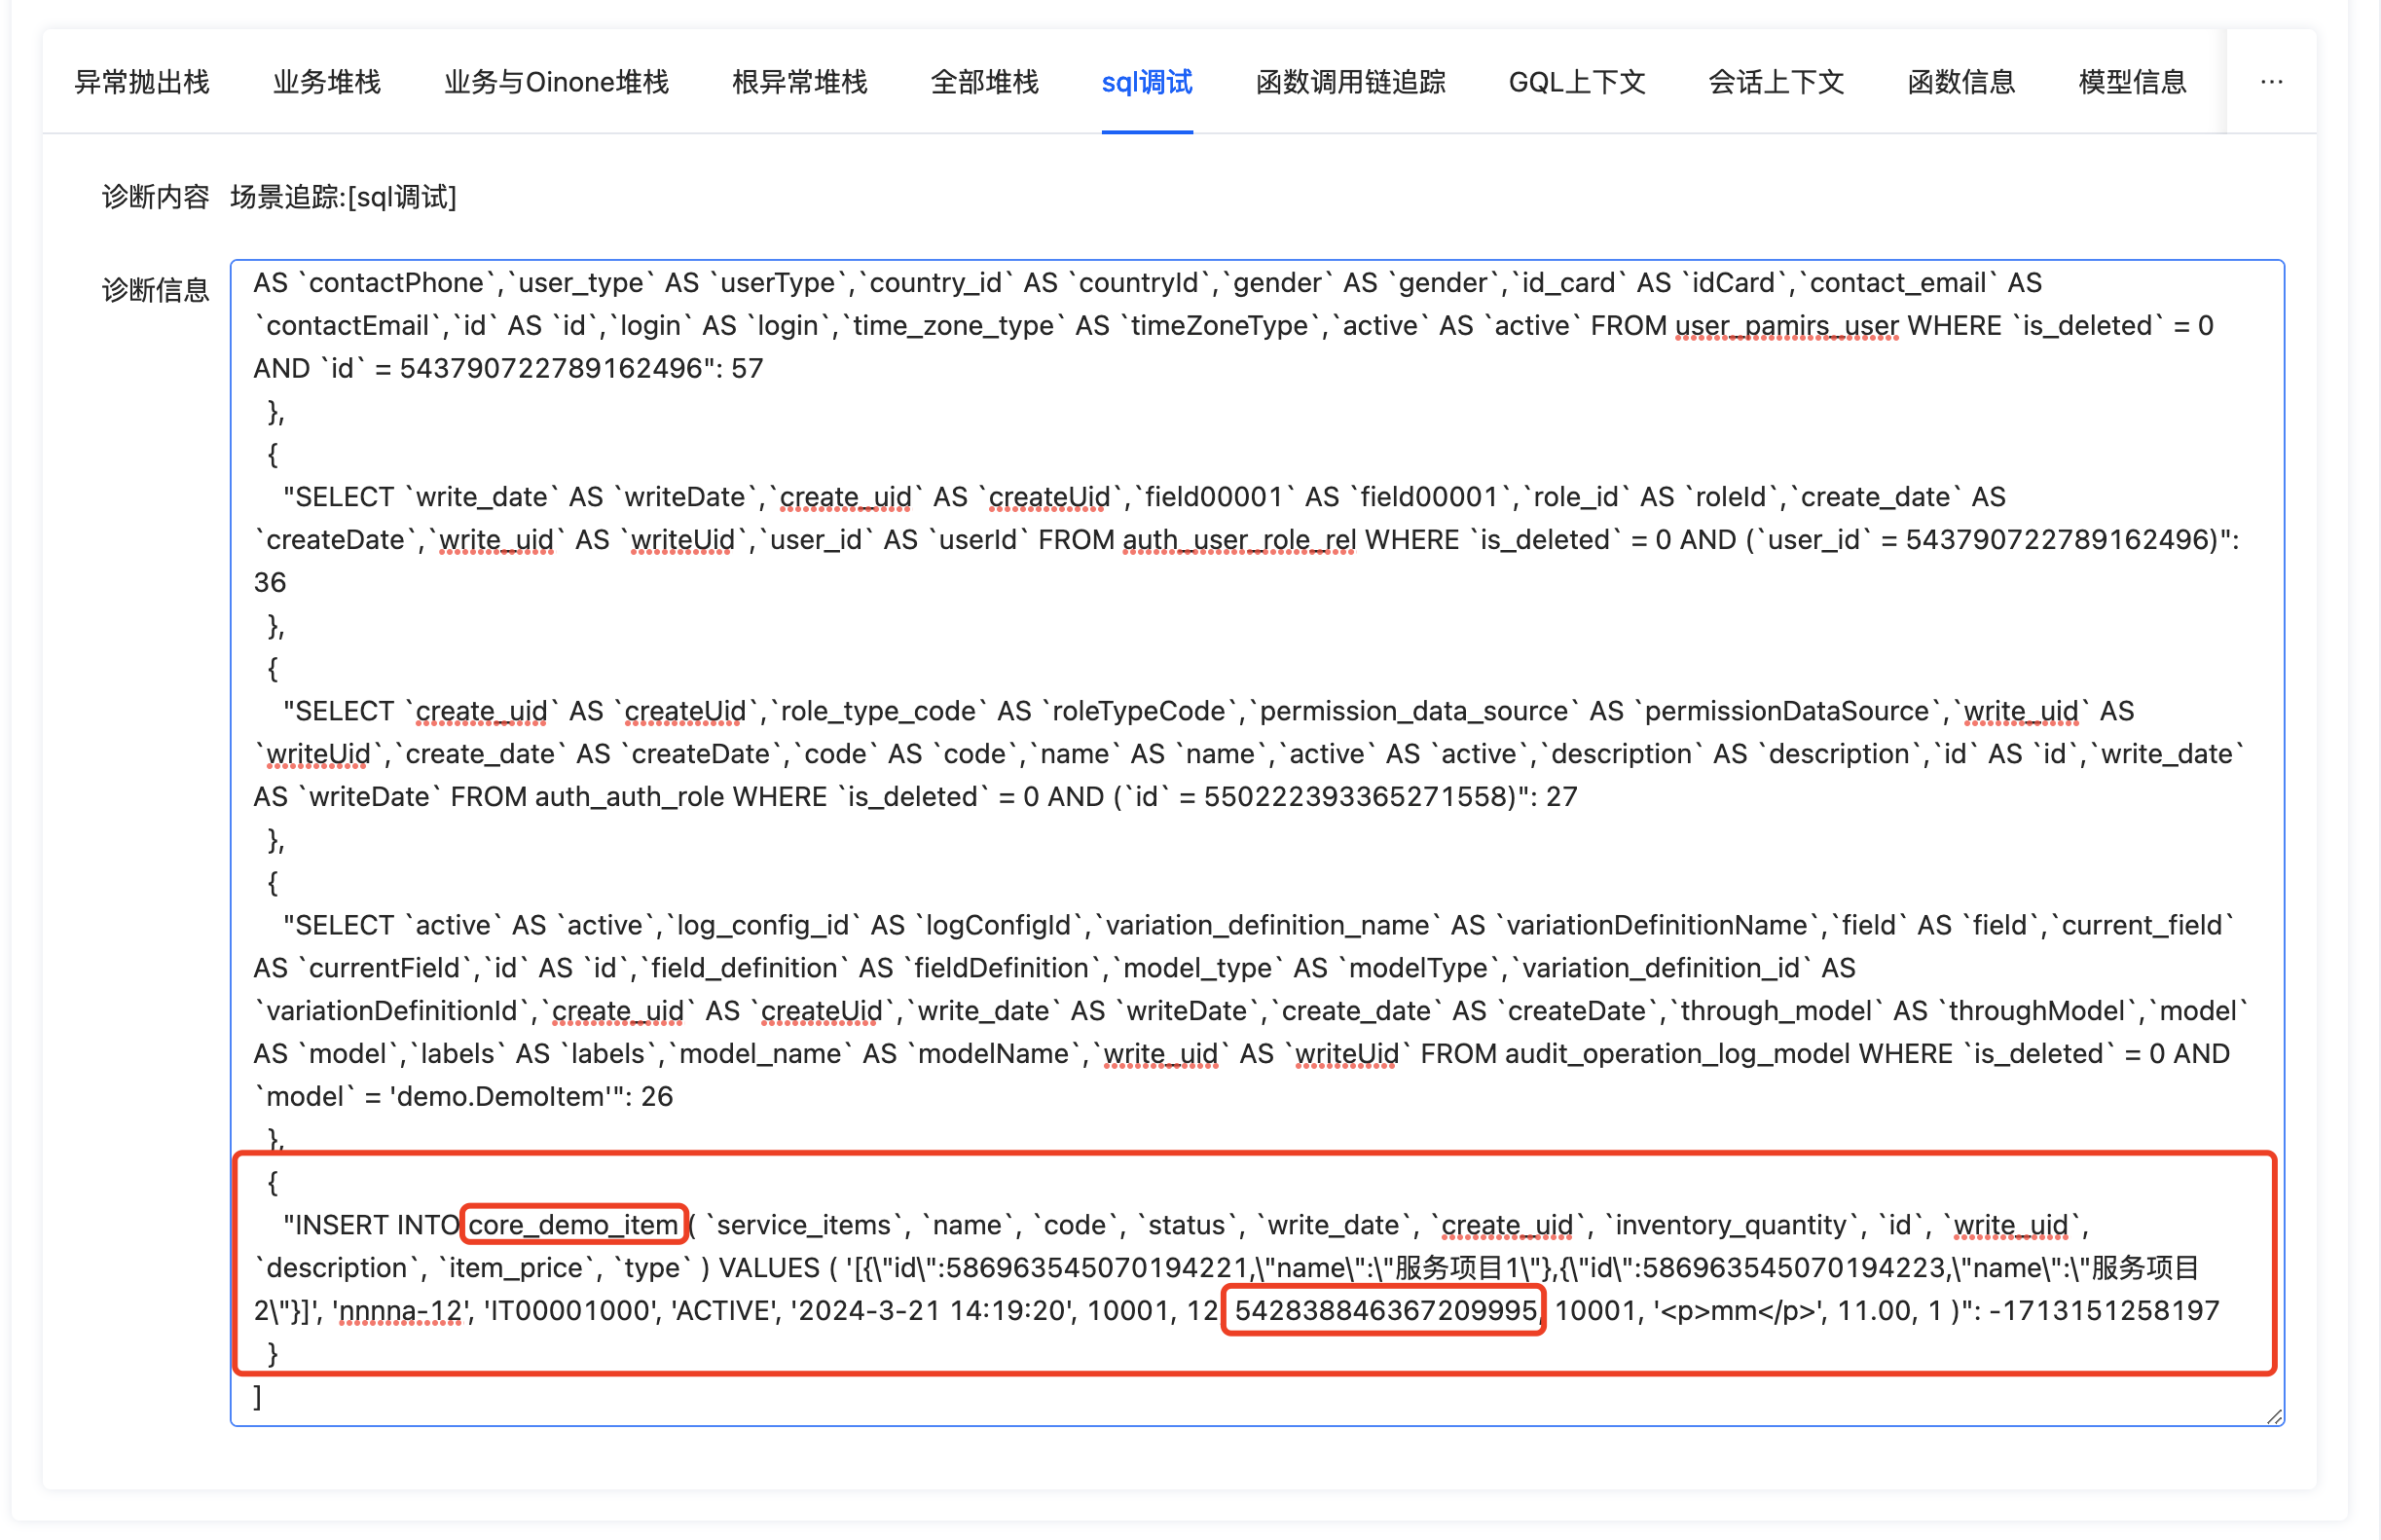
我们还可以切换到“sql调试”的标签页,可以看到出错的具体sql语句
image.png
经过分析可以得知是240行的data.create()�重复创建数据导致的。

三、排查工具无法定位怎么办

当我们通过排查工具还是没有定位到问题的时候,可以通过调试页面的“下载全部调试数据”和“下载调试数据”按钮将调试信息的数据发送给官方售后人员帮助我们定位排查问题。

点击页面最顶部的“下载全部调试数据”按钮,可以下载页面调试数据和接口调试数据
点击“调试接口”标签页内的“下载调试数据”按钮,可以下载接口调试数据
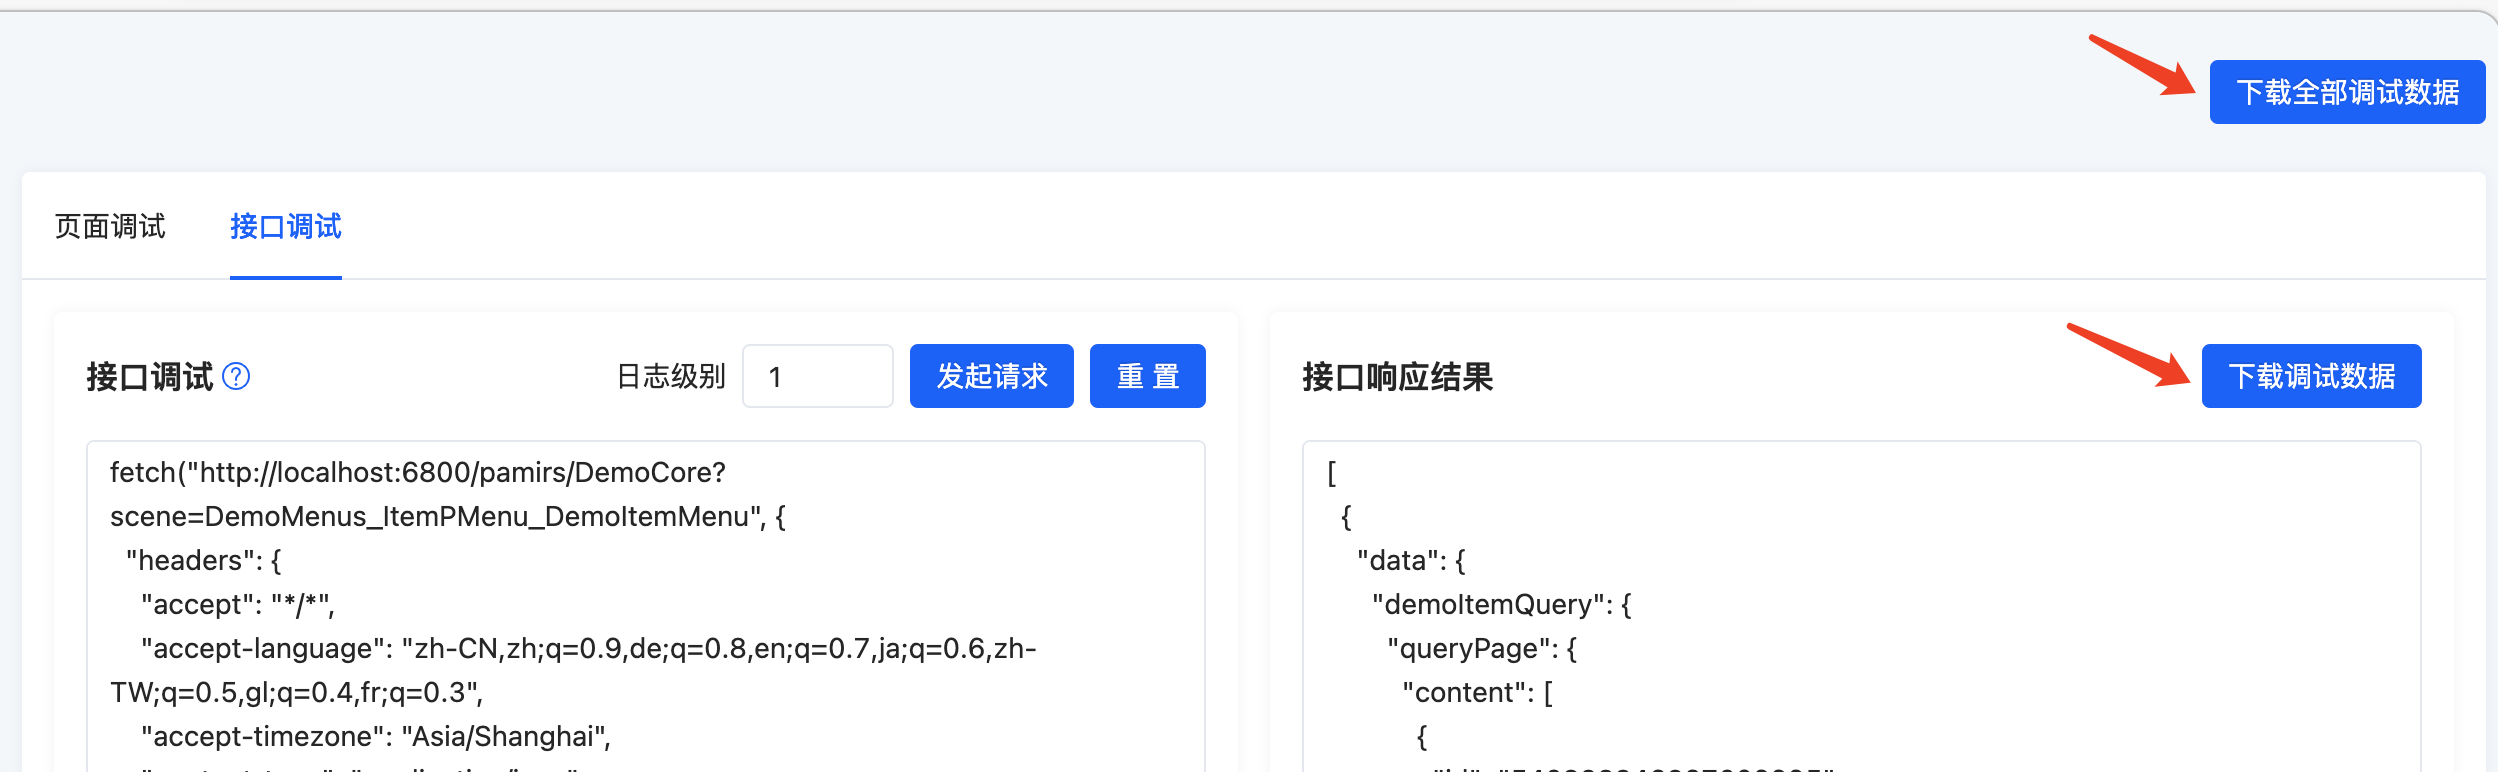
image.png

四、排查工具细节

Oinone社区 作者:shao原创文章,如若转载,请注明出处:https://doc.oinone.top/kai-fa-shi-jian/7484.html

访问Oinone官网:https://www.oinone.top获取数式Oinone低代码应用平台体验

Like (0)
shao's avatarshao数式管理员
Previous 2024年5月20日 pm9:04
Next 2024年5月21日 pm6:54

相关推荐

  • Oinone开发实践-业务实现多租户方案

    总体方案 业务项目中,需要隔离的模型自定义增加租户字段进行数据隔离; 参考了Mybatis-Plus插件的TenantSqlParser进行的JPA实现,使用jsqlparser解析并修改SQL; 实现获取当前用户租户ID,SQL增删改查时处理租户字段,实现租户数据的隔离 参考项目: https://github.com/baomidou/mybatis-plus https://github.com/JSQLParser/JSqlParser 具体实现方式 1、业务上定义两个基础抽象模型包含租户字段 定义包含ID的基础抽象模型,且包含租户字段(如:公司编码, 用其他字段作为租户字段也可以,根据实际业务情况灵活修改)。 @Model.model(XXIdModel.MODEL_MODEL) @Model.Advanced(type = ModelTypeEnum.ABSTRACT) @Model(displayName = “带公司CODE的基础ID抽象模型”, summary = “带公司Code的Id模型”) public abstract class XXIdModel extends IdModel { public static final String MODEL_MODEL = “demo.biz.XXIdModel”; @Field.String @Field(displayName = “所属公司编码”, invisible = true, index = true) private String companyCode; } 定义包含Code的基础抽象模型,且包含租户字段(如:公司编码, 用其他字段作为租户字段也可以,根据实际业务情况灵活修改)。 @Model.model(XXCodeModel.MODEL_MODEL) @Model.Advanced(type = ModelTypeEnum.ABSTRACT) @Model(displayName = “带公司CODE的基础Code抽象模型”, summary = “带公司CODE的Code模型”) public abstract class XXCodeModel extends CodeModel { public static final String MODEL_MODEL = “demo.biz.XXCodeModel”; @Field.String @Field(displayName = “所属公司编码”, invisible = true, index = true) private String companyCode; } 2、业务模块的模型需租户隔离的都是继承上面这两个模型; @Model.model(PetPetCompany.MODEL_MODEL) @Model(displayName = “宠物公司”, labelFields = “name”) public class PetPetCompany extends AbstractCompanyCodeModel { public static final String MODEL_MODEL = “demo.PetPetCompany”; @Field.String @Field(displayName = “名称”) private String name; @Field.Text @Field(displayName = “简介”) private String introduction; } 3、自定义扩展Session,Session中设置租户信息 每次请求多把登录用户所属公司编码(companyCode)放到Session中;Session扩展参考:https://doc.oinone.top/oio4/9295.html 4、定义拦截器Interceptor进行数据隔离 数据创建和查询通过拦截器把Session中的中的公司编码(companyCode)设置到隔离字段中;拦截器的java示例代码参考: package pro.shushi.pamirs.demo.core.interceptor; import net.sf.jsqlparser.JSQLParserException; import net.sf.jsqlparser.expression.Expression; import net.sf.jsqlparser.expression.LongValue; import net.sf.jsqlparser.expression.StringValue; import net.sf.jsqlparser.expression.operators.relational.ExpressionList; import net.sf.jsqlparser.expression.operators.relational.ItemsListVisitor; import net.sf.jsqlparser.expression.operators.relational.MultiExpressionList; import net.sf.jsqlparser.expression.operators.relational.NamedExpressionList; import net.sf.jsqlparser.parser.CCJSqlParserUtil; import net.sf.jsqlparser.schema.Column; import net.sf.jsqlparser.statement.Statement; import net.sf.jsqlparser.statement.insert.Insert; import net.sf.jsqlparser.statement.select.*; import net.sf.jsqlparser.statement.update.Update; import net.sf.jsqlparser.statement.values.ValuesStatement; import org.apache.commons.lang3.StringUtils; import org.apache.ibatis.executor.Executor; import org.apache.ibatis.mapping.BoundSql; import org.apache.ibatis.mapping.MappedStatement; import org.apache.ibatis.mapping.SqlCommandType; import org.apache.ibatis.mapping.SqlSource; import org.apache.ibatis.plugin.*; import org.apache.ibatis.reflection.MetaObject; import org.apache.ibatis.reflection.SystemMetaObject; import…

    2024年4月6日
    1.6K00
  • Oinone连接外部数据源方案

    场景描述 在实际业务场景中,有是有这样的需求:链接外部数据进行数据的获取;通常的做法:1、【推荐】通过集成平台的数据连接器,链接外部数据源进行数据操作;2、项目代码中链接数据源,即通过程序代码操作外部数据源的数据; 本篇文章只介绍通过程序代码操作外部数据源的方式. 整体方案 Oinone管理外部数据源,即yml中配置外部数据源; 后端通过Mapper的方式进行数据操作(增/删/查/改); 调用Mapper接口的时候,指定到外部数据源; 详细步骤 1、数据源配置(application.yml), 与正常的数据源配置一样 out_ds_name(外部数据源别名): driverClassName: com.mysql.cj.jdbc.Driver type: com.alibaba.druid.pool.DruidDataSource # local环境配置调整 url: jdbc:mysql://ip(host):端口/数据库Schema?useSSL=false&allowPublicKeyRetrieval=true&useServerPrepStmts=true&cachePrepStmts=true&useUnicode=true&characterEncoding=utf8&serverTimezone=Asia/Shanghai&autoReconnect=true&allowMultiQueries=true username: 用户名 password: 命名 initialSize: 5 maxActive: 200 minIdle: 5 maxWait: 60000 timeBetweenEvictionRunsMillis: 60000 testWhileIdle: true testOnBorrow: false testOnReturn: false poolPreparedStatements: true asyncInit: true 2、外部数据源其他配置外部数据源限制创建表结构的执行,可以通过配置指定【不创建DB,不创建数据表】 persistence: global: auto-create-database: true auto-create-table: true ds: out_ds_name(外部数据源别名): # 不创建DB auto-create-database: false # 不创建数据表 auto-create-table: false 3、后端写Mapper SQL Mapper跟使用原生mybaits/mybaits-plus写法一样,无特殊限制; Mapper和SQL写到一起,或者分开两个文件都可以 4、Mapper被Service或者Action调用1)启动的Application中@MapperScan需要扫描到对应的包。2)调用是与普通bean一样(即调用方式跟传统的方式样),唯一的区别就是加上DsHintApi,即指定Mapper所使用的数据源。 @Autowired private ScheduleItemMapper scheduleItemMapper; public saveData(Object data) { ScheduleQuery scheduleQuery = new ScheduleQuery(); //scheduleQuery.setActionName(); try (DsHintApi dsHint = DsHintApi.use(“外部数据源名称”)) { List<ScheduleItem> scheduleItems = scheduleItemMapper.selectListForSerial(scheduleQuery); // 具体业务逻辑 } } 其他参考:如何自定义sql语句:https://doc.oinone.top/backend/4759.html

    2024年5月17日
    2.7K00
  • 树形下拉组件数据查询覆写

    一、背景与问题 Oinone 的树形下拉组件(TreeSelect)和树视图(Tree)在查询数据时,最终调用的是树节点所配置模型的数据管理器函数: 树接口 调用的数据管理器函数 场景 fetchAll queryListByWrapper 一次性全量加载 fetchChildren queryPage 按层级懒加载(默认) queryKeywords4Tree queryListByWrapper 关键字搜索 reverselyQuery queryListByWrapper 已选数据回填 官方文档原文:「所有树查询接口都会调用模型对应的数据管理器函数,可以通过重写的方式修改其查询结果。」 直接覆写的风险 如果直接在原模型(如 business.PamirsDepartment)上覆写 queryPage: // ⚠️ 危险写法:会影响所有使用 PamirsDepartment.queryPage 的场景 @Component @Model.model(PamirsDepartment.MODEL_MODEL) public class DeptQueryAction { @Function.Advanced(type = FunctionTypeEnum.QUERY, category = FunctionCategoryEnum.QUERY_PAGE) @Function.fun(FunctionConstants.queryPage) @Function(openLevel = {FunctionOpenEnum.LOCAL, FunctionOpenEnum.REMOTE, FunctionOpenEnum.API}) public Pagination<PamirsDepartment> queryPage(Pagination<PamirsDepartment> page, IWrapper<PamirsDepartment> queryWrapper) { // 追加过滤条件… return new PamirsDepartment().queryPage(page, queryWrapper); } } 该覆写会全局生效——不仅是树形下拉,所有调用 PamirsDepartment 的 queryPage 的地方(组织架构页面、人员管理列表、权限分配、框架内部关联查询等)都会受到影响,容易引发难以排查的副作用。 二、推荐方案:代理模型(PROXY)隔离 核心思路 创建一个继承原模型的代理模型(ModelTypeEnum.PROXY),拥有独立的模型命名空间 在代理模型中重新声明自关联字段(如 parent),将关联目标指向代理模型自身 在代理模型的 Action 中覆写数据管理器函数,追加树形场景专属的过滤逻辑 树形下拉的视图 DSL 中,<node> 的 model 指向代理模型 代理模型与原模型共享同一张数据表,但函数注册在各自独立的命名空间下,互不干扰。 框架官方示例 Oinone 框架自身就采用了这一模式:ResourceRegionProxyModel 继承 ResourceRegion,用于地区页面的代理展示,其扩展点 ResourceRegionProxyModelExtPoint 中的 queryPageAfter 只影响代理模型自身的查询。 三、完整实现步骤(以 PamirsDepartment 为例) 场景假设 业务需求:某个表单页面的「部门」树形下拉只需要展示当前公司(companyCode == 当前用户公司)且启用状态(dataStatus == ENABLED)的部门,而系统中其他使用 PamirsDepartment 的地方(组织架构、权限管理等)不受影响。 步骤 1:定义代理模型 package com.example.demo.model; import pro.shushi.pamirs.meta.annotation.Field; import pro.shushi.pamirs.meta.annotation.Model; import pro.shushi.pamirs.meta.enmu.ModelTypeEnum; import pro.shushi.pamirs.business.api.model.PamirsDepartment; import java.util.List; /** * 部门树形下拉专用代理模型 * <p> * 继承 PamirsDepartment,共享同一张数据表, * 但拥有独立的函数命名空间,覆写 queryPage 不影响原模型。 */ @Model.model(DeptTreeProxy.MODEL_MODEL) @Model.Advanced(type = ModelTypeEnum.PROXY) @Model(displayName = "部门(树选择)", labelFields = "name") public class DeptTreeProxy extends PamirsDepartment { public static final String MODEL_MODEL = "demo.DeptTreeProxy"; /** * 【必须重新声明】上级部门(自关联字段) * <p> * 基类 PamirsDepartment 中 parent 的类型是 PamirsDepartment, * 代理模型必须将其覆盖为指向自身(DeptTreeProxy), * 否则设计器/树组件无法在代理模型命名空间内构成完整的自关联关系, * 导致树形下拉无法正确展开层级。 */ @Field.many2one @Field.Relation(relationFields = {"parentCode"}, referenceFields = {"code"}) @Field(displayName = "上级部门")…

    后端 2026年7月27日
    56900
  • Oinone如何支持构建分布式项目

    分布式调用下的[强制]约束 1、[强制]分布式调用情况下base库和redis需共用;2、[强制]如果环境有设计器,设计器的base库和redis保持一致也需与项目中的保持一致;3、[强制]相同base库下,不同应用的相同模块的数据源需保持一致;4、[强制]项目中需引入分布式缓存包。参考下文的分布式包依赖 分布式支持 1、分布式包依赖 1) 父pom的依赖管理中先加入pamirs-distribution的依赖 <dependency> <groupId>pro.shushi.pamirs</groupId> <artifactId>pamirs-distribution</artifactId> <version>${pamirs.distribution.version}</version> <type>pom</type> <scope>import</scope> </dependency> 2) 启动的boot工程中增加pamirs-distribution相关包 <!– 分布式服务发布 –> <dependency> <groupId>pro.shushi.pamirs.distribution</groupId> <artifactId>pamirs-distribution-faas</artifactId> </dependency> <!– 分布式元数据缓存 –> <dependency> <groupId>pro.shushi.pamirs.distribution</groupId> <artifactId>pamirs-distribution-session</artifactId> </dependency> <dependency> <groupId>pro.shushi.pamirs.distribution</groupId> <artifactId>pamirs-distribution-gateway</artifactId> </dependency> 3)启动工程的Application中增加类注解@EnableDubbo @EnableDubbo public class XXXStdApplication { public static void main(String[] args) throws IOException { StopWatch stopWatch = new StopWatch(); stopWatch.start(); // ……………………………… log.info("XXXX Application loading…"); } } 2、修改bootstrap.yml文件 注意序列化方式:serialization: pamirs 以下只是一个示例(zk为注册中心),注册中心支持zk和Nacos;Nacos作为注册中心参考:https://doc.oinone.top/kai-fa-shi-jian/5835.html spring: profiles: active: dev application: name: pamirs-demo cloud: service-registry: auto-registration: enabled: false pamirs: default: environment-check: true tenant-check: true — spring: profiles: dev cloud: service-registry: auto-registration: enabled: false config: enabled: false uri: http://127.0.0.1:7001 label: master profile: dev nacos: server-addr: http://127.0.0.1:8848 discovery: enabled: false namespace: prefix: application file-extension: yml config: enabled: false namespace: prefix: application file-extension: yml dubbo: application: name: pamirs-demo version: 1.0.0 registry: address: zookeeper://127.0.0.1:2181 protocol: name: dubbo port: -1 serialization: pamirs scan: base-packages: pro.shushi cloud: subscribed-services: metadata-report: disabled: true 3、模块启动的最⼩集 pamirs: boot: init: true sync: true modules: – base – sequence – 业务工程的Module 4、业务模型间的依赖关系 服务调用方(即Client端),在启动yml中modules不安装服务提供方的Module 服务调用方(即Client端),项目的pom中只依赖服务提供方的API(即模型和API的定义) 服务调用方(即Client端),项目模块定义(即模型Module定义),dependencies中增加服务提供方的Modeule. 如下面示例代码中的FileModule @Module( name = DemoModule.MODULE_NAME, displayName = "oinoneDemo工程", version = "1.0.0", dependencies = {ModuleConstants.MODULE_BASE, CommonModule.MODULE_MODULE, FileModule.MODULE_MODULE, SecondModule.MODULE_MODULE/**服务提供方的模块定义*/ } )…

    2024年2月20日
    1.6K00
  • Oinone项目引入Nacos作为配置中心

    Oinone项目引入nacos作为配置中心 Oinone项目配置默认读取的项目中yml文件(application-xxx.yml), 实际项目中有可能要求项目的配置放到Nacos配置中心中; Oinone默认引入的nacos-client-1.4.1,低于1.4.1的版本不支持认证配置;1.4.1的客户端版本支持Nacos服务端1.x的和2.x的版本; 一、项目中增加依赖 项目主pom引入依赖(最新版平台已默认引入), Nacos版本要求1.4.1以上,低版本不支持认证配置 <dependency> <groupId>com.alibaba.cloud</groupId> <artifactId>spring-cloud-starter-alibaba-nacos-config</artifactId> <version>2021.1</version> </dependency> <dependency> <groupId>com.alibaba.nacos</groupId> <artifactId>nacos-client</artifactId> <version>1.4.1</version> </dependency> 项目的boot工程的pom引入依赖(最新版平台已默认引入) <dependency> <groupId>com.alibaba.cloud</groupId> <artifactId>spring-cloud-starter-alibaba-nacos-config</artifactId> </dependency> <dependency> <groupId>com.alibaba.nacos</groupId> <artifactId>nacos-client</artifactId> </dependency> 二、项目工程bootstrap配置 bootstrap.yml文件的配置修改为: spring: application: name: hr-simple # 替换为实际服务名 profiles: active: wx # 指定 profile cloud: config: enabled: false nacos: discovery: enabled: false config: server-addr: 127.0.0.1:8848 enabled: true # namespace: # 如果使用 public 命名空间,建议省略此行 # namespace: your-custom-namespace-id # 如果使用自定义命名空间,填写其 ID group: DEFAULT_GROUP # prefix: # 通常省略,使用默认的 spring.application.name file-extension: yaml # 推荐使用 yaml,而不是 yml (虽然通常兼容) timeout: 5000 #【可选】修改为和nacos一致即可(如果服务端未开启可以不用配置) # username: wangxian # password: wangxian 三、Naocs服务端配置 在Nacos服务端的对应的namespace(5a8b3710-a9a2-4f7c-932f-50f326cb1ccf)下增加配置,把原本配置在代码中的(application-xxx.yml)配置到Nacos中

    2024年2月28日
    2.6K00

Leave a Reply

Please Login to Comment