
1.5 Oinone与行业对比

随着企业数字化转型的推进,软件公司获得了许多机会。尽管竞争日趋激烈,但由于需求旺盛,各种模式仍在不断涌现。因此,当前市场上存在各种各样的数字化转型解决方案,围绕企业的各个方面展开。每种解决方案都有其优点和缺点。本文将从定位、技术和产品等方面简单比较,帮助您从不同的视角了解Oinone的差异。

1.4.1 整体视角对比

一、与对标公司Odoo的对比

Odoo Oinone
定位 一站式全业务链管理平台:赋能企业信息化升级 一站式低代码商业支撑平台:赋能企业数字化升级
需求变化 关注单一企业的管理、流程、效率的提升 关注企业价值链的网络竞争,围绕外部协同、运营、数据、商业展开
技术更替 关注稳定、安全、功能丰富度 除了稳定、安全、功能丰富度以外,更强调需求响应速度、用户体验、系统承载极限与弹性扩展、智能化

表1-1 Oinone与对标公司Odoo的对比

二、与国内低代码或无代码公司对比

低代码或无代码公司 Oinone
定位 低代码开发工具:提供各类系统模版,基于模版快速搭建和个性化配置。但系统模版无法再升级 平台型SaaS:提供各类系统产品,产品安装后客户可以根据需求进行个性化调整,同时产品永远在线可升级
场景差异 只能支持企业内部人员使用,以完成部门级边缘系统为主,一般多为没有专业软件厂商支撑和强临时性特性 从内外部协同的商业场景出发,关注企业核心业务场景,适应【企业业务在线化后,所有的业务变化与创新都需要通过系统来触达上下游】的时代背景,以敏捷响应业务的变化与创新为目标
技术代差 单表支撑100万数据已是业内天花板 支撑单模型数据过亿,无单点瓶颈。封装互联网架构并且做到单体与分布式的灵活部署,为不同大小公司提供不同技术支撑

表1-2 Oinone与国内低代码/无代码公司对比

1.4.2 从技术角度对比

我们不会与其他无代码平台进行比较,因为它们不能解决业务复杂性的问题。相反,我们将重点介绍三种不同的低代码平台模式(如下图1-8所示)。

第一种模式是最基础的低代码平台,也被称为代码生成器。它通过预定义应用程序模板和必要的配置生成代码,简化了工程搭建并提供了一些基础逻辑。虽然在信息化时代内部流程标准化方面较为适合,但在数字化时代外部协同业务在线的情况下就不那么合适了。因为这种模式不能减少研发难度和提高效率,也无法体现敏捷迭代快速创新的优势。

第二种模式是经典的低代码平台,以元数据为基础,以模型为驱动。当无法满足需要时,通过特定方式将代码以插件的形式注入平台,作为低代码平台的内置逻辑,供设计器使用。它的优点在于降低了研发门槛,当无法满足需求时才需要编写代码。它可以实现企业内部的复杂流程和复杂逻辑,但其性能和工程管理存在局限性。性能问题使其不适合处理互联网化的在线业务,而工程管理问题则使其不适合处理快速变化的业务。这也是许多研发人员反对低代码的核心原因之一,因为研发人员变成了辅助角色,而软件工程是一门需要技术能力的学科,让没有技术能力的人主导是违反常理的。对于软件产品公司来说,产品需要迭代规划,需要多人协作,需要工程化管理。

第三种模式是oinone提出的基于互联网架构的低代码平台,它采用低无一体的设计。首先,oinone屏蔽了互联网架构带来的复杂性。其次,同样以元数据为基础,以模型为驱动,但是元数据的生成方式有两种:一种是使用无代码设计器(与经典低代码相同),另一种是通过代码来描述元数据。通过使用代码来描述元数据,可以无缝地与代码衔接,并在不改变研发习惯的情况下降低门槛、提高效率,并进行工程化管理。

最后总结来说:低无一体不仅仅是指两种模式的结合,还包括两种模式的融合应用方式。具体来说,这种融合应用方式可以分为两种情况:

  1. 当开发核心产品时,主要采用低代码开发,无代码设计器作为辅助。这种方式可以提高开发效率和代码质量,同时保证产品的快速迭代和升级。

  2. 当需要满足个性化或非产品支持的需求时,主要采用无代码设计器,低代码作为辅助。这种方式可以快速地满足客户需求,并且避免对产品的核心代码产生影响。

简单来说,低代码模式适用于产品的迭代升级,而无代码设计器则适用于满足个性化和非产品支撑的额外需求。低代码和无代码模式在整个软件生命周期中都有各自的价值,在不同场景下可以相互融合,发挥最大的优势。
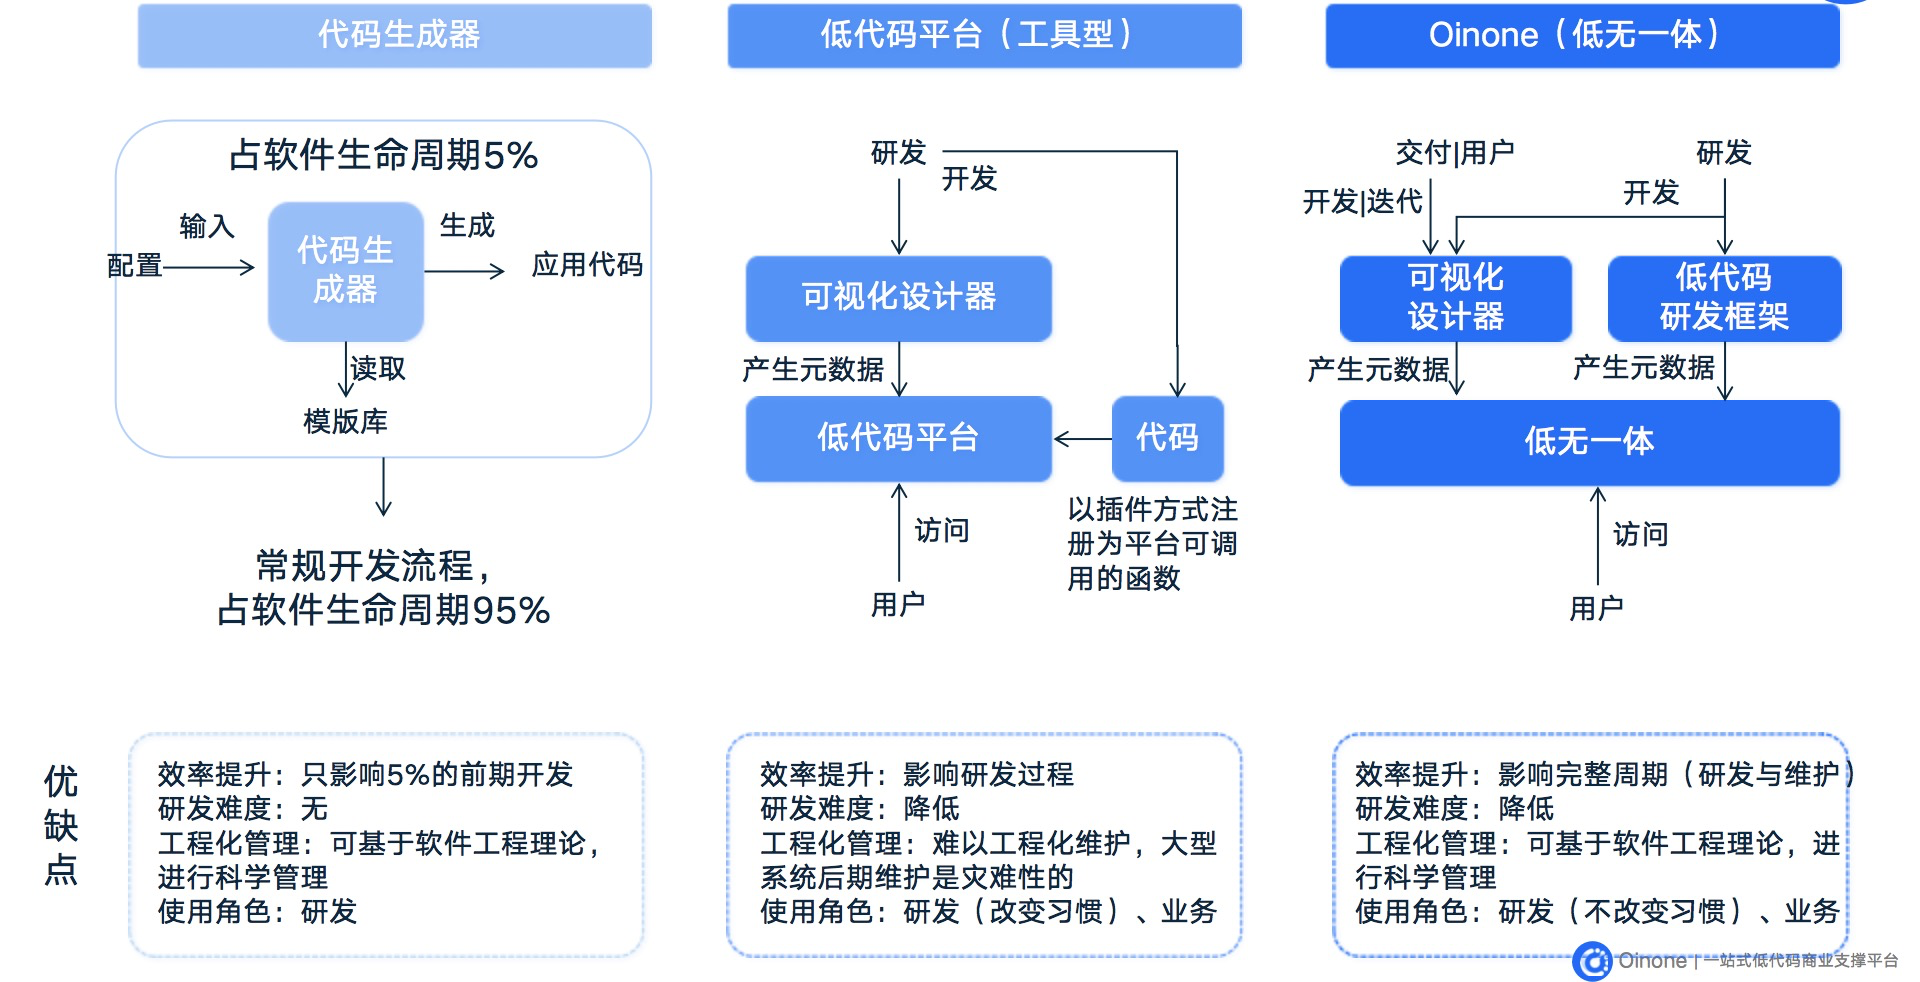
image.png

图1-8 代码生成器、低代码平台与Oinone的优缺点对比

1.4.3 从产品角度对比

产品上的对比,从客户、场景满足度、再次销售三个方面来做简易的对比

一、Oinone vs 数字化软件服务商

客户 满足度 销售
Oinone 一站式商业智能软件,更高性价比、用户体验客户范围:5000万~5亿、5亿~100亿、标杆:100亿~1000亿、1000亿以上 满足企业核心业务需求,并联合伙伴一起满足企业所有需求,无需集成提供统一工作台、数据接口、底层协议,无论基于Oinone的开源框架还是增加其他应用都有很好的扩展性 支持OP+SaaS两种模式,收费方式不同:OP按买断方式进行,SaaS按效果付费跟账号数无关新的模块进行二次销售
数字化软件服务商 针对成熟的大型企业需投入巨大资源和成本客户范围:100亿~1000亿、1000亿以上 满足企业部分需求,无法输出技术标准,无法解决多供应商一起开发的问题,只能通过集成实现对接 OP模式进行销售,通过设置权限来进行来实现二次销售或无法进行二次销售

表1-3 Oinone vs 数字化软件服务商

二、Oinone vs 低代码或无代码行业

客户 满足度 销售
Oinone 一站式商业智能软件客户范围:5000万~5亿、5亿~100亿、标杆:100亿~1000亿、1000亿以上 从外部商业场景出发,强业务场景驱动,符合企业从信息化管理到业务创新的数字化转变的趋势。提供统一工作台、数据接口、底层协议,无论基于oinone的开源框架还是增加其他应用都有很好的扩展性 支持OP+SaaS两种模式,收费方式不同:OP按买断方式进行,SaaS按效果付费跟账号数无关新的模块进行二次销售
低代码或无代码公司 针对小微企业内部信息化管理诉求,以表单流程为主客户范围:5亿以下 满足企业部门级信息化的适应性需求,无法满足企业核心业务管理与业务创新诉求 按应用模块进行收费,新的模块进行二次销售

表1-4 Oinone vs 低代码或无代码行业

三、Oinone vs 国外对标公司Odoo

客户 满足度 销售
Oinone 一站式商业智能软件客户范围:5000万~5亿、5亿~100亿、标杆:100亿~1000亿、1000亿以上 从外部商业场景出发,强业务场景驱动,符合企业从信息化管理到业务创新的数字化转变的趋势。基线产品覆盖:采购、营销、服务、销售、交易等企业商业领域。主要涉及行业:零售品牌。其他领域或行业靠合作伙伴共建方式进行 支持OP+SaaS两种模式,收费方式不同:OP按买断方式进行,SaaS按效果付费跟账号数无关新的模块进行二次销售
Odoo 一站式企业管理软件客户范围:5000万~5亿、5亿~100亿、标杆:100亿~1000亿、1000亿以上 从企业内部管理需求出发,逐渐拥有互联网相关应用组件,但还是属于强内部管理、弱外部场景。基线产品覆盖:业务财务一体化、人财务、进销存。主要涉及行业:建造业。其他领域或行业靠合作伙伴共建方式进行 支持OP+SaaS两种模式,收费方式相同:按用户数+应用模块进行收费新的模块进行二次销售

表1-5 Oinone vs 国外对标公司Odoo

Oinone社区 作者:史, 昂原创文章,如若转载,请注明出处:https://doc.oinone.top/oio4/9214.html

访问Oinone官网:https://www.oinone.top获取数式Oinone低代码应用平台体验

Like (0)
史, 昂's avatar史, 昂数式管理员
Previous 2024年5月23日
Next 2024年5月23日

相关推荐

  • 组件属性

    1. 通用属性 介绍组件和其属性之前,先介绍一些大部分组件通用支持的一些基础属性。 1.2 标题 标题是字段在当前页面的展示名称,标题默认为字段名称,可以修改。 1.2 占位提示 在未填写内容时,输入框或选择框内的浅色提示文字,仅用于提示,不会影响字段的值。 1.3 描述说明 一个字段的描述信息,通常用于说明当前字段的范围、注意事项等。描述说明大部分在组件的下方显示,特殊的是,分组的描述说明在标题的左侧。 1.4 默认值 创建数据时,有些字段大概率都是相同值,可设置默认值,减少添加人员的操作步骤,提高录入数据效率。 1.5 只读 设为只读时,字段可见,但不可编辑。 除了只读和非只读的对立选项,也可以设置条件只读,在设置的条件下才只读,条件不符合则非只读。 1.6 禁用 设为禁用时,字段可见,但不可编辑。 除了禁用和非禁用的对立选项,也可以设置条件禁用,在设置的条件下才禁用,条件不符合则非禁用。 1.7 隐藏 设为隐藏时,字段不可见,也不可编辑。但是在页面设计时,隐藏的组件也会展示,效果如下图。 除了隐藏和非隐藏的对立选项,也可以设置条件隐藏,在设置的条件下才隐藏,条件不符合则非隐藏。 1.8 必填 控制字段在当前页面是否必填,若设置为必填则在标题前会有红色的*作为标识。除了必填和非必填的对立选项,也可以设置条件必填,在设置的条件下才必填,条件不符合则非必填。 1.9 标题排列方式 字段的标题可以自定义横向排列还是纵向排列。每个字段组件都支持设置,设置后之间互不影响。除了组件支持自定义,表单、分组、选项卡也可以设置排列方式,对于这种布局容器类组件,设置后会将其容器内的所有组件的标题排列方式都改为所设置的值。 1.10 宽度 定义在页面中的宽度:占整行的比例,一般可选项有1/4、1/3、1/2、2/3、3/4、1。 其中1/2表示占当前行的一半;1表示占当前行一整行;以此类推。部分组件特殊,如富文本仅支持宽度为1,即占一整行。 2. 分组 分组是一个布局类组件,类似一个容器,可以把业务含义相近的内容放在这个分组容器内。 2.1 属性 2.1.1 标题 分组可以定义一个标题名称,标题显示在分组左上角,可以不设置标题。 2.1.2 描述说明 分组的描述说明显示在分组标题右侧。 2.1.3 标题排列方式 分组中的标题排列方式属性并不是控制分组的标题,而是控制分组内组件的标题。设置后对分组内的所有组件生效。 3. 选项卡 选项卡是一个布局类组件,类似一个容器,每个选项卡可以添加多个选项页,可以把业务含义相近的内容放在选项卡的选项页容器内。 3.1 选项卡属性 3.1.1 选项页排列方式 选中选项卡,可选择选项卡中的选项页排列方式:水平排列、竖直排列。默认是水平排列,效果如下图。 3.1.2 标题排列方式 选项卡中的标题排列方式控制选项卡内组件的标题。设置后对选项卡内的所有组件生效。 3.2 选项页属性 3.2.1 标题 选中选项页,显示选项页的属性设置,选项卡中的每个选项页支持设置标题。 3.2.2 标题排列方式 选项页中的标题排列方式控制选项页内组件的标题。设置后对选项页内的所有组件生效。同一个选项卡,不同选项页之间的标题排列方式可以不同。 4. 单行文本 单行文本输入框,常用于记录名称、身份证号或其他普通的文字内容。 4.1 创建字段 单行文本仅支持创建「文本」业务类型的字段,填写规则、内容和模型设计器端创建字段一致。 4.2 表单属性 4.2.1 通用属性 在表单中,单行文本可以设置一些通用的属性:标题、占位提示、描述说明、默认值、只读、隐藏、禁用、必填、标题排列方式、宽度。 4.2.2 文本类型 文本类型选项为文本或密码。若设置为文本,输入时内容是可见的;若设置为密码,输入时是不可见的密码形态,如下图: 4.2.3 最小/大长度 设置输入框输入内容的长度,输入框会根据设置的值进行校验。 最大长度默认为创建字段时填写的长度,且设置的最大长度不可以大于字段的长度 最小长度默认为空,为空则为不限制最小长度 4.2.4 输入格式 设置输入格式为网址或者身份证时,会进行格式的校验 无:默认为无,不会校验内容 网址:进行网址校验 身份证:进行身份证号校验,设置后,需要输入正确的身份证号 4.2.5 显示计数器 当需要用户关注输入内容长度时,可以开启显示计数器,在输入时会实时显示当前内容的长度。 4.2.6 显示清除按钮 若开启了清除按钮,则在输入框有内容时,点击清除按钮一键清除已有内容 5. 多行文本 多行文本输入框,常用于记录字数较多的文字,如意见、复杂备注等。 5.1 创建字段 多行文本仅支持创建「多行文本」业务类型的字段,填写规则、内容和模型设计器端创建字段一致。 5.2 表单属性 5.2.1 通用属性 在表单中,单行文本可以设置一些通用的属性:标题、占位提示、描述说明、默认值、只读、隐藏、禁用、必填、标题排列方式、宽度。 5.2.2 最小/大长度 设置输入框输入内容的长度,输入框会根据设置的值进行校验。 -最大长度默认为创建字段时填写的长度,且设置的最大长度不可以大于字段的长度 -最小长度默认为空,为空则为不限制最小长度 5.2.3 显示计数器 当需要用户关注输入内容长度时,可以开启显示计数器,在输入时会实时显示当前内容的长度。 5.2.5 显示清除按钮 若开启了清除按钮,则在输入框有内容时,点击清除按钮一键清除已有内容 6. 整数 整数输入框,常用于输入整数的天数、数量等,如果会出现小数,请使用小数组件。 6.1 创建字段 整数仅支持创建「整数」业务类型的字段,填写规则、内容和模型设计器端创建字段一致。 6.2 表单属性 6.2.1 通用属性 在表单中,整数可以设置一些通用的属性:标题、占位提示、描述说明、默认值、只读、隐藏、禁用、必填、标题排列方式、宽度。 6.2.2 最小/大值 设置整数输入框输入内容的最值,输入框会根据设置的最值进行校验。 最大值可设置的范围根据字段填写的长度转换,如设置长度为3,则最大值最大不可以超过999 截图 6.2.3 显示千分位 数字过长时,不便于查看,可开启显示千分位。 7. 小数 小数输入框,常用于输入金额、单价等,会出现小数的数值。 7.1 创建字段 小数仅支持创建「浮点型」业务类型的字段,填写规则、内容和模型设计器端创建字段一致。 7.2 表单属性 7.2.1 通用属性 在表单中,小数可以设置一些通用的属性:标题、占位提示、描述说明、默认值、只读、隐藏、禁用、必填、标题排列方式、宽度。 7.2.2 最小/大值 设置小数输入框输入内容的最值,输入框会根据设置的最值进行校验。 最大值可设置的范围根据字段填写的长度转换,如设置长度为3,则最大值最大不可以超过999 7.2.3 保留小数位数 支持设置小数的保留位数,设置后在页面中输入内容时,将进行校验 可设置的保留小数位数不可大于该字段的精度,如字段精度为2,则组件属性中的小数位数最大只能为2; 7.2.4 显示千分位 数字过长时,不便于查看,可开启显示千分位。 8. 下拉单选 从多个选项中下拉选择一个数据,作为数据值。选项可以是关联模型的数据,也可以是数据字典或布尔型开关。 8.1 创建字段 下拉单选支持创建三种业务类型的字段,分别是:多对一、布尔型、数据字典。 多对一:创建字段时需要选择关联的模型,关联模型的数据将作为下拉选项; 布尔型:下拉选项默认只有是、否; 数据字典:创建字段时需要选择数据字典,其数据字典项将作为下拉选项 8.2 表单属性 8.2.1 通用属性 在表单中,下拉单选可以设置一些通用的属性:标题、占位提示、描述说明、只读、隐藏、禁用、必填、标题排列方式、宽度。 8.2.2 选项类型…

    2024年6月20日
    1.8K00
  • 5.3 基础支撑之用户与客户域

    一、三户概念 三户由来 介绍下经典的三户模型,它是电信运营支持系统的基础。三户模型即客户、用户和帐户,来源于etom的模型。这三者之间的关系应该是一个相互关联但又是独立的三个实体,这种关联只是一个归属和映射的关系,而三个实体本身是相互独立的,分别是体现完全不同的几个域的信息,客户是体现了社会域的信息,用户体现了业务域的信息,帐户体现的是资金域的信息。 客户:它是个社会化的概念,一个自然人或一个法人 用户:它是客户使用运营商开发的一个产品以及基于该产品之上的增值业务时,产生的一个实体。如果说一个客户使用了多个产品,那么一个客户就会对应好几个用户(即产品) 账户:它的概念起源于金融业,只是一个客户在运营商存放资金的实体,目的是为选择的产品付费 Oinone的三户 在原三户模型中【用户】是购买关系产生的产品与客户关系的服务实例,在互联网发展中用户的概念发生了非常大的变化,【用户】概念变成了:使用者,是指使用电脑或网络服务的人,通常拥有一个用户账号,并以用户名识别。而且新概念在互联网强调用户数的大背景下已经被普遍介绍,再去强调电信行业的用户概念就会吃力不讨好。而且不管是企业应用领域和互联网领域,原用户概念都显得过于复杂和没有必要。也就有了特色的oinone的三户模型: 客户:它是个社会化的概念,一个自然人或一个法人 用户:使用者,是指使用电脑或网络服务的人,通常拥有一个用户账号,并以用户名识别 账户:它的概念起源于金融业,只是一个客户在运营商存放资金的实体,目的是为选择的产品付费 二、Oinone的客户与用户 三户模型是构建上层应用的基础支撑能力,任何业务行为都跟这里两个实体脱不了干系。以客户为中心建立商业关系与商业行为主体,以用户为中心构建一致体验与操作行为主体。在底层设计上二者相互独立并无关联,由上层应用自行作关联绑定,往往在登陆时在Session的处理逻辑中会根据【用户】去找到对应一个或多个【商业(主体)客户】,Session的实现可以参考4.1.20【框架之Session】一文。 图5-3-1 Oinone的客户与用户 客户设计说明 PamirsPartner作为商业关系与商业行为的主体,派生了两个子类PamirsCompany与PamirsPerson分别对应:公司(法人)客户、自然人客户 公司(法人)客户PamirsCompany对应多个组织部门PamirsDepartment,公司(法人)客户PamirsCompany对应多个员工PamirsEmployee 部门PamirsDepartment对应一个公司(法人)客户PamirsCompany,对应多个员工PamirsEmployee 员工PamirsEmployee对应多个部门PamirsDepartment,对应一个或多个公司(法人)客户PamirsCompany,其中有一个主的 用户设计说明 PamirsUser作为一致体验与操作行为主体,本身绑定登陆账号,并且可以关联多个三方登陆账户PamirsUserThirdParty 客户与用户如何关联(举例) 例子设计: 新建demo系统的PetComany和PetEmployee,用PetEmployee去关联用户。 当用户登陆时,根据用户Id找到PetEmployee,在根据PetEmployee找到PetComany,把PetComany放到Session中去 修改PetShop模型关联一个PamirsPartner,PamirsPartner的信息从Session取。 Step1 pamirs-demo-api工程增加依赖,并且DemoModule增加对BusinessModule的依赖 <dependency> <groupId>pro.shushi.pamirs.core</groupId> <artifactId>pamirs-business-api</artifactId> </dependency> 图5-3-2 pamirs-demo-api工程增加依赖 在DemoModule类中通过@Module.dependencies中增加BusinessModule.MODULE_MODULE @Module( dependencies = { BusinessModule.MODULE_MODULE} ) 图5-3-3 声明对BusinessModule的依赖 Step2 新建PetComany和PetEmployee,以及对应的服务 package pro.shushi.pamirs.demo.api.model; import pro.shushi.pamirs.business.api.model.PamirsEmployee; import pro.shushi.pamirs.meta.annotation.Field; import pro.shushi.pamirs.meta.annotation.Model; import pro.shushi.pamirs.user.api.model.PamirsUser; @Model.model(PetEmployee.MODEL_MODEL) @Model(displayName = "宠物公司员工",labelFields = "name") public class PetEmployee extends PamirsEmployee { public static final String MODEL_MODEL="demo.PetEmployee"; @Field(displayName = "用户") private PamirsUser user; } 图5-3-4 新建PetEmployee package pro.shushi.pamirs.demo.api.model; import pro.shushi.pamirs.business.api.entity.PamirsCompany; import pro.shushi.pamirs.meta.annotation.Field; import pro.shushi.pamirs.meta.annotation.Model; @Model.model(PetCompany.MODEL_MODEL) @Model(displayName = "宠物公司",labelFields = "name") public class PetCompany extends PamirsCompany { public static final String MODEL_MODEL="demo.PetCompany"; @Field.Text @Field(displayName = "简介") private String introductoin; } 图5-3-5 新建PetComany package pro.shushi.pamirs.demo.api.service; import pro.shushi.pamirs.demo.api.model.PetEmployee; import pro.shushi.pamirs.meta.annotation.Fun; import pro.shushi.pamirs.meta.annotation.Function; @Fun(PetEmployeeQueryService.FUN_NAMESPACE) public interface PetEmployeeQueryService { String FUN_NAMESPACE ="demo.PetEmployeeQueryService"; @Function PetEmployee queryByUserId(Long userId); } 图5-3-6 新建PetEmployee对应服务 package pro.shushi.pamirs.demo.core.service; import org.springframework.stereotype.Component; import pro.shushi.pamirs.demo.api.model.PetEmployee; import pro.shushi.pamirs.demo.api.service.PetEmployeeQueryService; import pro.shushi.pamirs.framework.connectors.data.sql.query.QueryWrapper; import pro.shushi.pamirs.meta.annotation.Fun; import pro.shushi.pamirs.meta.annotation.Function; @Fun(PetEmployeeQueryService.FUN_NAMESPACE) @Component public class PetEmployeeQueryServiceImpl implements PetEmployeeQueryService { @Override @Function public PetEmployee queryByUserId(Long userId) { if(userId==null){ return null; } QueryWrapper<PetEmployee> queryWrapper = new QueryWrapper<PetEmployee>().from(PetEmployee.MODEL_MODEL).eq("user_id", userId); return…

    2024年5月23日
    1.9K00
  • 3.5.5.1 设计器数据导出

    简介 通过调用导出接口,将设计器的设计数据与运动数据打包导出到文件中。 提供了download/export两类接口。 export 导出到OSS。导出的文件会上传到文件服务,通过返回的url下载导出文件。 请求示例: mutation { uiDesignerExportReqMutation { export( data: { module: "gemini_core", fileName: "meta", moduleBasics: true } ) { jsonUrl } } } 响应示例: { "data": { "uiDesignerExportReqMutation": { "export": { "jsonUrl": "https://xxx/meta.json" } } }, "errors": [], "extensions": {} } download 直接返回导出数据。适用于通过浏览器直接下载文件。 请求示例: mutation { uiDesignerExportReqMutation { download( data: { module: "gemini_core", fileName: "meta", moduleBasics: true } ) { jsonUrl } } } 如何构造url protocol :// hostname[:port] / path ? query=URLEncode(GraphQL) 例: http://127.0.0.1:8080/pamirs/base?query=mutation%20%7B%0A%09uiDesignerExportReqMutation%20%7B%0A%09%09download(%0A%09%09%09data%3A%20%7B%20module%3A%20%22gemini_core%22%2C%20fileName%3A%20%22meta%22%2C%20moduleBasics%3A%20true%20%7D%0A%09%09)%20%7B%0A%09%09%09jsonUrl%0A%09%09%7D%0A%09%7D%0A%7D 在浏览器中访问构造后的url,可直接下载文件 接口列表 模型设计器 指定模块导出 query { modelMetaDataExporterQuery { export/download(query: { module: "模块编码" }) { module url } } } module参数:指定导出的模块编码 url返回结果:export方式导出的文件url 页面设计器 导出页面 指定模块导出 mmutation { uiDesignerExportReqMutation { download/export( data: { module: "gemini_core", fileName: "meta", moduleBasics: false } ) { jsonUrl } } } module参数:模块编码 fileName参数:指定生成的json文件名称 moduleBasics参数:指定是否只导出模块基础数据,如果为true,只导出内置布局、模块菜单、菜单关联的动作。 如果为false,还会导出模块内的所有页面,以及页面关联的动作元数据、页面设计数据 等等。 默认值为false。 指定菜单导出 mutation { uiDesignerExportReqMutation { download/export( data: { menu: { name: "uiMenu0000000000048001" } fileName: "meta" relationViews: true } ) { jsonUrl } } } menu参数:菜单对象,指定菜单的name。只会导出该菜单及其绑定页面,不会递归查询子菜单 fileName参数:指定生成的json文件名称 relationViews参数:指定是否导出关联页面,默认为false,只导出菜单关联的页面。如果为true,还会导出该页面通过跳转动作关联的自定义页面。 指定页面导出 mutation { uiDesignerExportReqMutation { download/export( data: { view: { name: "xx_TABLE_0000000000119001" model: "ui.designer.TestUiDesigner" } fileName: "meta" relationViews: true } ) { jsonUrl } } }…

    Oinone 7天入门到精通 2024年5月23日
    2.1K00
  • 3.5.7.6 自定义字段

    字段是什么 字段的基本概念 定义:字段通常指的是数据的一个单独项,它可以是一个文本框、下拉菜单、复选框等,用于在用户界面上收集或展示数据。 用途:在表单中,字段用于收集用户输入;在表格或列表中,字段用于显示数据。 类型:字段可以有不同的类型,如文本、数字、日期等,这些类型通常由数据模型定义。 Oinone框架中的字段 在Oinone框架中,字段的设计和实现遵循以下原则: 后端模型驱动:前端的字段直接由后端的数据模型决定。这意味着后端定义了哪些数据应该展示,以及如何展示。 减少前后端联调:由于字段的定义和行为是由后端控制的,前后端的联调需求大大减少。前端开发者主要关注于如何呈现这些字段,而后端则负责数据的逻辑和结构。 灵活性与规范性:虽然Oinone推荐所有场景都遵循后端模型驱动字段的原则,以保持前后端的一致性和减少沟通成本,但它也为高度定制化的前端页面提供了灵活性。 元数据使用:Oinone可能还使用元数据来进一步定义字段的行为,例如它们是否可见、如何验证用户输入等。 结合前后端 在使用Oinone时,理解前后端如何合作来定义和展示字段是很重要的。这种方法不仅提高了开发效率,而且有助于确保数据的一致性和应用程序的可维护性。同时,对于那些需要特定定制或特殊处理的场景,开发团队能够灵活地适应这些需求,在遵守总体架构原则的同时进行一些特定的调整和优化。 作用场景 在Oinone框架中,字段扮演着连接后端数据模型和前端用户界面的重要角色。其作用场景包括但不限于以下几点: 业务组件的核心: Oinone集成了AntdDesignVue的全部UI组件,将它们转化为业务组件。这些业务组件以字段的形式存在,使得前端开发变得简单高效。开发人员可以直接使用这些现成的业务组件来构建用户界面,大大减少了开发工作量。 无代码开发支持: 字段的设计使得Oinone支持无代码开发。开发者可以通过拖拉拽的方式在前端快速构建界面,而后端模型的定义直接决定了这些界面的生成。这种模式简化了传统的前端开发流程,提升了开发效率。 个性化定制: 虽然标准的UI组件可以满足大部分需求,但复杂多变的业务场景往往需要更多个性化的处理。在Oinone中,开发者可以根据具体业务需求和公司的UI指南,定义专门针对特定行业或客户的定制化字段和组件。 与无代码平台的结合: Oinone允许将个性化的字段和组件与无代码平台相结合。这意味着即使在进行个性化定制时,也能保持使用无代码工具的便利性,实现更灵活、更高效的前端开发。 适应多维度业务需求: 由于字段在Oinone中的灵活性和可定制性,它们能够适应多维度的业务需求,无论是从UI设计、用户体验还是业务逻辑的角度,字段都能提供合适的解决方案 自定义字段 示例工程目录 以下是需关注的工程目录示例,main.ts更新导入./field: 图3-5-7-24 自定义字段工程目录示例 示例代码 创建自定义字段组件: 使用Vue框架创建一个新的组件(例如 CustomStringFieldVue),并定义其模板、脚本和样式。 在模板中定义字段的HTML结构。 在脚本中使用 defineComponent 来定义Vue组件。 字段类的定义: 导入必要的模块,如 FormFieldWidget, ModelFieldType, SPI, ViewType 等。 使用 @SPI.ClassFactory 装饰器来注册自定义字段。 在类内部初始化并设置组件。 SPI注册参数解释: viewType: 指定视图类型,如表单视图或搜索视图。 widget: 可以指定组件名称。 ttype: 字段的业务类型,例如字符串、数字等。 multi: 指明字段是否支持多值。 model: 定义字段所属的模型。 viewName: 指定视图名称。 name: 定义所属字段的名称。 import {FormFieldWidget, ModelFieldType, SPI, ViewType} from '@kunlun/dependencies'; import CustomStringFieldVue from './CustomStringField.vue'; @SPI.ClassFactory( FormFieldWidget.Token({ viewType: [ViewType.Form, ViewType.Search], ttype: ModelFieldType.String }) ) export class CustomStringField extends FormFieldWidget { public initialize(props) { super.initialize(props); this.setComponent(CustomStringFieldVue); return this; } } 图3-5-7-24 自定义字段组件(TS)示例 <template> <div class="custom-string-filed-wrapper"> 字段组件 </div> </template> <script lang="ts"> import { defineComponent } from 'vue' export default defineComponent({ inheritAttrs: false, name: 'CustomStringFieldVue' }) </script> <style lang="scss"> .custom-string-filed-wrapper { } </style> 图3-5-7-24 自定义字段组件(Vue)示例 效果 图3-5-7-24 自定义字段效果示例

    2024年5月23日
    2.5K00
  • 4.1.17 框架之网关协议-GraphQL协议

    GraphQL 是一个用于 API 的查询语言,是一个使用基于类型系统来执行查询的服务端运行时(类型系统由你的数据定义)。GraphQL 并没有和任何特定数据库或者存储引擎绑定,而是依靠你现有的代码和数据支撑。 一个 GraphQL 服务是通过定义类型和类型上的字段来创建的,然后给每个类型上的每个字段提供解析函数。例如,一个 GraphQL 服务告诉我们当前登录用户是 me,这个用户的名称可能像这样: type Query { me: User } type User { id: ID name: String } 图4-1-17-1 GraphQL定义类型和字段示意 一并的还有每个类型上字段的解析函数: function Query_me(request) { return request.auth.user; } function User_name(user) { return user.getName(); } 图4-1-17-2 每个类型上字段的解析函数示意 一旦一个 GraphQL 服务运行起来(通常在 web 服务的一个 URL 上),它就能接收 GraphQL 查询,并验证和执行。接收到的查询首先会被检查确保它只引用了已定义的类型和字段,然后运行指定的解析函数来生成结果。 例如这个查询: { me { name } } 图4-1-17-3 GraphQL查询请求示意 会产生这样的JSON结果: { "me": { "name": "Luke Skywalker" } } 图4-1-17-4 GraphQL查询结果示意 了解更多 https://graphql.cn/learn/

    Oinone 7天入门到精通 2024年5月23日
    1.5K00

Leave a Reply

Please Login to Comment

Comments(2)

  • xinf's avatar
    xinf 2024年6月14日 am9:52

    bug反馈:采用无一体设计 -> 采用低无一体设计