
页面设计

1. 功能说明

页面设计时界面设计器中「页面」模块的设计入口,在这个界面,进行页面的设置、搭建、设计、排版。

主要分为顶部操作栏、左侧工具栏、中部设计画布区、右侧属性面板。
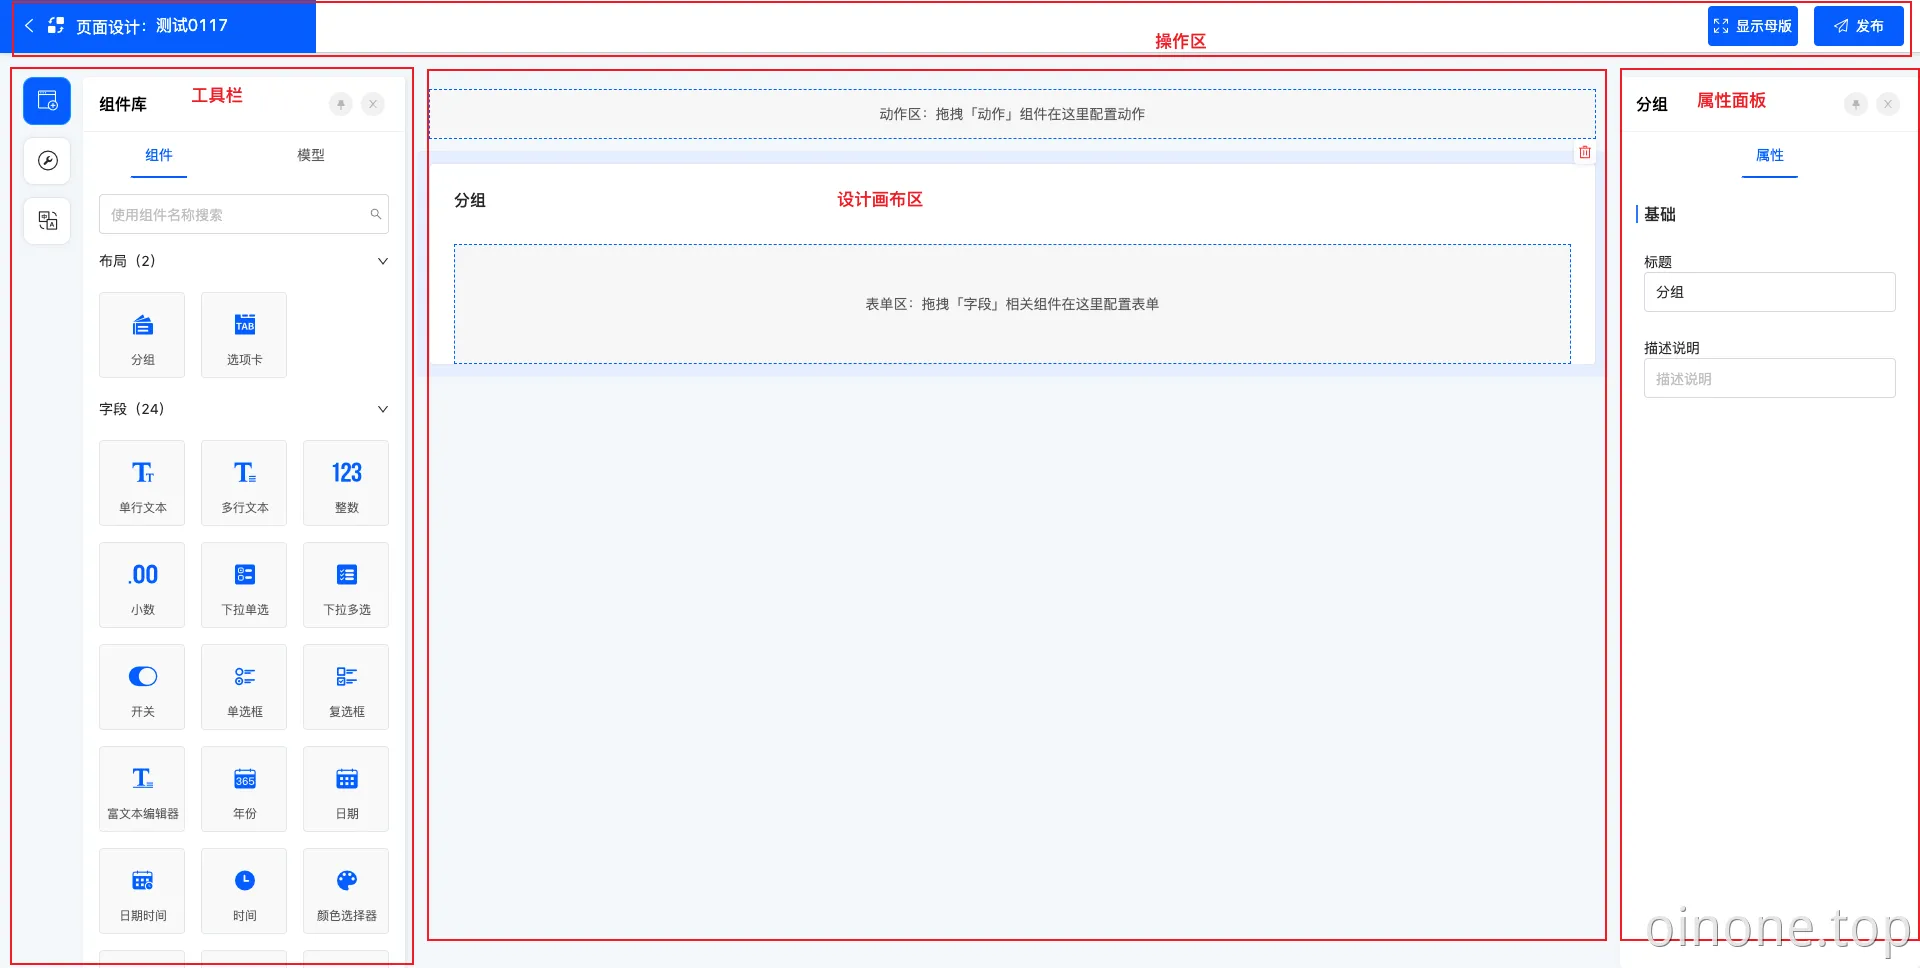
image.png

2. 操作栏

进入页面设计,顶部显示了页面的标题,以及返回、发布等操作。

2.1 发布

页面设计完成后,点击「发布」运行页面生效。若不点击发布,页面也有自动保存的功能,但在发布前,自动保存也等同于草稿,不会正式生效。

发布时如果有属性不符合校验规则(必填的属性未填、输入的内容校验不通过),会发布失败,相应的字段会特殊标记,需要查看并修改属性。
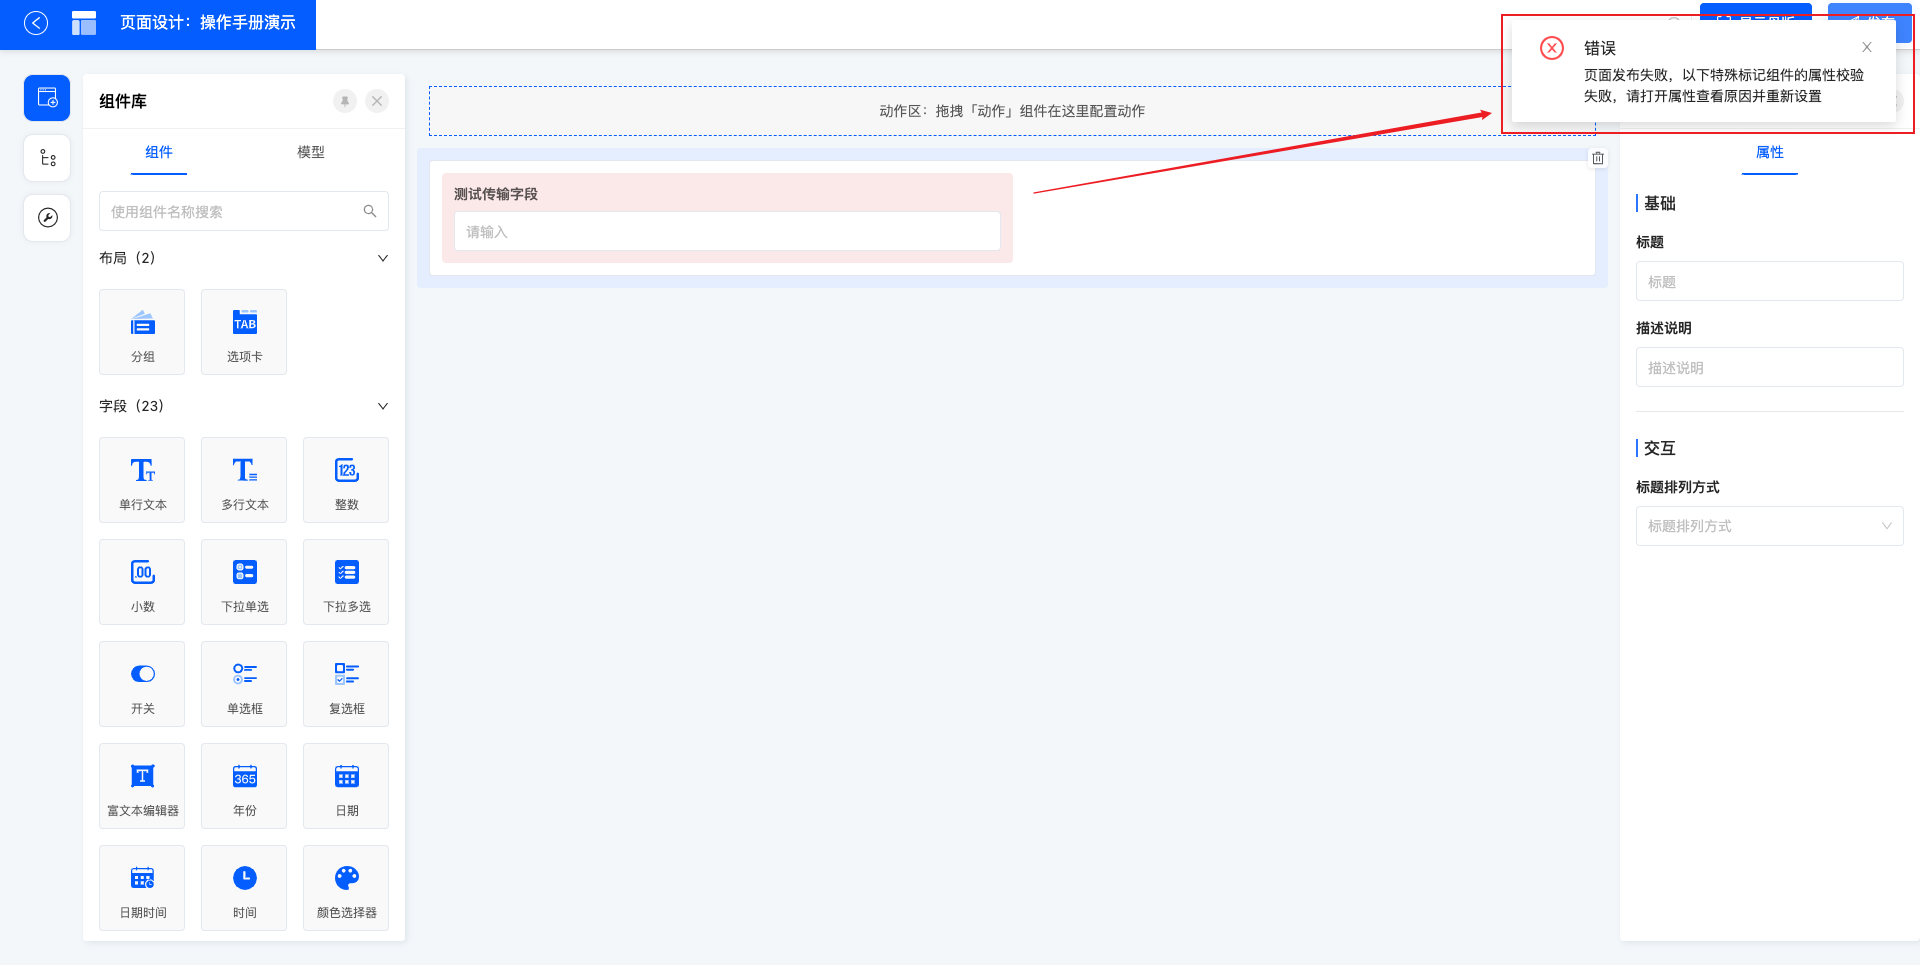
image.png

2.2 显示/隐藏母版

进入页面设计时默认不展示母版,可以手动操作显示母版

3. 工具栏

左侧的工具栏中包括组件库、页面设置等模块。

3.1 组件库

组件库中包含组件和模型,组件是当前设计器支持的所有组件,模型是页面所在模型下的所有字段和动作。

3.1.1 组件

组件中展示了系统支持的所有组件。包含

1)布局类组件,如分组、选项卡等,使用布局组件可以将页面进字段分类、分页;

2)字段类组件,如单行文本、整数、日期等等,使用字段类组件时都会在模型下对应创建一个字段;

3)动作类组件,如跳转动作、提交动作、链接动作等。
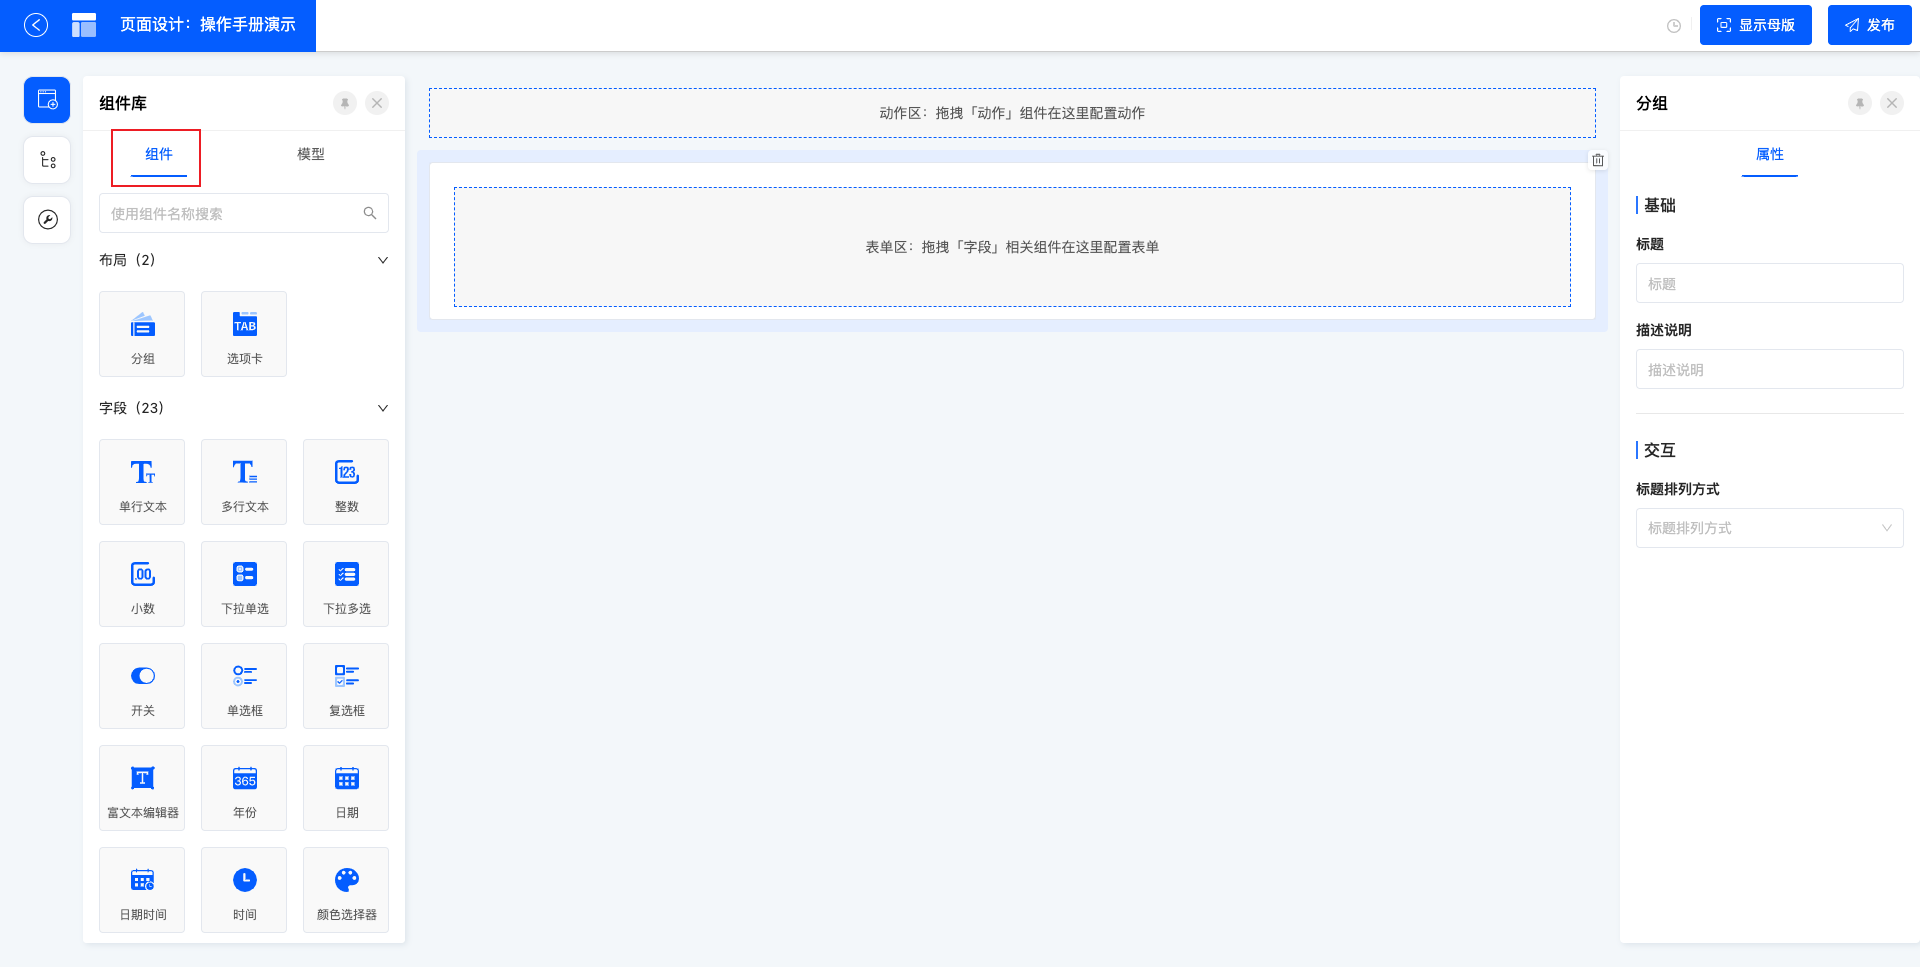
image.png

3.1.2 模型

组件库顶部,由组件可切换为模型:模型选项下,会展示当前模型的所有字段,以及系统默认动作。可以直接拖拽字段至设计画布中,会应用形成某个组件,可对组件进行多样的属性设置,优化交互。
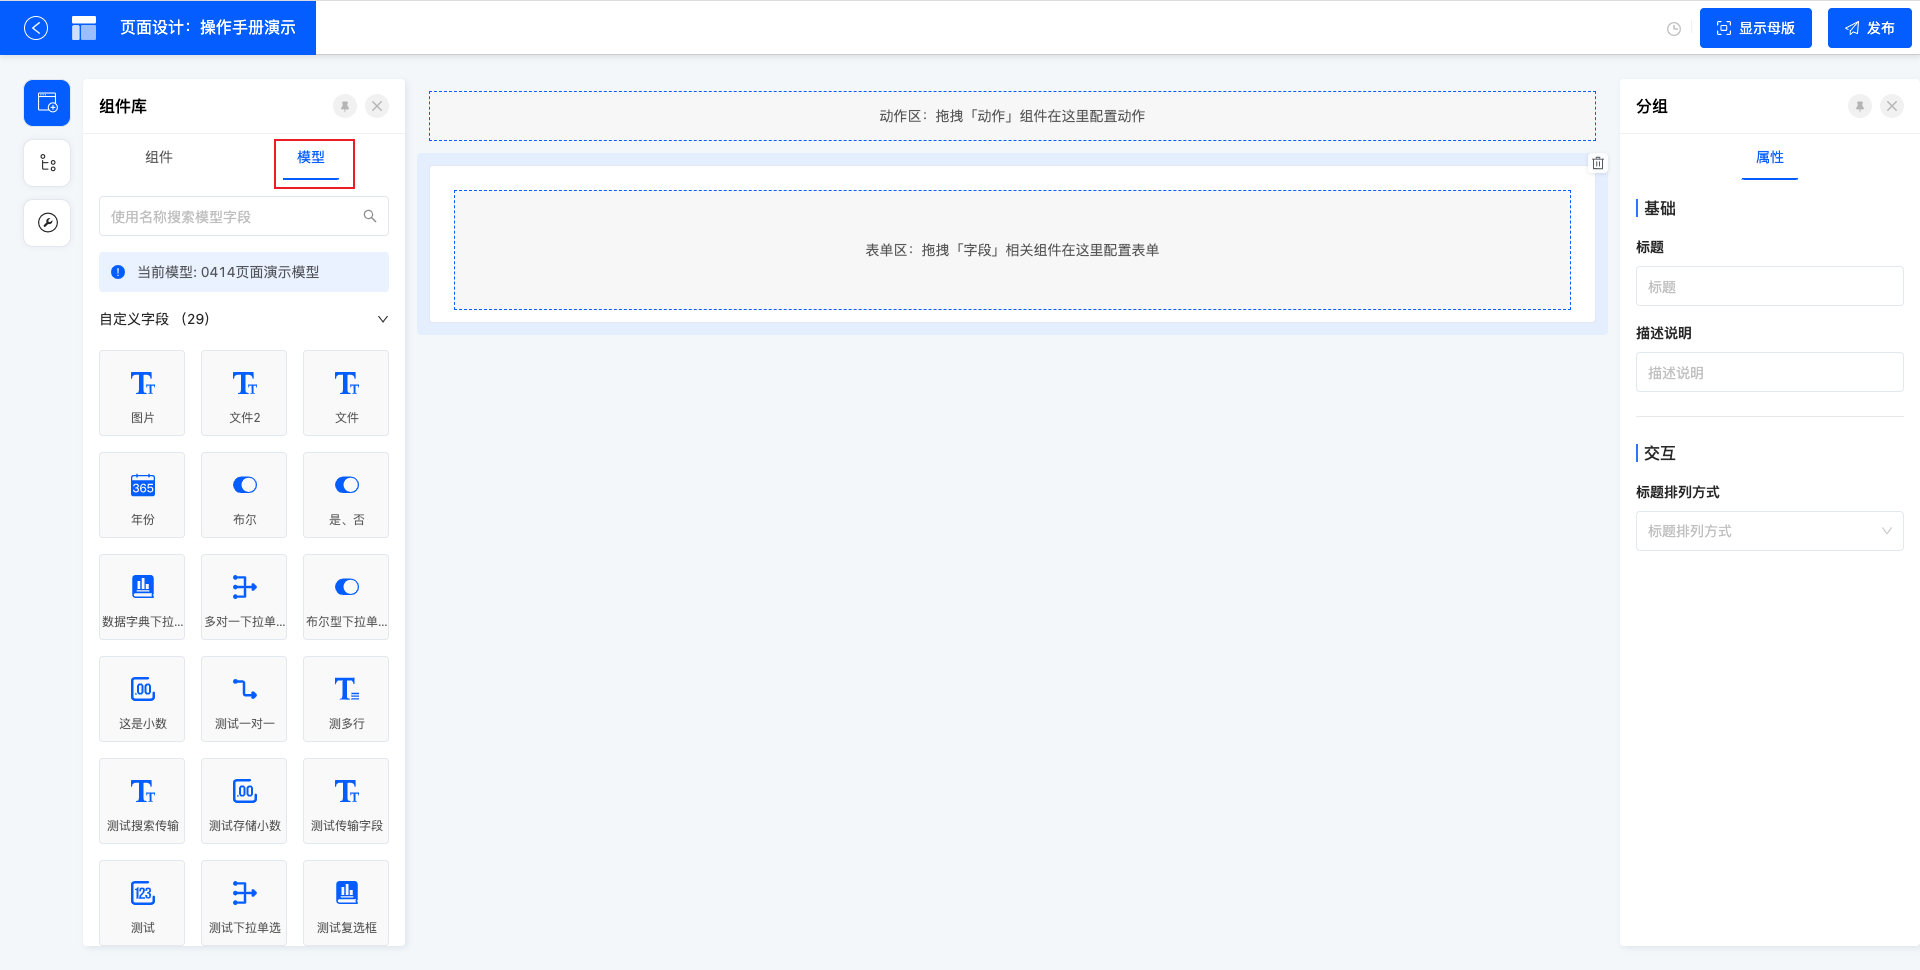
image.png

3.1.2 组件和模型有什么区别

1展示内容维度不同

组件中展示的内容是组件信息,如分组、选项卡、单行文本、文件上传等;模型中展示的是模型下已有的所有字段。

2使用功能不同

组件中的组件使用前需要在模型中创建一个字段,当然,创建好的字段也会存在于模型中;模型中的字段可直接使用,并且使用时会在设计画布中对应生成个默认组件。

3使用场景不同

如果模型中已经存在目标字段,应直接选择从模型中拖拽字段;如果模型中没有需要的字段,可以在页面中增加一个组件,实际上也是在新增一个字段。

3.2 页面设置

页面设置中可以修改当前页面的标题、分组、页面描述,同时也是给页面上传缩略图的唯一入口。
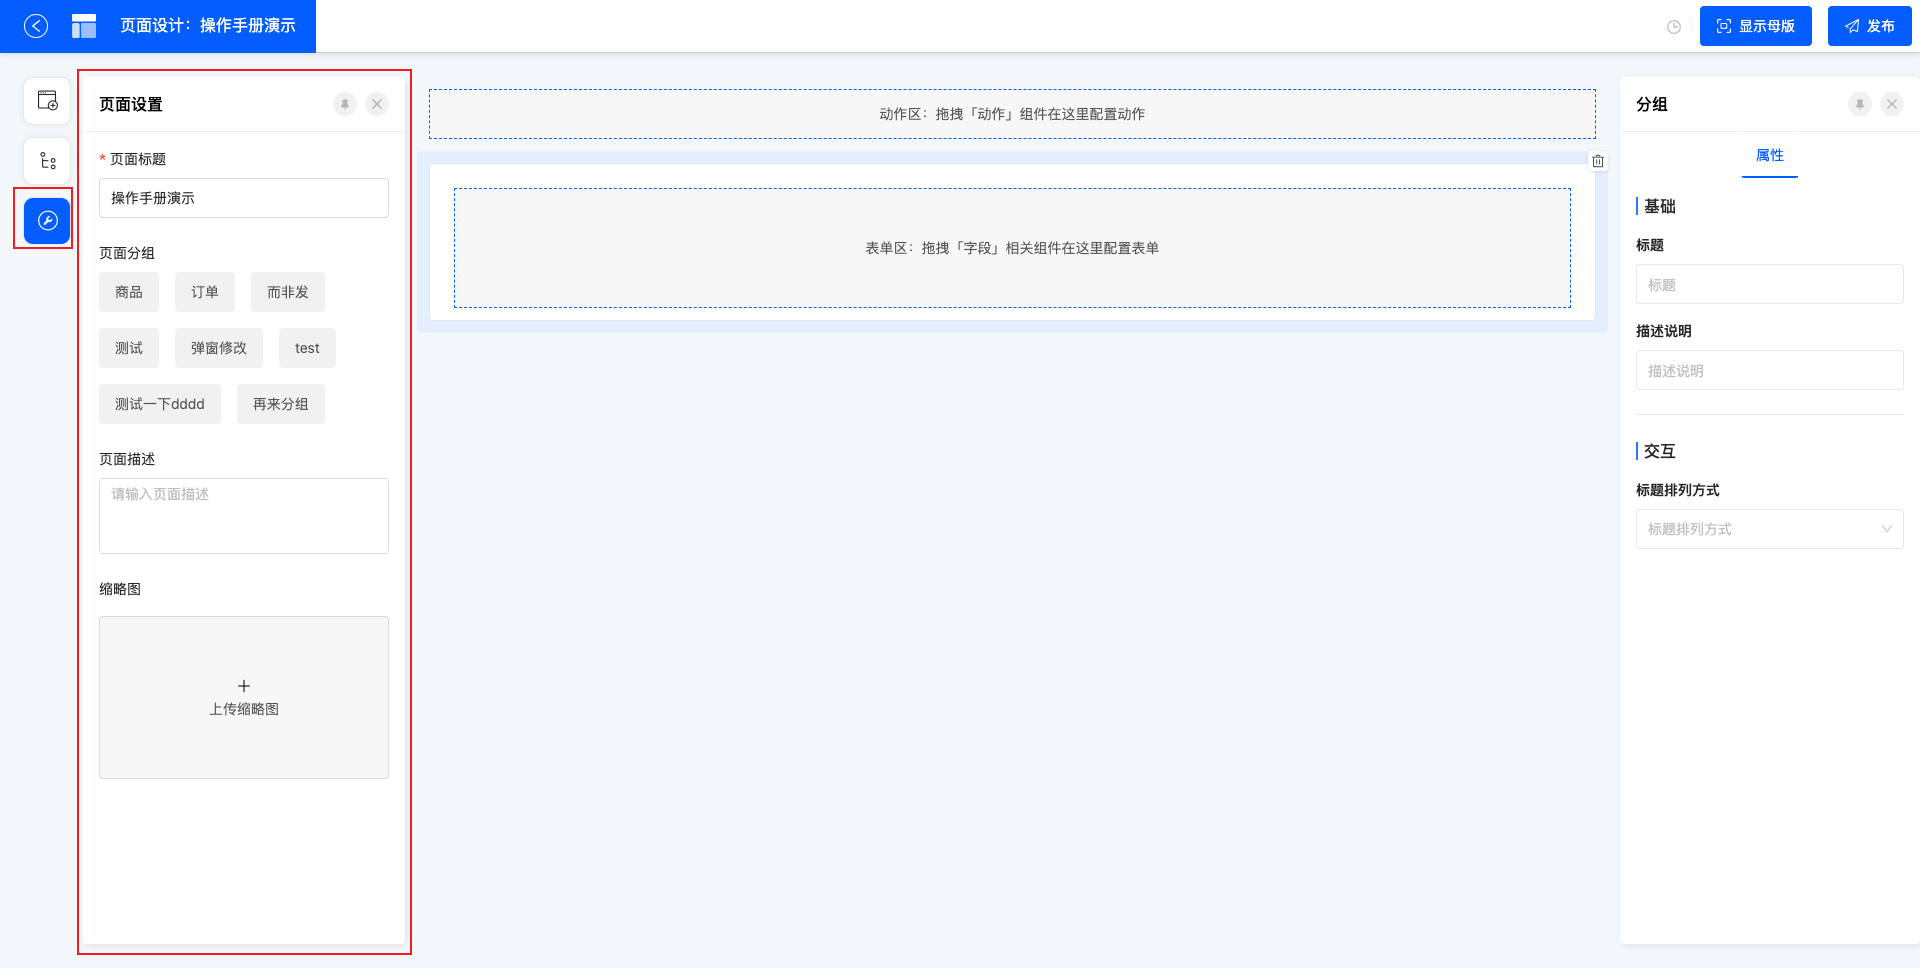
image.png

4. 设计画布

将组件或字段拖拽至设计画布区,会生成样式。点击组件,右侧可对其进行设置,大部分属性可实时在画布中展示效果。

5. 属性面板

右侧属性面板抽屉中可以设置属性或查看字段信息,通过不同的属性配置化实现组件的多样化。
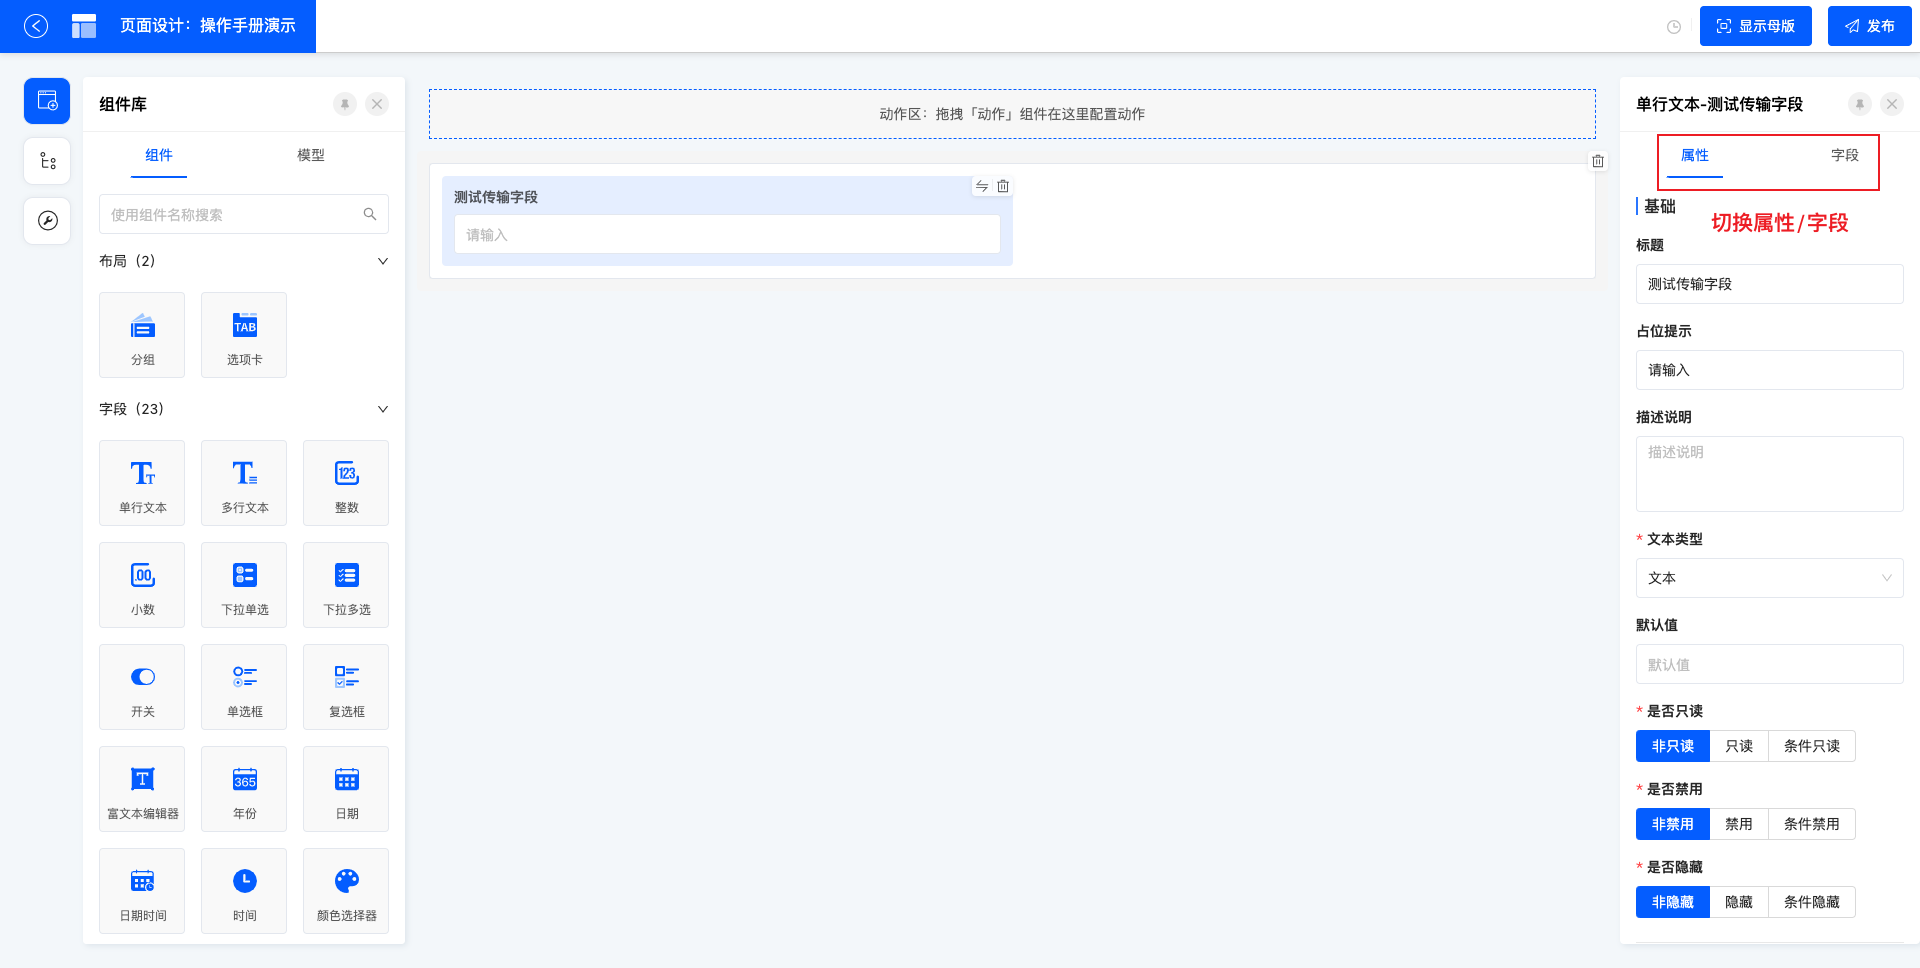
image.png

5.1 属性

属性中包括基本信息(如标题、占位提示、描述说明等)、校验信息(如是否必填、长度校验等)、交互信息(如排序方式、是否展示计数器等)
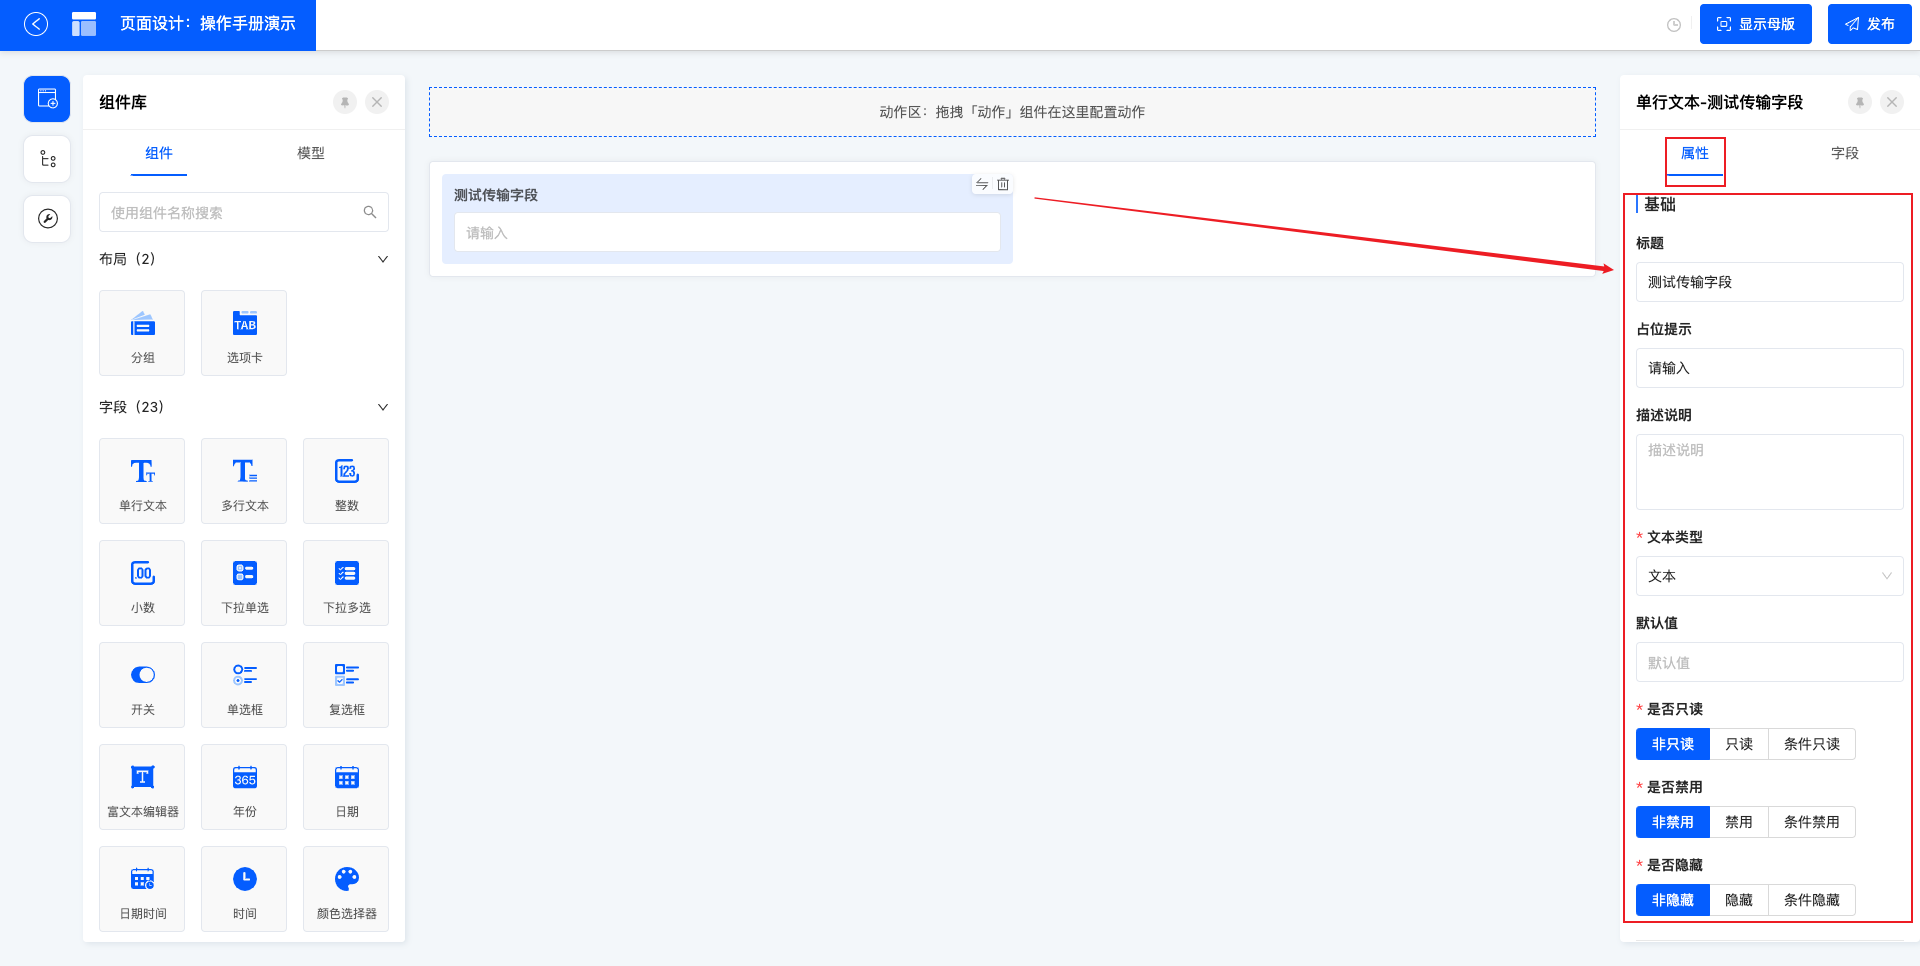
image.png

5.2 字段

首次从组件中拖拽,会先展示字段信息,并且是需要先创建一个字段,字段创建成功后,再次切换字段选项,只读展示当前组件所对应的字段基本信息。同理,如果是直接从字段中拖拽,字段选项中,只读展示当前字段基本信息。
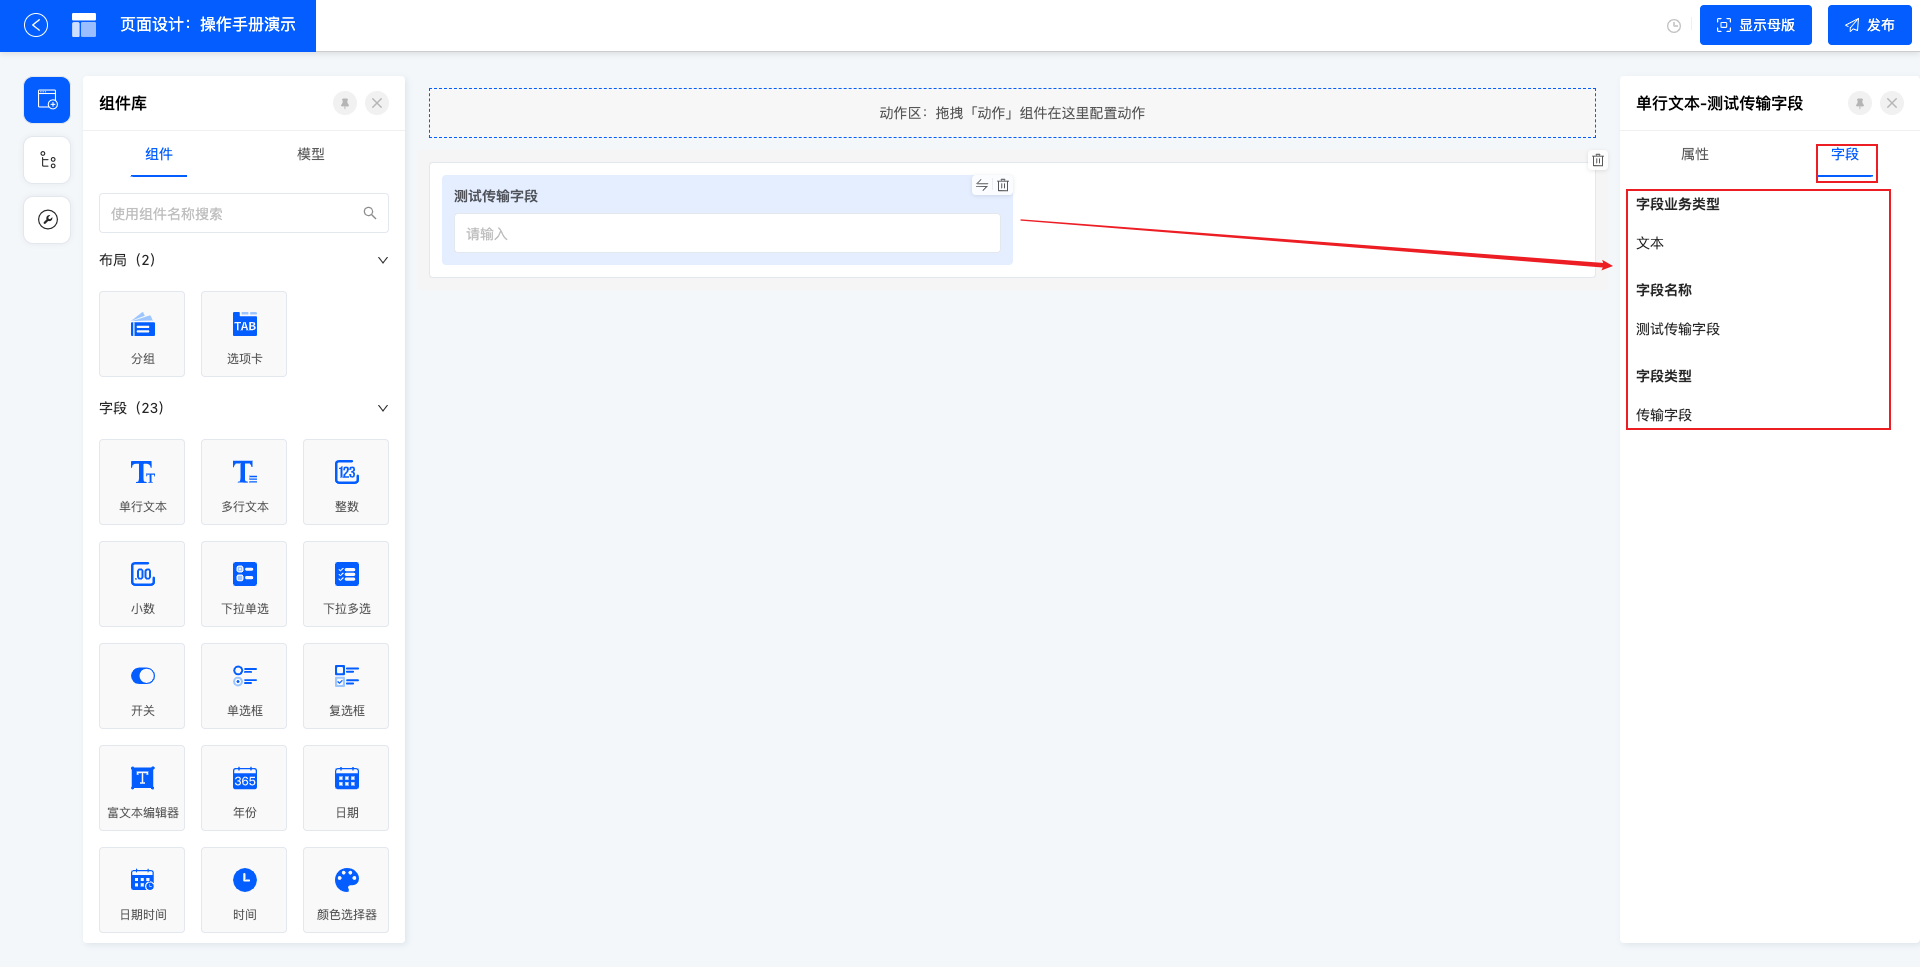
image.png

Oinone社区 作者:史, 昂原创文章,如若转载,请注明出处:https://doc.oinone.top/oio4/9405.html

访问Oinone官网:https://www.oinone.top获取数式Oinone低代码应用平台体验

Like (0)
史, 昂's avatar史, 昂数式管理员
Previous 2024年6月20日
Next 2024年6月20日

相关推荐

  • 2.4.1 Oinone独特性之单体与分布式的灵活切换

    企业数字化转型需要处理分布式带来的复杂性和成本问题。尽管这些问题令人望而却步,但分布式架构对于大部分企业仍然是必须的选择。如果一个低代码平台缺乏分布式能力,那么它的性能就无法满足客户的要求。相比之下,Oinone平台通过对部署的创新(如图2-6所示),成功实现了分布式架构的支持,而且能够按照客户的业务发展需求,灵活选择不同的部署模式,同时节约企业成本,提升创新效率。这一创新是Oinone平台与其他低代码平台的重要区别,能够满足客户预期发展并兼顾成本效益。 图2-6 传统部署方式VS Oinone部署方式 实现原理 要实现灵活部署的特性,必须满足两个基本要求: 开发过程中不需要过多关注分布式技术,就像开发单体应用一样简单。代码在运行时应该能够根据模块是否在运行容器中,来决定路由走本地还是远程。这样可以大大减少研发人员的工作量和技术复杂度。 研发与部署要分离,即"开发单体应用一样开发分布式应用,而部署形式由后期决定"。为此,我们的工程结构支持多种启动模式,并逐一介绍了针对不同场景的工程结构类型(如下图2-7所示)。这样可以让客户在后期根据业务发展情况和需求,选择最适合的部署模式,从而达到灵活部署的目的。 图2-7 Oinone工程结构梳理 在整个工程结构上,我们秉承了Spring Boot的规范,不会改变大家的工程习惯。而Oinone的部署能力则可以让我们更灵活地应对各种情况。现在,我们来逐一介绍几种常规的工程结构以及它们适用的场景: 单模块工程结构(常规操作) a. 这是非常标准的Spring Boot工程,适用于简单的应用场景开发以及入门学习。 多模块工程结构(常规操作) a. 这是非常标准的多Spring Boot工程,可以实现分布式独立启动,适用于常规的分布式应用场景开发。 多模块工程结构-独立boot工程模式 a. 这种工程结构在多模块工程的基础上,通过独立的boot工程来支撑多部署方式。适用于中大型分布式应用场景开发。 b. 然而,随着工程越来越多,我们也会面临一些问题: ⅰ研发:环境准备非常困难,每个模块都要单独启动,研发调试跟踪困难。 ⅱ部署:分布式的高可靠性保证需要每个模块至少有两个部署节点,但在模块较多的情况下,起步成本非常高。同时,企业初期业务不稳定且规模较小,使用多模块工程的第二种模式会增加问题排查难度和成本。 c. 此时,Oinone的多模块工程下的独立boot工程模式部署就可以发挥其灵活性,让研发和业务起步阶段可以选择all-in-one模式,等到业务发展到一定规模的时候,只需要把线上部署模式切换成模块独立部署,而研发还可以保留all-in-one模式的优势。 d. 值得注意的是,分分合合的部署模式在传统互联网架构和低代码或无代码平台上都是有代价的,但是Oinone却可以灵活适配,只需要在boot工程的yml文件中写入需要加载的模块就可以解决。此处我们仅介绍多模块加载配置,选择性忽略其他无关配置,具体配置(如下图2-8所示)。 pamirs: boot: init: true sync: true modules: – base – resource – sequence – user – auth – web tenants: – pamirs 图2-8 Oinone yml配置图大型多场景工程结构-独立boot工程模式: a. 在多模块工程结构基础上的加强版,增加CDM层设计,让不同场景即保持数据统一,又保持逻辑独立。这种工程结构特别适用于大型企业软件开发,其中涉及到多个场景的情况,例如B端和C端的应用,或者跨不同业务线的应用,能够保证数据的一致性,同时也能够保持逻辑独立,避免不同场景间的代码冲突。 b. 这种工程结构是我们Oinone支撑“企业级软件生态”的核心,我们可以把场景A当作我们官方应用,场景B当作其他第三方伙伴应用。在这个工程结构下,我们的客户可以定制化开发自己的应用,同时我们也可以通过这种模式来支持我们的伙伴们进行开发,实现多方共赢。 c. 基于独立boot工程模式,我们同样对应多种部署模式应对不同情况,并统一管理所有伙伴应用。这种工程结构的优点是扩展性好,可以支持不同规模的应用,并且可以根据需要进行快速扩展或缩小规模,具有很高的灵活性。 基于标准产品的二开工程结构,是指基于标准产品进行二次开发,满足客户特定需求的工程结构。这种模式下,Oinone提供标准产品,客户可以根据自己的需求进行二次开发,实现定制化需求,同时可以利用我们的模块化开发特性,将每一个需求作为一个模块进行开发和管理。这种工程结构的优点是能够快速满足客户特定需求,同时也具有很好的可维护性和可扩展性,因为每个需求都是一个独立的模块,可以方便地进行维护和扩展。在下一篇“Oinone独特性之每一个需求都是一个模块”文章中有详细介绍。

    2024年5月23日
    2.7K00
  • 4.2.4 框架之网络请求-HttpClient

    oinone提供统一的网络请求底座,基于graphql二次封装 一、初始化 import { HttpClient } from '@kunlun/dependencies'; const http = HttpClient.getInstance(); http.setMiddleware() // 必须设置,请求回调。具体查看文章https://shushi.yuque.com/yqitvf/oinone/vwo80g http.setBaseURL() // 必须设置,后端请求的路径 图4-2-4-1 初始化代码示例 二、HttpClient详细介绍 获取实例 import { HttpClient } from '@kunlun/dependencies'; const http = HttpClient.getInstance(); 图4-2-4-2 获取实例 接口地址 import { HttpClient } from '@kunlun/dependencies'; const http = HttpClient.getInstance(); http.setBaseURL('接口地址'); http.getBaseURL(); // 获取接口地址 图4-2-4-3 接口地址 请求头 import { HttpClient } from '@kunlun/dependencies'; const http = HttpClient.getInstance(); http.setHeader({key: value}); 图4-2-4-4 请求头 variables import { HttpClient } from '@kunlun/dependencies'; const http = HttpClient.getInstance(); http.setExtendVariables((moduleName: string) => { return customFuntion(); }); 图4-2-4-5 variables 回调 import { HttpClient } from '@kunlun/dependencies'; const http = HttpClient.getInstance(); http.setMiddleware([middleware]); 图4-2-4-6 回调 业务使用-query private http = HttpClient.getInstance(); private getTestQuery = async () => { const query = `gql str`; const result = await this.http.query('module name', query); console.log(result) return result.data[`xx`]['xx']; // 返回的接口,打印出result对象层次返回 }; 图4-2-4-7 业务使用-query 业务使用-mutate private http = HttpClient.getInstance(); private getTestMutate = async () => { const mutation = `gql str`; const result = await this.http.mutate('module name', mutation); console.log(result) return result.data[`xx`]['xx']; // 返回的接口,打印出result对象层次返回 }; 图4-2-4-8 业务使用-mutate 三、如何使用HttpClient 初始化 在项目目录src/main.ts下初始化httpClient 初始化必须要做的事: 设置服务接口链接 设置接口请求回调 业务实战 前文说到自定义新增宠物表单,让我们在这个基础上加入我们的httpClient; 第一步新增service.ts 图4-2-4-8 新增service.ts service.ts import { HttpClient }…

    2024年5月23日
    2.5K00
  • 4.5 研发辅助

    这里都是一些提升研发效率的小工具

    Oinone 7天入门到精通 2024年5月23日
    1.7K00
  • 5.4 基础支撑之商业关系域

    PamirsPartner作为商业关系与商业行为的主体,那么PamirsPartner间的关系如何描述,本文将介绍两种常见的设计思路,从思维和实现两方面进行对比,给出oinone为啥选择关系设计模式的原因。 一、两种设计模式对比 设计模式思路介绍 角色设计模式思路介绍 从产品角度枚举所有商业角色,每个商业角色对应一个派生的商业主体,并把主体间的关系类型进行整理。 图5-4-1 角色设计模式 关系设计模式思路介绍 从产品角度枚举所有商业角色,每个商业角色对应一个派生的主体间商业关系 图5-4-2 关系设计模式 设计模式对应实现介绍 角色设计模式实现介绍 不单商业主体需要扩展,关系也要额外维护,可以是字段或是关系表。一般M2O和O2M字段维护,M2M关系表维护。 创建合同场景中甲方选择【商业主体A】,乙方必须是【商业主体A】有关联的经销商、分销商、零售商、供应商等,则在角色设计模式下就非常麻烦,因为关系都是独立维护的 图5-4-3 角色设计模式实现介绍 关系设计模式实现介绍 只需维护商业关系扩展 同时在设计上收敛了商业关系,统一管理应对不同场景都比较从容 图5-4-4 关系设计模式实现介绍 二、oinone商业关系的默认实现 首先oinone的商业关系选择关系设计模式 其次模型上采用多表继承模式,父模型上维护核心字段,子模型维护个性化字段。

    2024年5月23日
    2.4K00
  • 4.1.24 框架之分库分表

    随着数据库技术的发展如分区设计、分布式数据库等,业务层的分库分表的技术终将成老一辈程序员的回忆,谈笑间扯扯蛋既羡慕又自吹地说到“现在的研发真简单,连分库分表都不需要考虑了”。竟然这样为什么要写这篇文章呢?因为现今的数据库虽能解决大部分场景的数据量问题,但涉及核心业务数据真到过亿数据后性能加速降低,能给的方案都还有一定的局限性,或者说性价比不高。相对性价比比较高的分库分表,也会是现阶段一种不错的补充。言归正传oinone的分库分表方案是基于Sharding-JDBC的整合方案,所以大家得先具备一点Sharding-JDBC的知识。 一、分表(举例) 做分库分表前,大家要有一个明确注意的点就是分表字段的选择,它是非常重要的,与业务场景非常相关。在明确了分库分表字段以后,甚至在功能上都要做一些妥协。比如分库分表字段在查询管理中做为查询条件是必须带上的,不然效率只会更低。 Step1 新建ShardingModel模型 ShardingModel模型是用于分表测试的模型,我们选定userId作为分表字段。分表字段不允许更新,所以这里更新策略设置类永不更新,并在设置了在页面修改的时候为readonly package pro.shushi.pamirs.demo.api.model; import pro.shushi.pamirs.boot.base.ux.annotation.field.UxWidget; import pro.shushi.pamirs.boot.base.ux.annotation.view.UxForm; import pro.shushi.pamirs.meta.annotation.Field; import pro.shushi.pamirs.meta.annotation.Model; import pro.shushi.pamirs.meta.enmu.FieldStrategyEnum; @Model.model(ShardingModel.MODEL_MODEL) @Model(displayName = "分表模型",summary="分表模型",labelFields ={"name"} ) public class ShardingModel extends AbstractDemoIdModel { public static final String MODEL_MODEL="demo.ShardingModel"; @Field(displayName = "名称") private String name; @Field(displayName = "用户id",summary = "分表字段",immutable=true/* 不可修改 **/) @UxForm.FieldWidget(@UxWidget(readonly = "scene == 'redirectUpdatePage'"/* 在编辑页面只读 **/ )) @Field.Advanced(updateStrategy = FieldStrategyEnum.NEVER) private Long userId; } 图4-1-24-1 新建ShardingModel模型 Step2 配置分表策略 配置ShardingModel模型走分库分表的数据源pamirsSharding 为pamirsSharding配置数据源以及sharding规则 a. pamirs.sharding.define用于oinone的数据库表创建用 b. pamirs.sharding.rule用于分表规则配置 pamirs: load: sessionMode: true framework: system: system-ds-key: base system-models: – base.WorkerNode data: default-ds-key: pamirs ds-map: base: base modelDsMap: "[demo.ShardingModel]": pamirsSharding #配置模型对应的库 图4-1-24-2 指定模型对应数据源 pamirs: sharding: define: data-sources: ds: pamirs pamirsSharding: pamirs #申明pamirsSharding库对应的pamirs数据源 models: "[trigger.PamirsSchedule]": tables: 0..13 "[demo.ShardingModel]": tables: 0..7 table-separator: _ rule: pamirsSharding: #配置pamirsSharding库的分库分表规则 actual-ds: – pamirs #申明pamirsSharding库对应的pamirs数据源 sharding-rules: # Configure sharding rule ,以下配置跟sharding-jdbc配置一致 – tables: demo_core_sharding_model: #demo_core_sharding_model表规则配置 actualDataNodes: pamirs.demo_core_sharding_model_${0..7} tableStrategy: standard: shardingColumn: user_id shardingAlgorithmName: table_inline shardingAlgorithms: table_inline: type: INLINE props: algorithm-expression: demo_core_sharding_model_${(Long.valueOf(user_id) % 8)} props: sql.show: true 图4-1-24-3 分库分表规则配置 Step3 配置测试入口 修改DemoMenus类增加一行代码,为测试提供入口 @UxMenu("分表模型")@UxRoute(ShardingModel.MODEL_MODEL) class ShardingModelMenu{} 图4-1-24-4 配置测试入口 Step4 重启看效果 自行尝试增删改查 观察数据库表与数据分布 图4-1-24-5 自行尝试增删改查 图4-1-24-6 观察数据库表与数据分布 二、分库分表(举例) Step1 新建ShardingModel2模型 ShardingModel2模型是用于分库分表测试的模型,我们选定userId作为分表字段。分库分表字段不允许更新,所以这里更新策略设置类永不更新,并在设置了在页面修改的时候为readonly package pro.shushi.pamirs.demo.api.model; import pro.shushi.pamirs.boot.base.ux.annotation.field.UxWidget; import pro.shushi.pamirs.boot.base.ux.annotation.view.UxForm; import…

    2024年5月23日
    1.6K00

Leave a Reply

Please Login to Comment