数据类

1.数据类

1.1 新增数据

新增数据节点可以为任意模型通过表达式新增数据,包含两种模式,「节点执行完即增加业务数据」功能下新增的数据也可以同步触发流程,相反「节点执行完不增加业务数据」则不会触发新增业务数据关联的流程,数据仅可用于后续流程使用。

流程增加的数据在节点执行时就生效。

1.2 更新数据

更新数据节点可以为任意模型通过表达式更新数据。

1.3 获取数据

当流程需要调用触发模型之外的模型中的数据时就需要使用获取数据的功能。

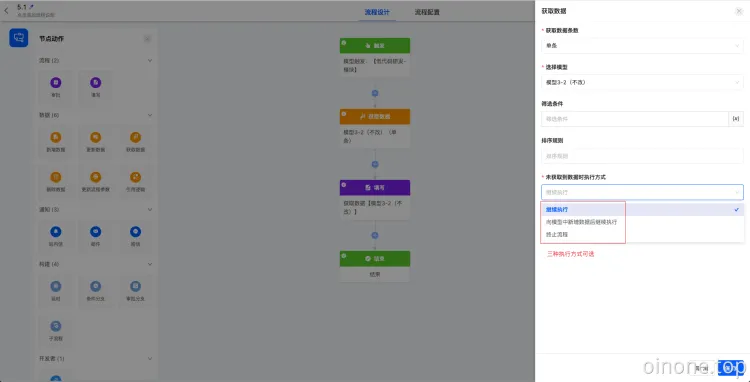
需要选择获取单条/多条数据,选择一个获取数据的模型,可以设置一些筛选项减少不必要的数据。最后需要设置未获取到数据时的执行方式。

  • 继续执行:跳过本次数据获取,继续执行流程。
  • 向模型中新增数据后继续执行:新增数据来供后续节点使用,新增数据同时存入数据库中。
  • 终止流程:终止流程将结束该流程,不管之后是否还有流程节点。

image.png

1.4 删除数据

删除数据节点可以将流程节点上面的模型数据从数据库中删除。

1.5 更新流程参数

可以将「流程配置」中的「流程参数」进行修改,仅有变更过的流程参数才能其他节点选中。

1.6 引用逻辑

可以在流程中使用模块自带的逻辑或使用低代码设计的逻辑。

Oinone社区 作者:史, 昂原创文章,如若转载,请注明出处:https://doc.oinone.top/oio4/9416.html

访问Oinone官网:https://www.oinone.top获取数式Oinone低代码应用平台体验

Like (0)
史, 昂's avatar史, 昂数式管理员
Previous 2024年5月23日 pm4:51
Next 2024年5月23日 pm4:56

相关推荐

  • 3.3.10 字段类型之关系描述的特殊场景

    在3.3.9【字段类型之关系与引用】一文中已经描述了各种关系字段的常规写法,还有一些特殊场景如:关系映射中存在常量,或者M2M中间表是大于两个字段构成。 举例说明关系字段-高级用法 场景描述 PetTalent模型增加talentType字段,PetItem与PetTalent的多对多关系增加talentType(达人类型),PetItemRelPetTalent 中间表维护petItemId、petTalentId以及talentType,PetDogItem和PetCatItem分别重写petTalents 字段,关系中增加常量描述。示意图如下 实际操作步骤: Step1 新增 TalentTypeEnum package pro.shushi.pamirs.demo.api.enumeration; import pro.shushi.pamirs.meta.annotation.Dict; import pro.shushi.pamirs.meta.common.enmu.BaseEnum; @Dict(dictionary = TalentTypeEnum.DICTIONARY,displayName = "达人类型") public class TalentTypeEnum extends BaseEnum<TalentTypeEnum,Integer> { public static final String DICTIONARY ="demo.TalentTypeEnum"; public final static TalentTypeEnum DOG =create("DOG",1,"狗达人","狗达人"); public final static TalentTypeEnum CAT =create("CAT",2,"猫达人","猫达人"); } Step2 PetTalent模型增加talentType字段 package pro.shushi.pamirs.demo.api.model; import pro.shushi.pamirs.demo.api.enumeration.TalentTypeEnum; import pro.shushi.pamirs.meta.annotation.Field; import pro.shushi.pamirs.meta.annotation.Model; @Model.model(PetTalent.MODEL_MODEL) @Model(displayName = "宠物达人",summary="宠物达人",labelFields ={"name"}) public class PetTalent extends AbstractDemoIdModel{ public static final String MODEL_MODEL="demo.PetTalent"; @Field(displayName = "达人") private String name; @Field(displayName = "达人类型") private TalentTypeEnum talentType; } Step3 修改PetItem的petTalents字段,在关系描述中增加talentType(达人类型) @Field.many2many(relationFields = {"petItemId"},referenceFields = {"petTalentId","talentType"},through = "PetItemRelPetTalent") @Field.Relation(relationFields = {"id"}, referenceFields = {"id","talentType"}) @Field(displayName = "推荐达人",summary = "推荐该商品的达人们") private List<PetTalent> petTalents; Step4 PetDogItem增加petTalents字段,重写父类PetItem的关系描述 talentType配置为常量,填入枚举的值 增加domain描述用户页面选择的时候自动过滤出特定类型的达人,RSQL用枚举的name @Field.many2many(relationFields = {"petItemId"},referenceFields = {"petTalentId","talentType"},through = "PetItemRelPetTalent") @Field.Relation(relationFields = {"id"}, referenceFields = {"id","talentType"}) @Field(displayName = "推荐达人",summary = "推荐该商品的达人们") private List<PetTalent> petTalents; Step5 PetCatItem增加petTalents字段,重写父类PetItem的关系描述 talentType配置为常量,填入枚举的值 增加domain描述用户页面选择的时候自动过滤出特定类型的达人,RSQL用枚举的name @Field(displayName = "推荐达人") @Field.many2many( through = "PetItemRelPetTalent", relationFields = {"petItemId"}, referenceFields = {"petTalentId","talentType"} ) @Field.Relation(relationFields = {"id"}, referenceFields = {"id", "#2#"}, domain = " talentType == CAT") private List<PetTalent> petTalents; Step6 清除中间表demo_core_pet_item_rel_pet_talent的数据记录 清除PetItem与PetTalent的多对多中间表demo_core_pet_item_rel_pet_talent的数据记录 Step7 重启看效果 修改达人记录,选择不同达人类型 PetItem、PetCatItem、PetDogItem不同的交互页面

    2024年5月23日
    1.9K00
  • 数据大屏

    1. 业务场景 数据大屏是利用相应的系统来分析数据,通过图形的形式为企业提供客观、直接的数据分析结果,让业务人员和企业决策者直观面对数据背后的信息,实时监测企业数据,给予更直观的决策场景体验,助力企业数字化运营升级。 2. 操作流程 1)进入数据可视化,进入数据大屏tab,维护分组信息; 2)在二级分组名称后点击“+”【添加数据大屏】,对数据大屏进行设计; 3)创建完成后可以【编辑】数据大屏; 4)数据大屏完善后,可以点击【发布】数据大屏,则数据大屏此时可以被显示器引用播放; 5)如果数据大屏有更新,则可以点击【更新发布】; 6)如果数据大屏数据不再可以公开使用,则需要通过【隐藏】功能将数据大屏的引用权限收起,但不影响已被使用的数据大屏; 7)隐藏后可以【取消隐藏】,数据大屏恢复隐藏前的状态和功能,可以被引用 。 3. 操作流程图解 3.1 创建分组 1)操作流程:创建分组 2)操作路径:数据可视化-数据大屏-创建分组 3)点击搜索框后的「+」创建一级分组,输入一级分组名称后,点击一级分组后的「+」创建二级分组,输入二级分组名称后,此时分组创建完成,可以在二级分组下创建数据大屏 3.2 编辑分组名称 1)操作流程:选择分组-编辑分组名称 2)操作路径:数据可视化-数据大屏-编辑分组名称 3)鼠标移动至需要修改的分组上,点击出现的「编辑图标」,可以修改分组名称,修改后分组名称实时更新 3.3 删除分组 1)操作流程:选择分组-删除分组 2)操作路径:数据可视化-数据大屏-删除分组 3)鼠标移动至需要删除的分组上,当分组下无报表时出现「删除图标」,可以点击图标后删除分组,删除一级分组时对应所有的二级分组也会被删除,删除后消失,只有分组下没有数据大屏的分组才能直接删除成功 3.4 创建数据大屏 1)操作流程:选择二级分组-创建数据大屏 2)操作路径:数据可视化-数据大屏-二级分组-创建数据大屏 3)鼠标移动至需要创建数据大屏的二级分组上,出现「+」,点击图标后=需要填写数据大屏标题 a数据大屏标题:最大支持20个字,支持汉字、数字、大小写字母、-;同个一级分组下不允许重复; 4)输入标题后进入设计页面 3.5 编辑数据大屏 1)操作流程:选择数据大屏-编辑数据大屏 2)操作路径:数据可视化-数据大屏-二级分组-数据大屏-编辑数据大屏 3)只能编辑未发布或者已发布但没有被隐藏的数据大屏,且存在三种编辑情况 a. 第一种:点击数据大屏标题后的编辑图标,仅能编辑数据大屏标题; b. 第二种:点击数据大屏中的数据大屏标题、备注后的编辑图标,可以直接编辑数据大屏标题; c. 第三种:点击【编辑】按钮,进入数据大屏设计页面,带出已有的组件内容,编辑时的规则与创建时一致,编辑后可以点击保存进行更新,如果未保存直接返回,则编辑无效; 4)编辑后实时生效,数据大屏信息保持展示最新效果 3.6 删除数据大屏 1)操作流程:选择数据大屏-删除数据大屏 2)操作路径:数据可视化-数据大屏-二级分组-数据大屏-删除数据大屏 3)未发布或者已发布但没有被隐藏的数据大屏,并且没被引用,才展示数据大屏菜单名称后的删除图标 4)删除后数据大屏消失 3.7 复制 1)操作流程:选择数据大屏-复制数据大屏 2)操作路径:数据可视化-数据大屏-二级分组-数据大屏-复制数据大屏 3)点击【复制】按钮,复制成功,名称为copy of 原数据大屏标题,展示在原数据大屏分组的最后一个 3.8 发布 1)操作流程:选择数据大屏-发布数据大屏 2)操作路径:数据可视化-数据大屏-二级分组-数据大屏-发布 3)选择单个未发布且没有被隐藏的数据大屏,点击【发布】按钮,数据大屏状态变为已发布,展示最近发布时间; 4)如果数据大屏发布后有更新内容,会展示的更新类型:更新数据大屏信息/更新数据大屏内容 3.9 查看最近一次发布的版本 1)操作流程:选择数据大屏-查看最近一次发布的版本 2)操作路径:数据可视化-数据大屏-二级分组-数据大屏-更新发布数据大屏 3)当数据大屏发布后有更新,在最近发布时间左侧展示【查看】,在最近发布时间下展示更新的类型,点击查看可以查看最近发布的版本 3.10 更新发布 1)操作流程:选择数据大屏-更新发布数据大屏 2)操作路径:数据可视化-数据大屏-二级分组-数据大屏-更新发布数据大屏 3)选择单个已发布且没有被隐藏的数据大屏,并且该数据大屏在上次发布后有所更新,可以点击【更新发布】按钮,将最新的数据大屏内容发布至业务系统,业务系统引用的数据大屏为最新内容; 4)如果更新了内容,但未点击更新发布,则展示的仍是上次发布的数据大屏 3.11 隐藏 1)操作流程:选择数据大屏-隐藏数据大屏 2)操作路径:数据可视化-数据大屏-二级分组-数据大屏-隐藏数据大屏 3)数据大屏默认不隐藏,点击数据大屏左侧的是否隐藏可以切换 a. 未发布的数据大屏,较隐藏前,不可以操作【发布】,可以【取消隐藏】; b. 已发布的数据大屏,较隐藏前,只能操作【导出图片、导出excel、取消隐藏】; 4)隐藏后的数据大屏不可以被用于展示在其他大屏上,但不影响已经被引用的数据 3.12 取消隐藏 1)操作流程:选择数据大屏-取消隐藏数据大屏 2)操作路径:数据可视化-数据大屏-二级分组-数据大屏-取消隐藏数据大屏 3)隐藏后的数据大屏可以取消隐藏,切换是否隐藏=否,取消隐藏后,数据大屏恢复隐藏前的状态和功能,可以被引用 3.13 查看引用 1)流程:选择图表-查看被哪些报表/数据大屏/页面引用 2)操作路径:数据可视化-数据大屏-二级分组-数据大屏-更多-查看引用 3)选择具体的数据大屏,查看当前数据大屏被引用的所有信息 3.14 不允许别人编辑 1)流程:选择数据大屏-不允许别人编辑 2)操作路径:数据可视化-数据大屏-二级分组-数据大屏-更多-不允许别人编辑 3)选择自己创建的数据大屏,对数据大屏是否允许其他人编辑进行设置;如果设置为不允许,则其他人无法编辑数据大屏 3.15 不允许别人引用 1)流程:选择图表-更多-不允许别人引用 2)操作路径:数据可视化-数据大屏-二级分组-数据大屏-更多-不允许别人引用 3)选择自己创建的数据大屏,对数据大屏是否允许他人引用进行设置;如果设置为不允许,则其他人无法选择到 3.16 导出图片 1)操作流程:选择数据大屏-导出图片 2)操作路径:数据可视化-数据大屏-二级分组-数据大屏-导出图片 3)选择数据大屏后,点击【导出图片】按钮可以将当前数据大屏导出为图片 3.17 导出EXCEL 1)操作流程:选择数据大屏-导出EXCEL 2)操作路径:数据可视化-数据大屏-二级分组-数据大屏-数据大屏导出EXCEL 3)选择数据大屏后,点击【导出EXCEL】按钮可以将当前数据大屏包含的图表导出为EXCEL 4. 数据大屏设计页面 4.1 缩放自适应 1)流程:创建数据大屏-进入数据大屏设计页面 2)操作路径:数据可视化-数据大屏-创建/编辑-设计页面 3)进入页面后,默认按照当前屏幕展示最适合的数据大屏尺寸,可以通过+、-进行自定义缩放,每次缩放10% 4.2 全屏 1)流程:创建数据大屏-进入数据大屏设计页面 2)操作路径:数据可视化-数据大屏-创建/编辑-设计页面 3)进入页面后,设置完成,可以【全屏】查看效果,按esc退出全屏 4.3 保存 1) 流程:创建数据大屏-进入数据大屏设计页面 2) 操作路径:数据可视化-数据大屏-创建/编辑-设计页面 3) 进入页面后,设置完成后进行保存,数据大屏保持最新内容 4.4 添加、编辑、删除组件 1)流程:创建数据大屏-进入数据大屏设计页面 2)操作路径:数据可视化-数据大屏-创建/编辑-设计页面 3)可以添加图表、文本、通用标题、倒计时、时间器、图片、轮播图、视频、边框等组件;图表组件中,一个图表只能添加一次,其他组件不限制数量; 4)所有组件添加后均可进行设置样式,有编辑权限的图表组件可以通过【编辑】图标直接进入图表设计页面; 5)添加后均可删除,删除后组件不再展示在数据大屏画布中,可以重新添加 4.5 数据大屏设置 1)操作流程:创建数据大屏-进入数据大屏设计页面 2)操作路径:数据可视化-数据大屏-创建/编辑-设计页面 3)设置数据大屏时可以设置屏幕的宽高、背景颜色、背景图片、主题 a. 宽高:根据数据大屏需要投放的屏幕大小进行设置; b. 背景颜色:当数据大屏无图片背景时可以调整背景颜色; c. 背景图片:支持为数据大屏上传一张图片作为背景; d. 主题模版:可任选其一,需要先选定模版后再进行设计,不然设计完后再修改模版,会清空已选组件。 4.6 图表组件设置 1)操作流程:创建数据大屏-进入数据大屏设计页面 2)操作路径:数据可视化-数据大屏-创建/编辑-设计页面 3)拖入图表组件,可与边框合为一体,可以设置图表的显示内容、边框信息、动画效果、刷新频率 a. 图表显示内容:展示标题、副标题、描述、标签、图例,一屏展示条数,原图表有的内容在设置展示后展示在数据大屏,原图表没有的内容设置展示后不生效; b. 边框信息:包括边框样式、背景颜色、边框线条颜色、展示边框标题、边框标题内容、边框标题颜色、边框标题字体大小; c. 动画效果:可以设置自动轮播,为是时可以设置结束后停顿时长、速度、切换形式; d. 刷新频率:设置图表获取数据的频率,自动刷新、刷新频率。 4.7 文本组件设置 1)操作流程:创建数据大屏-进入数据大屏设计页面 2)操作路径:数据可视化-数据大屏-创建/编辑-设计页面 3)拖入文本组件后,可以输入多行文本,可以设置内容、对齐方式、字体大小、字体加粗、字体颜色、背景颜色、边框样式、文字滚动、结束后停顿、速度 4)当文字滚动开启时,文字会按照一行展示,通过设置结束后停顿和速度来控制文字滚动的效果 4.8 通用标题组件设置…

    2024年6月20日
    1.8K00
  • 4.1.2 模块之启动指令

    针对不同启动指令的组合可以满足不同场景需求,下面列举了几个常规组合方式,小伙伴们务必把这几种模式都尝试一遍,会更有体感 本节为小伙伴讲解oinone模块的几种启动方式,它是为能灵活地应对企业市场的不同场景需求,为op(本地化部署)、saas和研发提供个性化支撑。也为oinone独特性之单体与分布式的灵活切换提供基础支撑 一、部署参数 参数 名称 默认值 说明 -Plifecycle 生命周期部署指令 RELOAD 可选项:无/INSTALL/PACKAGE/RELOAD/DDL安装-install为AUTO;upgrade为FORCE打包-install为AUTO;upgrade为FORCE;profile为PACKAGE重启-install、upgrade、profile为READONLY打印变更DDL-install为AUTO;upgrade为FORCE;profile为DDL 表4-1-2-1 部署参数 如果在启动命令中配置了部署参数,可不再设置服务参数和可选项参数。下图为在启动命令中添加部署参数的示例。 图4-1-2-1 在启动命令中添加部署参数的示例 二、使用场景 针对不同启动指令的组合可以满足不同场景需求,下面列举了几个常规组合方式,小伙伴们务必把这几种模式都尝试一遍,会更有体感。 场景一:DDL(1)+RELOAD(N)应对专有DBA 因为很多公司数据库是由专门的DBA来管理的,不允许应用直接变更数据库相关配置、表结构、初始化数据。而oinone是基于元数据驱动的,任何模型、行为的变化都会自动转化成对物理存储的改变与元数据变化。 oinone为了适用企业op场景,特别增加了DDL模式。把发布上线分为两个步骤。 一:用DDL模式把涉及到数据库的变更与元数据初始化的脚本进行输出,交由客户公司DBA审批,并执行 二:用RELOAD模式,进行正常的应用重启工作,不进行安装、升级、以及数据库物理变革等操作。 #应用启动关闭自动DDL配置 pamirs.boot.profile: CUSTOMIZE pamirs.boot.options.rebuildTable: false pamirs.persistence.global.auto-create-database: false pamirs.persistence.global.auto-create-table: false 图4-1-2-2 应用启动关闭自动DDL模式 场景二:PACKAGE(1)+RELOAD(N)应对提升多机器实例效率 在机器规模相对大的场景中我们会碰到以下问题: 元数据差量计算、数据库变更、元数据变化保存都非常费时,如果每台机器都来一遍是非常费时费力的 分布式下多机器如果并发进行INSTALL,会导致数据库修改表结构、元数据变化保存锁死 所以我们可以选择一台机器用PACKAGE,其他机器采用RELOAD模式,做到合理规避问题,提升应用发布效率 场景三:INSTALL应对开发模式 研发在本地开发模式下INSTALL是最有效率的,把所需依赖模块一把启动和调试。 上线如果要用INSTALL需要注意,要逐台进行。当然也可以改进成INSTALL(1)+RELOAD(N)模式 三、启动命令解读 查看启动命令 可以在启动日志中查看当前所用启动命令。 图4-1-2-3 在启动日志中查看当前所用启动命令 生命周期管理-Plifecycle 除了通过启动YAML中pamirs.boot属性来设置启动参数,你还可以在应用启动命令中使用-Plifecycle参数来快捷控制模块生命周期的管理方式。该参数的可选项为RELOAD、INSTALL、CUSTOM_INSTALL、PACKAGE、DDL。 java -jar <your jar name>.jar -Plifecycle=RELOAD 启动命令优先级高于YAML中pamirs.boot属性中的install、upgrade和profile属性。如果不使用-Plifecycle参数,则使用YAML中pamirs.boot属性中的install、upgrade和profile属性配置。若YAML中未配置,则采用默认值。 启动配置项 默认值 RELOAD INSTALL CUSTOM_INSTALL PACKAGE DDL install AUTO READONLY AUTO AUTO AUTO AUTO upgrade AUTO READONLY FORCE FORCE FORCE FORCE profile CUSTOMIZE READONLY AUTO CUSTOMIZE PACKAGE DDL 表4-1-2-2 Plifecycle可选项与启动项对应表 profile属性请参考4.1.1【服务启动可选项】一文。只有pamirs.boot.profile=CUSTOMIZE时,在pamirs.boot.options中自定义的可选项才生效。 自动建表-PbuildTable java -jar <your jar name>.jar -PbuildTable=NEVER PbuildTable参数用于设置自动构建表结构的方式。如果不使用该参数,则options属性的默认值请参考4.1.1【服务启动可选项】一文。-PbuildTable参数可选项为: NEVER – 不自动构建表结构,会将pamirs.boot.options中的diffTable和rebuildTable属性设置为false EXTEND – 增量构建表结构,会将pamirs.boot.options中的diffTable属性设置为false,rebuildTable属性设置为true DIFF – 差量构建表结构,会将pamirs.boot.options中的diffTable和rebuildTable属性设置为true 模块在线 -PmoduleOnline java -jar <your jar name>.jar -PmoduleOnline=CHECK PmoduleOnline参数用于设置模块在线的方式。如果不使用该参数,则profile属性的默认值请参考4.1.1【服务启动可选项】一文。-PmoduleOnline参数可选项为: NEVER – 不读取存储在数据库中的模块信息,会将pamirs.boot.options中的reloadModule和checkModule属性设置为false READ – 读取存储在数据库中的模块信息,会将pamirs.boot.options中的checkModule属性设置为false,reloadModule属性设置为true CHECK – 读取存储在数据库中的模块信息并校验依赖模块是否已安装,会将pamirs.boot.options中的reloadModule和checkModule属性设置为true 元数据在线-PmetaOnline java -jar <your jar name>.jar -PmetaOnline=MODULE PmetaOnline参数用于设置元数据在线的方式,如果不使用该参数,则profile属性的默认值请参考4.1.1【服务启动可选项】一文。-PmetaOnline参数可选项为: NEVER – 不持久化元数据,会将pamirs.boot.options中的updateModule、reloadMeta和updateMeta属性设置为false MODULE – 只注册模块信息,会将pamirs.boot.options中的updateModule属性设置为true,reloadMeta和updateMeta属性设置为false ALL – 注册持久化所有元数据,会将pamirs.boot.options中的updateModule、reloadMeta和updateMeta属性设置为true 开放远程服务-PenableRpc PenableRpc参数用于设置是否开启远程服务。如果不使用该参数,则profile属性的默认值请参考4.1.1【服务启动可选项】一文。-PenableRpc参数可选项为true和false。该参数会将参数值设置到pamirs.boot.options中的publishService属性。 开启API服务-PopenApi PopenApi参数用于设置是否开启HTTP API服务。如果不使用该参数,则profile属性的默认值请参考4.1.1【服务启动可选项】一文。-PopenApi参数可选项为true和false。该参数会将参数值设置到pamirs.boot.options中的rebuildHttpApi属性。 开启字段校验-PcheckField PcheckField参数用于设置是否开启字段校验。-PcheckField参数可选项为true和false。由于通常应用的字段数量非常多,会延长系统启动时长,所以默认不会开启字段校验。 启用数据初始化服务-PinitData PinitData参数用于设置是否开启数据初始化服务。如果不使用该参数,则profile属性的默认值请参考4.1.1【服务启动可选项】一文。-PinitData参数可选项为true和false。该参数会将参数值设置到pamirs.boot.options中的updateData属性。 四、不使用自动构建数据库表功能 Oinone LCDP默认提供框架的所有服务,所以会自动构建数据库表。如果不需要使用Oinone的存储构建服务,可以设置YAML文件中关于自动建表的配置。这样就不会动态构建数据库表,你可以手动搭建数据库表。 通过配置启动YAML中pamirs.boot.options.rebuildTable为false彻底关闭自动建表功能。 pamirs: boot: options: rebuildTable: false 图4-1-2-4 不使用自动构建数据库表功能 也可以按需配置启动YAML中pamirs.persistence配置来关闭部分数据源的自动建表功能。persistence配置既可以针对全局也可以分数据源进行配置。 pamirs: persistence: global: # 是否自动创建数据库的全局配置,默认为true autoCreateDatabase: true # 是否自动创建数据表的全局配置,默认为true autoCreateTable: true <your ds key>: # 是否自动创建数据库的数据源配置,默认为true autoCreateDatabase: true # 是否自动创建数据表的数据源配置,默认为true…

    2024年5月23日
    1.4K00
  • 2.4.2 Oinone独特性之每一个需求都可以是一个模块

    我们的Oinone平台采用模型驱动的方式,并符合面向对象设计原则,每个需求都可以是一个独立模块,可以独立安装、升级和卸载。这让系统真正像乐高积木一样搭建,具有高度的灵活性和可维护性。 与大部分低代码或无代码平台不同的是,它们的应用市场上的应用往往是模板式的,也就是说,这是一个拷贝,个性化只能在应用上直接修改,而且一旦修改就不能升级。这对于软件公司和客户来说都非常痛苦。客户无法享受到软件公司产品的升级功能,而软件公司在服务大量客户时,也会面临不同版本的维护问题,成本也非常高。而我们的Oinone平台完全避免了这些问题,让客户和软件公司都可以从中受益(如下图2-9、2-10所示)。 图2-9软件公司与客户项目的关系-让标准与个性化共存 图2-10 软件公司与客户项目的关系-让升级无忧 实现原理 在满足客户个性化定制需求时,传统的方法通常是直接修改标准产品源码,但这样做会带来一个问题:标准产品无法持续升级。相反,无论是在OP模式还是SaaS模式下,Oinone都采用全新的模块为客户进行个性化开发,保持标准产品和个性化模块的独立维护和升级。这是因为在元数据设计时,Oinone采用了面向对象的设计原则,实现了元数据设计与面向对象设计思想的完美融合。 面向对象设计的核心特征包括封装、继承、多态,而Oinone的元数据设计完全融入了这些思想。下面是几个例子,说明Oinone的元数据设计如何体现面向对象设计的核心特征,并带来了什么好处: 继承:在继承原有模型的字段、逻辑、展示的情况下,增加一段代码来扩展模型的字段、逻辑、展示。 多态:在继承原有模型的字段、逻辑、展示的情况下,增加一段代码来覆盖模型的原有字段、逻辑、展示。 封装:外部无需关心模型内部如何实现,只需按照不同场景调用模型对应开放级别的字段、逻辑、展示。 这些特征和优势使得Oinone在满足客户个性化需求时更加灵活和可持续,同时使得标准产品的维护和升级变得更加容易和高效。 在Java语言设计中,万物皆对象,一切都以对象为基础。而Oinone的元数据设计则是以模型为出发点,作为数据和行为的承载体。如下图2-11清晰地描述了Java面向对象编程中封装、继承、多态在Oinone元数据中的对应关系。Oinone元数据描述了B对象继承A对象并拥有其所有属性和方法,并覆盖了A对象的属性1和方法1,同时新增了属性3和方法3。 此外,Oinone的面向对象特性是用元数据来描述的。一方面,我们基于Java编码规范收集相关元数据,以保持不改变Java编程习惯。另一方面,方法和对象的挂载是松耦合的,只要按照元数据规范进行挂载,就能轻松地将其附加到模型上。在不改变原有A对象的情况下,我们可以直接增加方法和属性(如下图2-12所示)。 图2-11 java面向对象在Oinone元数据中对应 图2-12 java对象的修改 VS Oinone元数据模型的修改 Oinone函数不仅支持面向对象的继承和多态特性,还提供了面向切面的拦截器和SPI机制的扩展点,以应对方法逻辑的覆盖和扩展,以及系统层面的逻辑扩展(如下图2-13所示)。这些扩展功能可以独立地在模块中维护。 其中,拦截器可以在不侵入函数逻辑的情况下,根据优先级为满足条件的函数添加执行前和执行后的逻辑。 扩展点是一种类似于SPI机制的逻辑扩展机制,用于扩展函数的逻辑。通过这一机制,可以对函数逻辑进行灵活的扩展,以满足不同的业务需求。 图2-13 Oinone函数拦截与扩展机制 不管是对象、属性还是方法,都可以以独立的模块方式来扩展,这就使得每一个需求都可以成为一个独立的模块,方便我们在研发标准产品时进行模块化的划分,同时也让我们在以低代码模式为客户进行二次开发时,能够更好地支持“标准产品迭代与个性化保持独立”的需求。在2.4.3【oinone独特性之低无一体】一文中,我们也提到了这个特性,但那是在低无一体的情况下,通过元数据融合来实现的。让我们看看基于低代码开发模式下,典型的Oinone二次开发工程结构(如下图2-14所示),就可以更好地理解这个特性啦! 图2-14 Oinone典型的二开工程结构

    2024年5月23日
    1.7K00
  • 3.4.1 构建第一个Function

    Function做为oinone的可管理的执行逻辑单元,是无处不在的 在3.3.3【模型的数据管理器】和3.3.2【模型类型】一文中的代理模型部分,涉及到包括在Action中自定义函数(action背后都对应一个Function)、重写queryPage的函数、以及独立抽取的公共逻辑函数,Function做为oinone的可管理的执行逻辑单元,是无处不在的。这也是为什么说oinone以函数为内在的原因。 一、构建第一个Function 因为数据管理器和数据构造器是oinone为模型自动赋予的Function,是内在数据管理能力。模型其他Function都需要用以下四种方式主动定义 伴随模型新增函数(举例) 它是跟模型的java类定义在一起,复用模型的命名空间。 Step1 为PetShop增加一个名为sayHello的Function package pro.shushi.pamirs.demo.api.model; …… //import @Model.model(PetShop.MODEL_MODEL) @Model(displayName = "宠物店铺",summary="宠物店铺",labelFields ={"shopName"} ) @Model.Code(sequence = "DATE_ORDERLY_SEQ",prefix = "P",size=6,step=1,initial = 10000,format = "yyyyMMdd") public class PetShop extends AbstractDemoIdModel { public static final String MODEL_MODEL="demo.PetShop"; …… //省略其他代码 @Function(openLevel = FunctionOpenEnum.API) @Function.Advanced(type=FunctionTypeEnum.QUERY) public PetShop sayHello(PetShop shop){ PamirsSession.getMessageHub().info("Hello:"+shop.getShopName()); return shop; } } 图3-4-1-1 代码示例 Step2 重启看效果 用graphQL工具Insomnia查看效果 用Insomnia模拟登陆 a. 创建一个login请求,用于保存login请求,为后续模拟登陆保留快捷方式 图3-4-1-2 创建一个login请求 b. 下面为登陆请求的GraphQL,请在post输入框中输入。如果请求输入框提示错误可以,可以点击schema 的Refresh Schema来刷新文档 mutation { pamirsUserTransientMutation { login(user: {login: "admin", password: "admin"}) { broken errorMsg errorCode errorField } } } 图3-4-1-3 登陆请求的GraphQL c. 点击Send按钮,我们可以看到登陆成功的反馈信息 图3-4-1-4 登陆成功的反馈信息 用Insomnia模拟访问PetShop的sayHello方法,gql的返回中,我们可以看到两个核心返回 a. 一是方法正常返回的shopName b. 二是“PamirsSession.getMessageHub().info("Hello:"+shop.getShopName())”代码执行的结果,在messages中有一个消息返回,更多消息机制详见4.1.23【框架之信息传递】 query{ petShopQuery{ sayHello(shop:{shopName:"cpc"}){ shopName } } } 图3-4-1-5 用Insomnia模拟访问PetShop的sayHello 图3-4-1-6 代码执行结果 用Insomnia模拟访问PetShopProxy的sayHello方法 效果同用Insomnia模拟访问PetShop的sayHello方法,体现Function的继承特性。 独立新增函数绑定到模型(举例) 独立方法定义类,并采用Model.model或Fun注解,但是value都必须是模型的编码,如@Model.model(PetShop.MODEL_MODEL)或@Fun(PetShop.MODEL_MODEL) Step1 提取PetShop的sayHello方法独立到PetShopService中 注释掉PetShop的sayHello方法 package pro.shushi.pamirs.demo.api.model; …… //import @Model.model(PetShop.MODEL_MODEL) @Model(displayName = "宠物店铺",summary="宠物店铺",labelFields ={"shopName"} ) @Model.Code(sequence = "DATE_ORDERLY_SEQ",prefix = "P",size=6,step=1,initial = 10000,format = "yyyyMMdd") public class PetShop extends AbstractDemoIdModel { public static final String MODEL_MODEL="demo.PetShop"; …… //省略其他代码 // @Function(openLevel = FunctionOpenEnum.API) // @Function.Advanced(type=FunctionTypeEnum.QUERY) // public PetShop sayHello(PetShop shop){ // PamirsSession.getMessageHub().info("Hello:"+shop.getShopName()); // return shop; // } } 图3-4-1-7 注释掉PetShop的sayHello 新增PetShopService接口类 接口的方法上要加上@Function注解,这样另模块依赖api包的时候,会自动注册远程服务的消费者 package pro.shushi.pamirs.demo.api.service; import pro.shushi.pamirs.demo.api.model.PetShop; import pro.shushi.pamirs.meta.annotation.Fun; import pro.shushi.pamirs.meta.annotation.Function; @Fun(PetShop.MODEL_MODEL) //@Model.model(PetShop.MODEL_MODEL) public interface…

    2024年5月23日
    2.0K00

Leave a Reply

Please Login to Comment