
3.5.5 设计器的结合(改)

在页面开发的时候,直接通过前端组件和视图xml进行开发虽然开放性是很大的、但我们经常会忘记视图的配置属性,同时用xml配置的页面因为缺少设计数据,导致无法直接在设计器中复制,自定义页面得从头设计。今天就带大家一起来学习如何结合无代码设计器来完成页面开发,并把设计后的页面元数据装载为标准产品的一部分。

1 安装Docker

如果没有Docker的话,请自行到官网下载:https://www.docker.com/get-started/

2 下载Docker 镜像,并导入镜像

Step2.1 镜像下载

v.4.6.28.3-allinone-full 版本说明 前后端以及中间件一体
镜像地址 docker pull harbor.oinone.top/oinone/designer:4.6.28.3-allinone-full
下载结构包 oinone-op-ds-all-full.zip(17 KB)
v.4.6.28.3-allinone-mini 版本说明 前后端一体支持外部中间件
镜像地址 docker pull harbor.oinone.top/oinone/designer:4.6.28.3-allinone-mini
下载结构包 oinone-op-ds-all-mini.zip(14 KB)
v.4.7.9-allinone-full 版本说明 前后端以及中间件一体
镜像地址 docker pull harbor.oinone.top/oinone/designer:4.7.9-allinone-full
下载结构包 oinone-op-ds-all-full.zip(17 KB)
v.4.7.9-allinone-mini 版本说明 前后端一体支持外部中间件
镜像地址 docker pull harbor.oinone.top/oinone/designer:4.7.9-allinone-mini
下载结构包 oinone-op-ds-all-mini.zip(14 KB)

Step2.1.2 镜像下载用户与密码

需要商业版镜像需要加入Oinone商业版本伙伴专属群,向Oinone技术支持获取用户名与密码,镜像会定时更新并通知大家。

#注意:docker镜像拉取的账号密码请联系数式技术
docker login --username=用户名 harbor.oinone.top
docker pull docker pull harbor.oinone.top/oinone/designer:4.6.28.3-allinone-full

Step2.1.3 镜像和版本选择

目前有2个版本可供选择,包含中间件以及不包含中间件2个版本,下载结构包以后注意修改startup.sh和startup.cmd中对应镜像地址的版本号。

Step2.1.4 本地结构说明

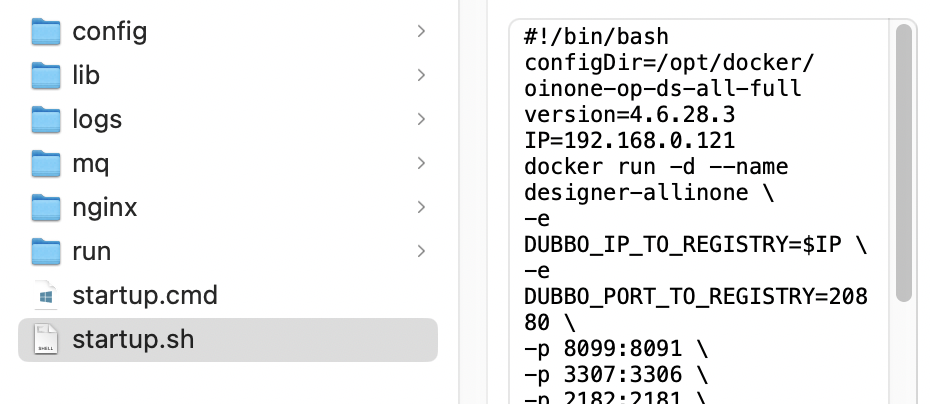
下载结构包并解压
3.5.5 设计器的结合(改)

  1. config是放application.yml的目录,可以在application.yml配置需要启动的自有模块同时修改对应其他中间件配置项

  2. lib是放自有模块的jar包以及其对应的依赖包比如:pamirs-demo-api-1.0.0-SNAPSHOT.jar和pamirs-demo-core-1.0.0-SNAPSHOT.jar

  3. nginx:前端运行的nginx站点配置文件

  4. mq:消息配置,再使用低无一体时需要指定mq的broker的IP

  5. run:容器运行中间件的脚本,可以对个别中间件是否启动进行设置,(注释掉运行脚本,容器启动时就不会启动该中间件)

  6. logs是运行时系统日志目录

Step2.2 修改startup.sh中的路径

Step2.2.1 linux环境修改参数

在文件中找到如下 configDir=/opt/docker/oinone-op-ds-all-full version=4.6.28.3 IP=192.168.0.121

  • 修改configDir的路径(下载oinone-op-ds-xx.zip解压后的路径)

  • 修改对应的镜像版本号

  • 修改对应的IP为docker宿主机IP

#!/bin/bash
configDir=/opt/docker/oinone-op-ds-all-full
version=4.6.28.3
IP=192.168.0.121
docker run -d --name designer-allinone \
-e DUBBO_IP_TO_REGISTRY=$IP \
-e DUBBO_PORT_TO_REGISTRY=20880 \
-p 8099:8091 \
-p 3307:3306 \
-p 2182:2181 \
-p 6378:6379 \
-p 19876:9876 \
-p 10991:10991 \
-p 15555:15555 \
-p 20880:20880 \
-p 88:80 \
-v $configDir/config/:/opt/pamirs/ext \
-v $configDir/nginx:/opt/pamirs/nginx/vhost \
-v $configDir/logs:/opt/pamirs/logs \
-v $configDir/mq/broker.conf:/opt/mq/conf/broker.conf \
-v $configDir/run/run.sh:/opt/pamirs/run/run.sh \
-v $configDir/lib:/opt/pamirs/outlib harbor.oinone.top/oinone/designer:$version-allinone-full

Step2.2.3 window环境修改参数

在文件中找到如下 set configDir=/d/shushi/docker/oinone-op-ds-all-full set version=4.6.28.3 set IP=192.168.0.121

  • 修改configDir的路径((下载oinone-op-ds-xx.zip解压后的路径)

  • 修改对应的镜像版本号

  • 修改对应的IP为docker宿主机IP

@echo off
set configDir=/d/shushi/docker/oinone-op-ds-all-full
set version=4.6.28.3
set IP=192.168.0.121
docker run -d --name designer-allinone ^
-e DUBBO_IP_TO_REGISTRY=%IP% ^
-e DUBBO_PORT_TO_REGISTRY=20880 ^
-p 8099:8091 ^
-p 3307:3306 ^
-p 2182:2181 ^
-p 6378:6379 ^
-p 19876:9876 ^
-p 10991:10991 ^
-p 15555:15555 ^
-p 88:80  ^
-v %configDir%/config/:/opt/pamirs/ext   ^
-v %configDir%/nginx:/opt/pamirs/nginx/vhost ^
-v %configDir%/logs:/opt/pamirs/logs ^
-v %configDir%/mq/broker.conf:/opt/mq/conf/broker.conf ^
-v %configDir%/run/run.sh:/opt/pamirs/run/run.sh ^
-v %configDir%/lib:/opt/pamirs/outlib harbor.oinone.top/oinone/designer:%version%-allinone-full

3 不包含中间件的application.yml配置示例

修改结构包目录下config/application.yml

  • 要把192.168.0.121换成非127.0.0.1的机器分配IP:通过ifconfig(mac)或ipconfig(windows)命令查询
  • 数据库换成自己demo工程的数据库,demo6_v3 --> demo
dubbo:
  #dubbo的配置
server:
  address: 0.0.0.0
  port: 8091
  sessionTimeout: 3600
spring:
  redis:
  #redis的配置
logging:
        #日志的配置
pamirs:
  framework:
    system:
      system-ds-key: base
      system-models: base.WorkerNode
    data:
      default-ds-key: pamirs
      ds-map:
        base: base
    gateway:
      statistics: true
      show-doc: true
    meta:
      dynamic: false
  persistence:
    global:
      auto-create-database: true
      auto-create-table: true
  datasource:
    pamirs:
      driverClassName: com.mysql.cj.jdbc.Driver
      type: com.alibaba.druid.pool.DruidDataSource
      url: jdbc:mysql://127.0.0.1:3306/demo?useSSL=false&allowPublicKeyRetrieval=true&useServerPrepStmts=true&cachePrepStmts=true&useUnicode=true&characterEncoding=utf8&serverTimezone=Asia/Shanghai&autoReconnect=true&allowMultiQueries=true
      username: root
      password: oinone
            #............
      asyncInit: true
  #............
  boot:
    init: true
    sync: true
    modules:
      - base
      #-其他module
      - demo_core
    tenants:
      - pamirs
  auth:
      #权限过滤配置
  eip:
    #eip配置

我们前面中间件所绑定的IP都是127.0.0.1,因为我们这里使用了docker来访问,需要让中间件支持真正机器分配IP访问

Step3.1 检查mysql

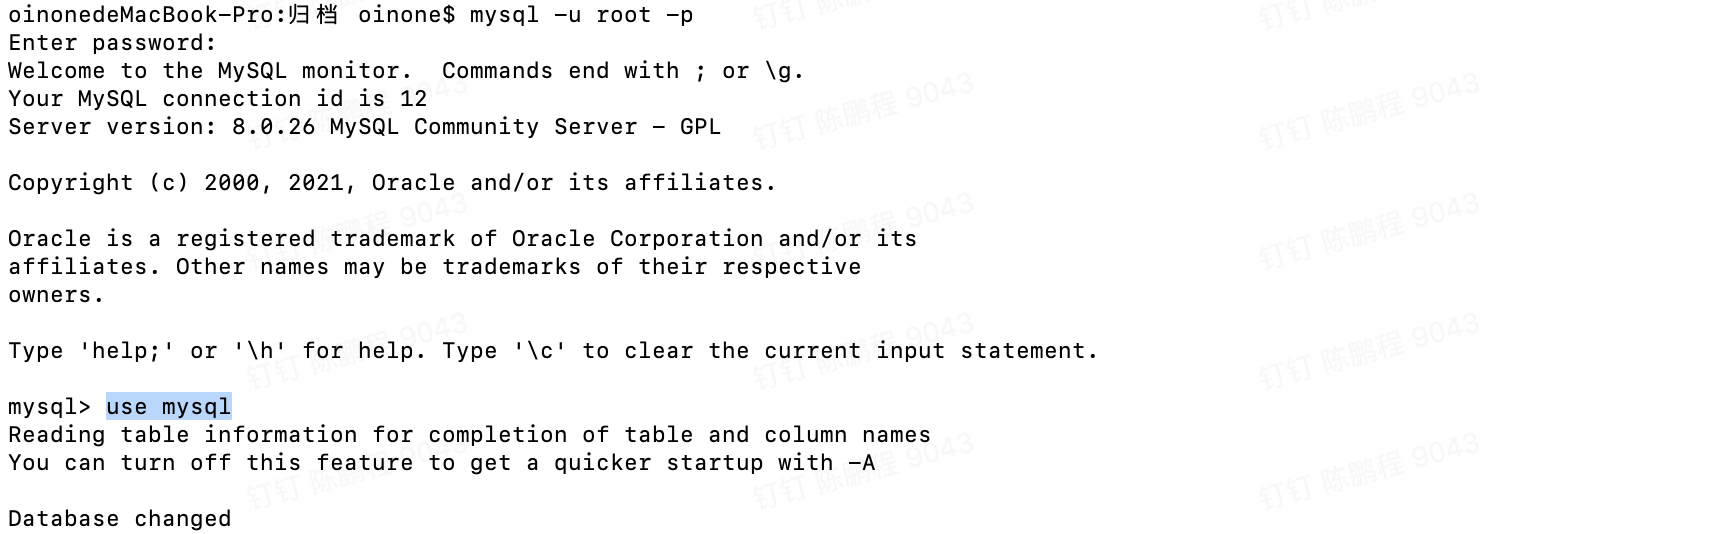
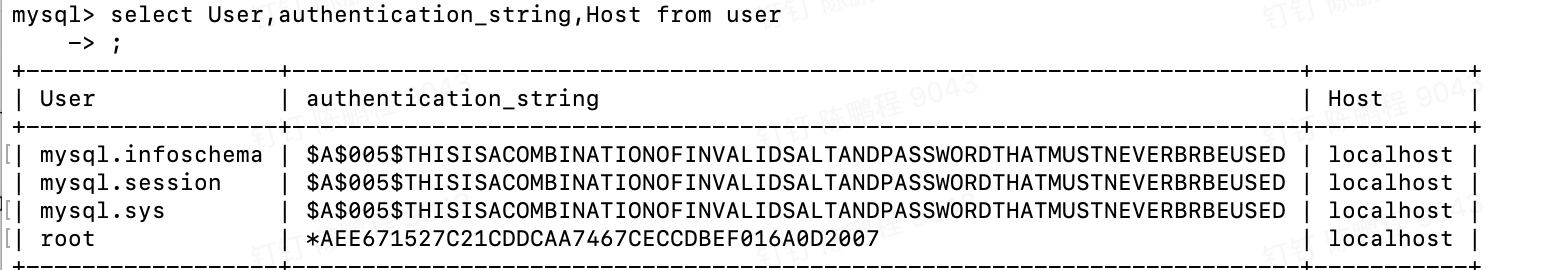
  1. 确保yml文件中配置的用户可以通过机器IP来访问,例子中我们是用的是root用户,按以下步骤检查
mysql -u root -p
use mysql
3.5.5 设计器的结合(改)

select User,authentication_string,Host from user;
3.5.5 设计器的结合(改)

update user set Host='%' where user='root';
flush privileges;

Step3.2 检查redis

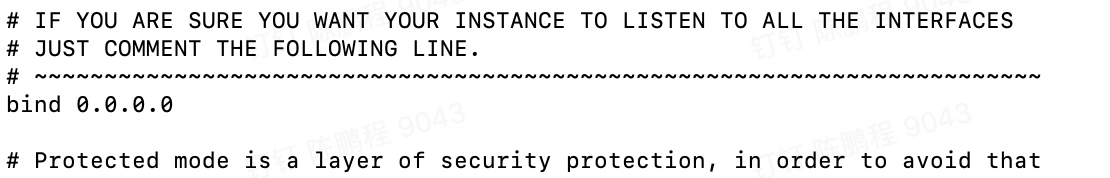
找到redis安装目录,编辑redis.conf,bind 从127.0.0.1改成0.0.0.0或对应本机IP,重启redis。
3.5.5 设计器的结合(改)

如果redis访问有问题,可以尝试在启动命令中增加 “--protected-mode no” 参数

nohup redis-server --protected-mode no & 

Step3.3 检查RocketMq

检查broker节点配置IP,如果有配置不能用127.0.0.1

Step3.4 检查Zookeeper

如果本地搭集群方式需要检查IP,如果有配置不能用127.0.0.1

4 包含中间件的application.yml以及其他配置示例

  • 对应中间件的配置:指定对应IP和端口或密码,把其中192.168.0.121改为宿主机IP
    • zookeeper
    • mysql
    • rocket-mq
    • redis
    • 阿里云oss配置

Step4.1 修改nginx/default.conf

如在docker和业务应用共同中间件实现低无一体时,如想在设计器中访问业务应用需要配置业务应用的nginx转发

location /pamirs/DemoCore {
    # 对应额外工程部署的IP,端口为额外工程后端的端口
    proxy_pass  http://192.168.0.121:8190
    proxy_set_header    Host    $host;
    proxy_set_header    X-Real-IP   $remote_addr;
    proxy_set_header    X-Forwarded-For $proxy_add_x_forwarded_for;
}

修改以后可进容器重启nginx直接生效

进入docker容器
docker exec -it designer-allinone /bin/bash
docker镜像中重启nginx
/usr/local/nginx/sbin/nginx -s reload

Step4.2 修改mq/broker.conf

修改其中brokerIP1的IP从192.168.0.121改成宿主机IP

brokerClusterName = DefaultCluster
namesrvAddr=192.168.0.121:19876
brokerIP1=192.168.0.121
brokerName = broker-a
brokerId = 0
deleteWhen = 04
fileReservedTime = 48
brokerRole = ASYNC_MASTER
flushDiskType = ASYNC_FLUSH
autoCreateTopicEnable=true
listenPort=10991
transactionCheckInterval=1000
#存储使用率阀值,当使用率超过阀值时,将拒绝发送消息请求
diskMaxUsedSpaceRatio=98
#磁盘空间警戒阈值,超过这个值则停止接受消息,默认值90
diskSpaceWarningLevelRatio=99
#强制删除文件阈值,默认85
diskSpaceCleanForciblyRatio=97

5. 启动Docker

Step5.1 linux环境启动

  • 在终端执行 sh startup.sh

Step5.2 window环境启动

  • 用PowerShell 执行 .\startup.cmd

Step5.3 查看日志,检查是否启动成功

在logs目录下可看到生成的日志文件,第一次启动时间会相对长一些,等看到日志文件中输出 启动耗时 。。。等字样,代表启动成功

6 体验并设计页面

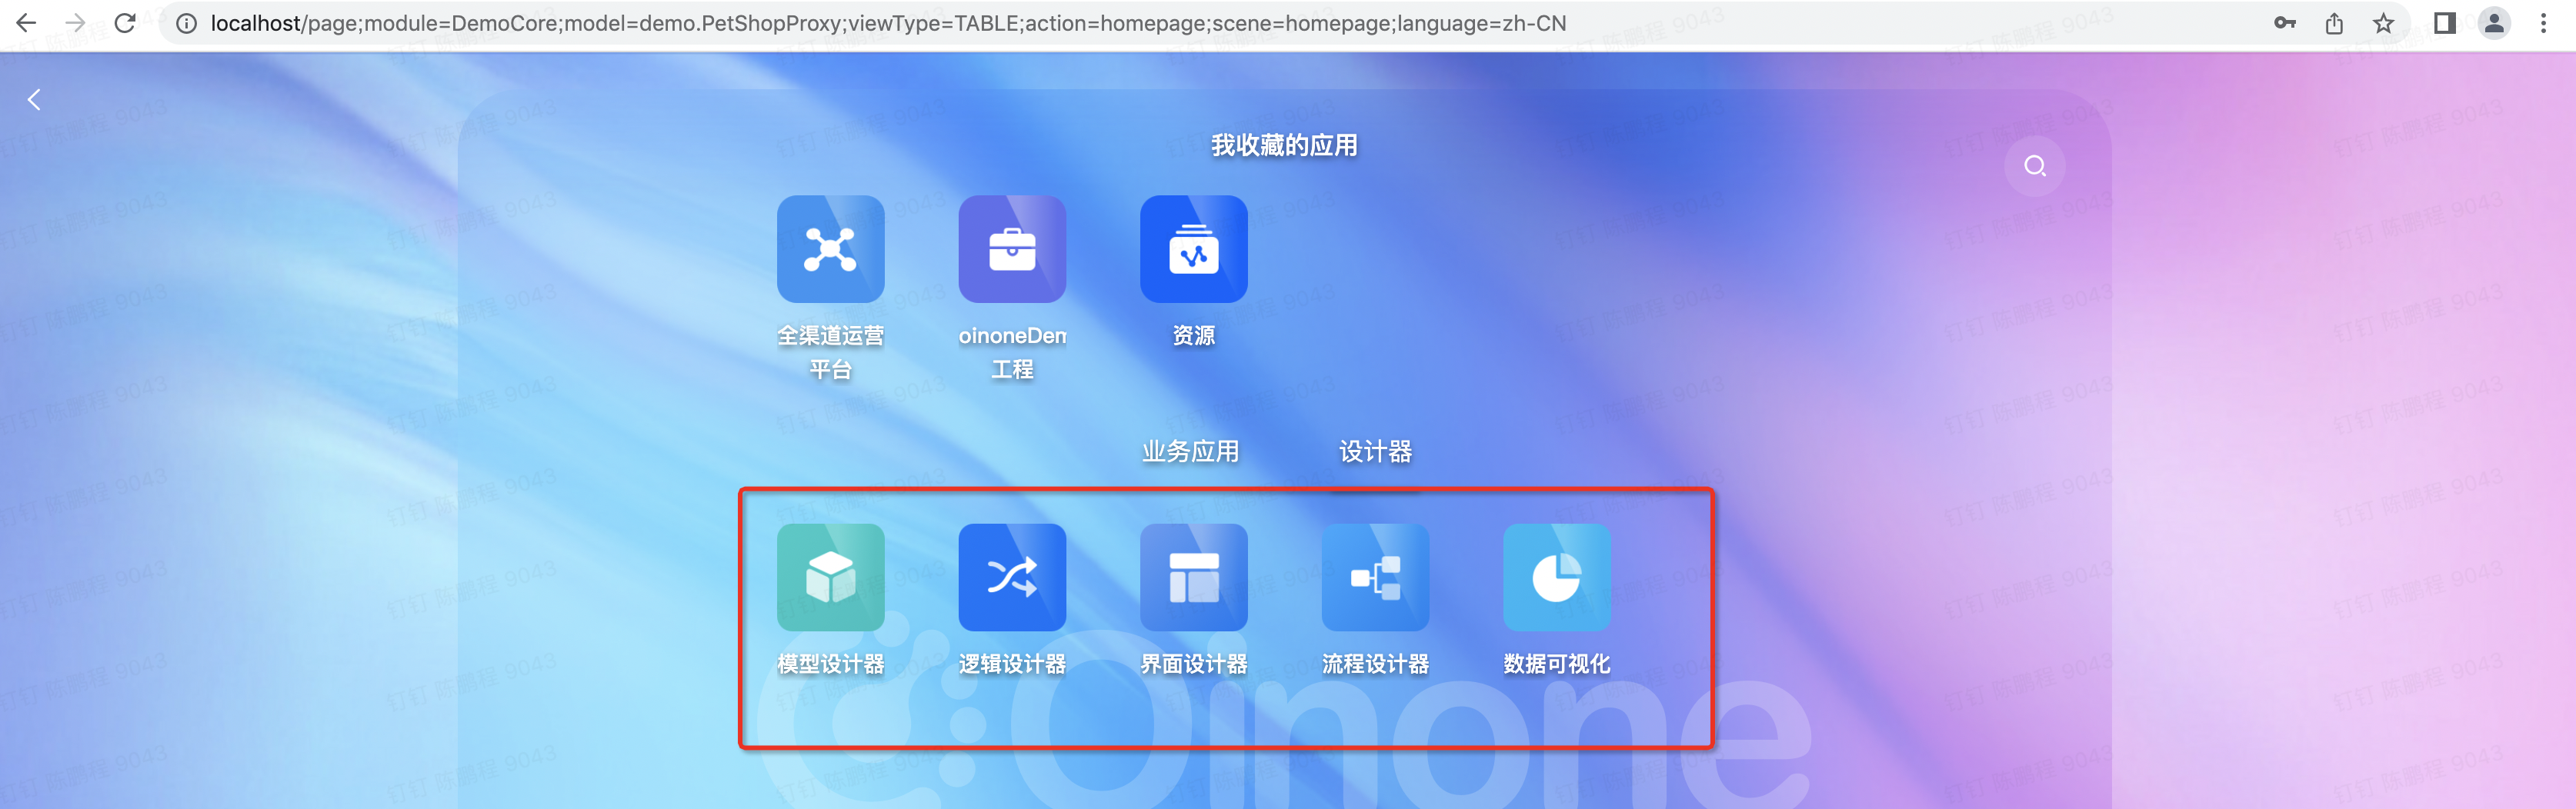
输入http://localhost/访问,通过App Finder 切换时多了设计器一项
3.5.5 设计器的结合(改)

7 导出数据,并固化数据到产品中

Step7.1通过接口导出数据

设计器数据导出

Step7.2 导入数据到项目中

  1. pom依赖:

    pro.shushi.pamirs.metadata.manager
    pamirs-metadata-manager
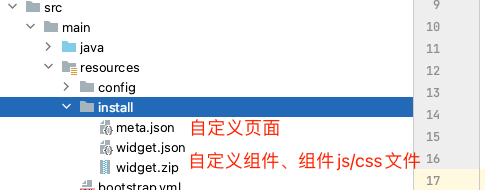
  1. 将第二步下载后的文件放入项目中(注意文件放置的位置)。放置工程的resources下面。例如:
3.5.5 设计器的结合(改)

3、 项目启动过程中,将文件中的数据导入(通常放在core模型的init包下面)。示例代码:

package pro.shushi.pamirs.sys.setting.enmu;

import com.google.common.collect.Lists;
import org.apache.commons.collections4.CollectionUtils;
import org.springframework.beans.factory.annotation.Autowired;
import org.springframework.context.ApplicationContext;
import org.springframework.stereotype.Component;
import pro.shushi.pamirs.boot.common.api.command.AppLifecycleCommand;
import pro.shushi.pamirs.boot.common.api.init.LifecycleCompletedAllInit;
import pro.shushi.pamirs.boot.common.extend.MetaDataEditor;
import pro.shushi.pamirs.core.common.InitializationUtil;
import pro.shushi.pamirs.meta.annotation.fun.extern.Slf4j;
import pro.shushi.pamirs.meta.api.dto.meta.Meta;
import pro.shushi.pamirs.meta.domain.module.ModuleDefinition;
import pro.shushi.pamirs.metadata.manager.core.helper.DesignerInstallHelper;
import pro.shushi.pamirs.metadata.manager.core.helper.WidgetInstallHelper;

import java.util.List;
import java.util.Map;

@Slf4j
@Component
public class DemoAppMetaInstall implements MetaDataEditor, LifecycleCompletedAllInit {

    @Autowired
    private ApplicationContext applicationContext;

    @Override
    public void edit(AppLifecycleCommand command, Map metaMap) {
        if (!doImport()) {
            return;
        }
        log.info("[设计器业务元数据导入]");
        InitializationUtil bizInitializationUtil = InitializationUtil.get(metaMap, DemoModule.MODULE_MODULE/***改成自己的Module*/, DemoModule.MODULE_NAME/***改成自己的Module*/);
        DesignerInstallHelper.mateInitialization(bizInitializationUtil, "install/meta.json");

        log.info("[自定义组件元数据导入]");
//        写法1: 将组件元数据导入到页面设计器. 只有在安装设计器的服务中执行才有效果
        WidgetInstallHelper.mateInitialization(metaMap, "install/widget.json");

//        写法2: 与写法1相同效果
        InitializationUtil uiInitializationUtil = InitializationUtil.get(metaMap, "ui_designer", "uiDesigner");
        if (uiInitializationUtil != null) {
            DesignerInstallHelper.mateInitialization(uiInitializationUtil, "install/widget.json");
        }

//        写法3: 业务工程和设计器分布式部署,且希望通过业务工程导入自定义组件元数据. 业务模块需要依赖页面设计器模块,然后指定业务模块导入
        DesignerInstallHelper.mateInitialization(bizInitializationUtil, "install/widget.json");
    }

    @Override
    public void process(AppLifecycleCommand command, Map runModuleMap) {
        if (!doImport()) {
            return;
        }

        log.info("[设计器业务数据导入]");
//        支持远程调用,但是执行的生命周期必须是LifecycleCompletedAllInit或之后. 本地如果安装了设计器,则没有要求
        DesignerInstallHelper.bizInitialization("install/meta.json");

        log.info("[自定义组件业务数据导入]");
//        当开发环境和导入环境的文件服务不互通时, 可通过指定js和css的文件压缩包,自动上传到导入环境,并替换导入组件数据中的文件url
//        WidgetInstallHelper.bizInitialization("install/widget.json", "install/widget.zip");
        WidgetInstallHelper.bizInitialization("install/widget.json");
        return;
    }

    private boolean doImport() {
        // 自定义导入判断. 避免用于设计的开发环境执行导入逻辑
        String[] envs = applicationContext.getEnvironment().getActiveProfiles();
        List envList = Lists.newArrayList(envs);
        return CollectionUtils.isNotEmpty(envList) && (envList.contains("prod"));
    }

}

常见异常问题

启动失败现象

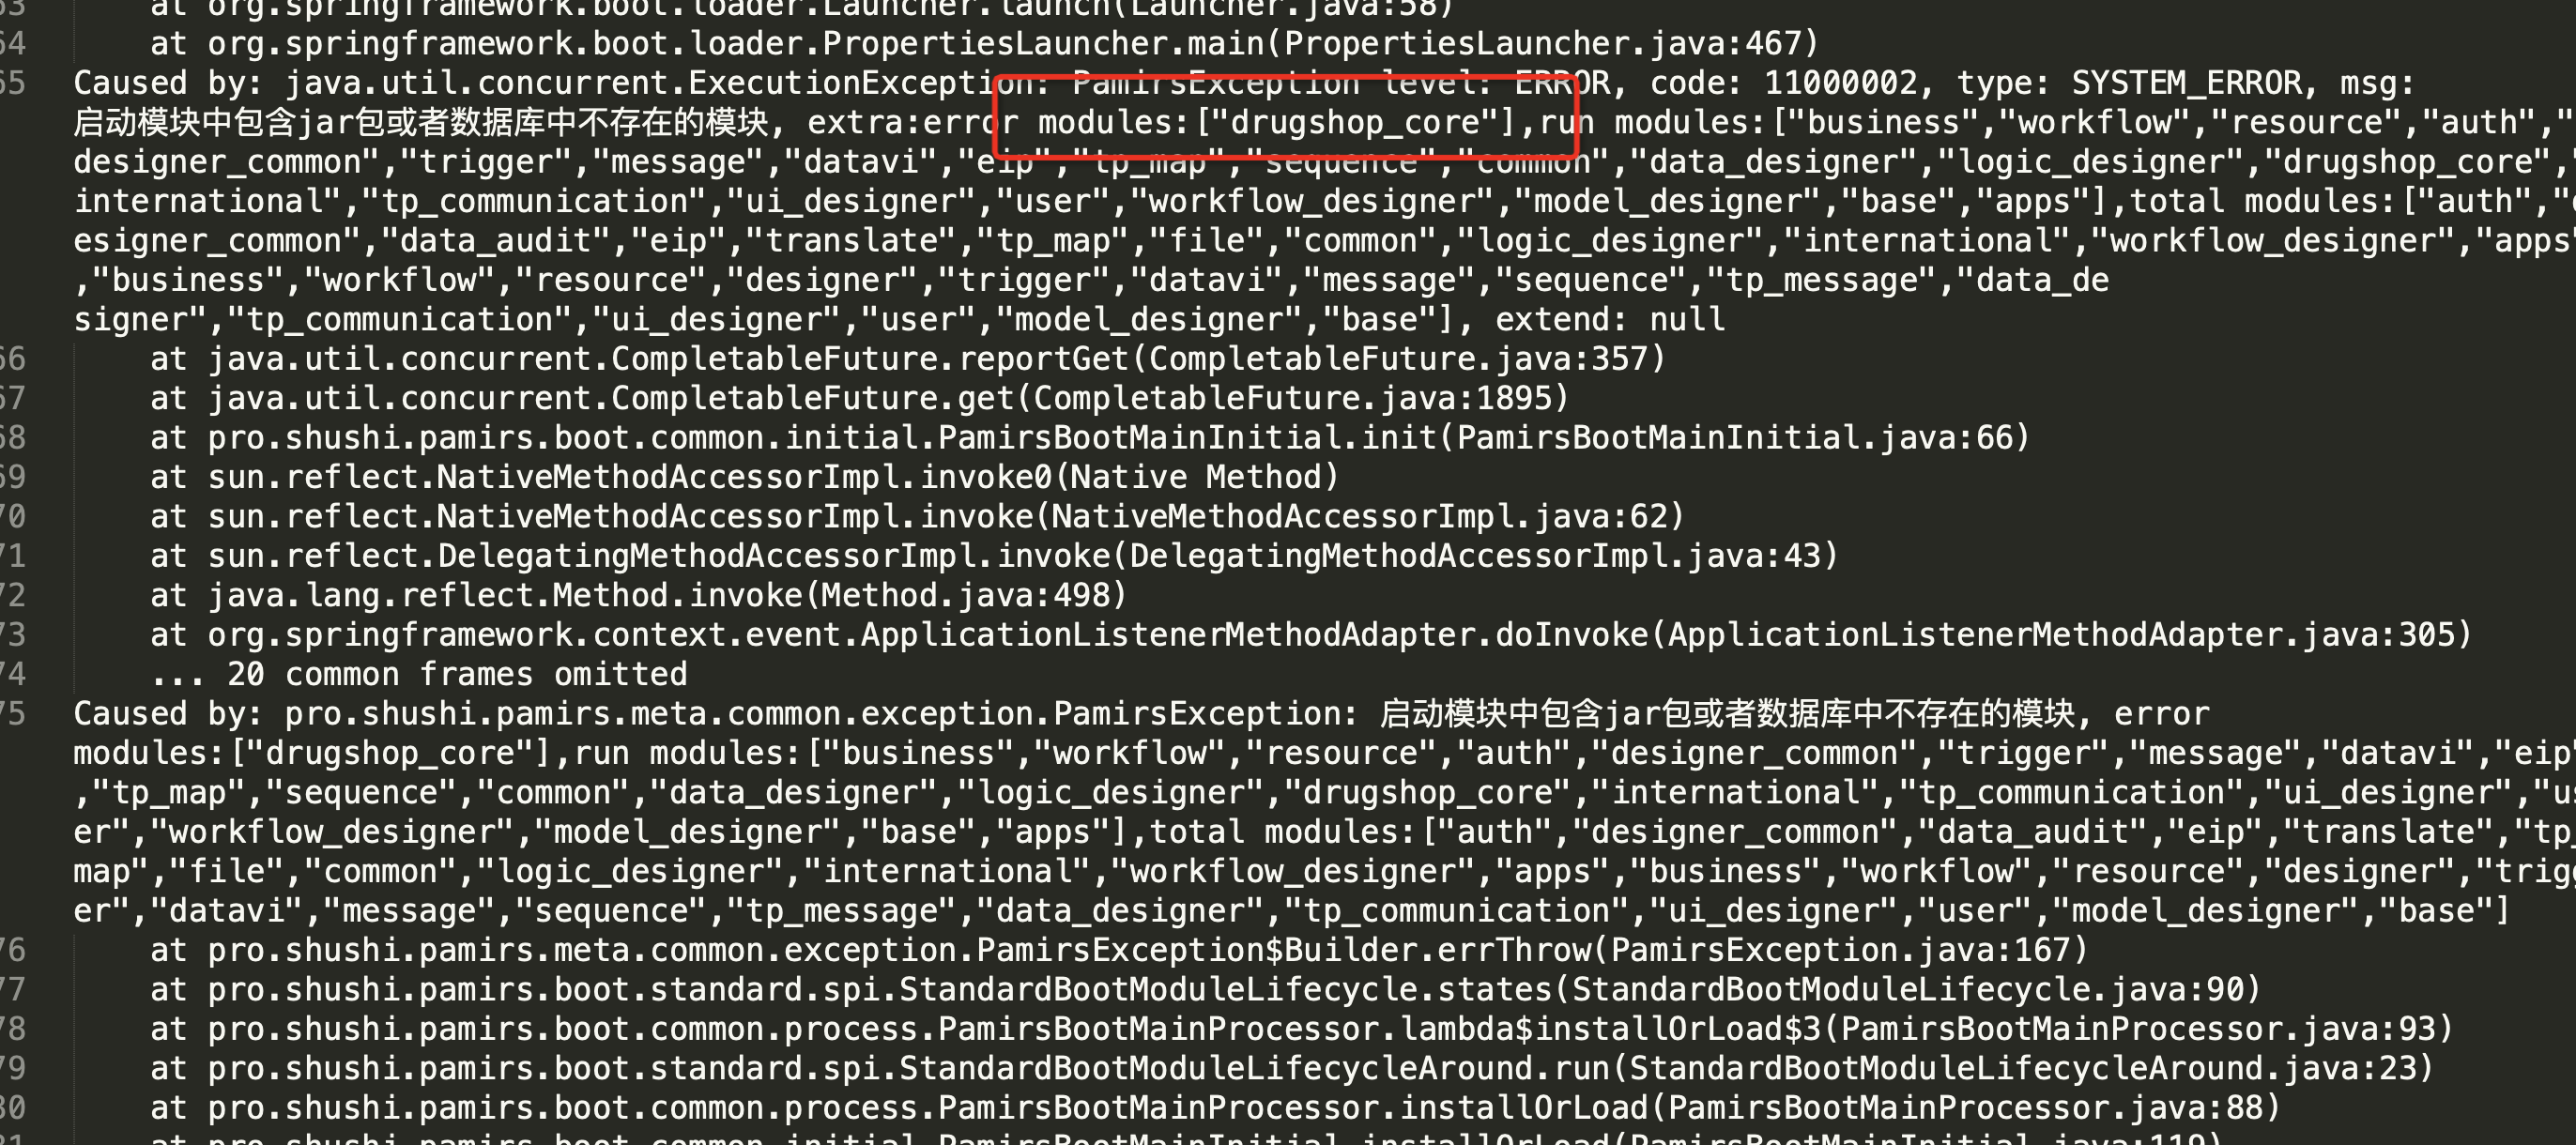
启动设计器的Docker容器,lib包中增加自定义的Jar启动报错,错误信息为:
3.5.5 设计器的结合(改)

问题原因

自定义Jar的包路径不是系统默认扫描路径。 目前系统默认的包扫描路径是:pro.shushi.pamirs 和 pro.shushi.oinone。 自定义扫描路径Spring加载不到

问题解决方法

资料参考:https://itcn.blog/p/214153911.html

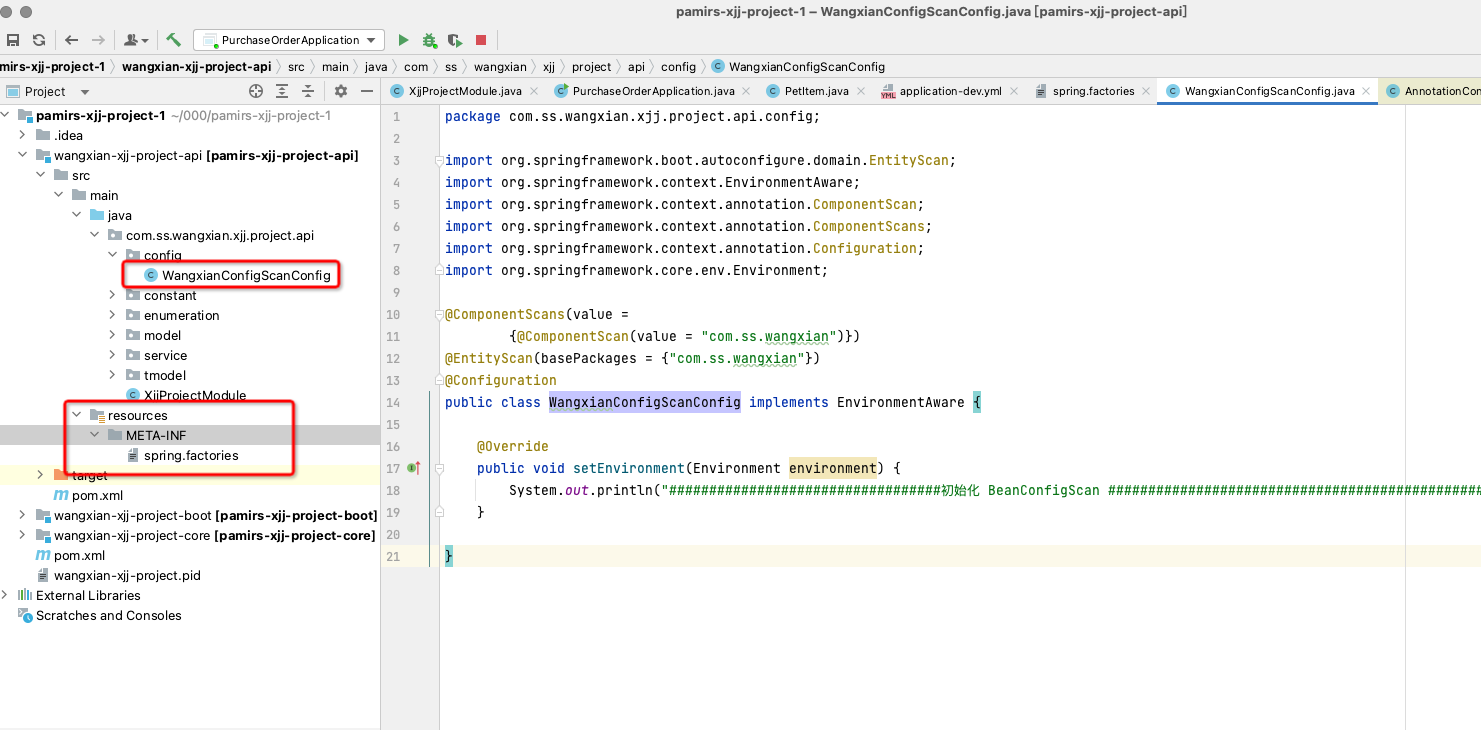
  1. 业务工程API模块 新建一个ScanConfig, resources目录下创建META-INF目录,然后创建spring.factories文件。上述两个文件目录参考如下:
3.5.5 设计器的结合(改)

  1. 文件内容参考

2.1. WangxianConfigScanConfig,根据自己的实际情况修改 命名类和包扫描路径

package com.ss.wangxian.xjj.project.api.config;

import org.springframework.boot.autoconfigure.domain.EntityScan;
import org.springframework.context.EnvironmentAware;
import org.springframework.context.annotation.ComponentScan;
import org.springframework.context.annotation.ComponentScans;
import org.springframework.context.annotation.Configuration;
import org.springframework.core.env.Environment;

@ComponentScans(value =
                {@ComponentScan(value = com.ss.wangxian)})
    @EntityScan(basePackages = {com.ss.wangxian})
    @Configuration
    public class WangxianConfigScanConfig implements EnvironmentAware {

        @Override
        public void setEnvironment(Environment environment) {
            System.out.println(#####初始化 BeanConfigScan #############);
        }

    }

2.2. spring.factories,根据实际情况修改类名和路径

# Auto Configure
org.springframework.boot.autoconfigure.EnableAutoConfiguration=com.ss.wangxian.xjj.project.api.config.WangxianConfigScanConfig
  1. API工程重新打包,然后放入到docker文档中指定的lib包下,重新启动容器。

Oinone社区 作者:史, 昂原创文章,如若转载,请注明出处:https://doc.oinone.top/oio4/9257.html

访问Oinone官网:https://www.oinone.top获取数式Oinone低代码应用平台体验

Like (0)
史, 昂's avatar史, 昂数式管理员
Previous 2024年5月23日
Next 2024年5月23日

相关推荐

  • 3.3.10 字段类型之关系描述的特殊场景

    在3.3.9【字段类型之关系与引用】一文中已经描述了各种关系字段的常规写法,还有一些特殊场景如:关系映射中存在常量,或者M2M中间表是大于两个字段构成。 举例说明关系字段-高级用法 场景描述 PetTalent模型增加talentType字段,PetItem与PetTalent的多对多关系增加talentType(达人类型),PetItemRelPetTalent 中间表维护petItemId、petTalentId以及talentType,PetDogItem和PetCatItem分别重写petTalents 字段,关系中增加常量描述。示意图如下 实际操作步骤: Step1 新增 TalentTypeEnum package pro.shushi.pamirs.demo.api.enumeration; import pro.shushi.pamirs.meta.annotation.Dict; import pro.shushi.pamirs.meta.common.enmu.BaseEnum; @Dict(dictionary = TalentTypeEnum.DICTIONARY,displayName = "达人类型") public class TalentTypeEnum extends BaseEnum<TalentTypeEnum,Integer> { public static final String DICTIONARY ="demo.TalentTypeEnum"; public final static TalentTypeEnum DOG =create("DOG",1,"狗达人","狗达人"); public final static TalentTypeEnum CAT =create("CAT",2,"猫达人","猫达人"); } Step2 PetTalent模型增加talentType字段 package pro.shushi.pamirs.demo.api.model; import pro.shushi.pamirs.demo.api.enumeration.TalentTypeEnum; import pro.shushi.pamirs.meta.annotation.Field; import pro.shushi.pamirs.meta.annotation.Model; @Model.model(PetTalent.MODEL_MODEL) @Model(displayName = "宠物达人",summary="宠物达人",labelFields ={"name"}) public class PetTalent extends AbstractDemoIdModel{ public static final String MODEL_MODEL="demo.PetTalent"; @Field(displayName = "达人") private String name; @Field(displayName = "达人类型") private TalentTypeEnum talentType; } Step3 修改PetItem的petTalents字段,在关系描述中增加talentType(达人类型) @Field.many2many(relationFields = {"petItemId"},referenceFields = {"petTalentId","talentType"},through = "PetItemRelPetTalent") @Field.Relation(relationFields = {"id"}, referenceFields = {"id","talentType"}) @Field(displayName = "推荐达人",summary = "推荐该商品的达人们") private List<PetTalent> petTalents; Step4 PetDogItem增加petTalents字段,重写父类PetItem的关系描述 talentType配置为常量,填入枚举的值 增加domain描述用户页面选择的时候自动过滤出特定类型的达人,RSQL用枚举的name @Field.many2many(relationFields = {"petItemId"},referenceFields = {"petTalentId","talentType"},through = "PetItemRelPetTalent") @Field.Relation(relationFields = {"id"}, referenceFields = {"id","talentType"}) @Field(displayName = "推荐达人",summary = "推荐该商品的达人们") private List<PetTalent> petTalents; Step5 PetCatItem增加petTalents字段,重写父类PetItem的关系描述 talentType配置为常量,填入枚举的值 增加domain描述用户页面选择的时候自动过滤出特定类型的达人,RSQL用枚举的name @Field(displayName = "推荐达人") @Field.many2many( through = "PetItemRelPetTalent", relationFields = {"petItemId"}, referenceFields = {"petTalentId","talentType"} ) @Field.Relation(relationFields = {"id"}, referenceFields = {"id", "#2#"}, domain = " talentType == CAT") private List<PetTalent> petTalents; Step6 清除中间表demo_core_pet_item_rel_pet_talent的数据记录 清除PetItem与PetTalent的多对多中间表demo_core_pet_item_rel_pet_talent的数据记录 Step7 重启看效果 修改达人记录,选择不同达人类型 PetItem、PetCatItem、PetDogItem不同的交互页面

    2024年5月23日
    1.9K00
  • 7.1 设计器总览

    设计器转为非专业研发设计,在Oinone3.0版本中已经完成元数据完整在线化,真正做到低无一体。对于设计器的定位我们开篇就介绍过,它是LCDP的产品化呈现,是冰山露在外面大家看得到的,核心还是在LCDP本身。我们先目睹下设计器的一些产品页面,如您有想体验,可以在Oinone官网注册 模型设计器 Oinone以模型为驱动,当有模型、数据字典、数据编码等设计功能,我们就可以完整地定义产品数据模型,模型设计器整体呈现区别于普通ER图,以当前模型为核心视角展开,可以点击关联模型切换主视角。这样的好处在于突出当前设计,聚焦设计本身。同时模型上预留了几个核心入口如:分类管理、继承拓扑图、页面设计、逻辑设计等。另外我们在体验上区分了专家模式和经典模式,顾名思义,专家模式的功能会更加丰富,对专业知识的要求也会更高。专家模式下一般会增加一些跟业务无关的配置如:索引设置等调优行为 逻辑设计器 从图灵完备的角度上说,要支持功能越完备,使用越复杂。我们优先从图灵完备的角度出发,所以我们第一版逻辑设计器相对比较复杂,第二版本规划中会类似模型设计器推出专家版和经典版。 界面设计器 界面设计器第一版会先支撑后端页面在线自定义,后边将陆续推出前端页面、多端能力。为了支持多端和2C页面的设计,我们对前后端协议做了比较大的改造。目前设计器已经支持完全基于V3的前后端协议。 数据可视化 数据可视化支持从内部系统模型获取数据内容后,根据业务需求自定义图表,目的是为企业提供更高效的数据分析工具。 与市场同类产品相比,我们的数据可视化产品:不需要前置维护数据源、进行数据转换;可智取业务系统模型,系统自动解析选择的模型、接口、表格中的字段后进行数据分析;降低对数据分析人员研发能力要求的同时,也提升了数据分析的效率。 流程设计器 Oinone流程设计器为业务流程和审批流程提供了可自动执行的流程模型:通过定义流转过程中的各个动作、规则,以此实现流程自动化。在Oinone流程设计器中,流程可以跨应用设计,不同应用的模型之间可以通过同一流程执行。

    2024年5月23日
    2.2K00
  • 1.3 Oinone的生态思考

    以“企业级软件生态”的方式去帮助企业建立“一站式的商业智能软件”。 通过观察信息化到数字化的软件行业发展历程(如下图1-3所示),我们可以发现,企业真正需要的是一站式的软件产品。然而,一站式的软件产品往往都是从单个领域的需求满足开始,这在信息化时代和数字化时代都是如此。在信息化时代,以ERP为终点的一站式趋势逐渐形成;而在数字化时代,中台概念的提出则标志着一站式的趋势重新开始。本文将从企业数字化转型所面临的困境出发,探讨Oinone的生态思考。 图1-3 从信息化到数字化软件行业发展历程 1.3.1 与中台的渊源 中台概念的提出标志着企业数字化改造进入了一个新的时代。随着数字化转型不断深入,企业面临着严重的数据割裂、系统隔离等问题。在这样的背景下,“敏捷响应,低成本地快速创新”成为了推动一站式商业智能软件的内在诉求。需要澄清的是,互联网中台架构只是一种企业解决数据割裂、系统隔离,建立一站式商业智能软件的技术概念之一,并不是技术标准。而且这种方式只适用于企业自建模式。在多供应商环境下,则会适得其反,导致建立更复杂的烟囱系统。 阿里于15年提出中台架构概念,抓住了企业数字化转型的核心诉求,即“敏捷响应,低成本快速创新”。然而,阿里作为一家生态公司,在16年时基本上是带着合作伙伴来给企业交付,但由于伙伴对互联网技术的理解和能力的限制,基本上都做得不好,甚至失败。在2017年,阿里成立了原生交付团队,希望能够树立一些标杆案例。我和公司的核心成员也都来自于这个团队。在做完几个客户后,我发现阿里也做不好,但这次做不好的原因不是技术不行或项目上不了线,而是上线以后预期的效果没有达到,其本质是企业的IT组织能力无法驾驭复杂的互联网中台架构。当无法驾驭的时候,所谓的目标“敏捷响应,快速创新”就无从说起了。结果客户会反馈以下三类问题: 不是说敏捷响应吗?为什么改个需求这么慢,不但时间更长,付出的成本也更高了?是因为中台架构需要一定的技术能力和经验才能有效地应用,就像一个只会骑自行车的人给他一辆汽车或者飞机,他也不能驾驭它们,更不用说是手动挡的。 不是说能力中心吗?当引入新供应商或有新场景开发的时候,为什么前期做的能力中心不能支撑了?是因为能力中心是一种面向业务的能力组织方式,它将不同的业务能力抽象出来,以服务的形式对内提供。然而,由于业务场景的差异,不同的业务需要的能力也会不同,因此能力中心需要不断迭代和升级。对于新引入的供应商或新场景开发,需要根据实际情况对能力中心进行定制化和扩展化,但谁来负责呢?新项目的供应商还是客户自己? 不是说性能好吗?为什么我投入的物理资源更多了?是因为中台架构采用微服务来解决单点瓶颈问题,提高系统性能和可用性,但是在初始阶段,投入的资源可能会更多。每个模块至少需要两个实例来保障高可用性,因此物理资源的投入量可能会比以前更多。 1.3.2 找解决方案 在考虑解决方案之前,我们需要思考企业数字化软件的最终状态将是什么样子。目前有两种主要的方案(如下图1-4所示): 第一种是以自建研发团队为核心。中国的大型企业已经开始尝试这种模式,看起来似乎是一个时下比较流行的可行性方案。然而,绝大多数企业由于成本、人才团队等原因而难以坚持下去,只能与供应商合作开发。 第二种是以供应商为核心。由于大多数企业无法选择第一种路径,他们必须接受目前分散的情况,并通过系统集成尽可能拉通各个系统。尽管如此,在数字化时代中,真正意义上的一站式商业智能软件供应商还未出现。 图1-4 企业数字化桎梏和囹圄 对企业来说,这两种方案都非常艰难,但在大规模数字化历程中又不得不做出选择。此外,我们还能清晰看到以下几点: "敏捷响应,低成本地快速创新"成为企业推动一站式商业智能软件的内在诉求 目前没有一家软件供应商能满足企业所有外围商业场景,也不可能有这样的供应商 绝大部分企业需要软件供应商,而不是自建 如何突破这种局面也成为中国软件行业发展的一个机遇。因此,我的思考是: 我们的目标不是依托于提升研发人员的能力,而是降低互联网架构的门槛,让更多企业真正拥有“敏捷响应,低成本快速创新”的能力。 我们的目标不是输出中台方法论,而是提供中台建设的技术平台。 我们的目标不是只服务大企业,而是真正赋能不同IT组织能力的企业,让它们都具备持续创新的能力。 今天,许多中台软件公司告诉企业:“中台是持续演进和快速迭代的过程,因此企业需要组建中台架构团队来实现,而他们则通过中台项目落地将中台建设方法论传授给企业。”这句话的前半部分是正确的,因为我们之前提到企业需要具备敏捷响应业务的能力,即应变能力,因为应变是不断变化的。然而,后半部分是不正确的,因为今天的企业已经有能力组建团队,那么这些中台软件公司到底有什么用呢?企业真的缺少方法论吗?在19年,我就提出了自己的看法:没有低代码能力的中台公司都在收取智商税,都在欺诈,因为很多企业根本找不到足够懂互联网架构的人才。明白流氓在哪里了吗?这些流氓公司赚了很多钱,最后责怪企业无法招到人才,这是企业的责任。因此,仍然认为“最好的赋能是降低门槛,而不是让客户提高技术水平”。 最终,我们得出了一个服务模式的想法:构建企业级的软件生态。企业级软件生态的确切定义是:通过开放的方式,让企业本身以及不同的软件供应商共同参与,遵循相同的技术和数据规范,打造一体化、无需集成的各类企业级软件。如果要打造企业级软件生态,我们列出了六个要点(如下图1-5所示)。 图1-5 打造企业级软件生态需要具备的六大能力 我很幸运地有机会通过“企业级软件生态”的方式,为企业建立“一站式的商业支持平台”提供帮助。我们的Oinone平台结合了低代码开发、通用数据模型和业务产品的优势(如下图1-6所示)。 图1-6 Oinone = 低代码开发平台 + 通用数据模型 + 业务产品 我们对Oinone一站式低代码商业支撑平台展开介绍,它大致分为4部分: 以低代码开发平台为基础,输出具备互联网架构下的软件快速开发标准。这可以帮助企业快速构建符合互联网架构标准的应用程序,从而实现快速响应和低成本创新。 以通用数据模型为基础,满足不同软件基于同一套数据标准的扩展能力。这可以确保不同软件系统之间的数据兼容性和互操作性,避免数据孤岛和信息隔离。 在业务产品层面上,企业和伙伴基于相同的技术标准和数据标准共同提供解决方案。这可以帮助企业和伙伴共同开发出符合标准的商业支撑平台,以提高业务效率和创新能力。 最后是无代码设计器,用于满足项目开展中,超出业务标品范围之外的需求,或者针对标品的临时需求。这可以帮助业务人员在不需要专业软件支持的情况下,自主解决业务需求,并支持部门间的协同工作。 1.3.3 生态建设 Oinone致力于打造全球最大的无需集成的商业应用程序及其生态系统,通过开源内核、汇集数千名开发人员和业务专家,为企业提供成本效益、一体化、模块化的解决方案,解决所有商业需求,让不同技术之间的合作变得简单易行,摆脱烦恼的集成问题。 在客户和场景领域,我们严格限定了自身的专注领域。针对超大型头部企业,我们专注于树立标杆,而对于大、中、小型企业,则交由我们的伙伴来支持。小微企业可以通过我们的开源社区版获得覆盖。在企业数字化转型的核心领域中,我们的解决方案涵盖了数字化交易场景、全渠道订单履约场景、数字化采购场景、数字化营销等产品。在其他领域,我们完全交由伙伴来建设。由于我们自身在企业协同商务领域拥有深厚的背景,因此在该领域提供的产品拥有特别的优势。 企业数字化转型核心领域 图1-7 企业数字化转型核心领域

    2024年5月23日
    2.7K00
  • 3.3.5 模型编码生成器

    在我们日常开发中经常要一些单据生成指定格式的编码,而且现在分布式环境下要考虑的事情会特别多。oinone提供了简易的编码生成能力 一、编码生成器 可以在模型或者字段上配置编码自动生成规则。在进行数据存储时,如果配置了编码自动生成规则的字段值为空,则系统将根据规则自动生成编码。编码自动生成功能是通过序列生成器来支持的。可以在序列生成器生成的序列编码基础上再进行组合配置的功能编码生成最终的编码。序列生成器可以配置初始序列,步长,日期格式,长度。 模型序列生成器(举例) 使用模型编码生成器,需要继承CodeModel或者有Code字段,那么使用Model.Code注解即可。 Step1 为PetShop增加一个@Model.Code注解,并增加一个店铺编码(Code)字段 package pro.shushi.pamirs.demo.api.model; import pro.shushi.pamirs.meta.annotation.Field; import pro.shushi.pamirs.meta.annotation.Model; import java.sql.Time; @Model.model(PetShop.MODEL_MODEL) @Model(displayName = "宠物店铺",summary="宠物店铺",labelFields = {"shopName"}) @Model.Code(sequence = "DATE_ORDERLY_SEQ",prefix = "P",size=6,step=1,initial = 10000,format = "yyyyMMdd") public class PetShop extends AbstractDemoIdModel { public static final String MODEL_MODEL="demo.PetShop"; @Field(displayName = "店铺编码") private String code; @Field(displayName = "店铺名称",required = true) private String shopName; @Field(displayName = "开店时间",required = true) private Time openTime; @Field(displayName = "闭店时间",required = true) private Time closeTime; } 图3-3-5-1 为PetShop增加一个@Model.Code注解 Step2 重启查看效果 进入店铺新增页面新增一个oinone宠物店铺003 图3-3-5-2 示例操作效果图 查看店铺列表页面,新增的记录中店铺编码一列,已经按Model.Code注解要求地生成了 图3-3-5-3 示例操作效果图 Step3 小结 在我们日常开发中经常要一些单据生成指定格式的编码,而且现在分布式环境下要考虑的事情会特别多。oinone提供了简易的编码生成能力,大家可以根据编码注解说明,自行对PetShop模型进行不同配置,来学习编码生成器的知识 字段序列生成器 字段编码生成器,在对应的字段上增加,并使用Field.Sequence注解即可 Step1 为PetShop增加一个字段codeTwo并增加@Field.Sequence注解 package pro.shushi.pamirs.demo.api.model; import pro.shushi.pamirs.meta.annotation.Field; import pro.shushi.pamirs.meta.annotation.Model; import java.sql.Time; @Model.model(PetShop.MODEL_MODEL) @Model(displayName = "宠物店铺",summary="宠物店铺",labelFields = {"shopName"}) @Model.Code(sequence = "DATE_ORDERLY_SEQ",prefix = "P",size=6,step=1,initial = 10000,format = "yyyyMMdd") public class PetShop extends AbstractDemoIdModel { public static final String MODEL_MODEL="demo.PetShop"; @Field(displayName = "店铺编码") private String code; @Field(displayName = "店铺编码2") @Field.Sequence(sequence = "DATE_ORDERLY_SEQ",prefix = "C",size=6,step=1,initial = 10000,format = "yyyyMMdd") private String codeTwo; @Field(displayName = "店铺名称",required = true) private String shopName; @Field(displayName = "开店时间",required = true) private Time openTime; @Field(displayName = "闭店时间",required = true) private Time closeTime; } 图3-3-5-4 为PetShop增加一个字段codeTwo Step2 重启查看效果 进入店铺新增页面新增一个oinone宠物店铺004 图3-3-5-5 示例操作效果图 查看店铺列表页面,新增的记录中店铺编码2一列,已经按Field.Sequence注解要求地生成了 图3-3-5-6 示例操作效果图 二、编码注解说明,模型更多其他注解详见4.1.6【模型之元数据详解】…

    2024年5月23日
    2.5K00
  • 4.1.24 框架之分库分表

    随着数据库技术的发展如分区设计、分布式数据库等,业务层的分库分表的技术终将成老一辈程序员的回忆,谈笑间扯扯蛋既羡慕又自吹地说到“现在的研发真简单,连分库分表都不需要考虑了”。竟然这样为什么要写这篇文章呢?因为现今的数据库虽能解决大部分场景的数据量问题,但涉及核心业务数据真到过亿数据后性能加速降低,能给的方案都还有一定的局限性,或者说性价比不高。相对性价比比较高的分库分表,也会是现阶段一种不错的补充。言归正传oinone的分库分表方案是基于Sharding-JDBC的整合方案,所以大家得先具备一点Sharding-JDBC的知识。 一、分表(举例) 做分库分表前,大家要有一个明确注意的点就是分表字段的选择,它是非常重要的,与业务场景非常相关。在明确了分库分表字段以后,甚至在功能上都要做一些妥协。比如分库分表字段在查询管理中做为查询条件是必须带上的,不然效率只会更低。 Step1 新建ShardingModel模型 ShardingModel模型是用于分表测试的模型,我们选定userId作为分表字段。分表字段不允许更新,所以这里更新策略设置类永不更新,并在设置了在页面修改的时候为readonly package pro.shushi.pamirs.demo.api.model; import pro.shushi.pamirs.boot.base.ux.annotation.field.UxWidget; import pro.shushi.pamirs.boot.base.ux.annotation.view.UxForm; import pro.shushi.pamirs.meta.annotation.Field; import pro.shushi.pamirs.meta.annotation.Model; import pro.shushi.pamirs.meta.enmu.FieldStrategyEnum; @Model.model(ShardingModel.MODEL_MODEL) @Model(displayName = "分表模型",summary="分表模型",labelFields ={"name"} ) public class ShardingModel extends AbstractDemoIdModel { public static final String MODEL_MODEL="demo.ShardingModel"; @Field(displayName = "名称") private String name; @Field(displayName = "用户id",summary = "分表字段",immutable=true/* 不可修改 **/) @UxForm.FieldWidget(@UxWidget(readonly = "scene == 'redirectUpdatePage'"/* 在编辑页面只读 **/ )) @Field.Advanced(updateStrategy = FieldStrategyEnum.NEVER) private Long userId; } 图4-1-24-1 新建ShardingModel模型 Step2 配置分表策略 配置ShardingModel模型走分库分表的数据源pamirsSharding 为pamirsSharding配置数据源以及sharding规则 a. pamirs.sharding.define用于oinone的数据库表创建用 b. pamirs.sharding.rule用于分表规则配置 pamirs: load: sessionMode: true framework: system: system-ds-key: base system-models: – base.WorkerNode data: default-ds-key: pamirs ds-map: base: base modelDsMap: "[demo.ShardingModel]": pamirsSharding #配置模型对应的库 图4-1-24-2 指定模型对应数据源 pamirs: sharding: define: data-sources: ds: pamirs pamirsSharding: pamirs #申明pamirsSharding库对应的pamirs数据源 models: "[trigger.PamirsSchedule]": tables: 0..13 "[demo.ShardingModel]": tables: 0..7 table-separator: _ rule: pamirsSharding: #配置pamirsSharding库的分库分表规则 actual-ds: – pamirs #申明pamirsSharding库对应的pamirs数据源 sharding-rules: # Configure sharding rule ,以下配置跟sharding-jdbc配置一致 – tables: demo_core_sharding_model: #demo_core_sharding_model表规则配置 actualDataNodes: pamirs.demo_core_sharding_model_${0..7} tableStrategy: standard: shardingColumn: user_id shardingAlgorithmName: table_inline shardingAlgorithms: table_inline: type: INLINE props: algorithm-expression: demo_core_sharding_model_${(Long.valueOf(user_id) % 8)} props: sql.show: true 图4-1-24-3 分库分表规则配置 Step3 配置测试入口 修改DemoMenus类增加一行代码,为测试提供入口 @UxMenu("分表模型")@UxRoute(ShardingModel.MODEL_MODEL) class ShardingModelMenu{} 图4-1-24-4 配置测试入口 Step4 重启看效果 自行尝试增删改查 观察数据库表与数据分布 图4-1-24-5 自行尝试增删改查 图4-1-24-6 观察数据库表与数据分布 二、分库分表(举例) Step1 新建ShardingModel2模型 ShardingModel2模型是用于分库分表测试的模型,我们选定userId作为分表字段。分库分表字段不允许更新,所以这里更新策略设置类永不更新,并在设置了在页面修改的时候为readonly package pro.shushi.pamirs.demo.api.model; import pro.shushi.pamirs.boot.base.ux.annotation.field.UxWidget; import pro.shushi.pamirs.boot.base.ux.annotation.view.UxForm; import…

    2024年5月23日
    1.6K00

Leave a Reply

Please Login to Comment