
报表

1. 业务场景

报表不局限于表格的样式,还能以各式各样的图表形式展现各项汇总数据 这有利于管理者更为直观地了解公司的经营情况,便于后续进行分析,提高对公司的管理水平。

2. 操作流程

1)进入数据可视化,进入报表tab,维护分组信息;

2)在二级分组名称后点击“+”【添加报表】,对报表进行编辑设计;

3)创建完成后可以【编辑】报表标题、备注;

4)需要通过【选择图表、创建图表】完善报表内容;

5)完善后可以点击【发布】报表,则报表此时可以被引用;

6)如果报表有更新,则可以点击【更新发布】,使业务系统引用对报表变为最新的报表信息;

7)如果报表数据不再可以公开使用,则需要通过【隐藏】功能将报表的引用权限收起,此时数据大屏、前端业务系统均不可再引用该报表,但不影响已被引用的报表;

8)隐藏后可以【取消隐藏】,报表恢复隐藏前的状态和功能,可以被引用。

3. 操作流程图解

3.1 创建分组

1)操作流程:创建分组

2)操作路径:数据可视化-报表-创建分组

3)点击搜索框后的「+」创建一级分组,输入一级分组名称后,点击一级分组后的「+」创建二级分组,输入二级分组名称后,此时分组创建完成,可以在二级分组下创建报表

3.2 编辑分组名称

1)操作流程:选择分组-编辑分组名称

2)操作路径:数据可视化-报表-编辑分组名称

3)鼠标移动至需要修改的分组上,点击出现的「编辑图标」,可以修改分组名称,修改后分组名称实时更新

3.3 删除分组

1)操作流程:选择分组-删除分组

2)操作路径:数据可视化-报表-删除分组

3)鼠标移动至需要删除的分组上,当分组下无报表时出现「删除图标」,可以点击图标后删除分组,删除一级分组时对应所有的二级分组也会被删除,删除后消失,只要分组下没有报表的分组才能直接删除成功

3.4 创建报表

1)操作流程:选择二级分组-创建报表

2)操作路径:数据可视化-报表-二级分组-创建报表

3)鼠标移动至需要创建报表的二级分组上,出现「+」,点击图标后=需要填写报表标题;

a. 报表标题:最大支持20个字,支持汉字、数字、大小写字母、-;同个一级分组下不允许重复;

4)创建后可以选择报表需要展示的图表

3.5 删除报表

1)操作流程:选择报表-删除报表

2)操作路径:数据可视化-报表-二级分组-报表名称-删除图表

3)未发布或者已发布但没有被隐藏的报表,并且没被前端或者数据大屏引用,才展示报表菜单名称后的删除图标

4)删除报表后报表消失

3.6 选择图表

1)操作流程:选择报表-为报表选择图表

2)操作路径:数据可视化-报表-二级分组-报表名称-选择图表

3)选择单个未发布或者已发布但没有被隐藏的报表,点击【选择图表】,弹出“选择图表”弹窗,对该报表需要展示的图表进行选择

a. 需要选择图表的一级分组后才能选择图表;

b. 可以多选图表,选择的图表只能是已选一级分组下的未隐藏的未被选择的图表;选择一个二级分组时,默认该二级分组下的图表会全部被选中,图表会按照选中的顺序展示在报表列表;

4)选择图表后,报表信息保持展示图表的最新效果;如果图表更新了,但是报表没有发布最新,则报表在前端展示的仍为最近发布的版本;

5)如果图表中存在超过一行的图内筛选项,则在报表处原始的图表尺寸只能查看一行图内筛选项,需要根据图表在报表处的等比拖动效果展示更多的图内筛选项
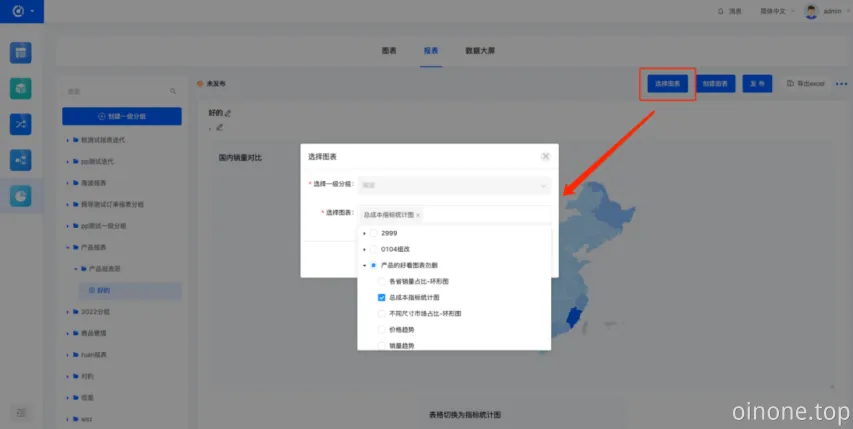
image.png

3.7 创建图表

1)操作流程:选择报表-创建图表

2)操作路径:数据可视化-报表-二级分组-创建图表

3)选择单个未发布或者已发布但没有被隐藏的报表,点击【创建图表】,弹出“创建图表”弹窗,需要填写图表标题、模型、方法;

a. 图表标题:最大支持20个字,支持汉字、数字、大小写字母、-;同个一级分组下不允许重复;

b. 模型:需要选择来源数据对应的模型;

c. 方法:选择模型后需要选择方法,方法是用来提取模型数据的逻辑;

4)选择成功后进入图表设计页面,创建图表保存后返回,返回到当前报表页面,新创建的图表展示在报表的第一个位置
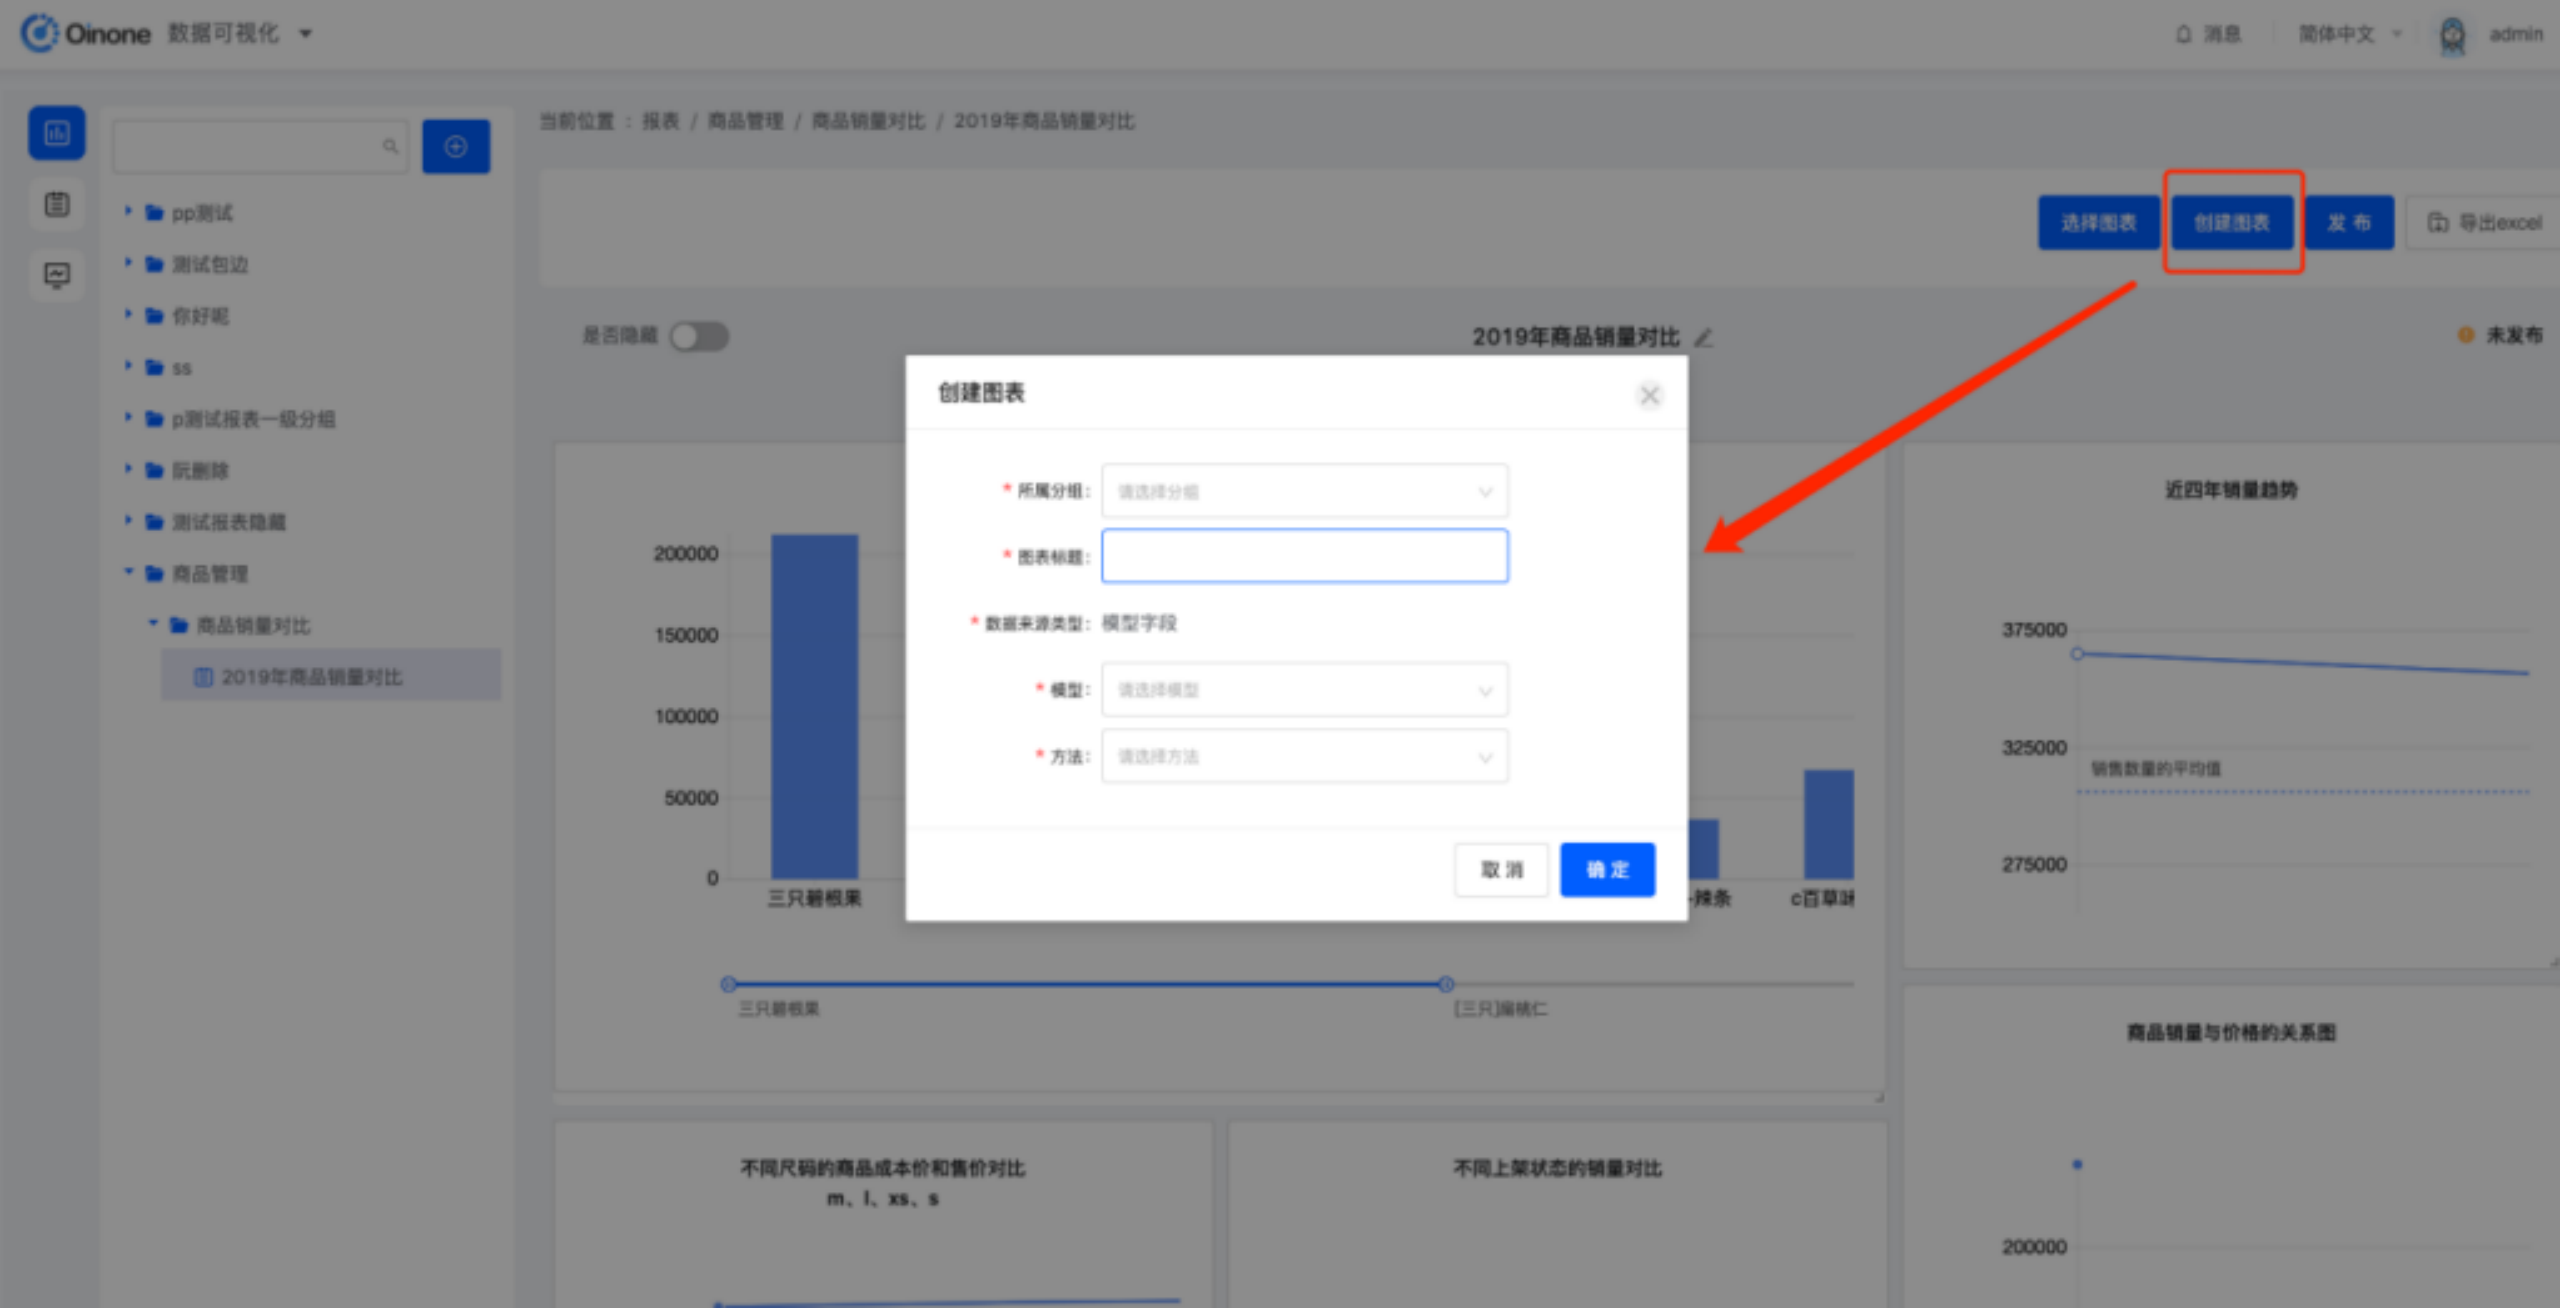
image.png

3.8 拖拽图表

1)操作流程:选择报表-拖拽图表

2) 操作路径:数据可视化-报表-二级分组-报表名称-拖拽图表

3)所有的报表均可拖拽图表,拖拽时需要选择图表,可以上下左右等比拖动,图表的内容也会根据拖动的比例进行缩放,展示全部的被遮挡图表内容

4)拖拽后实时生效,报表信息保持展示最新效果

3.9 移除图表

1)操作流程:选择报表-移除图表

2)操作路径:数据可视化-报表-二级分组-报表名称-移除图表

3)未发布或者已发布但没有被隐藏的报表,并且没被前端或者数据大屏引用,此时可以针对不需要的图表进行移除

4)选择移除后不展示在报表中,不影响原图表

5)报表移除图表后实时更新,更新发布后,前端可以展示最新的报表信息,如果未发布,则仅数据大屏可展示最新的报表信息,前端仍为最近发布的报表

3.10 设置报表筛选项

1)操作流程:选择报表-设置报表筛选项

2)操作路径:数据可视化-报表-二级分组-报表名称-更多-报表筛选项-添加

3)添加时选择筛选项字段的类型,关联每个图表对应的字段,一个图表只能关联一个

4)关联后可以按关联字段查询图表数据
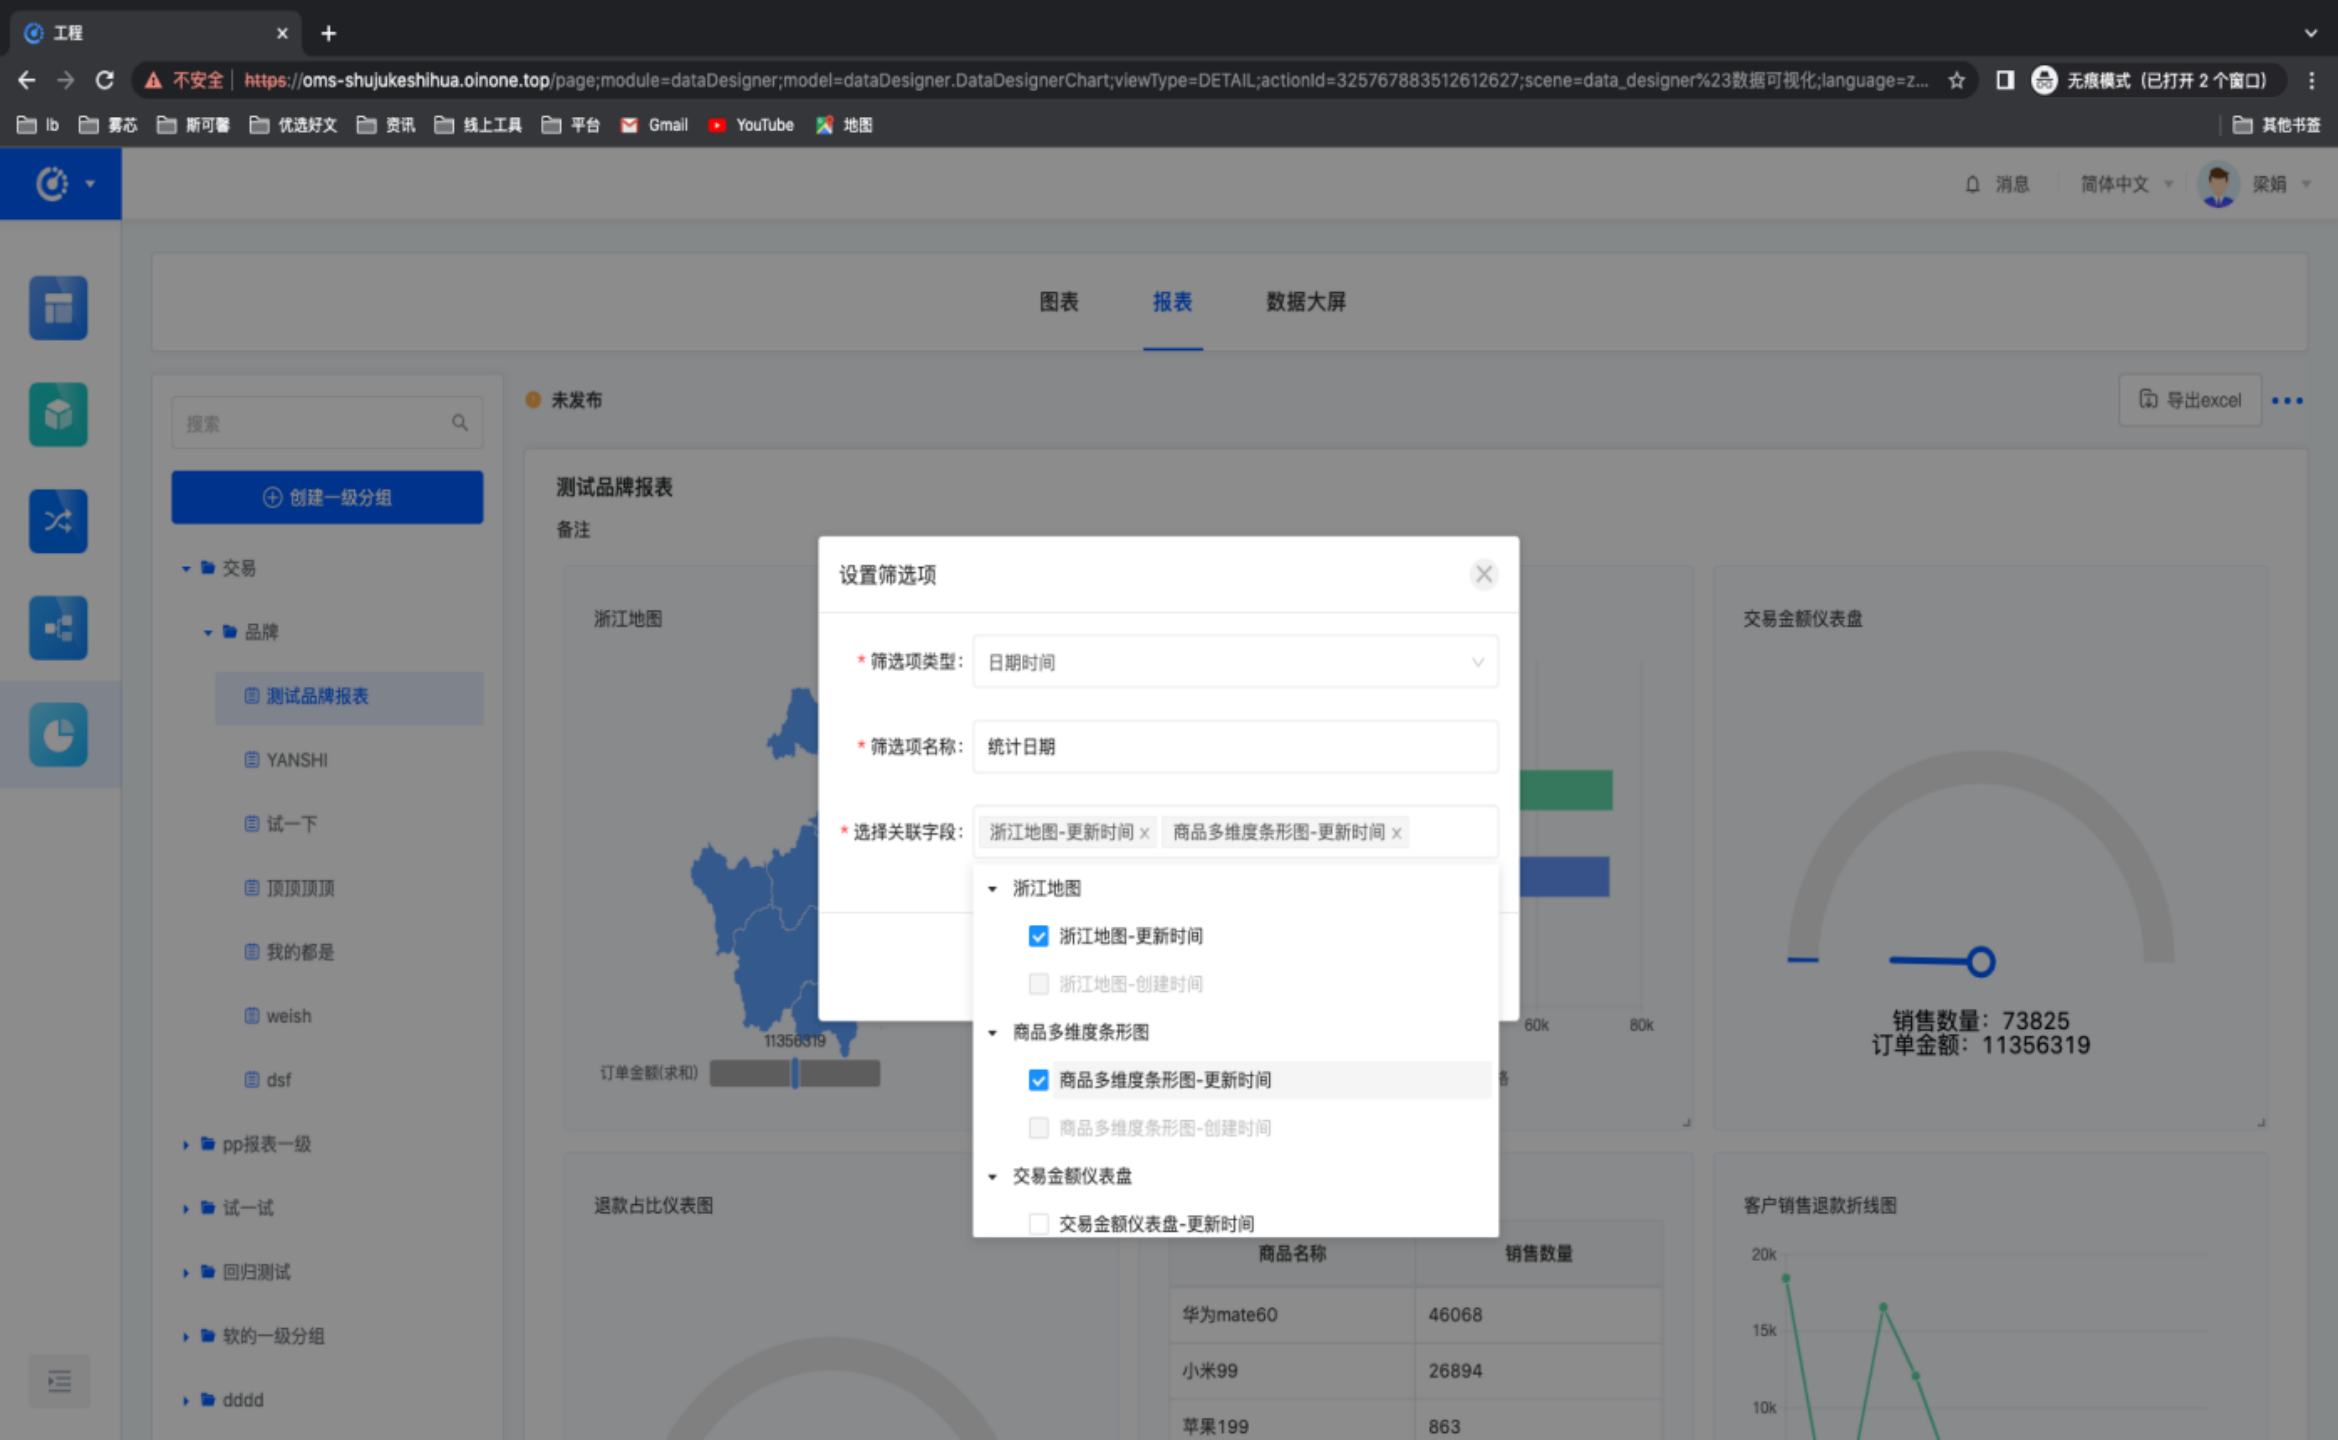
image.png

3.11 发布

1)操作流程:选择报表-发布报表

2)操作路径:数据可视化-图表-二级分组-报表-发布

3)选择单个未发布且没有被隐藏的报表,点击【发布】按钮,报表发布后可以被前端引用,报表状态变为已发布,展示最近发布时间;

4)如果报表发布后有更新内容,会展示的更新类型:更新报表信息/更新图表内容/选择图表/移除图表
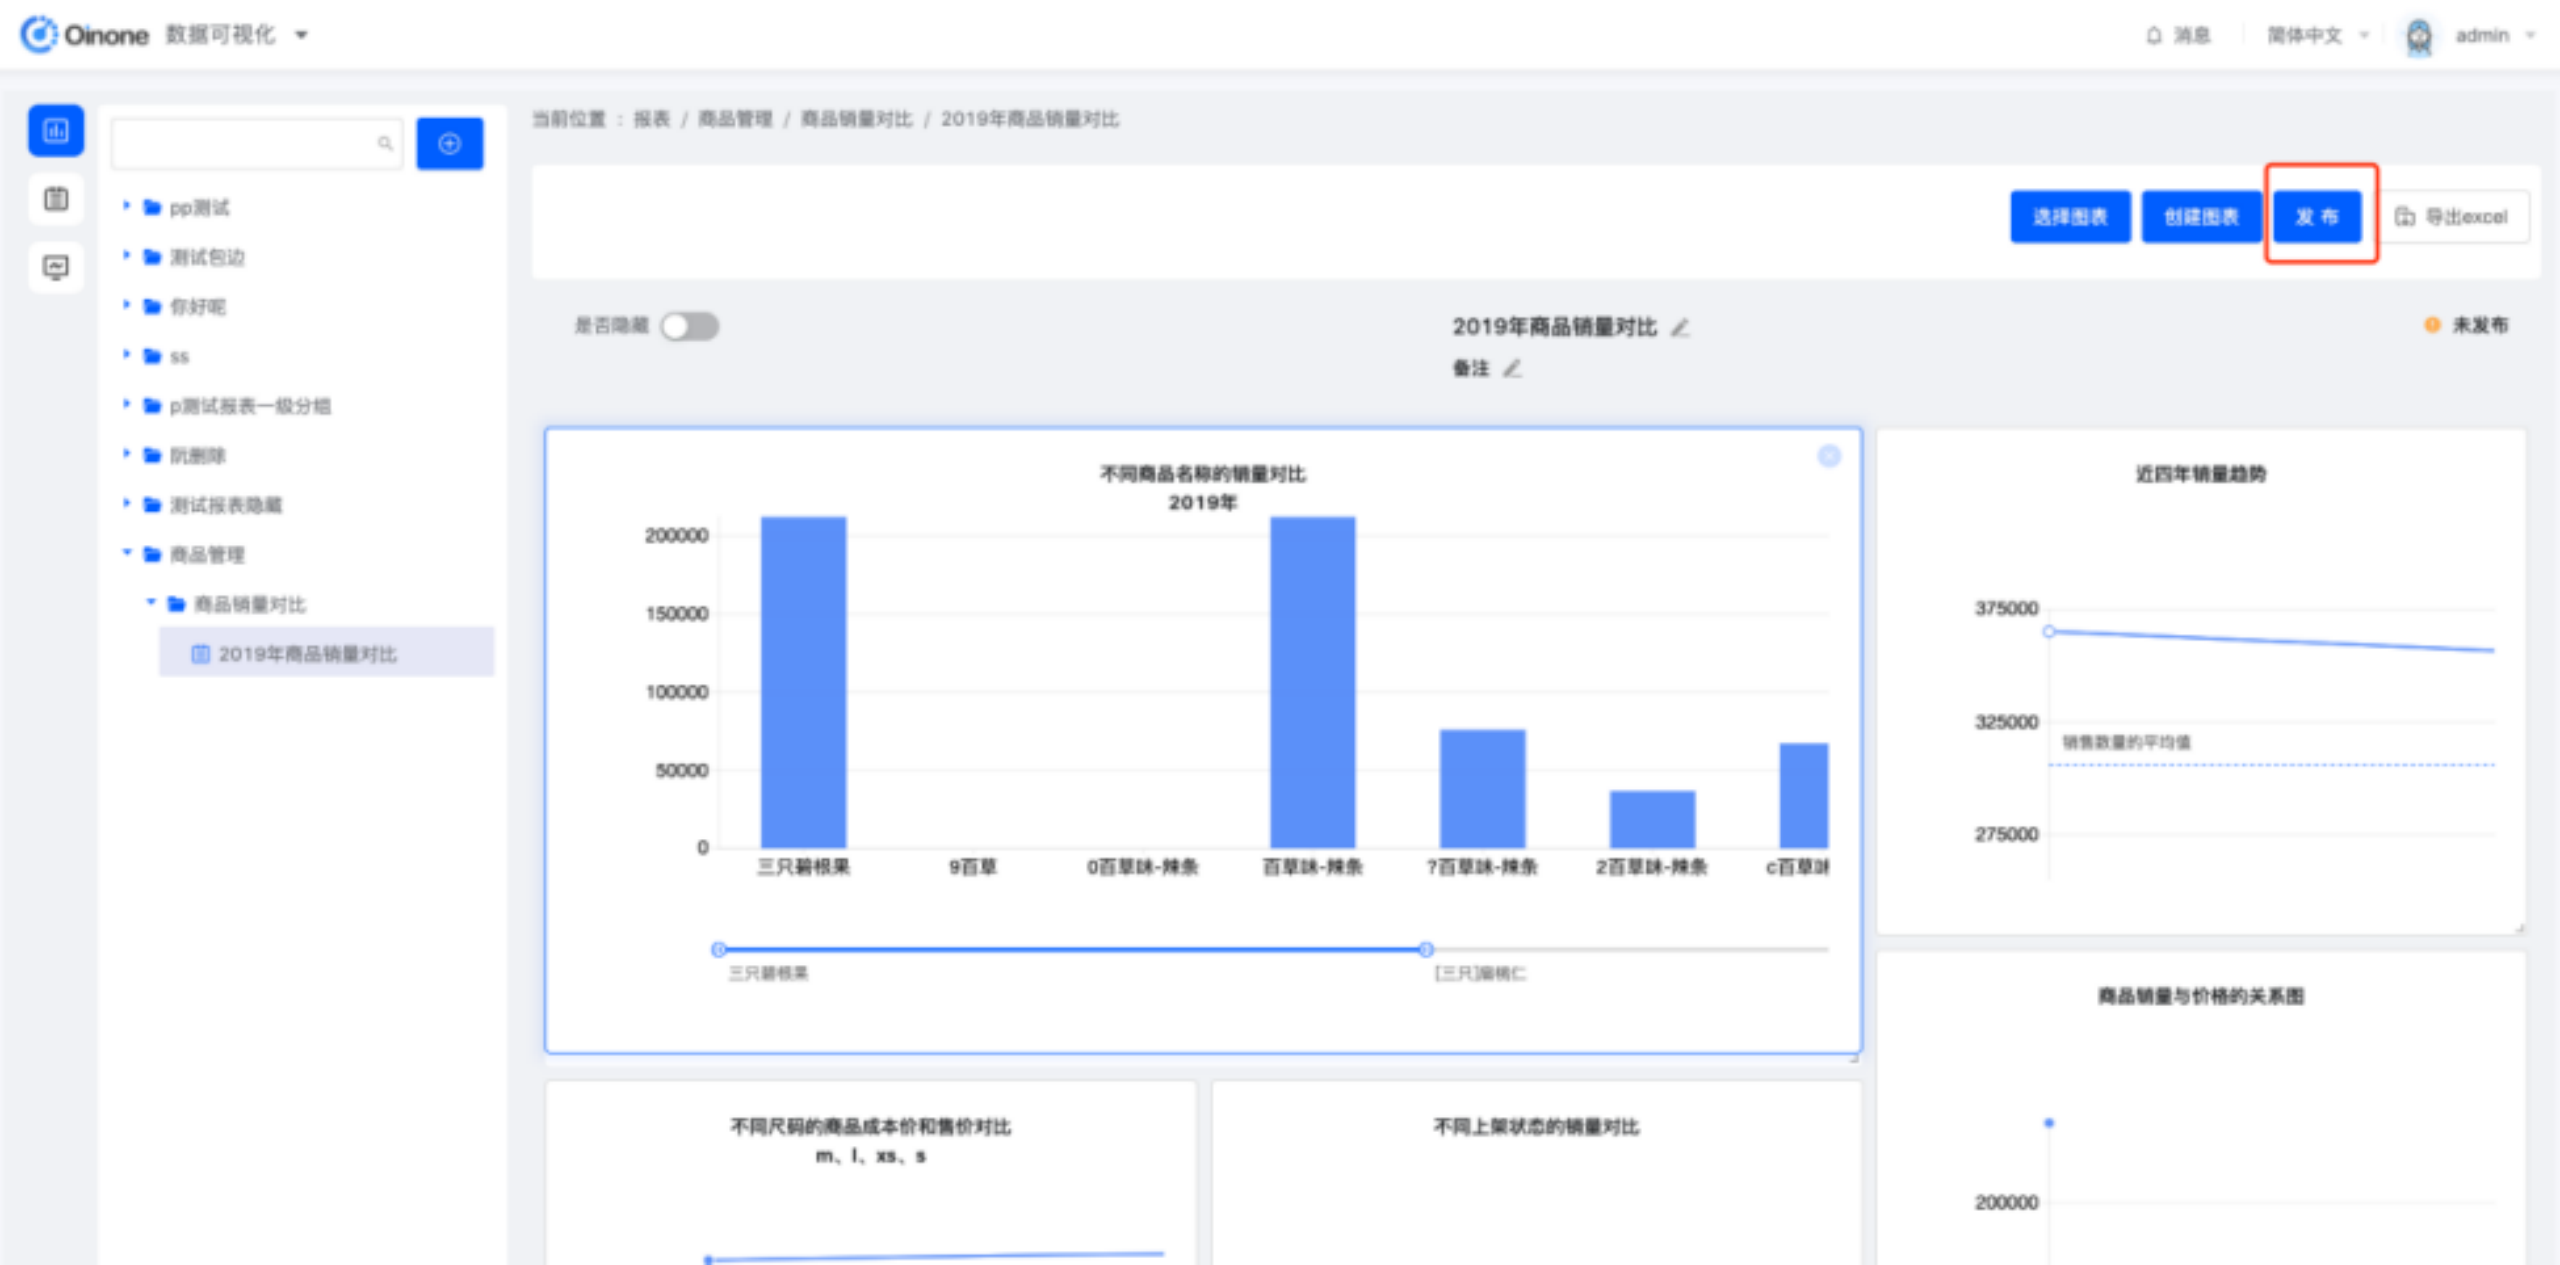
image.png

3.12 查看最近一次发布的版本

1)操作流程:选择报表-查看最近一次发布的版本

2)操作路径:数据可视化-报表-二级分组-报表名称-查看最近一次发布的版本

3)当报表发布后有更新,在最近发布时间左侧展示【查看】,在最近发布时间下展示更新的类型,点击查看可以查看最近发布的版

3.13 更新发布

1)操作流程:选择报表-更新发布报表

2)操作路径:数据可视化-报表-二级分组-报表名称-更新发布报表

3)选择单个已发布且没有被隐藏的报表,并且该报表在上次发布后有所更新,可以点击【更新发布】按钮,将最新的报表内容发布至业务系统,业务系统引用的报表为最新内容;

4)如果更新了内容,但未点击更新发布,则前端业务系统查看的报表仍为最近发布的报表
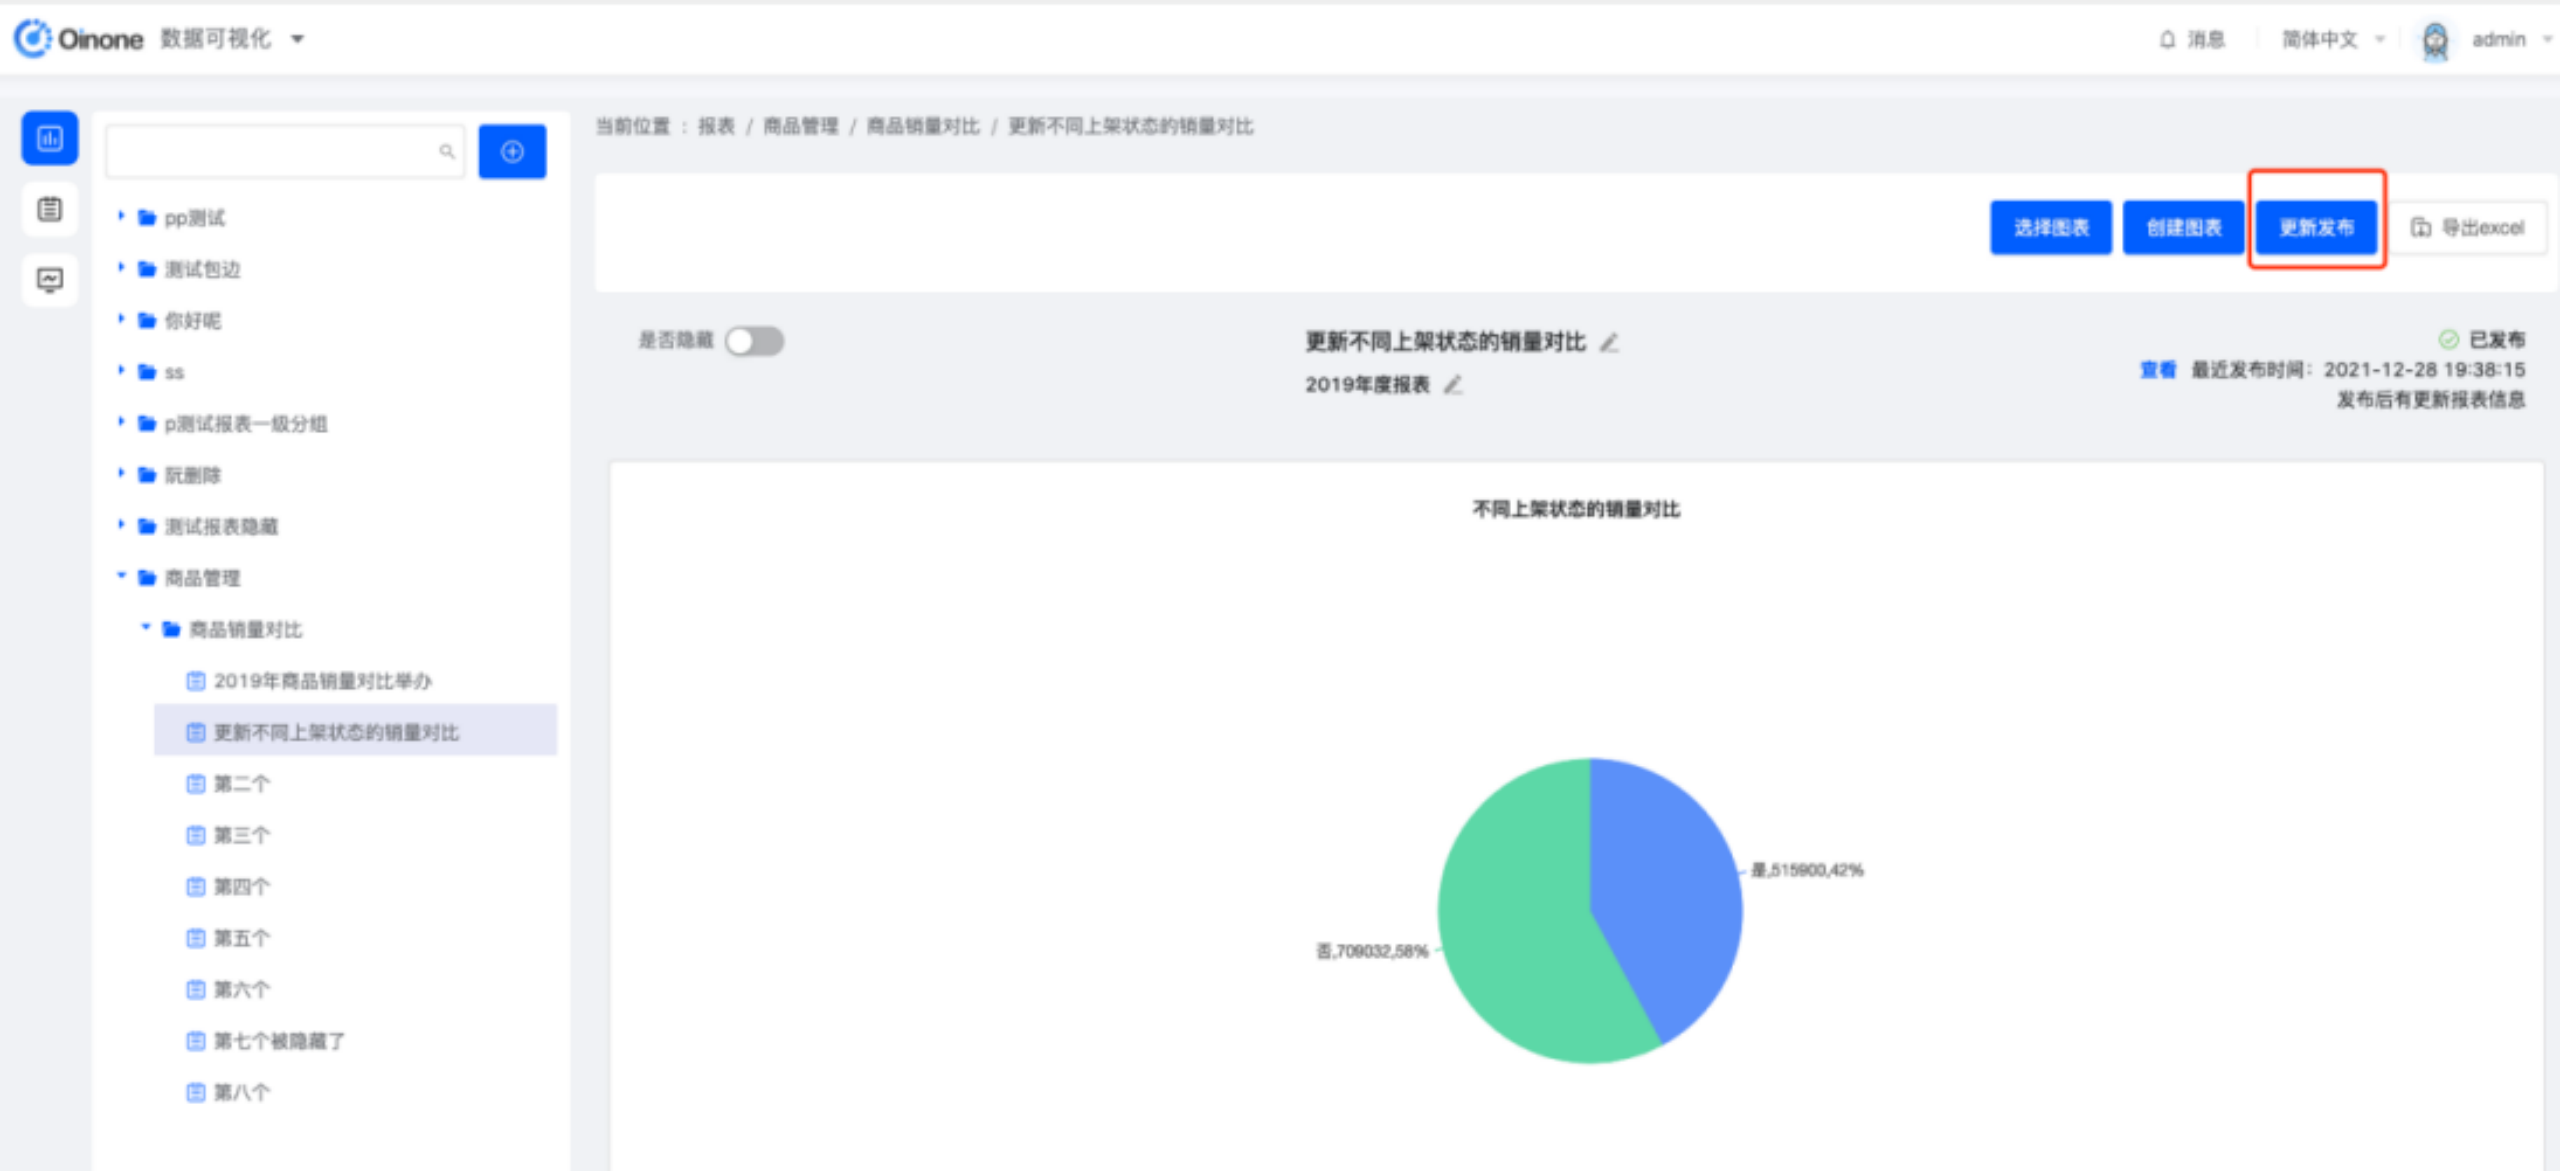
image.png

3.14 隐藏

1)操作流程:选择报表-隐藏报表

2)操作路径:数据可视化-报表-二级分组-报表名称-隐藏报表

3)报表默认不隐藏,可以切换是否隐藏=是

a. 未发布的报表,较隐藏前,不可以操作【发布】,可以【取消隐藏】;

b. 已发布的图表,较隐藏前,只能操作【导出图片、导出excel、取消隐藏】;

c. 隐藏后的报表不可以被引用,但不影响已经被引用的数据

3.15 取消隐藏

1) 操作流程:选择报表-取消隐藏报表

2) 操作路径:数据可视化-报表-二级分组-报表名称-取消隐藏报表

3) 隐藏后的报表可以取消隐藏,切换是否隐藏=否,取消隐藏后,报表恢复隐藏前的状态和功能,可以被引用

3.16 查看引用

1)流程:选择报表-查看被哪些页面引用

2)操作路径:数据可视化-报表-二级分组-报表-更多-查看引用

3)选择具体的报表,查看当前报表被引用的所有信息

3.17 不允许别人编辑

1)流程:选择报表-不允许别人编辑

2)操作路径:数据可视化-报表-二级分组-报表-更多-不允许别人编辑

3)选择自己创建的报表,对报表是否允许其他人编辑进行设置;如果设置为不允许,则其他人无法编辑报表

3.18 不允许别人引用

1)流程:选择图表-更多-不允许别人引用

2)操作路径:数据可视化-报表-二级分组-报表-更多-不允许别人引用

3)选择自己创建的报表,对报表是否允许他人引用进行设置;如果设置为不允许,则其他人无法引用到该报表

3.19 导出图片

1) 操作流程:选择报表-导出图片

2) 操作路径:数据可视化-报表-二级分组-报表名称-导出图片

3) 选择报表后,点击【导出图片】按钮可以将当前报表导出为图片

3.20 导出EXCEL

1)操作流程:选择报表-导出EXCEL

2)操作路径:数据可视化-报表-二级分组-报表名称-报表导出EXCEL

3)选择报表后,点击【导出EXCEL】按钮可以将当前报表导出为EXCEL

Oinone社区 作者:史, 昂原创文章,如若转载,请注明出处:https://doc.oinone.top/oio4/9423.html

访问Oinone官网:https://www.oinone.top获取数式Oinone低代码应用平台体验

Like (0)
史, 昂's avatar史, 昂数式管理员
Previous 2024年6月20日 am9:49
Next 2024年6月20日 am9:49

相关推荐

  • 7.3.2 原业务加审批流程

    场景说明 场景描述:全员营销标准产品的功能并未有任务发放的审批流,在实际执行中,当营销专员配置好任务后,需部门领导对整个活动如该任务内容、形式、参与人员进行审批。 业务需求:在发布任务这个流程中增加审批节点。 实战训练 Step1 原业务分析 点击菜单【任务中心】通过URL上的model参数找到对应模型编码为【gemini.biz.GeminiTaskProxy】 进入模型设计器主页面,应用选择【全员营销】、选择【系统模型】、通过搜索关键字【任务】选择【Gemini任务代理】,展示方式从图模式切换到表单模式,对比【模型编码】 但目前模型为代理模型,代理模型是用于代理存储模型的数据管理器能力,同时又可以扩展出非存储数据信息的交互功能的模型。因为在代理模型中新增的字段都是非存储字段,所以如果要增加【审核状态】的字段一定以要在存储模型增加。其父模型的查看有两种方式 表单模式下可以直接看父模型 在图模式和表单模式下点击继承关系 点击【Gemini任务】,进入【Gemini任务】的模型设计界面,可以看出该模型所在模块为【全员营销核心业务】,从【系统字段】中找到【任务状态】字段,点击查看字段详情,我们可以看到【业务类型】为数据字典,字典类型为【任务状态】。 在模型设计器的管理页面上方点击【数字字典】选项卡,模块选择为【全员营销核心业务】,选择【系统字典】就可以查看到【任务状态】数字字典 总结如下: 给【Gemini任务】模型增加一个【任务审批状态】,记录审批状态 在任务创建的时候,修改【任务状态】为【关闭】确保任务未审批通过的时,用户无法操作该任务。 审批通过后,恢复【任务状态】为【初始化】 我们先来整理下核心流程即:任务审批流程。 Step2 利用模型设计器设计模型 在模型设计器的管理页面上方点击【数字字典】选项卡,模块选择为【全员营销核心业务】,点击添加【数据字典】按钮,设置对应数据项 设置【字典名称】为【审批状态】 设置【字典项类型】为【文本】 通过【添加数据字典项】按钮增加对应数据字典项,如审核中、审核失败、审核成功 在模型设计器的管理页面上方点击【模型】选项卡,模块选择为【全员营销核心业务】,选择【系统模型】、搜索任务选择【Gemini任务】,点击添加字段 为模型【Gemini任务】添加字段 设置【字段名称】为【任务审批状态】 设置【字段业务类型】为数据字典,并选择关联数据字典为【任务审批状态】 最后点击【创建】按钮完成操作 回到【Gemini任务】设计区,我们可以看到在模型的【自定义字段】选项卡下方多了一个【任务审批状态】字段 Step3 利用界面设计器,设计出必要的审核页面 进入界面设计器,应用选择全员营销,模型选择【Gemini任务】,点击添加页面下的直接创建 设置页面标题、模型(自动带上可切换)、业务类型(运营管理后续会扩展其他类型)、视图类型(表单)后点击确认按钮进入【Gemini任务】表单设计页面 进入页面设计器,对【Gemini任务】表单页面进行设计(更多细节介绍,请参考界面设计产品使用手册) 左侧为物料区:分为组件、模型。 【组件】选项卡下为通用物料区,我们可以为页面增加对应布局、字段(如同在模型设计器增加字段)、动作、数据、多媒体等等 【模型】选项卡下为页面对应模型的自定义字段、系统字段、以及模型已有动作 中间是设计区域 右侧为属性面板,在设计区域选择中组件会显示对应组件的可配置参数 在左侧【组件】选项卡下,拖入布局组件【分组】,并设置组件【标题属性】为基础信息 在左侧【模型】选项卡下,分别系统字段中的【任务标题】、【任务开始时间】、【任务结束时间】、【视频标题】、【视频风格】、【任务描述】拖入【基础信息】分组,并点击【任务描述】,在右侧属性面板的【交互】分组中设置宽度为1。最后别忘了点击【发布】按钮完成页面的发布 Step4 通过流程设计器,设计对应业务流程 进入流程设计器,点击【创建】按钮 注意:流程中需要获取【关系字段】的除关联字段(一般为ID)以外的字段需要通过【数据获取】节点单独获取【关系字段】的对象数据。所以在流程设计中经常会用到【数据获取】节点 左上角编辑流程名称为【任务审批流程】,点击第一个【触发】节点,触发方式选择模型触发,模型选择【Gemini任务】,触发场景选择【新增或更新数据时】,【筛选条件】设置为【任务审批状态】为空或【任务审批状态】等于【审核中】,点击该节点的【保存】按钮 点击流程图节点间的【+】图标选择增加【获取数据】节点,或者拖动左侧物料区【获取数据】到特定的【+】图标 点击【获取数据】,在右侧属性面板中设置【获取数据条数】为多条,选择模型为【Gemini用户任务实例】,点击【筛选条件】的【{X}】图标,进行数据获取的条件设置 选择条件字段为【任务ID】条件操作符为【等于】,条件为变量的导购字段的ID。当上下文只有一个变量时默认不需要选择,这里默认的是【模型触发:[Gemini任务]】,设置好以后点击确认,回到属性面板设置【未获取到数据时执行方式】为【终止流程】,并点击节点【保持】按钮 增加【更新数据】节点,在右侧属性面板中 【更新模型】选择【模型触发:[Gemini任务]】 【字段列表】点击【创建】按钮 字段选择 更新【任务状态】字段 表达式设置为:【已关闭】。 【字段列表】点击【创建】按钮 字段选择 更新【任务审核状态】字段 表达式设置为:【审核中】。 最终完成的【模型触发:[Gemini任务]】更新设置 a. 【模型触发:[Gemini任务]】的【任务状态】字段等于数字字典的【已关闭】,任务审核状态为【审核中】 b. 最后点击节点【保持】按钮。 再增加【更新数据】节点,在右侧属性面板中 【更新模型】选择【获取数据[Gemini用户任务实例]】 【字段列表】点击【创建】按钮 字段选择 更新【任务状态】字段 表达式设置为:【已关闭】。 最终完成的【获取数据[Gemini用户任务实例]】更新设置 a. 【获取数据[Gemini用户任务实例]】的【任务状态】字段等于数字字典的【已关闭】 b. 最后点击节点【保持】按钮。 增加【审批】节点,在右侧属性面板中 【审批模型】选择模型为【模型触发:[Gemini任务]】 【选择视图】选择前面新建的页面【流程中的任务编辑页】 【审批人】选择角色为【超级管理员】 【数据】权限全部设置为【查看】 其他配置项默认,需要了解更多请查看产品使用手册 最后点击节点【保持】按钮。 新增【审核分支】,在【通过】分支中增加两个数据更新节点,跟审核前的两个数据更新节点对应 【模型触发:[Gemini任务]】的【任务状态】字段等于数字字典的【初始化】,任务审核状态为【审核通过】 【获取数据[Gemini用户任务实例]】的【任务状态】字段等于数字字典的【初始化】 流程确保保持并发布过,点击右上角【发布流程】完成流程的保存与发布 Step5 检验效果 创建任务后,任务状态为【关闭】状态,任务列表中的任务状态为多个状态的计算值 审核通过后,任务状态为【进行中】状态,任务列表中的任务状态为多个状态的计算值

    2024年5月23日
    1.8K00
  • 4.2.3 框架之SPI机制

    SPI(Service Provider Interface)服务提供接口,是一套用来被第三方实现或者扩展的API,它可以用来启用框架扩展和替换组件,简单来说就是用来解耦,实现组件的自由插拔,这样我们就能在平台提供的基础组件外扩展新组件或覆盖平台组件。 目前定义SPI组件 ViewWidget 视图组件 FieldWidget 字段组件 ActionWidget 动作组件 表4-2-3-1 目前定义SPI组件 前提知识点 使用 TypeScript 装饰器(注解)装饰你的代码 1. 通过注解定义一种SPI接口(Interface) @SPI.Base<IViewFilterOptions, IView>('View', ['id', 'name', 'type', 'model', 'widget']) export abstract class ViewWidget<ViewData = any> extends DslNodeWidget { } 图4-2-3-1 代码示意 2. 通过注解注册提供View类型接口的一个或多个实现 @SPI.Base<IViewFilterOptions, IView>('View', ['id', 'name', 'type', 'model', 'widget']) export abstract class ViewWidget<ViewData = any> extends DslNodeWidget { } 图4-2-3-2 代码示意 3. 视图的xml内通过配置来调用已定义的一种SPI组件 <view widget="form" model="demo.shop"> <field name="id" /> </view> 图4-2-3-3 代码示意 图4-2-3-4 组件继承示意图 当有多个服务提供方时,按以下规则匹配出最符合条件的服务提供方 SPI匹配规则 SPI组件没有严格的按匹配选项属性限定,而是一个匹配规则 按widget最优先匹配,配置了widget等于是指定了需要调用哪个widget,此时其他属性直接忽略 按最大匹配原则(匹配到的属性越多优先级越高) 按后注册优先原则

    2024年5月23日
    2.1K00
  • 4.1.24 框架之分库分表

    随着数据库技术的发展如分区设计、分布式数据库等,业务层的分库分表的技术终将成老一辈程序员的回忆,谈笑间扯扯蛋既羡慕又自吹地说到“现在的研发真简单,连分库分表都不需要考虑了”。竟然这样为什么要写这篇文章呢?因为现今的数据库虽能解决大部分场景的数据量问题,但涉及核心业务数据真到过亿数据后性能加速降低,能给的方案都还有一定的局限性,或者说性价比不高。相对性价比比较高的分库分表,也会是现阶段一种不错的补充。言归正传oinone的分库分表方案是基于Sharding-JDBC的整合方案,所以大家得先具备一点Sharding-JDBC的知识。 一、分表(举例) 做分库分表前,大家要有一个明确注意的点就是分表字段的选择,它是非常重要的,与业务场景非常相关。在明确了分库分表字段以后,甚至在功能上都要做一些妥协。比如分库分表字段在查询管理中做为查询条件是必须带上的,不然效率只会更低。 Step1 新建ShardingModel模型 ShardingModel模型是用于分表测试的模型,我们选定userId作为分表字段。分表字段不允许更新,所以这里更新策略设置类永不更新,并在设置了在页面修改的时候为readonly package pro.shushi.pamirs.demo.api.model; import pro.shushi.pamirs.boot.base.ux.annotation.field.UxWidget; import pro.shushi.pamirs.boot.base.ux.annotation.view.UxForm; import pro.shushi.pamirs.meta.annotation.Field; import pro.shushi.pamirs.meta.annotation.Model; import pro.shushi.pamirs.meta.enmu.FieldStrategyEnum; @Model.model(ShardingModel.MODEL_MODEL) @Model(displayName = "分表模型",summary="分表模型",labelFields ={"name"} ) public class ShardingModel extends AbstractDemoIdModel { public static final String MODEL_MODEL="demo.ShardingModel"; @Field(displayName = "名称") private String name; @Field(displayName = "用户id",summary = "分表字段",immutable=true/* 不可修改 **/) @UxForm.FieldWidget(@UxWidget(readonly = "scene == 'redirectUpdatePage'"/* 在编辑页面只读 **/ )) @Field.Advanced(updateStrategy = FieldStrategyEnum.NEVER) private Long userId; } 图4-1-24-1 新建ShardingModel模型 Step2 配置分表策略 配置ShardingModel模型走分库分表的数据源pamirsSharding 为pamirsSharding配置数据源以及sharding规则 a. pamirs.sharding.define用于oinone的数据库表创建用 b. pamirs.sharding.rule用于分表规则配置 pamirs: load: sessionMode: true framework: system: system-ds-key: base system-models: – base.WorkerNode data: default-ds-key: pamirs ds-map: base: base modelDsMap: "[demo.ShardingModel]": pamirsSharding #配置模型对应的库 图4-1-24-2 指定模型对应数据源 pamirs: sharding: define: data-sources: ds: pamirs pamirsSharding: pamirs #申明pamirsSharding库对应的pamirs数据源 models: "[trigger.PamirsSchedule]": tables: 0..13 "[demo.ShardingModel]": tables: 0..7 table-separator: _ rule: pamirsSharding: #配置pamirsSharding库的分库分表规则 actual-ds: – pamirs #申明pamirsSharding库对应的pamirs数据源 sharding-rules: # Configure sharding rule ,以下配置跟sharding-jdbc配置一致 – tables: demo_core_sharding_model: #demo_core_sharding_model表规则配置 actualDataNodes: pamirs.demo_core_sharding_model_${0..7} tableStrategy: standard: shardingColumn: user_id shardingAlgorithmName: table_inline shardingAlgorithms: table_inline: type: INLINE props: algorithm-expression: demo_core_sharding_model_${(Long.valueOf(user_id) % 8)} props: sql.show: true 图4-1-24-3 分库分表规则配置 Step3 配置测试入口 修改DemoMenus类增加一行代码,为测试提供入口 @UxMenu("分表模型")@UxRoute(ShardingModel.MODEL_MODEL) class ShardingModelMenu{} 图4-1-24-4 配置测试入口 Step4 重启看效果 自行尝试增删改查 观察数据库表与数据分布 图4-1-24-5 自行尝试增删改查 图4-1-24-6 观察数据库表与数据分布 二、分库分表(举例) Step1 新建ShardingModel2模型 ShardingModel2模型是用于分库分表测试的模型,我们选定userId作为分表字段。分库分表字段不允许更新,所以这里更新策略设置类永不更新,并在设置了在页面修改的时候为readonly package pro.shushi.pamirs.demo.api.model; import pro.shushi.pamirs.boot.base.ux.annotation.field.UxWidget; import pro.shushi.pamirs.boot.base.ux.annotation.view.UxForm; import…

    2024年5月23日
    1.6K00
  • 4.1.4 模块之元数据详解

    介绍Module相关元数据,以及对应代码注解方式。大家还是可以通读下,以备不时之需 如您还不了解Module的定义,可以先看下2.3【oinone独特之源,元数据与设计原则】一文对Module的描述,本节主要带大家了解Module元数据构成,能让小伙伴非常清楚oinone从哪些维度来描述Module, 一、元数据说明 ModuleDefinition 元素数据构成 含义 对应注解 备注 displayName 显示名称 @Module( displayName=””, name=””, version=””, category=””, summary=””, dependencies={“”,””}, exclusions={“”,””}, priority=1L ) name 技术名称 latestVersion 安装版本 category 分类编码 summary 描述摘要 moduleDependencies 依赖模块编码列表 moduleExclusions 互斥模块编码列表 priority 排序 module 模块编码 @Module.module(“”) dsKey 逻辑数据源名 @Module.Ds(“”) excludeHooks 排除拦截器列表 @Module.Hook(excludes={“”,””}) website 站点 @Module.Advanced( website=”http://www.oinone.top”, author=”oinone”, description=”oinone”, application=false, demo=false, web=false, toBuy=false, selfBuilt=true, license=SoftwareLicenseEnum.PEEL1, maintainer=”oinone”, contributors=”oinone”, url=”http://git.com” ) author module的作者 description 描述 application 是否应用 demo 是否演示应用 web 是否web应用 toBuy 是否需要跳转到website去购买 selfBuilt 自建应用 license 许可证 默认PEEL1 可选范围: GPL2 GPL2ORLATER GPL3 GPL3ORLATER AGPL3 LGPL3 ORTHEROSI PEEL1 PPL1 ORTHERPROPRIETARY maintainer 维护者 contributors 贡献者列表 url 代码库的地址 boot 是否自动安装的引导启动项 @Boot 加上该注解代表: 启动时会自动安装,不管yml文件的modules是否配置 moduleClazz 模块定义所在类 只有用代码编写的模块才有 packagePrefix 包路径,用于扫描该模块下的其他元数据 dependentPackagePrefix 依赖模块列对应的扫描路径 state 状态 系统自动计算,无需配置 metaSource 元数据来源 publishCount 发布总次数 platformVersion 最新平台版本 本地与中心平台的版本对应。做远程更新时会用到 publishedVersion 最新发布版本 表4-1-4-1 ModuleDefinition UeModule 是对ModuleDefinition的继承,并扩展了跟前端交互相关的元数据 元素数据构成 含义 对应注解 备注 homePage Model 跳转模型编码 @UxHomepage(@UxRoute() 对应一个ViewAction,如果UxRoute只配置了模型,则默认到该模型的列表页 homePage Name 视图动作或者链接动作名称 logo 图标 @UxAppLogo(logo=””) 表4-1-4-2 UeModule 二、元数据,代码注解方式 Module Module ├── displayName 显示名称 ├── name 技术名称 ├── version 安装版本 ├── category 分类编码 ├── summary 描述摘要 ├── dependencies 依赖模块编码列表 ├── exclusions 互斥模块编码列表 ├── priority 排序 ├── module 模块编码 │ └── value ├── Ds 逻辑数据源名 │ └── value ├── Hook 排除拦截器列表…

    Oinone 7天入门到精通 2024年5月23日
    1.9K00
  • 4.1.10 函数之触发与定时(改)

    函数的触发和定时在很多场景中会用到,也是一个oinone的基础能力。比如我们的流程产品中在定义流程触发时就会让用户选择模型触发还是时间触发,就是用到了函数的触发与定时能力。 整体链路示意图(如下图4-1-10-1 所示),本文只讲trigger里的两类任务,一个是触发任务,一个是定时任务,异步任务放在4.1.11【函数之异步执行】一文中单独去介绍。 图4-1-10-1 整体链路示意图 一、触发任务TriggerTaskAction(举例) 触发任务的创建,使用pamirs-middleware-canal监听mysql的binlog事件,通过rocketmq发送变更数据消息,收到MQ消息后,创建TriggerAutoTask。 触发任务的执行,使用TBSchedule拉取触发任务后,执行相应函数。 注意:pamirs-middleware-canal监听的数据库表必须包含触发模型的数据库表。 Step1 下载canal中间件 下载pamirs-middleware-canal-deployer-3.0.1.zip,去.txt后缀为pamirs-middleware-canal-deployer-3.0.1.zip,解压文件如下: 图4-1-10-2 下载canal中间件 Step2 引入依赖pamirs-core-trigger模块 pamirs-demo-api增加pamirs-trigger-api <dependency> <groupId>pro.shushi.pamirs.core</groupId> <artifactId>pamirs-trigger-api</artifactId> </dependency> 图4-1-10-3 pamirs-trigger-api依赖包 DemoModule在模块依赖定义中增加@Module(dependencies={TriggerModule.MODULE_MODULE}) @Component @Module( name = DemoModule.MODULE_NAME, displayName = "oinoneDemo工程", version = "1.0.0", dependencies = {ModuleConstants.MODULE_BASE, CommonModule.MODULE_MODULE, UserModule.MODULE_MODULE, TriggerModule.MODULE_MODULE} ) @Module.module(DemoModule.MODULE_MODULE) @Module.Advanced(selfBuilt = true, application = true) @UxHomepage(PetShopProxy.MODEL_MODEL) public class DemoModule implements PamirsModule { ……其他代码 } 图4-1-10-4 模块依赖中增加Trigger模块 pamirs-demo-boot 增加pamirs-trigger-core和pamirs-trigger-bridge-tbschedule的依赖 <dependency> <groupId>pro.shushi.pamirs.core</groupId> <artifactId>pamirs-trigger-core</artifactId> </dependency> <dependency> <groupId>pro.shushi.pamirs.core</groupId> <artifactId>pamirs-trigger-bridge-tbschedule</artifactId> </dependency> 图4-1-10-5 增加pamirs-trigger-core和pamirs-trigger-bridge-tbschedule的依赖 修改pamirs-demo-boot的applcation-dev.yml 修改pamris.event.enabled和pamris.event.schedule.enabled为true pamirs_boot_modules增加启动模块:trigger pamirs: event: enabled: true schedule: enabled: true rocket-mq: namesrv-addr: 127.0.0.1:9876 boot: init: true sync: true modules: – base – common – sequence – resource – user – auth – message – international – business – trigger – demo_core 图4-1-10-6 启动模块中增加trigger模块 Step3 启动canal中间件 canal的库表需要手工建 create schema canal_tsdb collate utf8mb4_bin 图4-1-10-7 canal的建库语句 CREATE TABLE IF NOT EXISTS `meta_snapshot` ( `id` bigint(20) unsigned NOT NULL AUTO_INCREMENT COMMENT '主键', `gmt_create` datetime NOT NULL COMMENT '创建时间', `gmt_modified` datetime NOT NULL COMMENT '修改时间', `destination` varchar(128) DEFAULT NULL COMMENT '通道名称', `binlog_file` varchar(64) DEFAULT NULL COMMENT 'binlog文件名', `binlog_offest` bigint(20) DEFAULT NULL COMMENT 'binlog偏移量', `binlog_master_id` varchar(64) DEFAULT NULL COMMENT 'binlog节点id', `binlog_timestamp` bigint(20) DEFAULT NULL…

    2024年5月23日
    1.9K00

Leave a Reply

Please Login to Comment