4.1.8 函数之事务管理

一、事务管理介绍

函数Function支持事务字段为isTransaction(默认为false),事务传播行为propagationBehavior(默认PROPAGATION_SUPPORTS),事务隔离级别isolationLevel(默认使用数据库默认的事务隔离级别),所以不会默认为函数添加事务。另外事务配置提供全局配置。

平台事务管理兼容Spring声明式与编程式事务,支持多数据源事务管理。事务管理中多数据源嵌套独立事务,不会造成死锁风险。使用多数据源或分表操作,不会导致脏读。如果需要多数据源分布式事务,请使用PamirsTransational分布式事务管理方案(@PamirsTransational(enableXa=true))。分布式事务一般用于量小的跨模块配置管理场景

使用方式

  • 声明式事务,使用@PamirsTransactional注解在需要事务管理的类或方法上标注。在非无代码场景下,与@Transactional注解功能一致。
  • 编程式事务,使用PamirsTransactionTemplate即可。在非无代码场景下,与TransactionTemplate功能一致。
  • 配置式事务,使用TxConfig模型在模块安装时初始化存储事务配置数据。

事务特性

  • 原子性 (atomicity):强调事务的不可分割.
  • 一致性 (consistency):事务的执行的前后数据的完整性保持一致.
  • 隔离性 (isolation):一个事务执行的过程中,不应该受到其他事务的干扰
  • 持久性(durability) :事务一旦结束,数据就持久到数据库

事务隔离级别

事务隔离级别指的是一个事务对数据的修改与另一个并行的事务的隔离程度,当多个事务同时访问相同数据时,如果没有采取必要的隔离机制,就可能发生以下问题:

问题 描述
脏读 一个事务读到另一个事务未提交的更新数据,所谓脏读,就是指事务A读到了事务B还没有提交的数据,比如银行取钱,事务A开启事务,此时切换到事务B,事务B开启事务–>取走100元,此时切换回事务A,事务A读取的肯定是数据库里面的原始数据,因为事务B取走了100块钱,并没有提交,数据库里面的账务余额肯定还是原始余额,这就是脏读
不可重复读 在一个事务里面的操作中发现了未被操作的数据 比方说在同一个事务中先后执行两条一模一样的select语句,期间在此次事务中没有执行过任何DDL语句,但先后得到的结果不一致,这就是不可重复读
幻读 是指当事务不是独立执行时发生的一种现象,例如第一个事务对一个表中的数据进行了修改,这种修改涉及到表中的全部数据行。 同时,第二个事务也修改这个表中的数据,这种修改是向表中插入一行新数据。那么,以后就会发生操作第一个事务的用户发现表中还有没有修改的数据行,就好象 发生了幻觉一样。

表4-1-8-1 事务隔离级别

Pamirs(Spring)支持的隔离级别

隔离级别 描述
DEFAULT 使用数据库本身使用的隔离级别 ORACLE(读已提交) MySQL(可重复读)
READ_UNCOMITTED 读未提交(脏读)最低的隔离级别,一切皆有可能。
READ_COMMITED 读已提交,ORACLE默认隔离级别,有不可重复读以及幻读风险。
REPEATABLE_READ 可重复读,解决不可重复读的隔离级别,但还是有幻读风险。
SERLALIZABLE 串行化,最高的事务隔离级别,不管多少事务,挨个运行完一个事务的所有子事务之后才可以执行另外一个事务里面的所有子事务,这样就解决了脏读、不可重复读和幻读的问题了

表4-1-8-2 隔离级别与描述

隔离级别 脏读可能性 不可重复读可能性 幻读可能性 加锁度
READ_UNCOMITTED 是 是 是 否
READ_COMMITED 否 是 是 否
REPEATABLE_READ 否 否 是 否
SERLALIZABLE 否 否 否 是

表4-1-8-3 隔离级别说明表

事务的传播行为

  • 保证同一个事务中

  • PROPAGATION_REQUIRED 支持当前事务,如果不存在 就新建一个(默认)

  • PROPAGATION_SUPPORTS 支持当前事务,如果不存在,就不使用事务

  • PROPAGATION_MANDATORY 支持当前事务,如果不存在,抛出异常

  • 保证没有在同一个事务中

  • PROPAGATION_REQUIRES_NEW 如果有事务存在,挂起当前事务,创建一个新的事务

  • PROPAGATION_NOT_SUPPORTED 以非事务方式运行,如果有事务存在,挂起当前事务

  • PROPAGATION_NEVER 以非事务方式运行,如果有事务存在,抛出异常

  • PROPAGATION_NESTED 如果当前事务存在,则嵌套事务执行

A中嵌套B事务,嵌套PROPAGATION_REQUIRES_NEW方法勿与A在同类中。

异常状态 PROPAGATION_REQUIRES_NEW (两个独立事务) PROPAGATION_NESTED (B的事务嵌套在A的事务中) PROPAGATION_REQUIRED (同一个事务)
A抛异常 B正常 A回滚,B正常提交 A与B一起回滚 A与B一起回滚
A正常 B抛异常 1.如果A中捕获B的异常,并没有继续向上抛异常,则B先回滚,A再正常提交; 2.如果A未捕获B的异常,默认则会将B的异常向上抛,则B先回滚,A再回滚 B先回滚,A再正常提交 A与B一起回滚
A抛异常B抛异常 B先回滚,A再回滚 A与B一起回滚 A与B一起回滚
A正常 B正常 B先提交,A再提交 A与B一起提交 A与B一起提交

表4-1-8-4 事务传播行为

二、声明式事务(举例)

Step1 修改PetShopBatchUpdateAction

用@PamirsTransactional或者@Transactional注解来声明事务,PamirsTransactional跟Spring的Transactional区别在于PamirsTransactional支持多库事务,但此多库事务为非严格的分布式多库事务,之所以选择这个方案,原因如下

a. 不损害任何性能。

b. 事务保障率超过4个9

c. 经过阿里的大厂验证,特别是在阿里的结算平台中得到了很好的验证

@PamirsTransactional更多配置项请详见4.1.7【函数之元数据详解】一文,自己多试试。同时@PamirsTransactional百分百兼容@Transactional

@Action(displayName = "确定",bindingType = ViewTypeEnum.FORM,contextType = ActionContextTypeEnum.SINGLE)
@PamirsTransactional
//@Transactional
public PetShopBatchUpdate conform(PetShopBatchUpdate data){
    if(data.getPetShopList() == null || data.getPetShopList().size()==0){
        throw  PamirsException.construct(DemoExpEnumerate.PET_SHOP_BATCH_UPDATE_SHOPLIST_IS_NULL).errThrow();
    }
    List<PetShopProxy> proxyList = data.getPetShopList();
    for(PetShopProxy petShopProxy:proxyList){
        petShopProxy.setDataStatus(data.getDataStatus());
    }
    new PetShopProxy().updateBatch(proxyList);
    throw PamirsException.construct(DemoExpEnumerate.SYSTEM_ERROR).errThrow();
    //        return data;
}

图4-1-8-1 修改PetShopBatchUpdateAction

Step2 重启看效果

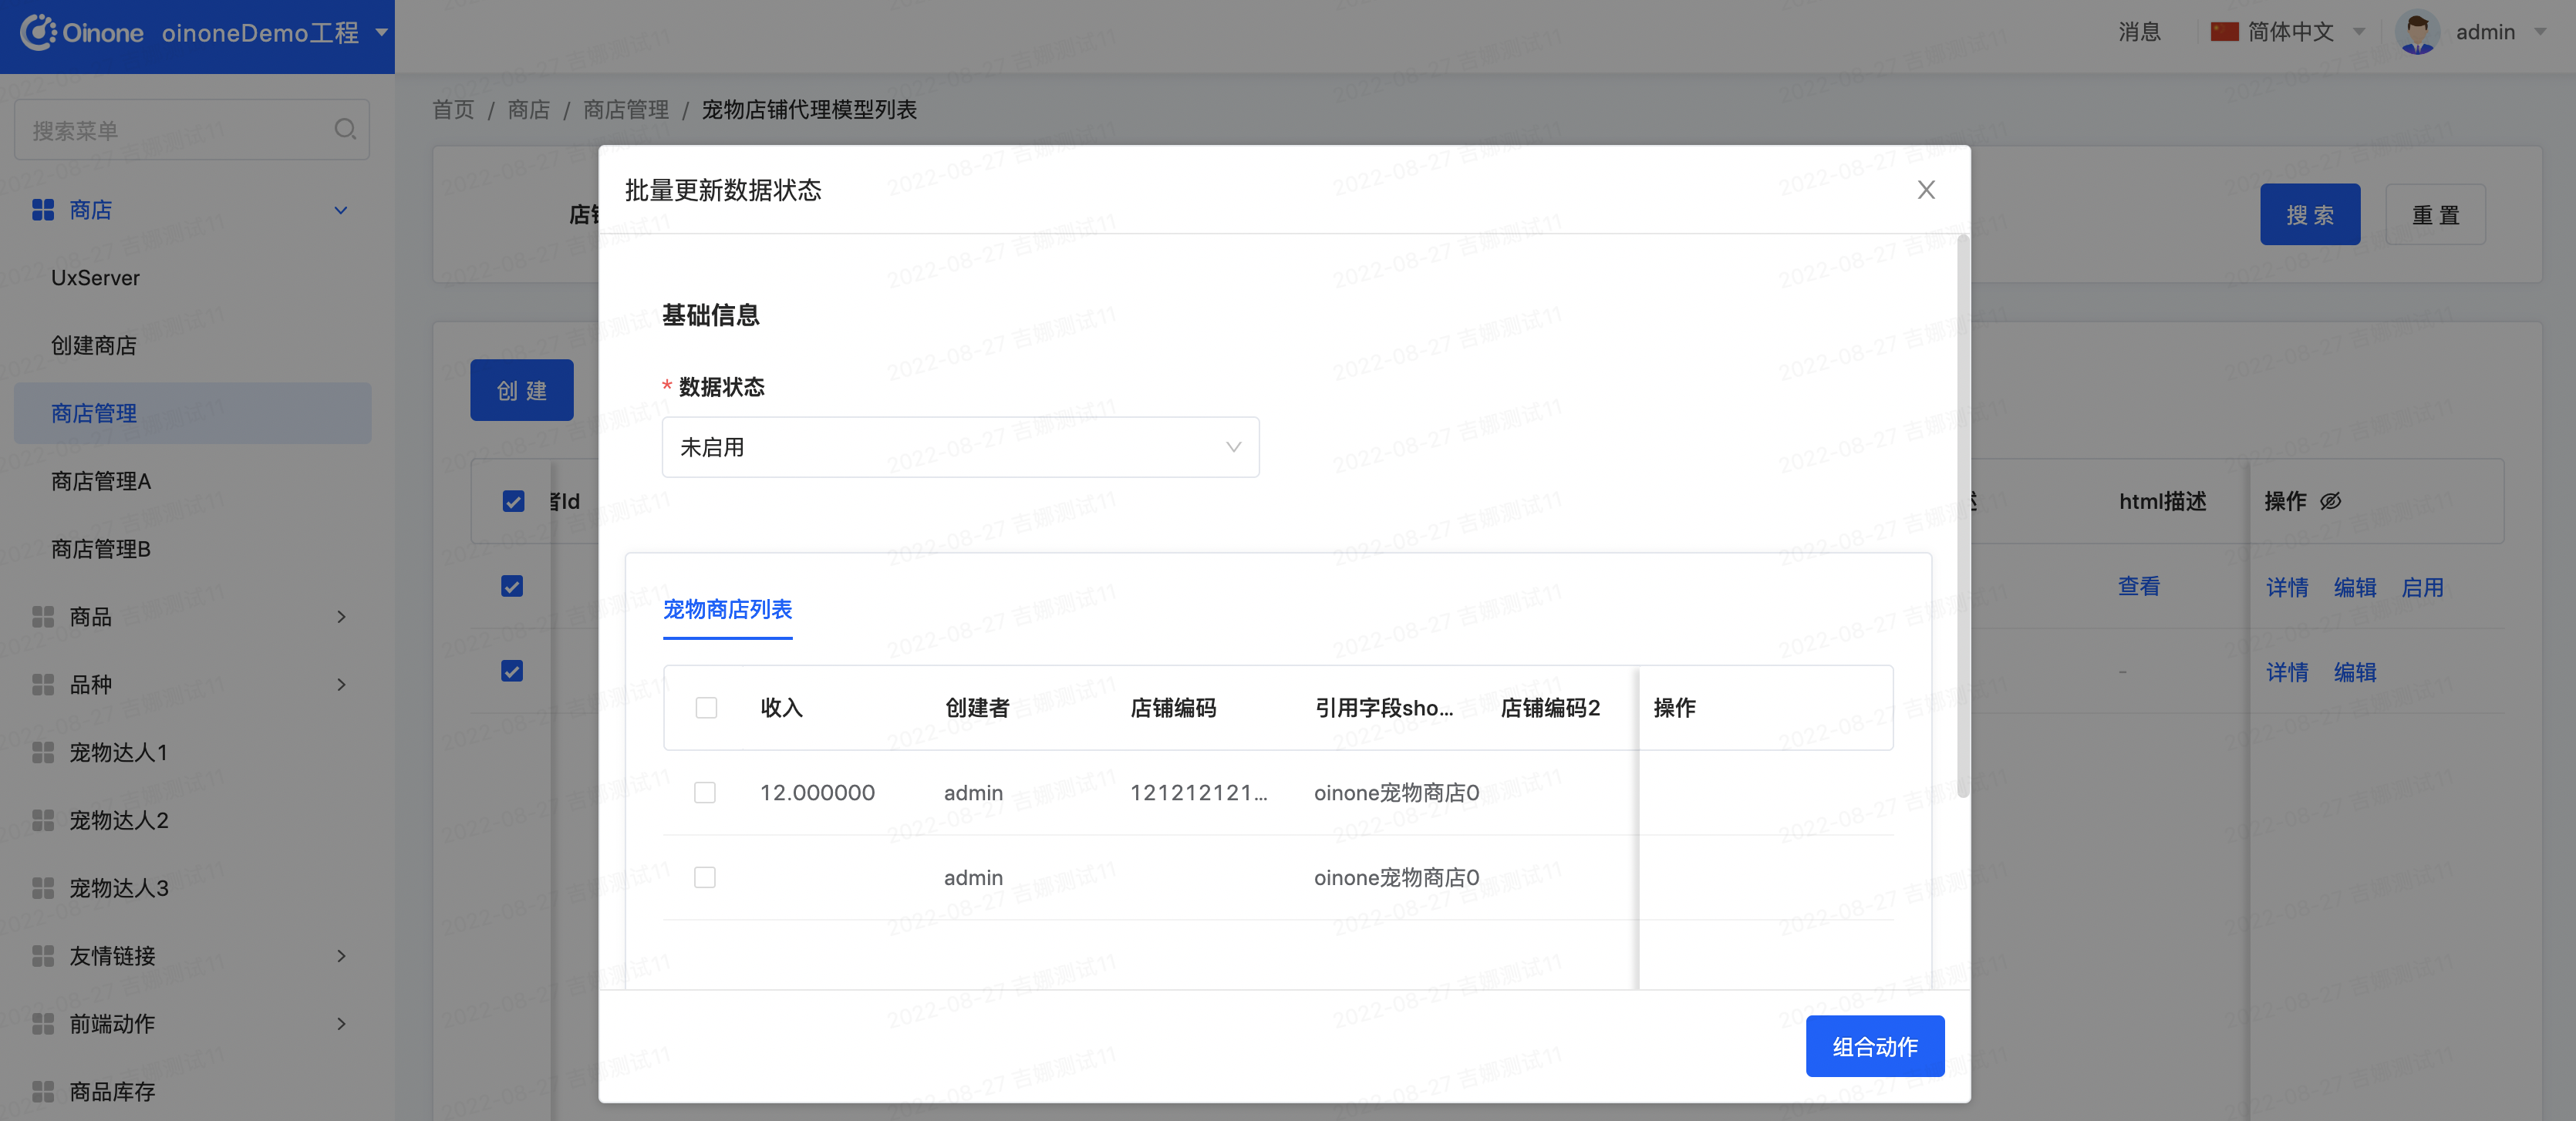
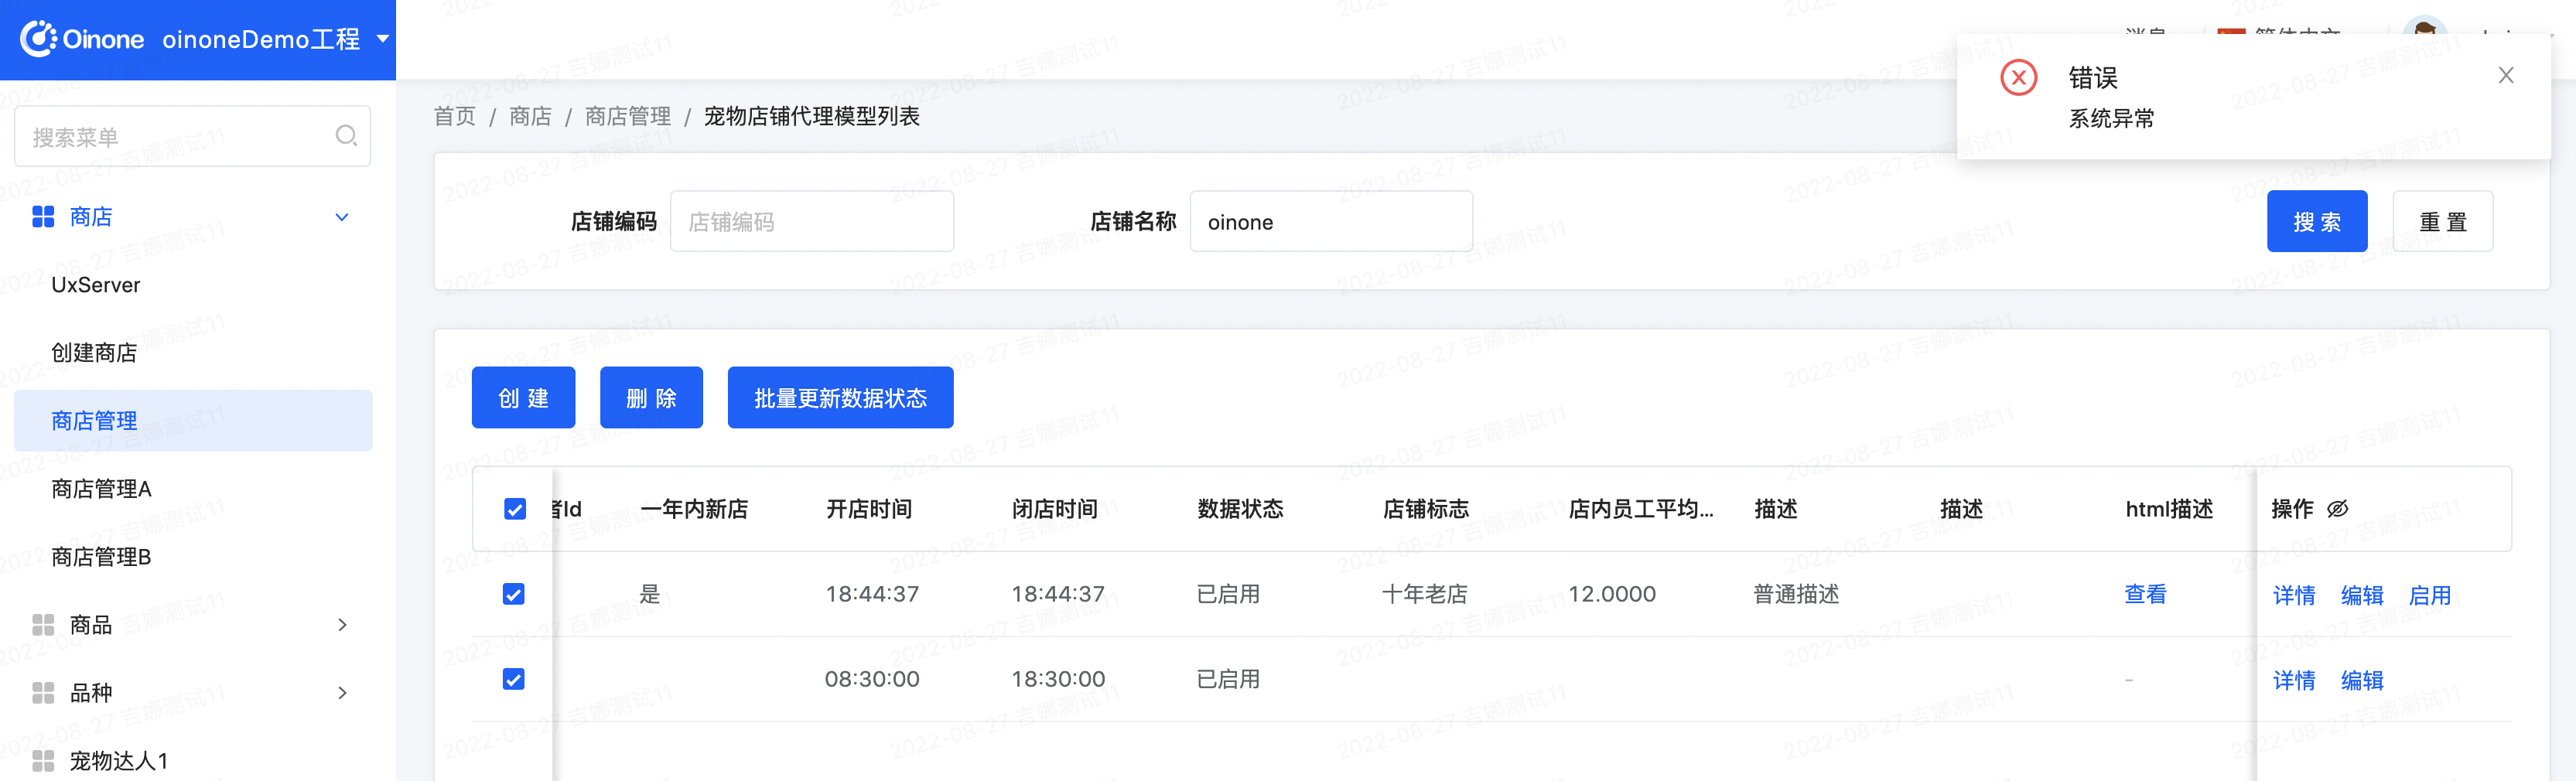
进入店铺管理列表页,选择记录点击【批量更新数据状态】按钮,修改记录的数据状态为【未启用】,提交看效果。期望效果为:提示系统异常,数据修改失败
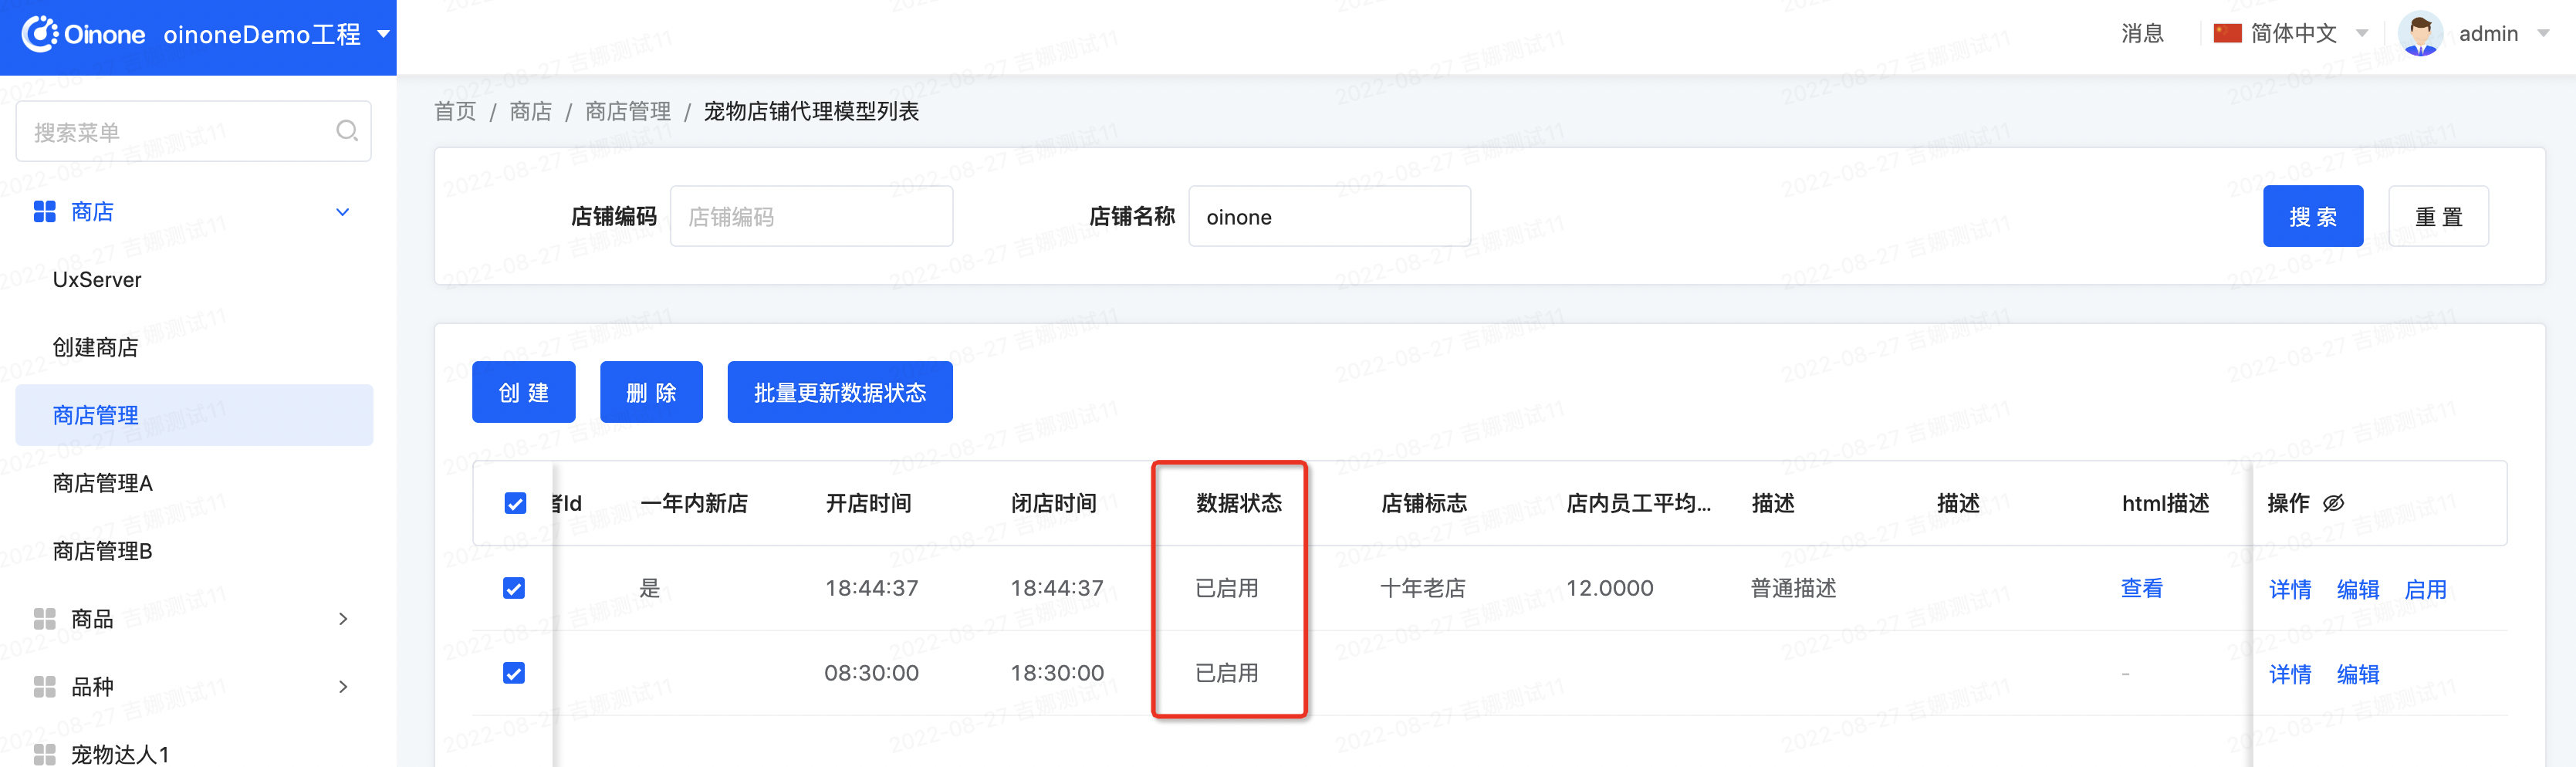
image.png

图4-1-8-2 数据状态显示已启用

image.png

图4-1-8-3 批量更新数据状态

image.png

图4-1-8-4 提示系统异常

三、编程式事务(举例)

为了提升性能,特别是在高并发场景,编程式事务开发模式有利于精细化控制事务开启长度,尽可能地在事务开启前,把费时的查询工作、数据准备做完。基本套路如下

Tx.build(new TxConfig().setPropagation(Propagation.REQUIRED.value())).executeWithoutResult(status -> {
      //执行逻辑
});

图4-1-8-5 编程式事务代码示意

Step1 修改PetShopBatchUpdateAction

@Action(displayName = "确定",bindingType = ViewTypeEnum.FORM,contextType = ActionContextTypeEnum.SINGLE)
public PetShopBatchUpdate conform(PetShopBatchUpdate data){
    if(data.getPetShopList() == null || data.getPetShopList().size()==0){
        throw  PamirsException.construct(DemoExpEnumerate.PET_SHOP_BATCH_UPDATE_SHOPLIST_IS_NULL).errThrow();
    }
    List<PetShopProxy> proxyList = data.getPetShopList();
    for(PetShopProxy petShopProxy:proxyList){
        petShopProxy.setDataStatus(data.getDataStatus());
    }
    Tx.build(new TxConfig().setPropagation(Propagation.REQUIRED.value())).executeWithoutResult(status -> {
        new PetShopProxy().updateBatch(proxyList);
        throw PamirsException.construct(DemoExpEnumerate.SYSTEM_ERROR).errThrow();
    });
    return data;
}

图4-1-8-6 修改PetShopBatchUpdateAction

Step2 重启看效果

跟声明式事务一致的效果

四、配置式事务

略,该模式一般用于平台内部使用以及无代码编辑器管理事务时用到,就不举例了

分布式事务(不建议使用)

如果要严格意义上的分布式事务,需要配置enableXa为true,@PamirsTransational(enableXa=true)。同时引入依赖包

<groupId>pro.shushi.pamirs.framework</groupId>
<artifactId>pamirs-connectors-data-xa</artifactId>

图4-1-8-7 分布式事务依赖包

注:该版本还不支持远程RPC后的分布式事务,因该模式有很大的弊端,也就是把原本无状态的服务变成有状态,导致性能和耦合度都极差。所以我们一般使用事务性消息、异步任务等最终一致性方案去替代。

Oinone社区 作者:史, 昂原创文章,如若转载,请注明出处:https://doc.oinone.top/oio4/9283.html

访问Oinone官网:https://www.oinone.top获取数式Oinone低代码应用平台体验

Like (0)
史, 昂's avatar史, 昂数式管理员
Previous 2024年5月23日 am8:55
Next 2024年5月23日

相关推荐

  • 翻译

    翻译应用是管理翻译规则的应用,以模型为基础、维护字段的翻译值,支持导入、导出 1. 操作步骤 Step1:导出所有翻译项; Step2:线下翻译; Step3:导入翻译项; Step4:刷新远程资源; Step5:页面右上角可切换语言,查看翻译效果。 2. 新增翻译 翻译是具体到模型字段,其中需要区分出是否字典; 源语言、目标语言,是在资源中维护的语言,可在资源中维护需要翻译的语言; 翻译项则是模型字段,默认翻译项为激活状态,关闭后维护的翻译项无效。 3. 导出、导入 不勾选导出:导出所有需要翻译的翻译项,包括模块、字段,源术语、翻译值等,其中如果已经翻译过的内容,会体现在翻译值中; 勾选导出:导出勾选模型的翻译项。 导入:导入翻译项,平台会根据模型拆分为多条数据。 4. 刷新远程资源 导入翻译项后,点击“刷新远程资源”按钮。 5. 查看翻译内容 页面右上角切换语言,查看翻译效果。

    2024年6月20日
    1.4K00
  • 3.2 Oinone以模块为组织

    模块(module):是按业务领域划分和管理的最小单元,是一组功能、界面的集合。 带大家快速认识下如何构建一个oinone的模块并启动它。我会从以下几个维度去介绍模块的构建与启动方式、模块详解。让大家直观且全方位地了解oinone的模块所包含的内容 构建第一个Module 启动前端工程 应用中心

    Oinone 7天入门到精通 2024年5月23日
    3.0K00
  • 4.5.1 研发辅助之插件-结构性代码

    研发辅助意在 消灭研发过程中的重复性工作提升研发效率,如结构性代码 提供生产示例性代码,如果根据模型生成导入导出、view自定义配置等经常性开发 一、插件安装 根据自身Idea版本下载插件并安装: 版本 插件 2023.1 pamirs-source-maker-1.0.0-2023.1.zip(2.4 MB) 2021.1 pamirs-source-maker-1.0.0-2021.1.zip(2.4 MB) 2021.2 pamirs-source-maker-1.0.0-2021.2.zip(2.4 MB) 2021.3 pamirs-source-maker-1.0.0-2021.3.zip(2.4 MB) 2022.1 pamirs-source-maker-1.0.0-2022.1.zip(2.4 MB) pamirs-source-maker-1.0.0-223-EAP-SNAPSHOT(2.4 MB) 表4-5-1-1 插件列表 二、研发辅助之配置式结构性代码生成器 我们在开发过程中为了日后代码易于维护和修改,往往会做工程性的职责划分。 除去模型外会有 代理模型和代理模型Action来负责前端交互 以面向接口的形式来定义函数,就会有api和实现类之分 如果项目有多端,那么如代理模型和代理模型Action又要为每一个端构建一份 在大型项目的初始阶段,我们需要手工重复做很多事情,特别麻烦。现在用oinone的研发辅助插件的结构性代码生成器,就可以避免前面的重复工作 插件执行的配置文件 <?xml version="1.0" encoding="utf-8" ?> <oinone> <makers> <!– 根据模型生成代理类、代理类的Action、Service、ServiceImpl –> <maker> <!– 选择模型所在位置 –> <modelPath>/Users/oinone/Documents/oinone/demo/pamirs-second/pamirs-second-api/src/main/java/pro/shushi/pamirs/second/api/model</modelPath> <!– 代理模型、代理模型Action生成相关配置信息 –> <proxyModules> <module> <!– 代理模型和代理模型Action的生成位置信息 –> <generatePath>/Users/oinone/Documents/oinone/demo/pamirs-second/pamirs-second-api/src/main/java/pro/shushi/pamirs/second/api</generatePath> <!– 代理模型和代理模型Action的模块前缀 –> <modulePrefix>second</modulePrefix> <!– 代理模型和代理模型Action的模块名,代理模型和代理模型Action类名为moduleName+模型名+"Proxy"+"Action" –> <moduleName>second</moduleName> <!– 代理模型和代理模型Action的包名,实际包名为 packageName+".proxy"或packageName+".action"–> <packageName>pro.shushi.pamirs.second.api</packageName> </module> </proxyModules> <!– 根据模型生成api,包括service(写方法)和queryService(读方法) –> <apiModule> <!– service和queryService的生成位置信息 –> <generatePath>/Users/oinone/Documents/oinone/demo/pamirs-second/pamirs-second-api/src/main/java/pro/shushi/pamirs/second/api</generatePath> <!– service和queryService的模块前缀 –> <modulePrefix>second</modulePrefix> <!– service和queryService的模块名 –> <moduleName>second</moduleName> <!– service和queryService的包名,实际包名为 packageName+".service" –> <packageName>pro.shushi.pamirs.second.api</packageName> </apiModule> <!– 根据模型生成api实现类,包括serviceImpl(写方法)和queryServiceImpl(读方法) –> <coreModule> <!– serviceImpl和queryServiceImpl的生成位置信息 –> <generatePath>/Users/oinone/Documents/oinone/demo/pamirs-second/pamirs-second-core/src/main/java/pro/shushi/pamirs/second/core</generatePath> <!– serviceImpl和queryServiceImpl的模块前缀 –> <modulePrefix>second</modulePrefix> <!– serviceImpl和queryServiceImpl的模块名 –> <moduleName>second</moduleName> <!– serviceImpl和queryServiceImpl的包名,实际包名为 packageName+".service" –> <packageName>pro.shushi.pamirs.second.core</packageName> </coreModule> </maker> </makers> </oinone> 图4-5-1-1 插件执行的配置文件 三、研发辅助之多模型结构性代码生成器 是配置式结构性代码生成器的补充,应对开发后期维护中新增模型的场景。它的不同点在于只要选择模型文件就可以,不需要专门编写xml文件。生成的文件默认就在模型所在路径下 Step1 菜单栏上找到oinone,并点击子菜单【多模型结构性代码生成器】 图4-5-1-2 多模型结构性代码生成操作步骤一 Step2 设置必要的信息 模型前缀 模型的所属模块 代理模型的模块 这三个信息分别用于构建 代理模型的MODEL_MODEL = 模型前缀.代理模型的模块.代理模型类名 服务的FUN_NAMESPACE = 模型前缀.代理模型的模块.服务类名 图4-5-1-3 多模型结构性代码生成操作步骤二 Step3 选择为哪些模型生成对应的结构性代码 图4-5-1-4 多模型结构性代码生成操作步骤三 Step4 代码在模型所在目录 生成的文件默认就在模型所在路径下,您可以手动拖动到对应的包路径当中去 图4-5-1-5 多模型结构性代码生成操作步骤四

    2024年5月23日
    1.5K00
  • 4.1.23 框架之信息传递

    在4.1.13【Action之校验】、3.4.1【构建第一个Function】等文章中,都用到PamirsSession.getMessageHub()来设置返回消息,基本上都是在传递后端逻辑判断的异常信息,而且在系统报错时也会通过它来返回错误信息,前端接收到错误信息则会以提示框的方式进行错误提示。其实后端除了可以返回错误信息以外,还可以返回调试、告警、成功、信息等级别的信息给前端。但是默认情况下前端只提示错误信息,可以通过前端的统一配置放开提示级别,有点类似后端的日志级别。 一、不同信息类型的举例 Step1 新建PetTypeAction 借用PetType模型的表格页做为信息传递的测试入口,为PetType模型新增一个ServerAction,在代码中对信息的所有类型进行模拟 package pro.shushi.pamirs.demo.core.action; import org.springframework.stereotype.Component; import pro.shushi.pamirs.demo.api.model.PetCatItem; import pro.shushi.pamirs.demo.api.model.PetType; import pro.shushi.pamirs.meta.annotation.Action; import pro.shushi.pamirs.meta.annotation.Model; import pro.shushi.pamirs.meta.api.dto.common.Message; import pro.shushi.pamirs.meta.api.session.PamirsSession; import pro.shushi.pamirs.meta.enmu.ActionContextTypeEnum; import pro.shushi.pamirs.meta.enmu.InformationLevelEnum; import pro.shushi.pamirs.meta.enmu.ViewTypeEnum; @Model.model(PetType.MODEL_MODEL) @Component public class PetTypeAction { @Action(displayName = "消息",bindingType = ViewTypeEnum.TABLE,contextType = ActionContextTypeEnum.CONTEXT_FREE) public PetType message(PetType data){ PamirsSession.getMessageHub().info("info1"); PamirsSession.getMessageHub().info("info2"); PamirsSession.getMessageHub().error("error1"); PamirsSession.getMessageHub().error("error2"); PamirsSession.getMessageHub().msg(new Message().msg("success1").setLevel(InformationLevelEnum.SUCCESS)); PamirsSession.getMessageHub().msg(new Message().msg("success2").setLevel(InformationLevelEnum.SUCCESS)); PamirsSession.getMessageHub().msg(new Message().msg("debug1").setLevel(InformationLevelEnum.DEBUG)); PamirsSession.getMessageHub().msg(new Message().msg("debug2").setLevel(InformationLevelEnum.DEBUG)); PamirsSession.getMessageHub().msg(new Message().msg("warn1").setLevel(InformationLevelEnum.WARN)); PamirsSession.getMessageHub().msg(new Message().msg("warn2").setLevel(InformationLevelEnum.WARN)); return data; } } 图4-1-23-1 为PetType模型新增一个ServerAction Step2 (前端)修改提示级别 在项目初始化时使用CLI构建初始化前端工程,在src/middleware有拦截器的默认实现,修改信息提示的默认级别为【ILevel.SUCCESS】 图4-1-23-2(前端)修改提示级别 const DEFAULT_MESSAGE_LEVEL = ILevel.SUCCESS; 图4-1-23-3(前端)修改提示级别 Step3 重启系统看效果 从页面效果中看到已经不在是只提示错误信息。从协议端看错误级别的信息是在errors下,其他级别的信息是在extensions下。 图4-1-23-4 示例效果 图4-1-23-5 系统提示的返回结果 二、MessageHub的其他说明 是实现上看MessageHub是基于GQL协议,前后端都有配套实现。同时前端还提供了订阅MessageHub的信息功能,以满足前端更多交互要求,前端MessageHub提供的订阅能力使用教程详见4.2.2前端高级特性之【框架之MessageHub】一文。

    2024年5月23日
    2.1K00
  • 2.4.1 Oinone独特性之单体与分布式的灵活切换

    企业数字化转型需要处理分布式带来的复杂性和成本问题。尽管这些问题令人望而却步,但分布式架构对于大部分企业仍然是必须的选择。如果一个低代码平台缺乏分布式能力,那么它的性能就无法满足客户的要求。相比之下,Oinone平台通过对部署的创新(如图2-6所示),成功实现了分布式架构的支持,而且能够按照客户的业务发展需求,灵活选择不同的部署模式,同时节约企业成本,提升创新效率。这一创新是Oinone平台与其他低代码平台的重要区别,能够满足客户预期发展并兼顾成本效益。 图2-6 传统部署方式VS Oinone部署方式 实现原理 要实现灵活部署的特性,必须满足两个基本要求: 开发过程中不需要过多关注分布式技术,就像开发单体应用一样简单。代码在运行时应该能够根据模块是否在运行容器中,来决定路由走本地还是远程。这样可以大大减少研发人员的工作量和技术复杂度。 研发与部署要分离,即"开发单体应用一样开发分布式应用,而部署形式由后期决定"。为此,我们的工程结构支持多种启动模式,并逐一介绍了针对不同场景的工程结构类型(如下图2-7所示)。这样可以让客户在后期根据业务发展情况和需求,选择最适合的部署模式,从而达到灵活部署的目的。 图2-7 Oinone工程结构梳理 在整个工程结构上,我们秉承了Spring Boot的规范,不会改变大家的工程习惯。而Oinone的部署能力则可以让我们更灵活地应对各种情况。现在,我们来逐一介绍几种常规的工程结构以及它们适用的场景: 单模块工程结构(常规操作) a. 这是非常标准的Spring Boot工程,适用于简单的应用场景开发以及入门学习。 多模块工程结构(常规操作) a. 这是非常标准的多Spring Boot工程,可以实现分布式独立启动,适用于常规的分布式应用场景开发。 多模块工程结构-独立boot工程模式 a. 这种工程结构在多模块工程的基础上,通过独立的boot工程来支撑多部署方式。适用于中大型分布式应用场景开发。 b. 然而,随着工程越来越多,我们也会面临一些问题: ⅰ研发:环境准备非常困难,每个模块都要单独启动,研发调试跟踪困难。 ⅱ部署:分布式的高可靠性保证需要每个模块至少有两个部署节点,但在模块较多的情况下,起步成本非常高。同时,企业初期业务不稳定且规模较小,使用多模块工程的第二种模式会增加问题排查难度和成本。 c. 此时,Oinone的多模块工程下的独立boot工程模式部署就可以发挥其灵活性,让研发和业务起步阶段可以选择all-in-one模式,等到业务发展到一定规模的时候,只需要把线上部署模式切换成模块独立部署,而研发还可以保留all-in-one模式的优势。 d. 值得注意的是,分分合合的部署模式在传统互联网架构和低代码或无代码平台上都是有代价的,但是Oinone却可以灵活适配,只需要在boot工程的yml文件中写入需要加载的模块就可以解决。此处我们仅介绍多模块加载配置,选择性忽略其他无关配置,具体配置(如下图2-8所示)。 pamirs: boot: init: true sync: true modules: – base – resource – sequence – user – auth – web tenants: – pamirs 图2-8 Oinone yml配置图大型多场景工程结构-独立boot工程模式: a. 在多模块工程结构基础上的加强版,增加CDM层设计,让不同场景即保持数据统一,又保持逻辑独立。这种工程结构特别适用于大型企业软件开发,其中涉及到多个场景的情况,例如B端和C端的应用,或者跨不同业务线的应用,能够保证数据的一致性,同时也能够保持逻辑独立,避免不同场景间的代码冲突。 b. 这种工程结构是我们Oinone支撑“企业级软件生态”的核心,我们可以把场景A当作我们官方应用,场景B当作其他第三方伙伴应用。在这个工程结构下,我们的客户可以定制化开发自己的应用,同时我们也可以通过这种模式来支持我们的伙伴们进行开发,实现多方共赢。 c. 基于独立boot工程模式,我们同样对应多种部署模式应对不同情况,并统一管理所有伙伴应用。这种工程结构的优点是扩展性好,可以支持不同规模的应用,并且可以根据需要进行快速扩展或缩小规模,具有很高的灵活性。 基于标准产品的二开工程结构,是指基于标准产品进行二次开发,满足客户特定需求的工程结构。这种模式下,Oinone提供标准产品,客户可以根据自己的需求进行二次开发,实现定制化需求,同时可以利用我们的模块化开发特性,将每一个需求作为一个模块进行开发和管理。这种工程结构的优点是能够快速满足客户特定需求,同时也具有很好的可维护性和可扩展性,因为每个需求都是一个独立的模块,可以方便地进行维护和扩展。在下一篇“Oinone独特性之每一个需求都是一个模块”文章中有详细介绍。

    2024年5月23日
    2.8K00

Leave a Reply

Please Login to Comment