
2.4.1 Oinone独特性之单体与分布式的灵活切换

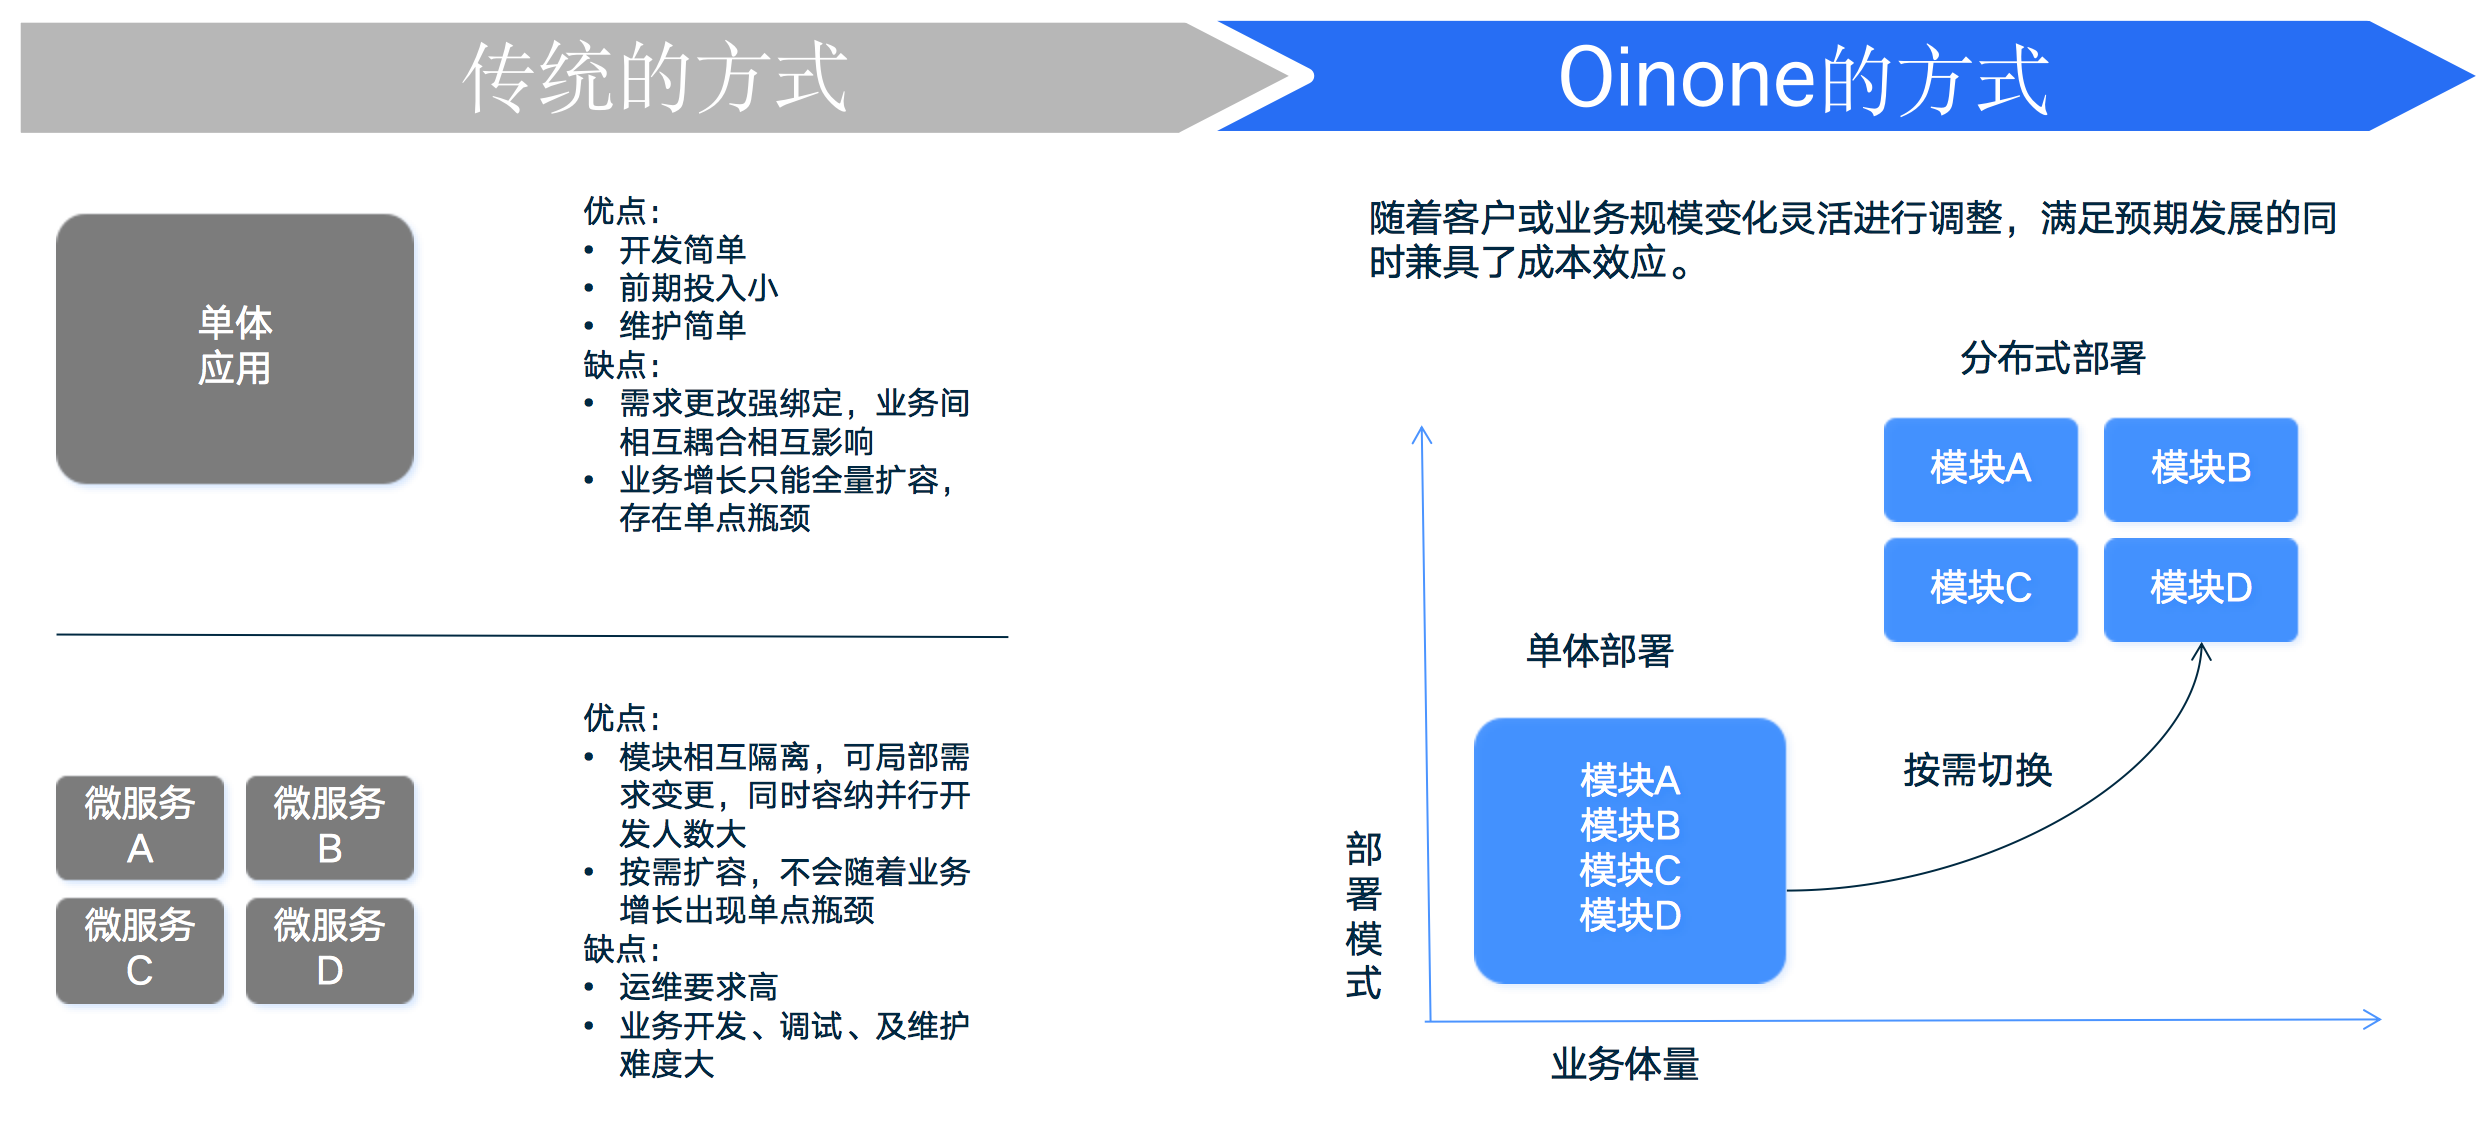
企业数字化转型需要处理分布式带来的复杂性和成本问题。尽管这些问题令人望而却步,但分布式架构对于大部分企业仍然是必须的选择。如果一个低代码平台缺乏分布式能力,那么它的性能就无法满足客户的要求。相比之下,Oinone平台通过对部署的创新(如图2-6所示),成功实现了分布式架构的支持,而且能够按照客户的业务发展需求,灵活选择不同的部署模式,同时节约企业成本,提升创新效率。这一创新是Oinone平台与其他低代码平台的重要区别,能够满足客户预期发展并兼顾成本效益。
2.4.1 Oinone独特性之单体与分布式的灵活切换

图2-6 传统部署方式VS Oinone部署方式

实现原理

要实现灵活部署的特性,必须满足两个基本要求:

  1. 开发过程中不需要过多关注分布式技术,就像开发单体应用一样简单。代码在运行时应该能够根据模块是否在运行容器中,来决定路由走本地还是远程。这样可以大大减少研发人员的工作量和技术复杂度。

  2. 研发与部署要分离,即"开发单体应用一样开发分布式应用,而部署形式由后期决定"。为此,我们的工程结构支持多种启动模式,并逐一介绍了针对不同场景的工程结构类型(如下图2-7所示)。这样可以让客户在后期根据业务发展情况和需求,选择最适合的部署模式,从而达到灵活部署的目的。

2.4.1 Oinone独特性之单体与分布式的灵活切换

图2-7 Oinone工程结构梳理

在整个工程结构上,我们秉承了Spring Boot的规范,不会改变大家的工程习惯。而Oinone的部署能力则可以让我们更灵活地应对各种情况。现在,我们来逐一介绍几种常规的工程结构以及它们适用的场景:

  1. 单模块工程结构(常规操作)

    a. 这是非常标准的Spring Boot工程,适用于简单的应用场景开发以及入门学习。

  2. 多模块工程结构(常规操作)

    a. 这是非常标准的多Spring Boot工程,可以实现分布式独立启动,适用于常规的分布式应用场景开发。

  3. 多模块工程结构-独立boot工程模式

    a. 这种工程结构在多模块工程的基础上,通过独立的boot工程来支撑多部署方式。适用于中大型分布式应用场景开发。

    b. 然而,随着工程越来越多,我们也会面临一些问题:

    ⅰ研发:环境准备非常困难,每个模块都要单独启动,研发调试跟踪困难。

    ⅱ部署:分布式的高可靠性保证需要每个模块至少有两个部署节点,但在模块较多的情况下,起步成本非常高。同时,企业初期业务不稳定且规模较小,使用多模块工程的第二种模式会增加问题排查难度和成本。

    c. 此时,Oinone的多模块工程下的独立boot工程模式部署就可以发挥其灵活性,让研发和业务起步阶段可以选择all-in-one模式,等到业务发展到一定规模的时候,只需要把线上部署模式切换成模块独立部署,而研发还可以保留all-in-one模式的优势。

    d. 值得注意的是,分分合合的部署模式在传统互联网架构和低代码或无代码平台上都是有代价的,但是Oinone却可以灵活适配,只需要在boot工程的yml文件中写入需要加载的模块就可以解决。此处我们仅介绍多模块加载配置,选择性忽略其他无关配置,具体配置(如下图2-8所示)。

    pamirs: 
    boot:
    init: true
    sync: true
    modules:
      - base
      - resource
      - sequence
      - user
      - auth
      - web
    tenants:
      - pamirs

    图2-8 Oinone yml配置图
  4. 大型多场景工程结构-独立boot工程模式:

    a. 在多模块工程结构基础上的加强版,增加CDM层设计,让不同场景即保持数据统一,又保持逻辑独立。这种工程结构特别适用于大型企业软件开发,其中涉及到多个场景的情况,例如B端和C端的应用,或者跨不同业务线的应用,能够保证数据的一致性,同时也能够保持逻辑独立,避免不同场景间的代码冲突。

    b. 这种工程结构是我们Oinone支撑“企业级软件生态”的核心,我们可以把场景A当作我们官方应用,场景B当作其他第三方伙伴应用。在这个工程结构下,我们的客户可以定制化开发自己的应用,同时我们也可以通过这种模式来支持我们的伙伴们进行开发,实现多方共赢。

    c. 基于独立boot工程模式,我们同样对应多种部署模式应对不同情况,并统一管理所有伙伴应用。这种工程结构的优点是扩展性好,可以支持不同规模的应用,并且可以根据需要进行快速扩展或缩小规模,具有很高的灵活性。

  5. 基于标准产品的二开工程结构,是指基于标准产品进行二次开发,满足客户特定需求的工程结构。这种模式下,Oinone提供标准产品,客户可以根据自己的需求进行二次开发,实现定制化需求,同时可以利用我们的模块化开发特性,将每一个需求作为一个模块进行开发和管理。这种工程结构的优点是能够快速满足客户特定需求,同时也具有很好的可维护性和可扩展性,因为每个需求都是一个独立的模块,可以方便地进行维护和扩展。在下一篇“Oinone独特性之每一个需求都是一个模块”文章中有详细介绍。

Oinone社区 作者:史, 昂原创文章,如若转载,请注明出处:https://doc.oinone.top/oio4/9220.html

访问Oinone官网:https://www.oinone.top获取数式Oinone低代码应用平台体验

Like (0)
史, 昂's avatar史, 昂数式管理员
Previous 2024年5月23日 am10:02
Next 2024年5月23日 am10:04

相关推荐

  • 3.4 Oinone以函数为内在

    函数(Function):是oinone可管理的执行逻辑单元,跟模型绑定则对应模型的方法 描述满足数学领域函数定义,含有三个要素:定义域A、值域C{f(x),x属于A}和对应法则f。其中核心是对应法则f,它是函数关系的本质特征 满足面向对象原则,可设置不同开放级别,本地与远程智能切换。 本章会带大家更加详细地了解Function的方方面面,主要以几下几个维度 构建第一个Function 函数的开放级别与类型 函数的相关特性 函数元数据详解

    Oinone 7天入门到精通 2024年5月23日
    1.8K00
  • 3.3.10 字段类型之关系描述的特殊场景

    在3.3.9【字段类型之关系与引用】一文中已经描述了各种关系字段的常规写法,还有一些特殊场景如:关系映射中存在常量,或者M2M中间表是大于两个字段构成。 举例说明关系字段-高级用法 场景描述 PetTalent模型增加talentType字段,PetItem与PetTalent的多对多关系增加talentType(达人类型),PetItemRelPetTalent 中间表维护petItemId、petTalentId以及talentType,PetDogItem和PetCatItem分别重写petTalents 字段,关系中增加常量描述。示意图如下 实际操作步骤: Step1 新增 TalentTypeEnum package pro.shushi.pamirs.demo.api.enumeration; import pro.shushi.pamirs.meta.annotation.Dict; import pro.shushi.pamirs.meta.common.enmu.BaseEnum; @Dict(dictionary = TalentTypeEnum.DICTIONARY,displayName = "达人类型") public class TalentTypeEnum extends BaseEnum<TalentTypeEnum,Integer> { public static final String DICTIONARY ="demo.TalentTypeEnum"; public final static TalentTypeEnum DOG =create("DOG",1,"狗达人","狗达人"); public final static TalentTypeEnum CAT =create("CAT",2,"猫达人","猫达人"); } Step2 PetTalent模型增加talentType字段 package pro.shushi.pamirs.demo.api.model; import pro.shushi.pamirs.demo.api.enumeration.TalentTypeEnum; import pro.shushi.pamirs.meta.annotation.Field; import pro.shushi.pamirs.meta.annotation.Model; @Model.model(PetTalent.MODEL_MODEL) @Model(displayName = "宠物达人",summary="宠物达人",labelFields ={"name"}) public class PetTalent extends AbstractDemoIdModel{ public static final String MODEL_MODEL="demo.PetTalent"; @Field(displayName = "达人") private String name; @Field(displayName = "达人类型") private TalentTypeEnum talentType; } Step3 修改PetItem的petTalents字段,在关系描述中增加talentType(达人类型) @Field.many2many(relationFields = {"petItemId"},referenceFields = {"petTalentId","talentType"},through = "PetItemRelPetTalent") @Field.Relation(relationFields = {"id"}, referenceFields = {"id","talentType"}) @Field(displayName = "推荐达人",summary = "推荐该商品的达人们") private List<PetTalent> petTalents; Step4 PetDogItem增加petTalents字段,重写父类PetItem的关系描述 talentType配置为常量,填入枚举的值 增加domain描述用户页面选择的时候自动过滤出特定类型的达人,RSQL用枚举的name @Field.many2many(relationFields = {"petItemId"},referenceFields = {"petTalentId","talentType"},through = "PetItemRelPetTalent") @Field.Relation(relationFields = {"id"}, referenceFields = {"id","talentType"}) @Field(displayName = "推荐达人",summary = "推荐该商品的达人们") private List<PetTalent> petTalents; Step5 PetCatItem增加petTalents字段,重写父类PetItem的关系描述 talentType配置为常量,填入枚举的值 增加domain描述用户页面选择的时候自动过滤出特定类型的达人,RSQL用枚举的name @Field(displayName = "推荐达人") @Field.many2many( through = "PetItemRelPetTalent", relationFields = {"petItemId"}, referenceFields = {"petTalentId","talentType"} ) @Field.Relation(relationFields = {"id"}, referenceFields = {"id", "#2#"}, domain = " talentType == CAT") private List<PetTalent> petTalents; Step6 清除中间表demo_core_pet_item_rel_pet_talent的数据记录 清除PetItem与PetTalent的多对多中间表demo_core_pet_item_rel_pet_talent的数据记录 Step7 重启看效果 修改达人记录,选择不同达人类型 PetItem、PetCatItem、PetDogItem不同的交互页面

    2024年5月23日
    1.9K00
  • 3.3 Oinone以模型为驱动

    模型(model):Oinone一切从模型出发,是数据及对行为的载体: 是对所需要描述的实体进行必要的简化,并用适当的变现形式或规则把它的主要特征描述出来所得到的系统模仿品。模型由元信息、字段、数据管理器和自定义函数构成; 符合面向对象设计原则包括:封装、继承、多态。 本章会带大家快速而全方位地认识Oinone的模型。会从以下几个维度去对模型展开详细介绍。 构建第一个Model 模型的类型 模型的数据管理器 模型的继承 模型编码生成器 枚举与数据字典 字段序列化方式 字段类型之基础与复合 字段类型之关系与引用

    Oinone 7天入门到精通 2024年5月23日
    1.7K00
  • 4.1.8 函数之事务管理

    一、事务管理介绍 函数Function支持事务字段为isTransaction(默认为false),事务传播行为propagationBehavior(默认PROPAGATION_SUPPORTS),事务隔离级别isolationLevel(默认使用数据库默认的事务隔离级别),所以不会默认为函数添加事务。另外事务配置提供全局配置。 平台事务管理兼容Spring声明式与编程式事务,支持多数据源事务管理。事务管理中多数据源嵌套独立事务,不会造成死锁风险。使用多数据源或分表操作,不会导致脏读。如果需要多数据源分布式事务,请使用PamirsTransational分布式事务管理方案(@PamirsTransational(enableXa=true))。分布式事务一般用于量小的跨模块配置管理场景 使用方式 声明式事务,使用@PamirsTransactional注解在需要事务管理的类或方法上标注。在非无代码场景下,与@Transactional注解功能一致。 编程式事务,使用PamirsTransactionTemplate即可。在非无代码场景下,与TransactionTemplate功能一致。 配置式事务,使用TxConfig模型在模块安装时初始化存储事务配置数据。 事务特性 原子性 (atomicity):强调事务的不可分割. 一致性 (consistency):事务的执行的前后数据的完整性保持一致. 隔离性 (isolation):一个事务执行的过程中,不应该受到其他事务的干扰 持久性(durability) :事务一旦结束,数据就持久到数据库 事务隔离级别 事务隔离级别指的是一个事务对数据的修改与另一个并行的事务的隔离程度,当多个事务同时访问相同数据时,如果没有采取必要的隔离机制,就可能发生以下问题: 问题 描述 脏读 一个事务读到另一个事务未提交的更新数据,所谓脏读,就是指事务A读到了事务B还没有提交的数据,比如银行取钱,事务A开启事务,此时切换到事务B,事务B开启事务–>取走100元,此时切换回事务A,事务A读取的肯定是数据库里面的原始数据,因为事务B取走了100块钱,并没有提交,数据库里面的账务余额肯定还是原始余额,这就是脏读 不可重复读 在一个事务里面的操作中发现了未被操作的数据 比方说在同一个事务中先后执行两条一模一样的select语句,期间在此次事务中没有执行过任何DDL语句,但先后得到的结果不一致,这就是不可重复读 幻读 是指当事务不是独立执行时发生的一种现象,例如第一个事务对一个表中的数据进行了修改,这种修改涉及到表中的全部数据行。 同时,第二个事务也修改这个表中的数据,这种修改是向表中插入一行新数据。那么,以后就会发生操作第一个事务的用户发现表中还有没有修改的数据行,就好象 发生了幻觉一样。 表4-1-8-1 事务隔离级别 Pamirs(Spring)支持的隔离级别 隔离级别 描述 DEFAULT 使用数据库本身使用的隔离级别 ORACLE(读已提交) MySQL(可重复读) READ_UNCOMITTED 读未提交(脏读)最低的隔离级别,一切皆有可能。 READ_COMMITED 读已提交,ORACLE默认隔离级别,有不可重复读以及幻读风险。 REPEATABLE_READ 可重复读,解决不可重复读的隔离级别,但还是有幻读风险。 SERLALIZABLE 串行化,最高的事务隔离级别,不管多少事务,挨个运行完一个事务的所有子事务之后才可以执行另外一个事务里面的所有子事务,这样就解决了脏读、不可重复读和幻读的问题了 表4-1-8-2 隔离级别与描述 隔离级别 脏读可能性 不可重复读可能性 幻读可能性 加锁度 READ_UNCOMITTED 是 是 是 否 READ_COMMITED 否 是 是 否 REPEATABLE_READ 否 否 是 否 SERLALIZABLE 否 否 否 是 表4-1-8-3 隔离级别说明表 事务的传播行为 保证同一个事务中 PROPAGATION_REQUIRED 支持当前事务,如果不存在 就新建一个(默认) PROPAGATION_SUPPORTS 支持当前事务,如果不存在,就不使用事务 PROPAGATION_MANDATORY 支持当前事务,如果不存在,抛出异常 保证没有在同一个事务中 PROPAGATION_REQUIRES_NEW 如果有事务存在,挂起当前事务,创建一个新的事务 PROPAGATION_NOT_SUPPORTED 以非事务方式运行,如果有事务存在,挂起当前事务 PROPAGATION_NEVER 以非事务方式运行,如果有事务存在,抛出异常 PROPAGATION_NESTED 如果当前事务存在,则嵌套事务执行 A中嵌套B事务,嵌套PROPAGATION_REQUIRES_NEW方法勿与A在同类中。 异常状态 PROPAGATION_REQUIRES_NEW (两个独立事务) PROPAGATION_NESTED (B的事务嵌套在A的事务中) PROPAGATION_REQUIRED (同一个事务) A抛异常 B正常 A回滚,B正常提交 A与B一起回滚 A与B一起回滚 A正常 B抛异常 1.如果A中捕获B的异常,并没有继续向上抛异常,则B先回滚,A再正常提交; 2.如果A未捕获B的异常,默认则会将B的异常向上抛,则B先回滚,A再回滚 B先回滚,A再正常提交 A与B一起回滚 A抛异常B抛异常 B先回滚,A再回滚 A与B一起回滚 A与B一起回滚 A正常 B正常 B先提交,A再提交 A与B一起提交 A与B一起提交 表4-1-8-4 事务传播行为 二、声明式事务(举例) Step1 修改PetShopBatchUpdateAction 用@PamirsTransactional或者@Transactional注解来声明事务,PamirsTransactional跟Spring的Transactional区别在于PamirsTransactional支持多库事务,但此多库事务为非严格的分布式多库事务,之所以选择这个方案,原因如下 a. 不损害任何性能。 b. 事务保障率超过4个9 c. 经过阿里的大厂验证,特别是在阿里的结算平台中得到了很好的验证 @PamirsTransactional更多配置项请详见4.1.7【函数之元数据详解】一文,自己多试试。同时@PamirsTransactional百分百兼容@Transactional @Action(displayName = "确定",bindingType = ViewTypeEnum.FORM,contextType = ActionContextTypeEnum.SINGLE) @PamirsTransactional //@Transactional public PetShopBatchUpdate conform(PetShopBatchUpdate data){ if(data.getPetShopList() == null || data.getPetShopList().size()==0){ throw PamirsException.construct(DemoExpEnumerate.PET_SHOP_BATCH_UPDATE_SHOPLIST_IS_NULL).errThrow(); } List<PetShopProxy> proxyList = data.getPetShopList(); for(PetShopProxy petShopProxy:proxyList){ petShopProxy.setDataStatus(data.getDataStatus()); } new PetShopProxy().updateBatch(proxyList); throw PamirsException.construct(DemoExpEnumerate.SYSTEM_ERROR).errThrow(); // return data; } 图4-1-8-1 修改PetShopBatchUpdateAction Step2 重启看效果 进入店铺管理列表页,选择记录点击【批量更新数据状态】按钮,修改记录的数据状态为【未启用】,提交看效果。期望效果为:提示系统异常,数据修改失败 图4-1-8-2 数据状态显示已启用 图4-1-8-3 批量更新数据状态…

    2024年5月23日
    1.8K00
  • 1.1 Oinone的萌芽

    在信息化时代,中国并没有涌现出一家世界知名的软件公司。这是因为像SAP、Oracle、IBM、Salesforce、NetSuite、Odoo等西方巨头所拥有的最佳实践在业务、技术和模式方面,给予了它们在企业信息化建设中高额利润的优势。中国软件业在这个时代的角色是学习和追随者,而最优秀的追随者是金蝶和用友,它们能在国家推行会计电算化的机遇中占据领先地位。但是,追随者始终只是追随者,没有真正的突破。 我自己进入软件行业的经历可以追溯到2015年。当时资本市场非常热门,大家都在创业。我认为这是一个时代的机会,就像国家改革开放一样。于是,我和很多同事一起开始了创业之旅。在数式之前,我加入并创办了三家公司:500mi、数列和端点。整个过程给了我宝贵的经验和启示,帮助我找到了最终想要的方向。 在500mi公司时,我从技术岗位转型为业务经营,起步并不顺利。然而,我从这份经历中获得了一堂重要的课:做自己擅长的事情,有助于渡过创业启动期最艰难的阶段。同时,市场调研为我提供了一个信号:传统企业对于IT的需求正逐渐向互联网靠拢。这个信号像注入了一剂强心剂,激励我继续前行。 2016年,我和三个曾在阿里工作的同事一起创办了一家新公司——数列,我们决定专注于我们最擅长的领域,即软件服务商。在没有任何商务资源的情况下,我们第一年就完成了1000多万的合同,这相较之前是一个非常成功的开端。然而,对于公司未来的发展方向,我们花费了长达大半年的时间进行思考:应该坚持做底层的PaaS还是专注于企业可见的上层应用和业务产品?我倾向于后者。尽管我们持续存在分歧,但凭借着多年的革命友情,最终我们友好地分道扬镳。数列此前的成功让我更加坚信:在数字化时代,软件需求将会有井喷式的增长,数字化软件服务将是未来5-10年的重要方向。而在这个领域,专业的技能将是应对未来不确定性的真正力量。 提到数字化,就不得不提阿里巴巴提出的中台理念。中台理念在15年前被阿里巴巴提出,当时引起了广泛的关注和讨论。企业之所以认同中台理念,是因为他们的核心需求已经从内部转向外部:从关注管理、流程、效率的提升,转向关注外部协同、运营、创新。他们已经不再只担心企业的效率和成本,而是担心自己是否有能力跟上时代的快速变化。现今做生意的渠道已经不再是单一的线下渠道,而是包括淘宝、天猫、京东、拼多多、抖音、快手等多个线上渠道,以及海外市场,这种变化速度非常快。而中台的核心理念是敏捷响应、低成本快速创新,正好解决了企业主的核心焦虑。 企业的视角正在从内部管理向业务在线和生态在线(协同)转变,这种转变带来了一系列新的需求(如下图1-1所示)。这种转变不仅是为了支持现有业务的发展,也为企业未来的业务发展和创新提供了支持,并将变化实时反映到上下游合作伙伴中。 图1-1 企业视角转变带来一系列新的诉求 在2017年下半年,阿里云收购了端点科技,打算重启阿里软件。那个时候,市场上涌现出一批中台厂商,整个行业也比较混乱,很多人对互联网架构本身的理解不够深入,快速学习拿到阿里云认证后就开始做定制化的中台架构开发,但最终的效果无法达到预期。因此,阿里云和端点科技的联姻是为了弥补阿里云没有向外输出上层应用产品能力的缺陷。多年来,软件市场一直被国外厂商掌控,中国一直缺乏一个强大的本土软件公司。阿里收购端点,承载着无数中国人的软件梦想。在这种背景下,我回到了阿里体系,加入了端点科技。后来,我参与了许多中台项目,深刻地认识到搭建中台技术架构和一些基础能力,为上层应用场景落地并不难。但是,当客户接手扩展中台能力和新的上层应用场景时,效果往往不尽如人意,这并不是中台架构理念的问题,而是因为传统企业客户的IT能力大多较弱,这是一个硬伤。许多文章都在讲述中台战略,长篇大论地描述组织中台、技术中台、业务中台、数据中台,我们不去评论这些方法论的对错,从技术角度回到初衷,我们只关注一个问题:技术是为商业服务的,中台如何快速满足企业业务多变的需求? 我们经历了多个行业的中台建设,每次都向客户强调第一阶段是打好基础,因此需要较长的周期,并且每个项目都需要顶级架构师来把控整体项目。如何找到互联网架构与传统软件良好结合点,降低对组织的要求,实现中台架构的标准化输出?这是我回归阿里后致力于解决的问题。然而,随着阿里云对端点战略发展思路的变化,阿里不再提供SaaS服务,而只愿意做平台被其他企业集成。因此,我离开了端点,并决定把自己的技术思考转化为现实,于是数式科技诞生了。 在数字化时代,无论是业务、技术还是商业模式的最佳实践,都源自中国。中国已经从追随者转变为互联网领域的全面引领者。我们有理由相信,中国一定会崛起一家世界级的软件公司,而Oinone将始终以此为愿景。

    2024年5月23日
    2.4K00

Leave a Reply

Please Login to Comment