
1.4 Oinone对软件特性的思考

我在个人的微信公众号上《浅谈企业IT架构的十年困局》一文中写了“企业或者软件公司在工程领域都关注哪些特征,而这些特征又应与具体研发人员的个体能力无关”的相关内容。收到很多业内人士的留言,也引起了很多同行的共鸣,所以今天在这里也打算针对这个话题,跟大家再做个深入的探讨。

一、首先为什么强调要跟研发个体能力无关

我们先来看一个故事:

轮扁是春秋时期齐国的木工,齐桓公召其入宫打造物件。有一天,齐桓公在堂上看书,轮扁在堂下用椎、凿等工具做车轮。

齐桓公看书看到得意处,不由得读出声来。轮扁听到读书声,想了想,放下手里的工具,走上堂来,在齐桓公面前几步远的地方停下,恭恭敬敬地说:“请恕臣斗胆问一下,君王读的是什么书?”齐桓公没想到这个老木匠会走上堂来,倒有点意外。不过看在他年纪大的份上,倒也不去斥责他,就回答说:“寡人读的是圣人写的书。”轮扁问:“圣人还在吗?”齐桓公说:“已经死了。”轮扁说:“这样看起来,君王所读的,不过是古人的糟粕而已!”齐桓公勃然大怒,说:“寡人读书,你一个做车轮的怎么敢议论?你说,这书上怎么会是古人的糟粕?说出道理便罢,说不出道理便难逃一死!”

轮扁不慌不忙地说:“臣是根据臣所从事的活计而明白这个道理的。砍削轮子,榫头做得宽了则松滑而不牢固,做得太紧就必然涩滞而安不进去,臣制作的榫头松紧适宜,是因为心里怎样想的手便怎样去做。然而尽管所需要的分寸度数心里都明白,要把它用言辞表达出来却实在不可能,全靠自己手与心的配合。所以,臣无法将其中的奥秘传授给儿子,臣的儿子也无法从臣这里学到其中的奥秘。因此,臣如今七十多岁了,还只好亲手去干制作轮子的活。这样看来,古人之道的精华都已随着古人死去而无法传世,那么君王所读的,不就是古人的糟粕了吗?”

这就是著名的成语故事——轮扁斫轮,出自《庄子·天道》。庄子通过轮扁的言论,深刻地揭示了高妙之技的难以言传。

而当我们转换视角,在企业数字化转型领域,无论是软件公司还是甲方IT团队,核心上是应用级开发需求,更多的精力应该放在业务场景理解、需求把控以及业务系统实现上。但往往在一个项目进入研发之前,会花很大力气在技术架构设计、技术栈选型、通用能力对接、扩展点设计这些跟业务场景无关的技术事项上,且需要高级别的架构师来主导。大部分情况下,架构师会选开源框架来实现,慢慢沉淀为企业的研发标准体系,所以底层架构的能力往往依赖架构师个人能力。不禁发现他们与轮扁有着异曲同工之处。架构师所积累的个人经验和技术能力,往往难以通过简单的手把手教学、技术评审会完全传递给团队中的其他成员。即使有所传授,其效率也可能仅达到50%,并且随着团队成员数量的增加,这种效率还可能持续递减。因此,我们需要更多地依赖于技术手段,将架构师的经验和能力固化下来,形成一套可复制、可推广的标准技术产品。这样,每个团队成员都能够通过学习和运用这些技术,达到至少70%的传递效率,从而确保团队整体技术水平的稳步提升。这也正是开篇所强调的,企业或软件公司在工程领域所关注的特征,应当与具体研发人员的个体能力相剥离,而更多地依赖于标准化、系统化的技术手段,来确保团队整体的高效运作。

二、软件公司在工程化领域都关注哪些特征

接下来,我将从技术角度深入剖析设计初衷和技术实现原理,以展现技术公司应当“被标准化的特征”究竟长什么样。

先做个名称解释,下文中涉及“标品”、“升级”、“扩展逻辑”,这是站在软件公司角度出发描述的,如果是企业内部可以把标品理解为特定业务应用平台,升级则是业务应用平台的正常规划迭代,扩展逻辑理解为脱离平台发展的临时性需求。

1. 可逆计算
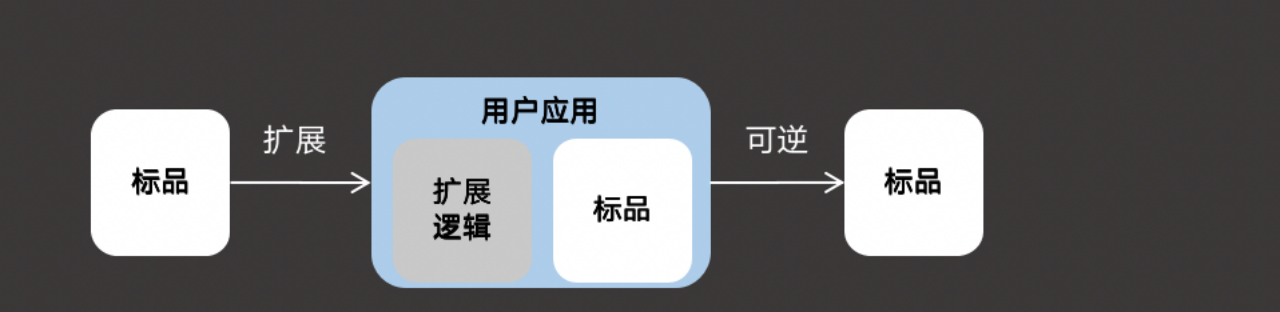
image.png

可逆计算,在应用上的特征图

场景:调查发现企业研发至少有40%的精力在跟各条业务线的团队在评审项目需求,判断需求是否合理。而且业务线对需求完善时间要求紧,每天盯着研发进度,经常问“这个需求什么时候支持,我们等着用”。导致产研部门的研发抱怨产品节奏乱,无法按照自身节奏进行迭代,被项目推着走,没有时间思考,人手不足,加班多,工作压力大……

价值:该特性很好的规避了研发因为时间紧迫,写的一些临时代码腐蚀核心业务系统。它需要做到不论从数据模型、业务逻辑、交互展示都能有扩展能力,并且这些扩展能力与个体研发无关才行。它同时所描述的也是一个具备差量计算能力的软件架构模式,它允许用户通过添加或移除扩展包来定制标准应用,同时保持应用的可逆性和独立性。这种架构模式的核心优势在于其灵活性和可维护性,使得应用的定制和恢复变得简单而高效。

技术原理:它所描述的是一个基于元数据驱动和差量计算的软件架构模式,它允许用户通过添加或移除扩展包来定制标准应用,同时保持应用的可逆性和独立性。这种架构模式的核心优势在于其灵活性和可维护性,通过元数据来驱动应用的构建和变更,使得应用的定制和恢复变得简单而高效

在这种架构中,元数据起到了至关重要的作用。元数据是关于数据的数据,它描述了数据的结构、属性、关系等信息。在软件应用中,元数据可以用来描述应用的组件、功能、配置等信息。通过元数据驱动应用可以根据元数据的描述来动态地构建和配置自身的功能和结构

差量计算则是实现应用可逆性的关键。当添加或移除扩展包时,系统会根据扩展包中的元数据与标准应用的元数据进行差量计算,确定需要添加或移除的功能和组件。这种差量计算可以确保在添加扩展包后,应用能够保持原有的功能和稳定性,同时新增扩展包带来的新功能,而在去除扩展包时,应用能够恢复到原始的标准状态,不会留下任何冗余或冲突的代码和配置。

为了实现这种架构模式,元数据注册表和分布式部署能力是非常重要的。元数据注册表需要能够存储和管理大量的元数据信息,并且提供高效的查询和更新机制。分布式部署能力则能够确保应用在不同的环境中都能够稳定运行,并且能够快速地响应扩展包的添加和移除操作,即差量(扩展包》可独立存在又相互作用。

总的来说,这种基于元数据驱动和差量计算的软件架构模式为应用的定制和恢复提供了强大的支持,使得应用能够根据不同的需求进行灵活的定制和扩展。同时,它也提高了应用的可维护性和可靠性,降低了开发和维护的成本

2. 协同演进
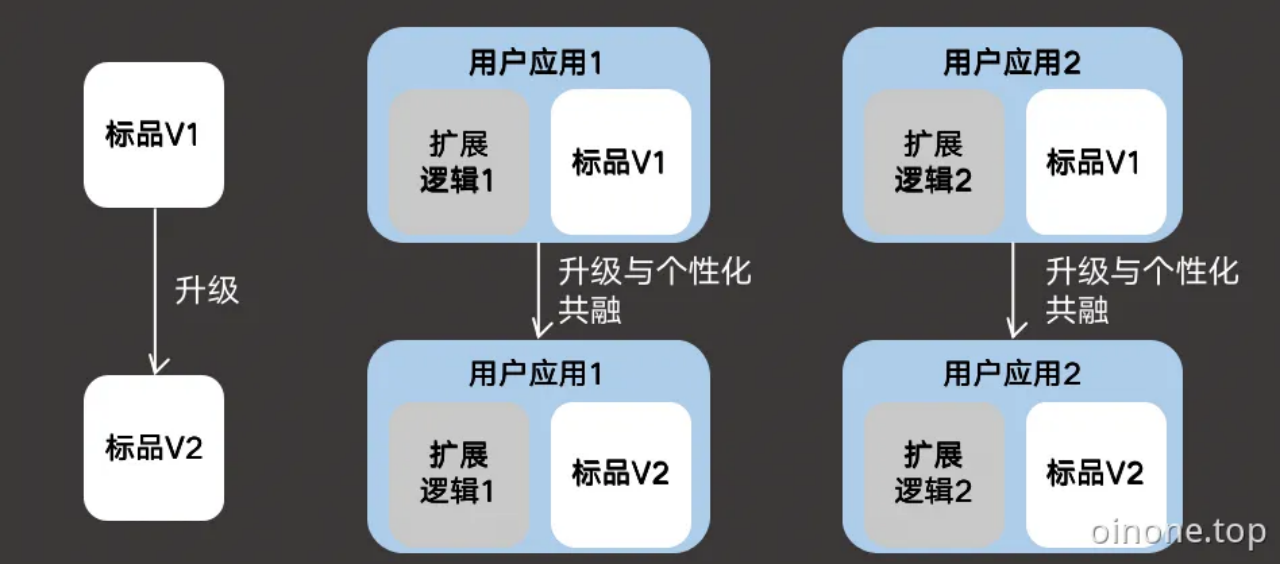
image.png

协同演进,在应用上的特征图

场景:它所描述的场景是一个复杂的软件升级过程,其中涉及了标准应用的升级以及用户个性化扩展的保留。通过面向对象的方式扩展标准应用的功能,可以在升级过程中保持用户自定义逻辑的完整性,并同时集成新版本中的新特性。

价值:很多号称产品型的软件公司,在交付客户项目的时候,都是从标品复制一个分支,然后客户个性化直接在这个分支上改。这种模式会带来两个问题:

  1. 是当客户数量变大,每个客户的版本都不一致,维护成本很高;

  2. 是当标品升级带来的新特性无法复制给客户,导致客户满意度下降甚至流失。协同演进就是要解决这个问题。

技术原理:它需要在第一个差量计算的特性基础上才能得以完成,同时在这种升级能力中,元数据驱动和模型驱动是关键所在。元数据驱动确保了应用能够理解和处理不同版本之间的变化,包括功能的增删改以及结构的调整。模型驱动则提供了描述和管理应用结构、组件和行为的能力,它不仅能够描述模型间的关系,还能够支持面向对象的特性,如继承、重写和重载等。

具体来说,当标准应用从V1升级到V2时,元数据驱动机制会首先识别和分析两个版本之间的差异。对于用户应用1中已经扩展的A功能,由于采用了面向对象的方式进行扩展,因此在升级过程中,A+逻辑作为A功能的重写或重载版本会被保留下来。同时,V2版本中新增的B功能也会被集成到用户应用1中,因为它是作为标准应用的新特性而存在的。

这种升级能力的实现依赖于一个强大的元数据注册表和模型管理能力。元数据注册表需要能够存储和管理不同版本应用的元数据信息,包括功能、组件、结构等。模型管理能力则需要能够解析和应用这些元数据,以生成正确的应用结构和行为。同时,还需要一套高效的升级机制来确保升级过程的平滑和可靠。

总的来说,通过元数据驱动和模型驱动的结合,可以实现标准应用的平滑升级,同时保留用户个性化扩展的完整性。这种能力对于提高软件的可维护性、可扩展性和用户满意度具有重要意义

3. 公民研发和专业研发共同参与
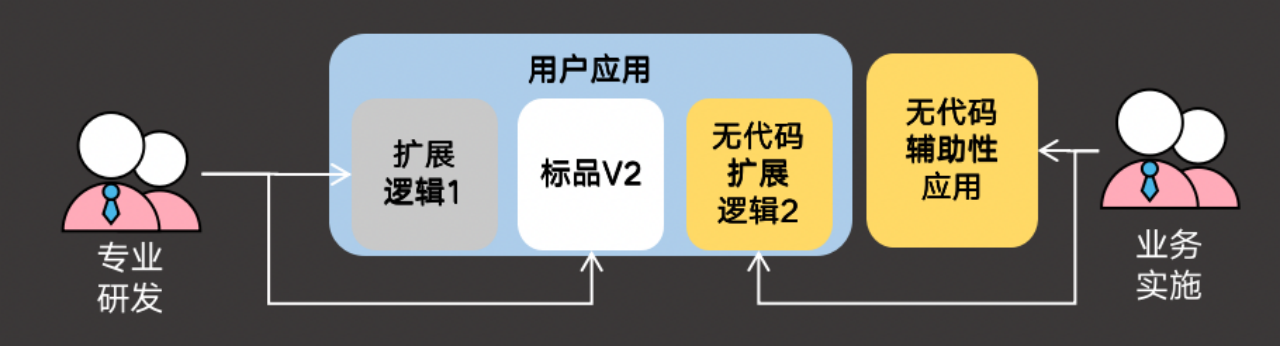
image.png

专业研发与公民研发共同参与,在应用上的特征图

场景:它所描述是在应用开发的整个生命周期中,专业研发专注在标品的长期规划与迭代,当出现临时性的需求或者应急性的辅助场景则由非专业人士进行即公民研发方式进行。这种模式下,专业研发可以按照规划有节奏的迭代产品,做更高级的事情,不至于忙于应对临时性的事务没有深度思考,更加避免了因为临时代码堆积导致产品从内部腐化。同时利用独立的扩展逻辑包和无代码方式解决了业务的紧迫感,毕竟业务需求的合理性是很难争论出高低的。它在前两个特性基础上让研发效能进一步得到释放。

价值:它的本质是,在专业研发在以低代码的方式下实现应用,并通过无代码的方式,快速扩展逻辑功能和创建辅助性应用。整个过程无缝衔接,我们给他取个名字专业名称叫:“低无一体”。它大大降低了技术门槛,使得专业和非专业的研发人员都能参与到应用扩展和定制中来。此外,它还提高了业务响应能力,使得企业能够更快速地适应市场变化和客户需求。

技术原理:它的核心要求就是元数据在线,元数据在线能力是指能够实时地、在线地管理和操作元数据,这种能力为企业或组织带来了诸多优势。通过无 代码的方式,用户可以更加灵活地进行应用的个性化扩展,以应对各种应急性需求,从而显著提升业务的响应能力。此外,元数据在线管理还确保核心应用、核心应用扩展以及辅助应用都是基于一套统一的技术体系构建的,这为不同角色的用户(包括专业和非专业的研发人员)提供了多样化的参与方式。同时,元数据在线管理需要符合开闭原则,这确保了系统的稳定性和可扩展性,使得新的功能或需求可以通过添加新的元数据或配置来实现,而非修改现有系统。

这种低代码开发与无代码一体化的优势在于,它大大降低了技术门槛,使得专业和非专业的研发人员都能参与到应用扩展和定制中来。此外,它还提高了业务响应能力,使得企业能够更快速地适应市场变化和客户需求。

总之,从用户应用到业务实施的过程通过元数据在线得到了优化和升级。低代码开发与无代码一体化的优势使得整个过程更加高效、灵活和易于维护,为企业带来了显著的价值和竞争优势。

4. 基于平台级别的AOP能力出现反向集成
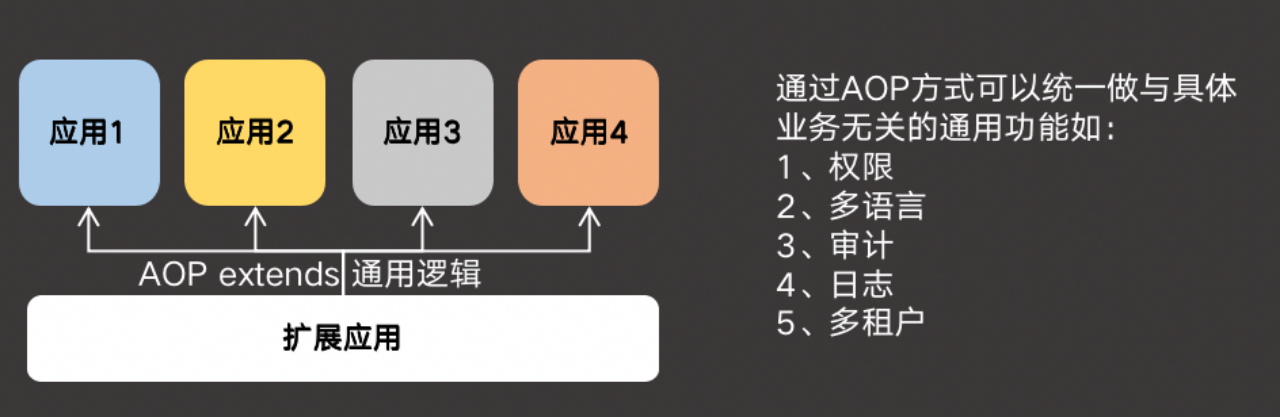
image.png

反向集成,在应用上的特征图

场景:平台级别的AOP(面向切面编程)能力允许开发者在应用程序的特定点“切入”额外的逻辑,而无需修改原有的业务代码。这种能力特别适用于横向追加平台逻辑,即在多个不同服务或功能点插入通用的处理逻辑,如日志记录、权限检查、审计、多租户、多语言等。过往在微服务架构中,这些能力都需要业务系统各自主动去对接,有了平台级别的AOP能力,则这些通用能力可以反向为所有业务系统增加特性能力,无需业务系统研发感知。这种现象我们称之为“反向集成”,能让业务研发更加专注在业务研发本身,不需要关心与业务无关的通用功能上。

价值:AOP的核心思想是将这些横切关注点(cross-cutting concerns)从业务逻辑中分离出来,使得业务代码更加清晰和专注于其核心功能。在平台级别的AOP中,标准化协议是实现这一能力的关键。平台具备统一的入口和扩展能力是非常重要的,因为它允许开发者在不修改现有代码的情况下添加新功能或修改现有功能的行为。这种能力对于快速响应业务需求变化、减少维护成本和提高代码质量都是非常有益的。

技术原理:标准化协议确保了不同组件之间的通信与语义是统一的,从而使得AOP能够更容易地实施。例如:

a前后端通信要标准协议(与端无关): 这意味着无论前端是使用Web、移动应用还是其他类型的客户端,后端服务都应该能够以一种标准的方式与之通信。

bORM层要有标准协议(与数据库无关): 对象关系映射 (ORM)层应该提供一个标准的接口来与数据库进行交互,这样无论底层使用哪种数据库(如MySQL、PostgreSQL、Oracle等),上层的业务逻辑都不需要改变。

cRPC需要标准协议(与Dubbo和Spring Cloud无关): 远程过程调用 (RPC)应该遵循一种标准协议,以便不同的服务可以无缝地进行通信,而不受特定框架 (如Dubbo、Spring Cloud等)的限制。

d所有逻辑调用统一fun调用: 这意味着平台上的所有功能调用都应该通过一个统一的入口点(如一个函数或方法)进行,这样AOP就可以在这个入口点切入额外的逻辑。

总的来说,平台级别的AOP能力通过标准化协议和统一的调用入口,为开发者提供了一种强大而灵活的方式来管理和扩展平台的逻辑功能。

5. 应用研发与部署无关
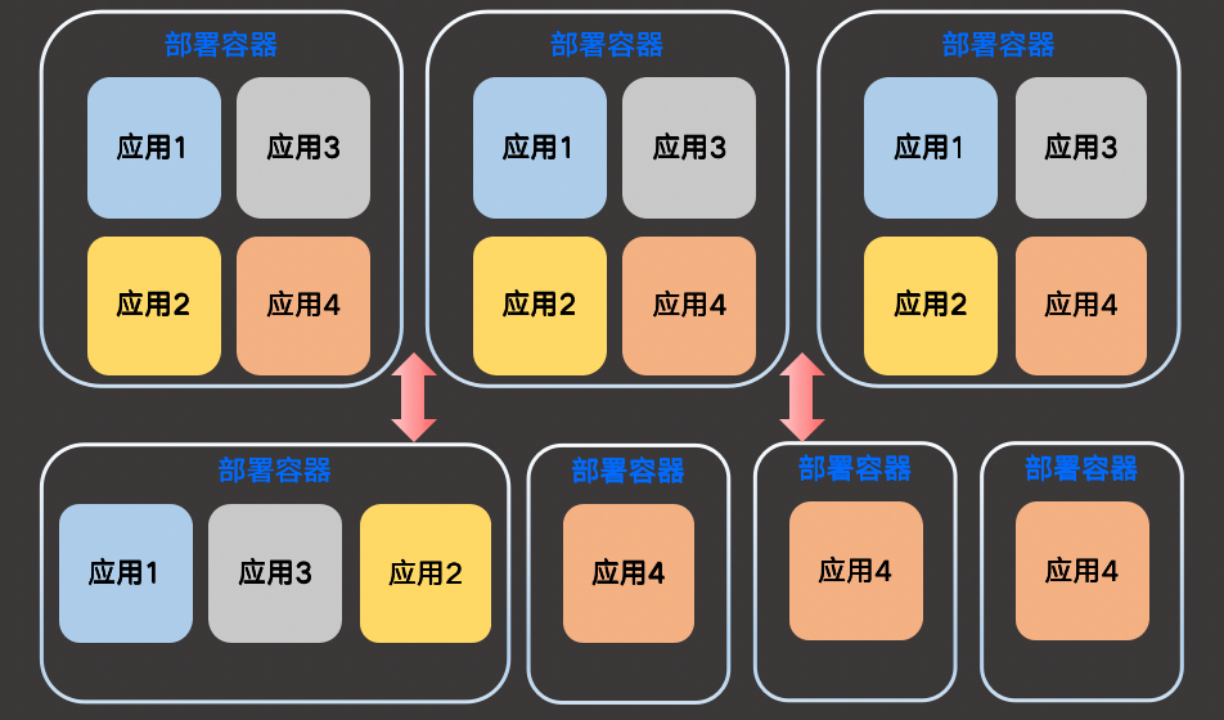
image.png

应用研发与部署无关,在应用上的特征图

场景:现在研发在选择部署方式的时候往往会选择分布式部署,或者你的客户招标需求里就写着“微服务”,构建一个微服务系统并不是一件容易的事,构建的复杂度远远超过单体系统,开发人员需要付出一定的学习成本去掌握更多的架构知识和框架知识。服务与服务之间通过HTTP协议或者消息传递机制通信,开发者需要选出最佳的通信机制,并解决网络服务较差时带来的风险。另外服务与服务之间相互依赖,如果修改某一个服务,会对另一个服务产生影响,如果掌控不好。会产生不必要的麻烦。由于服务的依赖性,测试也会变得很复杂,比如修改一个比较基础的服务,可能需要重启所有的服务才能完成测试。前段时间有篇很火的文章,《从微服务转为单体架构、成本降低 90%!》,无论是选择何种部署方式,我认为这都应该跟应用研发无关。

价值:应用研发与部署无关的理念确实为现代软件架构带来了显著的优势,它使得研发团队能够专注于业务逻辑和功能实现,而无需担心具体的部署细节。这种分离带来了灵活性、效率以及成本效益的多重提升。应该采用一种同时支持分布式和单体部署、且可以自由切换的架构,我们称之为可分可合。

首先,可分可合的能力使得系统能够灵活应对业务量的变化。在业务量小的时候,可以采用单体部署的方式,简化部署流程,降低初期成本。随着业务量的增长,系统可以平滑地过渡到分布式部署,通过拆分微服务来提高系统的处理能力和扩展性。这种灵活性确保了系统既能满足未来发展的需要,又能兼顾当下的成本效益。

其次,应用级别扩容的能力使得系统性能不再受限。通过增加微服务实例或调整资源配置,系统可以按需进行扩容,从而确保在业务高峰期或突发流量下仍能保持稳定的性能。这种按需扩容的方式不仅提高了系统的可靠性,还降低了运维成本。

技术原理:核心在于逻辑调用的统一执行和智能判断。通过如funEngine这一统一调用引擎,系统能够智能地选择最适合当前业务场景和性能需求的fun调用方式。无论是同步调用、异步调用还是基于消息队列的调用方式,funEngine都能进行智能决策,确保调用的高效性和可靠性。这种统一调用的方式简化了开发过程,降低了开发难度,同时也提高了系统的可维护性和可扩展性。

此外如果作为低代码或者其他研发平台来说。被集成特性也是实现该特性的关键所在。它提供了一套标准化的接口和协议,使得其他系统或应用能够轻松地与其进行集成。这种平台框架化的特性能够作为一个统一的、可扩展的框架来支撑整个系统的运行。

综上所述,具备可分可合的能力、应用级别扩容以及逻辑调用的统一执行和被集成特性,共同构成了应用研发与部署无关这一核心特性。该特性使得软件系统能够灵活地应对业务变化,实现高效、可扩展和可维护的运行,从而满足客户的长期发展需求并兼顾当下的成本效益。

Oinone社区 作者:史, 昂原创文章,如若转载,请注明出处:https://doc.oinone.top/oio4/9213.html

访问Oinone官网:https://www.oinone.top获取数式Oinone低代码应用平台体验

Like (0)
史, 昂's avatar史, 昂数式管理员
Previous 2024年5月23日 am10:09
Next 2024年5月23日 am10:11

相关推荐

  • 模型

    1. 模型介绍 Oinone低代码设计器是采用模型驱动的方式来设计应用,数据、数据都在模型,在模型设计器的模型管理模块,通过可视化配置的方式为用户提供快速设计模型的功能。 模型是对应用中所需要描述的实体进行必要的简化,并用适当的变现形式或规则把它的主要特征描述出来所得到的系统模仿品。模型由元信息、字段、数据管理器和自定义函数构成。 2. 操作模式 为了满足有无研发背景知识的不同用户使用需求,在模型设计器中,支持切换操作模式,包含专家模式和经典模式。经典模式功能基础且完善,操作交互简单易理解,适用于非研发用户;专家模式下模型的设计能力更高,有经典模式下的所有功能,相比于经典模式,功能更多,适用于一般有研发知识基础的用户。 比如在添加模型时,经典模式下可以创建的模型类型有:存储模型、传输模型,专家模式下,在此基础上还可以创建抽象模型和代理模型。 3. 分组管理 当模型过多时,可以自定义添加15个分组,将模型进行归类管理。点击「全部」展开所有分组,展开后,分组右侧可以管理分组。 3.1 管理分组 展开分组后,点击「管理分组」,出现弹窗,在弹窗中可以修改分组名称、添加分组、删除分组。 3.2 添加分组 操作「+模型分组」,可以直接输入分组名称后回车以添加一个新分组,或快捷选择其他应用使用的分组。最多添加15个分组。 3.3 修改分组 双击分组标签,即可对已有分组进行名称的修改。若分组在其他应用也使用,则在其他应用内,该分组名称也同步变化。 3.4 删除分组 点击分组标签右侧的“X”按钮,即为删除分组,但分组下如果有模型或者分组有被其他应用使用,则分组无法删除。 4. 模型管理 4.1 管理模式 在模型管理中,有两种管理模式,分别是图管理模式和列表管理模式。(下文简称图模式、表模式) 可以根据不同的使用场景,切换管理模式: 图管理模式下,模型操作区展示当前模型和与当前模型有直接关联关系的模型关系图,可以在关注模型关联关系时使用; 列表管理模式下,展示更多更详细的模型信息、字段信息,且左侧可快速切换不同模型,可以在关注模型基础信息时使用; 4.2 筛选 4.2.1 图模式筛选 在图模式下,顶部进行应用/模块、模型类型、分组的筛选,依此向下可以搜索或展开当前筛选条件下的模型列表,切换模型后在模型操作区将展示另一模型的信息。为了更大程度保留图模式下的模型展示区域,模型列表默认不会展示,点击搜索行的任意筛选项,即可展开模型列表。 4.2.2 表模式筛选 在表模式下,顶部和图模式一致,都是应用/模块、模型类型、分组的筛选,模型操作区左侧会直接展示模型列表。 4.2.3 重置筛选 图模式和表模式下,右侧都有重置筛选的选项。如果点击“重置筛选”按钮,则将筛选栏恢复到进入页面时的选项。 4.3 模型分组 模型新增成功后,默认无所属分组,每个模型可以设置所属分组,设置后通过分组进行筛选时,模型即展示在所属分组下。 4.3.1 图模式设置分组 图模式下为模型设置分组,点击模型信息顶部第一个「模型分组」操作图标,点击后设置或修改分组。 4.3.2 表模式设置分组 表模式下为模型设置分组,点击模型信息右上角第一个操作「模型分组」,点击后设置或修改分组。 4.4 继承关系 查看模型的继承关系,点击展示跟当前模型有父子关系的模型关系图。 页面初始状态只展示一层父模型与一层子模型,父模型顶部和子模型底部有“展示更多”按钮,点击展示更多再向上或向下加载一层。连线的顶部展示“收起”按钮,点击“收起”按钮收起子模型。 点击非当前模型,会打开新窗口,链接跳转到点击模型的模型设计器页面,新页面满足点击模型的筛选条件; 支持设置显示比例,缩放模型关系图; 支持最大化全屏展示。 4.4.1 图模式继承关系 4.4.2 表模式继承关系 4.5 查看引用关系 当删除模型时,如果模型有被其他设计器引用使用,则无法被删除。删除失败时会弹出“该模型仍在使用中,无法删除模型”的提示,并且可以点击「查看模型引用」,进而展示引用的详细信息。 引用包括五种:模型引用、页面引用、逻辑引用、流程引用、图表引用。 每种关系通过列表展示,列表项为链接(链接到对应的设计页面),内容为对应名称。例如,存在引用关系的流程的列表项显示的是流程的名称。列表项链接到对应流程的设计页面。 4.6 导入模型 导入模型的添加模型的一种方式,下载导入模板后在Excel中按照规则填写模型信息,成功导入后即添加模型成功。 点击「导入模型」后,可在弹窗中下载导入模板、上传导入文件、查看导入说明。 4.6.1 下载导入模板 下载导入模板时,会根据当前的操作模式不同,下载到的模板也不同。 在经典模型下,下载的导入模板中需要填写的模型信息基础、数量少、易懂。 在专家模型下,下载的导入模板中需要填写的模型信息丰富、数量多、专业。 4.6.2 查看导入说明 导入说明中描述了导入模板中各项内容的含义、填写规则等,有助于用户正确填写导入文件。在经典模式或专家模式下点击「导入说明」后,分别弹出两种操作模式下的导入说明。 4.6.3 导入上传 导入文件正确填写后,在弹窗中选择Excel文件,或将Excel直接拖入弹窗中的文件上传区域。Excel文件仅支持三种格式:.xlsx .xls .xlsm。 4.7 添加模型 点击「添加模型」,出现模型信息填写的弹窗,弹窗中包括:模型名称、模型类型、父模型。填写并保存成功后,模型即创建成功。 4.7.1 模型类型 专家模式下支持创建4种类型的模型:存储模型、传输模型、抽象模型、代理模型;经典模式下支持创建2种类型的模型:存储模型、传输模型。 存储模型:用于存储数据的模型,生成前后端交互协议、数据表、数据构造器和数据管理器。 抽象模型:用于配置多个子模型的公用字段和函数的模型,不会生成前后端交互协议、数据表、数据构造器和数据管理器。 传输模型:用于数据传输的模型,生成前后端交互协议和数据构造器,不生成数据表和数据管理器。 代理模型:用于以代理的方式扩展存储模型的模型,可以在存储模型的基础上增加传输字段和函数,与被代理的存储模型共用相同的数据管理器。 4.7.2 选择父模型 添加模型时,需要选择父模型,其中,经典模式下,无需且不展示父模型;专家模式下,必须选择父模型。 存储模型的父模型,默认是“基础存储模型”,可选项为可见的抽象模型和存储模型。 传输模型的父模型,默认是“基础存储模型”,可选项为可见的传输模型。 抽象模型的父模型,默认是“基础存储模型”,可选项为可见的抽象模型。 代理模型的父模型,无默认值,可选项为可见的存储模型和代理模型。 4.8 编辑模型 创建成功的模型,可以对其进行编辑,但只有部分信息支持编辑。 4.8.1 图模式编辑模型 图模式下,点击模型标题右侧的「编辑模型」按钮,即可在右侧弹出的抽屉中编辑模型信息。 4.8.2 表模式编辑模型 表模式下,点击模型信息标题右侧的「编辑模型」按钮,下方模型信息中可以被编辑修改的字段即由只读变为可编辑。 4.9 隐藏/可见模型 对于暂时不使用的模型,可以进行隐藏(隐藏后可再设置可见)的操作。 在其他设计器需要选择模型使用时,隐藏的模型将不被展示。对隐藏的模型再次操作可见后,即可选择到。 4.9.1 图模式隐藏/可见模型 图模式下,展开模型列表,模型列表中每个模型所在行的右侧,可点击隐藏/可见图标,以隐藏/可见该模型。 可见的模型常规展示,无特殊标识;隐藏后的模型在列表中将置灰展示。 4.9.1 表模式隐藏/可见模型 表模式下,模型信息左侧的模型列表中每个模型所在行的右侧,可点击隐藏/可见图标,以隐藏/可见该模型。 可见的模型常规展示,无特殊标识;隐藏后的模型在列表中将置灰展示。 4.10 删除模型 不再使用模型可以进行删除,删除时需要确保模型没有被其他设计器引用。删除成功后的模型将不在列表展示,且不可恢复,请谨慎操作。 4.10.1 图模式删除模型 图模式下,展开模型列表,模型列表中每个模型所在行的右侧,可点击删除图标,以删除该模型。 4.10.2 表模式删除模型 表模式下,模型信息左侧的模型列表中每个模型所在行的右侧,可点击删除图标,以删除该模型。 4.10.3 存在引用关系 如果删除的模型存在引用关系,则无法删除,并提示模型仍在使用。点击提示中的「查看模型引用」,可以查看这个模型引用情况。 5. 字段管理 在模型中,可以对字段进行增删改查等基础管理操作。 5.1 添加字段 每个模型中可以添加多个字段,手动添加的字段都为自定义字段。点击「添加字段」,右侧出现字段信息填写的抽屉,抽屉中包括:字段名称、字段业务类型、存储类型、长度(部分业务类型的字段无长度设置)。填写并保存成功后,字段即创建成功。 5.1.1 图模式添加字段 5.1.2 表模式添加字段 5.1.3 字段业务类型 添加字段时,支持设置16种基础类型的字段、支持设置4种关系类型字段。 基础类型:用户ID、整数、浮点数、金额、布尔型、文本、多行文本、富文本、日期时间、年份、日期、时间、数据字典、键值对、手机、邮箱; 字段为数据字典时需要选择一个数据字典。 关系类型:一对一、多对一、一对多、多对多 字段为关系类型字段时需要选择关联的模型。 5.1.4 多值字段 多值字段表示该字段可以存储或传输多个该业务类型的数据,非多值字段只能存储或传输单个该业务类型的数据。 5.1.5 存储类型 设置字段的存储类型:存储字段、传输字段 存储字段:用于查询和存储字段 传输字段:仅用于数据的组装与存储 5.2 编辑字段 创建成功的字段,可以对其进行编辑,但只有部分信息支持编辑。 字段长度和精度只能由小往大改,不能由大往小改。 关联关系的关联模型、关联字段、关系字段、中间模型,中间关系字段、中间关联字段、支持关联查询不可修改。 5.2.1 图模式编辑字段 图模式下,点击字段列表所在行右侧的「编辑字段」按钮,即可在右侧弹出的抽屉中编辑字段信息。 5.2.2 表模式编辑字段 表模式下,点击模型信息标题右侧的「编辑模型」按钮,下方模型中的字段都可以被展开编辑。 5.3 隐藏/可见字段 对于暂时不使用的字段,可以进行隐藏(隐藏后可再设置可见)的操作。 在其他设计器需要选择字段使用时,隐藏的字段将不被展示。对隐藏的字段再次操作可见后,即可选择到。 5.3.1 表模式隐藏/可见字段 表模式下,编辑模型时,字段所在行右侧可以操作隐藏/可见。 可见的字段常规展示,无特殊标识;隐藏的字段在列表中将置灰展示。 5.4 删除字段…

    2024年6月20日
    2.3K00
  • 4.1.4 模块之元数据详解

    介绍Module相关元数据,以及对应代码注解方式。大家还是可以通读下,以备不时之需 如您还不了解Module的定义,可以先看下2.3【oinone独特之源,元数据与设计原则】一文对Module的描述,本节主要带大家了解Module元数据构成,能让小伙伴非常清楚oinone从哪些维度来描述Module, 一、元数据说明 ModuleDefinition 元素数据构成 含义 对应注解 备注 displayName 显示名称 @Module( displayName=””, name=””, version=””, category=””, summary=””, dependencies={“”,””}, exclusions={“”,””}, priority=1L ) name 技术名称 latestVersion 安装版本 category 分类编码 summary 描述摘要 moduleDependencies 依赖模块编码列表 moduleExclusions 互斥模块编码列表 priority 排序 module 模块编码 @Module.module(“”) dsKey 逻辑数据源名 @Module.Ds(“”) excludeHooks 排除拦截器列表 @Module.Hook(excludes={“”,””}) website 站点 @Module.Advanced( website=”http://www.oinone.top”, author=”oinone”, description=”oinone”, application=false, demo=false, web=false, toBuy=false, selfBuilt=true, license=SoftwareLicenseEnum.PEEL1, maintainer=”oinone”, contributors=”oinone”, url=”http://git.com” ) author module的作者 description 描述 application 是否应用 demo 是否演示应用 web 是否web应用 toBuy 是否需要跳转到website去购买 selfBuilt 自建应用 license 许可证 默认PEEL1 可选范围: GPL2 GPL2ORLATER GPL3 GPL3ORLATER AGPL3 LGPL3 ORTHEROSI PEEL1 PPL1 ORTHERPROPRIETARY maintainer 维护者 contributors 贡献者列表 url 代码库的地址 boot 是否自动安装的引导启动项 @Boot 加上该注解代表: 启动时会自动安装,不管yml文件的modules是否配置 moduleClazz 模块定义所在类 只有用代码编写的模块才有 packagePrefix 包路径,用于扫描该模块下的其他元数据 dependentPackagePrefix 依赖模块列对应的扫描路径 state 状态 系统自动计算,无需配置 metaSource 元数据来源 publishCount 发布总次数 platformVersion 最新平台版本 本地与中心平台的版本对应。做远程更新时会用到 publishedVersion 最新发布版本 表4-1-4-1 ModuleDefinition UeModule 是对ModuleDefinition的继承,并扩展了跟前端交互相关的元数据 元素数据构成 含义 对应注解 备注 homePage Model 跳转模型编码 @UxHomepage(@UxRoute() 对应一个ViewAction,如果UxRoute只配置了模型,则默认到该模型的列表页 homePage Name 视图动作或者链接动作名称 logo 图标 @UxAppLogo(logo=””) 表4-1-4-2 UeModule 二、元数据,代码注解方式 Module Module ├── displayName 显示名称 ├── name 技术名称 ├── version 安装版本 ├── category 分类编码 ├── summary 描述摘要 ├── dependencies 依赖模块编码列表 ├── exclusions 互斥模块编码列表 ├── priority 排序 ├── module 模块编码 │ └── value ├── Ds 逻辑数据源名 │ └── value ├── Hook 排除拦截器列表…

    Oinone 7天入门到精通 2024年5月23日
    2.1K00
  • 应用中心

    在App Finder 中点击应用中心可以进入Oinone的应用中心,可以看到Oinone平台所有应用列表、应用大屏、以及技术可视化。 1. App Finder 平台提供App Finder搜索查找已安装的应用、点击进入应用; 我收藏的应用:在应用中心收藏后会呈现在“我收藏的应用”; 业务应用:与业务相关、用户可操作的应用; 设计器:平台提供五大设计器设计应用,即平台的无代码能力,包括:模型设计器、界面设计器、流程设计器、数据可视化、集成设计器。 2. 应用列表 应用列表管理平台中所有应用,管理应用的生命周期,如安装、升级、卸载,提供搜索、创建、编辑、卸载、收藏、设置首页等功能。 在介绍应用具体操作前,我们先来了解以下概念: 应用类型:分为应用与模块两种类型,两者区别在于在于应用有前台页面,可以在前台页面操作数据,模块没有前台页面、服务于其他应用或模块,大家在创建应用时可根据业务需求创建应用或模块。 依赖:创建新应用时,可依赖已有应用或模块,依赖后使用依赖应用/模块的能力,比如依赖文件应用可使用导入、导出能力,依赖资源应用可使用地址、语言等能力。 图3-2-35 Oinone的应用列表 2.1 创建 创建应用时,需要选择类型、定义应用名称、技术名称,选择依赖模块、所属分类、客户端类型。 每个应用大多数都需要依赖一些基础模块:文件、资源、 应用分类是按照应用所属业务域进行的分类管理,目前是平台提供的分类,后续会开放给用户自行管理。 客户端类型是指应用适用于PC端、移动端,如果只选择PC端,则应用不可在移动端使用。 2.2 编辑 编辑时,不允许编辑类型,技术名称,需要在创建时定义正确。 2.3 安装与卸载 卸载后,应用就不会呈现在App Finder中,不可进入应用、使用应用,可重新安装,安装后继续使用。 2.4 收藏应用 点击应用卡片右上角的星标可收藏、取消收藏应用,收藏的应用在App Finder和工作台中展示在收藏位置,可快捷进入。 2.5 设置首页 定义每个应用的首页,有两种方式: a. 通过绑定菜单,进入绑定菜单的页面; b. 直接绑定视图,选择模型、找到模型下的视图,如果可作为首页的视图不存在,也可以进入设计器创建。 2.6 应用详情 点击了解更多,可进入应用详情,查看应用基础信息。 2.7 设计器快捷入口 设计页面:进入界面设计器; 设计模型:进入模型设计器; 设计流程:进入流程设计器; 3. 应用大屏 应用大屏按照分类展示应用,未设置应用分类的应用,无法在应用大屏中呈现。 图3-2-37 未设置应用类目则无法在应用大屏中呈现。 4. 技术可视化 在技术可视化页面,出展示已经安装模块的元数据,并进行分类呈现。 图3-2-38 云数据分类呈现

    2024年5月23日
    2.8K00
  • 7.1 设计器总览

    设计器转为非专业研发设计,在Oinone3.0版本中已经完成元数据完整在线化,真正做到低无一体。对于设计器的定位我们开篇就介绍过,它是LCDP的产品化呈现,是冰山露在外面大家看得到的,核心还是在LCDP本身。我们先目睹下设计器的一些产品页面,如您有想体验,可以在Oinone官网注册 模型设计器 Oinone以模型为驱动,当有模型、数据字典、数据编码等设计功能,我们就可以完整地定义产品数据模型,模型设计器整体呈现区别于普通ER图,以当前模型为核心视角展开,可以点击关联模型切换主视角。这样的好处在于突出当前设计,聚焦设计本身。同时模型上预留了几个核心入口如:分类管理、继承拓扑图、页面设计、逻辑设计等。另外我们在体验上区分了专家模式和经典模式,顾名思义,专家模式的功能会更加丰富,对专业知识的要求也会更高。专家模式下一般会增加一些跟业务无关的配置如:索引设置等调优行为 逻辑设计器 从图灵完备的角度上说,要支持功能越完备,使用越复杂。我们优先从图灵完备的角度出发,所以我们第一版逻辑设计器相对比较复杂,第二版本规划中会类似模型设计器推出专家版和经典版。 界面设计器 界面设计器第一版会先支撑后端页面在线自定义,后边将陆续推出前端页面、多端能力。为了支持多端和2C页面的设计,我们对前后端协议做了比较大的改造。目前设计器已经支持完全基于V3的前后端协议。 数据可视化 数据可视化支持从内部系统模型获取数据内容后,根据业务需求自定义图表,目的是为企业提供更高效的数据分析工具。 与市场同类产品相比,我们的数据可视化产品:不需要前置维护数据源、进行数据转换;可智取业务系统模型,系统自动解析选择的模型、接口、表格中的字段后进行数据分析;降低对数据分析人员研发能力要求的同时,也提升了数据分析的效率。 流程设计器 Oinone流程设计器为业务流程和审批流程提供了可自动执行的流程模型:通过定义流转过程中的各个动作、规则,以此实现流程自动化。在Oinone流程设计器中,流程可以跨应用设计,不同应用的模型之间可以通过同一流程执行。

    2024年5月23日
    2.2K00
  • 4.1.24 框架之分库分表

    随着数据库技术的发展如分区设计、分布式数据库等,业务层的分库分表的技术终将成老一辈程序员的回忆,谈笑间扯扯蛋既羡慕又自吹地说到“现在的研发真简单,连分库分表都不需要考虑了”。竟然这样为什么要写这篇文章呢?因为现今的数据库虽能解决大部分场景的数据量问题,但涉及核心业务数据真到过亿数据后性能加速降低,能给的方案都还有一定的局限性,或者说性价比不高。相对性价比比较高的分库分表,也会是现阶段一种不错的补充。言归正传oinone的分库分表方案是基于Sharding-JDBC的整合方案,所以大家得先具备一点Sharding-JDBC的知识。 一、分表(举例) 做分库分表前,大家要有一个明确注意的点就是分表字段的选择,它是非常重要的,与业务场景非常相关。在明确了分库分表字段以后,甚至在功能上都要做一些妥协。比如分库分表字段在查询管理中做为查询条件是必须带上的,不然效率只会更低。 Step1 新建ShardingModel模型 ShardingModel模型是用于分表测试的模型,我们选定userId作为分表字段。分表字段不允许更新,所以这里更新策略设置类永不更新,并在设置了在页面修改的时候为readonly package pro.shushi.pamirs.demo.api.model; import pro.shushi.pamirs.boot.base.ux.annotation.field.UxWidget; import pro.shushi.pamirs.boot.base.ux.annotation.view.UxForm; import pro.shushi.pamirs.meta.annotation.Field; import pro.shushi.pamirs.meta.annotation.Model; import pro.shushi.pamirs.meta.enmu.FieldStrategyEnum; @Model.model(ShardingModel.MODEL_MODEL) @Model(displayName = "分表模型",summary="分表模型",labelFields ={"name"} ) public class ShardingModel extends AbstractDemoIdModel { public static final String MODEL_MODEL="demo.ShardingModel"; @Field(displayName = "名称") private String name; @Field(displayName = "用户id",summary = "分表字段",immutable=true/* 不可修改 **/) @UxForm.FieldWidget(@UxWidget(readonly = "scene == 'redirectUpdatePage'"/* 在编辑页面只读 **/ )) @Field.Advanced(updateStrategy = FieldStrategyEnum.NEVER) private Long userId; } 图4-1-24-1 新建ShardingModel模型 Step2 配置分表策略 配置ShardingModel模型走分库分表的数据源pamirsSharding 为pamirsSharding配置数据源以及sharding规则 a. pamirs.sharding.define用于oinone的数据库表创建用 b. pamirs.sharding.rule用于分表规则配置 pamirs: load: sessionMode: true framework: system: system-ds-key: base system-models: – base.WorkerNode data: default-ds-key: pamirs ds-map: base: base modelDsMap: "[demo.ShardingModel]": pamirsSharding #配置模型对应的库 图4-1-24-2 指定模型对应数据源 pamirs: sharding: define: data-sources: ds: pamirs pamirsSharding: pamirs #申明pamirsSharding库对应的pamirs数据源 models: "[trigger.PamirsSchedule]": tables: 0..13 "[demo.ShardingModel]": tables: 0..7 table-separator: _ rule: pamirsSharding: #配置pamirsSharding库的分库分表规则 actual-ds: – pamirs #申明pamirsSharding库对应的pamirs数据源 sharding-rules: # Configure sharding rule ,以下配置跟sharding-jdbc配置一致 – tables: demo_core_sharding_model: #demo_core_sharding_model表规则配置 actualDataNodes: pamirs.demo_core_sharding_model_${0..7} tableStrategy: standard: shardingColumn: user_id shardingAlgorithmName: table_inline shardingAlgorithms: table_inline: type: INLINE props: algorithm-expression: demo_core_sharding_model_${(Long.valueOf(user_id) % 8)} props: sql.show: true 图4-1-24-3 分库分表规则配置 Step3 配置测试入口 修改DemoMenus类增加一行代码,为测试提供入口 @UxMenu("分表模型")@UxRoute(ShardingModel.MODEL_MODEL) class ShardingModelMenu{} 图4-1-24-4 配置测试入口 Step4 重启看效果 自行尝试增删改查 观察数据库表与数据分布 图4-1-24-5 自行尝试增删改查 图4-1-24-6 观察数据库表与数据分布 二、分库分表(举例) Step1 新建ShardingModel2模型 ShardingModel2模型是用于分库分表测试的模型,我们选定userId作为分表字段。分库分表字段不允许更新,所以这里更新策略设置类永不更新,并在设置了在页面修改的时候为readonly package pro.shushi.pamirs.demo.api.model; import pro.shushi.pamirs.boot.base.ux.annotation.field.UxWidget; import pro.shushi.pamirs.boot.base.ux.annotation.view.UxForm; import…

    2024年5月23日
    1.6K00

Leave a Reply

Please Login to Comment

Comments(1)

  • psyy's avatar
    psyy 2024年8月21日 pm5:14

    1.4 Oinone对软件特性的思考,技术原理一段,几余(几->冗)
    1.4 Oinone对软件特性的思考,协同演进一段,新特生(生->性)