3.5.7.7 自定义主题

主题是什么

Oinone框架提供了强大的主题定制功能,使得平台可以轻松适应和遵循公司的品牌和UI规范。通过自定义主题,你可以调整颜色、间距、圆角等视觉元素,从而使Oinone更好地融入到特定行业的需求和公司标准中。以下是关于如何定制主题的关键点和步骤:

关键点

  1. 使用CSS变量:

    • Oinone使用CSS变量 (Css Var) 来实现主题定制。
    • CSS变量提供了一种高效且灵活的方式来定义和使用样式。
  2. 全面定制:

    • 可以定制的范围广泛,包括颜色、字体、间距、边框、圆角等。
    • 通过调整这些元素,可以确保UI符合公司的视觉标准。

定制步骤

  1. 了解CSS变量:

    • 首先,了解如何在CSS中使用变量。
    • 查看Oinone现有的CSS变量列表,以了解哪些样式可以被定制。
  2. 定义公司的UI规范:

    • 根据公司的品牌指南,定义一套UI规范。
    • 包括颜色方案、字体样式、元素尺寸等。
  3. 应用自定义样式:

    • 在Oinone的样式表中,使用定义的CSS变量来覆盖默认样式。
    • 确保在适当的地方应用这些自定义样式。

作用场景

Oinone平台提供了灵活的主题定制选项,包括内置的六套主题样式,涵盖深色和浅色模式以及不同的尺寸选项(大、中、小)。这些主题可以适应不同的业务需求和项目特性,同时提供了定制工具,方便用户根据公司的UI规范进行调整。下面是主题作用场景的详细说明:

主题选项

  1. 内置主题:

    • 六套主题:包括深色和浅色模式,以及大、中、小尺寸。
    • 用户可以通过系统设置功能轻松切换不同的主题。
  2. 可定制性:

    • 提供CSS变量的JSON文件,方便用户下载和修改。
    • 允许用户根据具体需求定制颜色、字体、间距等样式变量。

应用场景

  1. 公司UI规范对齐:

    • 首先根据公司的UI规范调整一份基础主题。
    • 这有助于确保平台的外观与公司品牌一致。
  2. 项目和业务适应性:

    • 在不同项目或业务场景中,可以基于公司UI规范进行微调。
    • 这提供了项目特定的灵活性,同时保持整体的品牌一致性。

实施建议

  • 初始设置:

  • 初始时,选择一个接近公司标准的内置主题作为起点。

  • 通过系统设置功能体验不同的主题效果。

  • 定制和微调:

  • 下载并修改CSS变量的JSON文件,以符合公司的UI标准。

  • 对于特定项目或业务场景,根据需要进行进一步的微调。

自定义主题

自定义主题功能允许在Oinone平台上创建和应用独特的视觉风格,以适应特定的业务需求和品牌标准。以下是自定义主题的步骤和示例,用于指导如何在Oinone平台上实现这一功能。

示例工程目录

以下是需关注的工程目录示例,main.ts更新导入./theme:
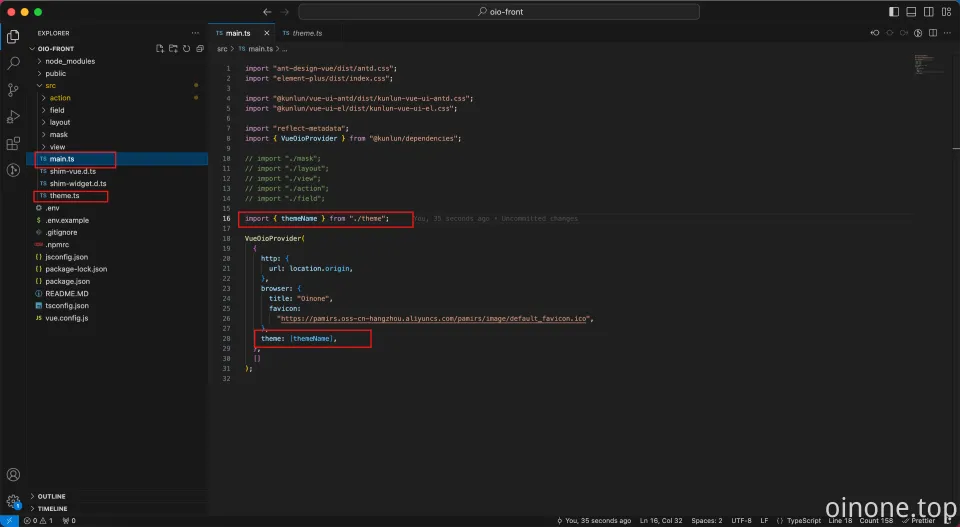
image.png

图3-5-7-24 自定义主题目录示例

步骤 1: 创建主题

  1. 定义主题变量: 创建一个包含主题样式变量的JavaScript文件。例如,可以定义一个名为OinoneTheme的新主题,并设置相应的CSS变量。

图3-5-7-24 自定义主题代码示例

  1. 注册主题: 使用registerTheme函数注册自定义主题。这个函数将新主题添加到可用主题列表中。

步骤 2: 应用主题

  1. 在主入口文件中引用: 在main.ts文件中引入自定义主题,并在VueOioProvider配置中指定。

图3-5-7-24 自定义主题应用配置示例

效果

image.png

图3-5-7-24 自定义黑色主题效果示例

  1. 主题叠加: Oinone支持多个主题变量同时存在,后导入的主题变量会覆盖前面导入的。

内置主题

Oinone平台内置了以下六个主题变量,你可以在自定义主题时参考或扩展它们:

  • 'default - large'
  • 'default - medium'
  • 'default - small'
  • 'dark - large'
  • 'dark - medium'
  • 'dark - small'

扩展变量

  • 在定义主题变量时,根据业务需求可以添加不存在的变量,作为变量的扩展。
示例
{
  "custom-color": "#新的辅助颜色",
  "button-padding": "10px 20px",
  // ...其他自定义变量
}

图3 - 5 - 7 - 24 扩展主题变量

查找主题变量

在Oinone平台上,通过DOM调试器查找主题变量是一种有效的方式,允许用户定位并获取相应组件的主题变量。以下是执行这一步骤的详细说明:

步骤:
  1. 使用DOM调试器:

    • 在浏览器中打开Oinone平台,进入需要查找主题变量的页面。
    • 使用浏览器的开发者工具或DOM调试器(通常可通过右键点击页面元素并选择“检查”打开)。
  2. 选择目标组件:

    • 在DOM调试器中,通过选择器工具或直接点击页面上的组件,选中你想要查找主题变量的目标组件。
  3. 查看样式和主题变量:

    • 在选中的组件上,浏览开发者工具中的“样式”或“计算”选项卡。
    • 可以通过查看样式表中的相关样式规则,找到组件所使用的主题变量。

4标识主题变量:

  • 主题变量通常以 --oio 为前缀。标识出你感兴趣的主题变量,记录下变量名和当前的取值。
示例:

假设你想查找某个按钮组件的主题变量,可以通过以下步骤:

  1. 在DOM调试器中选中按钮组件。

  2. 在“样式”或“计算”选项卡中查看相关样式规则。

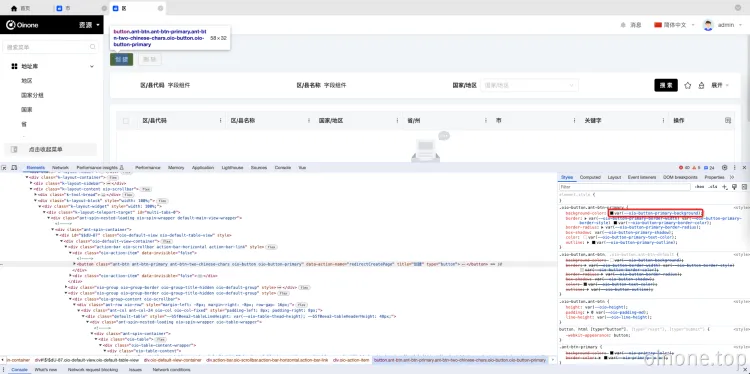
  3. 找到以 --oio 为前缀的主题变量,如 --oio-button-pirmary-background。

  4. 记录该主题变量的取值,例如 #3498db。

image.png

图3-5-7-24 DOM调试器查询主题变量

Oinone社区 作者:史, 昂原创文章,如若转载,请注明出处:https://doc.oinone.top/oio4/9270.html

访问Oinone官网:https://www.oinone.top获取数式Oinone低代码应用平台体验

Like (0)
史, 昂's avatar史, 昂数式管理员
Previous 2024年5月23日 am9:08
Next 2024年5月23日 am9:10

相关推荐

  • 1.4 Oinone对软件特性的思考

    我在个人的微信公众号上《浅谈企业IT架构的十年困局》一文中写了“企业或者软件公司在工程领域都关注哪些特征,而这些特征又应与具体研发人员的个体能力无关”的相关内容。收到很多业内人士的留言,也引起了很多同行的共鸣,所以今天在这里也打算针对这个话题,跟大家再做个深入的探讨。 一、首先为什么强调要跟研发个体能力无关 我们先来看一个故事: 轮扁是春秋时期齐国的木工,齐桓公召其入宫打造物件。有一天,齐桓公在堂上看书,轮扁在堂下用椎、凿等工具做车轮。 齐桓公看书看到得意处,不由得读出声来。轮扁听到读书声,想了想,放下手里的工具,走上堂来,在齐桓公面前几步远的地方停下,恭恭敬敬地说:“请恕臣斗胆问一下,君王读的是什么书?”齐桓公没想到这个老木匠会走上堂来,倒有点意外。不过看在他年纪大的份上,倒也不去斥责他,就回答说:“寡人读的是圣人写的书。”轮扁问:“圣人还在吗?”齐桓公说:“已经死了。”轮扁说:“这样看起来,君王所读的,不过是古人的糟粕而已!”齐桓公勃然大怒,说:“寡人读书,你一个做车轮的怎么敢议论?你说,这书上怎么会是古人的糟粕?说出道理便罢,说不出道理便难逃一死!” 轮扁不慌不忙地说:“臣是根据臣所从事的活计而明白这个道理的。砍削轮子,榫头做得宽了则松滑而不牢固,做得太紧就必然涩滞而安不进去,臣制作的榫头松紧适宜,是因为心里怎样想的手便怎样去做。然而尽管所需要的分寸度数心里都明白,要把它用言辞表达出来却实在不可能,全靠自己手与心的配合。所以,臣无法将其中的奥秘传授给儿子,臣的儿子也无法从臣这里学到其中的奥秘。因此,臣如今七十多岁了,还只好亲手去干制作轮子的活。这样看来,古人之道的精华都已随着古人死去而无法传世,那么君王所读的,不就是古人的糟粕了吗?” 这就是著名的成语故事——轮扁斫轮,出自《庄子·天道》。庄子通过轮扁的言论,深刻地揭示了高妙之技的难以言传。 而当我们转换视角,在企业数字化转型领域,无论是软件公司还是甲方IT团队,核心上是应用级开发需求,更多的精力应该放在业务场景理解、需求把控以及业务系统实现上。但往往在一个项目进入研发之前,会花很大力气在技术架构设计、技术栈选型、通用能力对接、扩展点设计这些跟业务场景无关的技术事项上,且需要高级别的架构师来主导。大部分情况下,架构师会选开源框架来实现,慢慢沉淀为企业的研发标准体系,所以底层架构的能力往往依赖架构师个人能力。不禁发现他们与轮扁有着异曲同工之处。架构师所积累的个人经验和技术能力,往往难以通过简单的手把手教学、技术评审会完全传递给团队中的其他成员。即使有所传授,其效率也可能仅达到50%,并且随着团队成员数量的增加,这种效率还可能持续递减。因此,我们需要更多地依赖于技术手段,将架构师的经验和能力固化下来,形成一套可复制、可推广的标准技术产品。这样,每个团队成员都能够通过学习和运用这些技术,达到至少70%的传递效率,从而确保团队整体技术水平的稳步提升。这也正是开篇所强调的,企业或软件公司在工程领域所关注的特征,应当与具体研发人员的个体能力相剥离,而更多地依赖于标准化、系统化的技术手段,来确保团队整体的高效运作。 二、软件公司在工程化领域都关注哪些特征 接下来,我将从技术角度深入剖析设计初衷和技术实现原理,以展现技术公司应当“被标准化的特征”究竟长什么样。 先做个名称解释,下文中涉及“标品”、“升级”、“扩展逻辑”,这是站在软件公司角度出发描述的,如果是企业内部可以把标品理解为特定业务应用平台,升级则是业务应用平台的正常规划迭代,扩展逻辑理解为脱离平台发展的临时性需求。 1. 可逆计算 可逆计算,在应用上的特征图 场景:调查发现企业研发至少有40%的精力在跟各条业务线的团队在评审项目需求,判断需求是否合理。而且业务线对需求完善时间要求紧,每天盯着研发进度,经常问“这个需求什么时候支持,我们等着用”。导致产研部门的研发抱怨产品节奏乱,无法按照自身节奏进行迭代,被项目推着走,没有时间思考,人手不足,加班多,工作压力大…… 价值:该特性很好的规避了研发因为时间紧迫,写的一些临时代码腐蚀核心业务系统。它需要做到不论从数据模型、业务逻辑、交互展示都能有扩展能力,并且这些扩展能力与个体研发无关才行。它同时所描述的也是一个具备差量计算能力的软件架构模式,它允许用户通过添加或移除扩展包来定制标准应用,同时保持应用的可逆性和独立性。这种架构模式的核心优势在于其灵活性和可维护性,使得应用的定制和恢复变得简单而高效。 技术原理:它所描述的是一个基于元数据驱动和差量计算的软件架构模式,它允许用户通过添加或移除扩展包来定制标准应用,同时保持应用的可逆性和独立性。这种架构模式的核心优势在于其灵活性和可维护性,通过元数据来驱动应用的构建和变更,使得应用的定制和恢复变得简单而高效 在这种架构中,元数据起到了至关重要的作用。元数据是关于数据的数据,它描述了数据的结构、属性、关系等信息。在软件应用中,元数据可以用来描述应用的组件、功能、配置等信息。通过元数据驱动应用可以根据元数据的描述来动态地构建和配置自身的功能和结构 差量计算则是实现应用可逆性的关键。当添加或移除扩展包时,系统会根据扩展包中的元数据与标准应用的元数据进行差量计算,确定需要添加或移除的功能和组件。这种差量计算可以确保在添加扩展包后,应用能够保持原有的功能和稳定性,同时新增扩展包带来的新功能,而在去除扩展包时,应用能够恢复到原始的标准状态,不会留下任何冗余或冲突的代码和配置。 为了实现这种架构模式,元数据注册表和分布式部署能力是非常重要的。元数据注册表需要能够存储和管理大量的元数据信息,并且提供高效的查询和更新机制。分布式部署能力则能够确保应用在不同的环境中都能够稳定运行,并且能够快速地响应扩展包的添加和移除操作,即差量(扩展包》可独立存在又相互作用。 总的来说,这种基于元数据驱动和差量计算的软件架构模式为应用的定制和恢复提供了强大的支持,使得应用能够根据不同的需求进行灵活的定制和扩展。同时,它也提高了应用的可维护性和可靠性,降低了开发和维护的成本 2. 协同演进 协同演进,在应用上的特征图 场景:它所描述的场景是一个复杂的软件升级过程,其中涉及了标准应用的升级以及用户个性化扩展的保留。通过面向对象的方式扩展标准应用的功能,可以在升级过程中保持用户自定义逻辑的完整性,并同时集成新版本中的新特性。 价值:很多号称产品型的软件公司,在交付客户项目的时候,都是从标品复制一个分支,然后客户个性化直接在这个分支上改。这种模式会带来两个问题: 是当客户数量变大,每个客户的版本都不一致,维护成本很高; 是当标品升级带来的新特性无法复制给客户,导致客户满意度下降甚至流失。协同演进就是要解决这个问题。 技术原理:它需要在第一个差量计算的特性基础上才能得以完成,同时在这种升级能力中,元数据驱动和模型驱动是关键所在。元数据驱动确保了应用能够理解和处理不同版本之间的变化,包括功能的增删改以及结构的调整。模型驱动则提供了描述和管理应用结构、组件和行为的能力,它不仅能够描述模型间的关系,还能够支持面向对象的特性,如继承、重写和重载等。 具体来说,当标准应用从V1升级到V2时,元数据驱动机制会首先识别和分析两个版本之间的差异。对于用户应用1中已经扩展的A功能,由于采用了面向对象的方式进行扩展,因此在升级过程中,A+逻辑作为A功能的重写或重载版本会被保留下来。同时,V2版本中新增的B功能也会被集成到用户应用1中,因为它是作为标准应用的新特性而存在的。 这种升级能力的实现依赖于一个强大的元数据注册表和模型管理能力。元数据注册表需要能够存储和管理不同版本应用的元数据信息,包括功能、组件、结构等。模型管理能力则需要能够解析和应用这些元数据,以生成正确的应用结构和行为。同时,还需要一套高效的升级机制来确保升级过程的平滑和可靠。 总的来说,通过元数据驱动和模型驱动的结合,可以实现标准应用的平滑升级,同时保留用户个性化扩展的完整性。这种能力对于提高软件的可维护性、可扩展性和用户满意度具有重要意义 3. 公民研发和专业研发共同参与 专业研发与公民研发共同参与,在应用上的特征图 场景:它所描述是在应用开发的整个生命周期中,专业研发专注在标品的长期规划与迭代,当出现临时性的需求或者应急性的辅助场景则由非专业人士进行即公民研发方式进行。这种模式下,专业研发可以按照规划有节奏的迭代产品,做更高级的事情,不至于忙于应对临时性的事务没有深度思考,更加避免了因为临时代码堆积导致产品从内部腐化。同时利用独立的扩展逻辑包和无代码方式解决了业务的紧迫感,毕竟业务需求的合理性是很难争论出高低的。它在前两个特性基础上让研发效能进一步得到释放。 价值:它的本质是,在专业研发在以低代码的方式下实现应用,并通过无代码的方式,快速扩展逻辑功能和创建辅助性应用。整个过程无缝衔接,我们给他取个名字专业名称叫:“低无一体”。它大大降低了技术门槛,使得专业和非专业的研发人员都能参与到应用扩展和定制中来。此外,它还提高了业务响应能力,使得企业能够更快速地适应市场变化和客户需求。 技术原理:它的核心要求就是元数据在线,元数据在线能力是指能够实时地、在线地管理和操作元数据,这种能力为企业或组织带来了诸多优势。通过无 代码的方式,用户可以更加灵活地进行应用的个性化扩展,以应对各种应急性需求,从而显著提升业务的响应能力。此外,元数据在线管理还确保核心应用、核心应用扩展以及辅助应用都是基于一套统一的技术体系构建的,这为不同角色的用户(包括专业和非专业的研发人员)提供了多样化的参与方式。同时,元数据在线管理需要符合开闭原则,这确保了系统的稳定性和可扩展性,使得新的功能或需求可以通过添加新的元数据或配置来实现,而非修改现有系统。 这种低代码开发与无代码一体化的优势在于,它大大降低了技术门槛,使得专业和非专业的研发人员都能参与到应用扩展和定制中来。此外,它还提高了业务响应能力,使得企业能够更快速地适应市场变化和客户需求。 总之,从用户应用到业务实施的过程通过元数据在线得到了优化和升级。低代码开发与无代码一体化的优势使得整个过程更加高效、灵活和易于维护,为企业带来了显著的价值和竞争优势。 4. 基于平台级别的AOP能力出现反向集成 反向集成,在应用上的特征图 场景:平台级别的AOP(面向切面编程)能力允许开发者在应用程序的特定点“切入”额外的逻辑,而无需修改原有的业务代码。这种能力特别适用于横向追加平台逻辑,即在多个不同服务或功能点插入通用的处理逻辑,如日志记录、权限检查、审计、多租户、多语言等。过往在微服务架构中,这些能力都需要业务系统各自主动去对接,有了平台级别的AOP能力,则这些通用能力可以反向为所有业务系统增加特性能力,无需业务系统研发感知。这种现象我们称之为“反向集成”,能让业务研发更加专注在业务研发本身,不需要关心与业务无关的通用功能上。 价值:AOP的核心思想是将这些横切关注点(cross-cutting concerns)从业务逻辑中分离出来,使得业务代码更加清晰和专注于其核心功能。在平台级别的AOP中,标准化协议是实现这一能力的关键。平台具备统一的入口和扩展能力是非常重要的,因为它允许开发者在不修改现有代码的情况下添加新功能或修改现有功能的行为。这种能力对于快速响应业务需求变化、减少维护成本和提高代码质量都是非常有益的。 技术原理:标准化协议确保了不同组件之间的通信与语义是统一的,从而使得AOP能够更容易地实施。例如: a前后端通信要标准协议(与端无关): 这意味着无论前端是使用Web、移动应用还是其他类型的客户端,后端服务都应该能够以一种标准的方式与之通信。 bORM层要有标准协议(与数据库无关): 对象关系映射 (ORM)层应该提供一个标准的接口来与数据库进行交互,这样无论底层使用哪种数据库(如MySQL、PostgreSQL、Oracle等),上层的业务逻辑都不需要改变。 cRPC需要标准协议(与Dubbo和Spring Cloud无关): 远程过程调用 (RPC)应该遵循一种标准协议,以便不同的服务可以无缝地进行通信,而不受特定框架 (如Dubbo、Spring Cloud等)的限制。 d所有逻辑调用统一fun调用: 这意味着平台上的所有功能调用都应该通过一个统一的入口点(如一个函数或方法)进行,这样AOP就可以在这个入口点切入额外的逻辑。 总的来说,平台级别的AOP能力通过标准化协议和统一的调用入口,为开发者提供了一种强大而灵活的方式来管理和扩展平台的逻辑功能。 5. 应用研发与部署无关 应用研发与部署无关,在应用上的特征图 场景:现在研发在选择部署方式的时候往往会选择分布式部署,或者你的客户招标需求里就写着“微服务”,构建一个微服务系统并不是一件容易的事,构建的复杂度远远超过单体系统,开发人员需要付出一定的学习成本去掌握更多的架构知识和框架知识。服务与服务之间通过HTTP协议或者消息传递机制通信,开发者需要选出最佳的通信机制,并解决网络服务较差时带来的风险。另外服务与服务之间相互依赖,如果修改某一个服务,会对另一个服务产生影响,如果掌控不好。会产生不必要的麻烦。由于服务的依赖性,测试也会变得很复杂,比如修改一个比较基础的服务,可能需要重启所有的服务才能完成测试。前段时间有篇很火的文章,《从微服务转为单体架构、成本降低 90%!》,无论是选择何种部署方式,我认为这都应该跟应用研发无关。 价值:应用研发与部署无关的理念确实为现代软件架构带来了显著的优势,它使得研发团队能够专注于业务逻辑和功能实现,而无需担心具体的部署细节。这种分离带来了灵活性、效率以及成本效益的多重提升。应该采用一种同时支持分布式和单体部署、且可以自由切换的架构,我们称之为可分可合。 首先,可分可合的能力使得系统能够灵活应对业务量的变化。在业务量小的时候,可以采用单体部署的方式,简化部署流程,降低初期成本。随着业务量的增长,系统可以平滑地过渡到分布式部署,通过拆分微服务来提高系统的处理能力和扩展性。这种灵活性确保了系统既能满足未来发展的需要,又能兼顾当下的成本效益。 其次,应用级别扩容的能力使得系统性能不再受限。通过增加微服务实例或调整资源配置,系统可以按需进行扩容,从而确保在业务高峰期或突发流量下仍能保持稳定的性能。这种按需扩容的方式不仅提高了系统的可靠性,还降低了运维成本。 技术原理:核心在于逻辑调用的统一执行和智能判断。通过如funEngine这一统一调用引擎,系统能够智能地选择最适合当前业务场景和性能需求的fun调用方式。无论是同步调用、异步调用还是基于消息队列的调用方式,funEngine都能进行智能决策,确保调用的高效性和可靠性。这种统一调用的方式简化了开发过程,降低了开发难度,同时也提高了系统的可维护性和可扩展性。 此外如果作为低代码或者其他研发平台来说。被集成特性也是实现该特性的关键所在。它提供了一套标准化的接口和协议,使得其他系统或应用能够轻松地与其进行集成。这种平台框架化的特性能够作为一个统一的、可扩展的框架来支撑整个系统的运行。 综上所述,具备可分可合的能力、应用级别扩容以及逻辑调用的统一执行和被集成特性,共同构成了应用研发与部署无关这一核心特性。该特性使得软件系统能够灵活地应对业务变化,实现高效、可扩展和可维护的运行,从而满足客户的长期发展需求并兼顾当下的成本效益。

    2024年5月23日
    2.6K10
  • 3.5 Oinone以交互为外在

    交互组件(UI Componment): 用组件化的方式统一管理:菜单、布局、视图 用Action做衔接,来勾绘出模块的前端交互拓扑,描述所有可操作行为 oinone的页面路由串联规则是以菜单为导航,用Action做衔接,用View做展示,详见3.5.2.1View的【整体介绍】。 本章节会重点介绍: 如何定义菜单、视图、行为以及其初始化 xml配置:视图配置(包括字段联动)、字段配置、布局配置、动作配置 前端组件自定义

    Oinone 7天入门到精通 2024年5月23日
    1.5K00
  • 4.1.17 框架之网关协议-GraphQL协议

    GraphQL 是一个用于 API 的查询语言,是一个使用基于类型系统来执行查询的服务端运行时(类型系统由你的数据定义)。GraphQL 并没有和任何特定数据库或者存储引擎绑定,而是依靠你现有的代码和数据支撑。 一个 GraphQL 服务是通过定义类型和类型上的字段来创建的,然后给每个类型上的每个字段提供解析函数。例如,一个 GraphQL 服务告诉我们当前登录用户是 me,这个用户的名称可能像这样: type Query { me: User } type User { id: ID name: String } 图4-1-17-1 GraphQL定义类型和字段示意 一并的还有每个类型上字段的解析函数: function Query_me(request) { return request.auth.user; } function User_name(user) { return user.getName(); } 图4-1-17-2 每个类型上字段的解析函数示意 一旦一个 GraphQL 服务运行起来(通常在 web 服务的一个 URL 上),它就能接收 GraphQL 查询,并验证和执行。接收到的查询首先会被检查确保它只引用了已定义的类型和字段,然后运行指定的解析函数来生成结果。 例如这个查询: { me { name } } 图4-1-17-3 GraphQL查询请求示意 会产生这样的JSON结果: { "me": { "name": "Luke Skywalker" } } 图4-1-17-4 GraphQL查询结果示意 了解更多 https://graphql.cn/learn/

    Oinone 7天入门到精通 2024年5月23日
    1.5K00
  • 翻译

    翻译应用是管理翻译规则的应用,以模型为基础、维护字段的翻译值,支持导入、导出 1. 操作步骤 Step1:导出所有翻译项; Step2:线下翻译; Step3:导入翻译项; Step4:刷新远程资源; Step5:页面右上角可切换语言,查看翻译效果。 2. 新增翻译 翻译是具体到模型字段,其中需要区分出是否字典; 源语言、目标语言,是在资源中维护的语言,可在资源中维护需要翻译的语言; 翻译项则是模型字段,默认翻译项为激活状态,关闭后维护的翻译项无效。 3. 导出、导入 不勾选导出:导出所有需要翻译的翻译项,包括模块、字段,源术语、翻译值等,其中如果已经翻译过的内容,会体现在翻译值中; 勾选导出:导出勾选模型的翻译项。 导入:导入翻译项,平台会根据模型拆分为多条数据。 4. 刷新远程资源 导入翻译项后,点击“刷新远程资源”按钮。 5. 查看翻译内容 页面右上角切换语言,查看翻译效果。

    2024年6月20日
    1.4K00
  • 组件属性

    1. 通用属性 介绍组件和其属性之前,先介绍一些大部分组件通用支持的一些基础属性。 1.2 标题 标题是字段在当前页面的展示名称,标题默认为字段名称,可以修改。 1.2 占位提示 在未填写内容时,输入框或选择框内的浅色提示文字,仅用于提示,不会影响字段的值。 1.3 描述说明 一个字段的描述信息,通常用于说明当前字段的范围、注意事项等。描述说明大部分在组件的下方显示,特殊的是,分组的描述说明在标题的左侧。 1.4 默认值 创建数据时,有些字段大概率都是相同值,可设置默认值,减少添加人员的操作步骤,提高录入数据效率。 1.5 只读 设为只读时,字段可见,但不可编辑。 除了只读和非只读的对立选项,也可以设置条件只读,在设置的条件下才只读,条件不符合则非只读。 1.6 禁用 设为禁用时,字段可见,但不可编辑。 除了禁用和非禁用的对立选项,也可以设置条件禁用,在设置的条件下才禁用,条件不符合则非禁用。 1.7 隐藏 设为隐藏时,字段不可见,也不可编辑。但是在页面设计时,隐藏的组件也会展示,效果如下图。 除了隐藏和非隐藏的对立选项,也可以设置条件隐藏,在设置的条件下才隐藏,条件不符合则非隐藏。 1.8 必填 控制字段在当前页面是否必填,若设置为必填则在标题前会有红色的*作为标识。除了必填和非必填的对立选项,也可以设置条件必填,在设置的条件下才必填,条件不符合则非必填。 1.9 标题排列方式 字段的标题可以自定义横向排列还是纵向排列。每个字段组件都支持设置,设置后之间互不影响。除了组件支持自定义,表单、分组、选项卡也可以设置排列方式,对于这种布局容器类组件,设置后会将其容器内的所有组件的标题排列方式都改为所设置的值。 1.10 宽度 定义在页面中的宽度:占整行的比例,一般可选项有1/4、1/3、1/2、2/3、3/4、1。 其中1/2表示占当前行的一半;1表示占当前行一整行;以此类推。部分组件特殊,如富文本仅支持宽度为1,即占一整行。 2. 分组 分组是一个布局类组件,类似一个容器,可以把业务含义相近的内容放在这个分组容器内。 2.1 属性 2.1.1 标题 分组可以定义一个标题名称,标题显示在分组左上角,可以不设置标题。 2.1.2 描述说明 分组的描述说明显示在分组标题右侧。 2.1.3 标题排列方式 分组中的标题排列方式属性并不是控制分组的标题,而是控制分组内组件的标题。设置后对分组内的所有组件生效。 3. 选项卡 选项卡是一个布局类组件,类似一个容器,每个选项卡可以添加多个选项页,可以把业务含义相近的内容放在选项卡的选项页容器内。 3.1 选项卡属性 3.1.1 选项页排列方式 选中选项卡,可选择选项卡中的选项页排列方式:水平排列、竖直排列。默认是水平排列,效果如下图。 3.1.2 标题排列方式 选项卡中的标题排列方式控制选项卡内组件的标题。设置后对选项卡内的所有组件生效。 3.2 选项页属性 3.2.1 标题 选中选项页,显示选项页的属性设置,选项卡中的每个选项页支持设置标题。 3.2.2 标题排列方式 选项页中的标题排列方式控制选项页内组件的标题。设置后对选项页内的所有组件生效。同一个选项卡,不同选项页之间的标题排列方式可以不同。 4. 单行文本 单行文本输入框,常用于记录名称、身份证号或其他普通的文字内容。 4.1 创建字段 单行文本仅支持创建「文本」业务类型的字段,填写规则、内容和模型设计器端创建字段一致。 4.2 表单属性 4.2.1 通用属性 在表单中,单行文本可以设置一些通用的属性:标题、占位提示、描述说明、默认值、只读、隐藏、禁用、必填、标题排列方式、宽度。 4.2.2 文本类型 文本类型选项为文本或密码。若设置为文本,输入时内容是可见的;若设置为密码,输入时是不可见的密码形态,如下图: 4.2.3 最小/大长度 设置输入框输入内容的长度,输入框会根据设置的值进行校验。 最大长度默认为创建字段时填写的长度,且设置的最大长度不可以大于字段的长度 最小长度默认为空,为空则为不限制最小长度 4.2.4 输入格式 设置输入格式为网址或者身份证时,会进行格式的校验 无:默认为无,不会校验内容 网址:进行网址校验 身份证:进行身份证号校验,设置后,需要输入正确的身份证号 4.2.5 显示计数器 当需要用户关注输入内容长度时,可以开启显示计数器,在输入时会实时显示当前内容的长度。 4.2.6 显示清除按钮 若开启了清除按钮,则在输入框有内容时,点击清除按钮一键清除已有内容 5. 多行文本 多行文本输入框,常用于记录字数较多的文字,如意见、复杂备注等。 5.1 创建字段 多行文本仅支持创建「多行文本」业务类型的字段,填写规则、内容和模型设计器端创建字段一致。 5.2 表单属性 5.2.1 通用属性 在表单中,单行文本可以设置一些通用的属性:标题、占位提示、描述说明、默认值、只读、隐藏、禁用、必填、标题排列方式、宽度。 5.2.2 最小/大长度 设置输入框输入内容的长度,输入框会根据设置的值进行校验。 -最大长度默认为创建字段时填写的长度,且设置的最大长度不可以大于字段的长度 -最小长度默认为空,为空则为不限制最小长度 5.2.3 显示计数器 当需要用户关注输入内容长度时,可以开启显示计数器,在输入时会实时显示当前内容的长度。 5.2.5 显示清除按钮 若开启了清除按钮,则在输入框有内容时,点击清除按钮一键清除已有内容 6. 整数 整数输入框,常用于输入整数的天数、数量等,如果会出现小数,请使用小数组件。 6.1 创建字段 整数仅支持创建「整数」业务类型的字段,填写规则、内容和模型设计器端创建字段一致。 6.2 表单属性 6.2.1 通用属性 在表单中,整数可以设置一些通用的属性:标题、占位提示、描述说明、默认值、只读、隐藏、禁用、必填、标题排列方式、宽度。 6.2.2 最小/大值 设置整数输入框输入内容的最值,输入框会根据设置的最值进行校验。 最大值可设置的范围根据字段填写的长度转换,如设置长度为3,则最大值最大不可以超过999 截图 6.2.3 显示千分位 数字过长时,不便于查看,可开启显示千分位。 7. 小数 小数输入框,常用于输入金额、单价等,会出现小数的数值。 7.1 创建字段 小数仅支持创建「浮点型」业务类型的字段,填写规则、内容和模型设计器端创建字段一致。 7.2 表单属性 7.2.1 通用属性 在表单中,小数可以设置一些通用的属性:标题、占位提示、描述说明、默认值、只读、隐藏、禁用、必填、标题排列方式、宽度。 7.2.2 最小/大值 设置小数输入框输入内容的最值,输入框会根据设置的最值进行校验。 最大值可设置的范围根据字段填写的长度转换,如设置长度为3,则最大值最大不可以超过999 7.2.3 保留小数位数 支持设置小数的保留位数,设置后在页面中输入内容时,将进行校验 可设置的保留小数位数不可大于该字段的精度,如字段精度为2,则组件属性中的小数位数最大只能为2; 7.2.4 显示千分位 数字过长时,不便于查看,可开启显示千分位。 8. 下拉单选 从多个选项中下拉选择一个数据,作为数据值。选项可以是关联模型的数据,也可以是数据字典或布尔型开关。 8.1 创建字段 下拉单选支持创建三种业务类型的字段,分别是:多对一、布尔型、数据字典。 多对一:创建字段时需要选择关联的模型,关联模型的数据将作为下拉选项; 布尔型:下拉选项默认只有是、否; 数据字典:创建字段时需要选择数据字典,其数据字典项将作为下拉选项 8.2 表单属性 8.2.1 通用属性 在表单中,下拉单选可以设置一些通用的属性:标题、占位提示、描述说明、只读、隐藏、禁用、必填、标题排列方式、宽度。 8.2.2 选项类型…

    2024年6月20日
    1.9K00

Leave a Reply

Please Login to Comment