
5.7 商业支撑之库存域

库存的差异会反馈到企业的整个价值链上,所以对库存的设计是至关重要的

一、基础介绍

我们先抛开仓库中对库存的实操管理和整个流通领域的库存,只围绕企业自身一级的采销链路上我们可以从管理和销售两个角度去看。

从管理角度上我们会关心:实物库存、在途库存、在产库存、库存批次等等,也就是企业有多少库存分布在哪里在什么环节。

从销售角度上我们会关心:可售库存、安全库存等等,也就是企业在特定渠道销售中库存分配规则。

在商业场景中库存管理一头对接仓库、生成、采购,另一头对接多个销售渠道。它的挑战在于不同行业不同特征商品都有比较大的差异。比如家具行业卖的是生产能力,家电区域化销售,生鲜拼车销售,服饰一仓销全国。热销的要分配提升体验防止超卖,滞销的要活动拉流量,普通的要渠道共享最大化可售。库存管理的差异会反馈到企业的整个价值链上,所以对库存的设计是至关重要的。

库存设计挑战在于:

  1. 技术上:库存类似账户账本的设计,需要能追溯库存变化的过程,且库存操作都能可追溯业务单据。热点数据的并发控制

  2. 业务上:在管理角度上游能跟仓库、采购、生产等进行对接、对账、并为其设置可售规则,下游能为各个销售渠道设置库存分配与同步规则

二、模型介绍
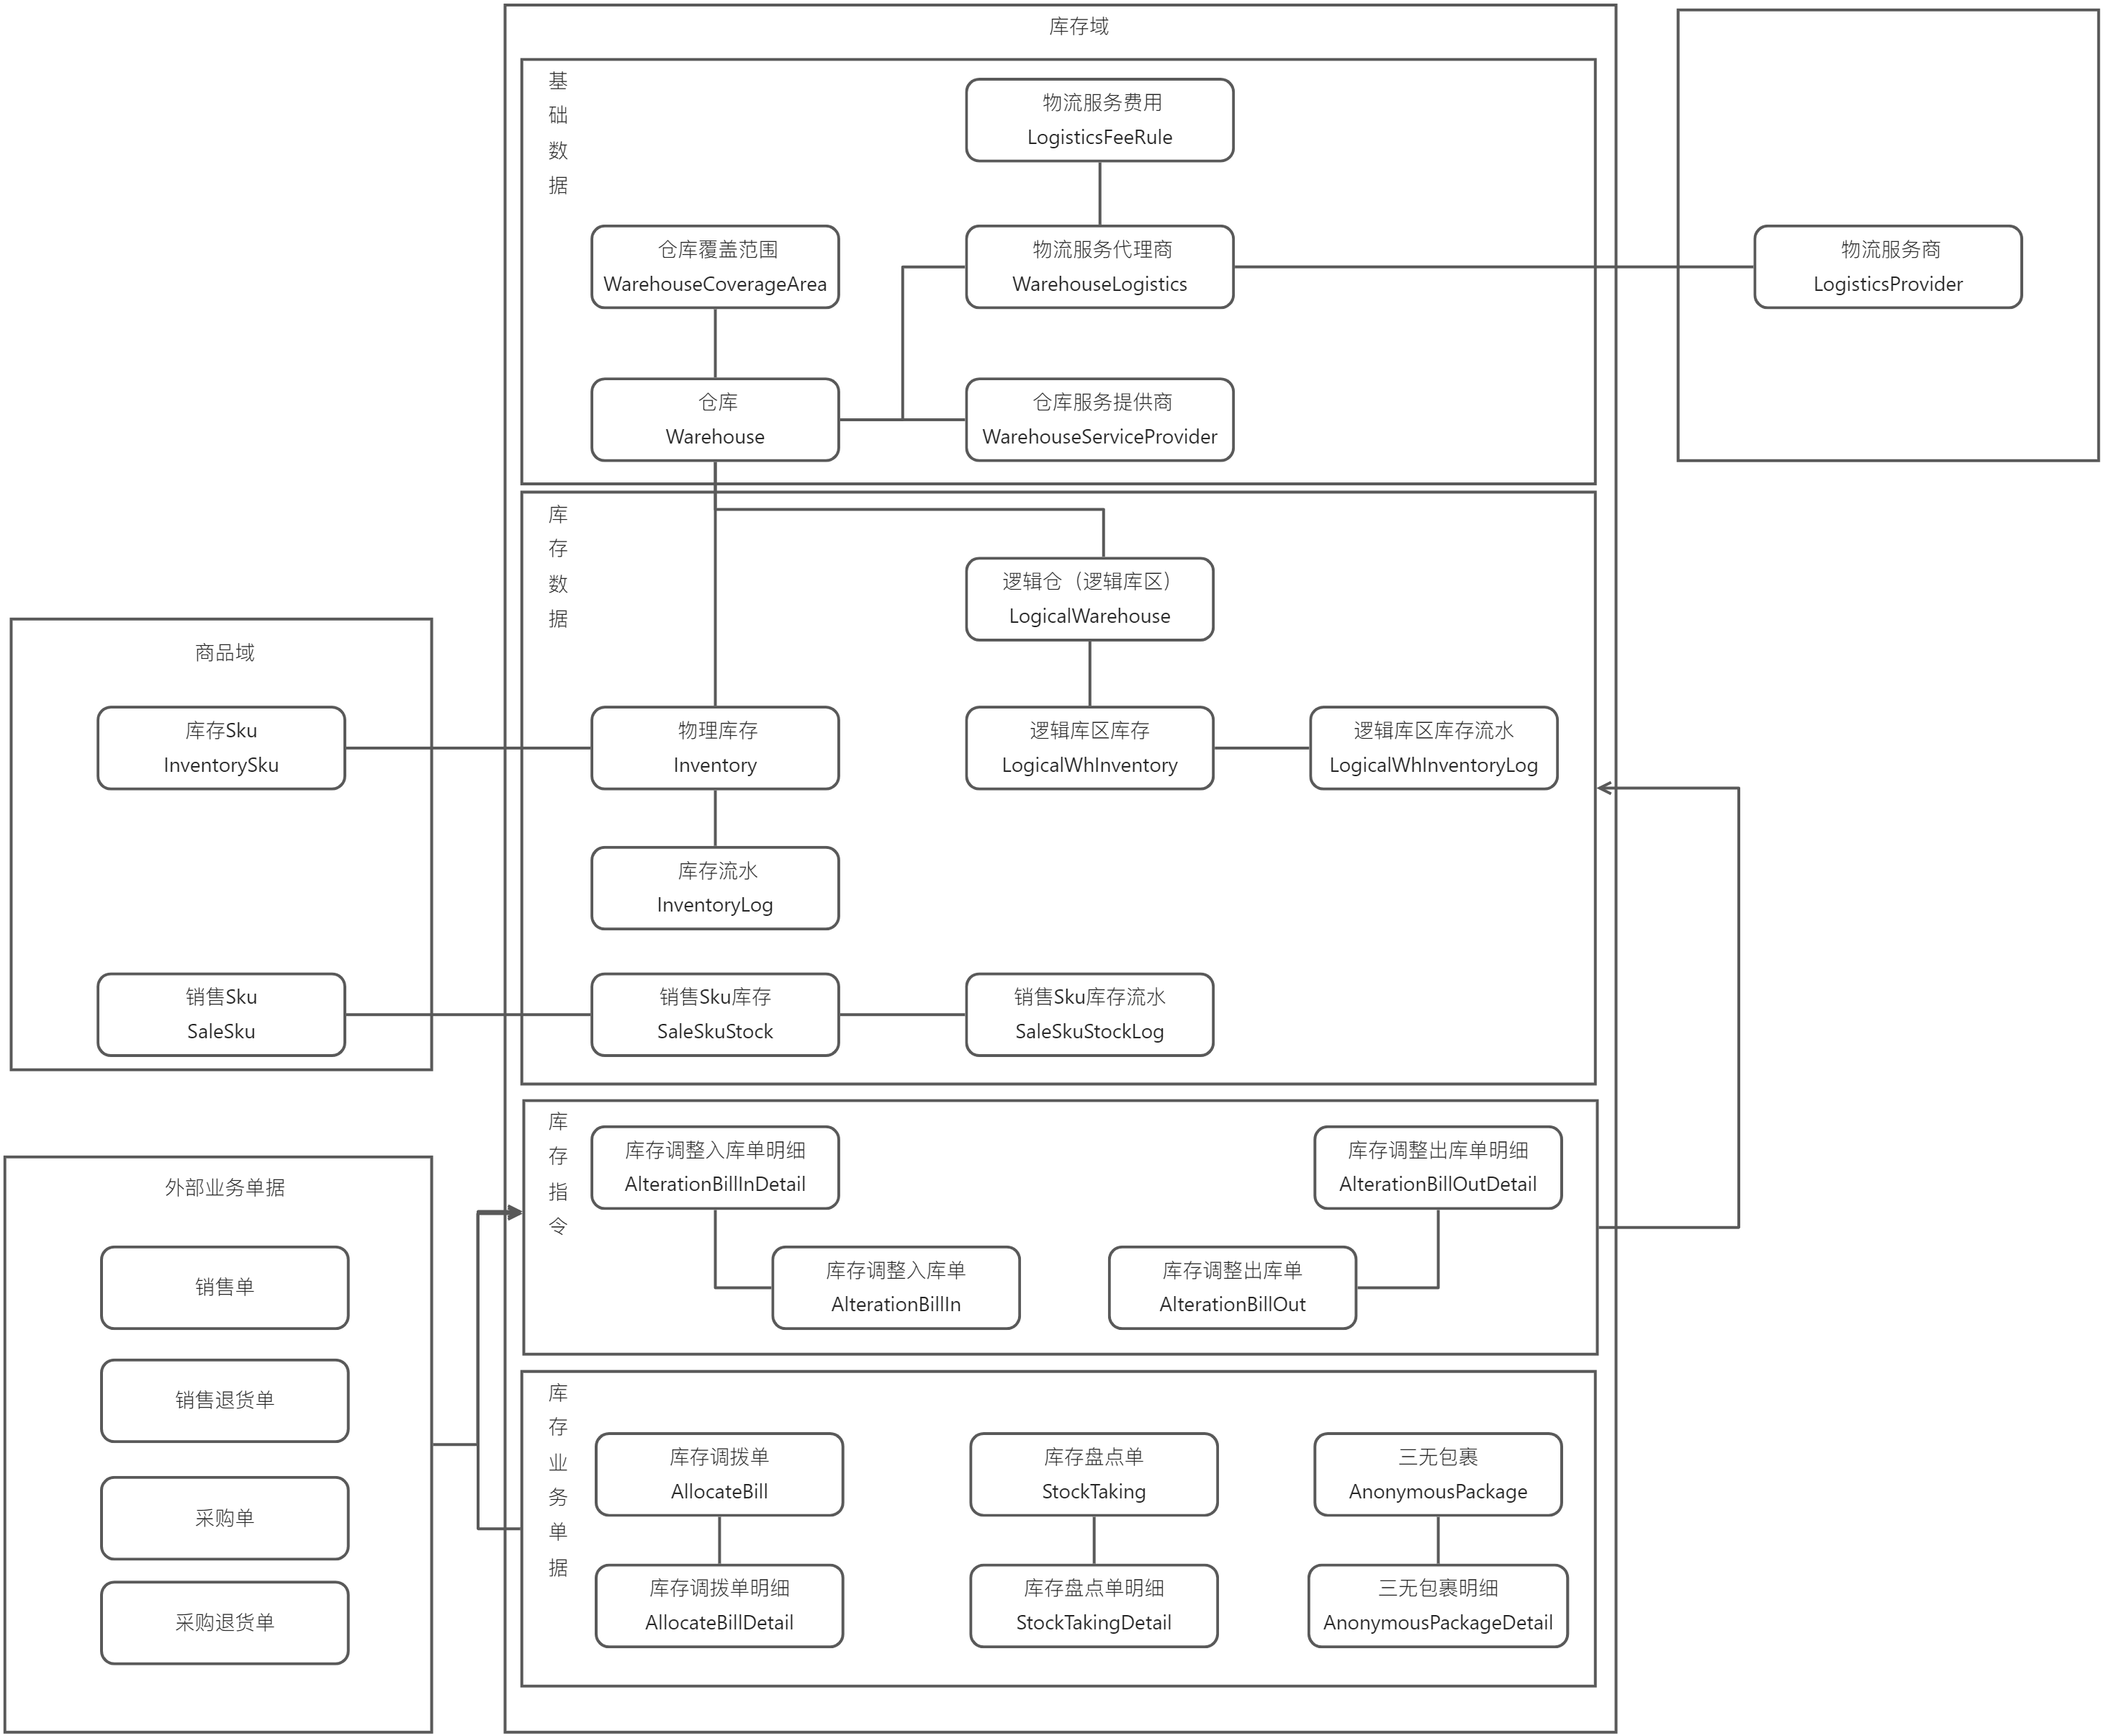
5.7 商业支撑之库存域

图5-7-1 模型介绍

核心设计逻辑:

  1. 单据链路:业务单据(外部业务单据+库存业务单据)产生库存指令(库存调整入\出库单),再由库存指令操作库存并记录库存流水。

  2. 管理链路:基础数据维护仓库、供应商、服务范围与费用。这些数据是订单履约路由和可售库存同步的基础

  3. 库存数据:对外跟商品域,通过库存指令进行操作。不同库存各自维护自身库存与流水记录,确保可追溯。

  4. 如果跟销售渠道对接,还需要扩展可售库存逻辑规则以及同步规则。比如oms类似的应用

Oinone社区 作者:史, 昂原创文章,如若转载,请注明出处:https://doc.oinone.top/oio4/9322.html

访问Oinone官网:https://www.oinone.top获取数式Oinone低代码应用平台体验

Like (0)
史, 昂's avatar史, 昂数式管理员
Previous 2024年5月23日 am8:16
Next 2024年5月23日 am8:18

相关推荐

  • 陈浩

    自2017年中国推进数字建设以来,数字经济规模持续增长,“十四五”规划和2035远景目标纲要中明确强调企业和政府需大力推动数字化转型,中国正在迈进一个崭新的数字经济时代。 在这个过程中,软件已经从工具变成信息化的基础设施,如何有效应对该变化所带来的一系列新的核心技术挑战,是整个软件行业发展遇到的另一难题。我认为,开源创新是解决这些难题的有效手段之一,也是未来软件发展的重要方向。如果说,数字化转型是时代趋势,那么开源创新也已成为时代主流。十四五规划纲要首提开源,2021年11月工信部印发《十四五软件和信息技术服务业发展规划》中提到开源重塑软件发展新生态,并将开源重塑软件发展新生态作为十四五期间我国软件产业的四大发展形势之一进行重点阐述。支持国产化开源创新体系发展,建设自己的开源社区和开源平台,其所具有的大众协同、开放共享、持续创新等特点,可有效推动各行业自主可控的数字化转型。 Oinone所倡导的开源理念和生态共建,与国家开源战略不谋而合:将开源作为一种合作手段,通过完善社区注重开源治理,吸引更多的企业和个体参与其中。湖南大学作为首批国家示范性软件学院的双一流建设高校,一直致力于推进和引导国产化开源软件体系的建设,并为此开展多种形式的产学研研究和实践。基于Oinone微服务分布式的设计理念和面向生态的开源特性,湖南大学结合自身在大数据分布式存储、多元异构数据汇聚融合和大数据智能分析等方面的研究成果,与Oinone展开了深度的技术创新合作,并在多个大中型企业数字化应用和数字政府应用中取得了良好的效果。 随着Oinone的开源,相信能激发更多的开发者参与到国产软件建设中,通过开源模式实现更广泛参与方的共享、共创、共生、共赢,构建价值驱动的数字创新生态平台,为我国数字经济发展贡献科技力量。 湖南大学教授:陈浩

    Oinone 7天入门到精通 2024年5月23日
    2.6K00
  • 2.1 数字化时代软件业的另一个本质变化

    随着企业从信息化向数字化转变,软件公司提供的产品也由传统的企业管理软件向企业商业支撑软件发展。这一变化带来了许多技术上的挑战和机遇。在之前的章节中,我们提到企业的视角已经从内部管理转向业务在线和生态在线协同,这也带来了一系列新的需求。但是,我们常常会忽视这一变化所带来的对系统要求的变化。在本章中,我们将探讨这些技术上的变化,以及这些变化所带来的机遇和挑战。 图2-1 从信息化到数字化软件本质变化 在信息化时代,企业的业务围绕着内部管理效率展开,借鉴国外优秀的管理经验,企业将其管理流程固化下来,典型的例子是ERP项目。这类项目上线后往往长期稳定,不轻易更改,因此信息化时代软件的技术流派侧重于通过模型对业务进行全面支持。例如,SAP具有丰富的配置能力,将已有企业管理思想抽象到极致。其功能基本上可以通过配置来实现,因此其模型设计特别复杂。但是,我们也应该清楚地了解到,配置是面向已知问题的。在数字化时代,创新和业务迭代速度非常快,这种方法可能就不太适合了。我们知道,模型抽象是在设计时具有前瞻性的,一旦不适合,修改起来就会异常困难。 随着数字化时代的到来,企业主的关注点已经从单一企业内部管理转变为了围绕企业上下游价值链的协同展开。这种变化给企业信息化系统提出了更高的要求,例如业务需求的响应速度、系统性能和用户体验等方面。现在,企业对软件不仅是管理需求的承载,更是业务在线化的承载。传统的重模型设计软件模式已经不再适用,因为业务本身不断创新和变化。因此,数字化时代需要新的软件技术流派,这种流派必须是轻模型加上低代码技术的结合体。通过模型抽象80%的通用场景,剩余的20%个性化需求可以通过技术手段来完成。这样的设计可以让每家企业的研发人员轻松理解模型,而不像ERP模型那样异常复杂,无法进行修改。此外,配合低代码技术可以快速研发和上线。如果说配置化是面向已知问题的,那么低代码就是面向未知问题设计的。虽然低代码的概念可以追溯到上个世纪80年代,当时是为了满足企业内部部门之间有协同需求,但又没有专业软件支撑,定制化开发又不划算的辅助场景。但现在它的核心原因是企业数字化的核心场景不稳定,变化很快,每家企业都有强烈的个性化需求。因此,低代码成为解决这些问题的核心手段,数字化时代的低代码需要具备处理复杂场景的能力,而不仅仅是围绕着内部管理展开。 企业在数字化转型的过程中需要考虑到不仅是成熟的全链路业务解决方案,还要应对数字化场景的快速变化和持续创新的需求。为此,Oinone打造了一站式低代码商业支撑平台,从业务与技术两个维度来帮助企业建立开放、链接、安全的数字化平台。这将在水平和垂直两个维度上全面推动企业数字化转型。 另外,低代码的另一个好处是完成了软件本身的数字化建设。通过基于元数据设计,元数据成为软件中数据、逻辑和交互的数据,软件结合AI可以有更多的创造可能。想象一下,AI了解软件的元数据后可以自我运作,人在极少情况下才需要参与,人机交互也会发生大的改变。未来的软件交互不再需要研发提前预设,而是能够实现用户所需即所呈现的效果。作为一家帮助企业进行数字化转型的软件公司,请问您的数字化转型是否已经完成呢?

    2024年5月23日
    1.7K00
  • 书籍封面

    2024年5月23日
    3.7K00
  • 4.1.24 框架之分库分表

    随着数据库技术的发展如分区设计、分布式数据库等,业务层的分库分表的技术终将成老一辈程序员的回忆,谈笑间扯扯蛋既羡慕又自吹地说到“现在的研发真简单,连分库分表都不需要考虑了”。竟然这样为什么要写这篇文章呢?因为现今的数据库虽能解决大部分场景的数据量问题,但涉及核心业务数据真到过亿数据后性能加速降低,能给的方案都还有一定的局限性,或者说性价比不高。相对性价比比较高的分库分表,也会是现阶段一种不错的补充。言归正传oinone的分库分表方案是基于Sharding-JDBC的整合方案,所以大家得先具备一点Sharding-JDBC的知识。 一、分表(举例) 做分库分表前,大家要有一个明确注意的点就是分表字段的选择,它是非常重要的,与业务场景非常相关。在明确了分库分表字段以后,甚至在功能上都要做一些妥协。比如分库分表字段在查询管理中做为查询条件是必须带上的,不然效率只会更低。 Step1 新建ShardingModel模型 ShardingModel模型是用于分表测试的模型,我们选定userId作为分表字段。分表字段不允许更新,所以这里更新策略设置类永不更新,并在设置了在页面修改的时候为readonly package pro.shushi.pamirs.demo.api.model; import pro.shushi.pamirs.boot.base.ux.annotation.field.UxWidget; import pro.shushi.pamirs.boot.base.ux.annotation.view.UxForm; import pro.shushi.pamirs.meta.annotation.Field; import pro.shushi.pamirs.meta.annotation.Model; import pro.shushi.pamirs.meta.enmu.FieldStrategyEnum; @Model.model(ShardingModel.MODEL_MODEL) @Model(displayName = "分表模型",summary="分表模型",labelFields ={"name"} ) public class ShardingModel extends AbstractDemoIdModel { public static final String MODEL_MODEL="demo.ShardingModel"; @Field(displayName = "名称") private String name; @Field(displayName = "用户id",summary = "分表字段",immutable=true/* 不可修改 **/) @UxForm.FieldWidget(@UxWidget(readonly = "scene == 'redirectUpdatePage'"/* 在编辑页面只读 **/ )) @Field.Advanced(updateStrategy = FieldStrategyEnum.NEVER) private Long userId; } 图4-1-24-1 新建ShardingModel模型 Step2 配置分表策略 配置ShardingModel模型走分库分表的数据源pamirsSharding 为pamirsSharding配置数据源以及sharding规则 a. pamirs.sharding.define用于oinone的数据库表创建用 b. pamirs.sharding.rule用于分表规则配置 pamirs: load: sessionMode: true framework: system: system-ds-key: base system-models: – base.WorkerNode data: default-ds-key: pamirs ds-map: base: base modelDsMap: "[demo.ShardingModel]": pamirsSharding #配置模型对应的库 图4-1-24-2 指定模型对应数据源 pamirs: sharding: define: data-sources: ds: pamirs pamirsSharding: pamirs #申明pamirsSharding库对应的pamirs数据源 models: "[trigger.PamirsSchedule]": tables: 0..13 "[demo.ShardingModel]": tables: 0..7 table-separator: _ rule: pamirsSharding: #配置pamirsSharding库的分库分表规则 actual-ds: – pamirs #申明pamirsSharding库对应的pamirs数据源 sharding-rules: # Configure sharding rule ,以下配置跟sharding-jdbc配置一致 – tables: demo_core_sharding_model: #demo_core_sharding_model表规则配置 actualDataNodes: pamirs.demo_core_sharding_model_${0..7} tableStrategy: standard: shardingColumn: user_id shardingAlgorithmName: table_inline shardingAlgorithms: table_inline: type: INLINE props: algorithm-expression: demo_core_sharding_model_${(Long.valueOf(user_id) % 8)} props: sql.show: true 图4-1-24-3 分库分表规则配置 Step3 配置测试入口 修改DemoMenus类增加一行代码,为测试提供入口 @UxMenu("分表模型")@UxRoute(ShardingModel.MODEL_MODEL) class ShardingModelMenu{} 图4-1-24-4 配置测试入口 Step4 重启看效果 自行尝试增删改查 观察数据库表与数据分布 图4-1-24-5 自行尝试增删改查 图4-1-24-6 观察数据库表与数据分布 二、分库分表(举例) Step1 新建ShardingModel2模型 ShardingModel2模型是用于分库分表测试的模型,我们选定userId作为分表字段。分库分表字段不允许更新,所以这里更新策略设置类永不更新,并在设置了在页面修改的时候为readonly package pro.shushi.pamirs.demo.api.model; import pro.shushi.pamirs.boot.base.ux.annotation.field.UxWidget; import pro.shushi.pamirs.boot.base.ux.annotation.view.UxForm; import…

    2024年5月23日
    1.6K00
  • 4.1.5 模型之持久层配置

    一、批量操作 批量操作包括批量创建与批量更新。批量操作的提交类型系统默认值为batchCommit。 批量提交类型: useAffectRows,循环单次单条脚本提交,返回实际影响行数 useAndJudgeAffectRows,循环单次单条脚本提交,返回实际影响行数,若实际影响行数与输入不一致,抛出异常 collectionCommit,将多个单条更新脚本拼接成一个脚本提交,不能返回实际影响行数 batchCommit,使用单条更新脚本批量提交,不能返回实际影响行数。 全局配置 pamirs: mapper: batch: batchCommit 图4-1-5-1 全局配置 运行时配置 非乐观锁模型系统默认采用batchCommit提交更新操作;乐观锁模型默认采用useAndJudgeAffectRows提交更新操作。也可以使用以下方式在运行时改变批量提交方式。 Spider.getDefaultExtension(BatchApi.class).run(() -> { 更新逻辑 }, 批量提交类型枚举); 图4-1-5-2 运行时配置 运行时校正 如果模型配置了数据库自增主键,而批量新增的批量提交类型为batchCommit,则系统将批量提交类型变更为collectionCommit(如果使用batchCommit,则需要单条提交以获得正确的主键返回值,性能有所损失)。 如果模型配置了乐观锁,而批量更新的批量提交类型为collectionCommit或者batchCommit,则系统将批量提交类型变更为useAndJudgeAffectRows。也可以失效乐观锁,让系统不做批量提交类型变更处理。 二、乐观锁(举例) 在一些会碰到并发修改的数据,往往需要进行并发控制,一般数据库层面有两种一种是悲观锁、一种是乐观锁。oinone对乐观锁进行了良好支持 定义方式 乐观锁的两种定义方式: 通过快捷继承VersionModel,构建带有乐观锁,唯一编码code且主键为id的模型。 可以在字段上使用@Field.Version注解来标识该模型更新数据时使用乐观锁 如果更新的实际影响行数与入参数量不一致,则会抛出异常,错误码为10150024。如果是批量更新数据,为了返回准确的实际影响行数,批量更新由批量提交改为循环单条数据提交更新,性能有所损失。 失效乐观锁 一个模型在某些场景下需要使用乐观锁来更新数据,而另一些场景不需要使用乐观锁来更新数据,则可以使用以下方式在一些场景下失效乐观锁。更多元位指令用法详见4.1.9【函数之元位指令】一文。 PamirsSession.directive().disableOptimisticLocker(); try{ 更新逻辑 } finally { PamirsSession.directive().enableOptimisticLocker(); } 图4-1-5-3 失效乐观锁 不抛乐观锁异常 将批量提交类型设置为useAffectRows即可,这样可改由外层逻辑对返回的实际影响行数进行自主判断。 Spider.getDefaultExtension(BatchApi.class).run(() -> { 更新逻辑,返回实际影响行数 }, BatchCommitTypeEnum.useAffectRows); 图4-1-5-4 将批量提交类型设置为useAffectRows 构建第一个VersionModel Step1 新建PetItemInventroy模型,继承快捷模型VersionModel package pro.shushi.pamirs.demo.api.model; import pro.shushi.pamirs.meta.annotation.Field; import pro.shushi.pamirs.meta.annotation.Model; import pro.shushi.pamirs.meta.base.common.VersionModel; import java.math.BigDecimal; @Model.model(PetItemInventroy.MODEL_MODEL) @Model(displayName = "宠物商品库存",summary="宠物商品库存",labelFields = {"itemName"}) public class PetItemInventroy extends VersionModel { public static final String MODEL_MODEL="demo.PetItemInventroy"; @Field(displayName = "商品名称") private String itemName; @Field(displayName = "库存数量") private BigDecimal quantity; } 图4-1-5-5 新建PetItemInventroy模型 Step2 修改DemoMenu,增加访问入口 @UxMenu("商品库存")@UxRoute(PetItemInventroy.MODEL_MODEL) class PetItemInventroyMenu{} 图4-1-5-6 修改DemoMenu Step3 重启看效果 体验一:页面上新增、修改数据库字段中的opt_version会自动加一 图4-1-5-7 示例效果一 图4-1-5-8 示例效果二 图4-1-5-9 示例效果三 图4-1-5-10 示例效果四 体验二:同时打两个页面,依次点击,您会发现一个改成功,一个没有改成功。但页面都没有报错,只是update返回影响行数一个为1,另一个为0而已。 图4-1-5-11 编辑宠物商品库存 图4-1-5-12 宠物商品库存列表 注:增加了乐观锁,我们在写代码的时候一定要注意,单记录更新操作的时候要去判断返回结果(影响行数),不然没改成功,程序是不会抛错的。不像batch接口默认会报错 Step4 预留任务:重写PetItemInventroy的update函数 留个任务,请各位小伙伴自行测试玩玩,这样会更有体感 package pro.shushi.pamirs.demo.core.action; import org.springframework.stereotype.Component; import pro.shushi.pamirs.demo.api.enumeration.DemoExpEnumerate; import pro.shushi.pamirs.demo.api.model.PetItemInventroy; import pro.shushi.pamirs.demo.api.model.PetTalent; import pro.shushi.pamirs.meta.annotation.Function; import pro.shushi.pamirs.meta.annotation.Model; import pro.shushi.pamirs.meta.common.exception.PamirsException; import pro.shushi.pamirs.meta.constant.FunctionConstants; import pro.shushi.pamirs.meta.enmu.FunctionOpenEnum; import pro.shushi.pamirs.meta.enmu.FunctionTypeEnum; import java.util.ArrayList; import java.util.List; @Model.model(PetItemInventroy.MODEL_MODEL) @Component public class PetItemInventroyAction { @Function.Advanced(type= FunctionTypeEnum.UPDATE) @Function.fun(FunctionConstants.update) @Function(openLevel = {FunctionOpenEnum.API}) public PetItemInventroy update(PetItemInventroy data){ List<PetItemInventroy> inventroys = new ArrayList<>(); inventroys.add(data); //批量更新会,自动抛错 int i =…

    2024年5月23日
    1.9K00

Leave a Reply

Please Login to Comment