7.4 Oinone的低无一体

基础介绍

前面我们学习了基于低代码开发平台进行快速开发,以及通过oinone的设计器进行零代码开发两种模式。当然低无一体不是简单地说两种模式还指:低无两种模式可以融合。

  1. 在做核心产品的时候以低代码开发为主,以无代码为辅助。见低代码开发的基础入门篇中设计器的结合一文

  2. 在做实施或临时性需求则是以无代码为主,以低代码为辅助

本文主要介绍第二种模式,它是www.oinone.top官网在SaaS模式下的专有特性。满足客户安装标品后通过设计器进行适应性修改后,但对于一些特殊场景还是需要通过代码进行完善或开发

在该模式下,我们提供了jar模式和代码托管两种模式,客户只要选择需要进行代码开发的模块,点击生产SDK,下载扩展工程模版,按Oinone低代码开发平台规范进行研发,后上传扩展工程即可。
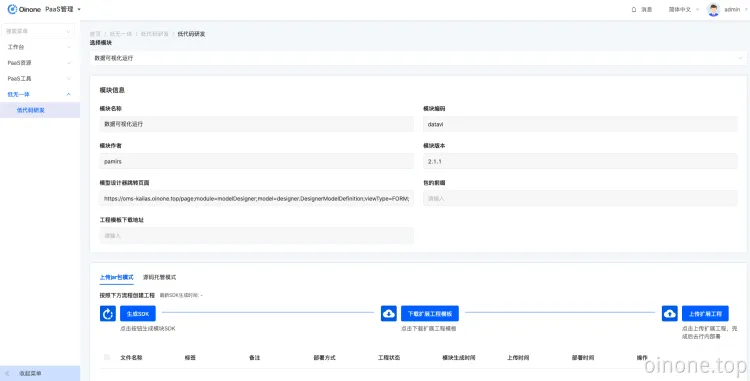
image.png

操作手册

低无一体这个模块是连接无代码设计器的桥梁,可以为一个模块或应用设计低代码的逻辑,可以在界面设计器或流程设计器中使用低代码的逻辑。

1.选择模块

首先需要在下拉单选中选择需要低代码的模块或应用。

  • 下拉选中只展示在「应用中心」中已安装的模块或应用,可前往「应用中心」安装后继续低代码操作。

  • 选择模块中不展示系统的基础模块或应用,因为这些模块或应用无法自定义模型。

2.模块信息

模块信息展示的是选择模块的基础信息:模块名称、模块编码、模块作者、模块版本、包的前缀、工程模板下载地址,下载地址仅在上传jar包模式时候用到。

3.低无一体操作

低无一体支持了两种使用模式:上传jar包模式、源码托管模式。

  • 上传控制工程或创建研发分支动作完成会生成一条数据,可以对单条数据进行部署、卸载、修改、删除。

3.1 上传jar包模式

在这个模式下,需要做四步动作。

  1. 生成SDK,点击按钮之后,会把模块的当前模型状态打成一个SDK包,SDK最新生成时间更新。当模型变更但未生成SDK时,使用低无一体就会出错,请重新生成SDK并修改扩展工程。生成SDK通常需要1分钟左右,若第一次使用低无一体模块,可能需要更长时间,请耐心等待。

  2. 下载扩展工程模板,点击按钮之后,会将SDK包和工程模板生成一个下载链接,复制模块信息中的卸载地址打开即可下载。

  3. 技术人员在工程模板的基础上写低代码逻辑。

  4. 上传扩展工程,点击按钮展开弹窗,在弹窗中设置标签、备注,并将最终的jar包上传,完成上传之后表格中就会新增一条数据。
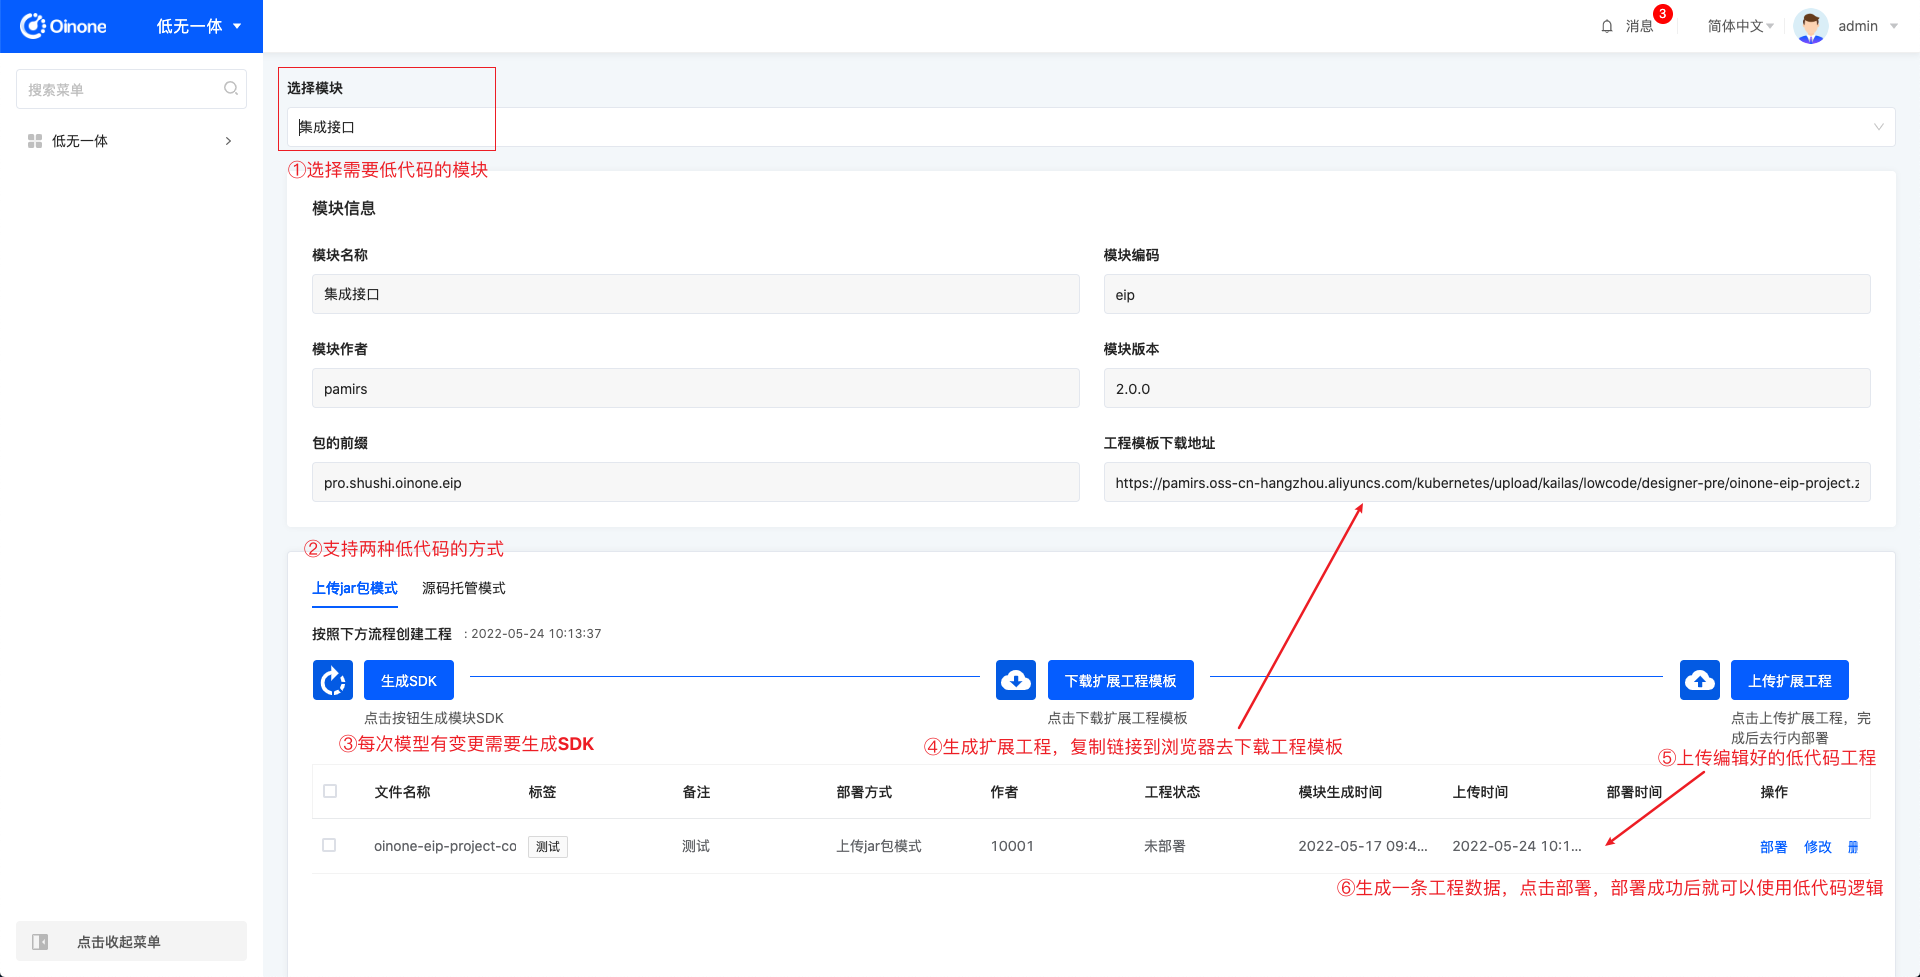
image.png

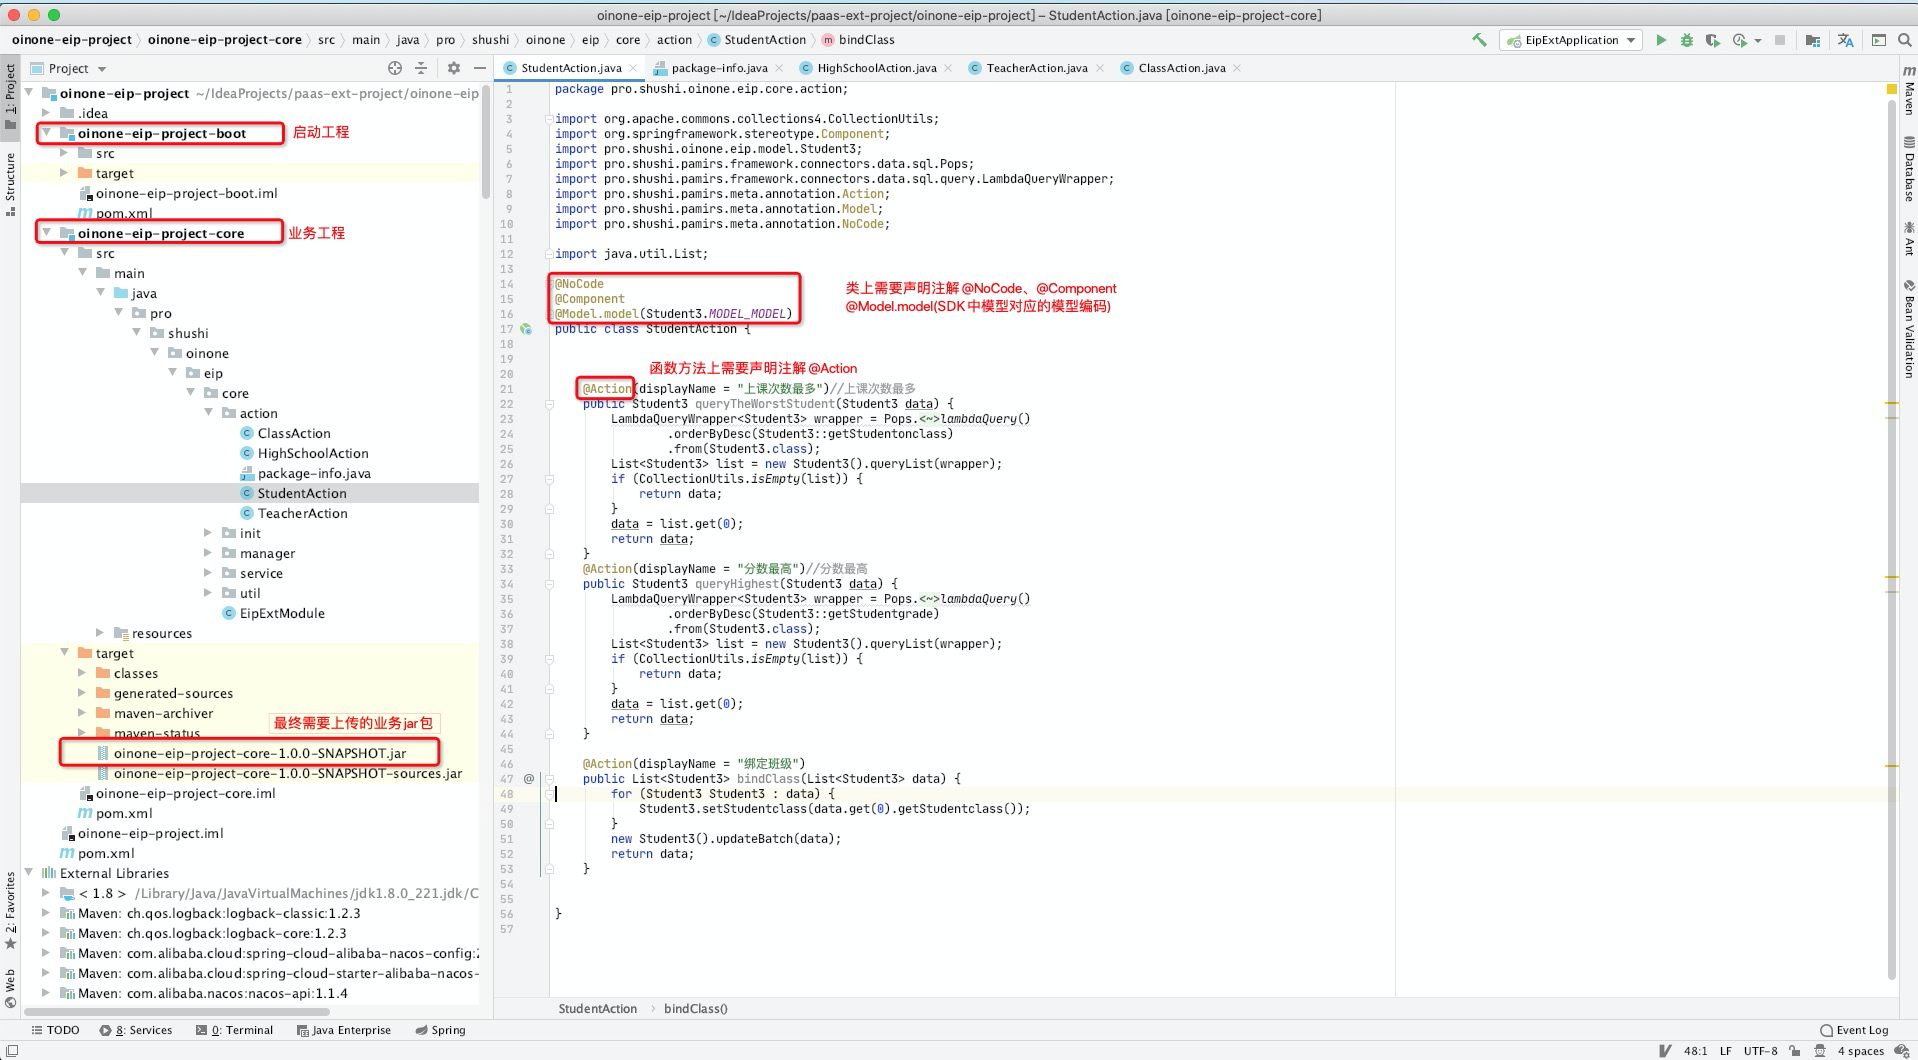
  1. 上传jar包模式下,模板工程中代码需要注意的点参考下图:

image.png

3.2 源码托管模式

在这个模式下,需要做三步动作。

  1. 生成SDK,点击按钮之后,会把模块的当前模型状态打成一个SDK包,SDK最新生成时间更新。当模型变更但未生成SDK时,使用低无一体就会出错,请重新生成SDK并修改扩展工程。生成SDK通常需要1分钟左右,若第一次使用低无一体模块,可能需要更长时间,请耐心等待。

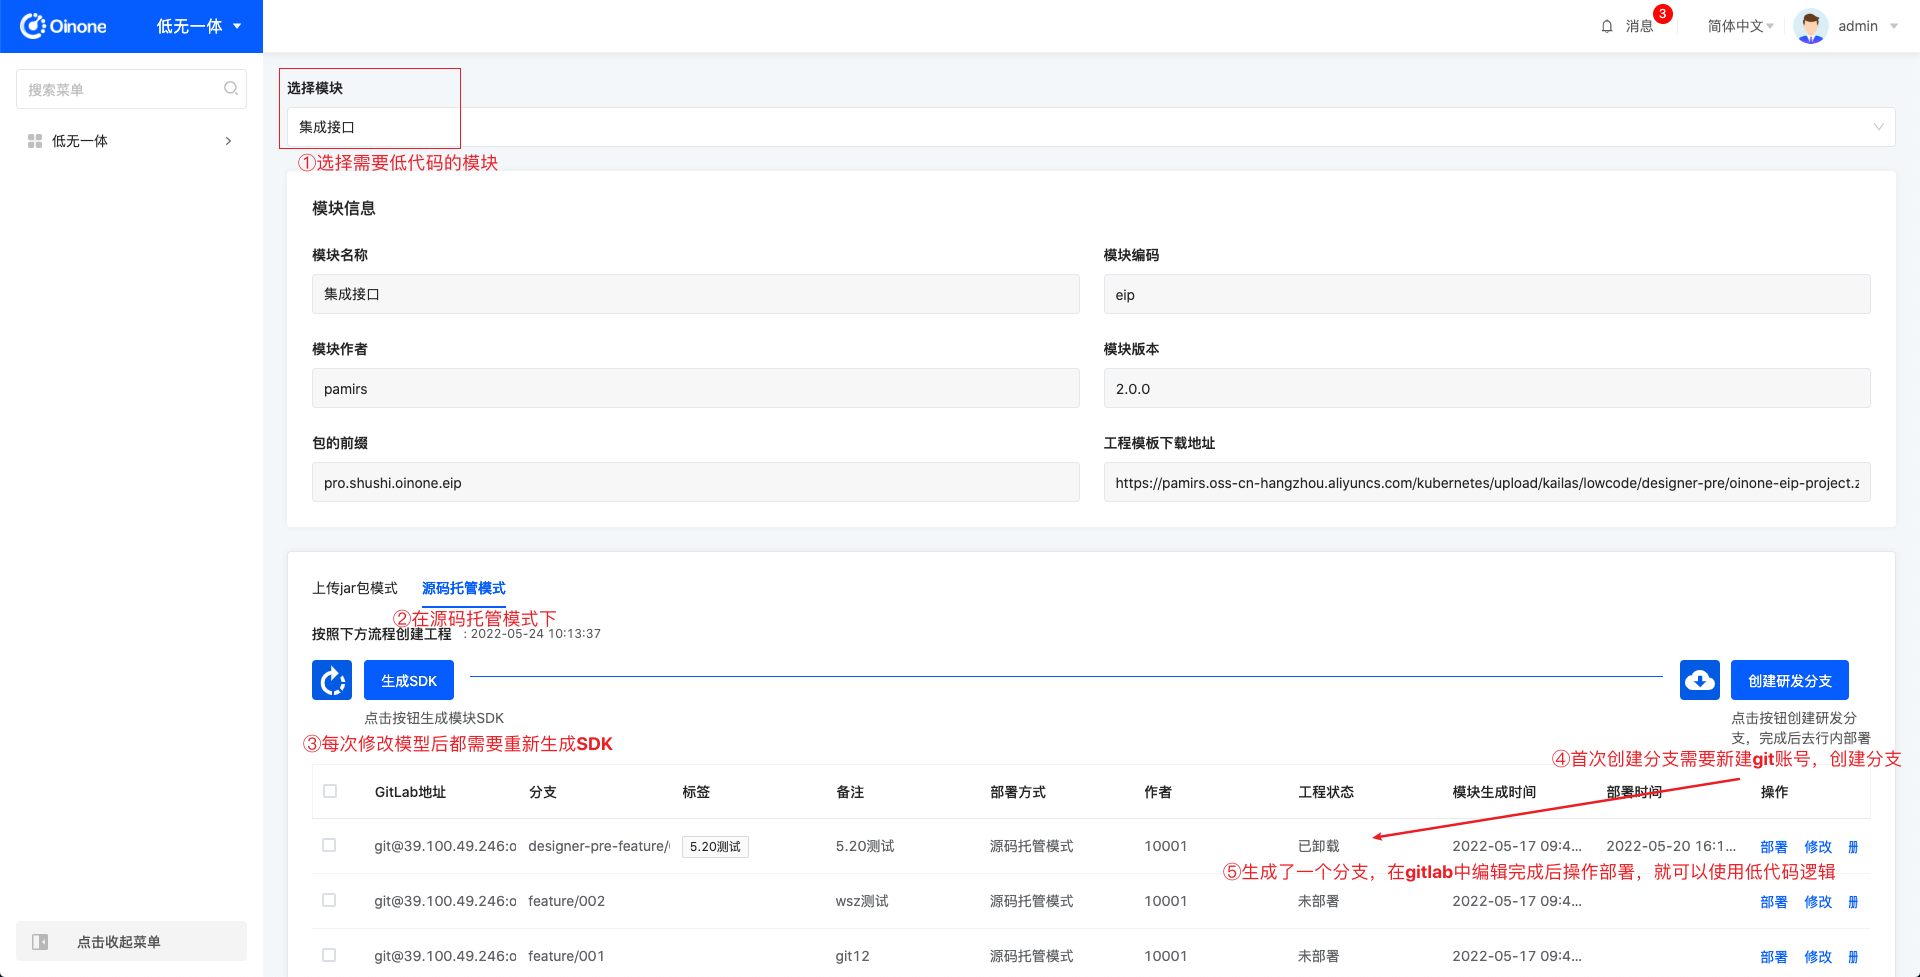
  2. 创建研发分支,点击按钮展开弹窗。首次创建时需要设置git账号名称、git账号邮箱来创建一个账号,另外在弹窗中设置分支名称、标签、备注,完成创建后表格中就会新增一条数据。

  3. 通过表格中的Gitlab地址,技术人员写低代码逻辑。

image.png

3.3 行内操作

  1. 部署:工程状态为未部署、部署失败、已卸载时展示行内的部署按钮,点击之后进行部署,工程状态变为部署中。部署过程大致需要5-10分钟,请耐心等待。部署完成之后,会生成一个新的模块:“原模块名称”扩展工程。

  2. 卸载:工程状态为已部署时展示行内的卸载按钮,点击之后会卸载这个已部署的工程,工程状态变为已卸载。同一模块只能有一个已部署的工程(与选择的模式无关),若需要使用新的工程请先卸载已部署的工程。

  3. 修改:行内操作修改按钮始终展示,只允许修改标签、备注。

  4. 删除:工程状态为未部署、部署失败、已卸载时展示行内的删除按钮,点击之后删除这一条工程记录。

3.4 部署效果

低无一体部署成功之后,可以进入对应模块的模型页面中使用提交动作来使用低代码逻辑,也可以在流程设计器中的引用逻辑节点中使用低代码逻辑。

Oinone社区 作者:史, 昂原创文章,如若转载,请注明出处:https://doc.oinone.top/oio4/9338.html

访问Oinone官网:https://www.oinone.top获取数式Oinone低代码应用平台体验

Like (0)
史, 昂's avatar史, 昂数式管理员
Previous 2024年5月23日
Next 2024年5月23日

相关推荐

  • 6.3 数据审计(改)

    在业务应用中我们经常需要为一些核心数据的变更做审计追踪,记录字段的前后变化、操作IP、操作人、操作地址等等。数据审计模块为此提供了支撑和统一管理。它在成熟的企业的核心业务系统中,需求是比较旺盛的。接下来我们开始学习下数据审计模块 准备工作 pamirs-demo-core的pom文件中引入pamirs-data-audit-api包依赖 <dependency> <groupId>pro.shushi.pamirs.core</groupId> <artifactId>pamirs-data-audit-api</artifactId> </dependency> pamirs-demo-boot的pom文件中引入pamirs-data-audit-core和pamirs-third-party-map-core包依赖,数据审计会记录操作人的地址信息,所以也依赖了pamirs-third-party-map-core <dependency> <groupId>pro.shushi.pamirs.core</groupId> <artifactId>pamirs-data-audit-core</artifactId> </dependency> <dependency> <groupId>pro.shushi.pamirs.core.map</groupId> <artifactId>pamirs-third-party-map-core</artifactId> </dependency> pamirs-demo-boot的application-dev.yml文件中增加配置pamirs.boot.modules增加data_audit 和third_party_map,即在启动模块中增加data_audit和third_party_map模块 pamirs: boot: modules: – data_audit – tp_map 为third_party_map模块增加高德接口api,下面e439dda234467b07709f28b57f0a9bd5换成自己的key pamirs: eip: map: gd: key: e439dda234467b07709f28b57f0a9bd5 数据审计 注解式(举例) Step1 新增PetTalentDataAudit数据审计定义类 package pro.shushi.pamirs.demo.core.init.audit; import pro.shushi.pamirs.data.audit.api.annotation.DataAudit; import pro.shushi.pamirs.demo.api.model.PetTalent; @DataAudit( model = PetTalent.MODEL_MODEL,//需要审计的模型 modelName = "宠物达人" ,//模型名称,默认模型对应的displayName //操作名称 optTypes = {PetTalentDataAudit.PETTALENT_CREATE,PetTalentDataAudit.PETTALENT_UDPATE}, fields={"nick","picList.id","picList.url","petShops.id","petShops.shopName"}//需要审计的字段,关系字段用"."连结 ) public class PetTalentDataAudit { public static final String PETTALENT_CREATE ="宠物达人创建"; public static final String PETTALENT_UDPATE ="宠物达人修改"; Step2 修改PetTalentAction的update方法 做审计日志埋点:手工调用 OperationLogBuilder.newInstance().record()方法。需要注意的是这里需要把原有记录的数据值先查出来做对比 @Function.Advanced(type= FunctionTypeEnum.UPDATE) @Function.fun(FunctionConstants.update) @Function(openLevel = {FunctionOpenEnum.API}) public PetTalent update(PetTalent data){ //记录日志 OperationLogBuilder.newInstance(PetTalent.MODEL_MODEL, PetTalentDataAudit.PETTALENT_UDPATE).record(data.queryById().fieldQuery(PetTalent::getPicList).fieldQuery(PetTalent::getPetShops),data); PetTalent existPetTalent = new PetTalent().queryById(data.getId()); if(existPetTalent !=null){ existPetTalent.fieldQuery(PetTalent::getPicList); existPetTalent.fieldQuery(PetTalent::getPetShops); existPetTalent.relationDelete(PetTalent::getPicList); existPetTalent.relationDelete(PetTalent::getPetShops); } data.updateById(); data.fieldSave(PetTalent::getPicList); data.fieldSave(PetTalent::getPetShops); return data; } Step3 重启看效果 修改宠物达人记录对应的字段,然后进入审计模块查看日志

    2024年5月23日
    1.6K00
  • 7.3.2 原业务加审批流程

    场景说明 场景描述:全员营销标准产品的功能并未有任务发放的审批流,在实际执行中,当营销专员配置好任务后,需部门领导对整个活动如该任务内容、形式、参与人员进行审批。 业务需求:在发布任务这个流程中增加审批节点。 实战训练 Step1 原业务分析 点击菜单【任务中心】通过URL上的model参数找到对应模型编码为【gemini.biz.GeminiTaskProxy】 进入模型设计器主页面,应用选择【全员营销】、选择【系统模型】、通过搜索关键字【任务】选择【Gemini任务代理】,展示方式从图模式切换到表单模式,对比【模型编码】 但目前模型为代理模型,代理模型是用于代理存储模型的数据管理器能力,同时又可以扩展出非存储数据信息的交互功能的模型。因为在代理模型中新增的字段都是非存储字段,所以如果要增加【审核状态】的字段一定以要在存储模型增加。其父模型的查看有两种方式 表单模式下可以直接看父模型 在图模式和表单模式下点击继承关系 点击【Gemini任务】,进入【Gemini任务】的模型设计界面,可以看出该模型所在模块为【全员营销核心业务】,从【系统字段】中找到【任务状态】字段,点击查看字段详情,我们可以看到【业务类型】为数据字典,字典类型为【任务状态】。 在模型设计器的管理页面上方点击【数字字典】选项卡,模块选择为【全员营销核心业务】,选择【系统字典】就可以查看到【任务状态】数字字典 总结如下: 给【Gemini任务】模型增加一个【任务审批状态】,记录审批状态 在任务创建的时候,修改【任务状态】为【关闭】确保任务未审批通过的时,用户无法操作该任务。 审批通过后,恢复【任务状态】为【初始化】 我们先来整理下核心流程即:任务审批流程。 Step2 利用模型设计器设计模型 在模型设计器的管理页面上方点击【数字字典】选项卡,模块选择为【全员营销核心业务】,点击添加【数据字典】按钮,设置对应数据项 设置【字典名称】为【审批状态】 设置【字典项类型】为【文本】 通过【添加数据字典项】按钮增加对应数据字典项,如审核中、审核失败、审核成功 在模型设计器的管理页面上方点击【模型】选项卡,模块选择为【全员营销核心业务】,选择【系统模型】、搜索任务选择【Gemini任务】,点击添加字段 为模型【Gemini任务】添加字段 设置【字段名称】为【任务审批状态】 设置【字段业务类型】为数据字典,并选择关联数据字典为【任务审批状态】 最后点击【创建】按钮完成操作 回到【Gemini任务】设计区,我们可以看到在模型的【自定义字段】选项卡下方多了一个【任务审批状态】字段 Step3 利用界面设计器,设计出必要的审核页面 进入界面设计器,应用选择全员营销,模型选择【Gemini任务】,点击添加页面下的直接创建 设置页面标题、模型(自动带上可切换)、业务类型(运营管理后续会扩展其他类型)、视图类型(表单)后点击确认按钮进入【Gemini任务】表单设计页面 进入页面设计器,对【Gemini任务】表单页面进行设计(更多细节介绍,请参考界面设计产品使用手册) 左侧为物料区:分为组件、模型。 【组件】选项卡下为通用物料区,我们可以为页面增加对应布局、字段(如同在模型设计器增加字段)、动作、数据、多媒体等等 【模型】选项卡下为页面对应模型的自定义字段、系统字段、以及模型已有动作 中间是设计区域 右侧为属性面板,在设计区域选择中组件会显示对应组件的可配置参数 在左侧【组件】选项卡下,拖入布局组件【分组】,并设置组件【标题属性】为基础信息 在左侧【模型】选项卡下,分别系统字段中的【任务标题】、【任务开始时间】、【任务结束时间】、【视频标题】、【视频风格】、【任务描述】拖入【基础信息】分组,并点击【任务描述】,在右侧属性面板的【交互】分组中设置宽度为1。最后别忘了点击【发布】按钮完成页面的发布 Step4 通过流程设计器,设计对应业务流程 进入流程设计器,点击【创建】按钮 注意:流程中需要获取【关系字段】的除关联字段(一般为ID)以外的字段需要通过【数据获取】节点单独获取【关系字段】的对象数据。所以在流程设计中经常会用到【数据获取】节点 左上角编辑流程名称为【任务审批流程】,点击第一个【触发】节点,触发方式选择模型触发,模型选择【Gemini任务】,触发场景选择【新增或更新数据时】,【筛选条件】设置为【任务审批状态】为空或【任务审批状态】等于【审核中】,点击该节点的【保存】按钮 点击流程图节点间的【+】图标选择增加【获取数据】节点,或者拖动左侧物料区【获取数据】到特定的【+】图标 点击【获取数据】,在右侧属性面板中设置【获取数据条数】为多条,选择模型为【Gemini用户任务实例】,点击【筛选条件】的【{X}】图标,进行数据获取的条件设置 选择条件字段为【任务ID】条件操作符为【等于】,条件为变量的导购字段的ID。当上下文只有一个变量时默认不需要选择,这里默认的是【模型触发:[Gemini任务]】,设置好以后点击确认,回到属性面板设置【未获取到数据时执行方式】为【终止流程】,并点击节点【保持】按钮 增加【更新数据】节点,在右侧属性面板中 【更新模型】选择【模型触发:[Gemini任务]】 【字段列表】点击【创建】按钮 字段选择 更新【任务状态】字段 表达式设置为:【已关闭】。 【字段列表】点击【创建】按钮 字段选择 更新【任务审核状态】字段 表达式设置为:【审核中】。 最终完成的【模型触发:[Gemini任务]】更新设置 a. 【模型触发:[Gemini任务]】的【任务状态】字段等于数字字典的【已关闭】,任务审核状态为【审核中】 b. 最后点击节点【保持】按钮。 再增加【更新数据】节点,在右侧属性面板中 【更新模型】选择【获取数据[Gemini用户任务实例]】 【字段列表】点击【创建】按钮 字段选择 更新【任务状态】字段 表达式设置为:【已关闭】。 最终完成的【获取数据[Gemini用户任务实例]】更新设置 a. 【获取数据[Gemini用户任务实例]】的【任务状态】字段等于数字字典的【已关闭】 b. 最后点击节点【保持】按钮。 增加【审批】节点,在右侧属性面板中 【审批模型】选择模型为【模型触发:[Gemini任务]】 【选择视图】选择前面新建的页面【流程中的任务编辑页】 【审批人】选择角色为【超级管理员】 【数据】权限全部设置为【查看】 其他配置项默认,需要了解更多请查看产品使用手册 最后点击节点【保持】按钮。 新增【审核分支】,在【通过】分支中增加两个数据更新节点,跟审核前的两个数据更新节点对应 【模型触发:[Gemini任务]】的【任务状态】字段等于数字字典的【初始化】,任务审核状态为【审核通过】 【获取数据[Gemini用户任务实例]】的【任务状态】字段等于数字字典的【初始化】 流程确保保持并发布过,点击右上角【发布流程】完成流程的保存与发布 Step5 检验效果 创建任务后,任务状态为【关闭】状态,任务列表中的任务状态为多个状态的计算值 审核通过后,任务状态为【进行中】状态,任务列表中的任务状态为多个状态的计算值

    2024年5月23日
    1.8K00
  • 3.3.8 字段类型之基础与复合

    模型字段是描述实体的特征属性,本文介绍重点介绍字段的基础类型与复合类型 使用@Field注解来描述模型的字段。如果未配置字段类型,系统会根据Java代码的字段声明类型来自动获取业务类型。建议配置displayName属性来描述字段在前端的显示名称。可以使用defaultValue配置字段的默认值。 一、安装与更新 使用@Field.field来配置字段的不可变更编码。字段一旦安装,无法在对该字段编码值进行修改,之后的字段配置更新会依据该编码进行查找并更新;如果仍然修改该注解的配置值,则系统会将该字段识别为新字段,存储模型会创建新的数据库表字段,而原字段将会rename为废弃字段。 二、字段类型 类型系统由基本类型、复合(组件)类型、引用类型和关系类型四种类型系统构成。通过类型系统描述应用程序、数据库和前端视觉视图如何进行交互,数据及数据间关系如何处理的协议。其中引用类型和关系类型介绍详见3.3.9【字段类型之关系与引用】一文,字段命名规范参见3.3.1【构建第一个Model】一文,这里不再赘述。 基本类型 业务类型 Java类型 数据库类型 规则说明 BINARY ByteByte[] TINYINTBLOB 二进制类型,不推荐使用 INTEGER ShortIntegerLongBigInteger smallintintbigintdecimal(size,0) 整数, 包括整数(10-11位有效数字)、长整数(19-20位有效数字)和大整数(超过19位)。【数据库规则】:默认使用int;如果size小于6则使用smallint;如果size超过6则使用int;如果size超过10位数字,即大于11(包含符号位),则使用长整数bigint;如果size超过19位数字,即大于20(包含符号位),则使用大数decimal。若未配置size,则按Java类型推测。【前端交互规则】:整数使用Number类型,长整数和大整数前后端协议使用字符串类型。 FLOAT FloatDoubleBigDecimal float(M,D)double(M,D)decimal(M,D) 浮点数,?包括单精度浮点数(7-8位有效数字)、双精度浮点数(15-16位有效数字)和大数(超过15位)。【数据库规则】:默认使用单精度浮点数float;如果size超过7位数字,即大于等于8,则使用双精度浮点数double;如果size超过15位数字,即大于等于16,则使用大数decimal。若未配置size,则按Java类型推测。【前端交互规则】:单精度浮点数float和双精度浮点数double使用Number类型(因为都使用IEEE754协议64位进行存储),大数前后端协议使用字符串类型。 BOOLEAN Boolean tinyint(1) 布尔类型,值为1,true(真)或0,false(假) ENUM Enum 与数据字典指定基本类型一致 【前端交互规则】:可选项从ModelField的options字段获取,options字段值为字段指定数据字典子集的JSON序列化字符串。前后端传递的是可选项的name,数据库存储使用可选项的value。multi属性为true,则使用多选控件;multi属性为false,则使用单元控件 STRING String varchar(size) 字符串,size为长度限制默认值参考,前端可以view中覆盖该配置 TEXT String text 多行文本,编辑态组件为多行文本框,长度限制为配置项size值 HTML String text 富文本编辑器 DATETIME java.util.Datejava.sql.Timestamp datetime(fraction)timestamp(fraction) 日期时间类型【数据库规则】:日期和时间的组合,时间格式为?YYYY-MM-DD HH:MM:SS[.fraction],默认精确到秒,在默认的秒精确度上,可以带小数,最多带6位小数,即可以精确到?microseconds (6 digits) precision。可以通过设置fraction来设置精确小数位数,最终存储在字段的decimal属性上。【前端交互规则】:前端默认使用日期时间控件,根据日期时间类型格式化格式format格式化日期时间 YEAR java.util.Date year 年份类型日期类型【数据库规则】:默认“YYYY”格式表示的日期值【前端交互规则】:前端默认使用年份控件,根据日期类型格式化格式format格式化日期 DATE java.util.Datejava.sql.Date datedate 日期类型【数据库规则】:默认“YYYY-MM-DD”格式表示的日期值【前端交互规则】:前端默认使用日期控件,根据日期类型格式化格式format格式化日期 TIME java.util.Datejava.sql.Time time(fraction)time(fraction) 时间类型【数据库规则】:默认“HH:MM:SS”格式表示的时间值【前端交互规则】:前端默认使用时间控件,根据日期类型格式化格式format格式化日期 表3-3-8-1 字段基本类型 复合类型 业务类型 Java类型 数据库类型 规则说明 MONEY BigDecimal decimal(M,D) 金额,前端使用金额控件,可以使用currency设置币种字段 表3-3-8-2 字段复合类型 不可变更字段 使用immutable属性来描述该字段前后端都无法进行更新操作,系统会忽略不可变更字段的更新操作。 自动生成编码的字段 详见3.3.5【模型编码生成器】一文。 字段的序列化与反序列化 使用@Field注解的serialize属性来配置非字符串类型属性的序列化与反序列化方式,最终会以序列化后的字符串持久化到存储中。 详见3.3.7【字段之序列化方式】一文 前端默认配置 可以使用@Field注解中的以下属性来配置前端的默认视觉与交互规则,也可以在前端设置覆盖以下配置。 @Field(required),是否必填 @Field(invisible),是否不可见 @Field(priority),字段优先级,列表的列使用该属性进行排序 更多前端默认视图配置详见:3.5.4【Ux注解详解】一文,如:readonly是否只读等。 举例 回顾我们前面学习例子 现有PetShop代码如下 package pro.shushi.pamirs.demo.api.model; import pro.shushi.pamirs.core.common.enmu.DataStatusEnum; import pro.shushi.pamirs.demo.api.enumeration.PetShopOptionEnum; import pro.shushi.pamirs.meta.annotation.Field; import pro.shushi.pamirs.meta.annotation.Model; import java.sql.Time; import java.util.List; @Model.model(PetShop.MODEL_MODEL) @Model(displayName = 宠物店铺,summary=宠物店铺,labelFields ={shopName} ) @Model.Code(sequence = DATE_ORDERLY_SEQ,prefix = P,size=6,step=1,initial = 10000,format = yyyyMMdd) public class PetShop extends AbstractDemoIdModel { public static final String MODEL_MODEL=demo.PetShop; @Field(displayName = 店铺编码) private String code; @Field(displayName = 店铺编码2) @Field.Sequence(sequence = DATE_ORDERLY_SEQ,prefix = C,size=6,step=1,initial = 10000,format = yyyyMMdd) private String codeTwo; @Field(displayName = 店铺名称,required = true) private String shopName; @Field(displayName = 开店时间,required = true) private Time openTime; @Field(displayName = 闭店时间,required = true) private Time closeTime; @Field(displayName =…

    2024年5月23日
    1.7K00
  • 4.1.14 Search之非存储字段条件

    search默认查询的是模型的queryPage函数,但我们有时候需要替换调用的函数,这个特性会在下个版本支持。其核心场景为当搜索条件中有非存储字段,如果直接用queryPage函数的rsql拼接就会报错,所以非存储字段不会增加在rsql中。本文介绍一个比较友好的临时替代方案。 非存储字段条件(举例) Step1 为PetTalent新增一个非存储字段unStore @Field(displayName = "非存储字段测试",store = NullableBoolEnum.FALSE) private String unStore; 图4-1-14-1 为PetTalent新增一个非存储字段unStore Step2 修改PetTalent的Table视图的Template 在标签内增加一个查询条件 <field data="unStore" /> 图4-1-14-2 修改PetTalent的Table视图的Template Step3 重启看效果 进入宠物达人列表页,在搜索框【非存储字段测试】输入查询内容,点击搜索跟无条件一致 Step4 修改PetTalentAction的queryPage方法 package pro.shushi.pamirs.demo.core.action; …… 引入依赖类 @Model.model(PetTalent.MODEL_MODEL) @Component public class PetTalentAction { ……其他代码 @Function.Advanced(type= FunctionTypeEnum.QUERY) @Function.fun(FunctionConstants.queryPage) @Function(openLevel = {FunctionOpenEnum.API}) public Pagination<PetTalent> queryPage(Pagination<PetTalent> page, IWrapper<PetTalent> queryWrapper){ QueryWrapper<PetTalent> queryWrapper1 = (QueryWrapper<PetTalent>) queryWrapper; Map<String, Object> queryData = queryWrapper.getQueryData(); String unStore = (String) queryData.get(LambdaUtil.fetchFieldName(PetTalent::getUnStore)); if (StringUtils.isNotEmpty(unStore)) { //转换查询条件 queryWrapper1.like( 图4-1-14-3 修改PetTalentAction的queryPage方法 Step5 重启看效果 在搜索框【非存储字段测试】输入查询内容,跟通过【达人】字段搜索的效果是一致的 图4-1-14-4 示例效果

    2024年5月23日
    2.1K00

Leave a Reply

Please Login to Comment