
1.3 Oinone的生态思考

以“企业级软件生态”的方式去帮助企业建立“一站式的商业智能软件”。

通过观察信息化到数字化的软件行业发展历程(如下图1-3所示),我们可以发现,企业真正需要的是一站式的软件产品。然而,一站式的软件产品往往都是从单个领域的需求满足开始,这在信息化时代和数字化时代都是如此。在信息化时代,以ERP为终点的一站式趋势逐渐形成;而在数字化时代,中台概念的提出则标志着一站式的趋势重新开始。本文将从企业数字化转型所面临的困境出发,探讨Oinone的生态思考。
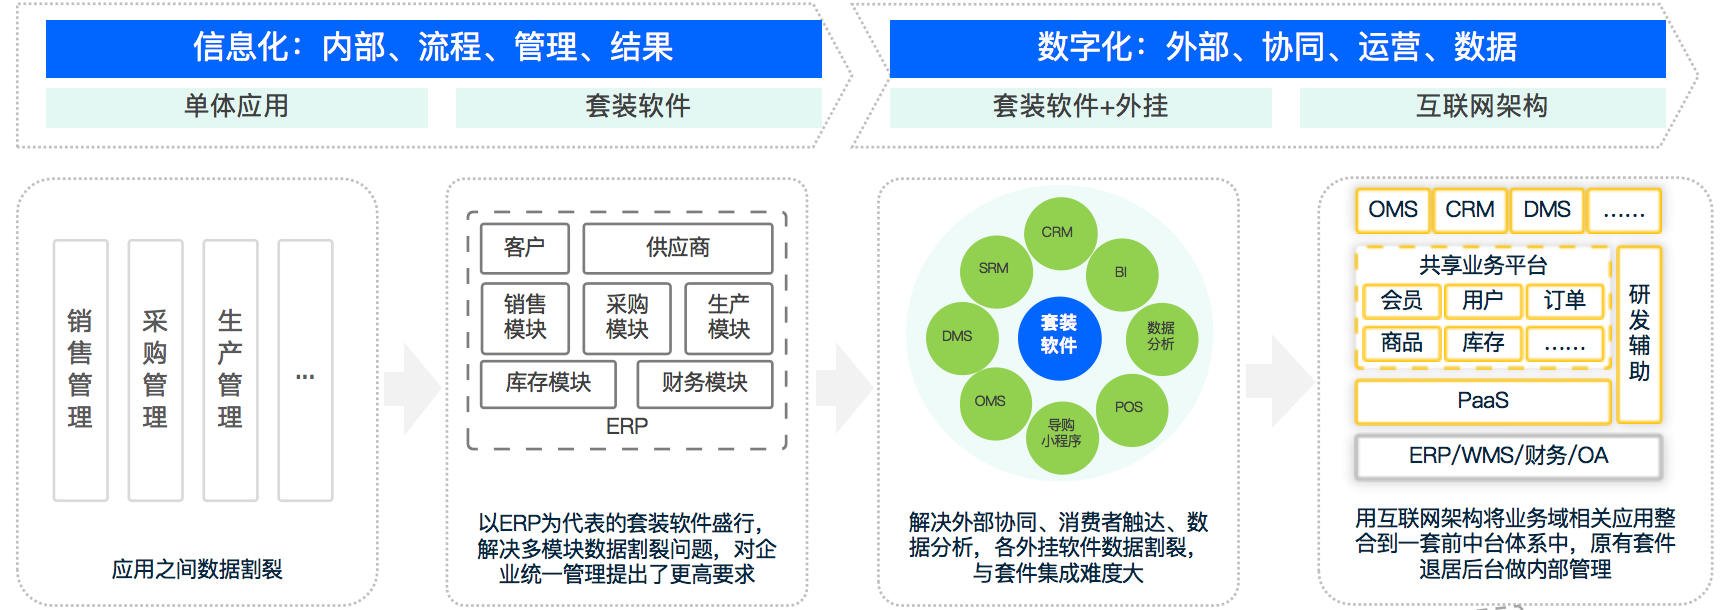
image.png

图1-3 从信息化到数字化软件行业发展历程

1.3.1 与中台的渊源

中台概念的提出标志着企业数字化改造进入了一个新的时代。随着数字化转型不断深入,企业面临着严重的数据割裂、系统隔离等问题。在这样的背景下,“敏捷响应,低成本地快速创新”成为了推动一站式商业智能软件的内在诉求。需要澄清的是,互联网中台架构只是一种企业解决数据割裂、系统隔离,建立一站式商业智能软件的技术概念之一,并不是技术标准。而且这种方式只适用于企业自建模式。在多供应商环境下,则会适得其反,导致建立更复杂的烟囱系统。

阿里于15年提出中台架构概念,抓住了企业数字化转型的核心诉求,即“敏捷响应,低成本快速创新”。然而,阿里作为一家生态公司,在16年时基本上是带着合作伙伴来给企业交付,但由于伙伴对互联网技术的理解和能力的限制,基本上都做得不好,甚至失败。在2017年,阿里成立了原生交付团队,希望能够树立一些标杆案例。我和公司的核心成员也都来自于这个团队。在做完几个客户后,我发现阿里也做不好,但这次做不好的原因不是技术不行或项目上不了线,而是上线以后预期的效果没有达到,其本质是企业的IT组织能力无法驾驭复杂的互联网中台架构。当无法驾驭的时候,所谓的目标“敏捷响应,快速创新”就无从说起了。结果客户会反馈以下三类问题:

  1. 不是说敏捷响应吗?为什么改个需求这么慢,不但时间更长,付出的成本也更高了?是因为中台架构需要一定的技术能力和经验才能有效地应用,就像一个只会骑自行车的人给他一辆汽车或者飞机,他也不能驾驭它们,更不用说是手动挡的。

  2. 不是说能力中心吗?当引入新供应商或有新场景开发的时候,为什么前期做的能力中心不能支撑了?是因为能力中心是一种面向业务的能力组织方式,它将不同的业务能力抽象出来,以服务的形式对内提供。然而,由于业务场景的差异,不同的业务需要的能力也会不同,因此能力中心需要不断迭代和升级。对于新引入的供应商或新场景开发,需要根据实际情况对能力中心进行定制化和扩展化,但谁来负责呢?新项目的供应商还是客户自己?

  3. 不是说性能好吗?为什么我投入的物理资源更多了?是因为中台架构采用微服务来解决单点瓶颈问题,提高系统性能和可用性,但是在初始阶段,投入的资源可能会更多。每个模块至少需要两个实例来保障高可用性,因此物理资源的投入量可能会比以前更多。

1.3.2 找解决方案

在考虑解决方案之前,我们需要思考企业数字化软件的最终状态将是什么样子。目前有两种主要的方案(如下图1-4所示):

第一种是以自建研发团队为核心。中国的大型企业已经开始尝试这种模式,看起来似乎是一个时下比较流行的可行性方案。然而,绝大多数企业由于成本、人才团队等原因而难以坚持下去,只能与供应商合作开发。

第二种是以供应商为核心。由于大多数企业无法选择第一种路径,他们必须接受目前分散的情况,并通过系统集成尽可能拉通各个系统。尽管如此,在数字化时代中,真正意义上的一站式商业智能软件供应商还未出现。
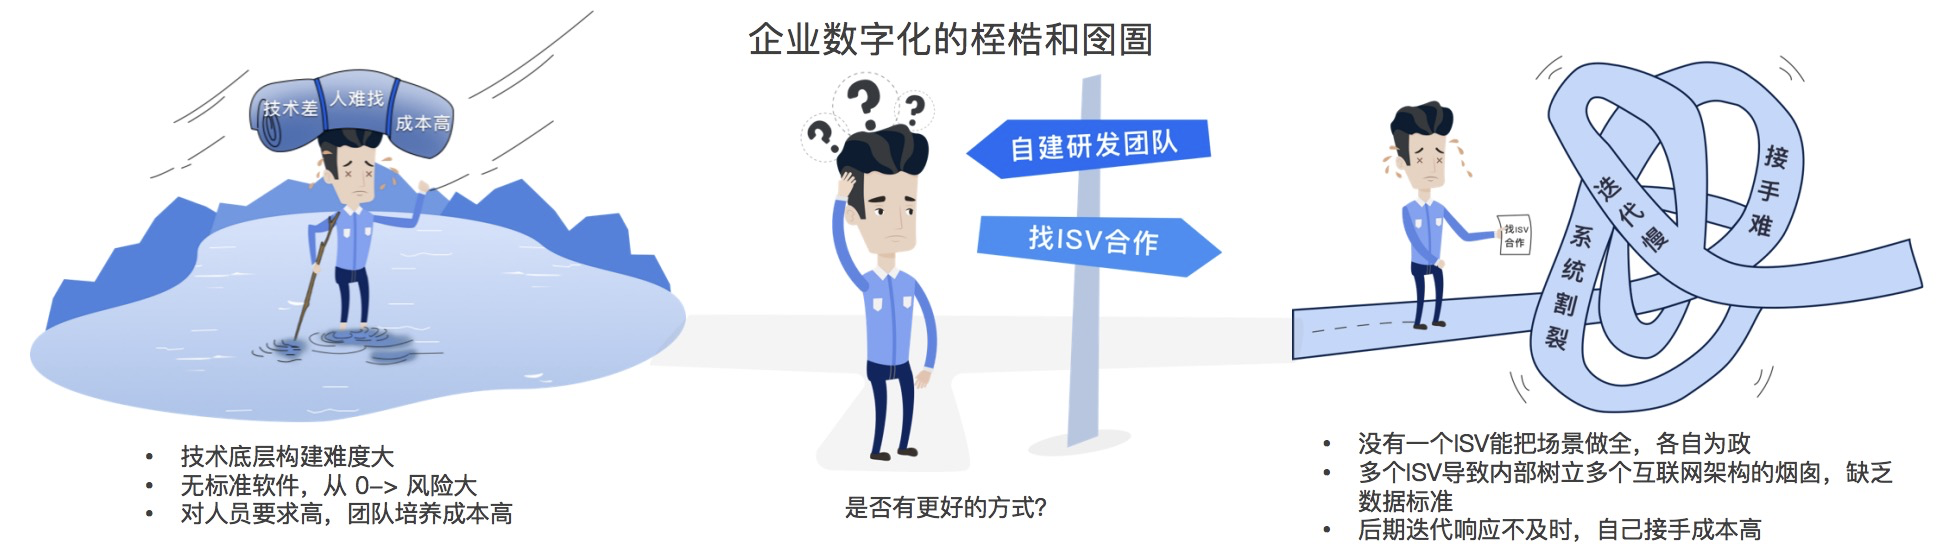
image.png

图1-4 企业数字化桎梏和囹圄

对企业来说,这两种方案都非常艰难,但在大规模数字化历程中又不得不做出选择。此外,我们还能清晰看到以下几点:

  1. "敏捷响应,低成本地快速创新"成为企业推动一站式商业智能软件的内在诉求

  2. 目前没有一家软件供应商能满足企业所有外围商业场景,也不可能有这样的供应商

  3. 绝大部分企业需要软件供应商,而不是自建

如何突破这种局面也成为中国软件行业发展的一个机遇。因此,我的思考是:

  1. 我们的目标不是依托于提升研发人员的能力,而是降低互联网架构的门槛,让更多企业真正拥有“敏捷响应,低成本快速创新”的能力。

  2. 我们的目标不是输出中台方法论,而是提供中台建设的技术平台。

  3. 我们的目标不是只服务大企业,而是真正赋能不同IT组织能力的企业,让它们都具备持续创新的能力。

今天,许多中台软件公司告诉企业:“中台是持续演进和快速迭代的过程,因此企业需要组建中台架构团队来实现,而他们则通过中台项目落地将中台建设方法论传授给企业。”这句话的前半部分是正确的,因为我们之前提到企业需要具备敏捷响应业务的能力,即应变能力,因为应变是不断变化的。然而,后半部分是不正确的,因为今天的企业已经有能力组建团队,那么这些中台软件公司到底有什么用呢?企业真的缺少方法论吗?在19年,我就提出了自己的看法:没有低代码能力的中台公司都在收取智商税,都在欺诈,因为很多企业根本找不到足够懂互联网架构的人才。明白流氓在哪里了吗?这些流氓公司赚了很多钱,最后责怪企业无法招到人才,这是企业的责任。因此,仍然认为“最好的赋能是降低门槛,而不是让客户提高技术水平”。

最终,我们得出了一个服务模式的想法:构建企业级的软件生态。企业级软件生态的确切定义是:通过开放的方式,让企业本身以及不同的软件供应商共同参与,遵循相同的技术和数据规范,打造一体化、无需集成的各类企业级软件。如果要打造企业级软件生态,我们列出了六个要点(如下图1-5所示)。
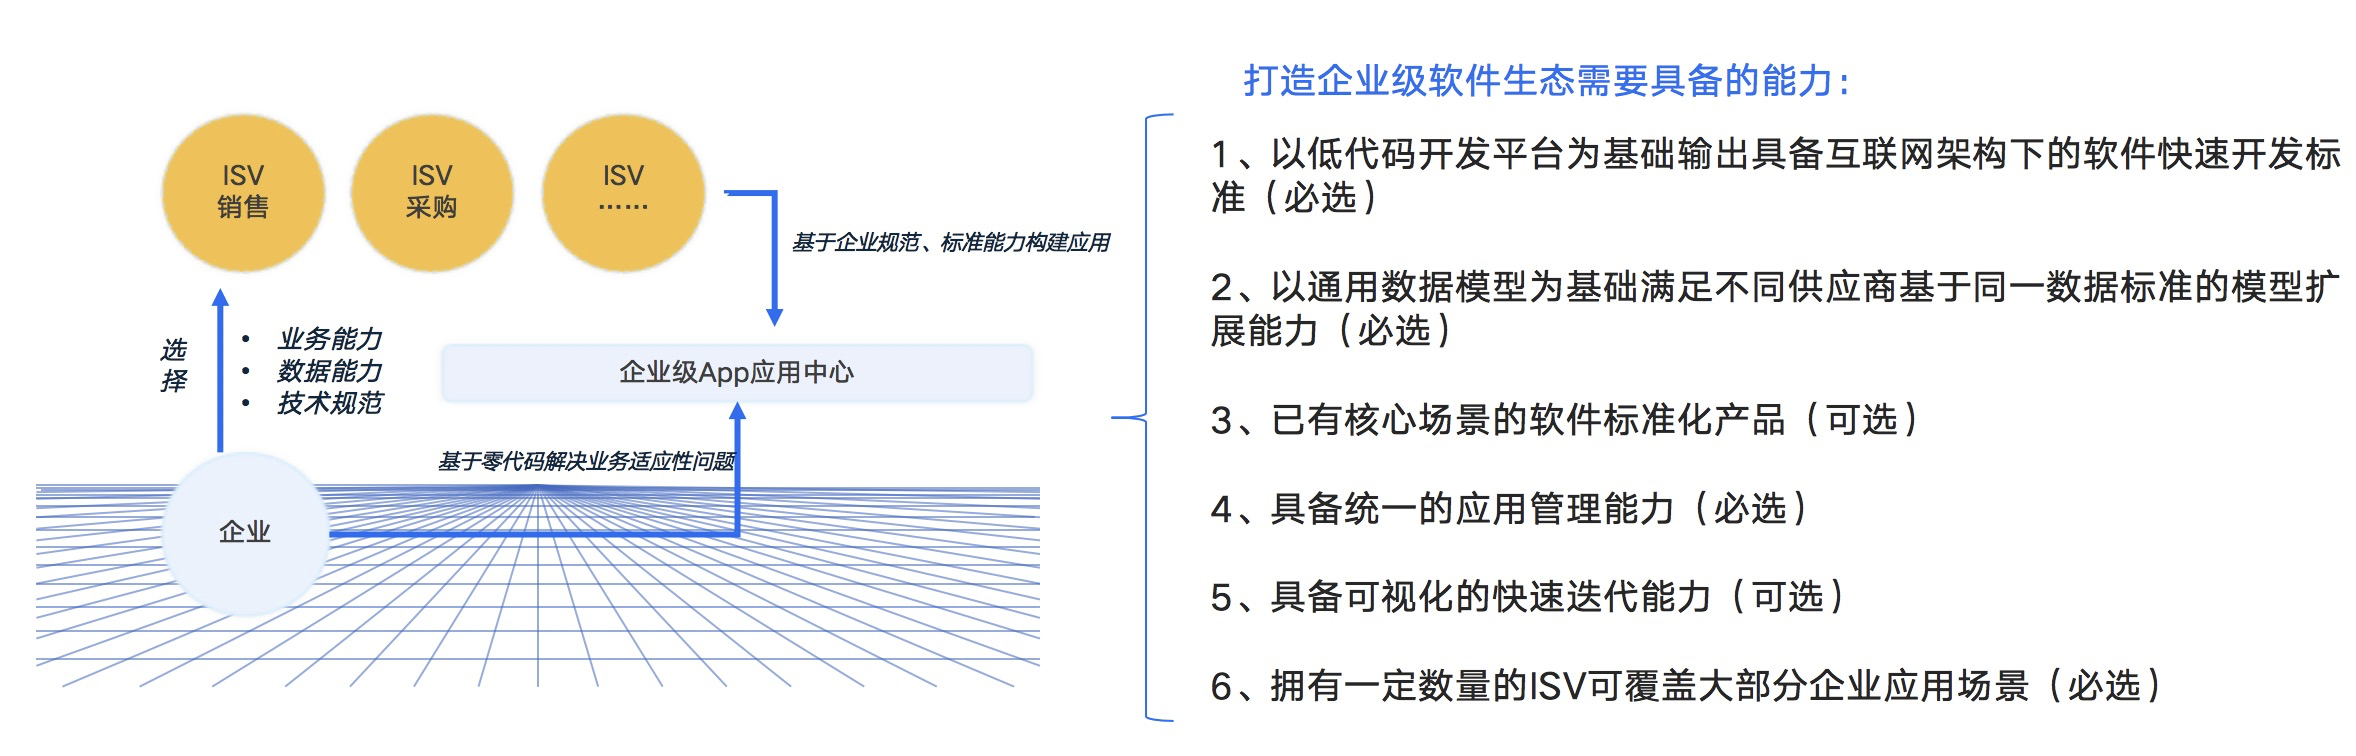
image.png

图1-5 打造企业级软件生态需要具备的六大能力

我很幸运地有机会通过“企业级软件生态”的方式,为企业建立“一站式的商业支持平台”提供帮助。我们的Oinone平台结合了低代码开发、通用数据模型和业务产品的优势(如下图1-6所示)。
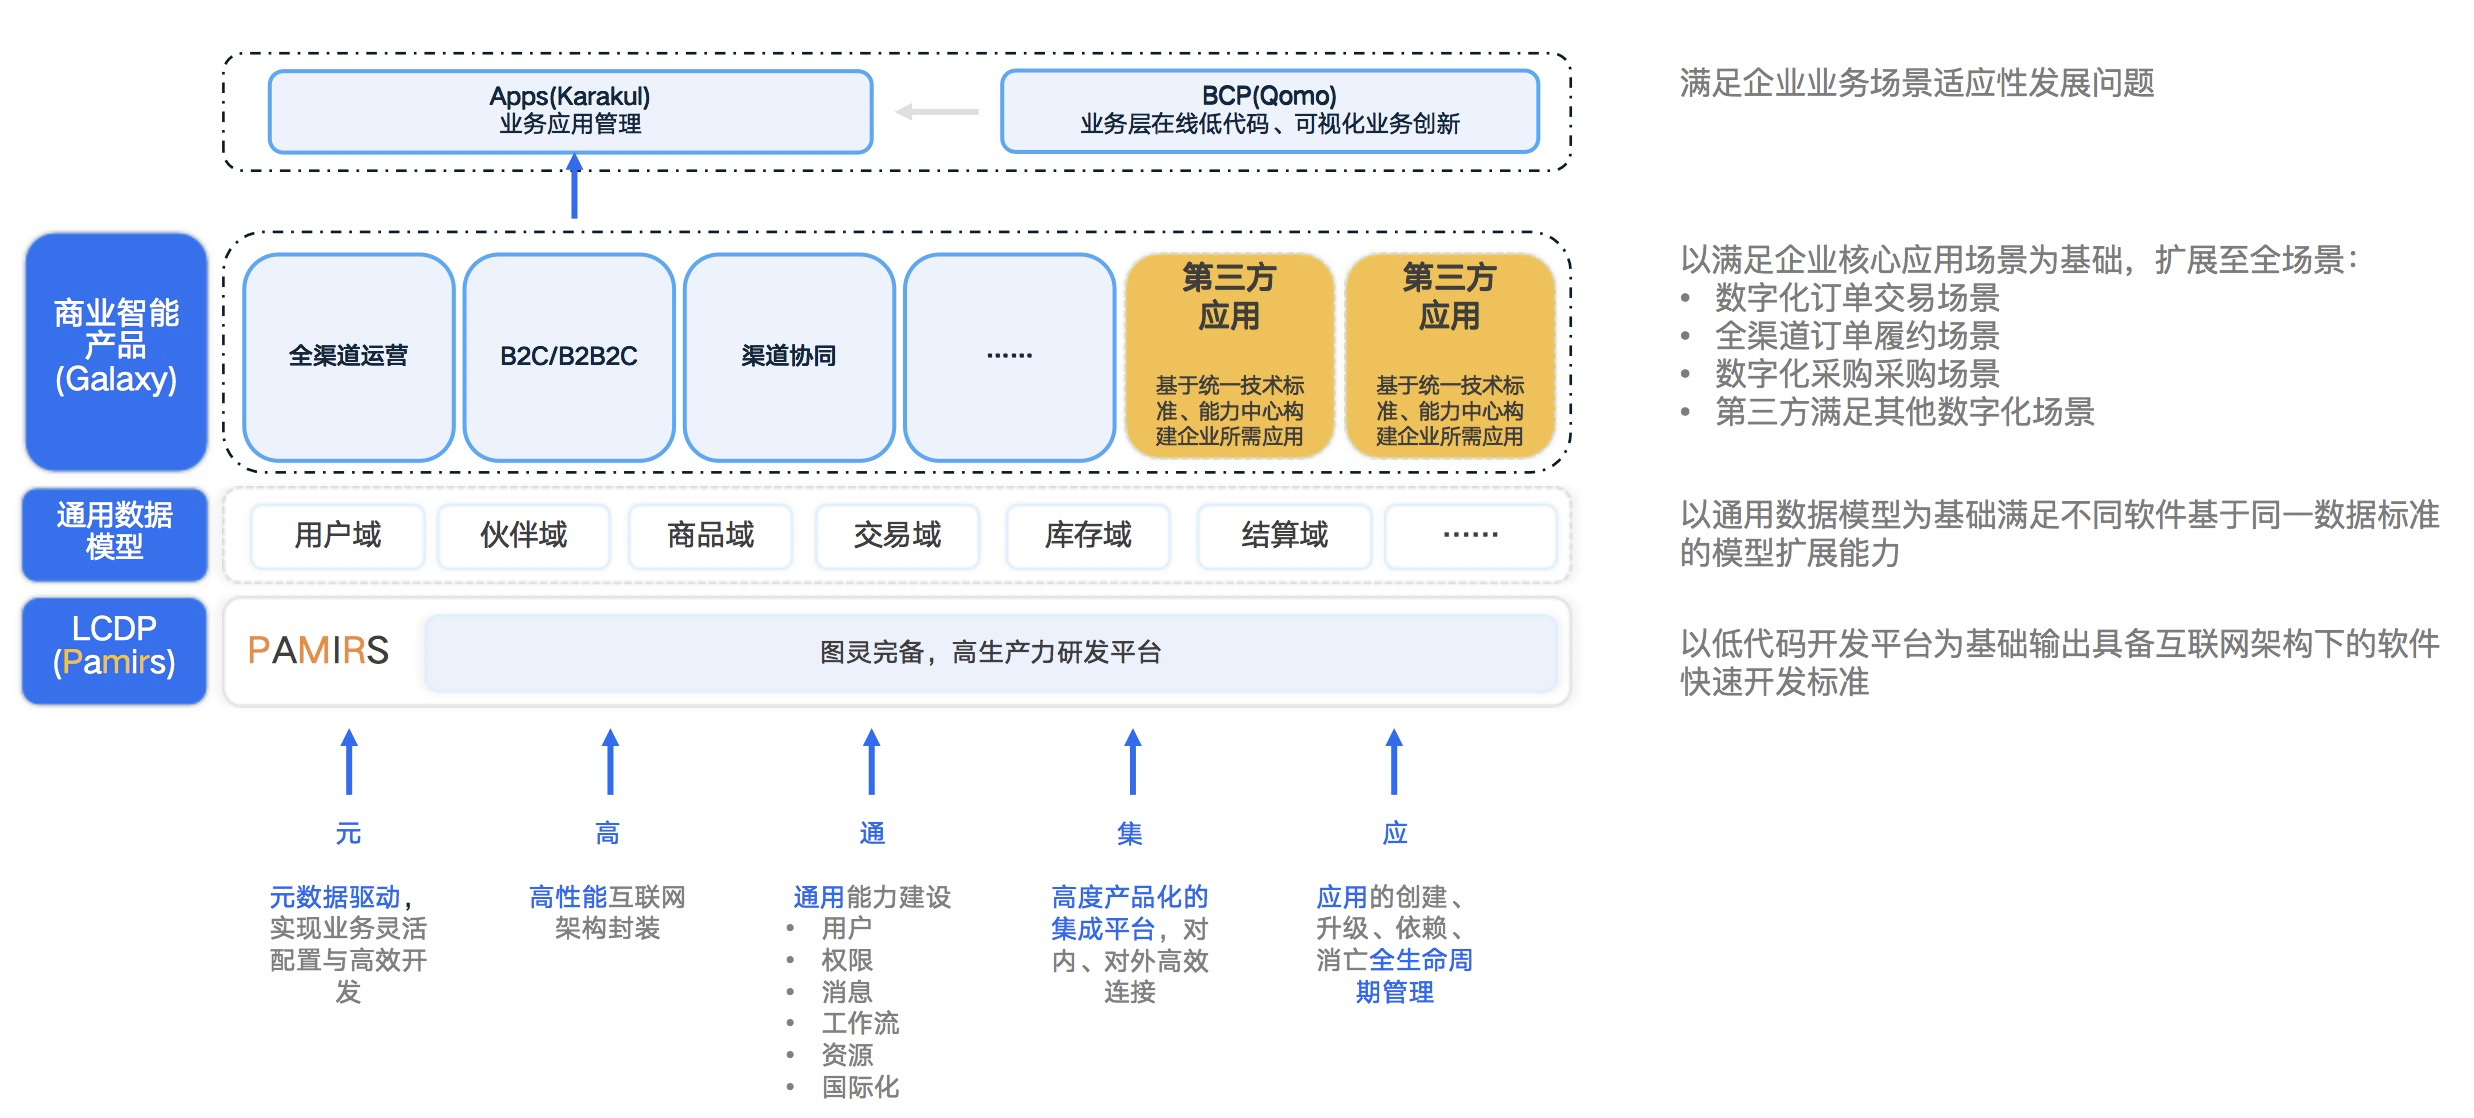
image.png

图1-6 Oinone = 低代码开发平台 + 通用数据模型 + 业务产品

我们对Oinone一站式低代码商业支撑平台展开介绍,它大致分为4部分:

  1. 以低代码开发平台为基础,输出具备互联网架构下的软件快速开发标准。这可以帮助企业快速构建符合互联网架构标准的应用程序,从而实现快速响应和低成本创新。

  2. 以通用数据模型为基础,满足不同软件基于同一套数据标准的扩展能力。这可以确保不同软件系统之间的数据兼容性和互操作性,避免数据孤岛和信息隔离。

  3. 在业务产品层面上,企业和伙伴基于相同的技术标准和数据标准共同提供解决方案。这可以帮助企业和伙伴共同开发出符合标准的商业支撑平台,以提高业务效率和创新能力。

  4. 最后是无代码设计器,用于满足项目开展中,超出业务标品范围之外的需求,或者针对标品的临时需求。这可以帮助业务人员在不需要专业软件支持的情况下,自主解决业务需求,并支持部门间的协同工作。

1.3.3 生态建设

Oinone致力于打造全球最大的无需集成的商业应用程序及其生态系统,通过开源内核、汇集数千名开发人员和业务专家,为企业提供成本效益、一体化、模块化的解决方案,解决所有商业需求,让不同技术之间的合作变得简单易行,摆脱烦恼的集成问题。

在客户和场景领域,我们严格限定了自身的专注领域。针对超大型头部企业,我们专注于树立标杆,而对于大、中、小型企业,则交由我们的伙伴来支持。小微企业可以通过我们的开源社区版获得覆盖。在企业数字化转型的核心领域中,我们的解决方案涵盖了数字化交易场景、全渠道订单履约场景、数字化采购场景、数字化营销等产品。在其他领域,我们完全交由伙伴来建设。由于我们自身在企业协同商务领域拥有深厚的背景,因此在该领域提供的产品拥有特别的优势。
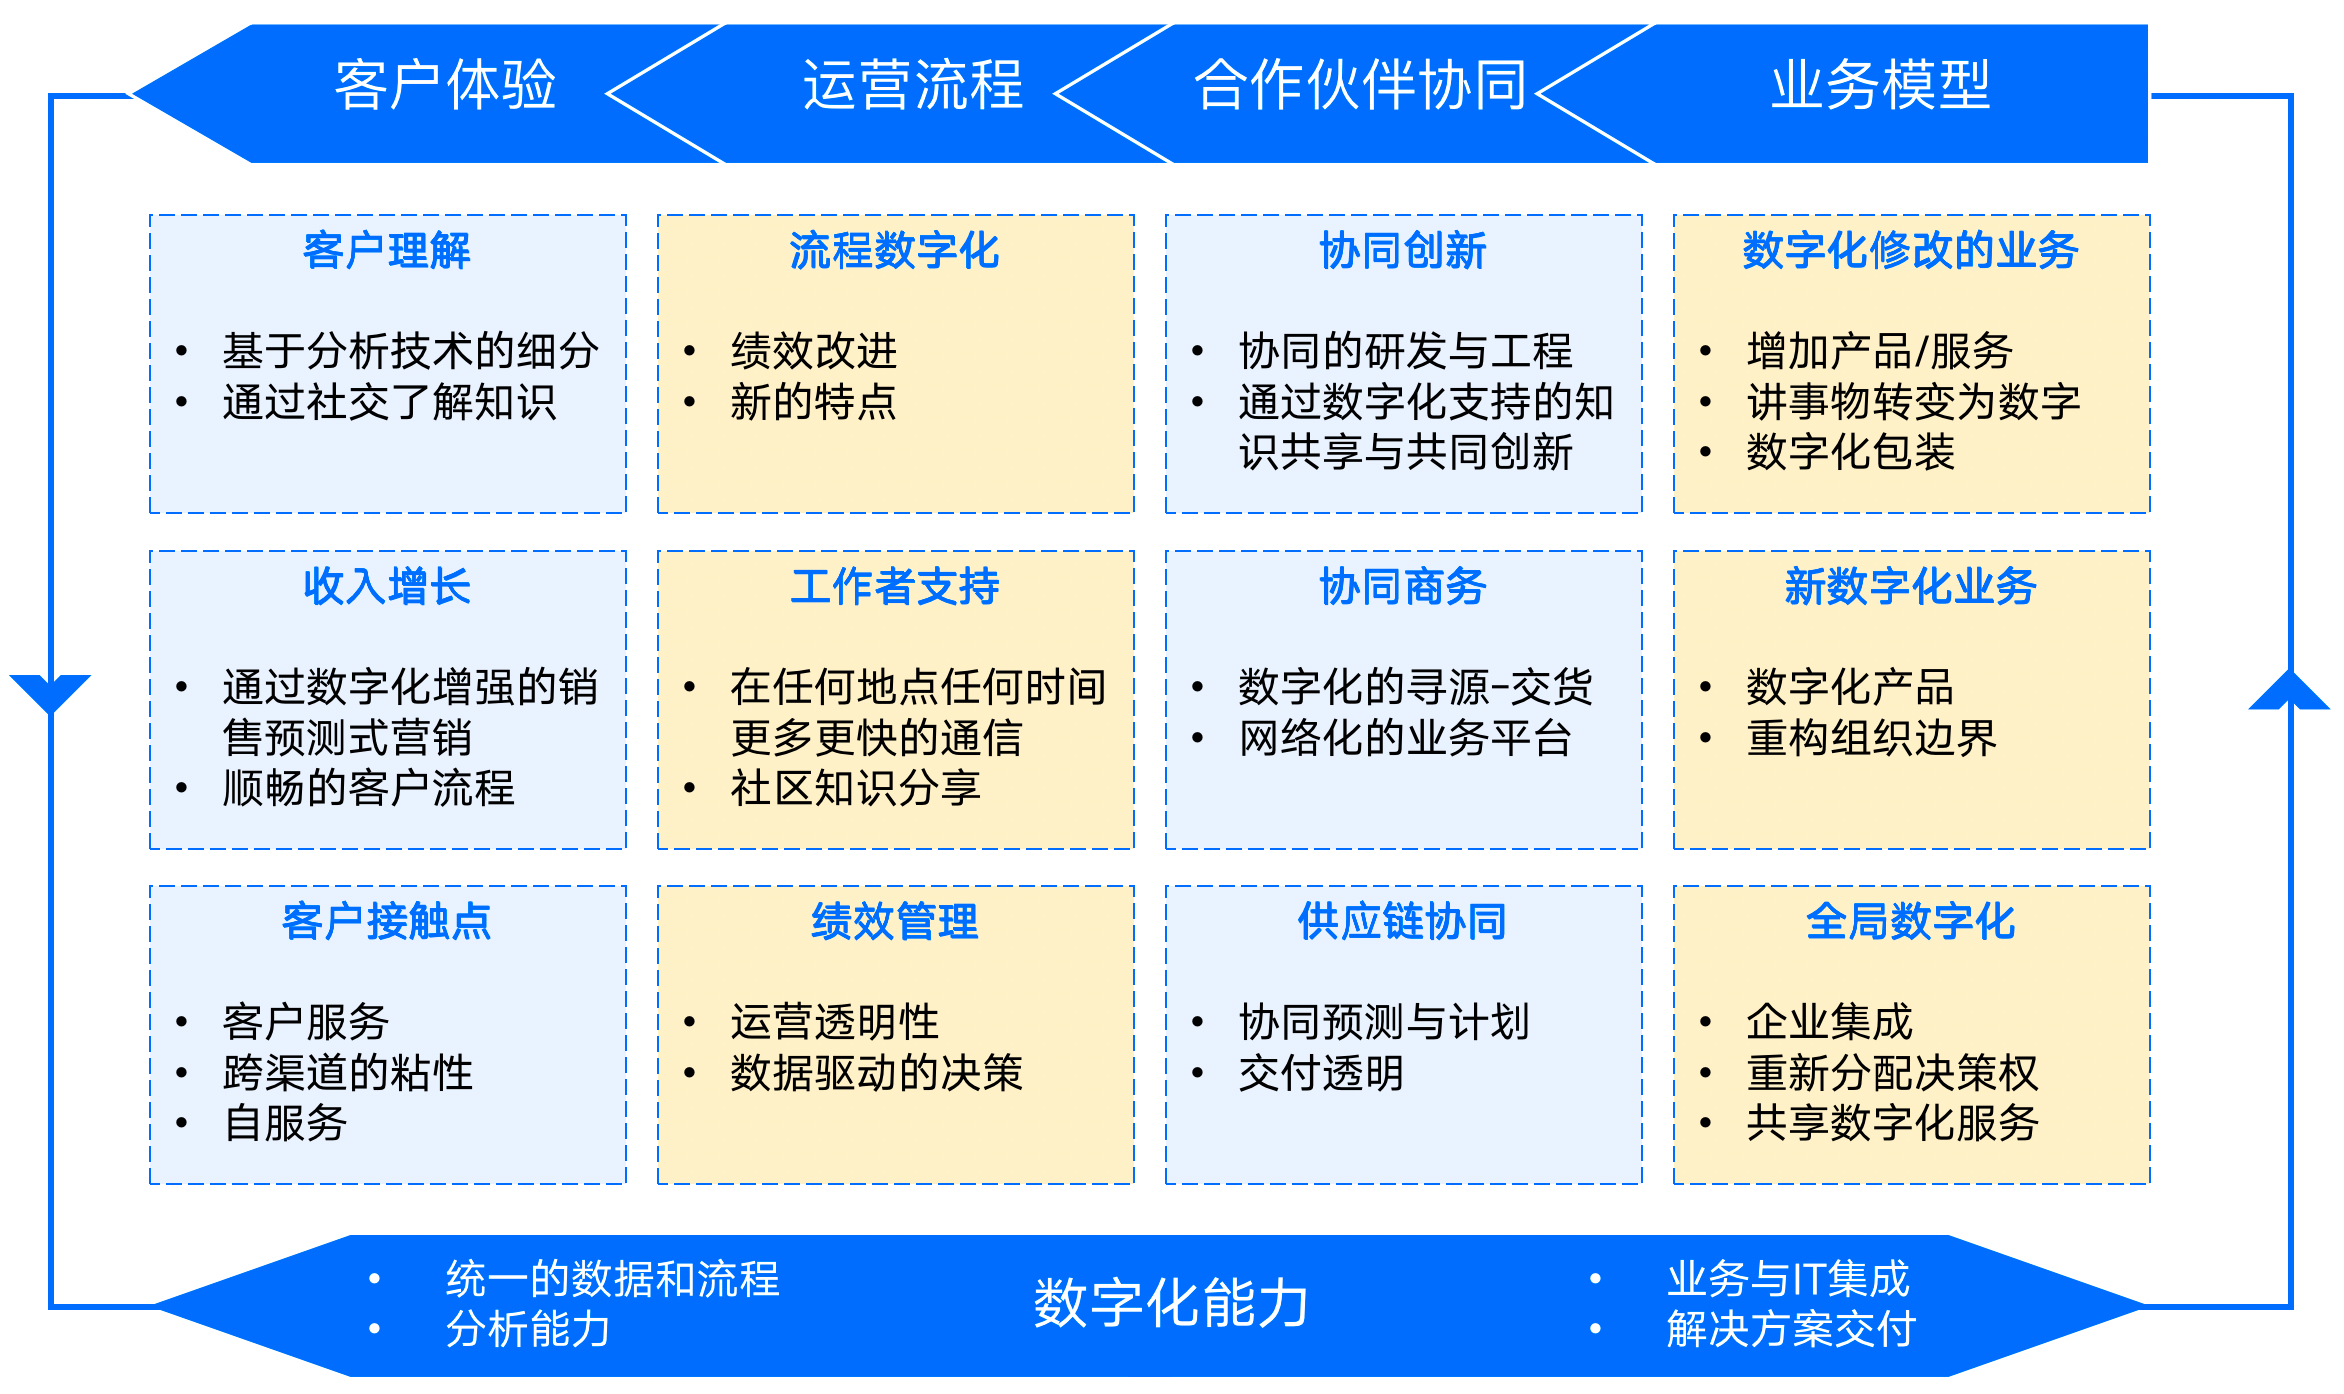
企业数字化转型核心领域

image.png

图1-7 企业数字化转型核心领域

Oinone社区 作者:史, 昂原创文章,如若转载,请注明出处:https://doc.oinone.top/oio4/9212.html

访问Oinone官网:https://www.oinone.top获取数式Oinone低代码应用平台体验

Like (0)
史, 昂's avatar史, 昂数式管理员
Previous 2024年5月23日 am10:10
Next 2024年5月23日 am10:12

相关推荐

  • 4.1.24 框架之分库分表

    随着数据库技术的发展如分区设计、分布式数据库等,业务层的分库分表的技术终将成老一辈程序员的回忆,谈笑间扯扯蛋既羡慕又自吹地说到“现在的研发真简单,连分库分表都不需要考虑了”。竟然这样为什么要写这篇文章呢?因为现今的数据库虽能解决大部分场景的数据量问题,但涉及核心业务数据真到过亿数据后性能加速降低,能给的方案都还有一定的局限性,或者说性价比不高。相对性价比比较高的分库分表,也会是现阶段一种不错的补充。言归正传oinone的分库分表方案是基于Sharding-JDBC的整合方案,所以大家得先具备一点Sharding-JDBC的知识。 一、分表(举例) 做分库分表前,大家要有一个明确注意的点就是分表字段的选择,它是非常重要的,与业务场景非常相关。在明确了分库分表字段以后,甚至在功能上都要做一些妥协。比如分库分表字段在查询管理中做为查询条件是必须带上的,不然效率只会更低。 Step1 新建ShardingModel模型 ShardingModel模型是用于分表测试的模型,我们选定userId作为分表字段。分表字段不允许更新,所以这里更新策略设置类永不更新,并在设置了在页面修改的时候为readonly package pro.shushi.pamirs.demo.api.model; import pro.shushi.pamirs.boot.base.ux.annotation.field.UxWidget; import pro.shushi.pamirs.boot.base.ux.annotation.view.UxForm; import pro.shushi.pamirs.meta.annotation.Field; import pro.shushi.pamirs.meta.annotation.Model; import pro.shushi.pamirs.meta.enmu.FieldStrategyEnum; @Model.model(ShardingModel.MODEL_MODEL) @Model(displayName = "分表模型",summary="分表模型",labelFields ={"name"} ) public class ShardingModel extends AbstractDemoIdModel { public static final String MODEL_MODEL="demo.ShardingModel"; @Field(displayName = "名称") private String name; @Field(displayName = "用户id",summary = "分表字段",immutable=true/* 不可修改 **/) @UxForm.FieldWidget(@UxWidget(readonly = "scene == 'redirectUpdatePage'"/* 在编辑页面只读 **/ )) @Field.Advanced(updateStrategy = FieldStrategyEnum.NEVER) private Long userId; } 图4-1-24-1 新建ShardingModel模型 Step2 配置分表策略 配置ShardingModel模型走分库分表的数据源pamirsSharding 为pamirsSharding配置数据源以及sharding规则 a. pamirs.sharding.define用于oinone的数据库表创建用 b. pamirs.sharding.rule用于分表规则配置 pamirs: load: sessionMode: true framework: system: system-ds-key: base system-models: – base.WorkerNode data: default-ds-key: pamirs ds-map: base: base modelDsMap: "[demo.ShardingModel]": pamirsSharding #配置模型对应的库 图4-1-24-2 指定模型对应数据源 pamirs: sharding: define: data-sources: ds: pamirs pamirsSharding: pamirs #申明pamirsSharding库对应的pamirs数据源 models: "[trigger.PamirsSchedule]": tables: 0..13 "[demo.ShardingModel]": tables: 0..7 table-separator: _ rule: pamirsSharding: #配置pamirsSharding库的分库分表规则 actual-ds: – pamirs #申明pamirsSharding库对应的pamirs数据源 sharding-rules: # Configure sharding rule ,以下配置跟sharding-jdbc配置一致 – tables: demo_core_sharding_model: #demo_core_sharding_model表规则配置 actualDataNodes: pamirs.demo_core_sharding_model_${0..7} tableStrategy: standard: shardingColumn: user_id shardingAlgorithmName: table_inline shardingAlgorithms: table_inline: type: INLINE props: algorithm-expression: demo_core_sharding_model_${(Long.valueOf(user_id) % 8)} props: sql.show: true 图4-1-24-3 分库分表规则配置 Step3 配置测试入口 修改DemoMenus类增加一行代码,为测试提供入口 @UxMenu("分表模型")@UxRoute(ShardingModel.MODEL_MODEL) class ShardingModelMenu{} 图4-1-24-4 配置测试入口 Step4 重启看效果 自行尝试增删改查 观察数据库表与数据分布 图4-1-24-5 自行尝试增删改查 图4-1-24-6 观察数据库表与数据分布 二、分库分表(举例) Step1 新建ShardingModel2模型 ShardingModel2模型是用于分库分表测试的模型,我们选定userId作为分表字段。分库分表字段不允许更新,所以这里更新策略设置类永不更新,并在设置了在页面修改的时候为readonly package pro.shushi.pamirs.demo.api.model; import pro.shushi.pamirs.boot.base.ux.annotation.field.UxWidget; import pro.shushi.pamirs.boot.base.ux.annotation.view.UxForm; import…

    2024年5月23日
    1.5K00
  • 3.3.2 模型的类型

    本文会介绍不同类型模型以及其简单的应用场景,方便大家理解不同类型模型的用途 模型分为元模型和业务模型。元数据是指描述应用程序运行所必需的数据、规则和逻辑的数据集;元模型是指用于描述内核元数据的一套模式集合;业务模型是指用于描述业务应用元数据的一套模式集合。 元模型分为模块域、模型域和函数域三个域。域的划分规则是根据元模型定义数据关联关系的离散性来判断,离散程度越小越聚集到一个域。在4.1.4【模块元数据详解】一文中介绍的ModuleDefinition就是元模型。而我们在开发中涉及的就是业务模型 一、模型类型 抽象模型:往往是提供公共能力和字段的模型,它本身不会直接用于构建协议和基础设施(如表结构等)。 传输模型:用于表现层和应用层之间的数据交互,本身不会存储,没有默认的数据管理器,只有数据构造器。 存储模型:存储模型用于定义数据表结构和数据的增删改查(数据管理器)功能,是直接与连接器进行交互的数据容器。 代理模型:用于代理存储模型的数据管理器能力的同时,扩展出非存储数据信息的交互功能的模型。 二、模型定义种类 模型定义就是模型描述,不同定义类型,代表计算描述模型的元数据的规则不同 静态模型定义:模型元数据不持久化、不进行模型定义的计算(默认值、主键、继承、关联关系) 静态计算模型定义:模型元数据不持久化但初始化时进行模型定义计算获得最终的模型定义 动态模型定义:模型元数据持久化且初始化时进行模型定义计算获得最终的模型定义 静态模型定义需要使用@Model.Static进行注解;静态计算模型定义使用@Model.Static(compute=true)进行注解;动态模型定义不注解@Model.Static注解。 三、安装与更新 使用@Model.model来配置模型的不可变更编码。模型一旦安装,无法在对该模型编码值进行修改,之后的模型配置更新会依据该编码进行查找并更新;如果仍然修改该注解的配置值,则系统会将该模型识别为新模型,存储模型会创建新的数据库表,而原表将会rename为废弃表。 如果模型配置了@Base注解,表明在【oinone的设计器】中该模型配置不可变更;如果字段配置了@Base注解,表明在【oinone的设计器】中该字段配置不可变更。 四、基础配置 模型基类 所有的模型都需要继承以下模型中的一种,来表明模型的类型,同时继承以下模型的默认数据管理器(详见3.3.3模型的数据管理器一节)。 继承BaseModel,构建存储模型,默认无id属性。 继承BaseRelation,构建多对多关系模型,默认无id属性。 继承TransientModel,构建临时模型(传输模型),临时模型没有数据管理器,也没有id属性。 继承EnhanceModel,构建数据源为ElasticSearch的增强模型。 快捷继承 继承IdModel,构建主键为id的模型。继承IdModel的模型会数据管理器会增加queryById方法(根据id查询单条记录) 继承CodeModel,构建带有唯一编码code的主键为id的模型。可以使用@Model.Code注解配置编码生成规则。也可以直接覆盖CodeModel的generateCode方法或者自定义新增的前置扩展点自定义编码生成逻辑。继承CodeModel的模型会数据管理器会增加queryByCode方法(根据唯一编码查询单条记录) 继承VersionModel,构建带有乐观锁,唯一编码code且主键为id的模型。 继承IdRelation,构建主键为id的多对多关系模型。 模型继承关系图 图3-3-2-1 模型继承关系图 AbstractModel抽象基类是包含createDate创建时间、writeDate更新时间、createUid创建用户ID、writeUid更新用户ID、aggs聚合结果和activePks批量主键列表等基础字段的抽象模型。 TransientModel传输模型抽象基类是所有传输模型的基类,传输模型不存储,没有数据管理器。 TransientRelation传输关系模型是所有传输关系模型的基类,传输关系模型不存储,用于承载多对多关系,没有数据管理器。 BaseModel存储模型基类提供数据管理器功能,数据模型主键可以不是ID。 IdModel带id模型抽象基类,在BaseModel数据管理器基础之上提供根据ID查询、更新、删除数据的功能。 BaseRelation关系模型抽象基类用于承载多对多关系,是多对多关系的中间模型,数据模型主键可以不是ID。 IdRelation带id关系模型抽象基类,在BaseRelation数据管理器基础之上提供根据ID查询、更新、删除数据的功能。 CodeModel带code模型抽象基类,提供按配置生成业务唯一编码功能,根据code查询、更新、删除数据的功能。 EnhanceModel增强模型,提供全文检索能力。此模型会在4.1.25【框架之搜索引擎】一文中展开介绍。 五、抽象模型(举例) 抽象模型本身不会直接用于构建协议和基础设施(如表结构等),而是通过继承的机制供子模型复用其字段和函数。子模型可以是所有类型的模型。 比如demo模块要管理的一些公共模型字段,我们可以建一个AbstractDemoIdModel和AbstractDemoCodeModel,demo模块中的实体模型就可以继承它们。我们来为demo模块的模型统一增加一个数据状态这么一个字段,用做数据的生效与失效管理。 Step1 引入DataStatusEnum类 pamirs-demo-api的pom.xml包增加依赖,便于引入DataStatusEnum类,当然也可以自己建,这里只是oinone提供了统一的数据记录状态的枚举,以及相应的通用方法,这边就直接引入 <dependency> <groupId>pro.shushi.pamirs.core</groupId> <artifactId>pamirs-core-common</artifactId> </dependency> 图3-3-2-2 引入通用类库 Step2 修改DemoModule DataStatusEnum枚举类本身也会做为数据字典,以元数据的方式被管理起来,当一个模块依赖另一个模块的元数据相关对象,则需要改模块的模块依赖定义。为DemoModule增加CommonModule的依赖注解 package pro.shushi.pamirs.demo.api; import org.springframework.stereotype.Component; import pro.shushi.pamirs.boot.base.ux.annotation.action.UxRoute; import pro.shushi.pamirs.boot.base.ux.annotation.navigator.UxHomepage; import pro.shushi.pamirs.core.common.CommonModule; import pro.shushi.pamirs.demo.api.model.PetShop; import pro.shushi.pamirs.meta.annotation.Module; import pro.shushi.pamirs.meta.base.PamirsModule; import pro.shushi.pamirs.meta.common.constants.ModuleConstants; @Component @Module( name = DemoModule.MODULE_NAME, displayName = "oinoneDemo工程", version = "1.0.0", dependencies = {ModuleConstants.MODULE_BASE, CommonModule.MODULE_MODULE} ) @Module.module(DemoModule.MODULE_MODULE) @Module.Advanced(selfBuilt = true, application = true) @UxHomepage(@UxRoute(PetShop.MODEL_MODEL)) public class DemoModule implements PamirsModule { public static final String MODULE_MODULE = "demo_core"; public static final String MODULE_NAME = "DemoCore"; @Override public String[] packagePrefix() { return new String[]{ "pro.shushi.pamirs.demo"}; } } 图3-3-2-3 定义模块依赖 Step3 新建AbstractDemoCodeModel和AbstractDemoIdModel 并新增AbstractDemoIdModel和AbstractDemoCodeModel分别继承IdModel和CodeModel,实现IDataStatus接口不是必须的,刚好DataStatus有配套的通用逻辑,暂时也先加进去,具体使用会在本文的【代理模型】这段介绍 package pro.shushi.pamirs.demo.api.model; import pro.shushi.pamirs.core.common.behavior.IDataStatus; import pro.shushi.pamirs.core.common.enmu.DataStatusEnum; import pro.shushi.pamirs.meta.annotation.Field; import pro.shushi.pamirs.meta.annotation.Model; import pro.shushi.pamirs.meta.annotation.sys.Base; import pro.shushi.pamirs.meta.base.common.CodeModel; import pro.shushi.pamirs.meta.enmu.ModelTypeEnum; @Base @Model.model(AbstractDemoCodeModel.MODEL_MODEL) @Model.Advanced(type = ModelTypeEnum.ABSTRACT) @Model(displayName = "AbstractDemoCodeModel") public abstract class AbstractDemoCodeModel extends CodeModel implements IDataStatus { public static final String MODEL_MODEL="demo.AbstractDemoCodeModel"; @Base @Field.Enum @Field(displayName = "数据状态",defaultValue = "DISABLED",required =…

    2024年5月23日
    2.1K00
  • 4.1.21 框架之分布式消息

    消息中间件是在分布式开发中常见的一种技术手段,用于模块间的解耦、异步处理、数据最终一致等场景。 一、介绍 oinone对开源的RocketMQ进行了封装,是平台提供的一种较为简单的使用方式,并非是对RocketMQ进行的功能扩展。同时也伴随着两个非常至关重要的目的: 适配不同企业对RocketMQ的不同版本选择,不至于改上层业务代码。目前已经适配RocketMQ的开源版本和阿里云版本。 下个版本会对API进行升级支持不同类型MQ,以适配不同企业对MQ的不同要求,应对一些企业客户已经对MQ进行技术选择 对协议头进行扩展:如多租户的封装,saas模式中为了共用MQ基础资源,需要在消息头中加入必要租户信息。 二、使用准备 demo工程默认已经依赖消息,这里只是做介绍无需大家额外操作,大家可以用maven依赖树命令查看引用关系。 依赖包 增加对pamirs-connectors-event的依赖 <dependency> <groupId>pro.shushi.pamirs.framework</groupId> <artifactId>pamirs-connectors-event</artifactId> </dependency> 图4-1-21-1 分布式消息的依赖包 相关功能引入 增加模型、触发器都依赖MQ <!– 增强模型 –> <!– 增强模型 –> <dependency> <groupId>pro.shushi.pamirs.core</groupId> <artifactId>pamirs-channel</artifactId> </dependency> <!– 触发器 api –> <dependency> <groupId>pro.shushi.pamirs.core</groupId> <artifactId>pamirs-trigger-api</artifactId> </dependency> <!– 触发器 core –> <dependency> <groupId>pro.shushi.pamirs.core</groupId> <artifactId>pamirs-trigger-core</artifactId> </dependency> 图4-1-21-2 增加模型、触发器都依赖MQ yml配置文件参考 详见4.1.1【模块之yml文件结构详解】的“pamirs.event”部分。 三、使用说明 发送消息(NotifyProducer) 概述 NotifyProducer是Pamirs Event中所有生产者的基本API,它仅仅定义了消息发送的基本行为,例如生产者自身的属性,启动和停止,当前状态,以及消息发送方法。它本身并不决定消息如何发送,而是根据具体的实现确定其功能。 目前仅实现了RocketMQProducer,你可以使用下面介绍的方法轻松使用这些功能。 使用方法 Notify注解方式 使用示例 @Component public class DemoProducer { @Notify(topic = "test", tags = "model") public DemoModel sendModel() { return new DemoModel(); } @Notify(topic = "test", tags = "dto") public DemoDTO sendDTO() { return new DemoDTO(); } } 图4-1-21-3 Notify注解方式使用示例 解释说明 使用Component注解方式注册Spring Bean。 Notify注解指定topic和tags。 topic和tags对应NotifyEvent中的topic和tags。 RocketMQProducer方法调用 使用示例 @Component public class SendRocketMQMessage { @Autowired private RocketMQProducer rocketMQProducer; /** * 发送普通消息 */ public void sendNormalMessage() { rocketMQProducer.send(new NotifyEvent("test", "model", new DemoModel())); rocketMQProducer.send(new NotifyEvent("test", "dto", new DemoDTO())); } /** * 发送有序消息 */ public void sendOrderlyMessage() { DemoModel data = new DemoModel(); data.setAge(10); rocketMQProducer.send(new NotifyEvent("test", "model", data) .setQueueSelector((queueSize, event) -> { DemoModel body = (DemoModel) event.getBody(); return body.getAge() % queueSize; })); } /** * 发送事务消息 */ public void sendTransactionMessage() { rocketMQProducer.send(new NotifyEvent("test", "model", new DemoModel()) .setIsTransaction(true) .setGroup("demoTransactionListener")); } } 图4-1-21-4 RocketMQProducer方法调用…

    2024年5月23日
    1.3K00
  • 5.8 商业支撑之执行域

    一、基础介绍 执行域包括两个核心一是订单的产生,二是订单的履约。往往品牌商既有自营渠道(包括2c、2b)、又有第三方渠道。那么有两种设计思路: 把第三方渠道的订单当作自有渠道的订单产生一种特殊方式,开放订单创建接口,并统一履约。 好处:简单,在3方渠道不多、且自有渠道单一,并且逻辑相识时系统结构会简单 坏处: 当3方渠道的履约方式、库存分配方式、逆向逻辑等有差异时,会让自有渠道参杂很多不相干的逻辑引入不必要的复杂度 自有渠道不够独立和纯粹,自有渠道多样化时难以支撑 把商家自营渠道假设为特殊的第三方渠道,再建立统一的订单管理系统来对接渠道订单,并完成履约 好处:交易与履约逻辑分离,对未来发展有扩展性 坏处:引入一定复杂度 我们采用的是第二套方案,整体结构简易图如下 图5-8-1 方案整体结构简易图 二、模型介绍 图5-8-2 模型介绍 核心设计逻辑 首先我们看到上图交易域和履约域有很多相同父模型的子模型,交易域和履约域的父模型在CDM的在himalaya-trade里。履约域看oms(libra)对himalaya-trade扩展,交易域看b2c(leo)和b2b(aries)对对himalaya-trade扩展。libra、leo、aries是我们对上层业务产品的命名,取自黄道十二星座 交易域是多商家平台视角设计,有自身渠道必要的履约相关信息,完成自闭环。 履约域是从单一商家对接多渠道视角设计,有渠道交易订单同步后完成履约发货相关设计,完成自闭环。 履约域的合单拆单发货设计,渠道订单只能合单为履约单不可拆,履约单可以拆单发货不可合。用m2o和o2m的组合设计来降低难度,而非采用两个m2m的设计。

    2024年5月23日
    1.3K00

Leave a Reply

Please Login to Comment