工作流

1. 查看、处理流程

1.1 流程查看

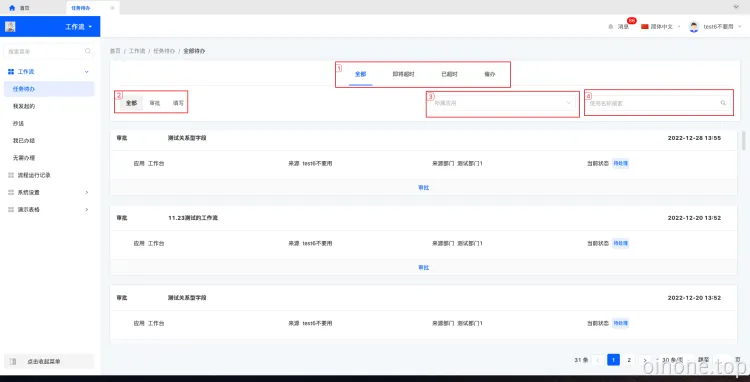
流程管理页面共同点:

  1. 选项分类筛选

  2. 标签筛选

  3. 应用下拉选筛选

  4. 根据流程名称搜索

image.png

  • 流程管理页面名词解释:
  1. 任务待办:当前登录用户未处理的流程节点

  2. 我发起的:当前登录用户人为触发的流程(模型触发)

  3. 抄送:抄送给当前登录用户的节点(审批/填写)

  4. 我已办结:由当前登录用户完成人工/自动同意、人工拒绝或人工填写的节点

  5. 无需办理:当前登录用户转交的任务/被退回、被撤销、被或签、被其他分支任务拒绝的还未办理的任务

1.2 流程处理

1.2.1 任务待办

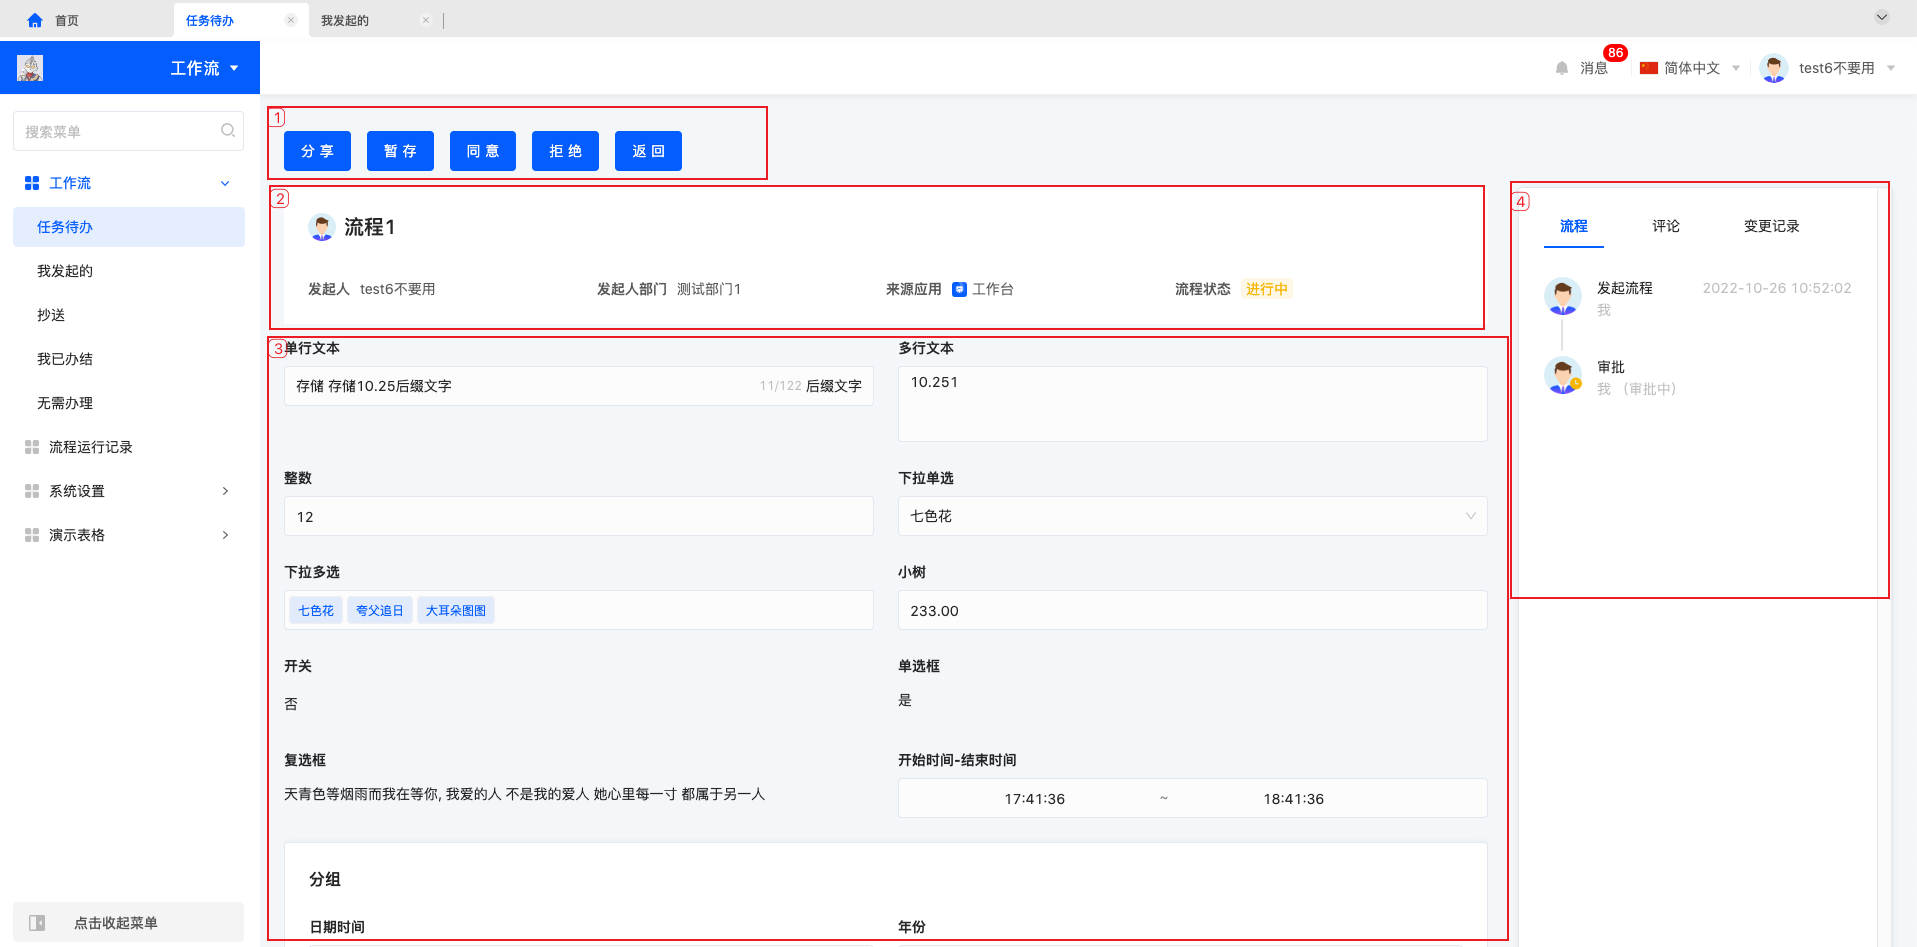
任务待办中点击“审批/填写”会进入流程详情处理页面,主要展示 1. 操作区 2. 流程发起人及状态 3. 模型视图内容 4. 流程时间线及其他记录。

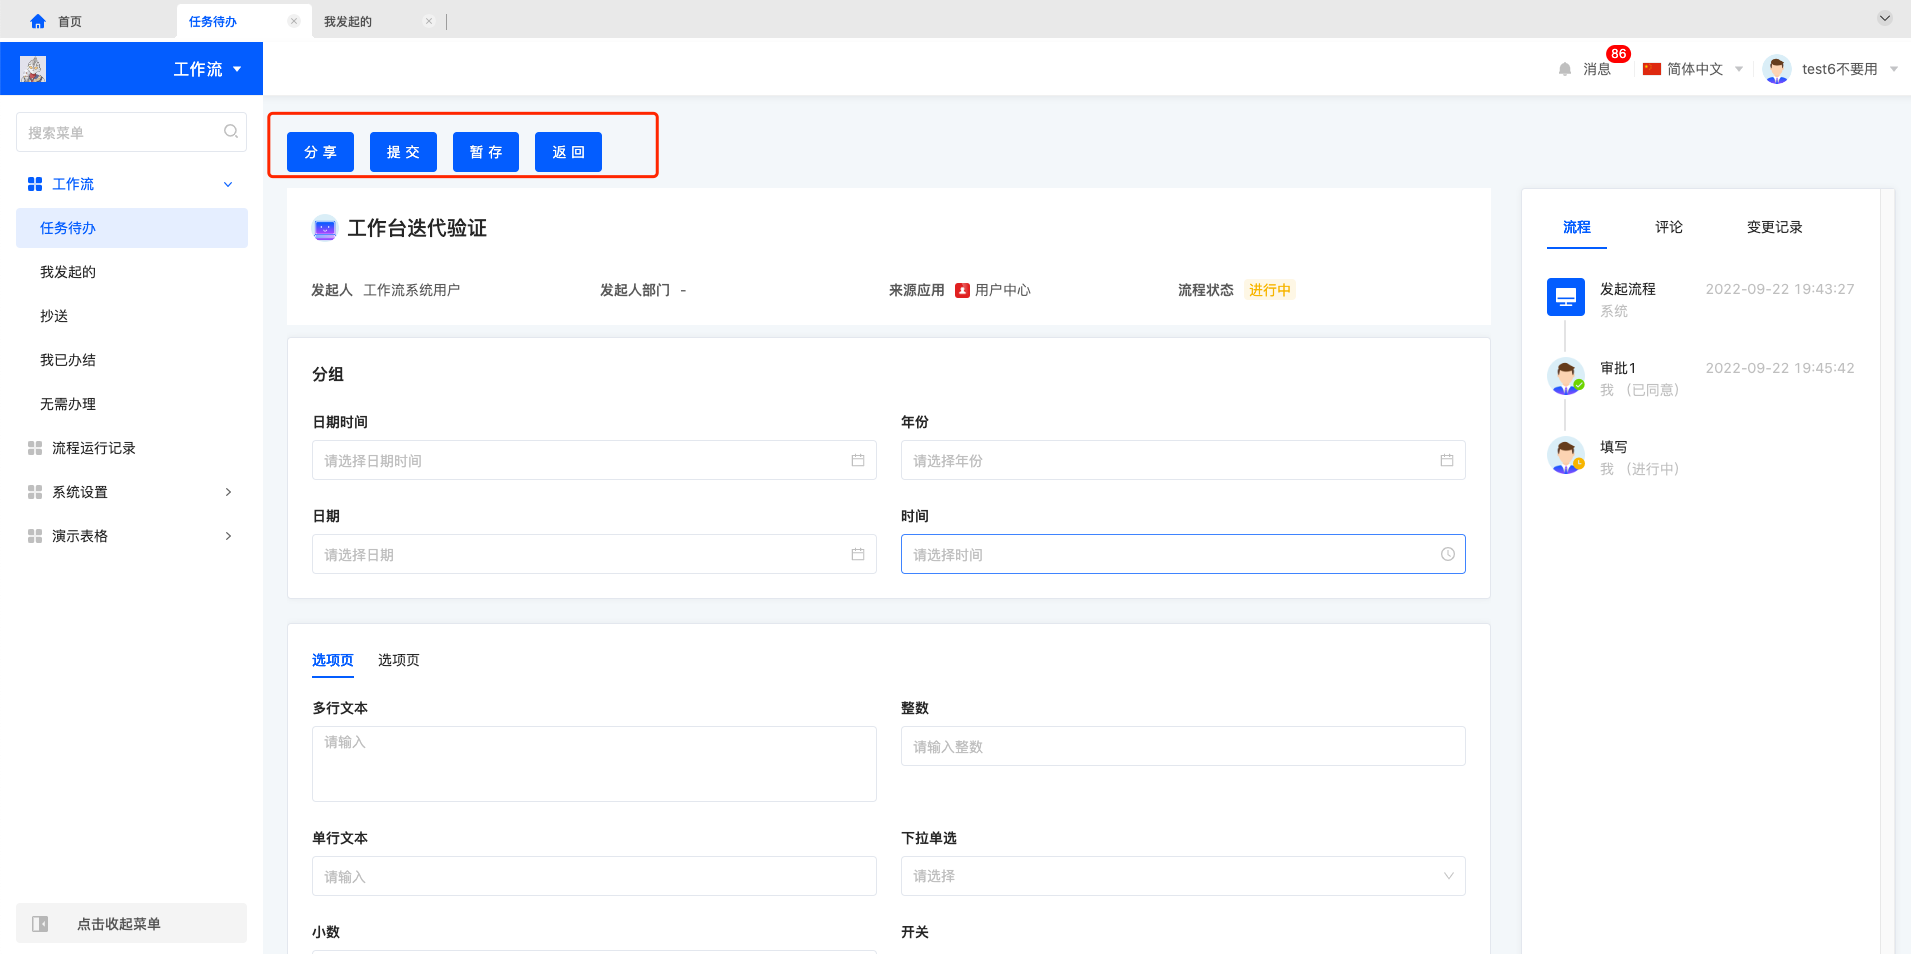
审批代办操作区可能包含“分享、同意、拒绝、退回、加签、转交、返回”,填写代办操作区可能包含“分享、转交、提交、暂存、返回”,审批/填写操作区包含哪些动作由流程设计决定。
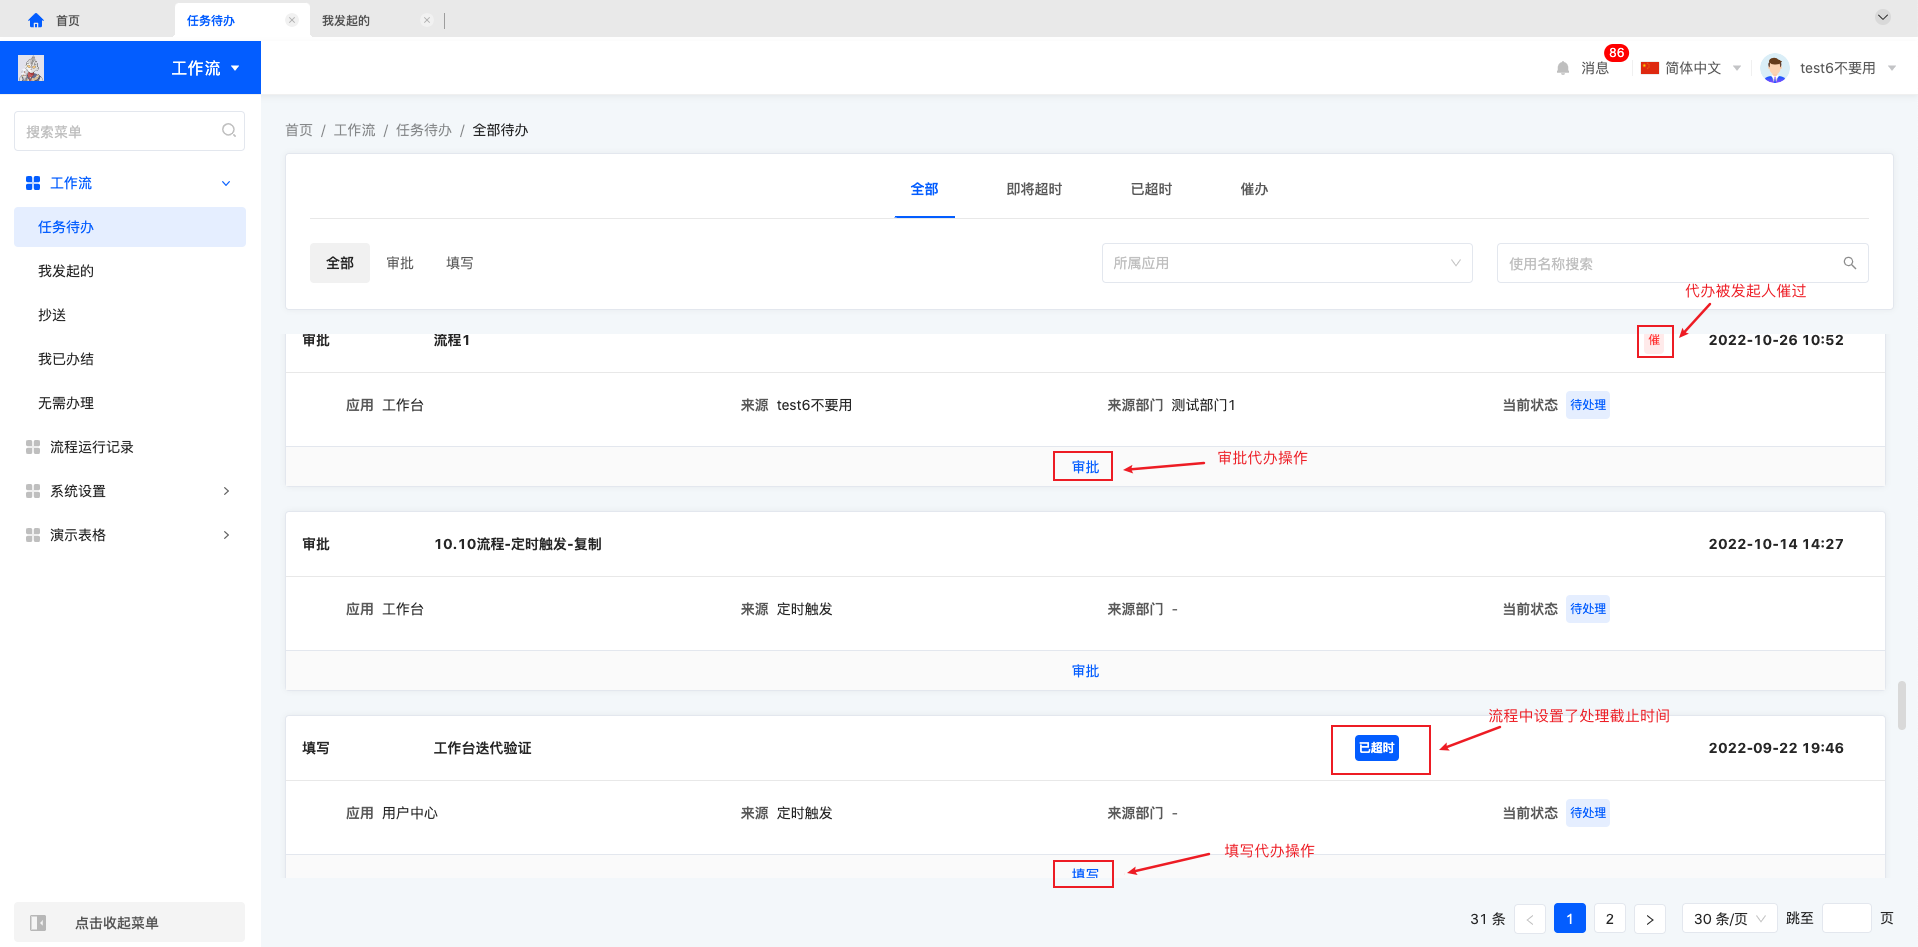
image.png

image.png

image.png

1.2.2 我发起的

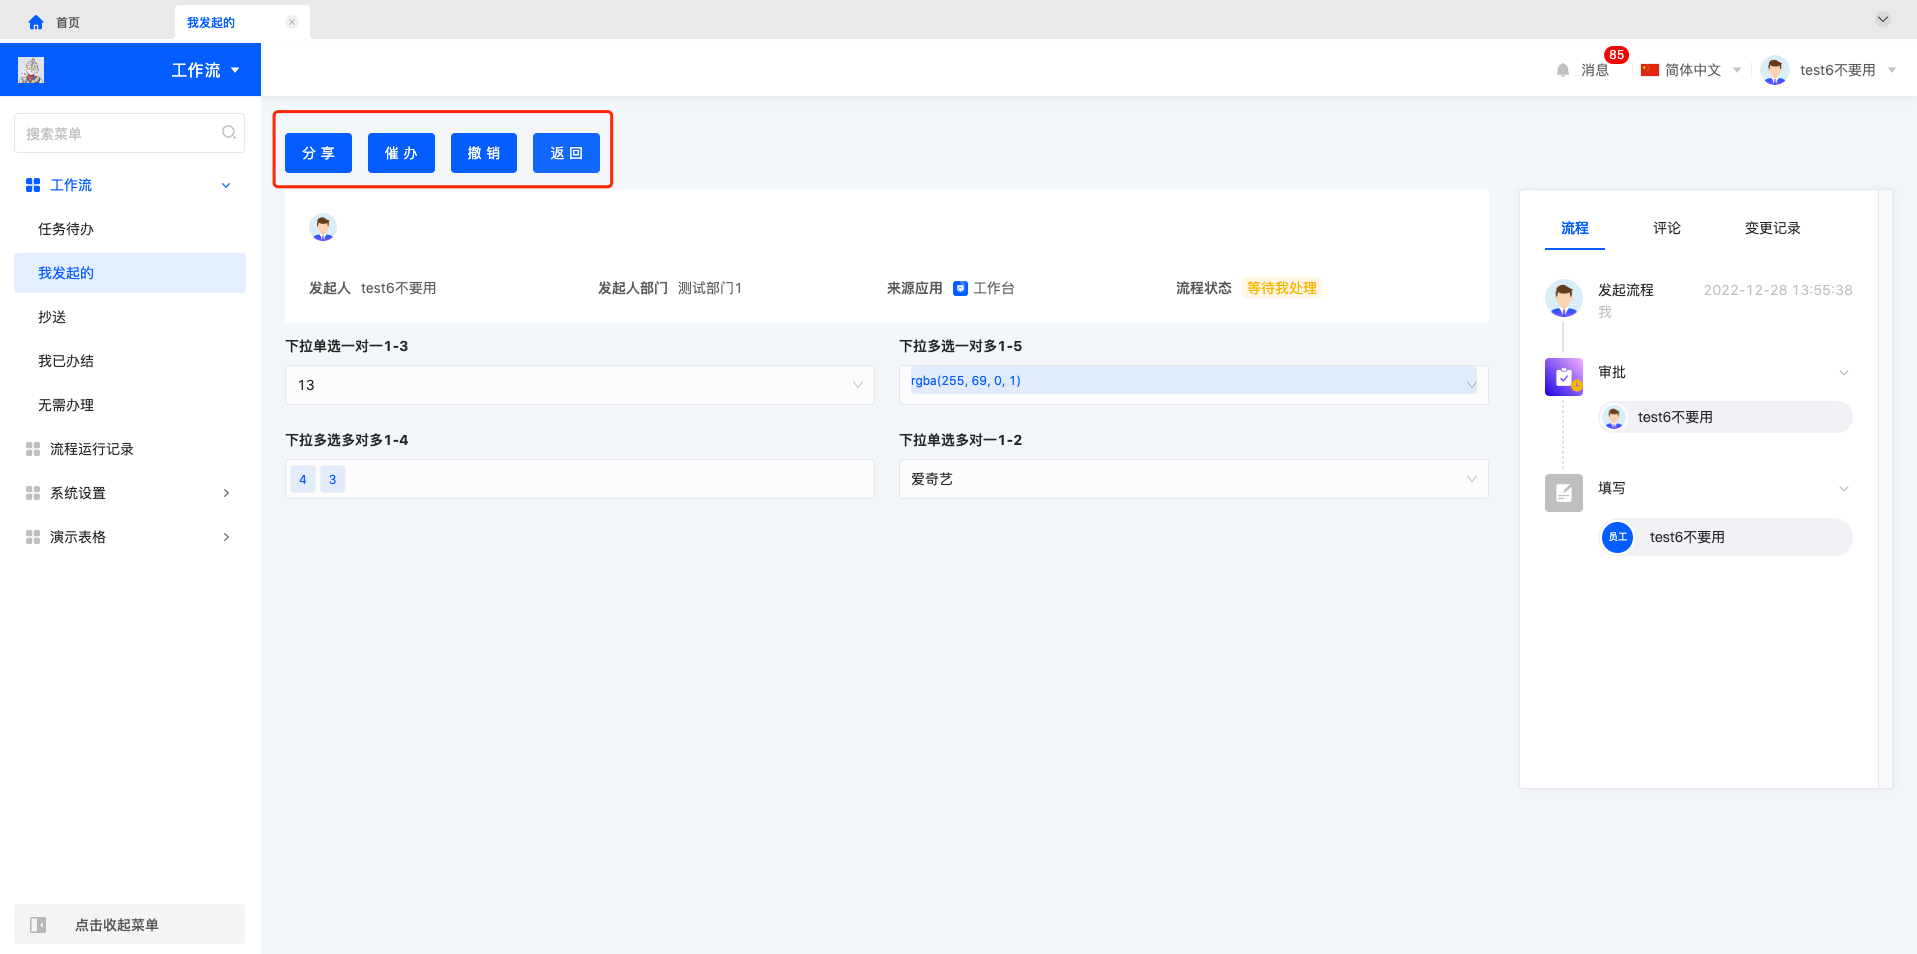
我发起的流程列表中主要分为进行中和已完成的流程。进行中的流程可以进行查看、催办、撤销的操作,已完成的流程可以进行查看操作。

查看我发起的流程,进入流程详情页面,也是根据流程状态展示对应操作功能,进行中的流程有分享、催办、撤销、返回按钮,已完成的流程有分享、返回按钮。
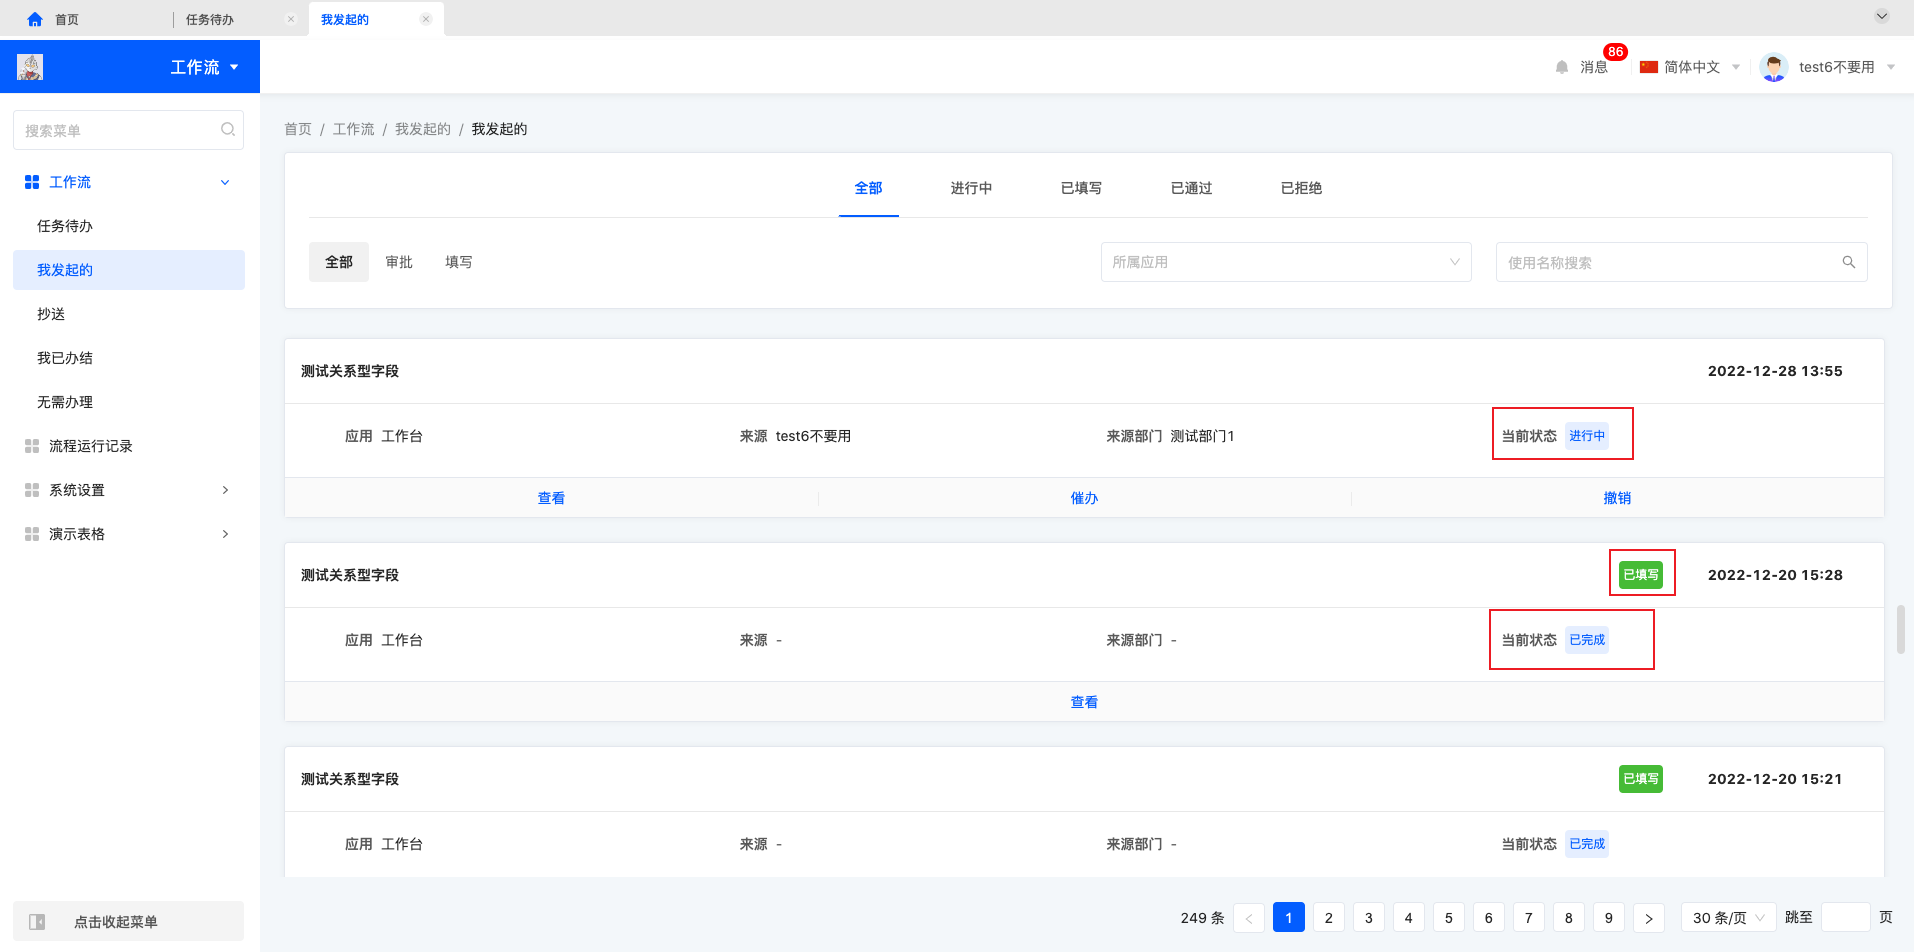
image.png

image.png

image.png

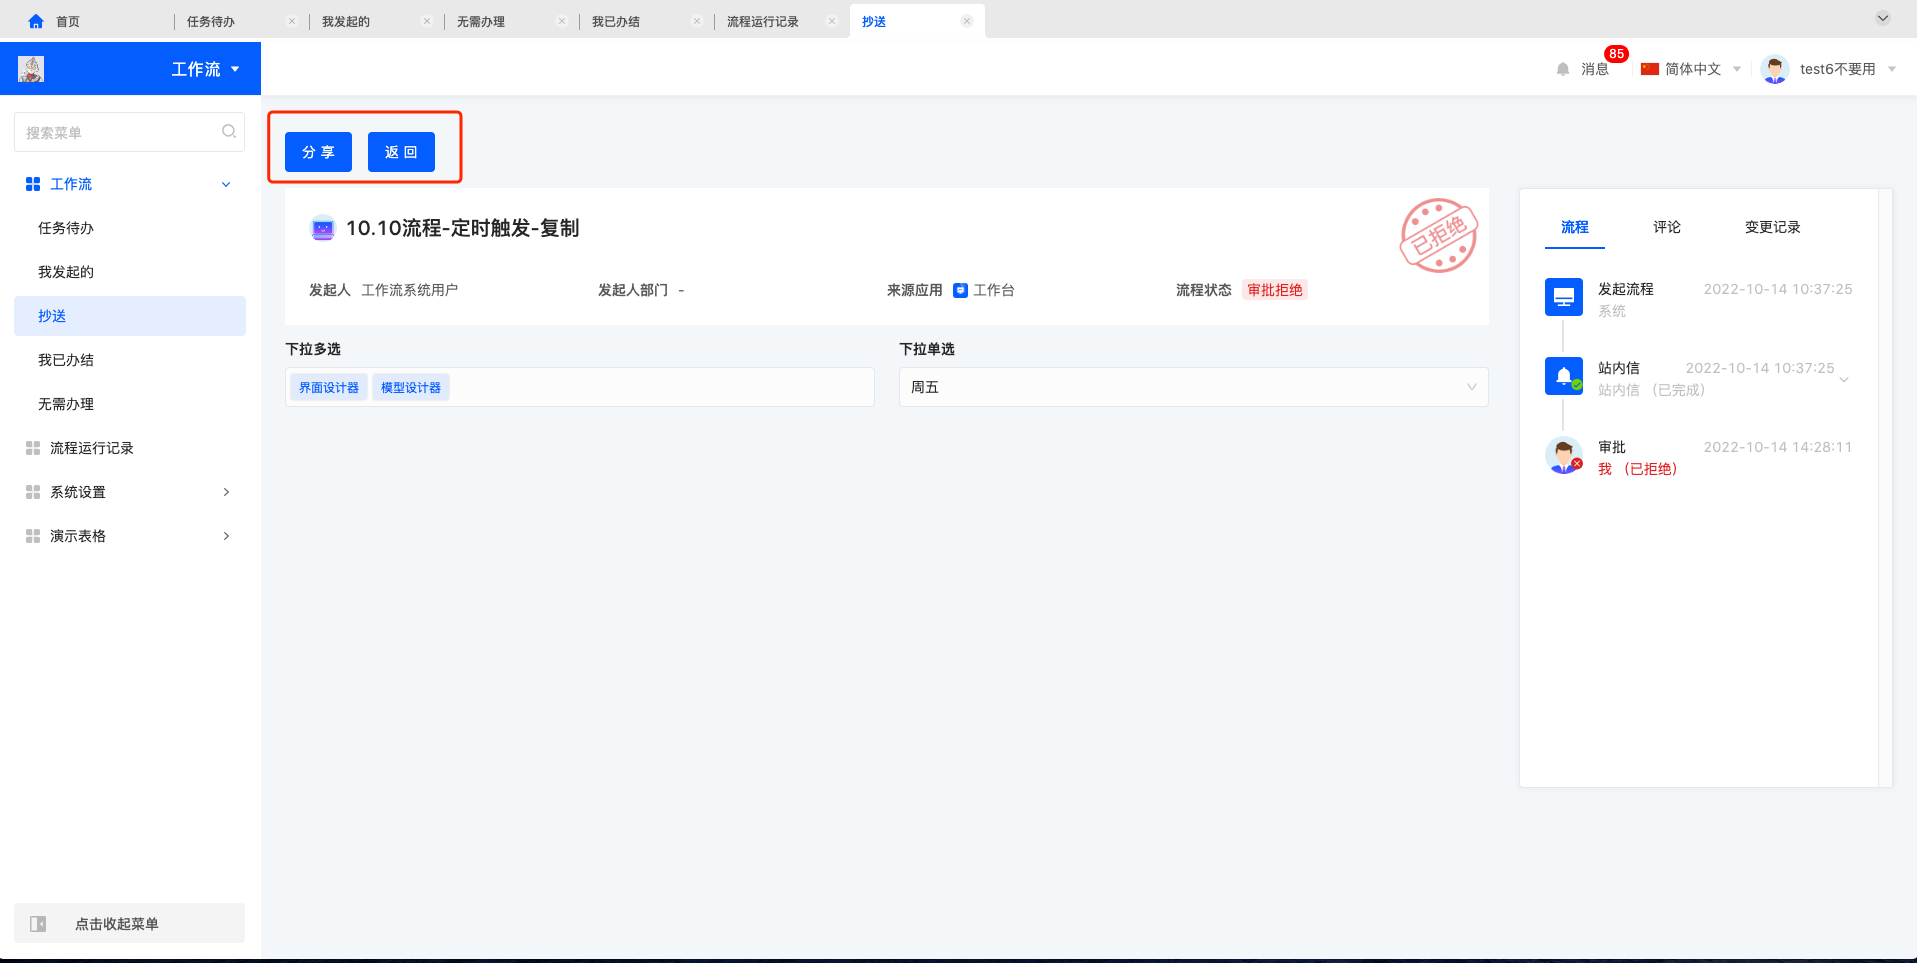
1.2.3 抄送

抄送列表中每条抄送只可以进行查看操作,查看进入流程的详情页面,有分享和返回的操作。
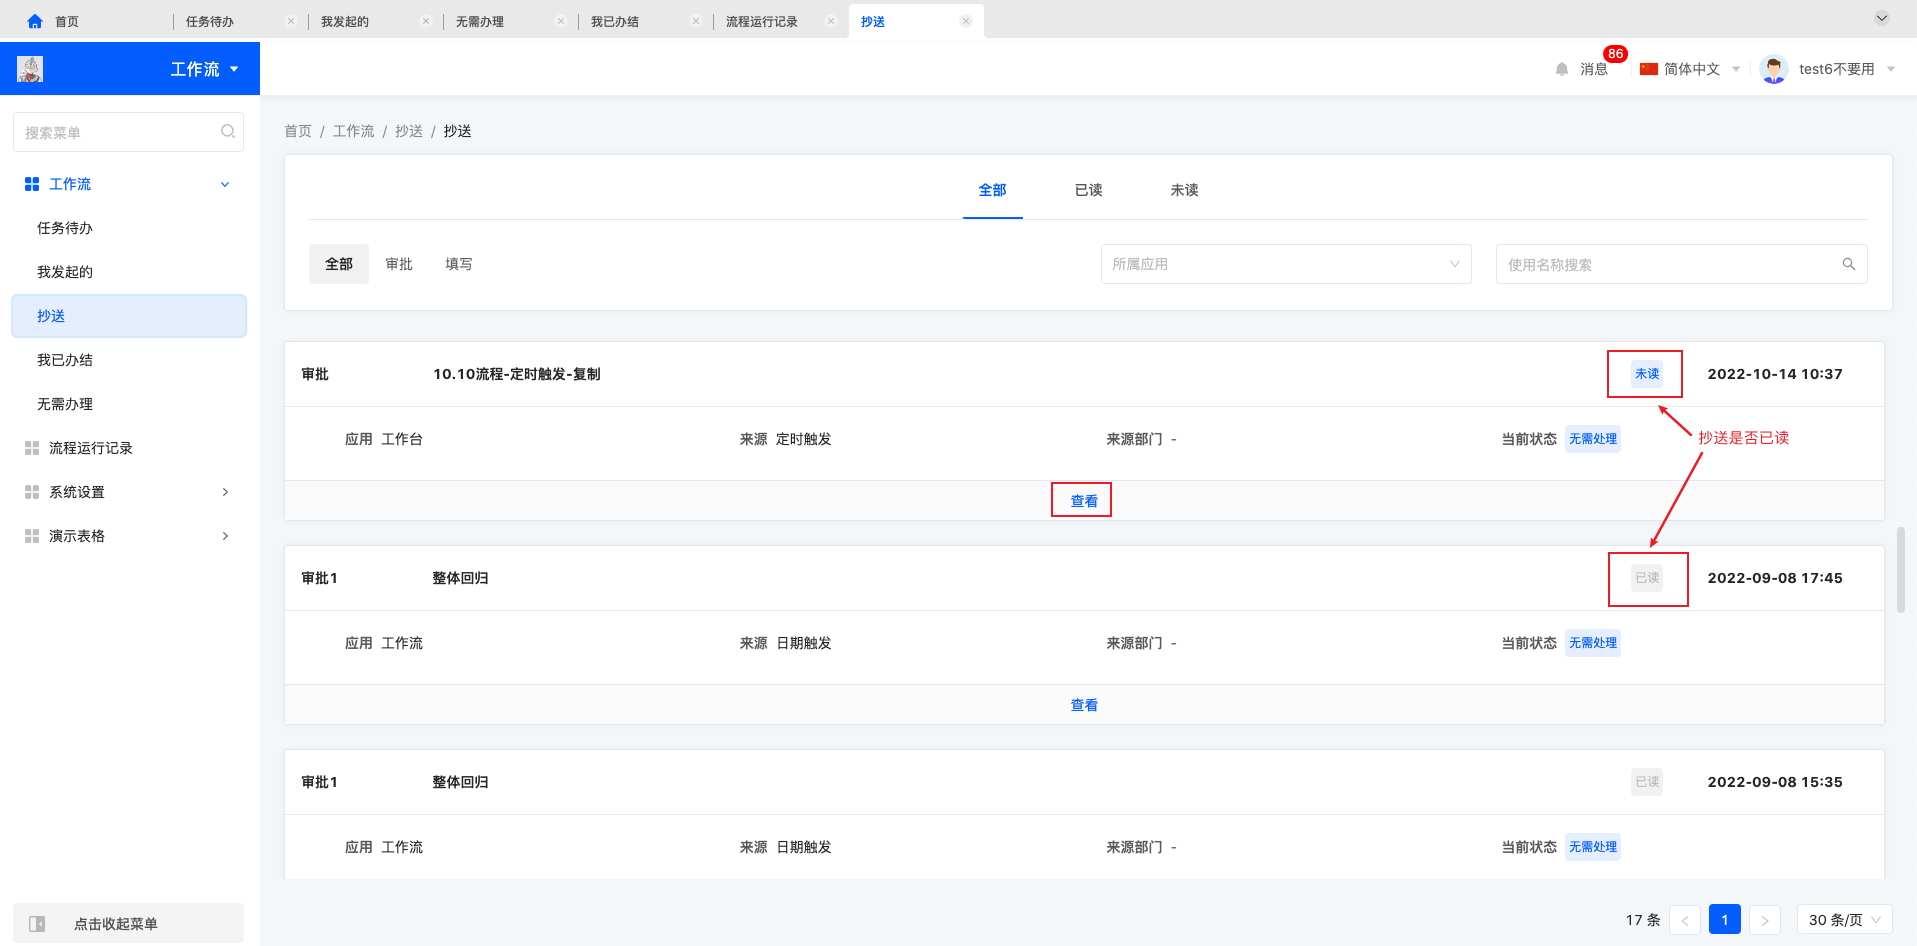
image.png

image.png

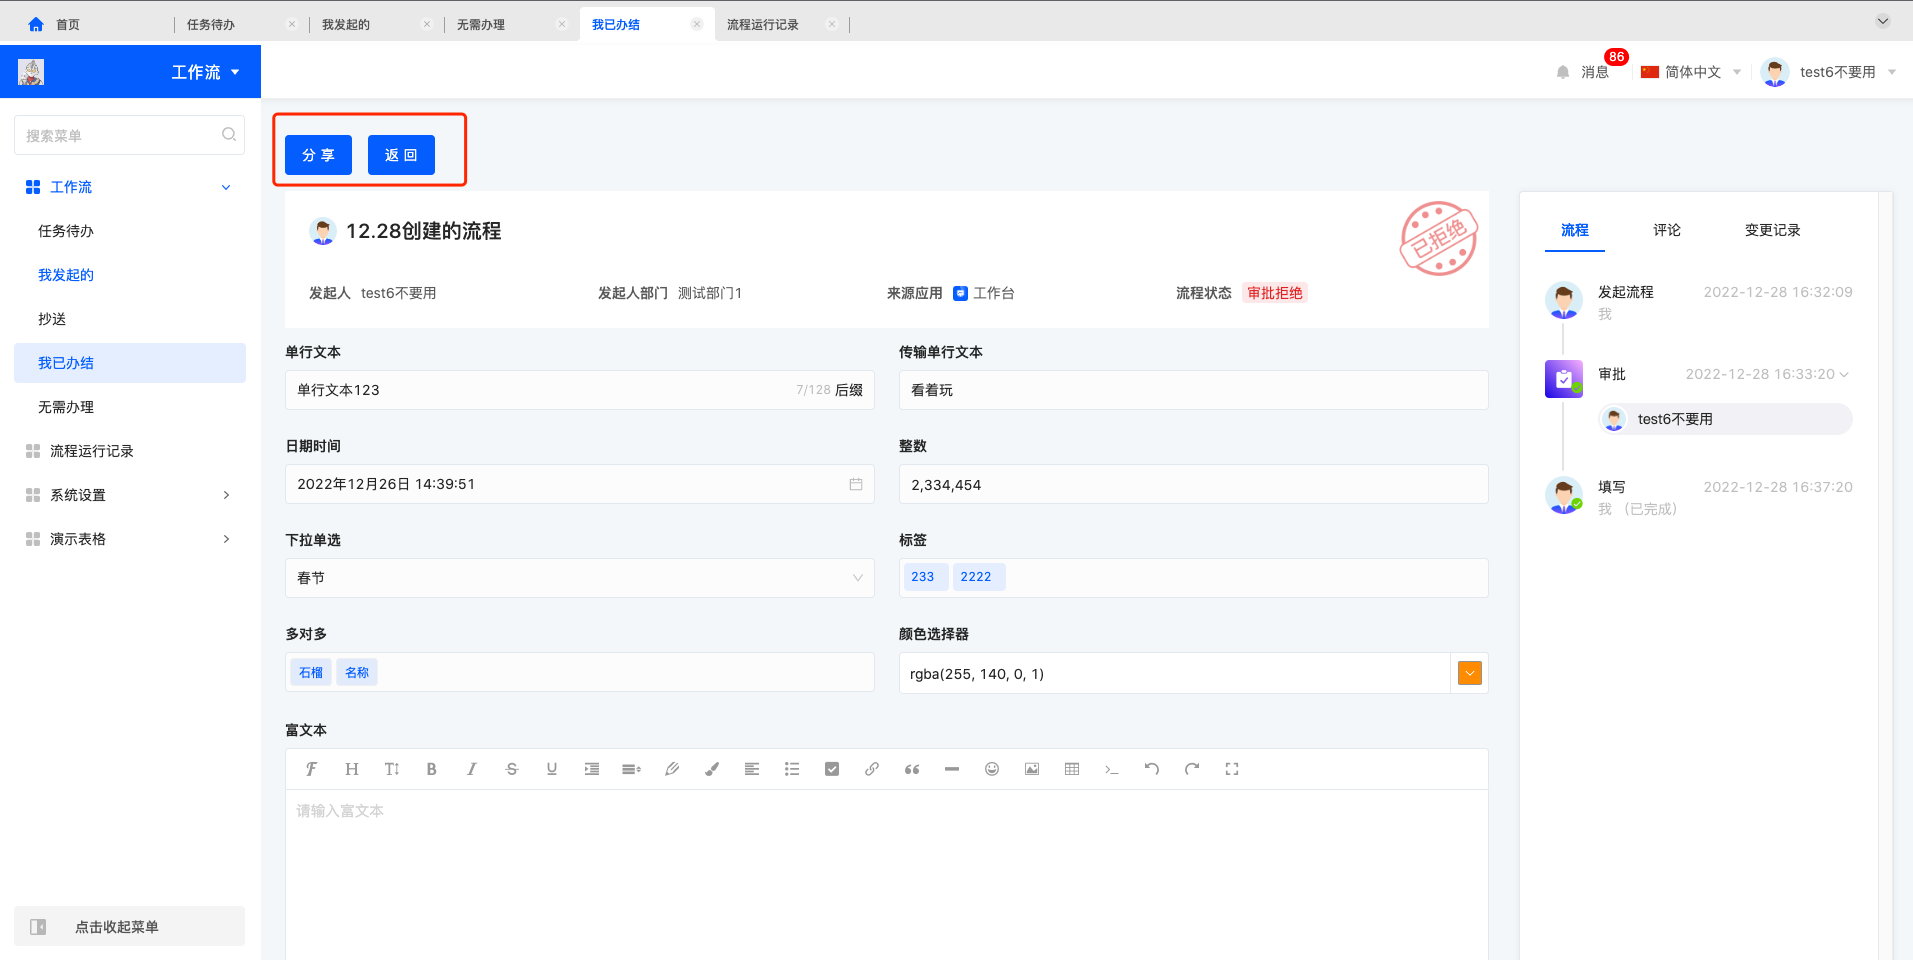
1.2.4 我已办结

我已办结列表中可以进行查看操作,查看进入代办的详情页面,可以进行分享和返回的操作。
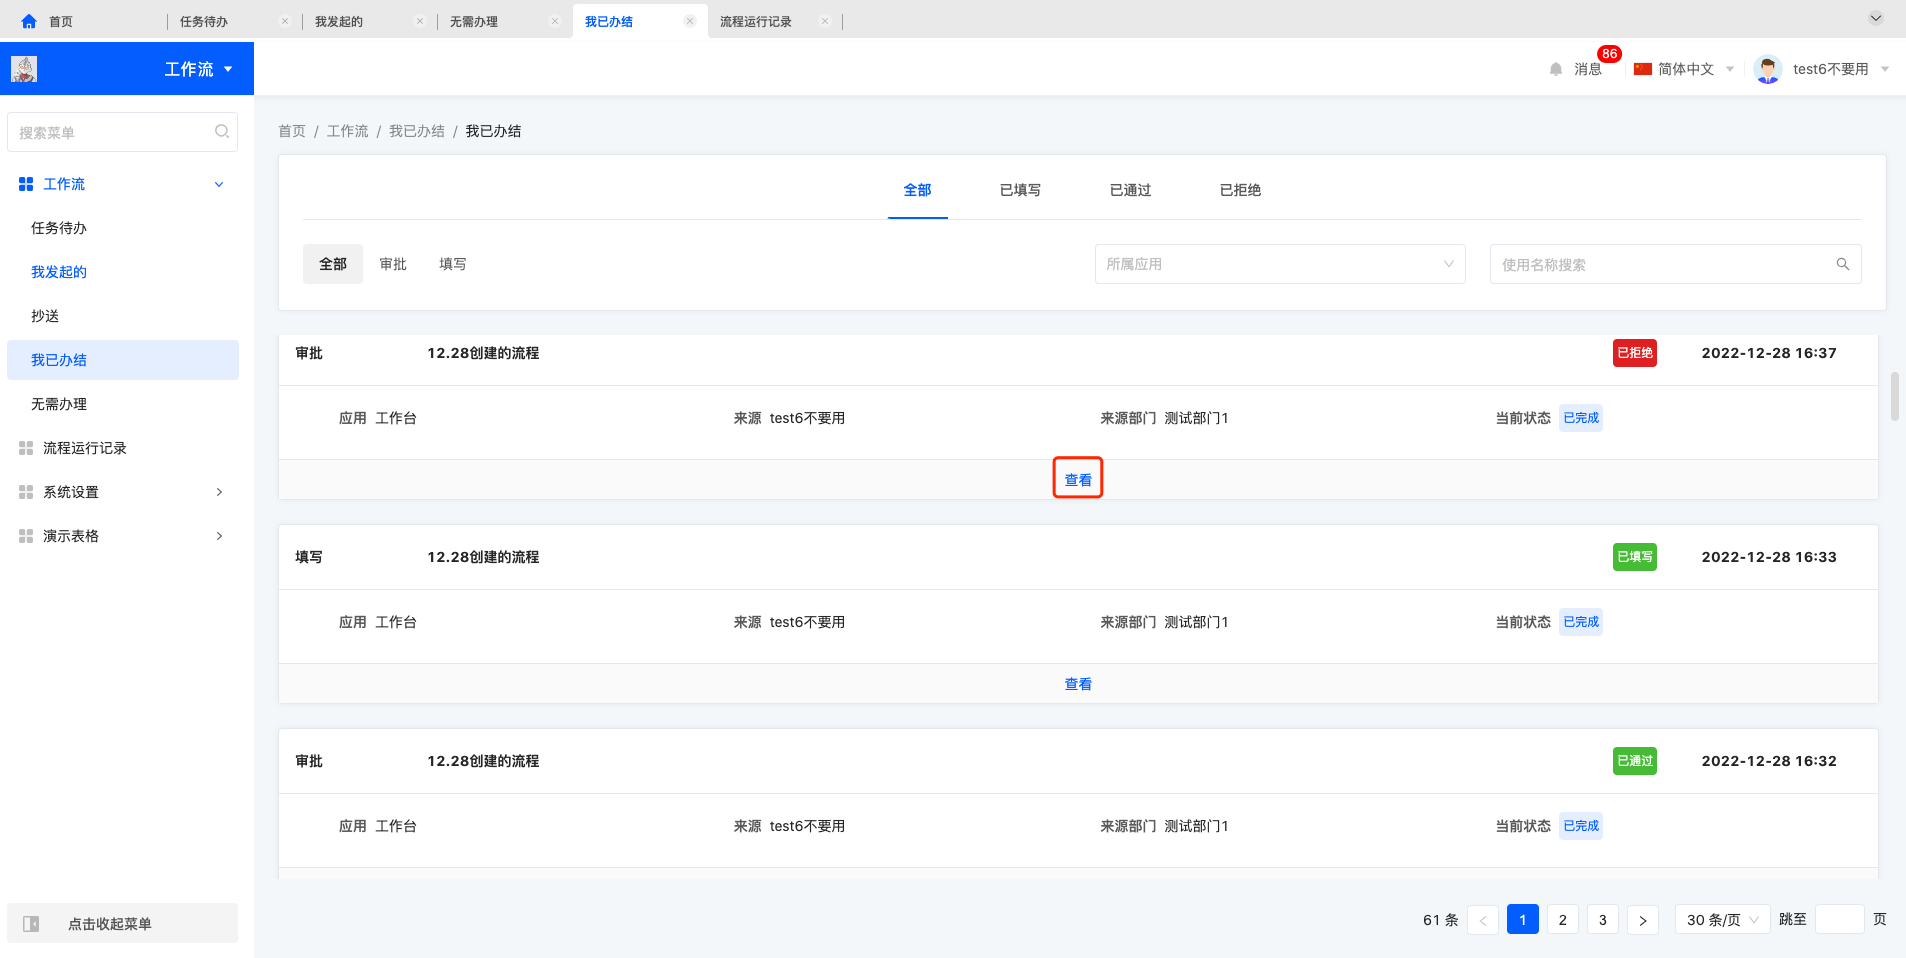
image.png

image.png

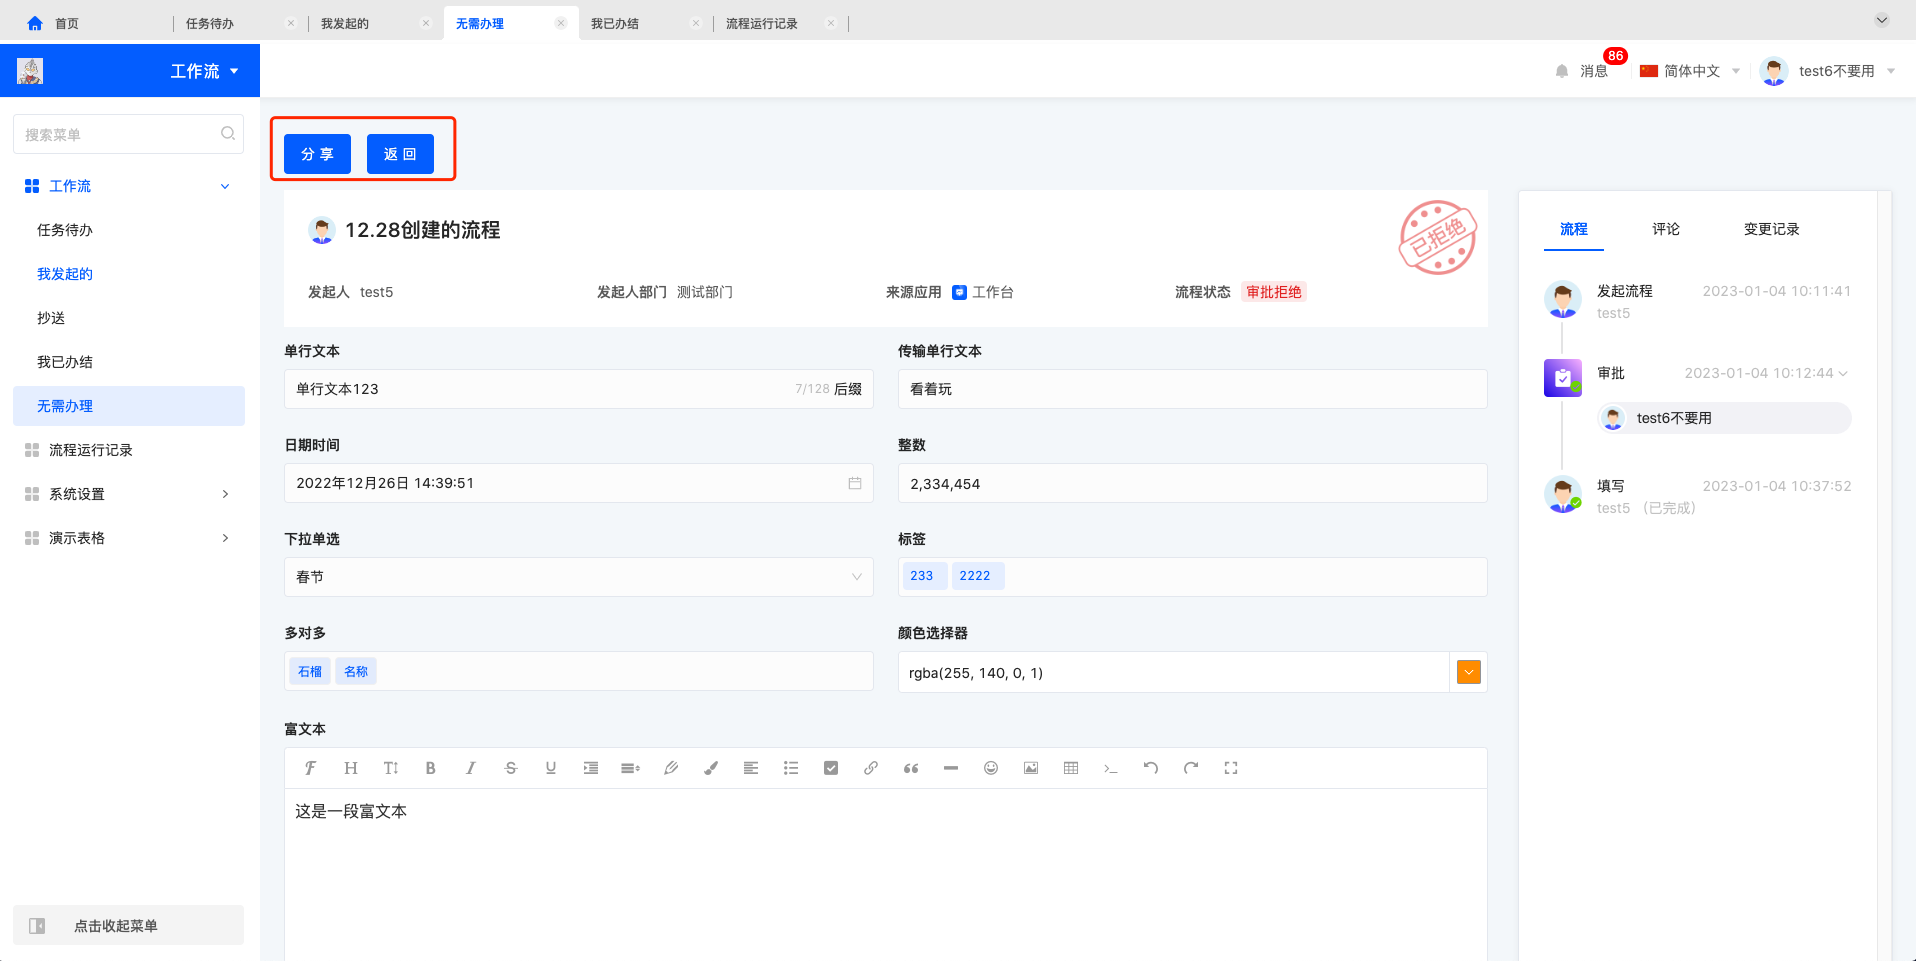
1.2.5 无需办理

无需办理列表中可以进行查看操作,查看进入代办的详情页面,可以进行分享和返回的操作。
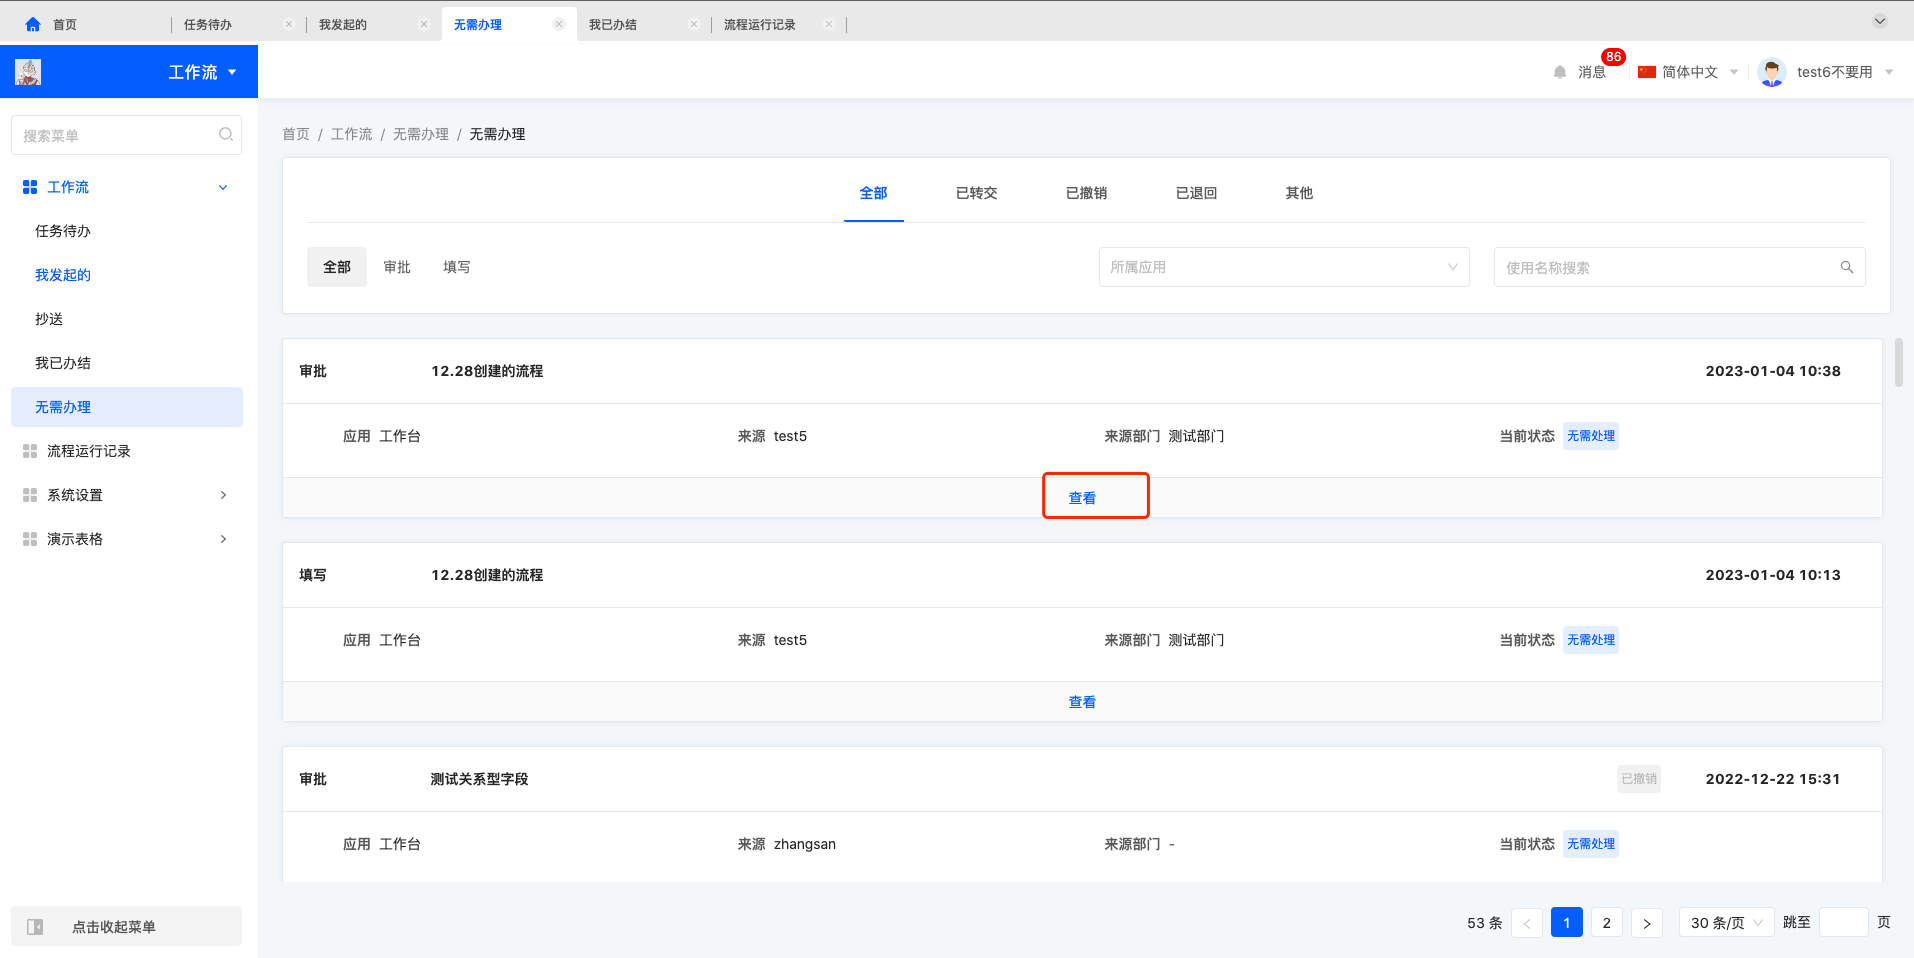
image.png

image.png

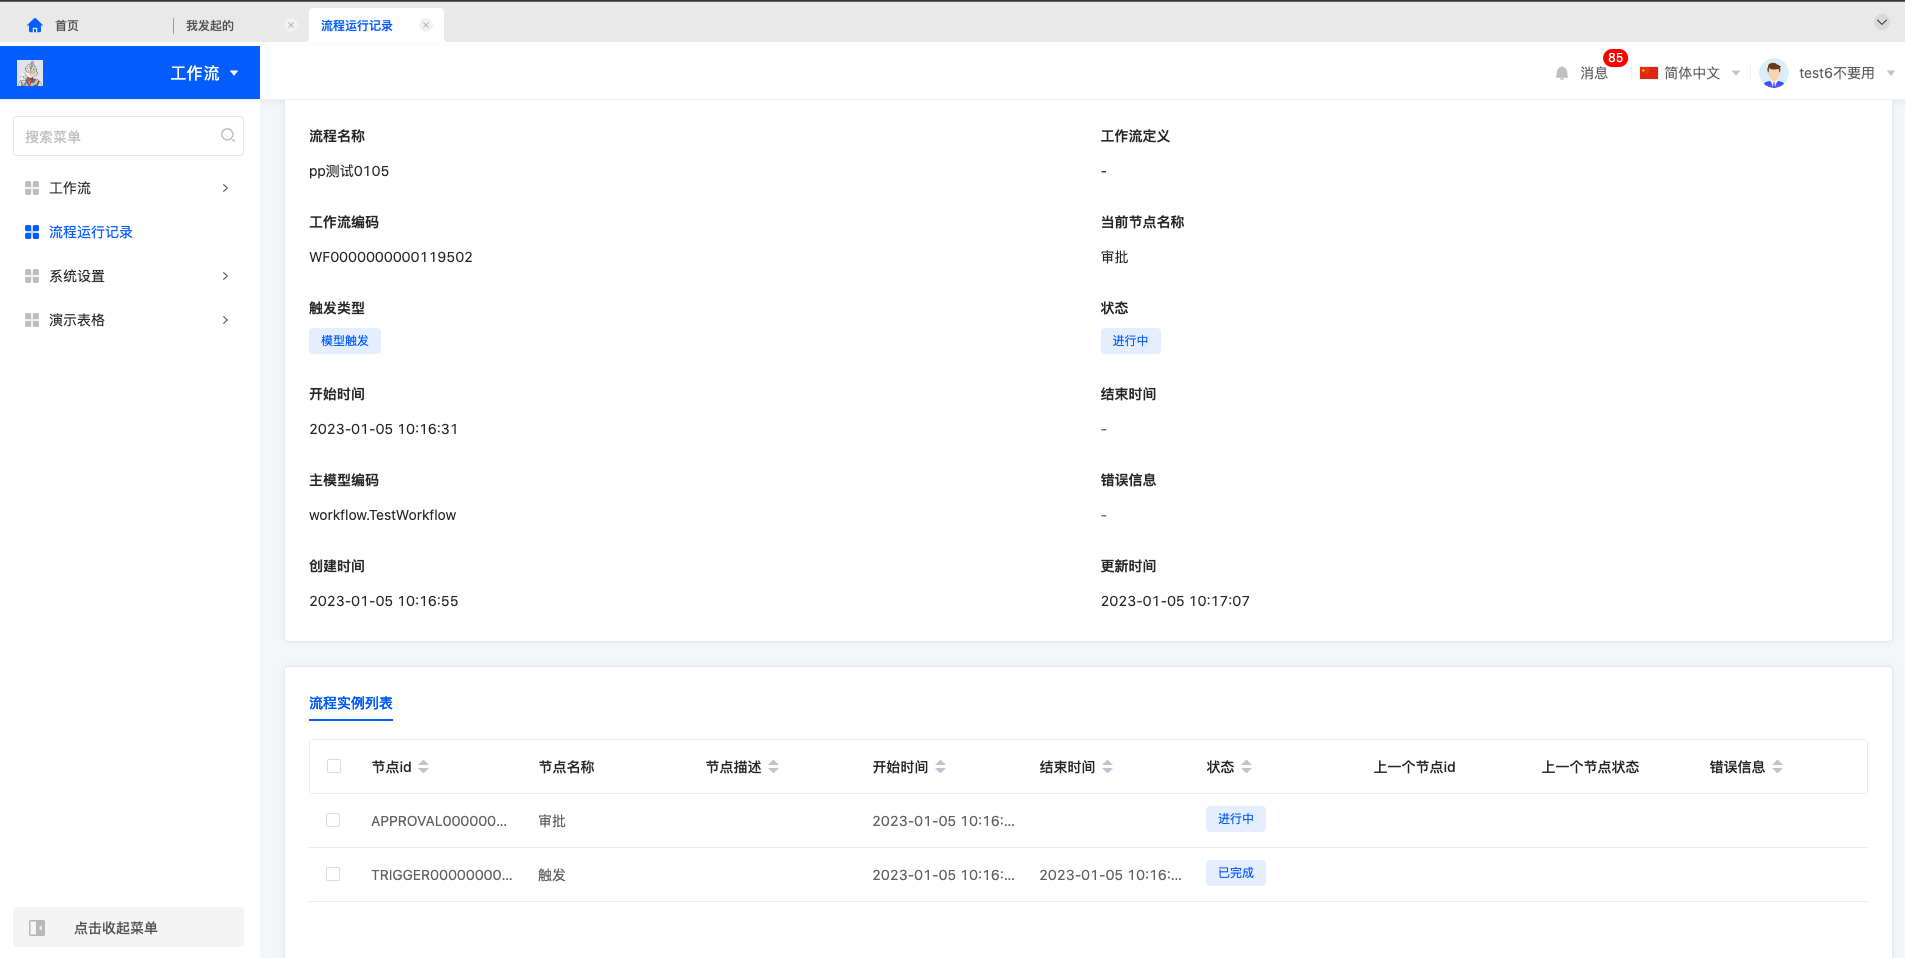
2. 流程运行记录查看

所有运行流程都会记录在流程运行记录中,可以根据流程的所属应用,流程名称,触发方式和状态进行搜索,流程运行记录详情中展示流程运行的具体节点,运行时间,当前运行节点,异常信息等。
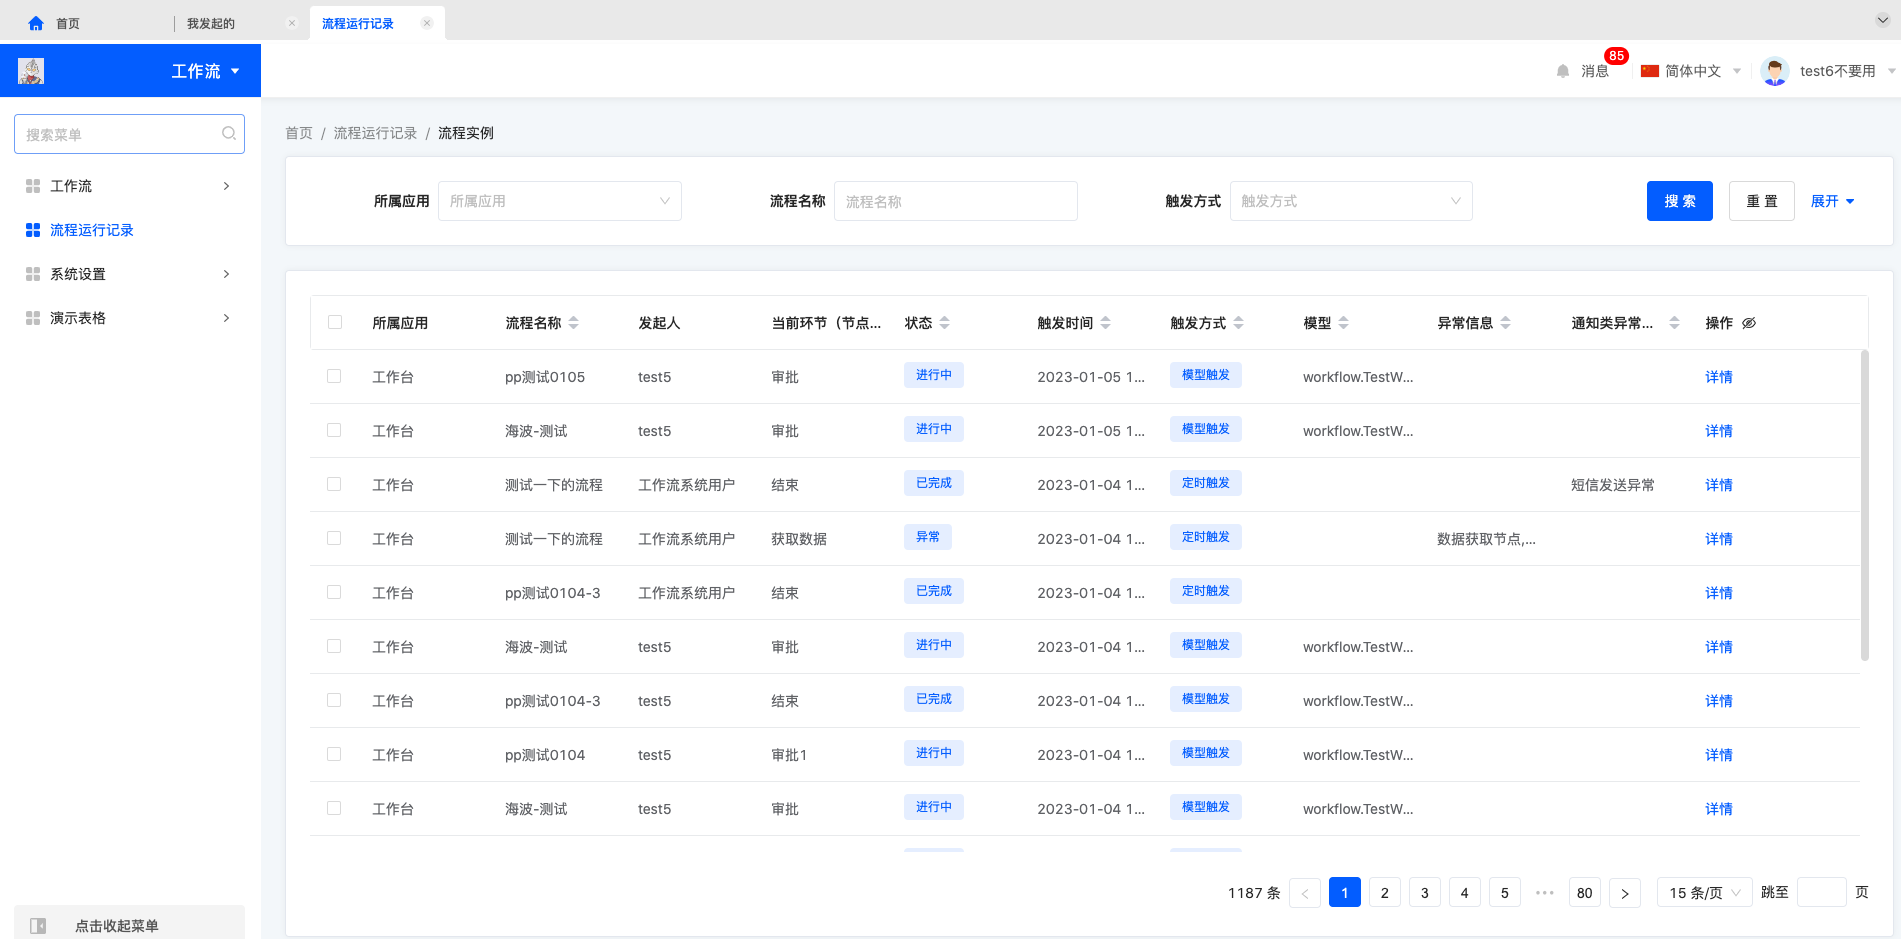
image.png

image.png

Oinone社区 作者:史, 昂原创文章,如若转载,请注明出处:https://doc.oinone.top/oio4/9388.html

访问Oinone官网:https://www.oinone.top获取数式Oinone低代码应用平台体验

Like (0)
史, 昂's avatar史, 昂数式管理员
Previous 2024年6月20日 am9:48
Next 2024年6月20日 am9:48

相关推荐

  • 自定义组件

    1. 定义组件介绍 平台提供了大多数的通用组件,面对企业个性话需求、复杂的业务场景,我们也提供了自定义组件的能力,帮助企业更快实施业务需求。 自定义组件包含“组件画廊”“组件排序”“元件画廊”“元件属性设计”四个页面。 1.1 组件与元件 在介绍如何自定义组件前,需要先了解以下概念: 组件:页面设计的组件库中看到的是组件。每个组件都有自己的属性面板,通过属性、字段决定组件逻辑,而自定义组件就是需要构建出组件自身的属性信息,再结合业务配置组件的属性、使用组件。 一个组件在不同的业务类型、视图类型、单值/多值,其属性面板是不同的,不同业务类型、视图类型、单值/多值的组合我们成为元件,多种组合即为多个元件,所以一个组件包括多个元件。 元件:一个组件可以对应多个元件。在创建时明确元件所适用的字段业务类型、单/多值、视图类型,在画布中切换元件时,会结合当前组件的字段业务类型、单/多值、所在视图类型确定可以使用哪一个元件。 此处切换的也是元件。 示例:创建一个“下拉选”的组件,其中可以包含“下拉单选”“下拉多选”两个元件。“下拉选”组件从组件库中拖入时,设置单值时使用“下拉单选”元件,设置多值时使用“下拉多选”元件。 2. 组件管理 2.1 组件创建 在组件画廊页面,点击添加组件,在弹窗中完善信息创建组件。 2.2 组件操作 自定义组件支持“搜索、删除、作废、查看引用关系、管理元件、编辑、低无一体、排序”的操作。 搜索:默认搜索可见组件,可切换“全部、可用、废弃”搜索组件,也可使用组件名称搜索。 删除:若组件未被引用,则可以直接删除。 作废:组件作废后,不可在画布中展示,不可在组件切换时使用,但已使用的数据不影响。 查看引用关系:可以查看存在引用关系的页面,支持点击跳转到对应页面的设计页面。仅当组件无引用关系时才支持删除。 管理元件:点击进入元件的管理页面。 编辑:可修改组件名称、组件图表、组件描述。 低无一体:比较复杂,在第5章中单独讲解。 排序:进入排序页,可拖动排序自定义组件。自定义组件会插在系统组件之后。可以点击“查看排序结果”选项页查看最终排序结果。排序同样会更新画布中的组件库顺序。 3. 元件管理 3.1 元件创建 在元件画廊页面,点击添加元件,在弹窗中完善信息创建一个元件。 3.2 元件操作 元件支持“删除、作废、查看引用关系、编辑、设计元件属性”的操作。 删除:若元件未被引用,则可以直接删除。 作废:元件作废后,不影响原来已使用的元件,无法新添加、使用该元件。 查看引用关系:可以查看存在引用关系的页面,支持点击跳转到对应页面的设计页面。仅当元件无引用关系时才支持删除。此处的引用关系数量会小于等于组件引用关系的数量。 编辑:可修改元件名称、支持视图类型、元件描述。 设计元件属性:比较复杂,将在第4章中单独讲解。 4. 设计元件属性 元件属性设计页面主要操作集中在这三部分,分别是①视图切换②属性面板设计区③复制功能 视图切换:元件创建时选择的支持视图类型,在①区域平铺可切换对应视图的属性面板进行设计。 属性面板设计区:可将组件拖入属性面板设计区进行设计,设计的是自定义组件的属性面板,左侧组件库和页面设计的组件库相同,仍然支持创建字段或使用模型字段,右侧进行元数据面板、属性面板设置。 复制功能:可将已设置好的属性面板复制到其他视图,提高设计效率。 5. 低无一体 低无一体简单讲就是组件代码上传,通过载入代码使组件在设计页面和实现页面可见和交互。 系统内置的属性不满足需求时,要用低无一体写代码,定制属性,比如从模型中拖拽设计就是内置的属性,从组件库中设置,就要配合低无一体,否则无效。 首次进入组件设计或组件中的元件变更时需要生成SDK。 生成结束后展示SDK生成时间,并且“下载模版工程”按钮可用。 点击下载模版工程,会自动下载模板工程。 在模版工程中编写前端代码。 根据实际需求上传JS、CSS文件后提交即可。

    2024年6月20日
    2.6K00
  • 数据字典

    1. 什么是数据字典 数据字典是一些固定字典项的集合,可作为多选或单选的选项,例如人员性别、员工属相、杭州市下属的行政区等都是数据字典。 选择一个应用/模块下的一个小模块,可以查看其中包含的自定义字典(自建的数据字典)和系统字典。可以通过导入或添加创建自定义字典。 2. 数据字典基本操作 删除:系统字典不支持删除,无法批量删除自定义数据字典,若数据字典已经被字段、页面等引用时,也无法删除这个数据字典。 隐藏/可见:自定义字典、系统字典都可以操作隐藏和可见,隐藏和可见不影响数据字典在字段、页面等处的使用。 查看引用关系:点击查看引用关系,展开弹窗,展示该数据字典和字段、视图的引用关系。 修改:若数据字典已经被引用,无法删除其中的字典项。若无引用关系则可以任意修改。 3. 数据字典导入 点击“导入数据字典”按钮,弹出窗口,可根据图中引导进行数据字典的导入。 在经典模式下,导入数据字典会新建数据字典。 在专家模式下,数据字典导入的模板中包含字段“字典编码”,若导入的字典编码不存在则会新建数据字典,若导入的字典编码已存在则会修改字典编码的设置,新建和修改的动作会校验是否符合规范。 4. 数据字典创建 4.1 专家模式(低代码模式) 字典项类型有“二进制、文本、整数”三种可选,选择二进制时,字典项值需要选择存储在数据库二进制中的第几位。系统根据字典项值去查找字典项名称,因此字典项值不可重复。 数据字典的api名称、代码名称、描述可不填,部分系统会赋默认值。 字典项中字典项名称和字典项值必填,api名称和字典项描述不填系统会赋默认值。 4.2 经典模式(无代码模式) 经典模式下只需要填写字典名称,添加字典项即可。系统会自动将字典项类型设置为“二进制”,并将字典项按照创建的先后顺序设置字典项值的位数。字典项类型、字典项值释义可参照专家模式的解释。

    2024年6月20日
    2.9K00
  • 1.3 Oinone的生态思考

    以“企业级软件生态”的方式去帮助企业建立“一站式的商业智能软件”。 通过观察信息化到数字化的软件行业发展历程(如下图1-3所示),我们可以发现,企业真正需要的是一站式的软件产品。然而,一站式的软件产品往往都是从单个领域的需求满足开始,这在信息化时代和数字化时代都是如此。在信息化时代,以ERP为终点的一站式趋势逐渐形成;而在数字化时代,中台概念的提出则标志着一站式的趋势重新开始。本文将从企业数字化转型所面临的困境出发,探讨Oinone的生态思考。 图1-3 从信息化到数字化软件行业发展历程 1.3.1 与中台的渊源 中台概念的提出标志着企业数字化改造进入了一个新的时代。随着数字化转型不断深入,企业面临着严重的数据割裂、系统隔离等问题。在这样的背景下,“敏捷响应,低成本地快速创新”成为了推动一站式商业智能软件的内在诉求。需要澄清的是,互联网中台架构只是一种企业解决数据割裂、系统隔离,建立一站式商业智能软件的技术概念之一,并不是技术标准。而且这种方式只适用于企业自建模式。在多供应商环境下,则会适得其反,导致建立更复杂的烟囱系统。 阿里于15年提出中台架构概念,抓住了企业数字化转型的核心诉求,即“敏捷响应,低成本快速创新”。然而,阿里作为一家生态公司,在16年时基本上是带着合作伙伴来给企业交付,但由于伙伴对互联网技术的理解和能力的限制,基本上都做得不好,甚至失败。在2017年,阿里成立了原生交付团队,希望能够树立一些标杆案例。我和公司的核心成员也都来自于这个团队。在做完几个客户后,我发现阿里也做不好,但这次做不好的原因不是技术不行或项目上不了线,而是上线以后预期的效果没有达到,其本质是企业的IT组织能力无法驾驭复杂的互联网中台架构。当无法驾驭的时候,所谓的目标“敏捷响应,快速创新”就无从说起了。结果客户会反馈以下三类问题: 不是说敏捷响应吗?为什么改个需求这么慢,不但时间更长,付出的成本也更高了?是因为中台架构需要一定的技术能力和经验才能有效地应用,就像一个只会骑自行车的人给他一辆汽车或者飞机,他也不能驾驭它们,更不用说是手动挡的。 不是说能力中心吗?当引入新供应商或有新场景开发的时候,为什么前期做的能力中心不能支撑了?是因为能力中心是一种面向业务的能力组织方式,它将不同的业务能力抽象出来,以服务的形式对内提供。然而,由于业务场景的差异,不同的业务需要的能力也会不同,因此能力中心需要不断迭代和升级。对于新引入的供应商或新场景开发,需要根据实际情况对能力中心进行定制化和扩展化,但谁来负责呢?新项目的供应商还是客户自己? 不是说性能好吗?为什么我投入的物理资源更多了?是因为中台架构采用微服务来解决单点瓶颈问题,提高系统性能和可用性,但是在初始阶段,投入的资源可能会更多。每个模块至少需要两个实例来保障高可用性,因此物理资源的投入量可能会比以前更多。 1.3.2 找解决方案 在考虑解决方案之前,我们需要思考企业数字化软件的最终状态将是什么样子。目前有两种主要的方案(如下图1-4所示): 第一种是以自建研发团队为核心。中国的大型企业已经开始尝试这种模式,看起来似乎是一个时下比较流行的可行性方案。然而,绝大多数企业由于成本、人才团队等原因而难以坚持下去,只能与供应商合作开发。 第二种是以供应商为核心。由于大多数企业无法选择第一种路径,他们必须接受目前分散的情况,并通过系统集成尽可能拉通各个系统。尽管如此,在数字化时代中,真正意义上的一站式商业智能软件供应商还未出现。 图1-4 企业数字化桎梏和囹圄 对企业来说,这两种方案都非常艰难,但在大规模数字化历程中又不得不做出选择。此外,我们还能清晰看到以下几点: "敏捷响应,低成本地快速创新"成为企业推动一站式商业智能软件的内在诉求 目前没有一家软件供应商能满足企业所有外围商业场景,也不可能有这样的供应商 绝大部分企业需要软件供应商,而不是自建 如何突破这种局面也成为中国软件行业发展的一个机遇。因此,我的思考是: 我们的目标不是依托于提升研发人员的能力,而是降低互联网架构的门槛,让更多企业真正拥有“敏捷响应,低成本快速创新”的能力。 我们的目标不是输出中台方法论,而是提供中台建设的技术平台。 我们的目标不是只服务大企业,而是真正赋能不同IT组织能力的企业,让它们都具备持续创新的能力。 今天,许多中台软件公司告诉企业:“中台是持续演进和快速迭代的过程,因此企业需要组建中台架构团队来实现,而他们则通过中台项目落地将中台建设方法论传授给企业。”这句话的前半部分是正确的,因为我们之前提到企业需要具备敏捷响应业务的能力,即应变能力,因为应变是不断变化的。然而,后半部分是不正确的,因为今天的企业已经有能力组建团队,那么这些中台软件公司到底有什么用呢?企业真的缺少方法论吗?在19年,我就提出了自己的看法:没有低代码能力的中台公司都在收取智商税,都在欺诈,因为很多企业根本找不到足够懂互联网架构的人才。明白流氓在哪里了吗?这些流氓公司赚了很多钱,最后责怪企业无法招到人才,这是企业的责任。因此,仍然认为“最好的赋能是降低门槛,而不是让客户提高技术水平”。 最终,我们得出了一个服务模式的想法:构建企业级的软件生态。企业级软件生态的确切定义是:通过开放的方式,让企业本身以及不同的软件供应商共同参与,遵循相同的技术和数据规范,打造一体化、无需集成的各类企业级软件。如果要打造企业级软件生态,我们列出了六个要点(如下图1-5所示)。 图1-5 打造企业级软件生态需要具备的六大能力 我很幸运地有机会通过“企业级软件生态”的方式,为企业建立“一站式的商业支持平台”提供帮助。我们的Oinone平台结合了低代码开发、通用数据模型和业务产品的优势(如下图1-6所示)。 图1-6 Oinone = 低代码开发平台 + 通用数据模型 + 业务产品 我们对Oinone一站式低代码商业支撑平台展开介绍,它大致分为4部分: 以低代码开发平台为基础,输出具备互联网架构下的软件快速开发标准。这可以帮助企业快速构建符合互联网架构标准的应用程序,从而实现快速响应和低成本创新。 以通用数据模型为基础,满足不同软件基于同一套数据标准的扩展能力。这可以确保不同软件系统之间的数据兼容性和互操作性,避免数据孤岛和信息隔离。 在业务产品层面上,企业和伙伴基于相同的技术标准和数据标准共同提供解决方案。这可以帮助企业和伙伴共同开发出符合标准的商业支撑平台,以提高业务效率和创新能力。 最后是无代码设计器,用于满足项目开展中,超出业务标品范围之外的需求,或者针对标品的临时需求。这可以帮助业务人员在不需要专业软件支持的情况下,自主解决业务需求,并支持部门间的协同工作。 1.3.3 生态建设 Oinone致力于打造全球最大的无需集成的商业应用程序及其生态系统,通过开源内核、汇集数千名开发人员和业务专家,为企业提供成本效益、一体化、模块化的解决方案,解决所有商业需求,让不同技术之间的合作变得简单易行,摆脱烦恼的集成问题。 在客户和场景领域,我们严格限定了自身的专注领域。针对超大型头部企业,我们专注于树立标杆,而对于大、中、小型企业,则交由我们的伙伴来支持。小微企业可以通过我们的开源社区版获得覆盖。在企业数字化转型的核心领域中,我们的解决方案涵盖了数字化交易场景、全渠道订单履约场景、数字化采购场景、数字化营销等产品。在其他领域,我们完全交由伙伴来建设。由于我们自身在企业协同商务领域拥有深厚的背景,因此在该领域提供的产品拥有特别的优势。 企业数字化转型核心领域 图1-7 企业数字化转型核心领域

    2024年5月23日
    2.7K00
  • 4.1.2 模块之启动指令

    针对不同启动指令的组合可以满足不同场景需求,下面列举了几个常规组合方式,小伙伴们务必把这几种模式都尝试一遍,会更有体感 本节为小伙伴讲解oinone模块的几种启动方式,它是为能灵活地应对企业市场的不同场景需求,为op(本地化部署)、saas和研发提供个性化支撑。也为oinone独特性之单体与分布式的灵活切换提供基础支撑 一、部署参数 参数 名称 默认值 说明 -Plifecycle 生命周期部署指令 RELOAD 可选项:无/INSTALL/PACKAGE/RELOAD/DDL安装-install为AUTO;upgrade为FORCE打包-install为AUTO;upgrade为FORCE;profile为PACKAGE重启-install、upgrade、profile为READONLY打印变更DDL-install为AUTO;upgrade为FORCE;profile为DDL 表4-1-2-1 部署参数 如果在启动命令中配置了部署参数,可不再设置服务参数和可选项参数。下图为在启动命令中添加部署参数的示例。 图4-1-2-1 在启动命令中添加部署参数的示例 二、使用场景 针对不同启动指令的组合可以满足不同场景需求,下面列举了几个常规组合方式,小伙伴们务必把这几种模式都尝试一遍,会更有体感。 场景一:DDL(1)+RELOAD(N)应对专有DBA 因为很多公司数据库是由专门的DBA来管理的,不允许应用直接变更数据库相关配置、表结构、初始化数据。而oinone是基于元数据驱动的,任何模型、行为的变化都会自动转化成对物理存储的改变与元数据变化。 oinone为了适用企业op场景,特别增加了DDL模式。把发布上线分为两个步骤。 一:用DDL模式把涉及到数据库的变更与元数据初始化的脚本进行输出,交由客户公司DBA审批,并执行 二:用RELOAD模式,进行正常的应用重启工作,不进行安装、升级、以及数据库物理变革等操作。 #应用启动关闭自动DDL配置 pamirs.boot.profile: CUSTOMIZE pamirs.boot.options.rebuildTable: false pamirs.persistence.global.auto-create-database: false pamirs.persistence.global.auto-create-table: false 图4-1-2-2 应用启动关闭自动DDL模式 场景二:PACKAGE(1)+RELOAD(N)应对提升多机器实例效率 在机器规模相对大的场景中我们会碰到以下问题: 元数据差量计算、数据库变更、元数据变化保存都非常费时,如果每台机器都来一遍是非常费时费力的 分布式下多机器如果并发进行INSTALL,会导致数据库修改表结构、元数据变化保存锁死 所以我们可以选择一台机器用PACKAGE,其他机器采用RELOAD模式,做到合理规避问题,提升应用发布效率 场景三:INSTALL应对开发模式 研发在本地开发模式下INSTALL是最有效率的,把所需依赖模块一把启动和调试。 上线如果要用INSTALL需要注意,要逐台进行。当然也可以改进成INSTALL(1)+RELOAD(N)模式 三、启动命令解读 查看启动命令 可以在启动日志中查看当前所用启动命令。 图4-1-2-3 在启动日志中查看当前所用启动命令 生命周期管理-Plifecycle 除了通过启动YAML中pamirs.boot属性来设置启动参数,你还可以在应用启动命令中使用-Plifecycle参数来快捷控制模块生命周期的管理方式。该参数的可选项为RELOAD、INSTALL、CUSTOM_INSTALL、PACKAGE、DDL。 java -jar <your jar name>.jar -Plifecycle=RELOAD 启动命令优先级高于YAML中pamirs.boot属性中的install、upgrade和profile属性。如果不使用-Plifecycle参数,则使用YAML中pamirs.boot属性中的install、upgrade和profile属性配置。若YAML中未配置,则采用默认值。 启动配置项 默认值 RELOAD INSTALL CUSTOM_INSTALL PACKAGE DDL install AUTO READONLY AUTO AUTO AUTO AUTO upgrade AUTO READONLY FORCE FORCE FORCE FORCE profile CUSTOMIZE READONLY AUTO CUSTOMIZE PACKAGE DDL 表4-1-2-2 Plifecycle可选项与启动项对应表 profile属性请参考4.1.1【服务启动可选项】一文。只有pamirs.boot.profile=CUSTOMIZE时,在pamirs.boot.options中自定义的可选项才生效。 自动建表-PbuildTable java -jar <your jar name>.jar -PbuildTable=NEVER PbuildTable参数用于设置自动构建表结构的方式。如果不使用该参数,则options属性的默认值请参考4.1.1【服务启动可选项】一文。-PbuildTable参数可选项为: NEVER – 不自动构建表结构,会将pamirs.boot.options中的diffTable和rebuildTable属性设置为false EXTEND – 增量构建表结构,会将pamirs.boot.options中的diffTable属性设置为false,rebuildTable属性设置为true DIFF – 差量构建表结构,会将pamirs.boot.options中的diffTable和rebuildTable属性设置为true 模块在线 -PmoduleOnline java -jar <your jar name>.jar -PmoduleOnline=CHECK PmoduleOnline参数用于设置模块在线的方式。如果不使用该参数,则profile属性的默认值请参考4.1.1【服务启动可选项】一文。-PmoduleOnline参数可选项为: NEVER – 不读取存储在数据库中的模块信息,会将pamirs.boot.options中的reloadModule和checkModule属性设置为false READ – 读取存储在数据库中的模块信息,会将pamirs.boot.options中的checkModule属性设置为false,reloadModule属性设置为true CHECK – 读取存储在数据库中的模块信息并校验依赖模块是否已安装,会将pamirs.boot.options中的reloadModule和checkModule属性设置为true 元数据在线-PmetaOnline java -jar <your jar name>.jar -PmetaOnline=MODULE PmetaOnline参数用于设置元数据在线的方式,如果不使用该参数,则profile属性的默认值请参考4.1.1【服务启动可选项】一文。-PmetaOnline参数可选项为: NEVER – 不持久化元数据,会将pamirs.boot.options中的updateModule、reloadMeta和updateMeta属性设置为false MODULE – 只注册模块信息,会将pamirs.boot.options中的updateModule属性设置为true,reloadMeta和updateMeta属性设置为false ALL – 注册持久化所有元数据,会将pamirs.boot.options中的updateModule、reloadMeta和updateMeta属性设置为true 开放远程服务-PenableRpc PenableRpc参数用于设置是否开启远程服务。如果不使用该参数,则profile属性的默认值请参考4.1.1【服务启动可选项】一文。-PenableRpc参数可选项为true和false。该参数会将参数值设置到pamirs.boot.options中的publishService属性。 开启API服务-PopenApi PopenApi参数用于设置是否开启HTTP API服务。如果不使用该参数,则profile属性的默认值请参考4.1.1【服务启动可选项】一文。-PopenApi参数可选项为true和false。该参数会将参数值设置到pamirs.boot.options中的rebuildHttpApi属性。 开启字段校验-PcheckField PcheckField参数用于设置是否开启字段校验。-PcheckField参数可选项为true和false。由于通常应用的字段数量非常多,会延长系统启动时长,所以默认不会开启字段校验。 启用数据初始化服务-PinitData PinitData参数用于设置是否开启数据初始化服务。如果不使用该参数,则profile属性的默认值请参考4.1.1【服务启动可选项】一文。-PinitData参数可选项为true和false。该参数会将参数值设置到pamirs.boot.options中的updateData属性。 四、不使用自动构建数据库表功能 Oinone LCDP默认提供框架的所有服务,所以会自动构建数据库表。如果不需要使用Oinone的存储构建服务,可以设置YAML文件中关于自动建表的配置。这样就不会动态构建数据库表,你可以手动搭建数据库表。 通过配置启动YAML中pamirs.boot.options.rebuildTable为false彻底关闭自动建表功能。 pamirs: boot: options: rebuildTable: false 图4-1-2-4 不使用自动构建数据库表功能 也可以按需配置启动YAML中pamirs.persistence配置来关闭部分数据源的自动建表功能。persistence配置既可以针对全局也可以分数据源进行配置。 pamirs: persistence: global: # 是否自动创建数据库的全局配置,默认为true autoCreateDatabase: true # 是否自动创建数据表的全局配置,默认为true autoCreateTable: true <your ds key>: # 是否自动创建数据库的数据源配置,默认为true autoCreateDatabase: true # 是否自动创建数据表的数据源配置,默认为true…

    2024年5月23日
    1.4K00

Leave a Reply

Please Login to Comment