7.1 设计器总览

设计器转为非专业研发设计,在Oinone3.0版本中已经完成元数据完整在线化,真正做到低无一体。对于设计器的定位我们开篇就介绍过,它是LCDP的产品化呈现,是冰山露在外面大家看得到的,核心还是在LCDP本身。我们先目睹下设计器的一些产品页面,如您有想体验,可以在Oinone官网注册

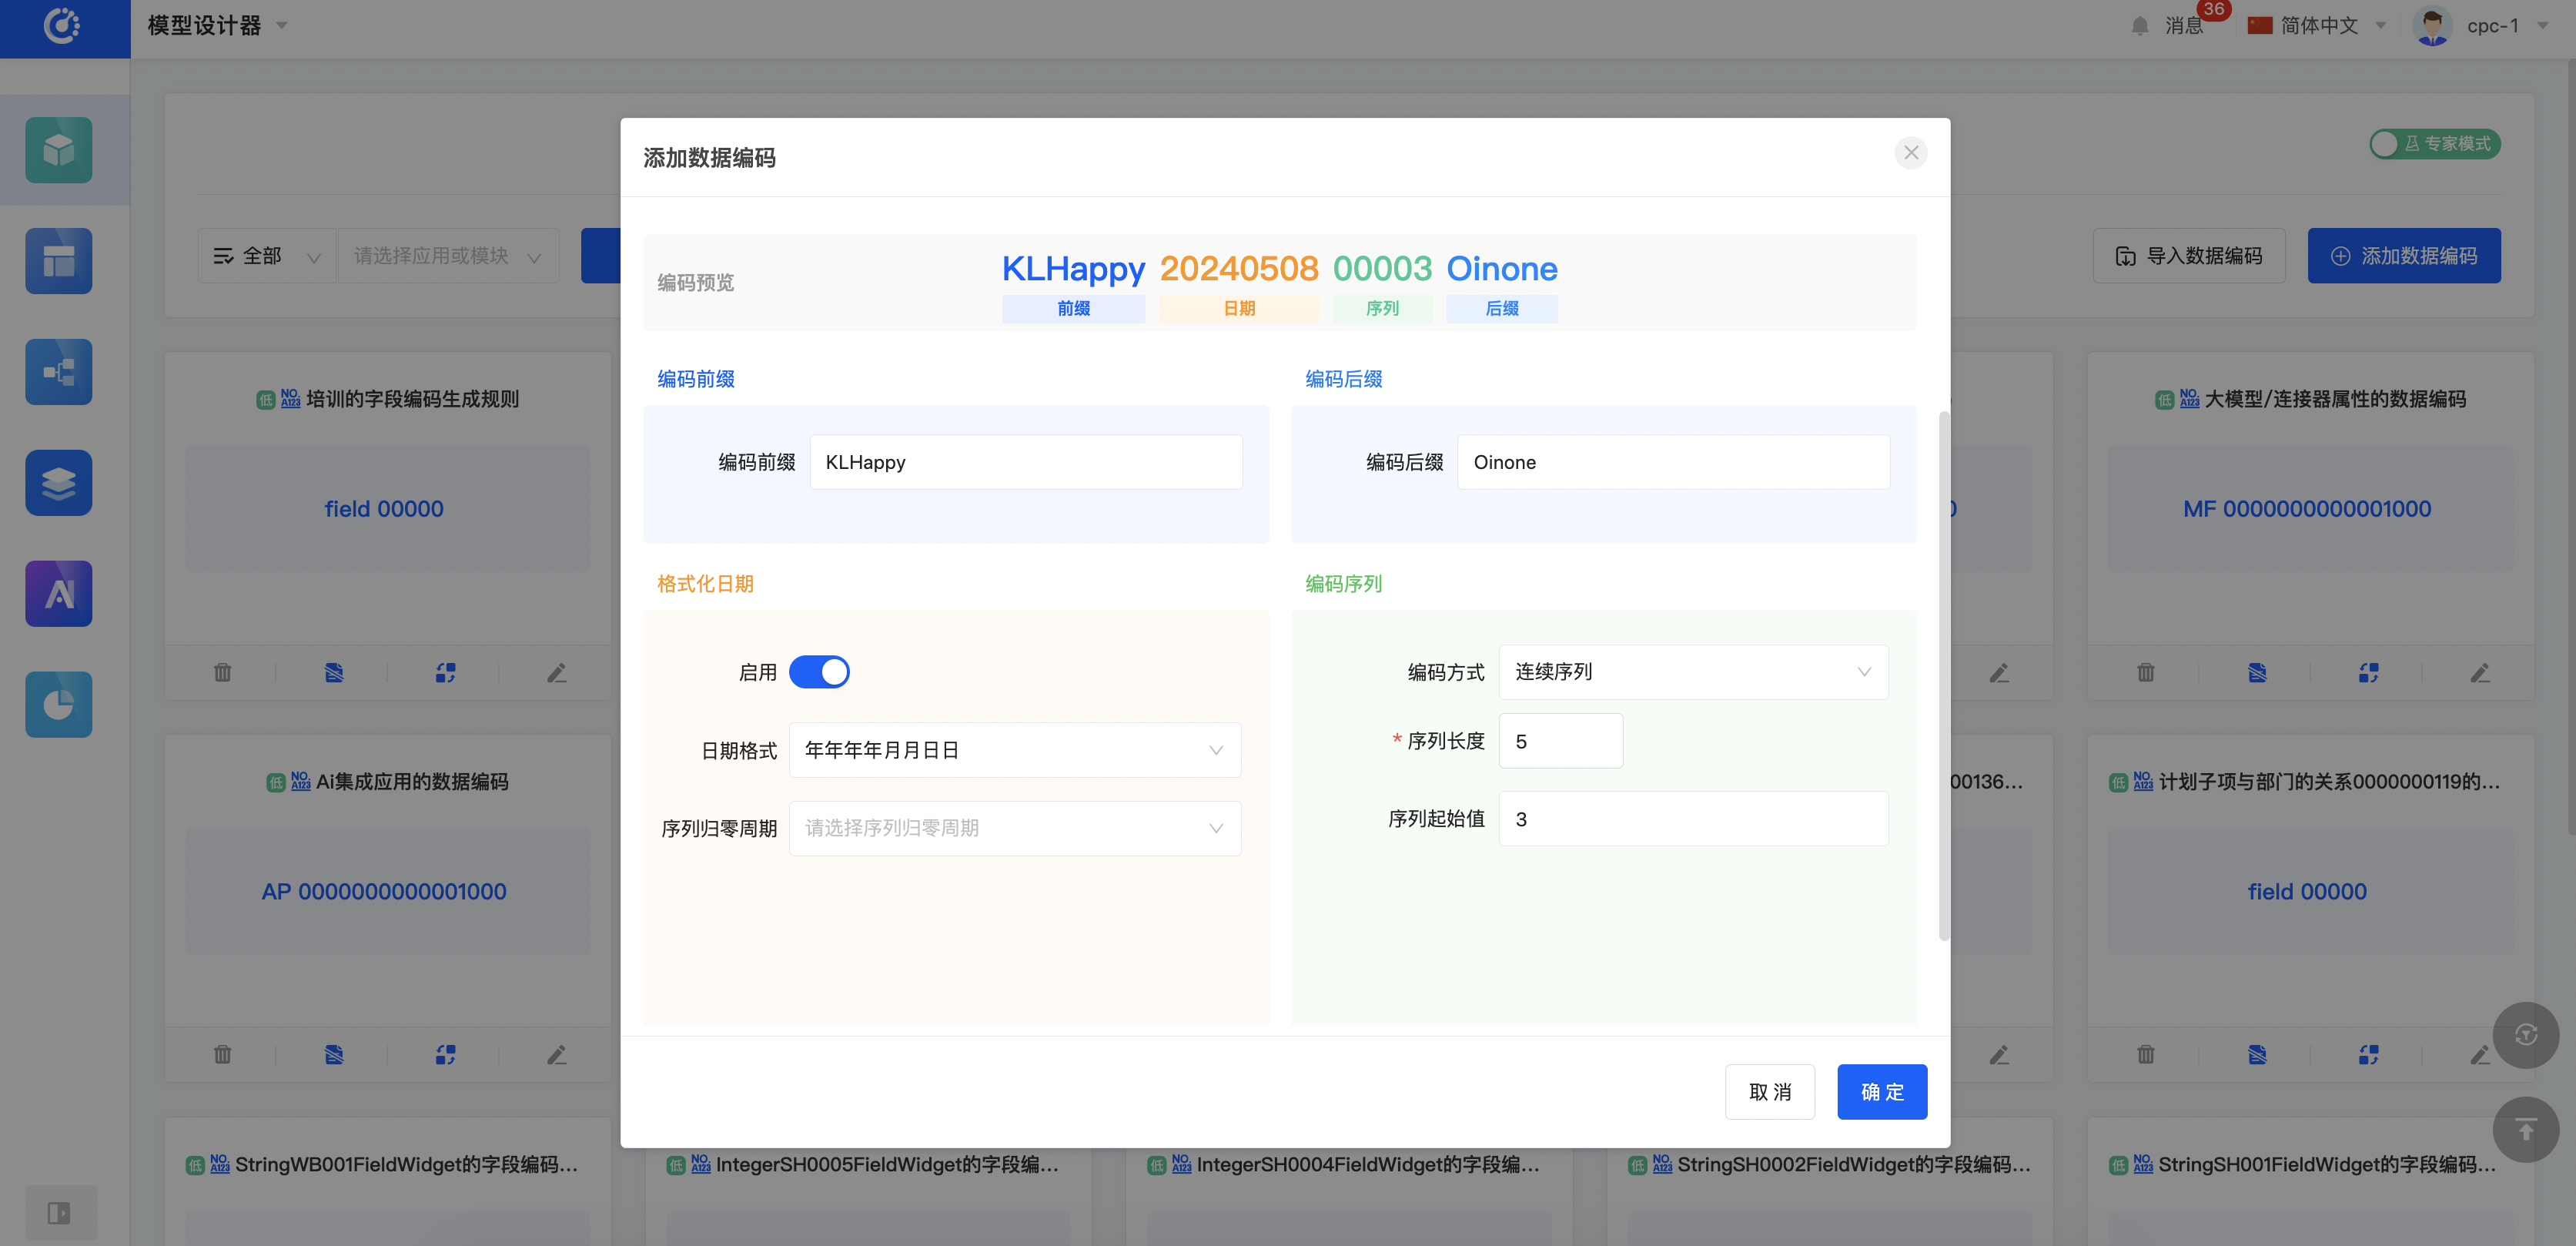
模型设计器

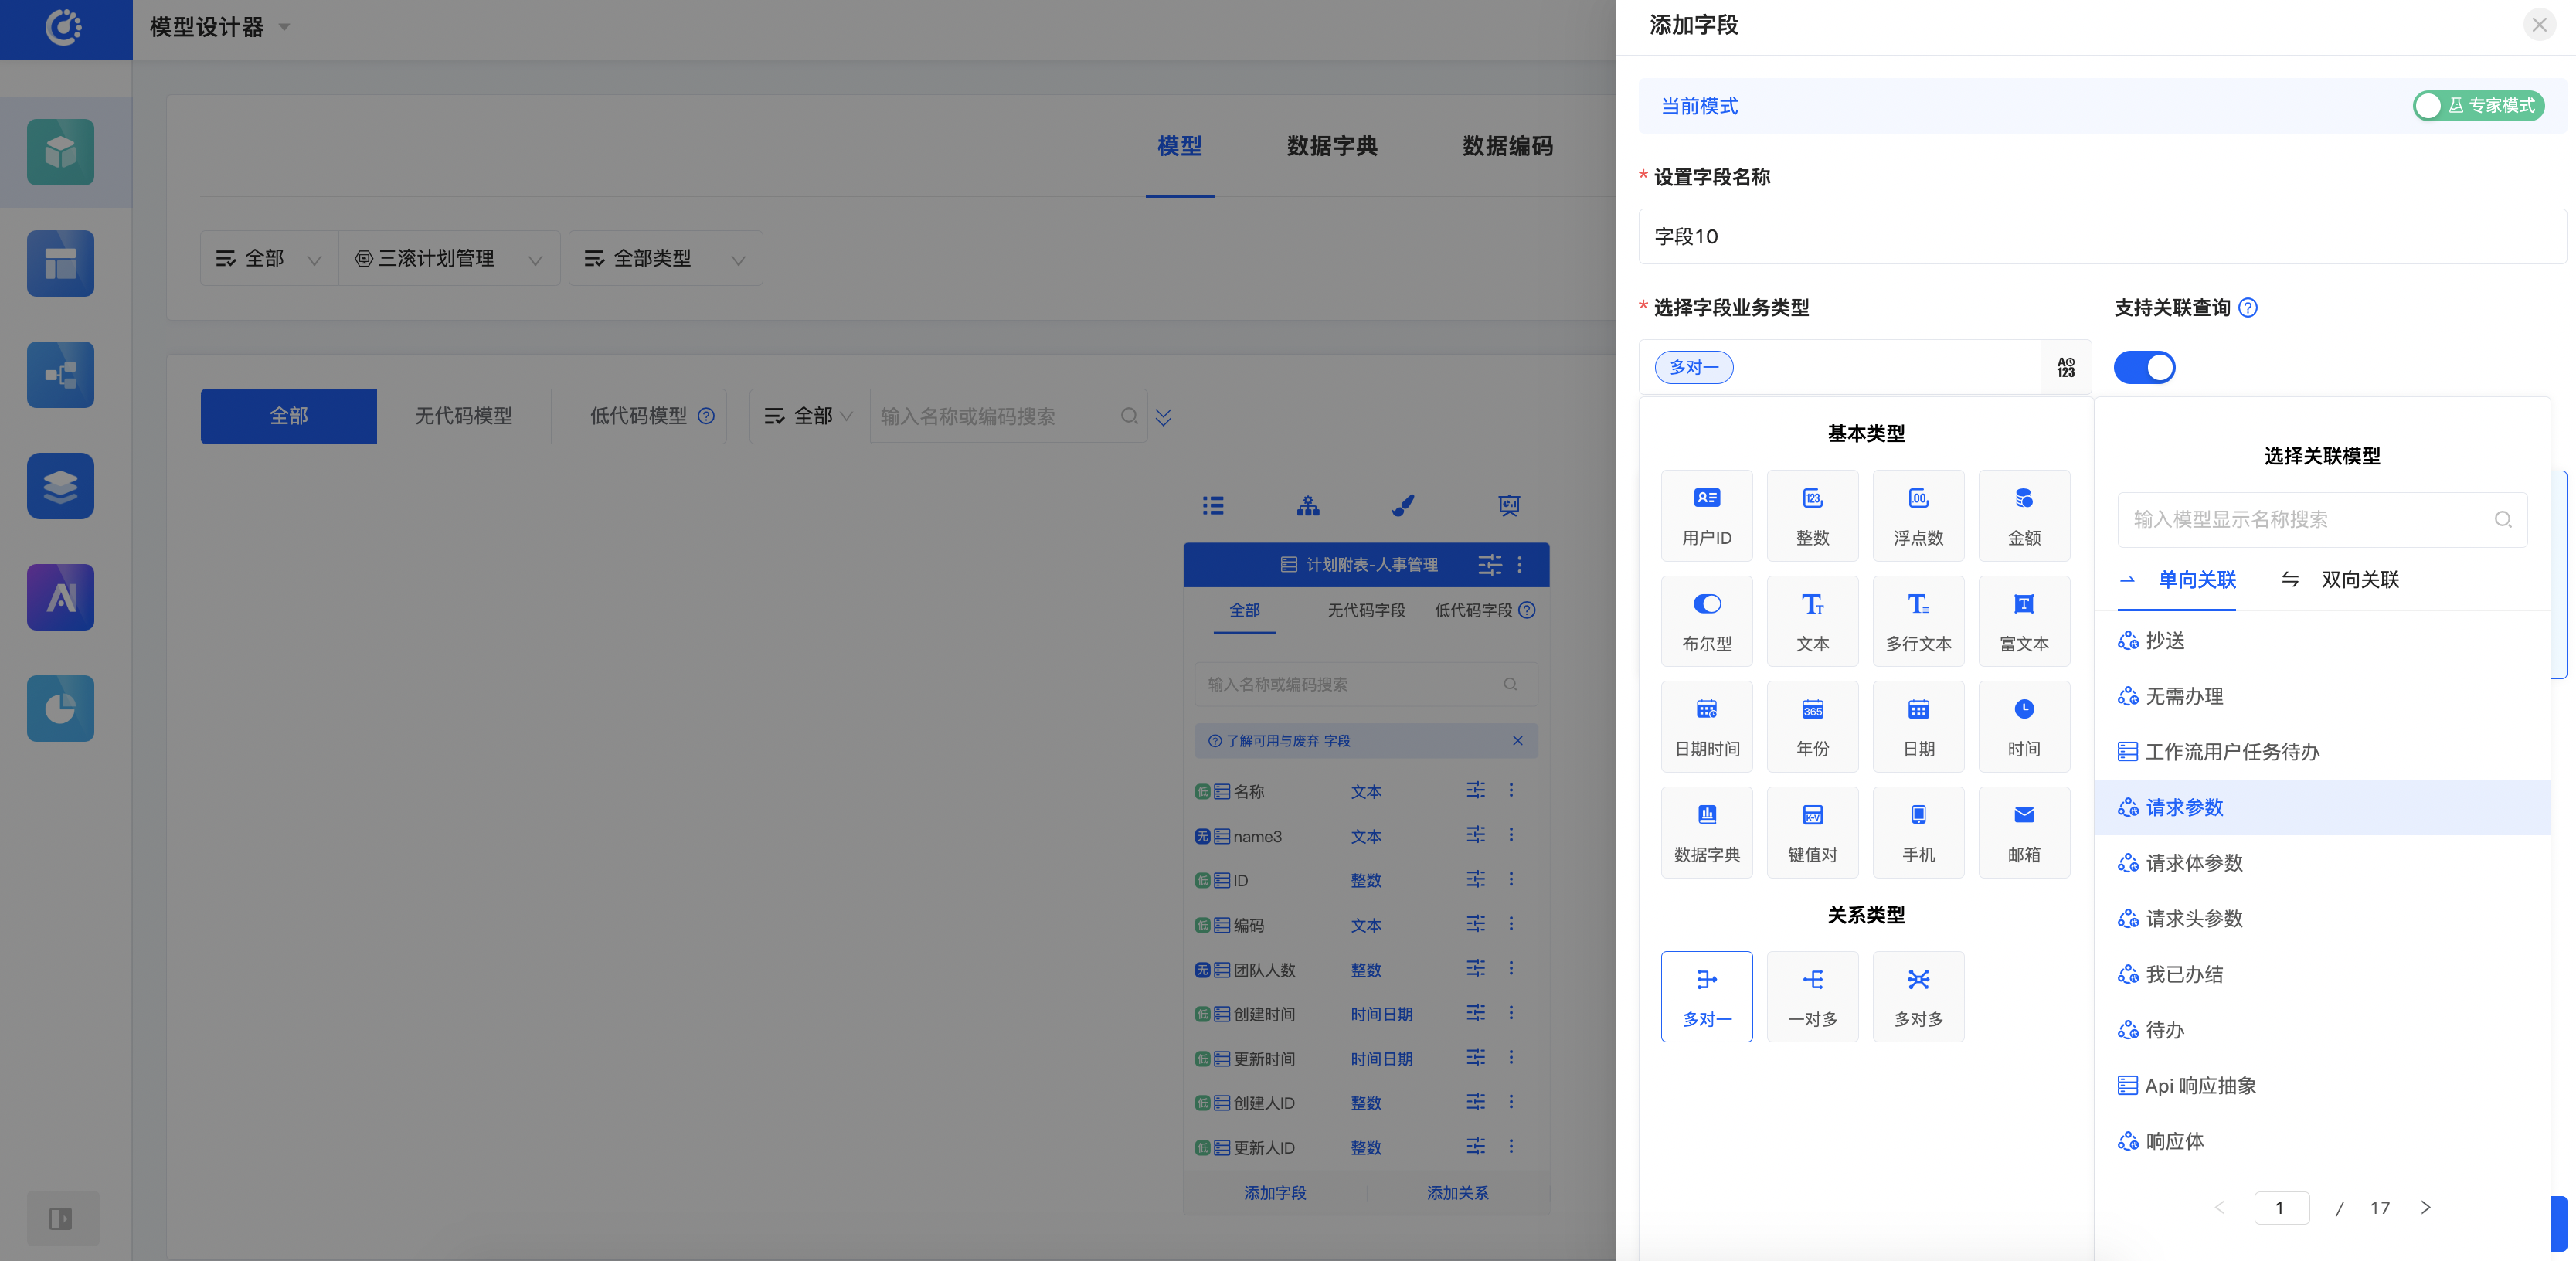
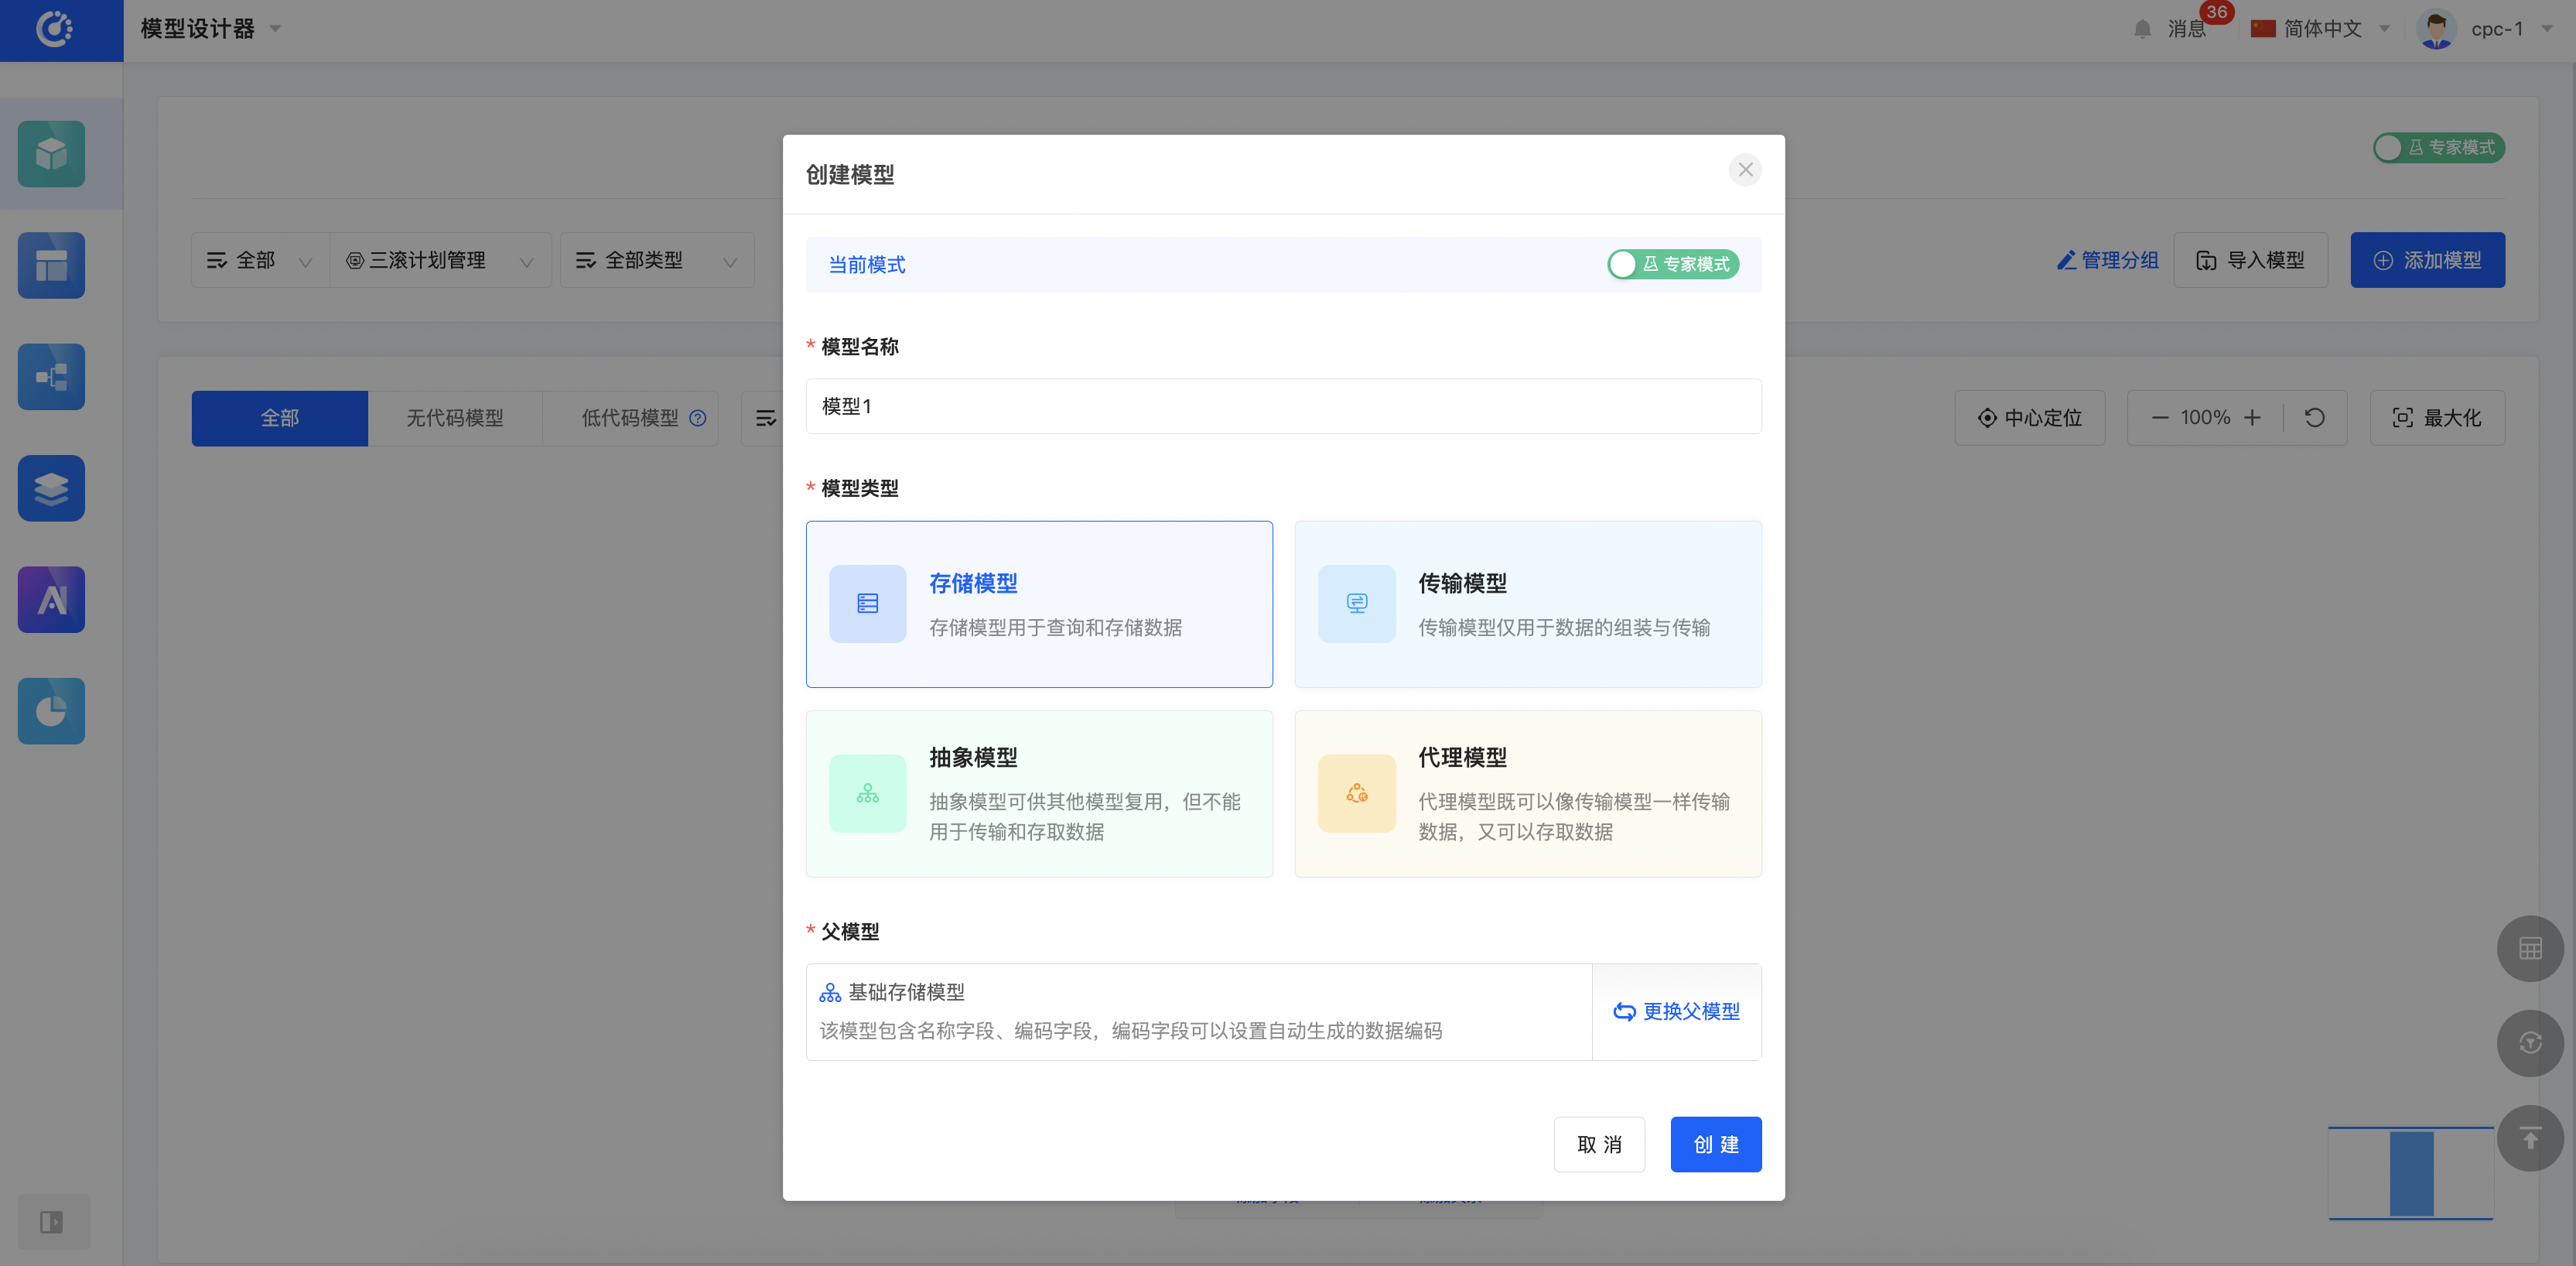
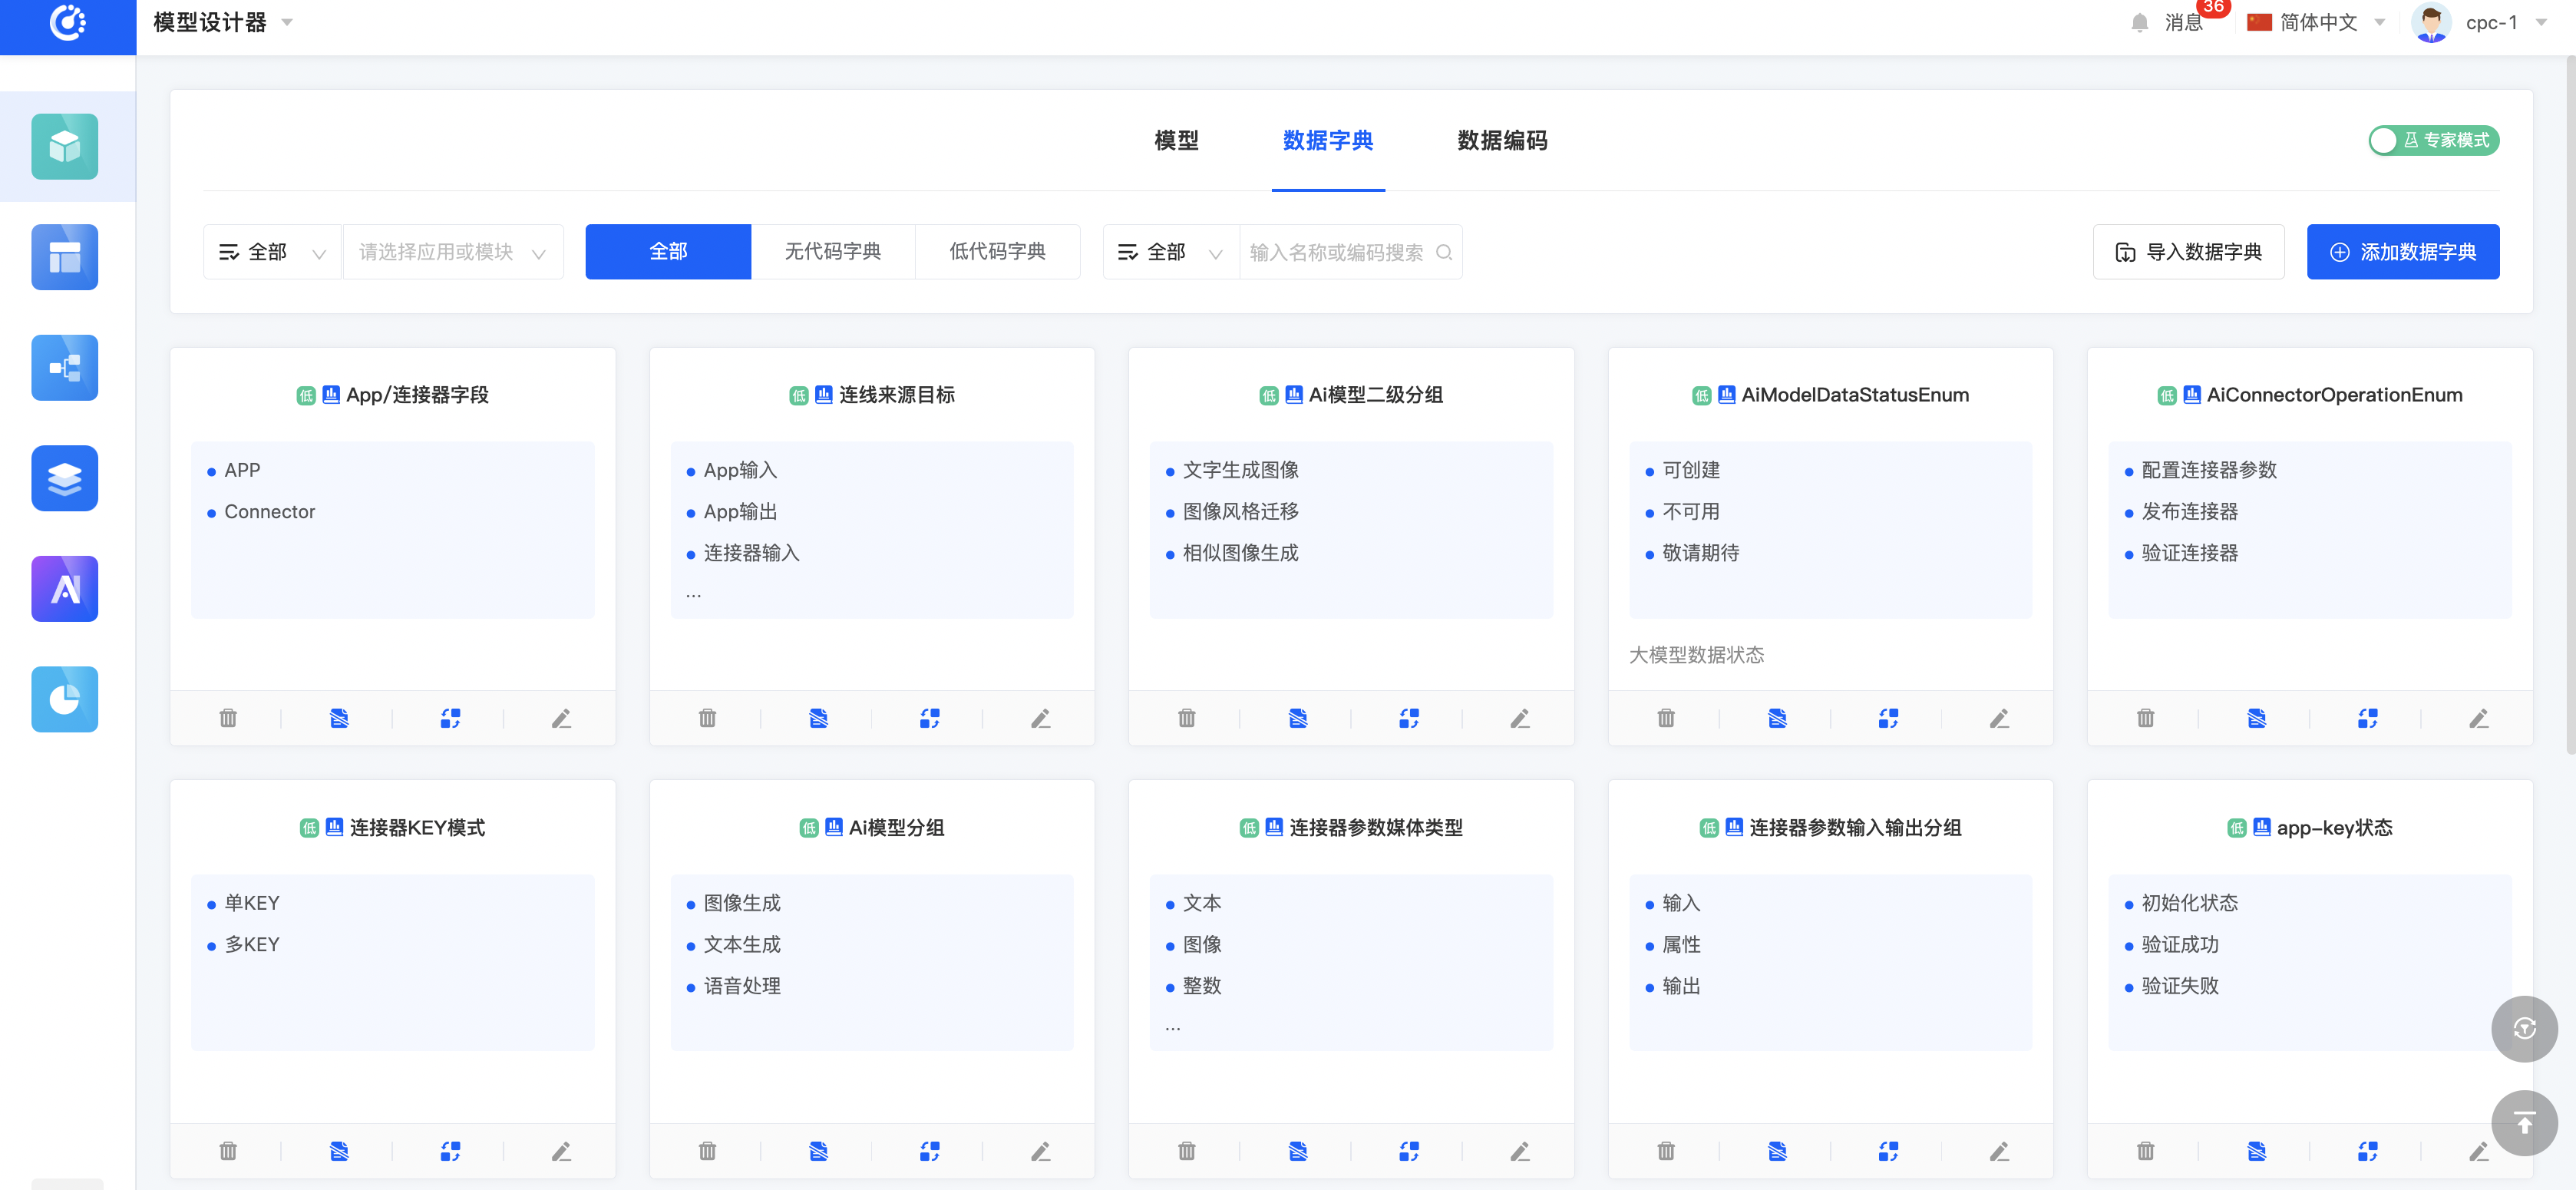
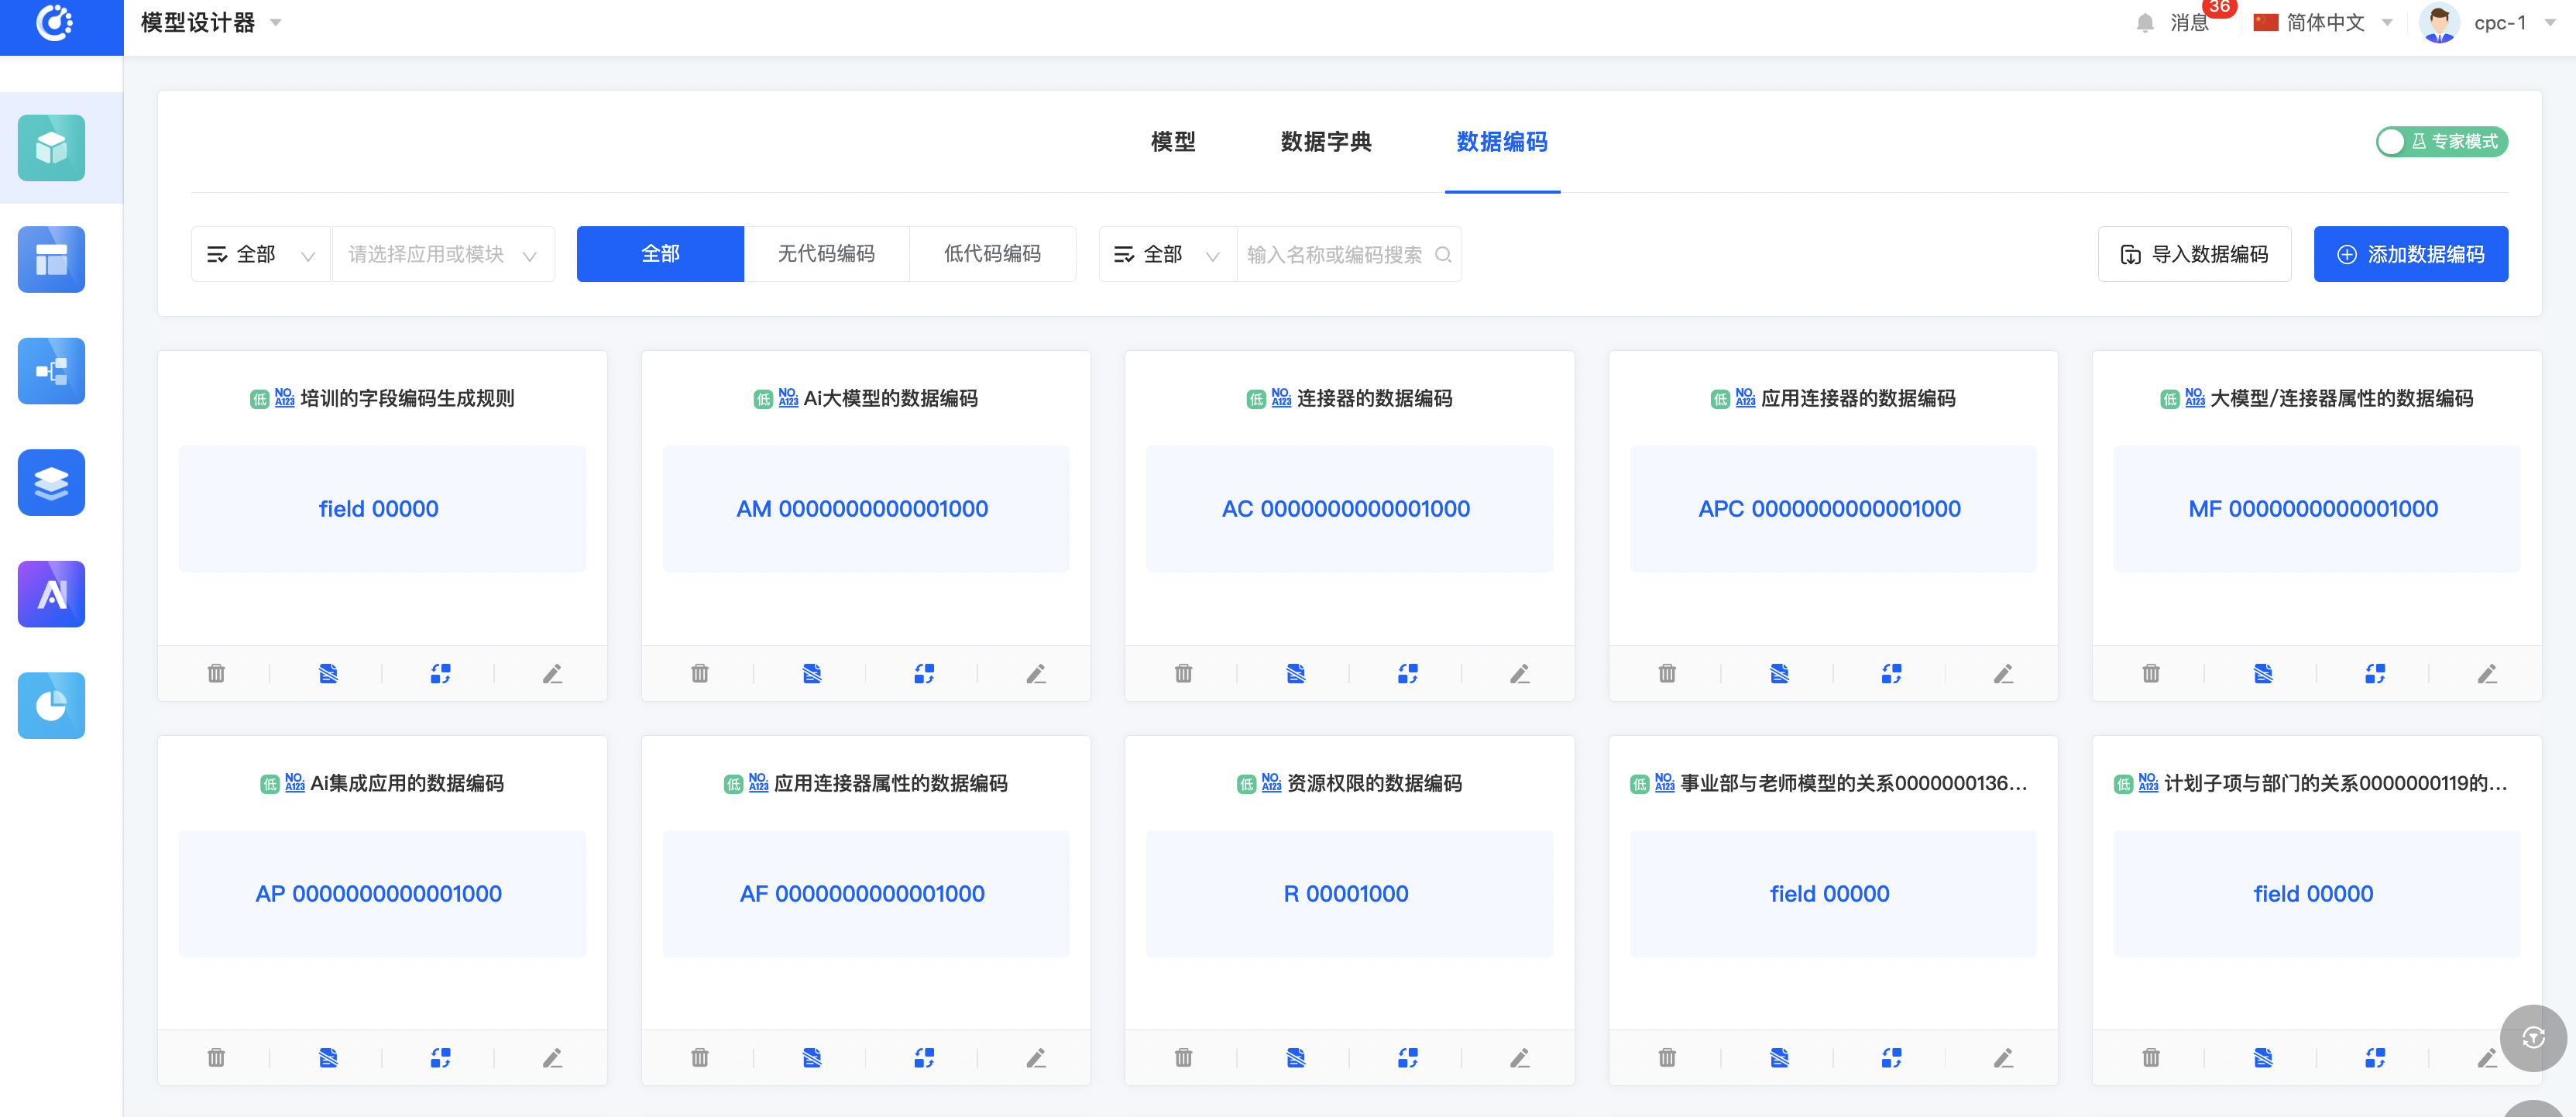
Oinone以模型为驱动,当有模型、数据字典、数据编码等设计功能,我们就可以完整地定义产品数据模型,模型设计器整体呈现区别于普通ER图,以当前模型为核心视角展开,可以点击关联模型切换主视角。这样的好处在于突出当前设计,聚焦设计本身。同时模型上预留了几个核心入口如:分类管理、继承拓扑图、页面设计、逻辑设计等。另外我们在体验上区分了专家模式和经典模式,顾名思义,专家模式的功能会更加丰富,对专业知识的要求也会更高。专家模式下一般会增加一些跟业务无关的配置如:索引设置等调优行为
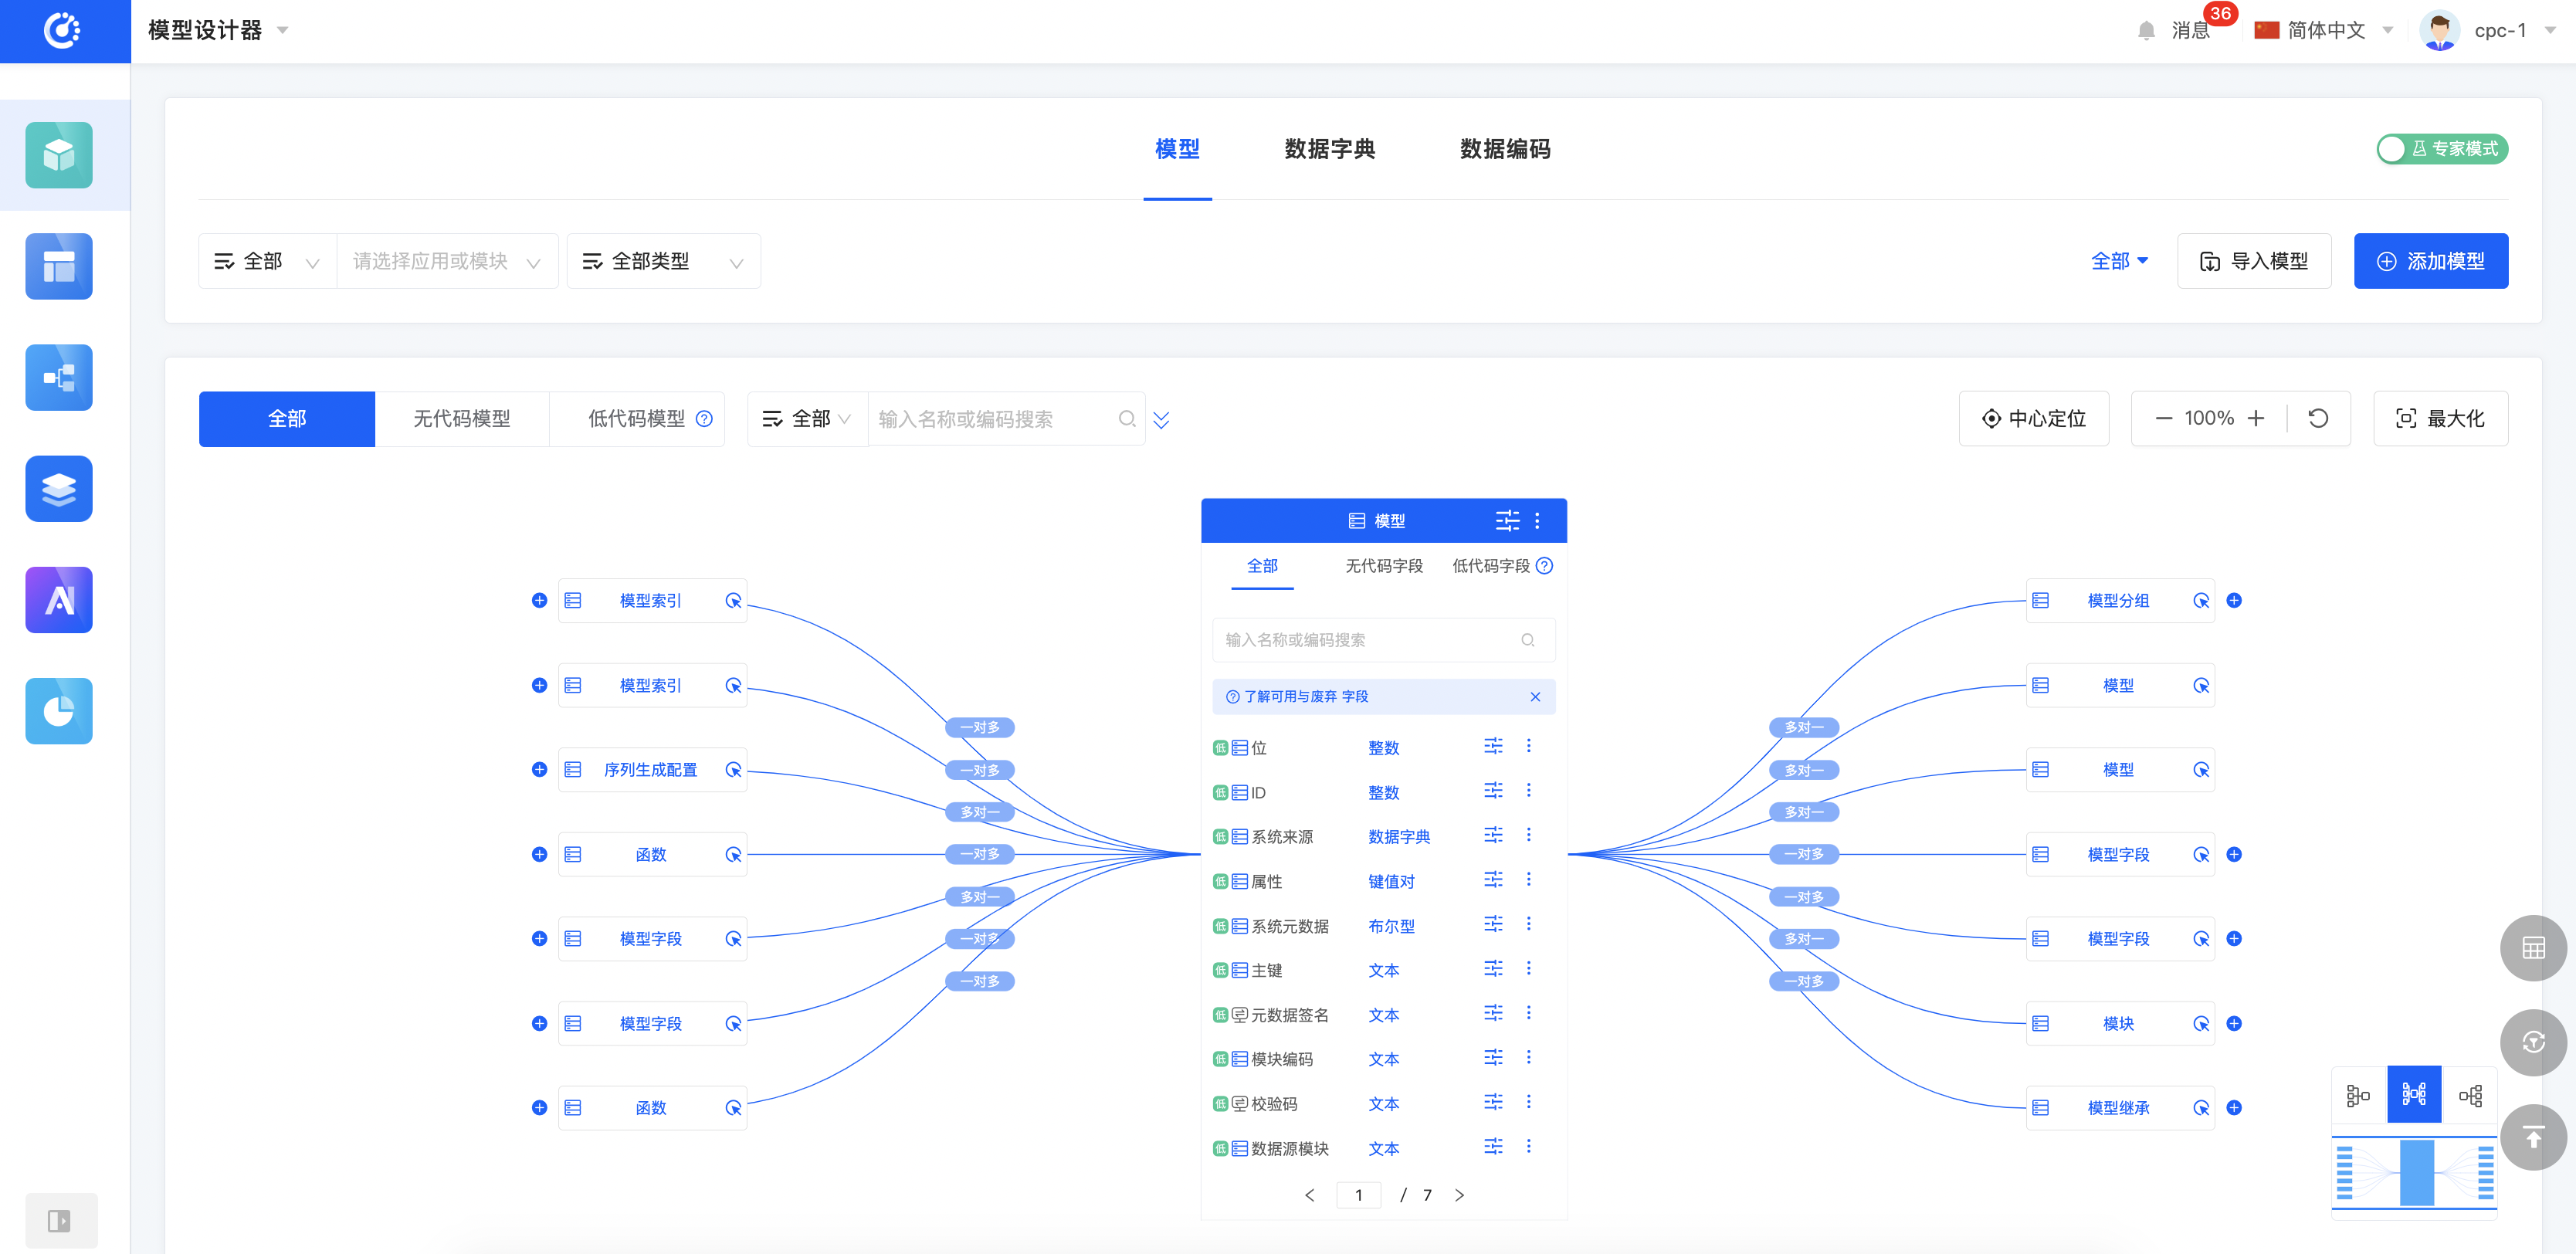
image.png

image.png

image.png

image.png

image.png

image.png

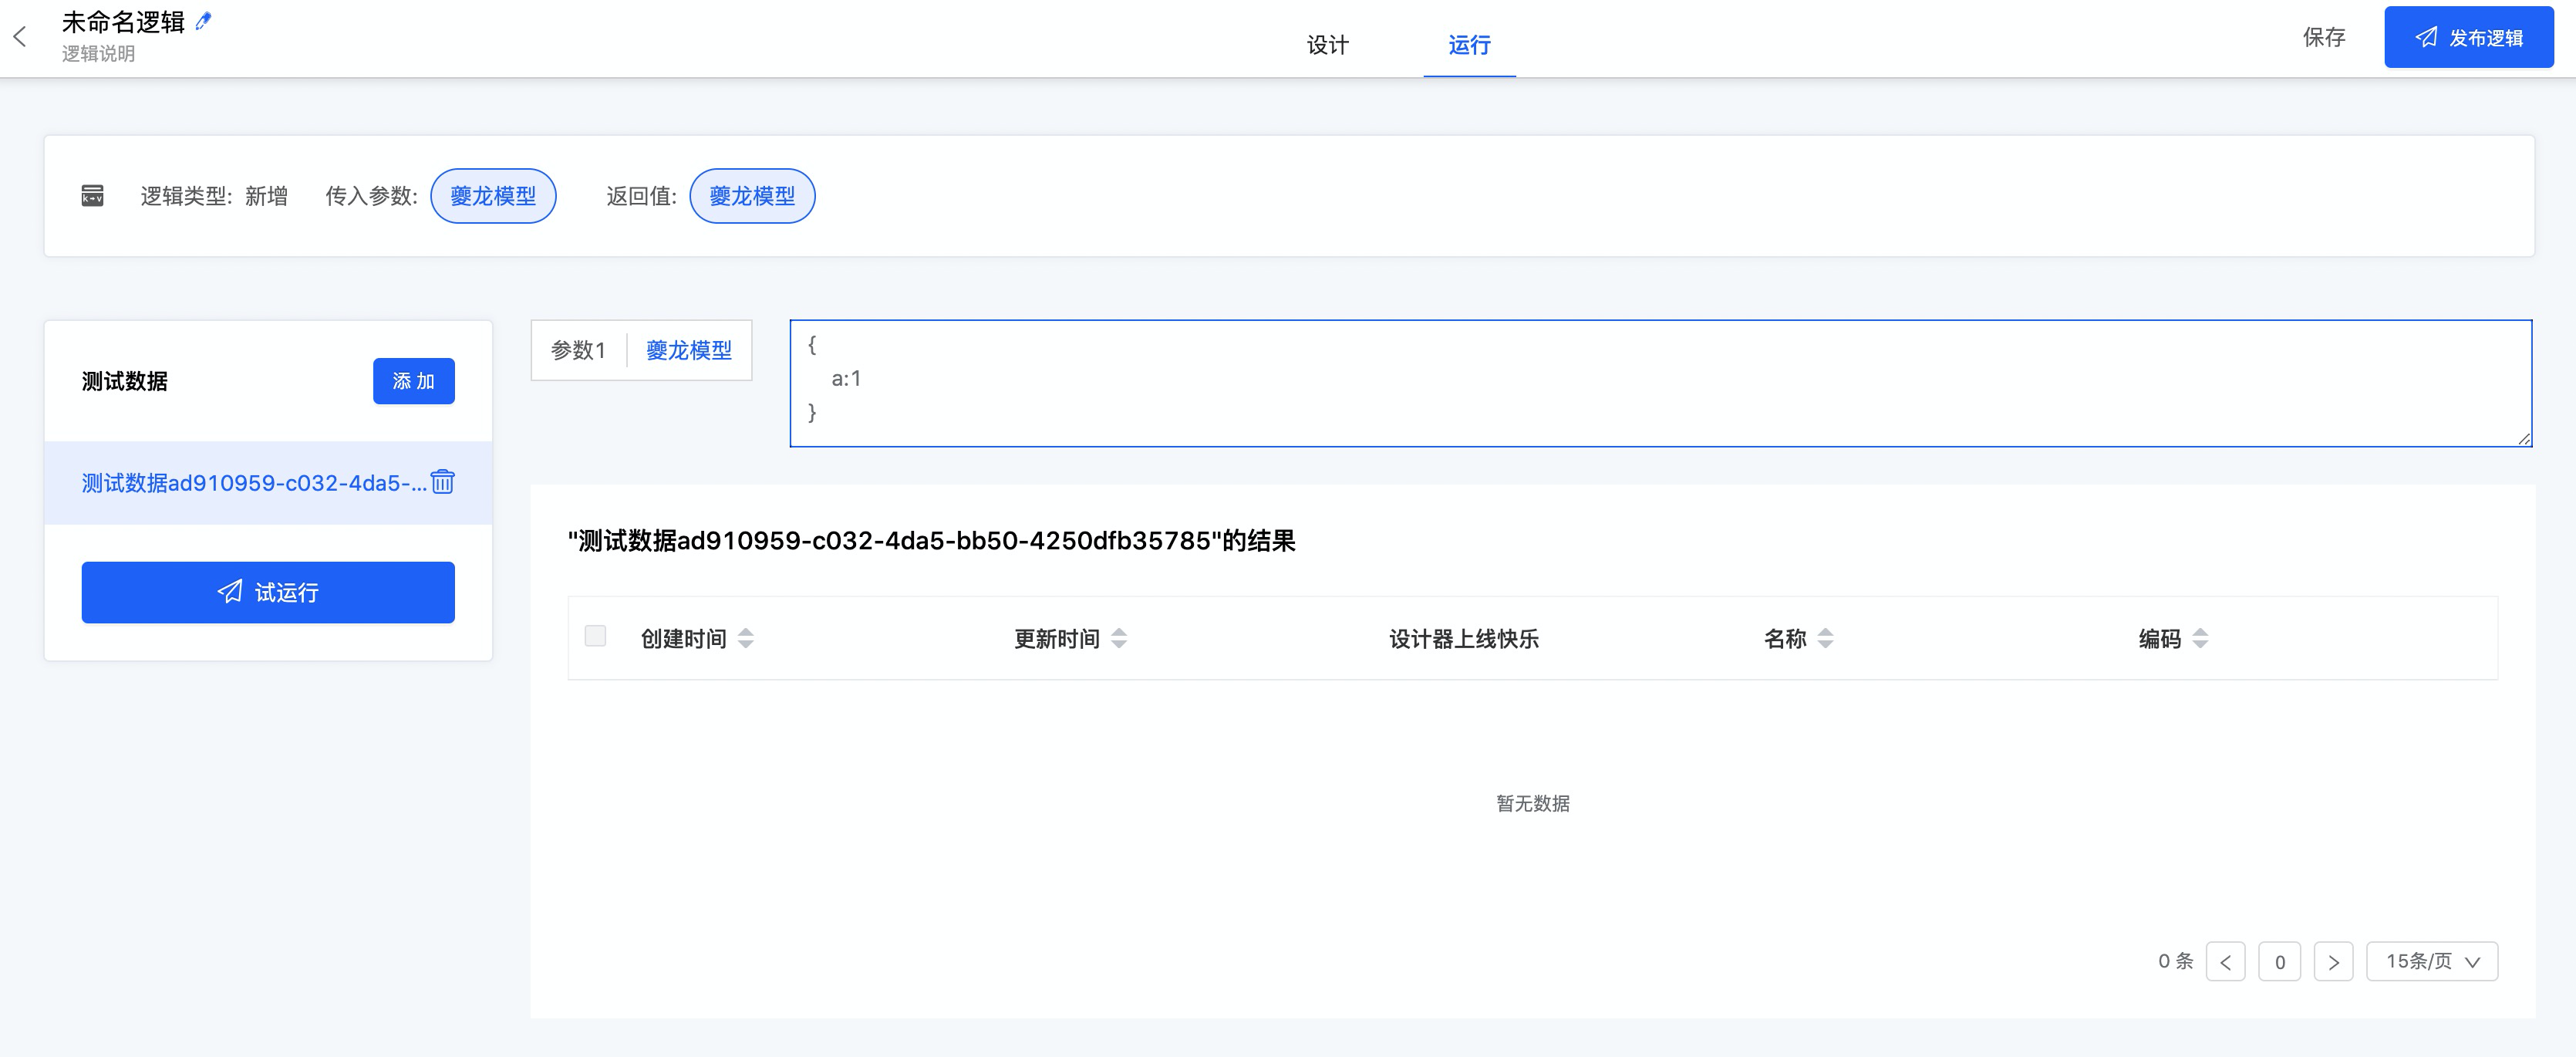
逻辑设计器

从图灵完备的角度上说,要支持功能越完备,使用越复杂。我们优先从图灵完备的角度出发,所以我们第一版逻辑设计器相对比较复杂,第二版本规划中会类似模型设计器推出专家版和经典版。
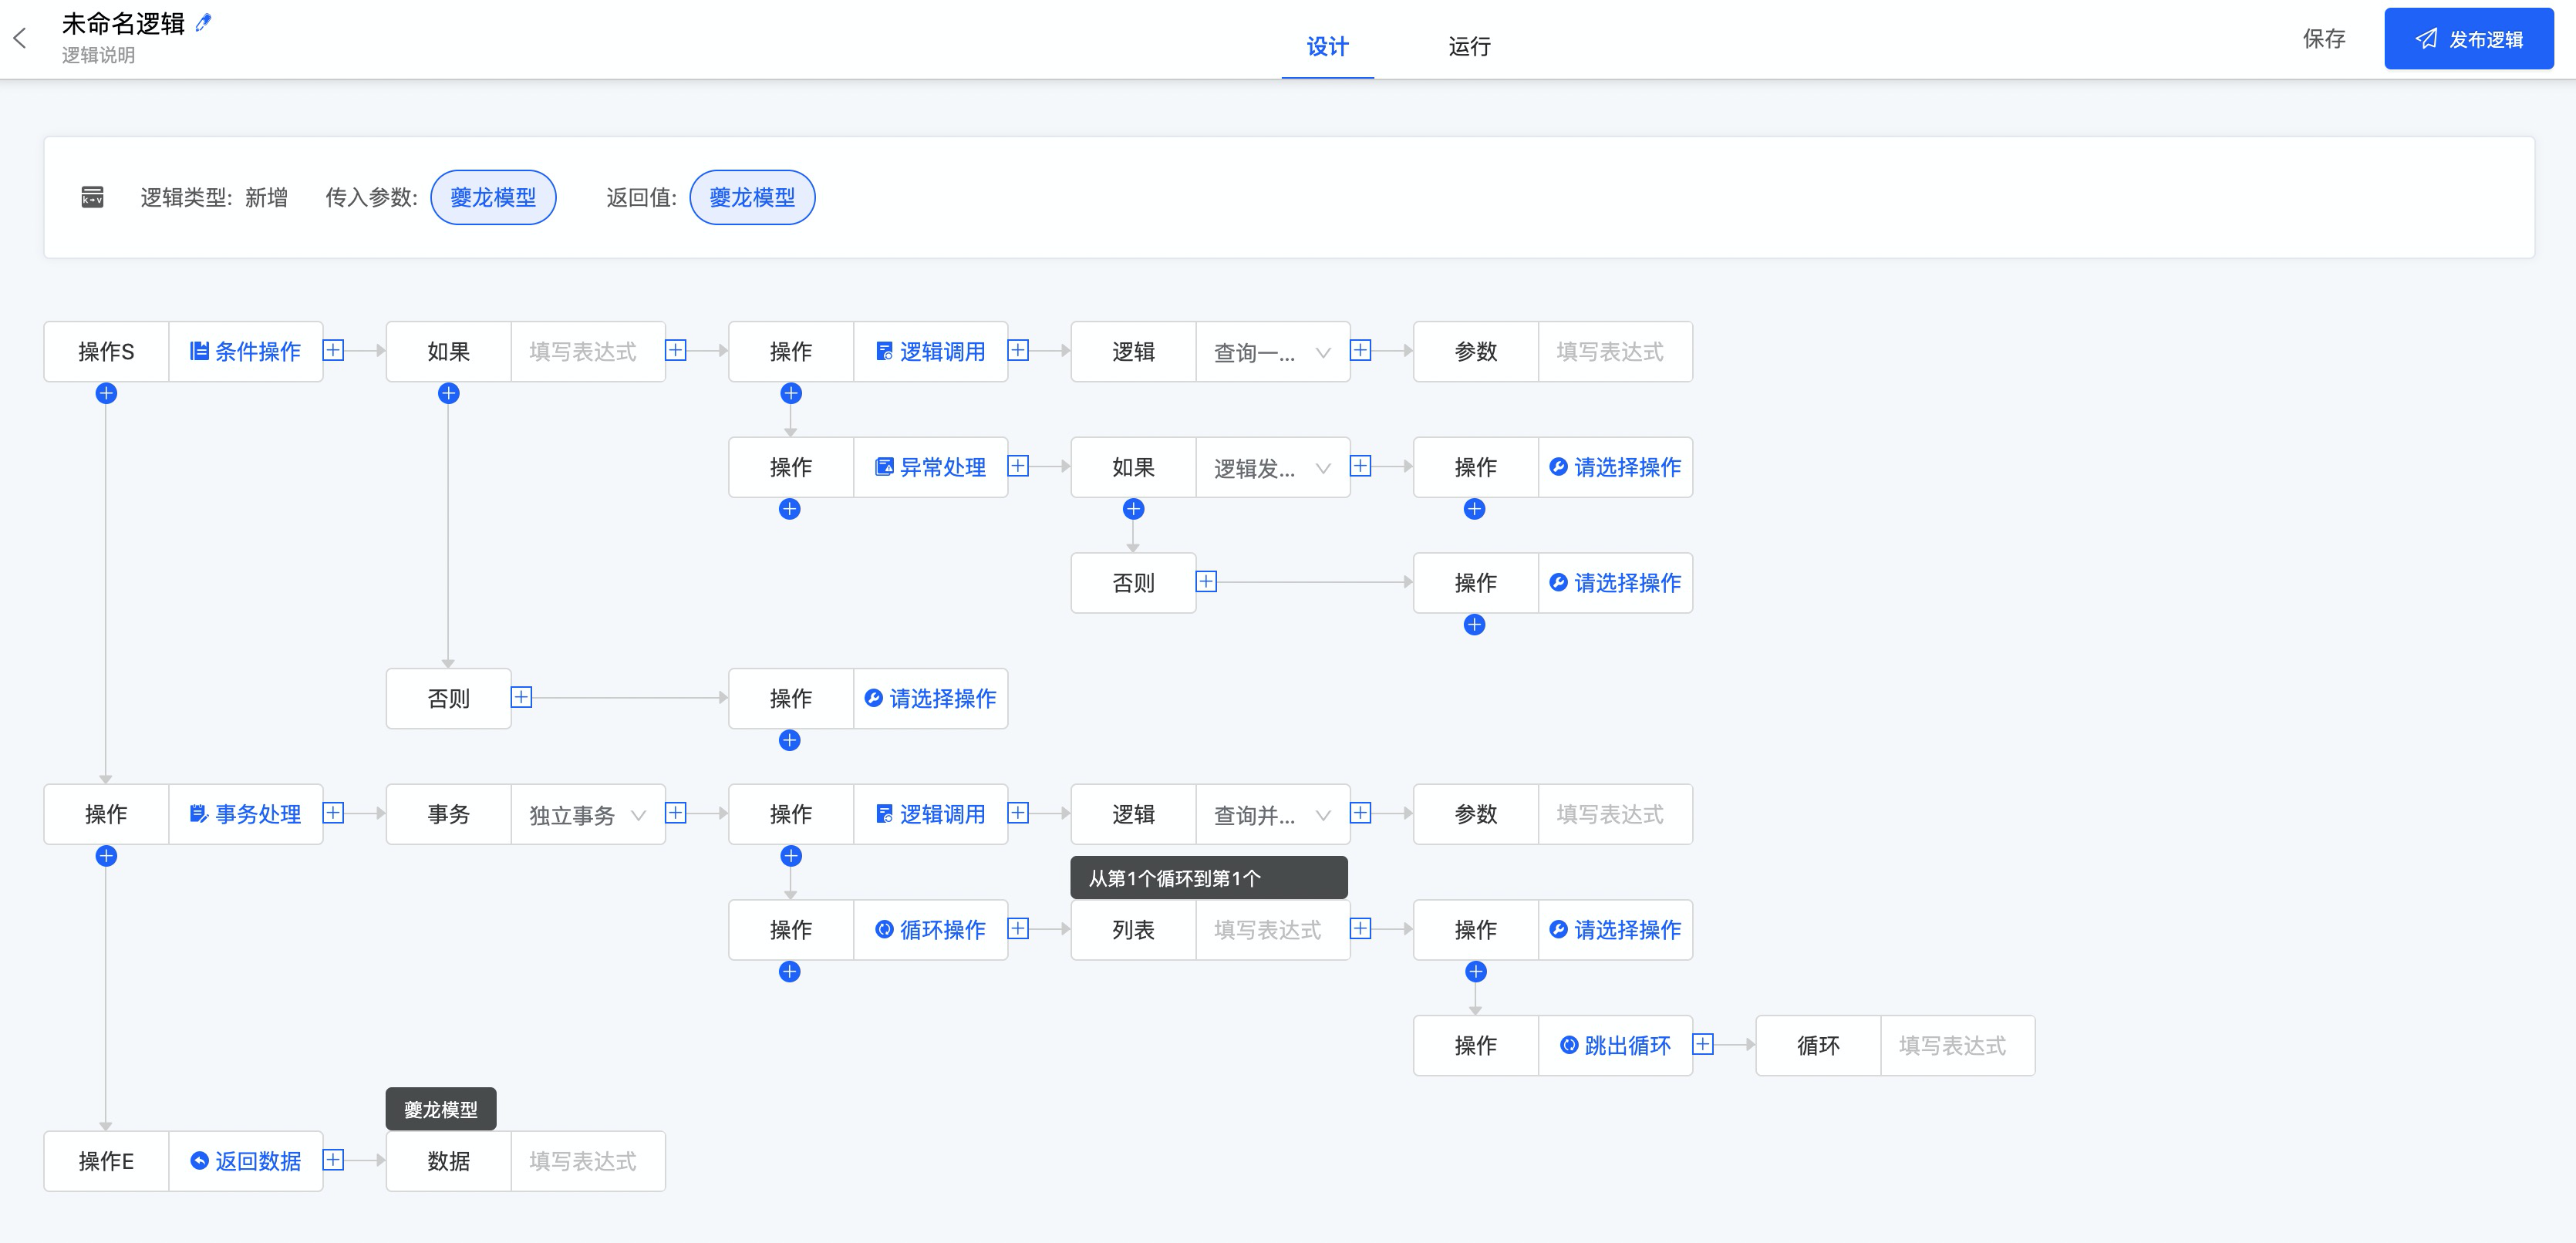
image.png

image.png

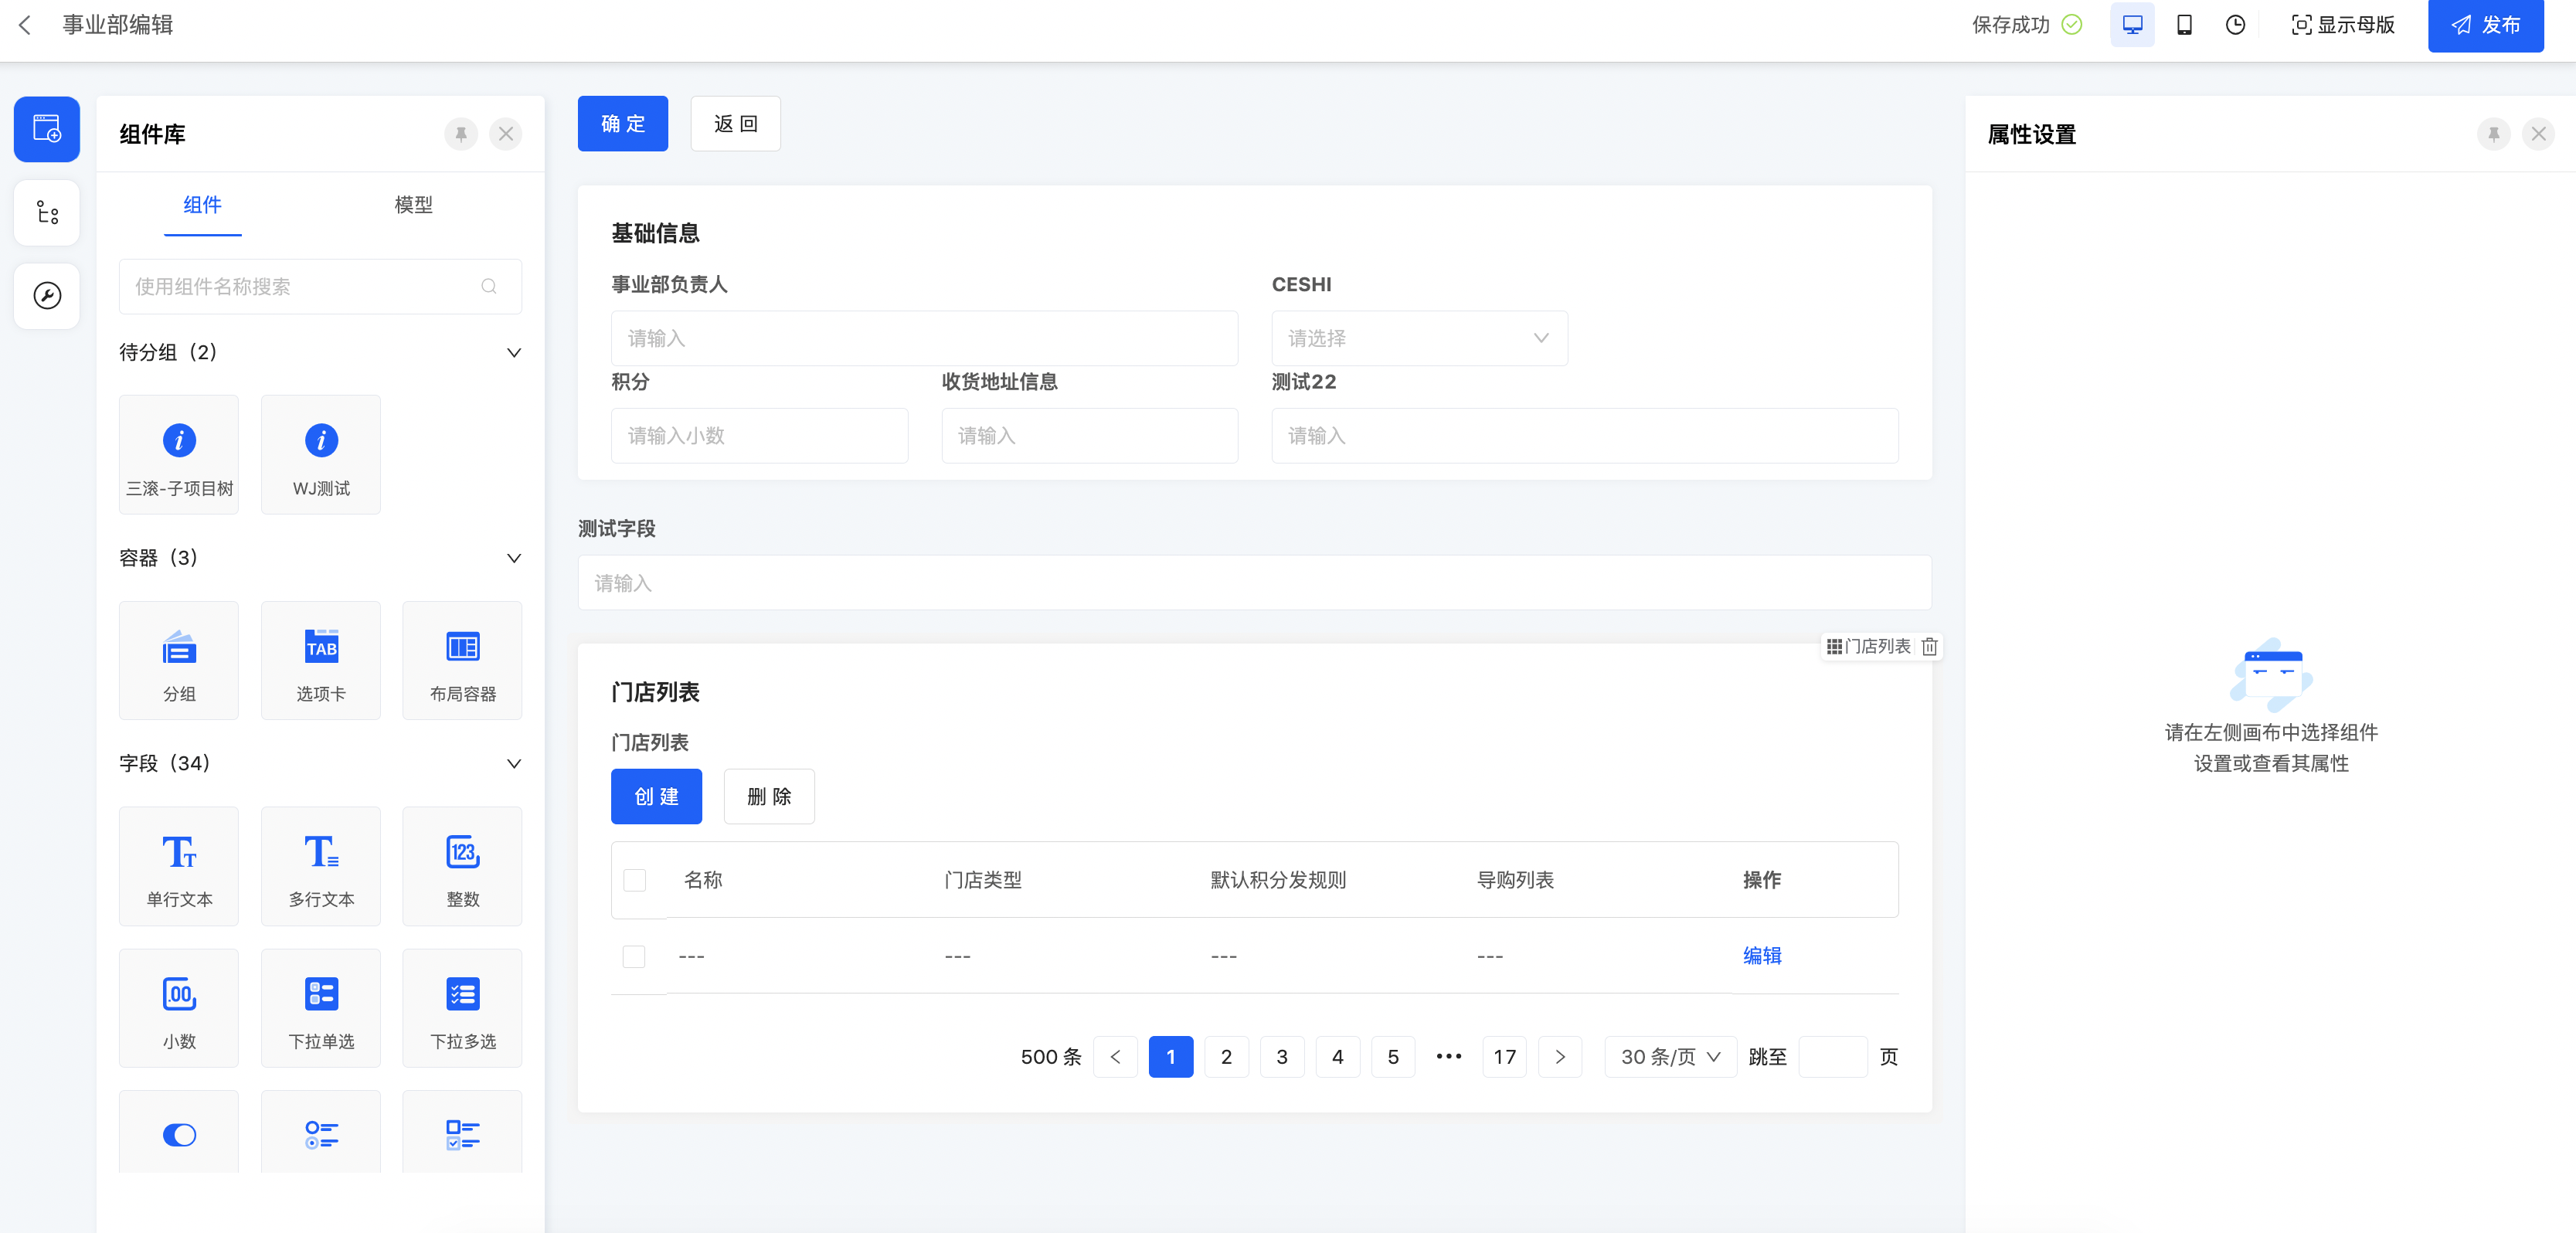
界面设计器

界面设计器第一版会先支撑后端页面在线自定义,后边将陆续推出前端页面、多端能力。为了支持多端和2C页面的设计,我们对前后端协议做了比较大的改造。目前设计器已经支持完全基于V3的前后端协议。
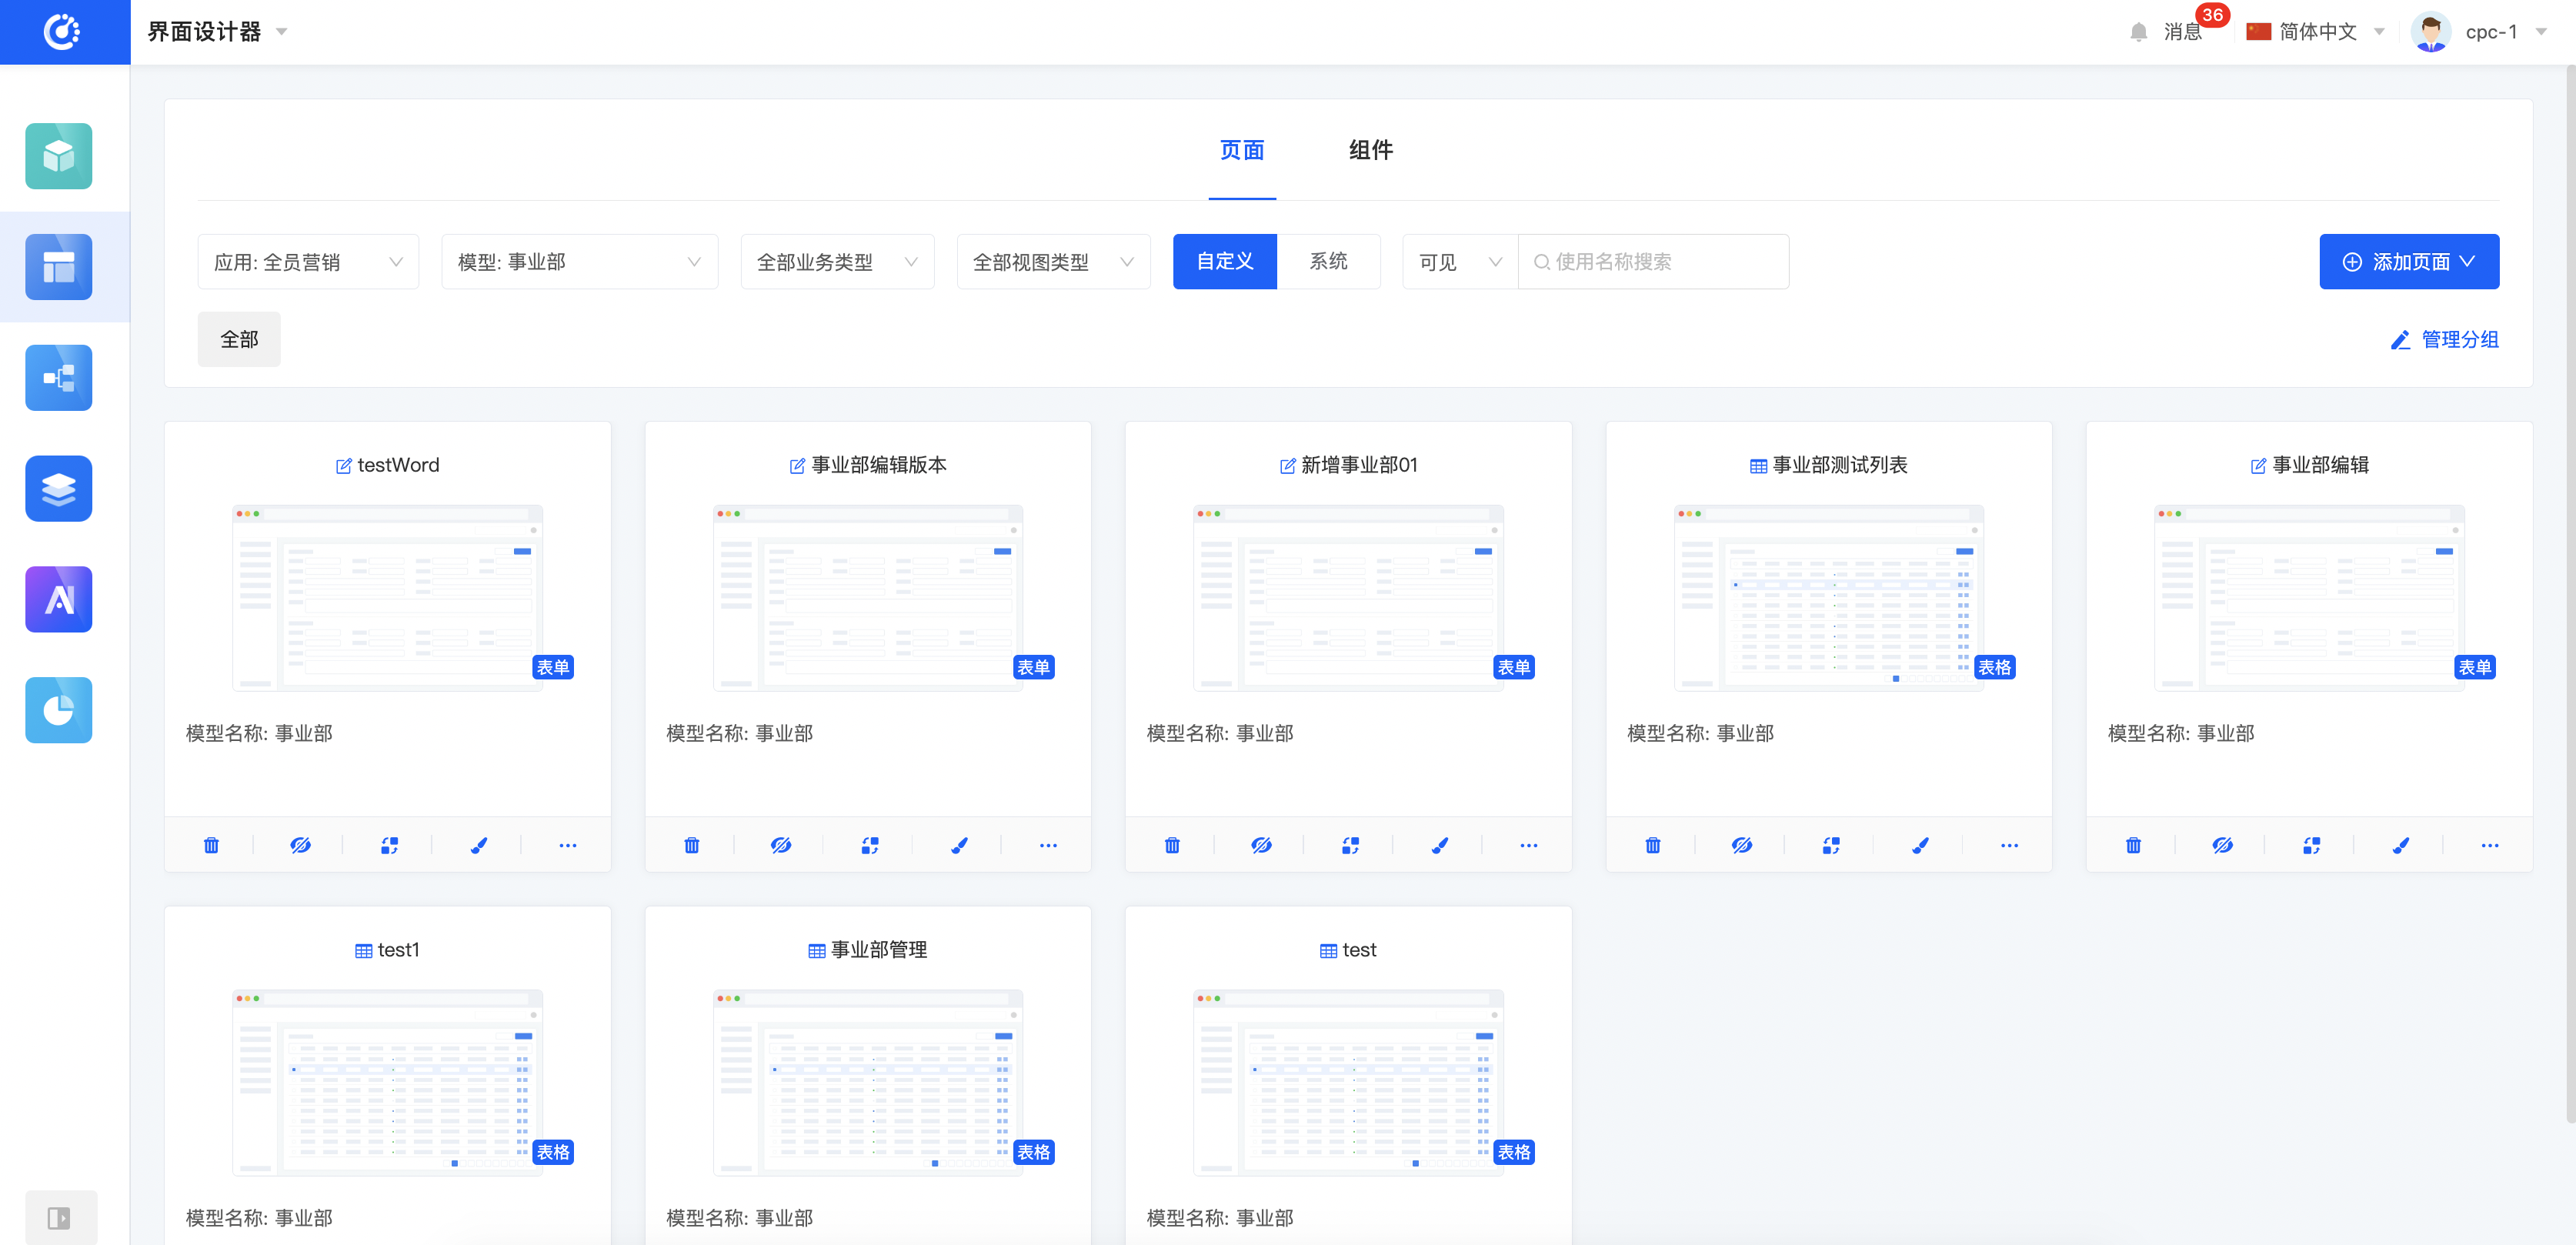
image.png

image.png

数据可视化

数据可视化支持从内部系统模型获取数据内容后,根据业务需求自定义图表,目的是为企业提供更高效的数据分析工具。

与市场同类产品相比,我们的数据可视化产品:不需要前置维护数据源、进行数据转换;可智取业务系统模型,系统自动解析选择的模型、接口、表格中的字段后进行数据分析;降低对数据分析人员研发能力要求的同时,也提升了数据分析的效率。
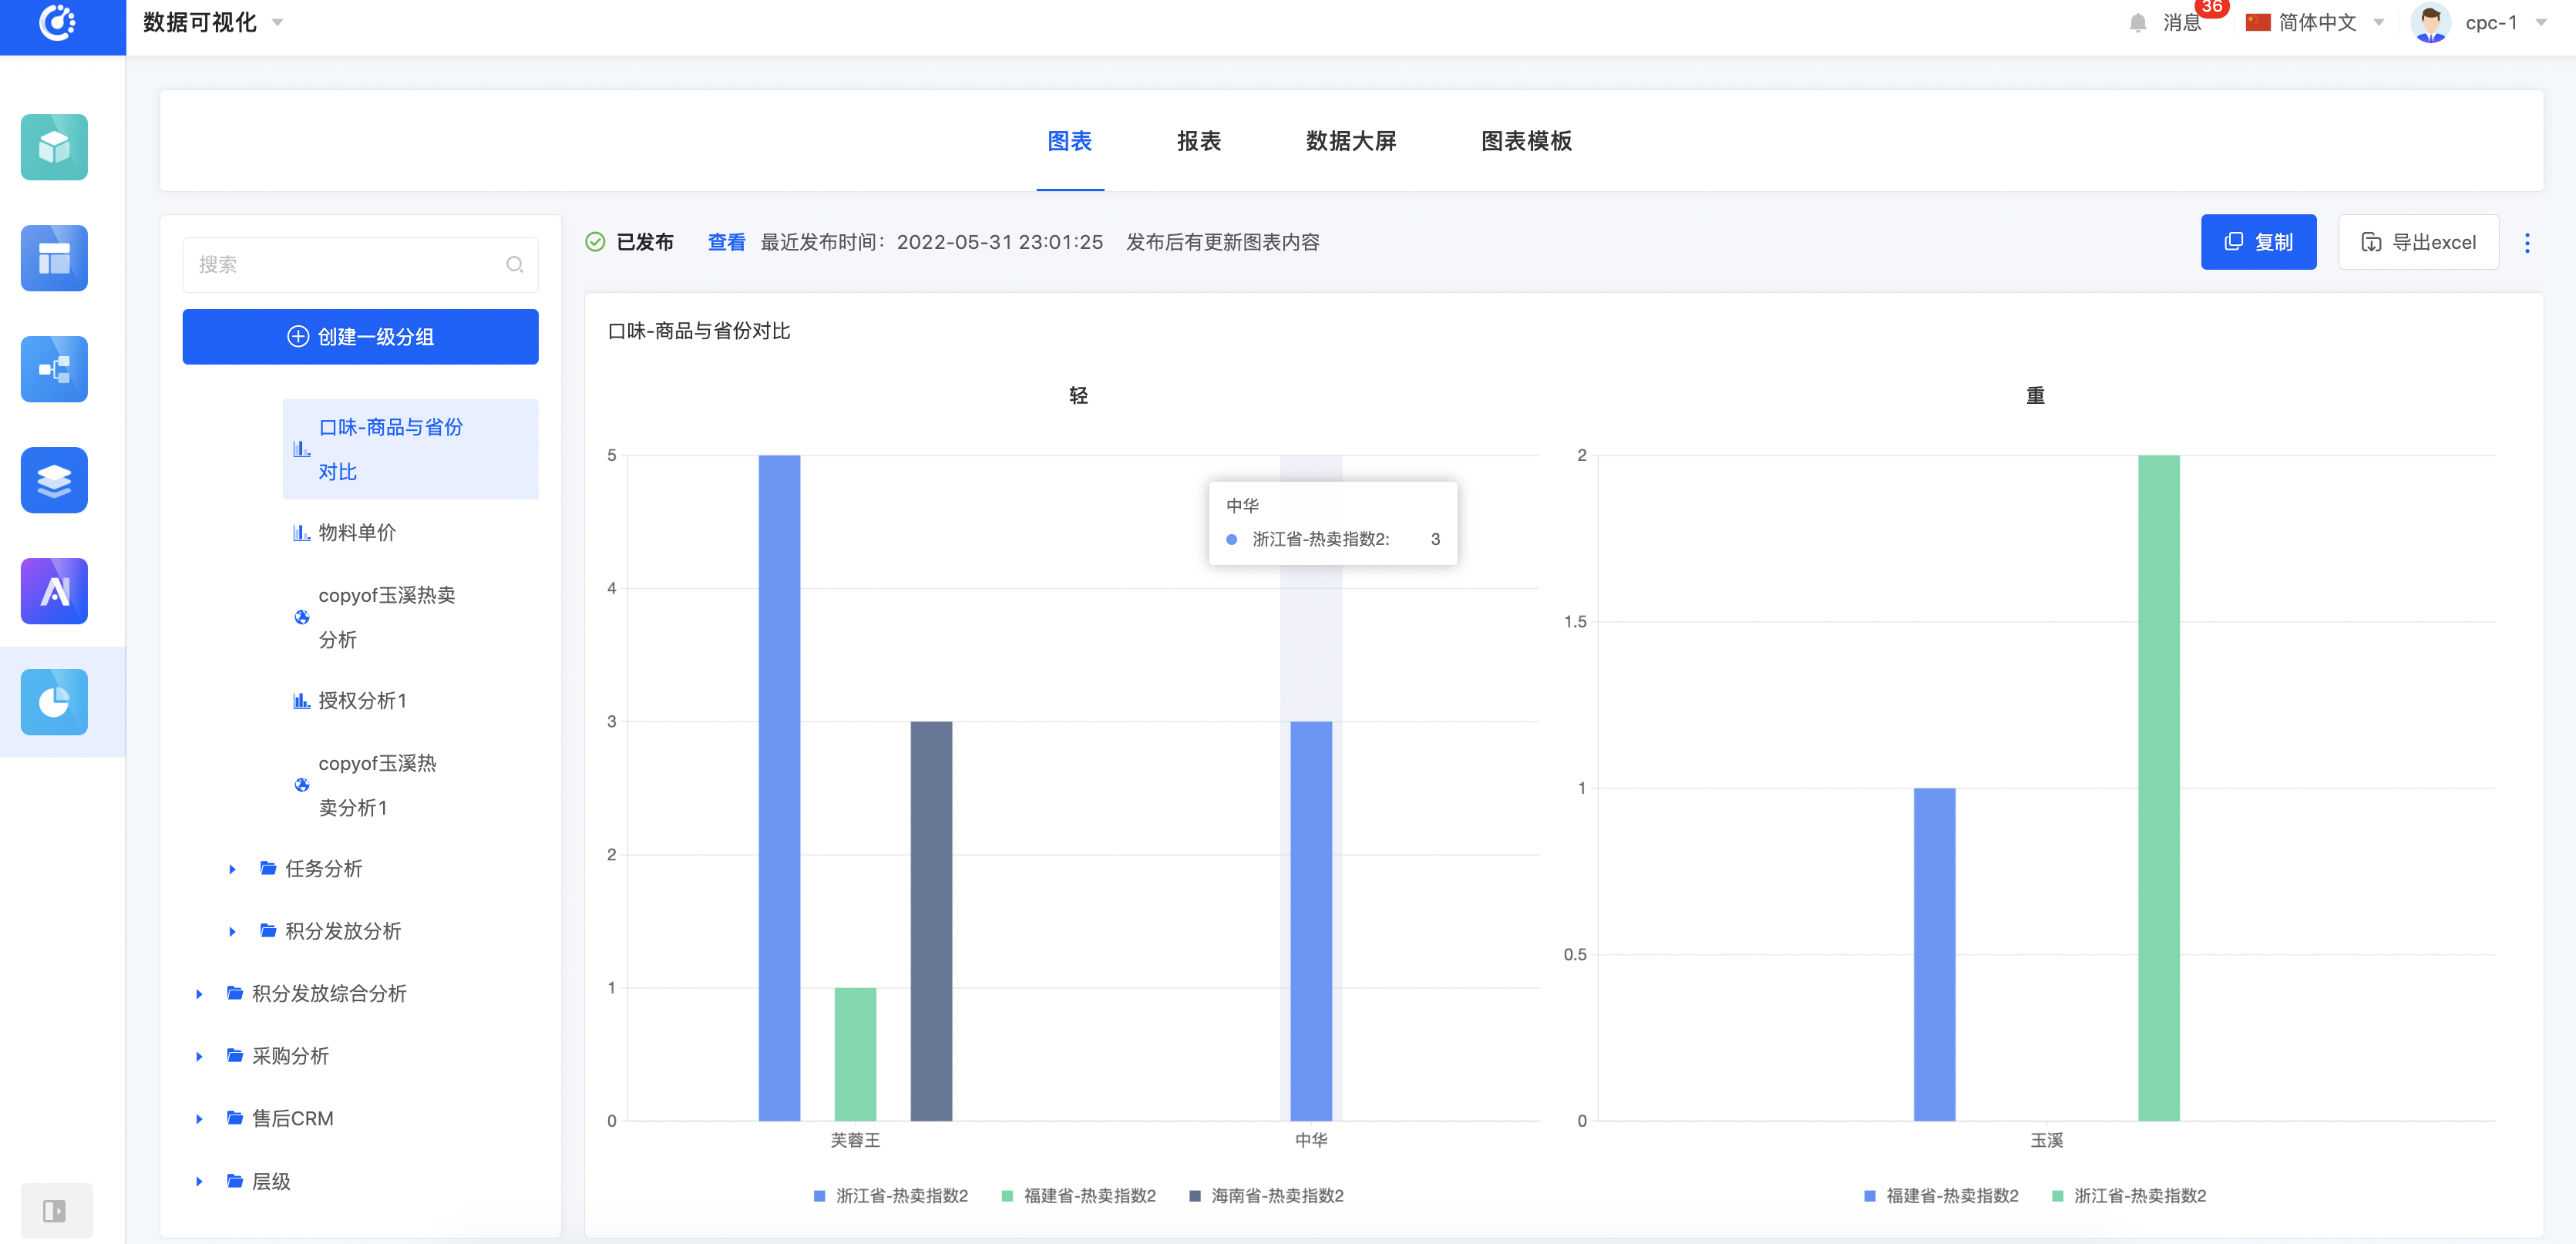
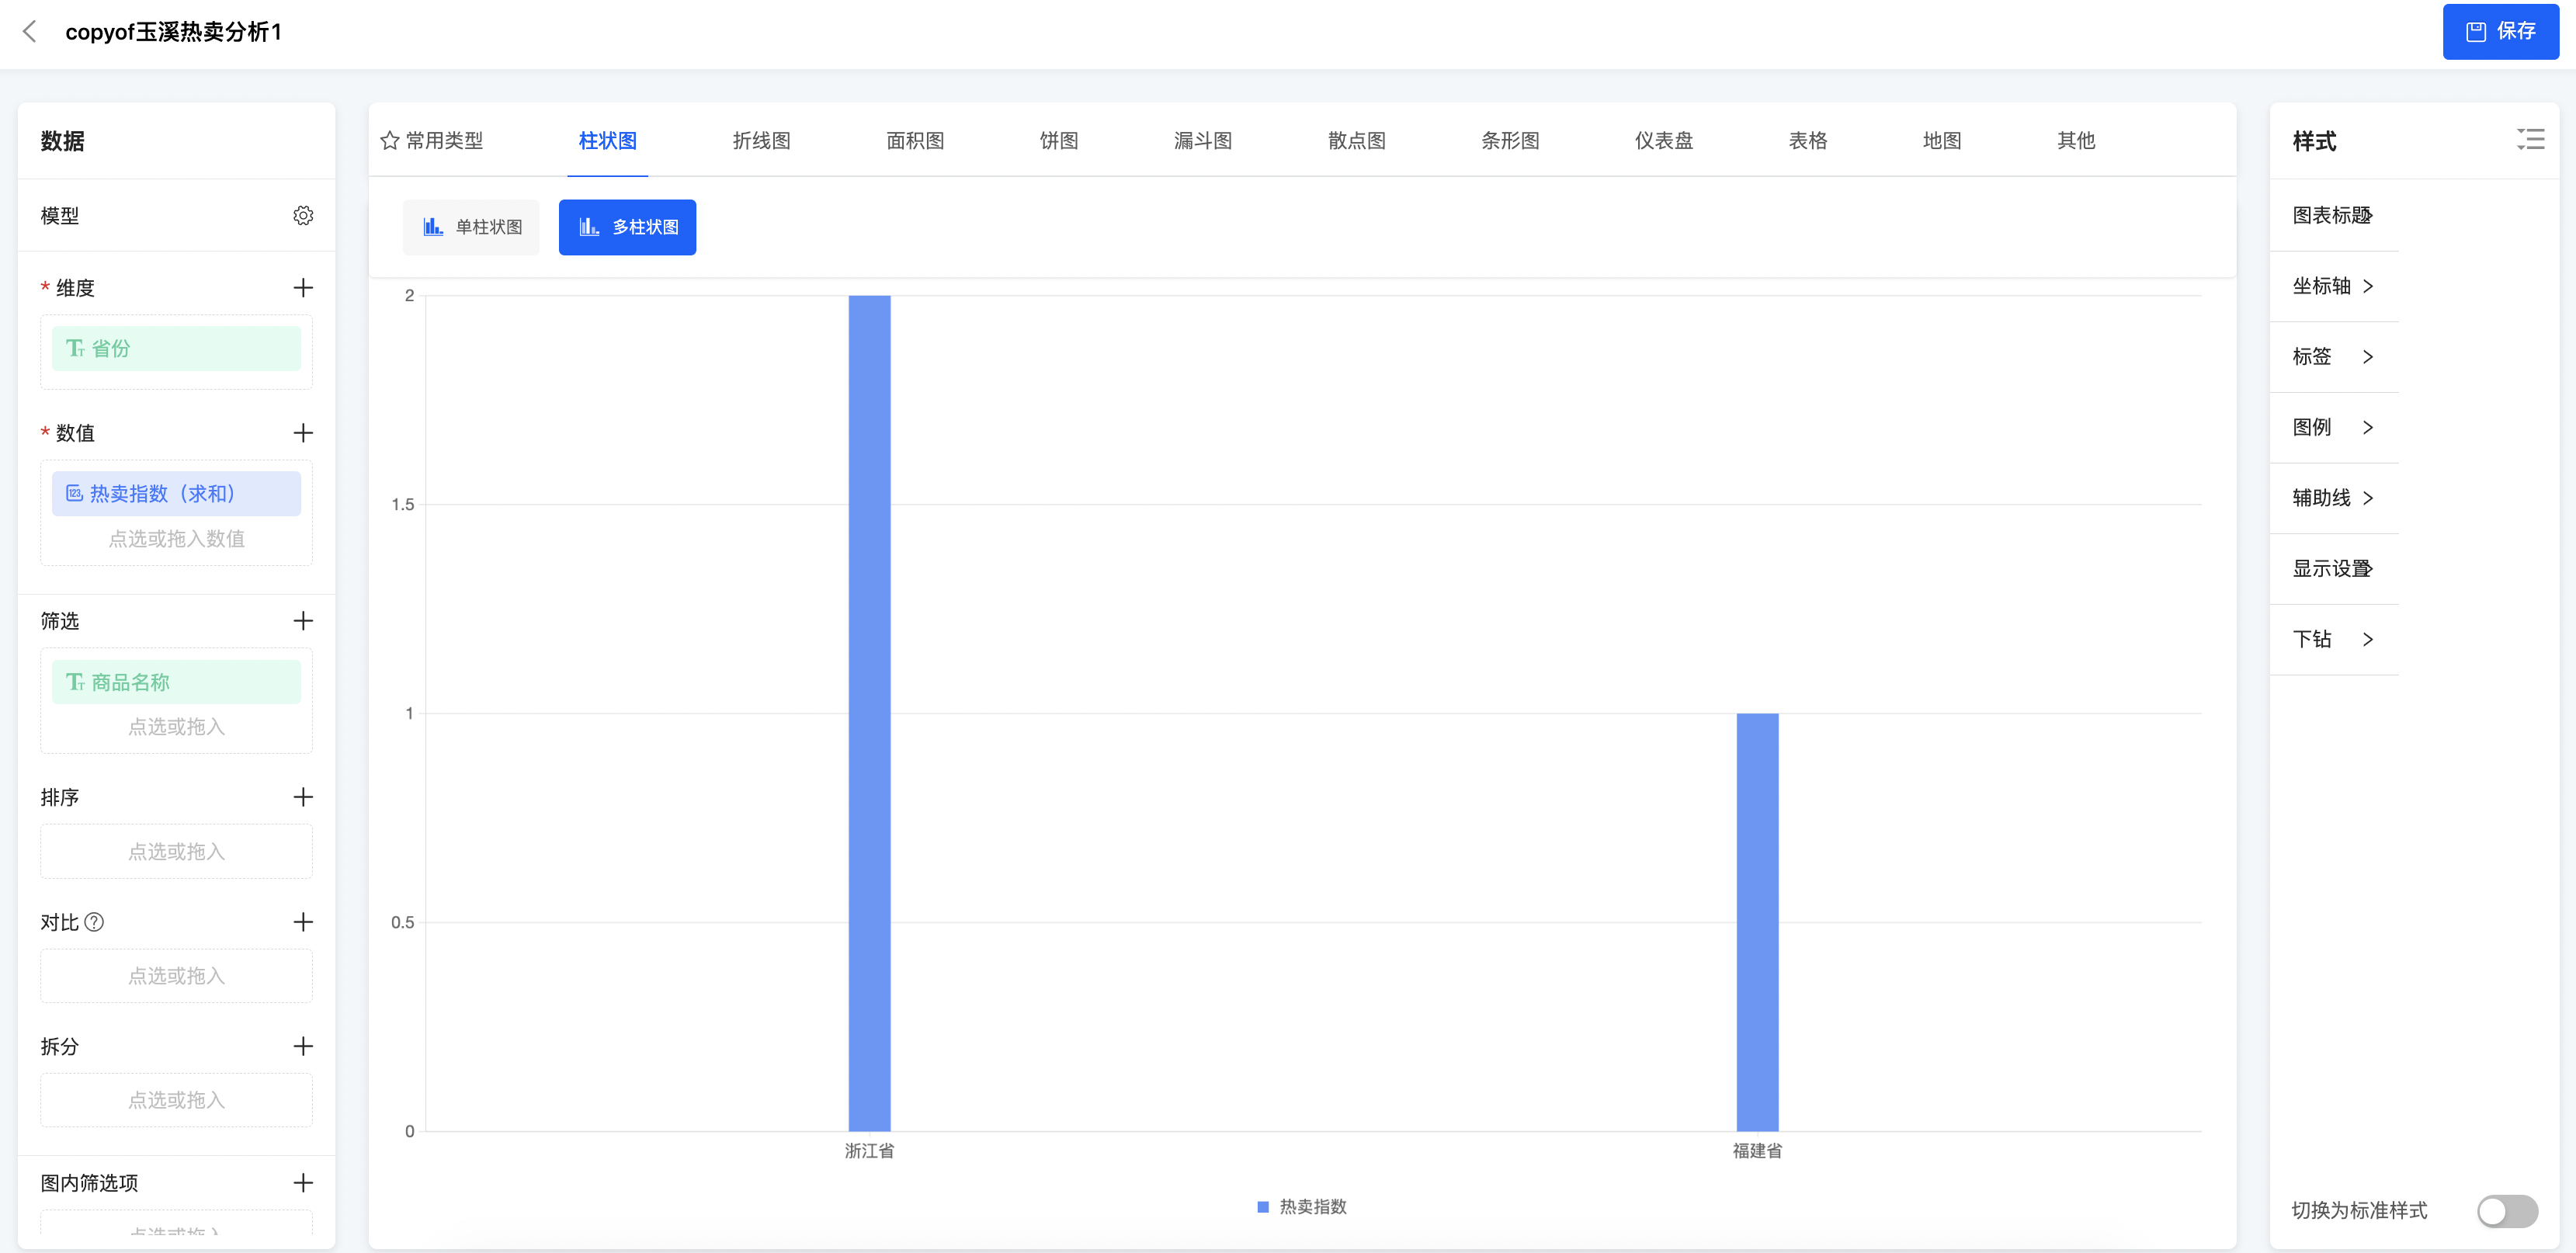
image.png

image.png

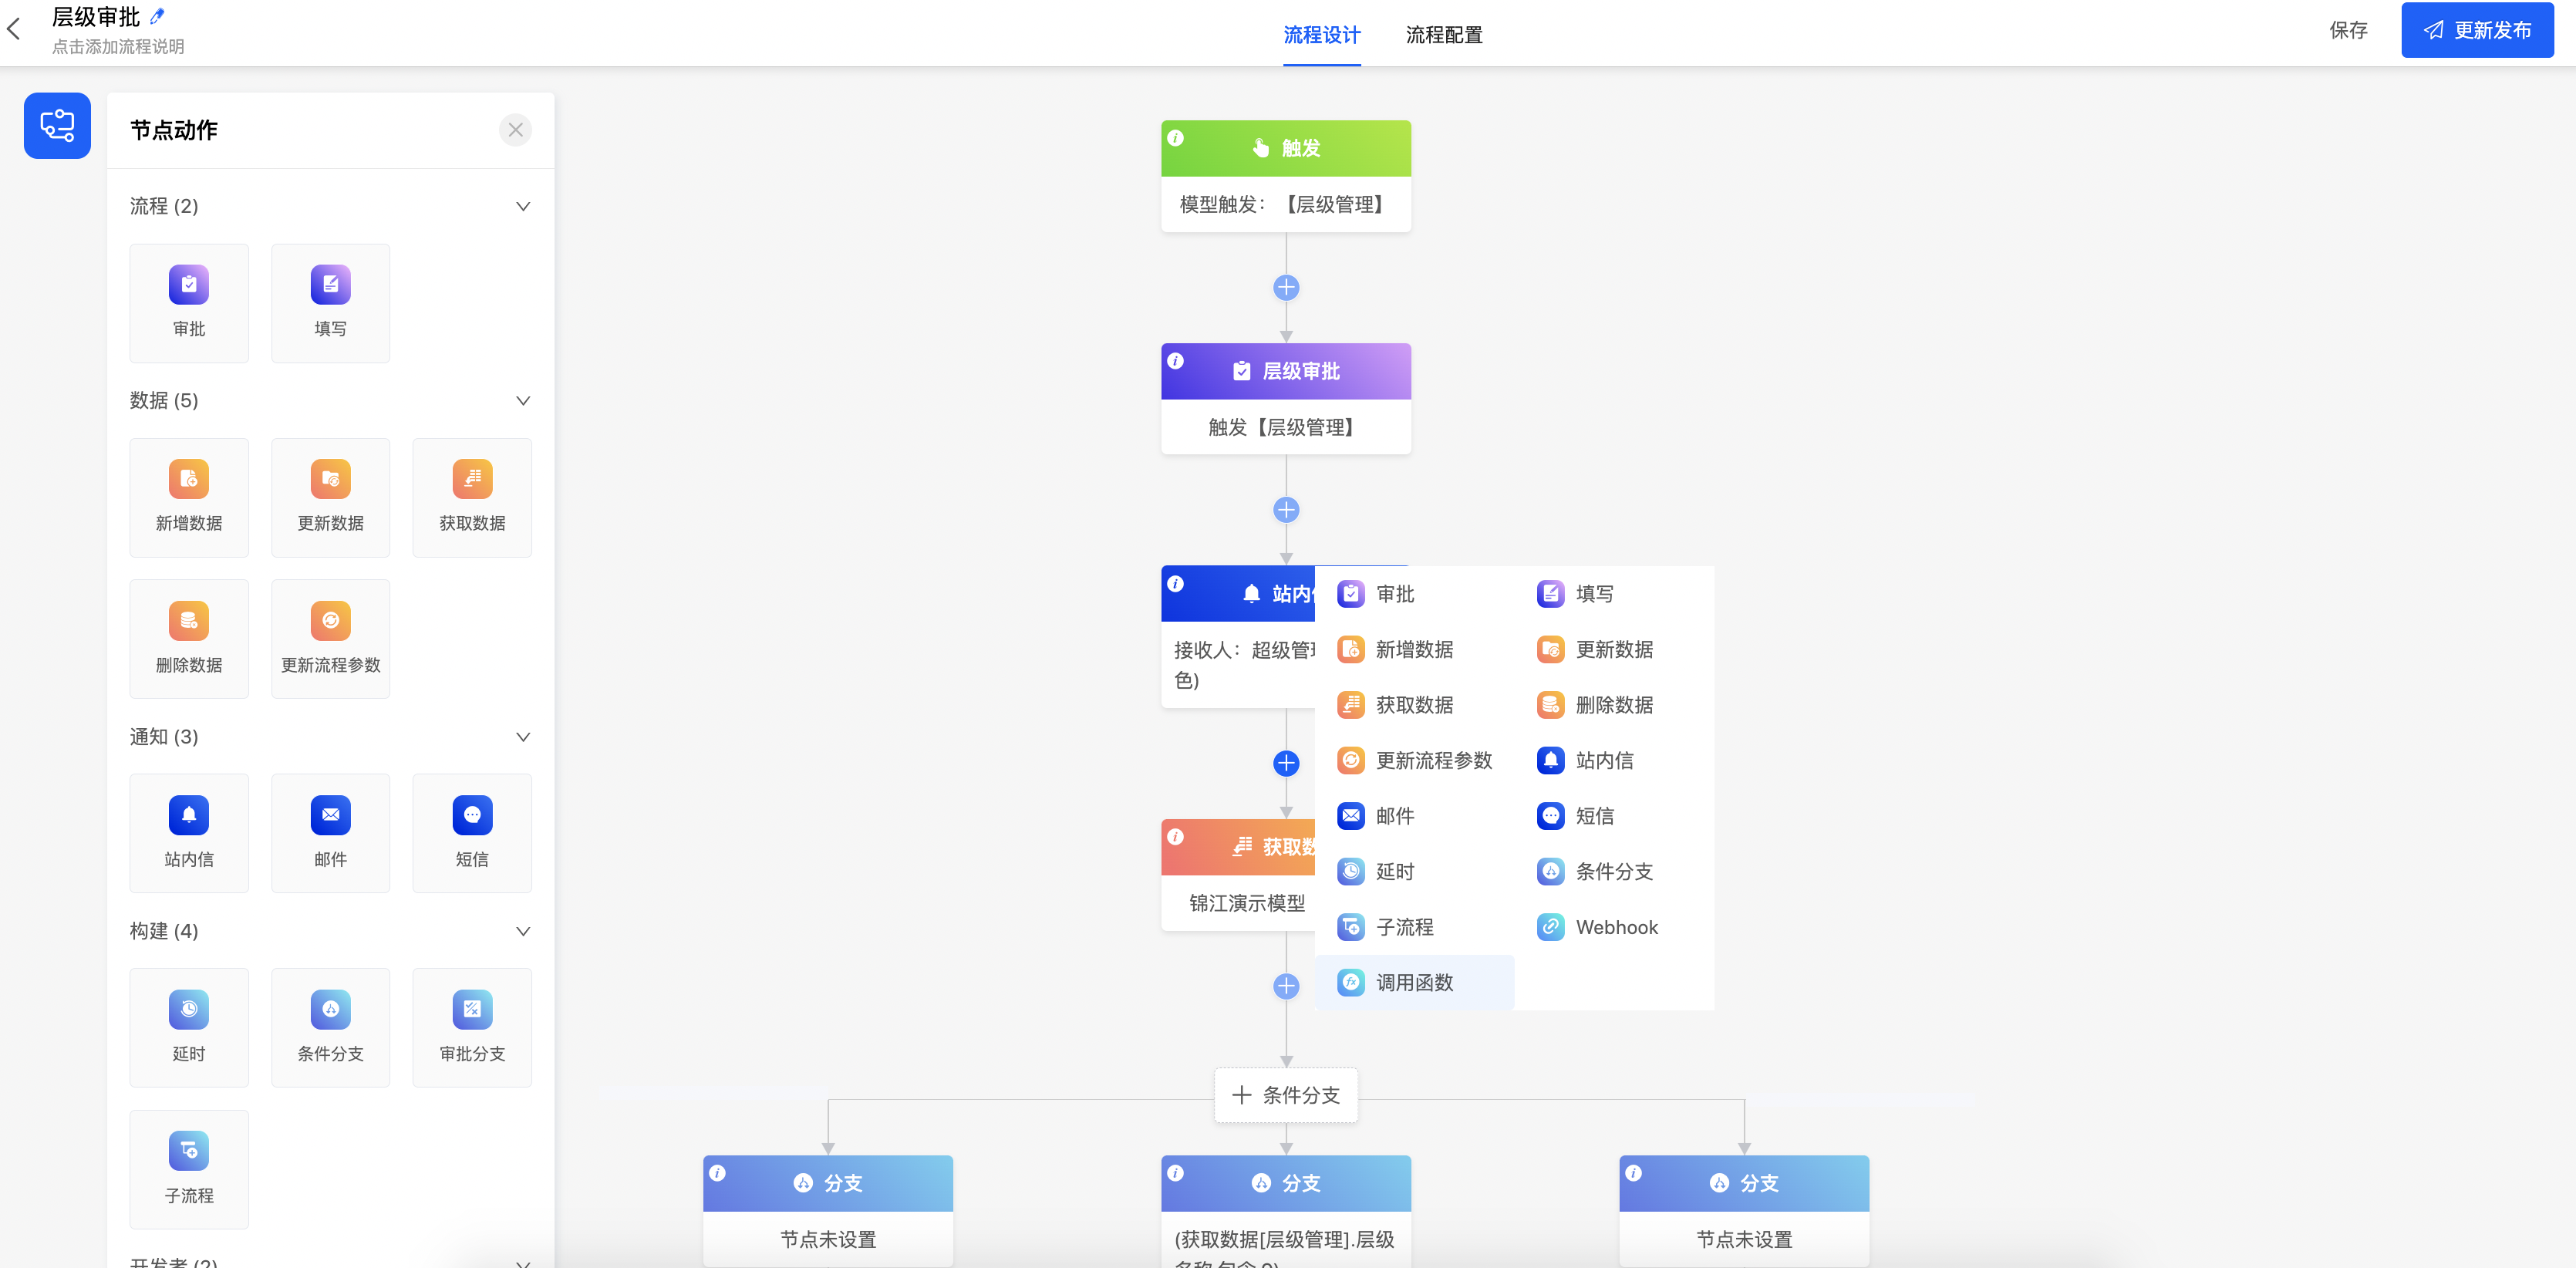
流程设计器

Oinone流程设计器为业务流程和审批流程提供了可自动执行的流程模型:通过定义流转过程中的各个动作、规则,以此实现流程自动化。在Oinone流程设计器中,流程可以跨应用设计,不同应用的模型之间可以通过同一流程执行。
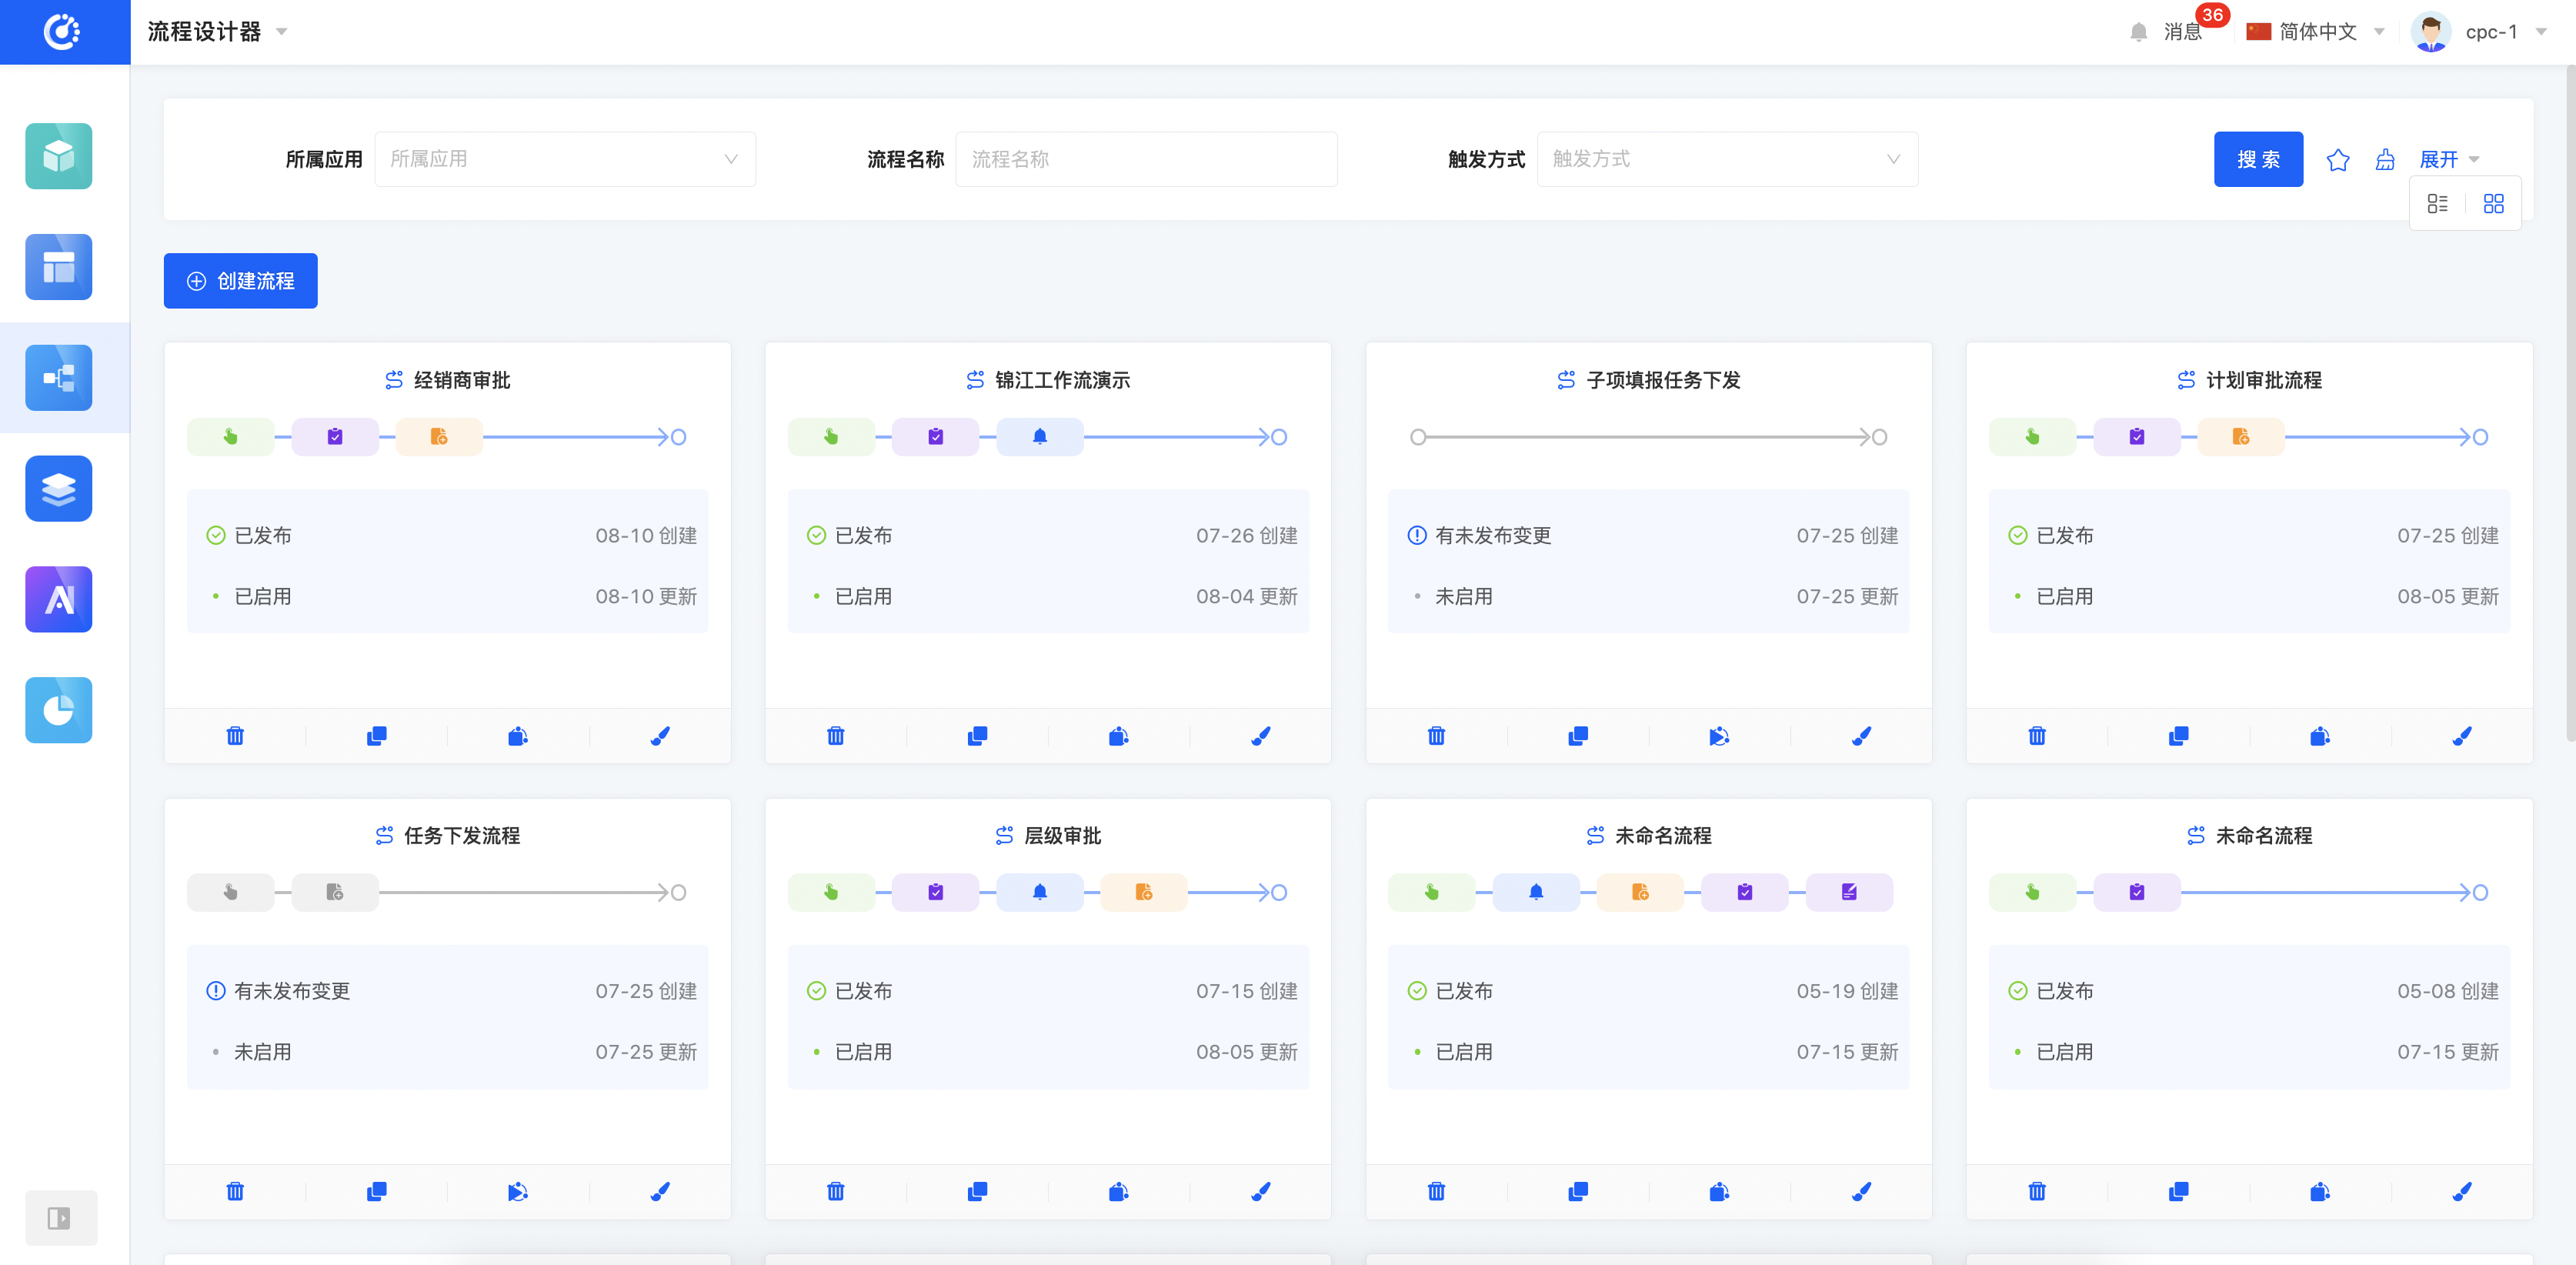
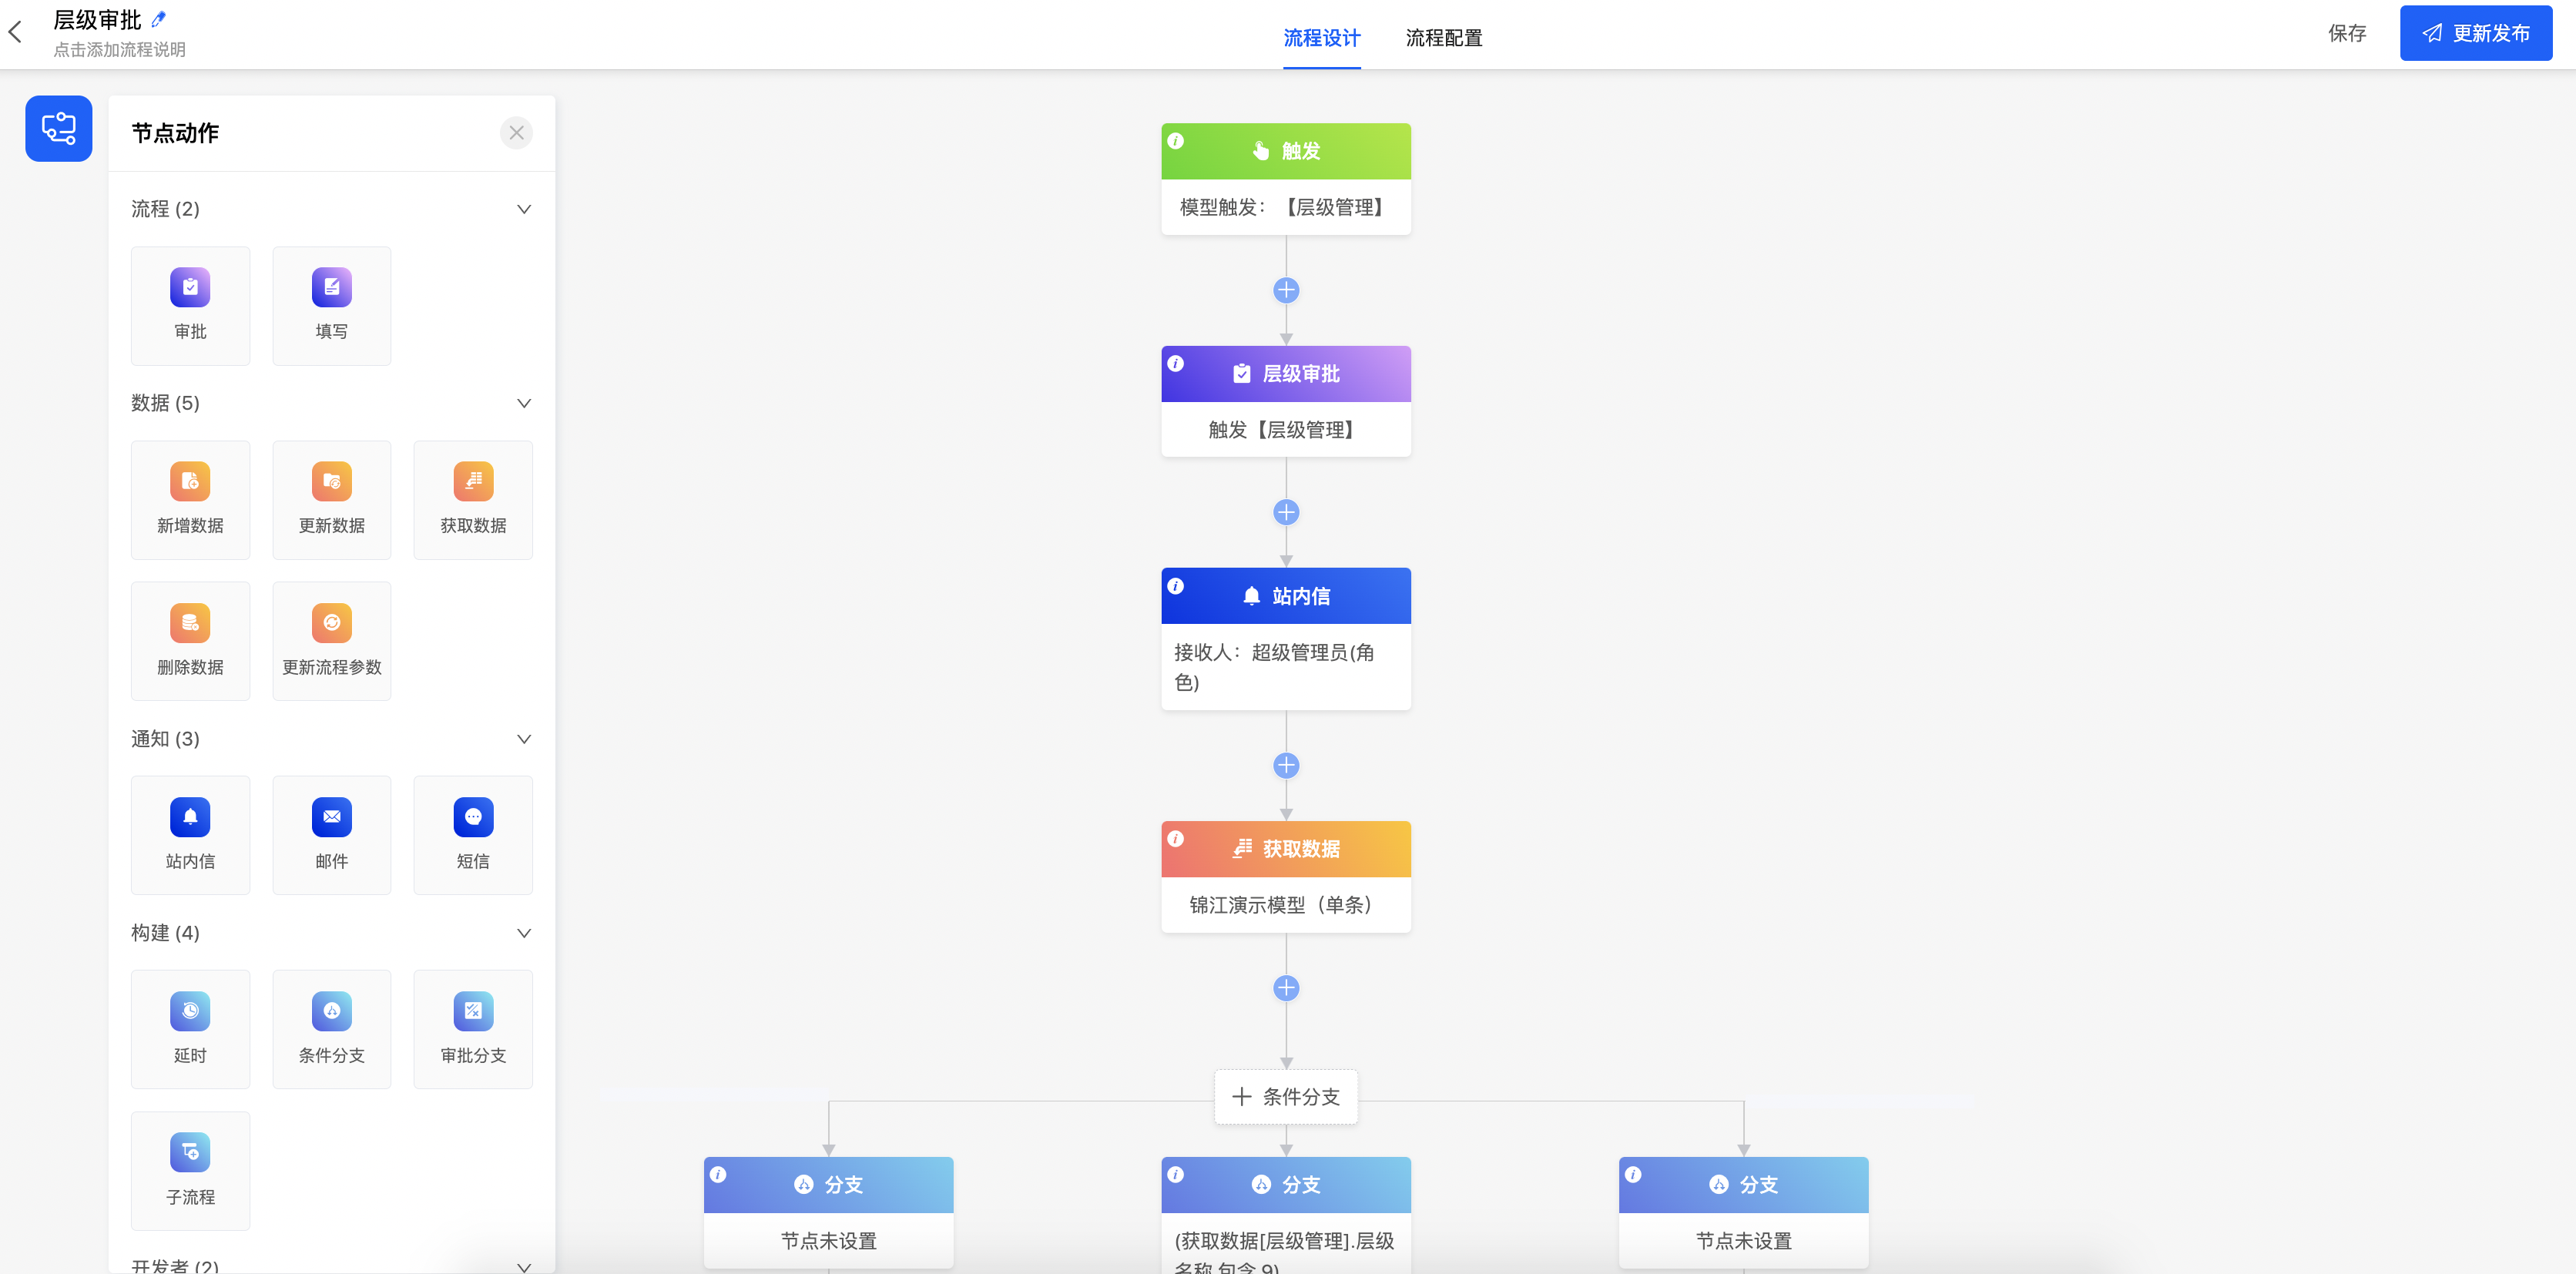
image.png

image.png

image.png

Oinone社区 作者:史, 昂原创文章,如若转载,请注明出处:https://doc.oinone.top/oio4/9333.html

访问Oinone官网:https://www.oinone.top获取数式Oinone低代码应用平台体验

Like (2)
史, 昂's avatar史, 昂数式管理员
Previous 2024年5月23日 am8:05
Next 2024年5月23日

相关推荐

  • 4.1.8 函数之事务管理

    一、事务管理介绍 函数Function支持事务字段为isTransaction(默认为false),事务传播行为propagationBehavior(默认PROPAGATION_SUPPORTS),事务隔离级别isolationLevel(默认使用数据库默认的事务隔离级别),所以不会默认为函数添加事务。另外事务配置提供全局配置。 平台事务管理兼容Spring声明式与编程式事务,支持多数据源事务管理。事务管理中多数据源嵌套独立事务,不会造成死锁风险。使用多数据源或分表操作,不会导致脏读。如果需要多数据源分布式事务,请使用PamirsTransational分布式事务管理方案(@PamirsTransational(enableXa=true))。分布式事务一般用于量小的跨模块配置管理场景 使用方式 声明式事务,使用@PamirsTransactional注解在需要事务管理的类或方法上标注。在非无代码场景下,与@Transactional注解功能一致。 编程式事务,使用PamirsTransactionTemplate即可。在非无代码场景下,与TransactionTemplate功能一致。 配置式事务,使用TxConfig模型在模块安装时初始化存储事务配置数据。 事务特性 原子性 (atomicity):强调事务的不可分割. 一致性 (consistency):事务的执行的前后数据的完整性保持一致. 隔离性 (isolation):一个事务执行的过程中,不应该受到其他事务的干扰 持久性(durability) :事务一旦结束,数据就持久到数据库 事务隔离级别 事务隔离级别指的是一个事务对数据的修改与另一个并行的事务的隔离程度,当多个事务同时访问相同数据时,如果没有采取必要的隔离机制,就可能发生以下问题: 问题 描述 脏读 一个事务读到另一个事务未提交的更新数据,所谓脏读,就是指事务A读到了事务B还没有提交的数据,比如银行取钱,事务A开启事务,此时切换到事务B,事务B开启事务–>取走100元,此时切换回事务A,事务A读取的肯定是数据库里面的原始数据,因为事务B取走了100块钱,并没有提交,数据库里面的账务余额肯定还是原始余额,这就是脏读 不可重复读 在一个事务里面的操作中发现了未被操作的数据 比方说在同一个事务中先后执行两条一模一样的select语句,期间在此次事务中没有执行过任何DDL语句,但先后得到的结果不一致,这就是不可重复读 幻读 是指当事务不是独立执行时发生的一种现象,例如第一个事务对一个表中的数据进行了修改,这种修改涉及到表中的全部数据行。 同时,第二个事务也修改这个表中的数据,这种修改是向表中插入一行新数据。那么,以后就会发生操作第一个事务的用户发现表中还有没有修改的数据行,就好象 发生了幻觉一样。 表4-1-8-1 事务隔离级别 Pamirs(Spring)支持的隔离级别 隔离级别 描述 DEFAULT 使用数据库本身使用的隔离级别 ORACLE(读已提交) MySQL(可重复读) READ_UNCOMITTED 读未提交(脏读)最低的隔离级别,一切皆有可能。 READ_COMMITED 读已提交,ORACLE默认隔离级别,有不可重复读以及幻读风险。 REPEATABLE_READ 可重复读,解决不可重复读的隔离级别,但还是有幻读风险。 SERLALIZABLE 串行化,最高的事务隔离级别,不管多少事务,挨个运行完一个事务的所有子事务之后才可以执行另外一个事务里面的所有子事务,这样就解决了脏读、不可重复读和幻读的问题了 表4-1-8-2 隔离级别与描述 隔离级别 脏读可能性 不可重复读可能性 幻读可能性 加锁度 READ_UNCOMITTED 是 是 是 否 READ_COMMITED 否 是 是 否 REPEATABLE_READ 否 否 是 否 SERLALIZABLE 否 否 否 是 表4-1-8-3 隔离级别说明表 事务的传播行为 保证同一个事务中 PROPAGATION_REQUIRED 支持当前事务,如果不存在 就新建一个(默认) PROPAGATION_SUPPORTS 支持当前事务,如果不存在,就不使用事务 PROPAGATION_MANDATORY 支持当前事务,如果不存在,抛出异常 保证没有在同一个事务中 PROPAGATION_REQUIRES_NEW 如果有事务存在,挂起当前事务,创建一个新的事务 PROPAGATION_NOT_SUPPORTED 以非事务方式运行,如果有事务存在,挂起当前事务 PROPAGATION_NEVER 以非事务方式运行,如果有事务存在,抛出异常 PROPAGATION_NESTED 如果当前事务存在,则嵌套事务执行 A中嵌套B事务,嵌套PROPAGATION_REQUIRES_NEW方法勿与A在同类中。 异常状态 PROPAGATION_REQUIRES_NEW (两个独立事务) PROPAGATION_NESTED (B的事务嵌套在A的事务中) PROPAGATION_REQUIRED (同一个事务) A抛异常 B正常 A回滚,B正常提交 A与B一起回滚 A与B一起回滚 A正常 B抛异常 1.如果A中捕获B的异常,并没有继续向上抛异常,则B先回滚,A再正常提交; 2.如果A未捕获B的异常,默认则会将B的异常向上抛,则B先回滚,A再回滚 B先回滚,A再正常提交 A与B一起回滚 A抛异常B抛异常 B先回滚,A再回滚 A与B一起回滚 A与B一起回滚 A正常 B正常 B先提交,A再提交 A与B一起提交 A与B一起提交 表4-1-8-4 事务传播行为 二、声明式事务(举例) Step1 修改PetShopBatchUpdateAction 用@PamirsTransactional或者@Transactional注解来声明事务,PamirsTransactional跟Spring的Transactional区别在于PamirsTransactional支持多库事务,但此多库事务为非严格的分布式多库事务,之所以选择这个方案,原因如下 a. 不损害任何性能。 b. 事务保障率超过4个9 c. 经过阿里的大厂验证,特别是在阿里的结算平台中得到了很好的验证 @PamirsTransactional更多配置项请详见4.1.7【函数之元数据详解】一文,自己多试试。同时@PamirsTransactional百分百兼容@Transactional @Action(displayName = "确定",bindingType = ViewTypeEnum.FORM,contextType = ActionContextTypeEnum.SINGLE) @PamirsTransactional //@Transactional public PetShopBatchUpdate conform(PetShopBatchUpdate data){ if(data.getPetShopList() == null || data.getPetShopList().size()==0){ throw PamirsException.construct(DemoExpEnumerate.PET_SHOP_BATCH_UPDATE_SHOPLIST_IS_NULL).errThrow(); } List<PetShopProxy> proxyList = data.getPetShopList(); for(PetShopProxy petShopProxy:proxyList){ petShopProxy.setDataStatus(data.getDataStatus()); } new PetShopProxy().updateBatch(proxyList); throw PamirsException.construct(DemoExpEnumerate.SYSTEM_ERROR).errThrow(); // return data; } 图4-1-8-1 修改PetShopBatchUpdateAction Step2 重启看效果 进入店铺管理列表页,选择记录点击【批量更新数据状态】按钮,修改记录的数据状态为【未启用】,提交看效果。期望效果为:提示系统异常,数据修改失败 图4-1-8-2 数据状态显示已启用 图4-1-8-3 批量更新数据状态…

    2024年5月23日
    1.8K00
  • 组件属性

    1. 通用属性 介绍组件和其属性之前,先介绍一些大部分组件通用支持的一些基础属性。 1.2 标题 标题是字段在当前页面的展示名称,标题默认为字段名称,可以修改。 1.2 占位提示 在未填写内容时,输入框或选择框内的浅色提示文字,仅用于提示,不会影响字段的值。 1.3 描述说明 一个字段的描述信息,通常用于说明当前字段的范围、注意事项等。描述说明大部分在组件的下方显示,特殊的是,分组的描述说明在标题的左侧。 1.4 默认值 创建数据时,有些字段大概率都是相同值,可设置默认值,减少添加人员的操作步骤,提高录入数据效率。 1.5 只读 设为只读时,字段可见,但不可编辑。 除了只读和非只读的对立选项,也可以设置条件只读,在设置的条件下才只读,条件不符合则非只读。 1.6 禁用 设为禁用时,字段可见,但不可编辑。 除了禁用和非禁用的对立选项,也可以设置条件禁用,在设置的条件下才禁用,条件不符合则非禁用。 1.7 隐藏 设为隐藏时,字段不可见,也不可编辑。但是在页面设计时,隐藏的组件也会展示,效果如下图。 除了隐藏和非隐藏的对立选项,也可以设置条件隐藏,在设置的条件下才隐藏,条件不符合则非隐藏。 1.8 必填 控制字段在当前页面是否必填,若设置为必填则在标题前会有红色的*作为标识。除了必填和非必填的对立选项,也可以设置条件必填,在设置的条件下才必填,条件不符合则非必填。 1.9 标题排列方式 字段的标题可以自定义横向排列还是纵向排列。每个字段组件都支持设置,设置后之间互不影响。除了组件支持自定义,表单、分组、选项卡也可以设置排列方式,对于这种布局容器类组件,设置后会将其容器内的所有组件的标题排列方式都改为所设置的值。 1.10 宽度 定义在页面中的宽度:占整行的比例,一般可选项有1/4、1/3、1/2、2/3、3/4、1。 其中1/2表示占当前行的一半;1表示占当前行一整行;以此类推。部分组件特殊,如富文本仅支持宽度为1,即占一整行。 2. 分组 分组是一个布局类组件,类似一个容器,可以把业务含义相近的内容放在这个分组容器内。 2.1 属性 2.1.1 标题 分组可以定义一个标题名称,标题显示在分组左上角,可以不设置标题。 2.1.2 描述说明 分组的描述说明显示在分组标题右侧。 2.1.3 标题排列方式 分组中的标题排列方式属性并不是控制分组的标题,而是控制分组内组件的标题。设置后对分组内的所有组件生效。 3. 选项卡 选项卡是一个布局类组件,类似一个容器,每个选项卡可以添加多个选项页,可以把业务含义相近的内容放在选项卡的选项页容器内。 3.1 选项卡属性 3.1.1 选项页排列方式 选中选项卡,可选择选项卡中的选项页排列方式:水平排列、竖直排列。默认是水平排列,效果如下图。 3.1.2 标题排列方式 选项卡中的标题排列方式控制选项卡内组件的标题。设置后对选项卡内的所有组件生效。 3.2 选项页属性 3.2.1 标题 选中选项页,显示选项页的属性设置,选项卡中的每个选项页支持设置标题。 3.2.2 标题排列方式 选项页中的标题排列方式控制选项页内组件的标题。设置后对选项页内的所有组件生效。同一个选项卡,不同选项页之间的标题排列方式可以不同。 4. 单行文本 单行文本输入框,常用于记录名称、身份证号或其他普通的文字内容。 4.1 创建字段 单行文本仅支持创建「文本」业务类型的字段,填写规则、内容和模型设计器端创建字段一致。 4.2 表单属性 4.2.1 通用属性 在表单中,单行文本可以设置一些通用的属性:标题、占位提示、描述说明、默认值、只读、隐藏、禁用、必填、标题排列方式、宽度。 4.2.2 文本类型 文本类型选项为文本或密码。若设置为文本,输入时内容是可见的;若设置为密码,输入时是不可见的密码形态,如下图: 4.2.3 最小/大长度 设置输入框输入内容的长度,输入框会根据设置的值进行校验。 最大长度默认为创建字段时填写的长度,且设置的最大长度不可以大于字段的长度 最小长度默认为空,为空则为不限制最小长度 4.2.4 输入格式 设置输入格式为网址或者身份证时,会进行格式的校验 无:默认为无,不会校验内容 网址:进行网址校验 身份证:进行身份证号校验,设置后,需要输入正确的身份证号 4.2.5 显示计数器 当需要用户关注输入内容长度时,可以开启显示计数器,在输入时会实时显示当前内容的长度。 4.2.6 显示清除按钮 若开启了清除按钮,则在输入框有内容时,点击清除按钮一键清除已有内容 5. 多行文本 多行文本输入框,常用于记录字数较多的文字,如意见、复杂备注等。 5.1 创建字段 多行文本仅支持创建「多行文本」业务类型的字段,填写规则、内容和模型设计器端创建字段一致。 5.2 表单属性 5.2.1 通用属性 在表单中,单行文本可以设置一些通用的属性:标题、占位提示、描述说明、默认值、只读、隐藏、禁用、必填、标题排列方式、宽度。 5.2.2 最小/大长度 设置输入框输入内容的长度,输入框会根据设置的值进行校验。 -最大长度默认为创建字段时填写的长度,且设置的最大长度不可以大于字段的长度 -最小长度默认为空,为空则为不限制最小长度 5.2.3 显示计数器 当需要用户关注输入内容长度时,可以开启显示计数器,在输入时会实时显示当前内容的长度。 5.2.5 显示清除按钮 若开启了清除按钮,则在输入框有内容时,点击清除按钮一键清除已有内容 6. 整数 整数输入框,常用于输入整数的天数、数量等,如果会出现小数,请使用小数组件。 6.1 创建字段 整数仅支持创建「整数」业务类型的字段,填写规则、内容和模型设计器端创建字段一致。 6.2 表单属性 6.2.1 通用属性 在表单中,整数可以设置一些通用的属性:标题、占位提示、描述说明、默认值、只读、隐藏、禁用、必填、标题排列方式、宽度。 6.2.2 最小/大值 设置整数输入框输入内容的最值,输入框会根据设置的最值进行校验。 最大值可设置的范围根据字段填写的长度转换,如设置长度为3,则最大值最大不可以超过999 截图 6.2.3 显示千分位 数字过长时,不便于查看,可开启显示千分位。 7. 小数 小数输入框,常用于输入金额、单价等,会出现小数的数值。 7.1 创建字段 小数仅支持创建「浮点型」业务类型的字段,填写规则、内容和模型设计器端创建字段一致。 7.2 表单属性 7.2.1 通用属性 在表单中,小数可以设置一些通用的属性:标题、占位提示、描述说明、默认值、只读、隐藏、禁用、必填、标题排列方式、宽度。 7.2.2 最小/大值 设置小数输入框输入内容的最值,输入框会根据设置的最值进行校验。 最大值可设置的范围根据字段填写的长度转换,如设置长度为3,则最大值最大不可以超过999 7.2.3 保留小数位数 支持设置小数的保留位数,设置后在页面中输入内容时,将进行校验 可设置的保留小数位数不可大于该字段的精度,如字段精度为2,则组件属性中的小数位数最大只能为2; 7.2.4 显示千分位 数字过长时,不便于查看,可开启显示千分位。 8. 下拉单选 从多个选项中下拉选择一个数据,作为数据值。选项可以是关联模型的数据,也可以是数据字典或布尔型开关。 8.1 创建字段 下拉单选支持创建三种业务类型的字段,分别是:多对一、布尔型、数据字典。 多对一:创建字段时需要选择关联的模型,关联模型的数据将作为下拉选项; 布尔型:下拉选项默认只有是、否; 数据字典:创建字段时需要选择数据字典,其数据字典项将作为下拉选项 8.2 表单属性 8.2.1 通用属性 在表单中,下拉单选可以设置一些通用的属性:标题、占位提示、描述说明、只读、隐藏、禁用、必填、标题排列方式、宽度。 8.2.2 选项类型…

    2024年6月20日
    1.9K00
  • 构件类

    1.构件类 1.1 延时 当下一个节点动作需要一段时间之后再发生时,可以使用延时节点。延时节点包含两种延时方式:1、延至指定日期,2、延时一段时间。 选择延至指定日期时,可以选择延至模型字段的时间或自定义时间,如果模型字段只包含日期则必填指定时辰。如果选择自定义则需要分别指定日期和时辰。 选择延时一段时间时,至少需要填“天、小时、分钟”中的一项。 1.2 条件分支 使不同条件的数据执行不同的分支流程。需要设置分支条件、添加满足条件的动作、也可以增删条件分支。 必须将分支条件填写完整流程才能正常进行。当只有两个分支时点击删除任一分支会删除整个条件分支。 1.3 审批分支 审批分支是一种特殊的条件分支。审批分支只能添加在审批节点下方。因为审批只存在通过和拒绝两种条件,所以无法添加其他条件,并且点击任意条件的叉都会删除整个条件分支。同时若审批节点被删除,审批分支也会同时删除。 1.4 子流程 一些高度重复的流程节点可以创建成子流程,在主流程中引用子流程,减少流程的重复配置。选择子流程时只能选择当前流程中有用到的模型下并且在启用状态的子流程,也可以在创建子流程节点处设置新增子流程。子流程的执行方式有两种:子流程可以和后续节点同时执行,也可以设置子流程执行完后再执行后续节点。 子流程与普通正常流程不同,不包含触发方式,普通流程流转到子流程节点即为子流程的触发条件,添加完节点动作之后发布即可。在不新增数据的情况下,子流程中只能使用该子流程对应模型的字段数据。

    2024年5月23日
    2.6K00
  • 6.2 集成平台(改)

    企业在数字化转型过程中内外部集成是一个必然需求、也是趋势 集成的诉求主要来自两个方面:1.企业的数字化改造是由外而内逐步进行的(内部异构集成)、2.企业数字化方向是朝越来越开放的方向发展(外部平台、工具集成)。总的来说企业在数字化转型过程中内外部集成是一个必然需求、也是趋势。所以我们不能简单地去理解做个API对接就结束了,而是要统一规划构建成企业的集成门户对API定义,安全、控制、记录等做全方位管理。oinone在下个版本规则中也纳入了基于集成平台之上做产品化配置的需求 概述 pamirs-eip为平台提供企业集成门户的相关功能,如请求外部接口使用的【集成接口】和对外开放被其他系统请求调用的【开放接口】功能。在请求外部接口时,还支持了多个接口调用(路由定义)、分页控制(paging)、增量控制(incremental)等功能。 准备工作 Step1 POM与模块依赖 pamirs-demo-api 和 pamirs-second-api 的pom文件中引入pamirs-eip2-api包依赖 <dependency> <groupId>pro.shushi.pamirs.core</groupId> <artifactId>pamirs-eip2-api</artifactId> </dependency> DemoModule和SecondModule 增加对EipModule的依赖 @Module(dependencies = {EipModule.MODULE_MODULE}) pamirs-demo-boot和pamirs-second-boot工程的pom文件中引入pamirs-eip2-core包依赖 <dependency> <groupId>pro.shushi.pamirs.core</groupId> <artifactId>pamirs-eip2-core</artifactId> </dependency> Step2 yaml配置文件参考 pamirs-demo-boot和pamirs-second-boot工程的application-dev.yml文件中增加配置pamirs.boot.modules增加eip,即在启动模块中增加eip模块 pamirs: boot: modules: – eip pamirs-demo-boot和pamirs-second-boot工程的application-dev.yml文件中增加eip模块的数据源与路由配置 pamirs: framework: data: ds-map: eip: eip datasource: eip: driverClassName: com.mysql.cj.jdbc.Driver type: com.alibaba.druid.pool.DruidDataSource url: jdbc:mysql://127.0.0.1:3306/eip_v3?useSSL=false&allowPublicKeyRetrieval=true&useServerPrepStmts=true&cachePrepStmts=true&useUnicode=true&characterEncoding=utf8&serverTimezone=Asia/Shanghai&autoReconnect=true&allowMultiQueries=true username: root password: oinone initialSize: 5 maxActive: 200 minIdle: 5 maxWait: 60000 timeBetweenEvictionRunsMillis: 60000 testWhileIdle: true testOnBorrow: false testOnReturn: false poolPreparedStatements: true asyncInit: true pamirs-demo-boot工程的application-dev.yml文件中修改eip的配置 pamirs: eip: open-api: enabled: false pamirs-second-boot工程的application-dev.yml文件中修改eip的配置 pamirs: eip: enabled: true open-api: enabled: true route: host: 127.0.0.1 port: 8094 aes-key: Nj5Thnxz4rV8Yy1FLGA2hUym3RepB8MKgafEaYC4GKo= 注: hosts配置在远程调用时不能使用127.0.0.1,可配置为0.0.0.0进行自动识别。若自动识别仍无法访问,请准确配置其他已知的可访问IP地址。 aes-key:用下面代码生成 附录:AES Key生成 pro.shushi.pamirs.core.common.EncryptHelper加解密帮助类,默认支持AES、RSA类型的数据加解密方法,也可自定义其他类型的加解密方法。 System.out.println(EncryptHelper.getKey(EncryptHelper.getAESKey())); Step3 在pamirs-second-api新建一个SessionTenantApi实现类 只要在我们公共的jar包中构建类似DemoSessionTenant类就可以了,之所以要构建SessionTenantApi实现类是因为EIP是以租户信息做路由的。所以这里我们写死返回一个“pamirs”租户就好了。 记得要重新mvn install second工程,再刷新demo工程 package pro.shushi.pamirs.second.api.tenant; import org.springframework.core.annotation.Order; import org.springframework.stereotype.Component; import pro.shushi.pamirs.framework.session.tenant.api.SessionTenantApi; import pro.shushi.pamirs.meta.api.core.session.SessionClearApi; import pro.shushi.pamirs.meta.common.spi.SPI; @Order(99) @Component @SPI.Service public class DemoSessionTenant implements SessionTenantApi, SessionClearApi { public String getTenant() { return "pamirs"; } public void setTenant(String tenant) { } public void clear() { } } 开放接口(举例) Step1 用于演示的模型定义 package pro.shushi.pamirs.second.api.model; import pro.shushi.pamirs.meta.annotation.Field; import pro.shushi.pamirs.meta.annotation.Model; import pro.shushi.pamirs.meta.base.IdModel; @Model.model(TestOpenApiModel.MODEL_MODEL) @Model(displayName = "演示开放接口模型") public class TestOpenApiModel extends IdModel { public static final String MODEL_MODEL = "demo.second.TestOpenApiModel"; @Field.String @Field(displayName = "名称") private…

    2024年5月23日
    2.0K00
  • 翻译

    翻译应用是管理翻译规则的应用,以模型为基础、维护字段的翻译值,支持导入、导出 1. 操作步骤 Step1:导出所有翻译项; Step2:线下翻译; Step3:导入翻译项; Step4:刷新远程资源; Step5:页面右上角可切换语言,查看翻译效果。 2. 新增翻译 翻译是具体到模型字段,其中需要区分出是否字典; 源语言、目标语言,是在资源中维护的语言,可在资源中维护需要翻译的语言; 翻译项则是模型字段,默认翻译项为激活状态,关闭后维护的翻译项无效。 3. 导出、导入 不勾选导出:导出所有需要翻译的翻译项,包括模块、字段,源术语、翻译值等,其中如果已经翻译过的内容,会体现在翻译值中; 勾选导出:导出勾选模型的翻译项。 导入:导入翻译项,平台会根据模型拆分为多条数据。 4. 刷新远程资源 导入翻译项后,点击“刷新远程资源”按钮。 5. 查看翻译内容 页面右上角切换语言,查看翻译效果。

    2024年6月20日
    1.5K00

Leave a Reply

Please Login to Comment