
构件类

1.构件类

1.1 延时

当下一个节点动作需要一段时间之后再发生时,可以使用延时节点。延时节点包含两种延时方式:1、延至指定日期,2、延时一段时间。
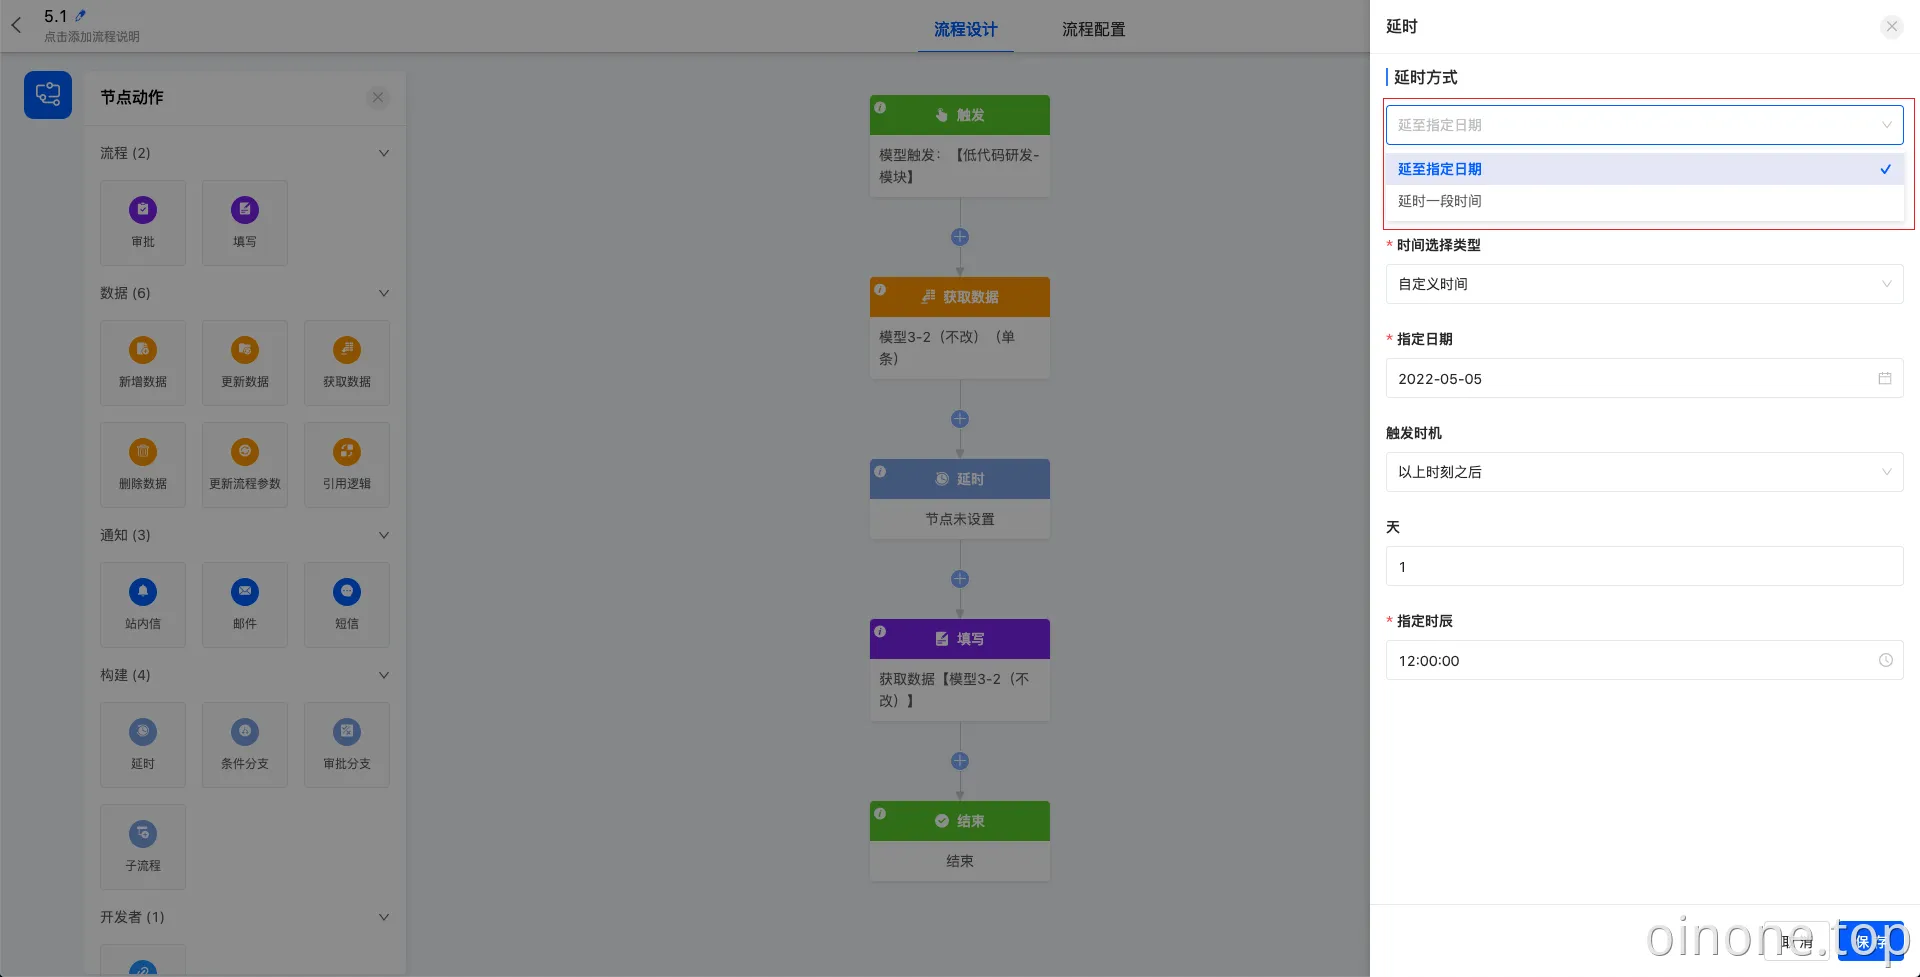
image.png

选择延至指定日期时,可以选择延至模型字段的时间或自定义时间,如果模型字段只包含日期则必填指定时辰。如果选择自定义则需要分别指定日期和时辰。

选择延时一段时间时,至少需要填“天、小时、分钟”中的一项。

1.2 条件分支

使不同条件的数据执行不同的分支流程。需要设置分支条件、添加满足条件的动作、也可以增删条件分支。

必须将分支条件填写完整流程才能正常进行。当只有两个分支时点击删除任一分支会删除整个条件分支。
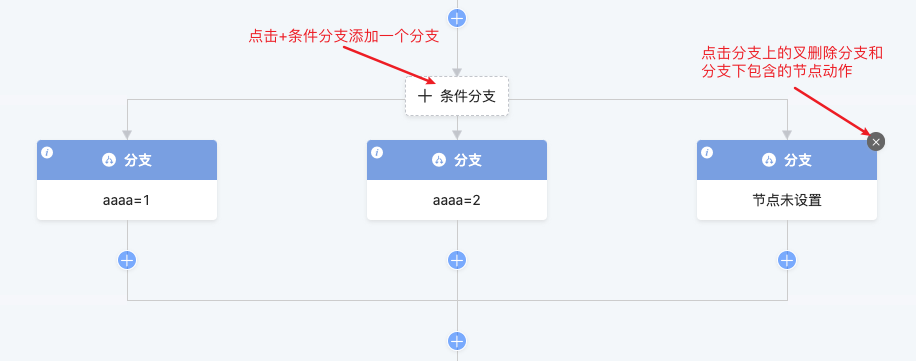
image.png

1.3 审批分支

审批分支是一种特殊的条件分支。审批分支只能添加在审批节点下方。因为审批只存在通过和拒绝两种条件,所以无法添加其他条件,并且点击任意条件的叉都会删除整个条件分支。同时若审批节点被删除,审批分支也会同时删除。
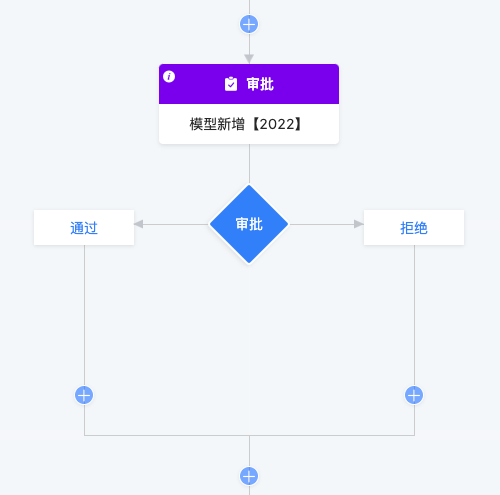
image.png

1.4 子流程

一些高度重复的流程节点可以创建成子流程,在主流程中引用子流程,减少流程的重复配置。选择子流程时只能选择当前流程中有用到的模型下并且在启用状态的子流程,也可以在创建子流程节点处设置新增子流程。子流程的执行方式有两种:子流程可以和后续节点同时执行,也可以设置子流程执行完后再执行后续节点。
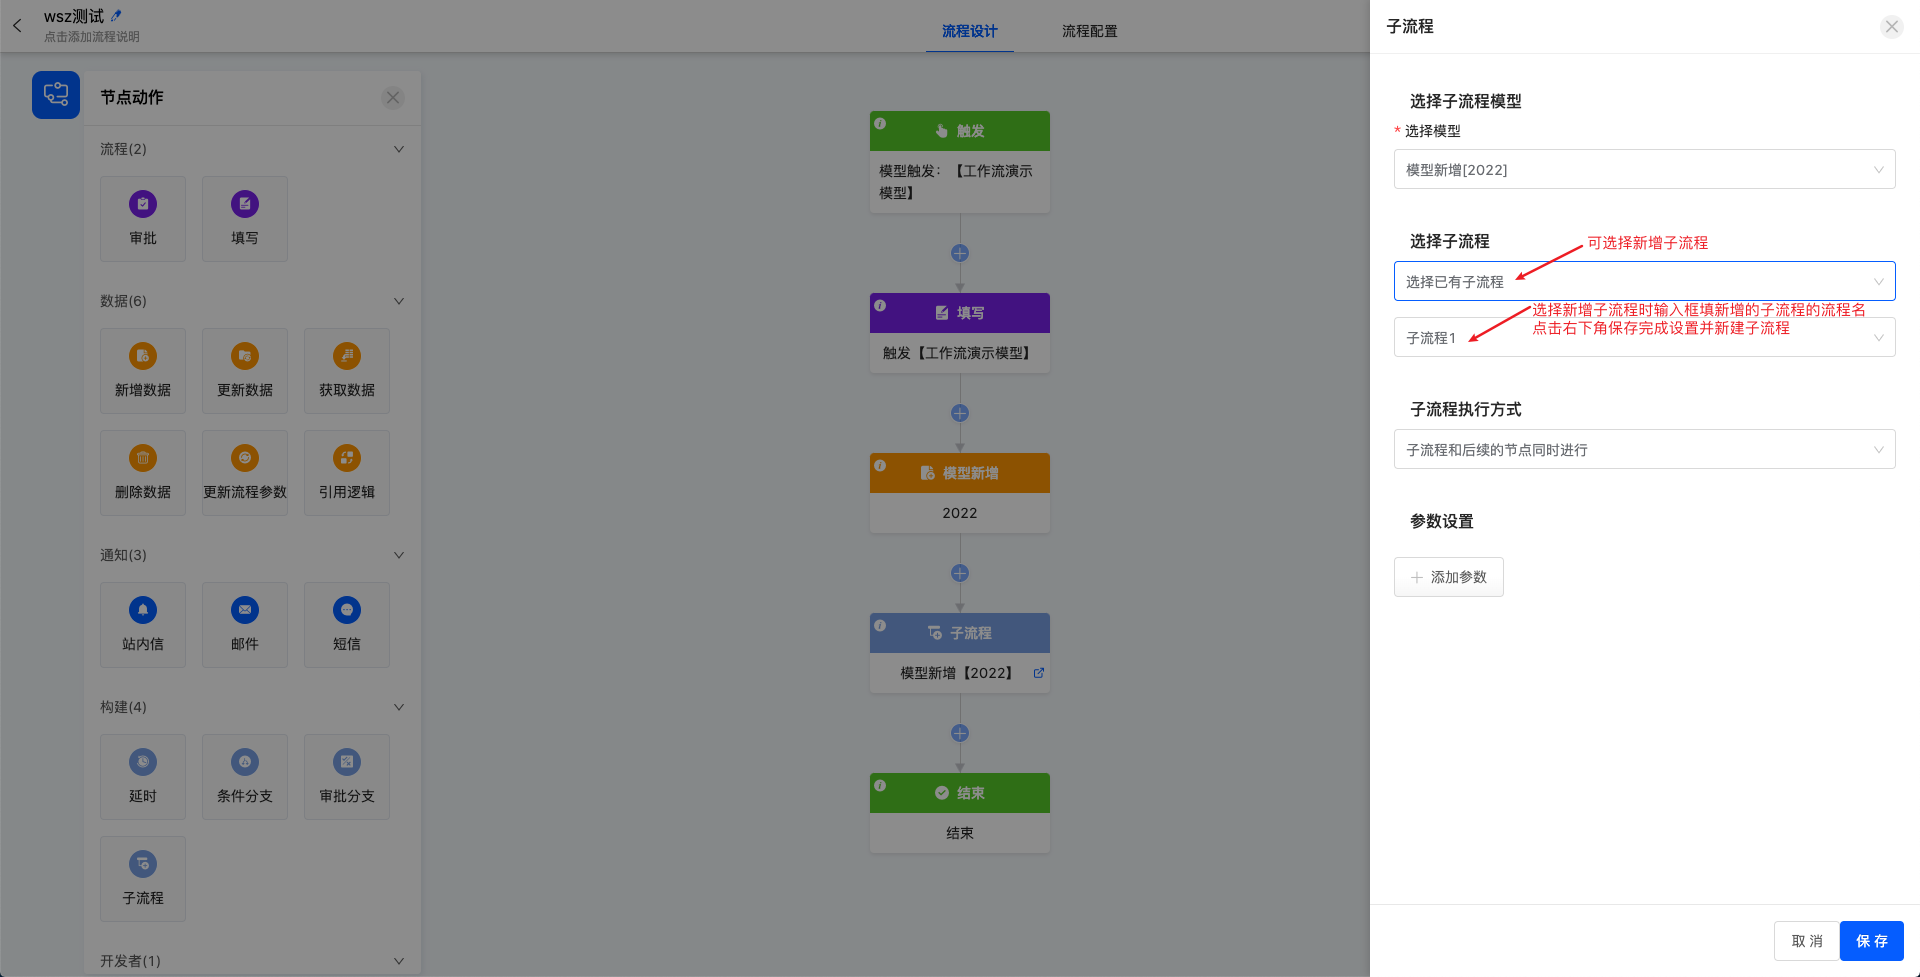
image.png

子流程与普通正常流程不同,不包含触发方式,普通流程流转到子流程节点即为子流程的触发条件,添加完节点动作之后发布即可。在不新增数据的情况下,子流程中只能使用该子流程对应模型的字段数据。
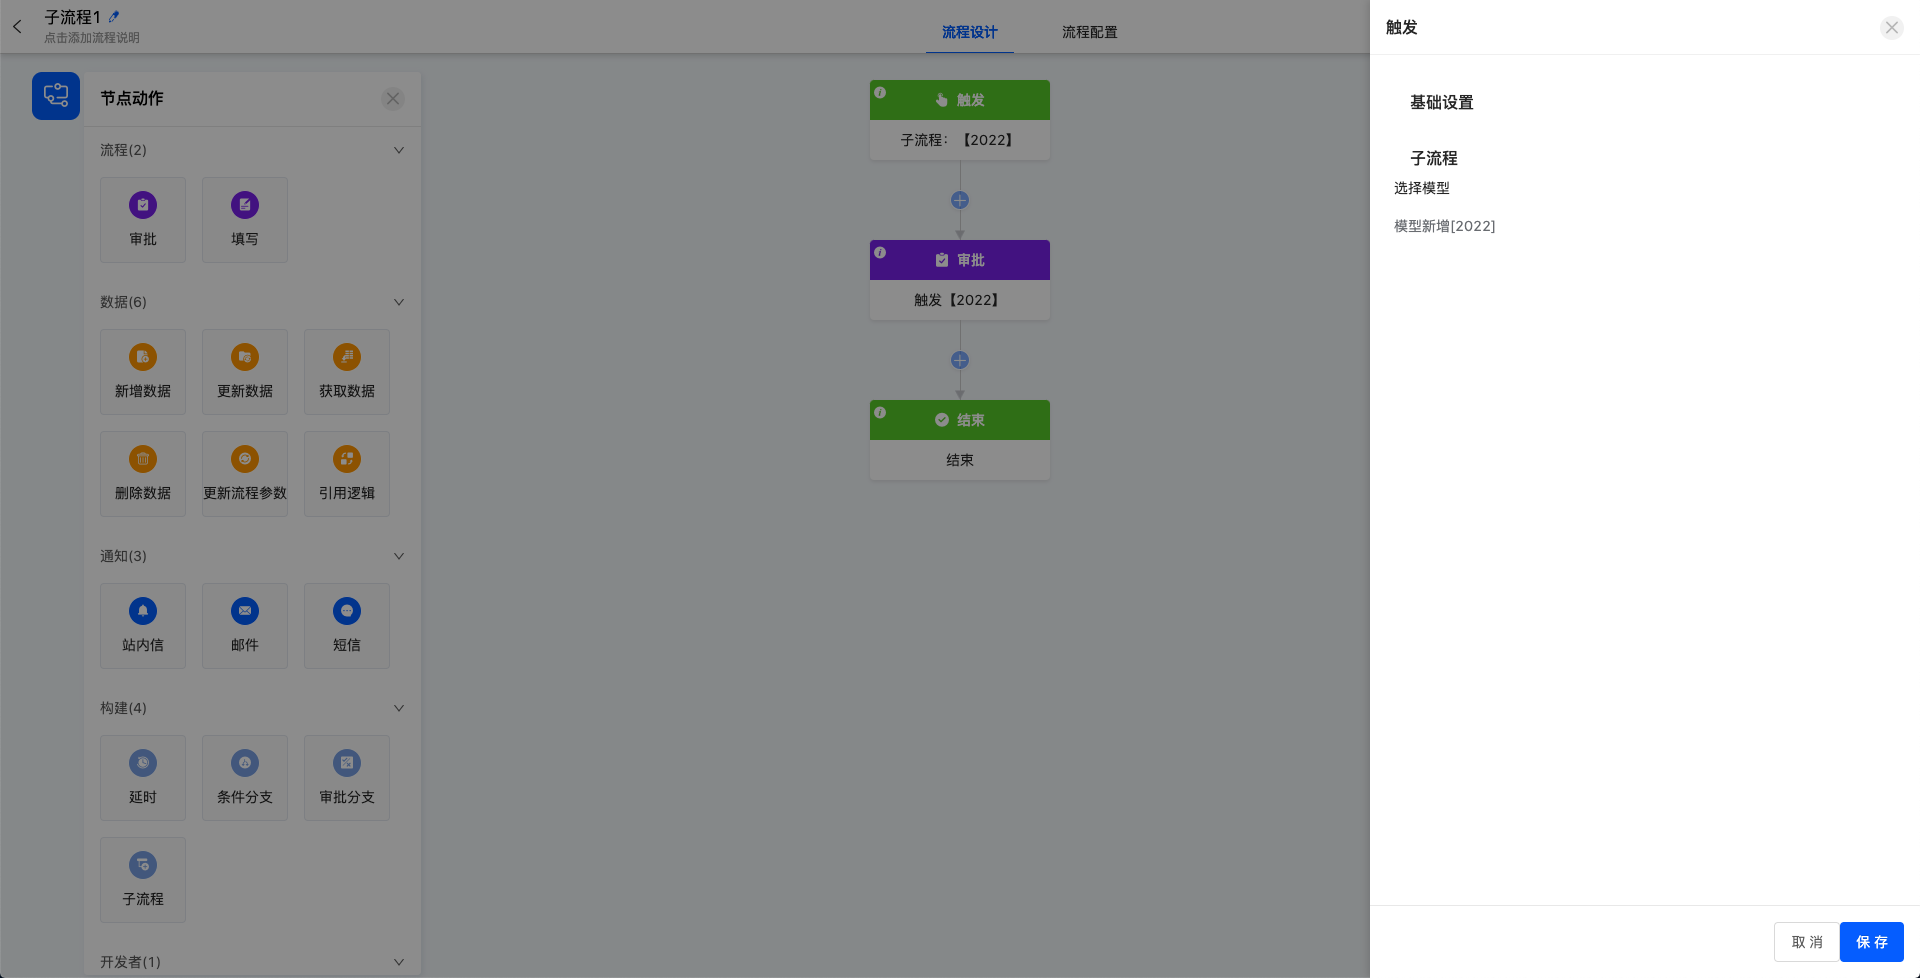
image.png

Oinone社区 作者:史, 昂原创文章,如若转载,请注明出处:https://doc.oinone.top/oio4/9418.html

访问Oinone官网:https://www.oinone.top获取数式Oinone低代码应用平台体验

Like (0)
史, 昂's avatar史, 昂数式管理员
Previous 2024年5月23日 pm4:54
Next 2024年5月23日 pm9:59

相关推荐

  • 3.6 问题排查工具

    当前端发起对应用的访问时,如果出现错误,那么我们可以通过以下方式进行简易排查,如果排查不出来,则也可以把排查工具给出的信息发送给Oinone官方售后进行进一步分析。本文将通过模拟异常信息,来介绍排查工具,提供了哪些辅助信息帮我们来快速定位问题。 排查工具基础介绍 通过前端页面的 /debug 路由路径访问调试工具的页面,假设我们的前端页面访问地址为http://localhost:6800,那么我们的排查工具请求路径就是 http://localhost:6800/debug排查工具可以帮我们排查前端页面元数据异常和后端接口的异常 排查前端页面元数据 将问题页面浏览器地址栏内 page 后的部分复制到调试工具的 debug 路由后重新发起请求,如图可以看到调试工具展示的信息,可以根据这些信息排查问题。 排查后端接口 后端接口出现问题后,打开(在原页面)浏览器的调试工具,切换到“网络”的标签页,在左侧的历史请求列表中找到需要调试的请求,右键会弹出菜单,点击菜单中的 “复制”,再次展开该菜单,点击二级菜单中的“以 fetch 格式复制”,这样可以复制到调试所需要的信息 2.复制调试信息到“接口调试”标签页内的文本框内,点击“发起请求”按钮获取调试结果 我们可以看到页面展示了该接口的各种调试信息,我们可以据此排查问题。 场景化的排查思路 业务代码中存在代码bug 报错后发起调试请求,我们可以看到,调试工具直接给出了异常抛出的具体代码所在位置,此时再切换到“全部堆栈”下,可以看到是业务类的233行导致的空指针异常,查看代码后分析可得是data.getName().eqauls方法在调用前未做条件判断补全该判断后代码可以正常执行 业务代码中没有直接的错误,异常在平台代码中抛出 报错后发起调试请求可以看到异常不在业务代码内再切换到“全部堆栈”,可以看到具体异常信息,提示core_demo_item表出现了重复的主键,该表是DemoItem模型的我们还可以切换到“sql调试”的标签页,可以看到出错的具体sql语句经过分析可以得知是240行的data.create()�重复创建数据导致的。 三、排查工具无法定位怎么办 当我们通过排查工具还是没有定位到问题的时候,可以通过调试页面的“下载全部调试数据”和“下载调试数据”按钮将调试信息的数据发送给官方售后人员帮助我们定位排查问题。 点击页面最顶部的“下载全部调试数据”按钮,可以下载页面调试数据和接口调试数据点击“调试接口”标签页内的“下载调试数据”按钮,可以下载接口调试数据 四、排查工具细节

    2024年5月23日
    2.6K00
  • 翻译

    翻译应用是管理翻译规则的应用,以模型为基础、维护字段的翻译值,支持导入、导出 1. 操作步骤 Step1:导出所有翻译项; Step2:线下翻译; Step3:导入翻译项; Step4:刷新远程资源; Step5:页面右上角可切换语言,查看翻译效果。 2. 新增翻译 翻译是具体到模型字段,其中需要区分出是否字典; 源语言、目标语言,是在资源中维护的语言,可在资源中维护需要翻译的语言; 翻译项则是模型字段,默认翻译项为激活状态,关闭后维护的翻译项无效。 3. 导出、导入 不勾选导出:导出所有需要翻译的翻译项,包括模块、字段,源术语、翻译值等,其中如果已经翻译过的内容,会体现在翻译值中; 勾选导出:导出勾选模型的翻译项。 导入:导入翻译项,平台会根据模型拆分为多条数据。 4. 刷新远程资源 导入翻译项后,点击“刷新远程资源”按钮。 5. 查看翻译内容 页面右上角切换语言,查看翻译效果。

    2024年6月20日
    1.4K00
  • 3.1 环境搭建

    一、基础环境说明 内容 是否必须 说明 后端基础环境 JDK1.8 必须 java的基础运行环境, 要求高于1.8_221以上,低于这个版本需要覆盖jce (原因:https://www.cnblogs.com/jinloooong/p/10619353.html) Mysql 必须 8.0.26 版本以上需要注意点:修改:my.cnf (macOS ) / my.ini (windows)时区、大小写敏感设置lower_case_table_names = 2default-time-zone = ‘+08:00’ Idea 必须 需要注意点:1.禁用Lombok插件2.java Compiler 增加 -parameters(不然java反射获取方法入参名会变成arg*) 指令3.安装oinone插件 DB GUI 非必须 Datagrip、MySQLWorkbench、DBEaver 选其一 Insomnia 非必须 GraphQL测试工具 Git 必须 2.2.0以上 Maven 必须 3.6.3需要注意点:1配置mvn的settings文件下载地址见oinone开源社区群公告,也可以联系oinone合作伙伴或服务人员2把settings.xml拷贝一份到maven安装目录conf目录下 RocketMQ 必须 4.7.1以上 Redis 必须 5.0.2以上 Zookeeper 必须 3.5.8以上 前端基础环境 nvm 非必须 方便node的版本管理 nodejs 必须 版本要求为12.12.0注意事项:1.npm的源配置为http://nexus.shushi.pro/repository/kunlun/2.源的用户名、密码见oinone开源社区群公告,也可以联系oinone合作伙伴或服务人员 vue-cli 必须 vue脚手架工具 表3-1-1基础环境说明 其他:canal和Es的环境搭建见具体学习章节 二、基础知识准备 前端必备知识 vue3、typescript、graphql 后端必备知识 SpringBoot、MybatisPlus 表3-1-2基础知识准备 三、下载快速安装包 Mac版 Windows版 四、学习安装 推荐,虽然慢点对环境有比较深入的了解,对自身能力提升和日后排查问题都有好处。 mac见:3.1.1【环境准备(Mac版)】一文 windows见:3.1.2【环境准备(Windows版)】一文

    Oinone 7天入门到精通 2024年5月23日
    3.3K00
  • 4.1.23 框架之信息传递

    在4.1.13【Action之校验】、3.4.1【构建第一个Function】等文章中,都用到PamirsSession.getMessageHub()来设置返回消息,基本上都是在传递后端逻辑判断的异常信息,而且在系统报错时也会通过它来返回错误信息,前端接收到错误信息则会以提示框的方式进行错误提示。其实后端除了可以返回错误信息以外,还可以返回调试、告警、成功、信息等级别的信息给前端。但是默认情况下前端只提示错误信息,可以通过前端的统一配置放开提示级别,有点类似后端的日志级别。 一、不同信息类型的举例 Step1 新建PetTypeAction 借用PetType模型的表格页做为信息传递的测试入口,为PetType模型新增一个ServerAction,在代码中对信息的所有类型进行模拟 package pro.shushi.pamirs.demo.core.action; import org.springframework.stereotype.Component; import pro.shushi.pamirs.demo.api.model.PetCatItem; import pro.shushi.pamirs.demo.api.model.PetType; import pro.shushi.pamirs.meta.annotation.Action; import pro.shushi.pamirs.meta.annotation.Model; import pro.shushi.pamirs.meta.api.dto.common.Message; import pro.shushi.pamirs.meta.api.session.PamirsSession; import pro.shushi.pamirs.meta.enmu.ActionContextTypeEnum; import pro.shushi.pamirs.meta.enmu.InformationLevelEnum; import pro.shushi.pamirs.meta.enmu.ViewTypeEnum; @Model.model(PetType.MODEL_MODEL) @Component public class PetTypeAction { @Action(displayName = "消息",bindingType = ViewTypeEnum.TABLE,contextType = ActionContextTypeEnum.CONTEXT_FREE) public PetType message(PetType data){ PamirsSession.getMessageHub().info("info1"); PamirsSession.getMessageHub().info("info2"); PamirsSession.getMessageHub().error("error1"); PamirsSession.getMessageHub().error("error2"); PamirsSession.getMessageHub().msg(new Message().msg("success1").setLevel(InformationLevelEnum.SUCCESS)); PamirsSession.getMessageHub().msg(new Message().msg("success2").setLevel(InformationLevelEnum.SUCCESS)); PamirsSession.getMessageHub().msg(new Message().msg("debug1").setLevel(InformationLevelEnum.DEBUG)); PamirsSession.getMessageHub().msg(new Message().msg("debug2").setLevel(InformationLevelEnum.DEBUG)); PamirsSession.getMessageHub().msg(new Message().msg("warn1").setLevel(InformationLevelEnum.WARN)); PamirsSession.getMessageHub().msg(new Message().msg("warn2").setLevel(InformationLevelEnum.WARN)); return data; } } 图4-1-23-1 为PetType模型新增一个ServerAction Step2 (前端)修改提示级别 在项目初始化时使用CLI构建初始化前端工程,在src/middleware有拦截器的默认实现,修改信息提示的默认级别为【ILevel.SUCCESS】 图4-1-23-2(前端)修改提示级别 const DEFAULT_MESSAGE_LEVEL = ILevel.SUCCESS; 图4-1-23-3(前端)修改提示级别 Step3 重启系统看效果 从页面效果中看到已经不在是只提示错误信息。从协议端看错误级别的信息是在errors下,其他级别的信息是在extensions下。 图4-1-23-4 示例效果 图4-1-23-5 系统提示的返回结果 二、MessageHub的其他说明 是实现上看MessageHub是基于GQL协议,前后端都有配套实现。同时前端还提供了订阅MessageHub的信息功能,以满足前端更多交互要求,前端MessageHub提供的订阅能力使用教程详见4.2.2前端高级特性之【框架之MessageHub】一文。

    2024年5月23日
    1.9K00
  • 1.4 Oinone对软件特性的思考

    我在个人的微信公众号上《浅谈企业IT架构的十年困局》一文中写了“企业或者软件公司在工程领域都关注哪些特征,而这些特征又应与具体研发人员的个体能力无关”的相关内容。收到很多业内人士的留言,也引起了很多同行的共鸣,所以今天在这里也打算针对这个话题,跟大家再做个深入的探讨。 一、首先为什么强调要跟研发个体能力无关 我们先来看一个故事: 轮扁是春秋时期齐国的木工,齐桓公召其入宫打造物件。有一天,齐桓公在堂上看书,轮扁在堂下用椎、凿等工具做车轮。 齐桓公看书看到得意处,不由得读出声来。轮扁听到读书声,想了想,放下手里的工具,走上堂来,在齐桓公面前几步远的地方停下,恭恭敬敬地说:“请恕臣斗胆问一下,君王读的是什么书?”齐桓公没想到这个老木匠会走上堂来,倒有点意外。不过看在他年纪大的份上,倒也不去斥责他,就回答说:“寡人读的是圣人写的书。”轮扁问:“圣人还在吗?”齐桓公说:“已经死了。”轮扁说:“这样看起来,君王所读的,不过是古人的糟粕而已!”齐桓公勃然大怒,说:“寡人读书,你一个做车轮的怎么敢议论?你说,这书上怎么会是古人的糟粕?说出道理便罢,说不出道理便难逃一死!” 轮扁不慌不忙地说:“臣是根据臣所从事的活计而明白这个道理的。砍削轮子,榫头做得宽了则松滑而不牢固,做得太紧就必然涩滞而安不进去,臣制作的榫头松紧适宜,是因为心里怎样想的手便怎样去做。然而尽管所需要的分寸度数心里都明白,要把它用言辞表达出来却实在不可能,全靠自己手与心的配合。所以,臣无法将其中的奥秘传授给儿子,臣的儿子也无法从臣这里学到其中的奥秘。因此,臣如今七十多岁了,还只好亲手去干制作轮子的活。这样看来,古人之道的精华都已随着古人死去而无法传世,那么君王所读的,不就是古人的糟粕了吗?” 这就是著名的成语故事——轮扁斫轮,出自《庄子·天道》。庄子通过轮扁的言论,深刻地揭示了高妙之技的难以言传。 而当我们转换视角,在企业数字化转型领域,无论是软件公司还是甲方IT团队,核心上是应用级开发需求,更多的精力应该放在业务场景理解、需求把控以及业务系统实现上。但往往在一个项目进入研发之前,会花很大力气在技术架构设计、技术栈选型、通用能力对接、扩展点设计这些跟业务场景无关的技术事项上,且需要高级别的架构师来主导。大部分情况下,架构师会选开源框架来实现,慢慢沉淀为企业的研发标准体系,所以底层架构的能力往往依赖架构师个人能力。不禁发现他们与轮扁有着异曲同工之处。架构师所积累的个人经验和技术能力,往往难以通过简单的手把手教学、技术评审会完全传递给团队中的其他成员。即使有所传授,其效率也可能仅达到50%,并且随着团队成员数量的增加,这种效率还可能持续递减。因此,我们需要更多地依赖于技术手段,将架构师的经验和能力固化下来,形成一套可复制、可推广的标准技术产品。这样,每个团队成员都能够通过学习和运用这些技术,达到至少70%的传递效率,从而确保团队整体技术水平的稳步提升。这也正是开篇所强调的,企业或软件公司在工程领域所关注的特征,应当与具体研发人员的个体能力相剥离,而更多地依赖于标准化、系统化的技术手段,来确保团队整体的高效运作。 二、软件公司在工程化领域都关注哪些特征 接下来,我将从技术角度深入剖析设计初衷和技术实现原理,以展现技术公司应当“被标准化的特征”究竟长什么样。 先做个名称解释,下文中涉及“标品”、“升级”、“扩展逻辑”,这是站在软件公司角度出发描述的,如果是企业内部可以把标品理解为特定业务应用平台,升级则是业务应用平台的正常规划迭代,扩展逻辑理解为脱离平台发展的临时性需求。 1. 可逆计算 可逆计算,在应用上的特征图 场景:调查发现企业研发至少有40%的精力在跟各条业务线的团队在评审项目需求,判断需求是否合理。而且业务线对需求完善时间要求紧,每天盯着研发进度,经常问“这个需求什么时候支持,我们等着用”。导致产研部门的研发抱怨产品节奏乱,无法按照自身节奏进行迭代,被项目推着走,没有时间思考,人手不足,加班多,工作压力大…… 价值:该特性很好的规避了研发因为时间紧迫,写的一些临时代码腐蚀核心业务系统。它需要做到不论从数据模型、业务逻辑、交互展示都能有扩展能力,并且这些扩展能力与个体研发无关才行。它同时所描述的也是一个具备差量计算能力的软件架构模式,它允许用户通过添加或移除扩展包来定制标准应用,同时保持应用的可逆性和独立性。这种架构模式的核心优势在于其灵活性和可维护性,使得应用的定制和恢复变得简单而高效。 技术原理:它所描述的是一个基于元数据驱动和差量计算的软件架构模式,它允许用户通过添加或移除扩展包来定制标准应用,同时保持应用的可逆性和独立性。这种架构模式的核心优势在于其灵活性和可维护性,通过元数据来驱动应用的构建和变更,使得应用的定制和恢复变得简单而高效 在这种架构中,元数据起到了至关重要的作用。元数据是关于数据的数据,它描述了数据的结构、属性、关系等信息。在软件应用中,元数据可以用来描述应用的组件、功能、配置等信息。通过元数据驱动应用可以根据元数据的描述来动态地构建和配置自身的功能和结构 差量计算则是实现应用可逆性的关键。当添加或移除扩展包时,系统会根据扩展包中的元数据与标准应用的元数据进行差量计算,确定需要添加或移除的功能和组件。这种差量计算可以确保在添加扩展包后,应用能够保持原有的功能和稳定性,同时新增扩展包带来的新功能,而在去除扩展包时,应用能够恢复到原始的标准状态,不会留下任何冗余或冲突的代码和配置。 为了实现这种架构模式,元数据注册表和分布式部署能力是非常重要的。元数据注册表需要能够存储和管理大量的元数据信息,并且提供高效的查询和更新机制。分布式部署能力则能够确保应用在不同的环境中都能够稳定运行,并且能够快速地响应扩展包的添加和移除操作,即差量(扩展包》可独立存在又相互作用。 总的来说,这种基于元数据驱动和差量计算的软件架构模式为应用的定制和恢复提供了强大的支持,使得应用能够根据不同的需求进行灵活的定制和扩展。同时,它也提高了应用的可维护性和可靠性,降低了开发和维护的成本 2. 协同演进 协同演进,在应用上的特征图 场景:它所描述的场景是一个复杂的软件升级过程,其中涉及了标准应用的升级以及用户个性化扩展的保留。通过面向对象的方式扩展标准应用的功能,可以在升级过程中保持用户自定义逻辑的完整性,并同时集成新版本中的新特性。 价值:很多号称产品型的软件公司,在交付客户项目的时候,都是从标品复制一个分支,然后客户个性化直接在这个分支上改。这种模式会带来两个问题: 是当客户数量变大,每个客户的版本都不一致,维护成本很高; 是当标品升级带来的新特性无法复制给客户,导致客户满意度下降甚至流失。协同演进就是要解决这个问题。 技术原理:它需要在第一个差量计算的特性基础上才能得以完成,同时在这种升级能力中,元数据驱动和模型驱动是关键所在。元数据驱动确保了应用能够理解和处理不同版本之间的变化,包括功能的增删改以及结构的调整。模型驱动则提供了描述和管理应用结构、组件和行为的能力,它不仅能够描述模型间的关系,还能够支持面向对象的特性,如继承、重写和重载等。 具体来说,当标准应用从V1升级到V2时,元数据驱动机制会首先识别和分析两个版本之间的差异。对于用户应用1中已经扩展的A功能,由于采用了面向对象的方式进行扩展,因此在升级过程中,A+逻辑作为A功能的重写或重载版本会被保留下来。同时,V2版本中新增的B功能也会被集成到用户应用1中,因为它是作为标准应用的新特性而存在的。 这种升级能力的实现依赖于一个强大的元数据注册表和模型管理能力。元数据注册表需要能够存储和管理不同版本应用的元数据信息,包括功能、组件、结构等。模型管理能力则需要能够解析和应用这些元数据,以生成正确的应用结构和行为。同时,还需要一套高效的升级机制来确保升级过程的平滑和可靠。 总的来说,通过元数据驱动和模型驱动的结合,可以实现标准应用的平滑升级,同时保留用户个性化扩展的完整性。这种能力对于提高软件的可维护性、可扩展性和用户满意度具有重要意义 3. 公民研发和专业研发共同参与 专业研发与公民研发共同参与,在应用上的特征图 场景:它所描述是在应用开发的整个生命周期中,专业研发专注在标品的长期规划与迭代,当出现临时性的需求或者应急性的辅助场景则由非专业人士进行即公民研发方式进行。这种模式下,专业研发可以按照规划有节奏的迭代产品,做更高级的事情,不至于忙于应对临时性的事务没有深度思考,更加避免了因为临时代码堆积导致产品从内部腐化。同时利用独立的扩展逻辑包和无代码方式解决了业务的紧迫感,毕竟业务需求的合理性是很难争论出高低的。它在前两个特性基础上让研发效能进一步得到释放。 价值:它的本质是,在专业研发在以低代码的方式下实现应用,并通过无代码的方式,快速扩展逻辑功能和创建辅助性应用。整个过程无缝衔接,我们给他取个名字专业名称叫:“低无一体”。它大大降低了技术门槛,使得专业和非专业的研发人员都能参与到应用扩展和定制中来。此外,它还提高了业务响应能力,使得企业能够更快速地适应市场变化和客户需求。 技术原理:它的核心要求就是元数据在线,元数据在线能力是指能够实时地、在线地管理和操作元数据,这种能力为企业或组织带来了诸多优势。通过无 代码的方式,用户可以更加灵活地进行应用的个性化扩展,以应对各种应急性需求,从而显著提升业务的响应能力。此外,元数据在线管理还确保核心应用、核心应用扩展以及辅助应用都是基于一套统一的技术体系构建的,这为不同角色的用户(包括专业和非专业的研发人员)提供了多样化的参与方式。同时,元数据在线管理需要符合开闭原则,这确保了系统的稳定性和可扩展性,使得新的功能或需求可以通过添加新的元数据或配置来实现,而非修改现有系统。 这种低代码开发与无代码一体化的优势在于,它大大降低了技术门槛,使得专业和非专业的研发人员都能参与到应用扩展和定制中来。此外,它还提高了业务响应能力,使得企业能够更快速地适应市场变化和客户需求。 总之,从用户应用到业务实施的过程通过元数据在线得到了优化和升级。低代码开发与无代码一体化的优势使得整个过程更加高效、灵活和易于维护,为企业带来了显著的价值和竞争优势。 4. 基于平台级别的AOP能力出现反向集成 反向集成,在应用上的特征图 场景:平台级别的AOP(面向切面编程)能力允许开发者在应用程序的特定点“切入”额外的逻辑,而无需修改原有的业务代码。这种能力特别适用于横向追加平台逻辑,即在多个不同服务或功能点插入通用的处理逻辑,如日志记录、权限检查、审计、多租户、多语言等。过往在微服务架构中,这些能力都需要业务系统各自主动去对接,有了平台级别的AOP能力,则这些通用能力可以反向为所有业务系统增加特性能力,无需业务系统研发感知。这种现象我们称之为“反向集成”,能让业务研发更加专注在业务研发本身,不需要关心与业务无关的通用功能上。 价值:AOP的核心思想是将这些横切关注点(cross-cutting concerns)从业务逻辑中分离出来,使得业务代码更加清晰和专注于其核心功能。在平台级别的AOP中,标准化协议是实现这一能力的关键。平台具备统一的入口和扩展能力是非常重要的,因为它允许开发者在不修改现有代码的情况下添加新功能或修改现有功能的行为。这种能力对于快速响应业务需求变化、减少维护成本和提高代码质量都是非常有益的。 技术原理:标准化协议确保了不同组件之间的通信与语义是统一的,从而使得AOP能够更容易地实施。例如: a前后端通信要标准协议(与端无关): 这意味着无论前端是使用Web、移动应用还是其他类型的客户端,后端服务都应该能够以一种标准的方式与之通信。 bORM层要有标准协议(与数据库无关): 对象关系映射 (ORM)层应该提供一个标准的接口来与数据库进行交互,这样无论底层使用哪种数据库(如MySQL、PostgreSQL、Oracle等),上层的业务逻辑都不需要改变。 cRPC需要标准协议(与Dubbo和Spring Cloud无关): 远程过程调用 (RPC)应该遵循一种标准协议,以便不同的服务可以无缝地进行通信,而不受特定框架 (如Dubbo、Spring Cloud等)的限制。 d所有逻辑调用统一fun调用: 这意味着平台上的所有功能调用都应该通过一个统一的入口点(如一个函数或方法)进行,这样AOP就可以在这个入口点切入额外的逻辑。 总的来说,平台级别的AOP能力通过标准化协议和统一的调用入口,为开发者提供了一种强大而灵活的方式来管理和扩展平台的逻辑功能。 5. 应用研发与部署无关 应用研发与部署无关,在应用上的特征图 场景:现在研发在选择部署方式的时候往往会选择分布式部署,或者你的客户招标需求里就写着“微服务”,构建一个微服务系统并不是一件容易的事,构建的复杂度远远超过单体系统,开发人员需要付出一定的学习成本去掌握更多的架构知识和框架知识。服务与服务之间通过HTTP协议或者消息传递机制通信,开发者需要选出最佳的通信机制,并解决网络服务较差时带来的风险。另外服务与服务之间相互依赖,如果修改某一个服务,会对另一个服务产生影响,如果掌控不好。会产生不必要的麻烦。由于服务的依赖性,测试也会变得很复杂,比如修改一个比较基础的服务,可能需要重启所有的服务才能完成测试。前段时间有篇很火的文章,《从微服务转为单体架构、成本降低 90%!》,无论是选择何种部署方式,我认为这都应该跟应用研发无关。 价值:应用研发与部署无关的理念确实为现代软件架构带来了显著的优势,它使得研发团队能够专注于业务逻辑和功能实现,而无需担心具体的部署细节。这种分离带来了灵活性、效率以及成本效益的多重提升。应该采用一种同时支持分布式和单体部署、且可以自由切换的架构,我们称之为可分可合。 首先,可分可合的能力使得系统能够灵活应对业务量的变化。在业务量小的时候,可以采用单体部署的方式,简化部署流程,降低初期成本。随着业务量的增长,系统可以平滑地过渡到分布式部署,通过拆分微服务来提高系统的处理能力和扩展性。这种灵活性确保了系统既能满足未来发展的需要,又能兼顾当下的成本效益。 其次,应用级别扩容的能力使得系统性能不再受限。通过增加微服务实例或调整资源配置,系统可以按需进行扩容,从而确保在业务高峰期或突发流量下仍能保持稳定的性能。这种按需扩容的方式不仅提高了系统的可靠性,还降低了运维成本。 技术原理:核心在于逻辑调用的统一执行和智能判断。通过如funEngine这一统一调用引擎,系统能够智能地选择最适合当前业务场景和性能需求的fun调用方式。无论是同步调用、异步调用还是基于消息队列的调用方式,funEngine都能进行智能决策,确保调用的高效性和可靠性。这种统一调用的方式简化了开发过程,降低了开发难度,同时也提高了系统的可维护性和可扩展性。 此外如果作为低代码或者其他研发平台来说。被集成特性也是实现该特性的关键所在。它提供了一套标准化的接口和协议,使得其他系统或应用能够轻松地与其进行集成。这种平台框架化的特性能够作为一个统一的、可扩展的框架来支撑整个系统的运行。 综上所述,具备可分可合的能力、应用级别扩容以及逻辑调用的统一执行和被集成特性,共同构成了应用研发与部署无关这一核心特性。该特性使得软件系统能够灵活地应对业务变化,实现高效、可扩展和可维护的运行,从而满足客户的长期发展需求并兼顾当下的成本效益。

    2024年5月23日
    2.5K10

Leave a Reply

Please Login to Comment