3.5.7.6 自定义字段

字段是什么

字段的基本概念

  1. 定义:字段通常指的是数据的一个单独项,它可以是一个文本框、下拉菜单、复选框等,用于在用户界面上收集或展示数据。

  2. 用途:在表单中,字段用于收集用户输入;在表格或列表中,字段用于显示数据。

  3. 类型:字段可以有不同的类型,如文本、数字、日期等,这些类型通常由数据模型定义。

Oinone框架中的字段

在Oinone框架中,字段的设计和实现遵循以下原则:

  1. 后端模型驱动:前端的字段直接由后端的数据模型决定。这意味着后端定义了哪些数据应该展示,以及如何展示。

  2. 减少前后端联调:由于字段的定义和行为是由后端控制的,前后端的联调需求大大减少。前端开发者主要关注于如何呈现这些字段,而后端则负责数据的逻辑和结构。

  3. 灵活性与规范性:虽然Oinone推荐所有场景都遵循后端模型驱动字段的原则,以保持前后端的一致性和减少沟通成本,但它也为高度定制化的前端页面提供了灵活性。

  4. 元数据使用:Oinone可能还使用元数据来进一步定义字段的行为,例如它们是否可见、如何验证用户输入等。

结合前后端

在使用Oinone时,理解前后端如何合作来定义和展示字段是很重要的。这种方法不仅提高了开发效率,而且有助于确保数据的一致性和应用程序的可维护性。同时,对于那些需要特定定制或特殊处理的场景,开发团队能够灵活地适应这些需求,在遵守总体架构原则的同时进行一些特定的调整和优化。

作用场景

在Oinone框架中,字段扮演着连接后端数据模型和前端用户界面的重要角色。其作用场景包括但不限于以下几点:

  1. 业务组件的核心: Oinone集成了AntdDesignVue的全部UI组件,将它们转化为业务组件。这些业务组件以字段的形式存在,使得前端开发变得简单高效。开发人员可以直接使用这些现成的业务组件来构建用户界面,大大减少了开发工作量。

  2. 无代码开发支持: 字段的设计使得Oinone支持无代码开发。开发者可以通过拖拉拽的方式在前端快速构建界面,而后端模型的定义直接决定了这些界面的生成。这种模式简化了传统的前端开发流程,提升了开发效率。

  3. 个性化定制: 虽然标准的UI组件可以满足大部分需求,但复杂多变的业务场景往往需要更多个性化的处理。在Oinone中,开发者可以根据具体业务需求和公司的UI指南,定义专门针对特定行业或客户的定制化字段和组件。

  4. 与无代码平台的结合: Oinone允许将个性化的字段和组件与无代码平台相结合。这意味着即使在进行个性化定制时,也能保持使用无代码工具的便利性,实现更灵活、更高效的前端开发。

  5. 适应多维度业务需求: 由于字段在Oinone中的灵活性和可定制性,它们能够适应多维度的业务需求,无论是从UI设计、用户体验还是业务逻辑的角度,字段都能提供合适的解决方案

自定义字段

示例工程目录

以下是需关注的工程目录示例,main.ts更新导入./field:
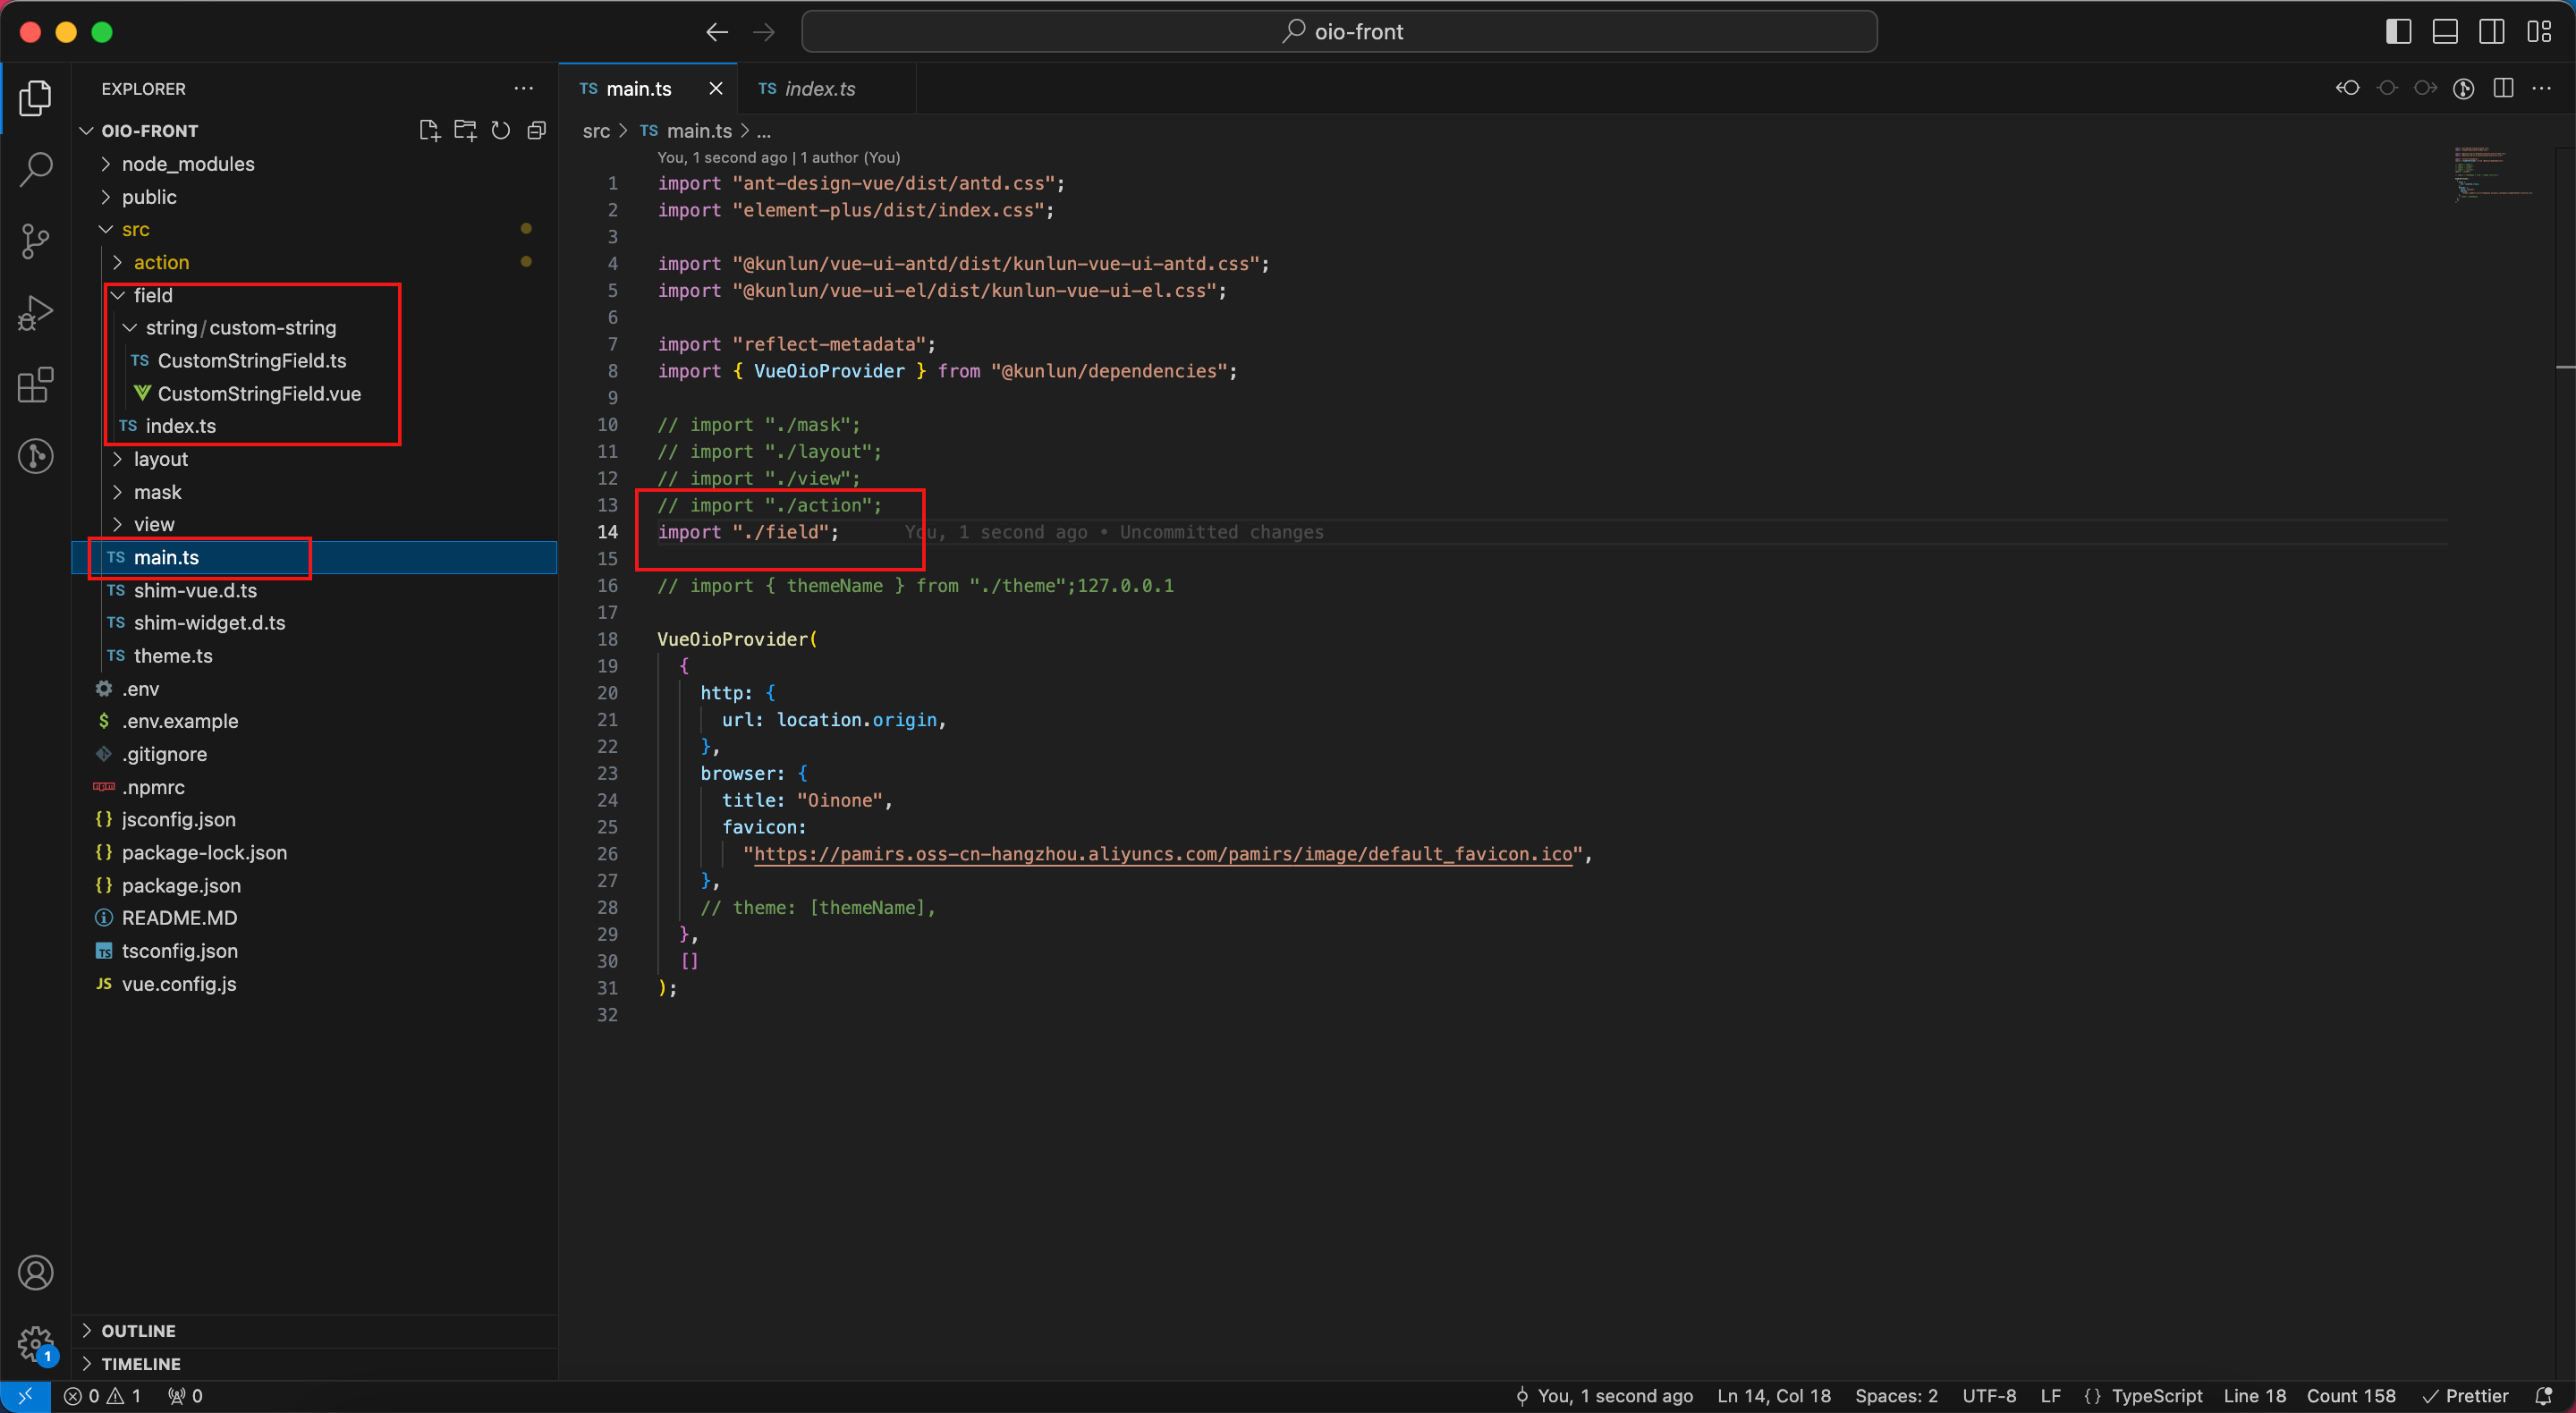
image.png

图3-5-7-24 自定义字段工程目录示例

示例代码

  1. 创建自定义字段组件:

    • 使用Vue框架创建一个新的组件(例如 CustomStringFieldVue),并定义其模板、脚本和样式。
    • 在模板中定义字段的HTML结构。
    • 在脚本中使用 defineComponent 来定义Vue组件。
  2. 字段类的定义:

    • 导入必要的模块,如 FormFieldWidget, ModelFieldType, SPI, ViewType 等。
    • 使用 @SPI.ClassFactory 装饰器来注册自定义字段。
    • 在类内部初始化并设置组件。
  3. SPI注册参数解释:

    • viewType: 指定视图类型,如表单视图或搜索视图。
    • widget: 可以指定组件名称。
    • ttype: 字段的业务类型,例如字符串、数字等。
    • multi: 指明字段是否支持多值。
    • model: 定义字段所属的模型。
    • viewName: 指定视图名称。
    • name: 定义所属字段的名称。
import {FormFieldWidget, ModelFieldType, SPI, ViewType} from '@kunlun/dependencies';
import CustomStringFieldVue from './CustomStringField.vue';

@SPI.ClassFactory(
  FormFieldWidget.Token({ viewType: [ViewType.Form, ViewType.Search], ttype: ModelFieldType.String })
)
export class CustomStringField extends FormFieldWidget {
  public initialize(props) {
    super.initialize(props);
    this.setComponent(CustomStringFieldVue);
    return this;
  }
}

图3-5-7-24 自定义字段组件(TS)示例

<template>
  <div class="custom-string-filed-wrapper">
   字段组件
  </div>
</template>

<script lang="ts">
import { defineComponent } from 'vue'

export default defineComponent({
  inheritAttrs: false,
  name: 'CustomStringFieldVue'
})
</script>

<style lang="scss">
.custom-string-filed-wrapper {
}
</style>

图3-5-7-24 自定义字段组件(Vue)示例

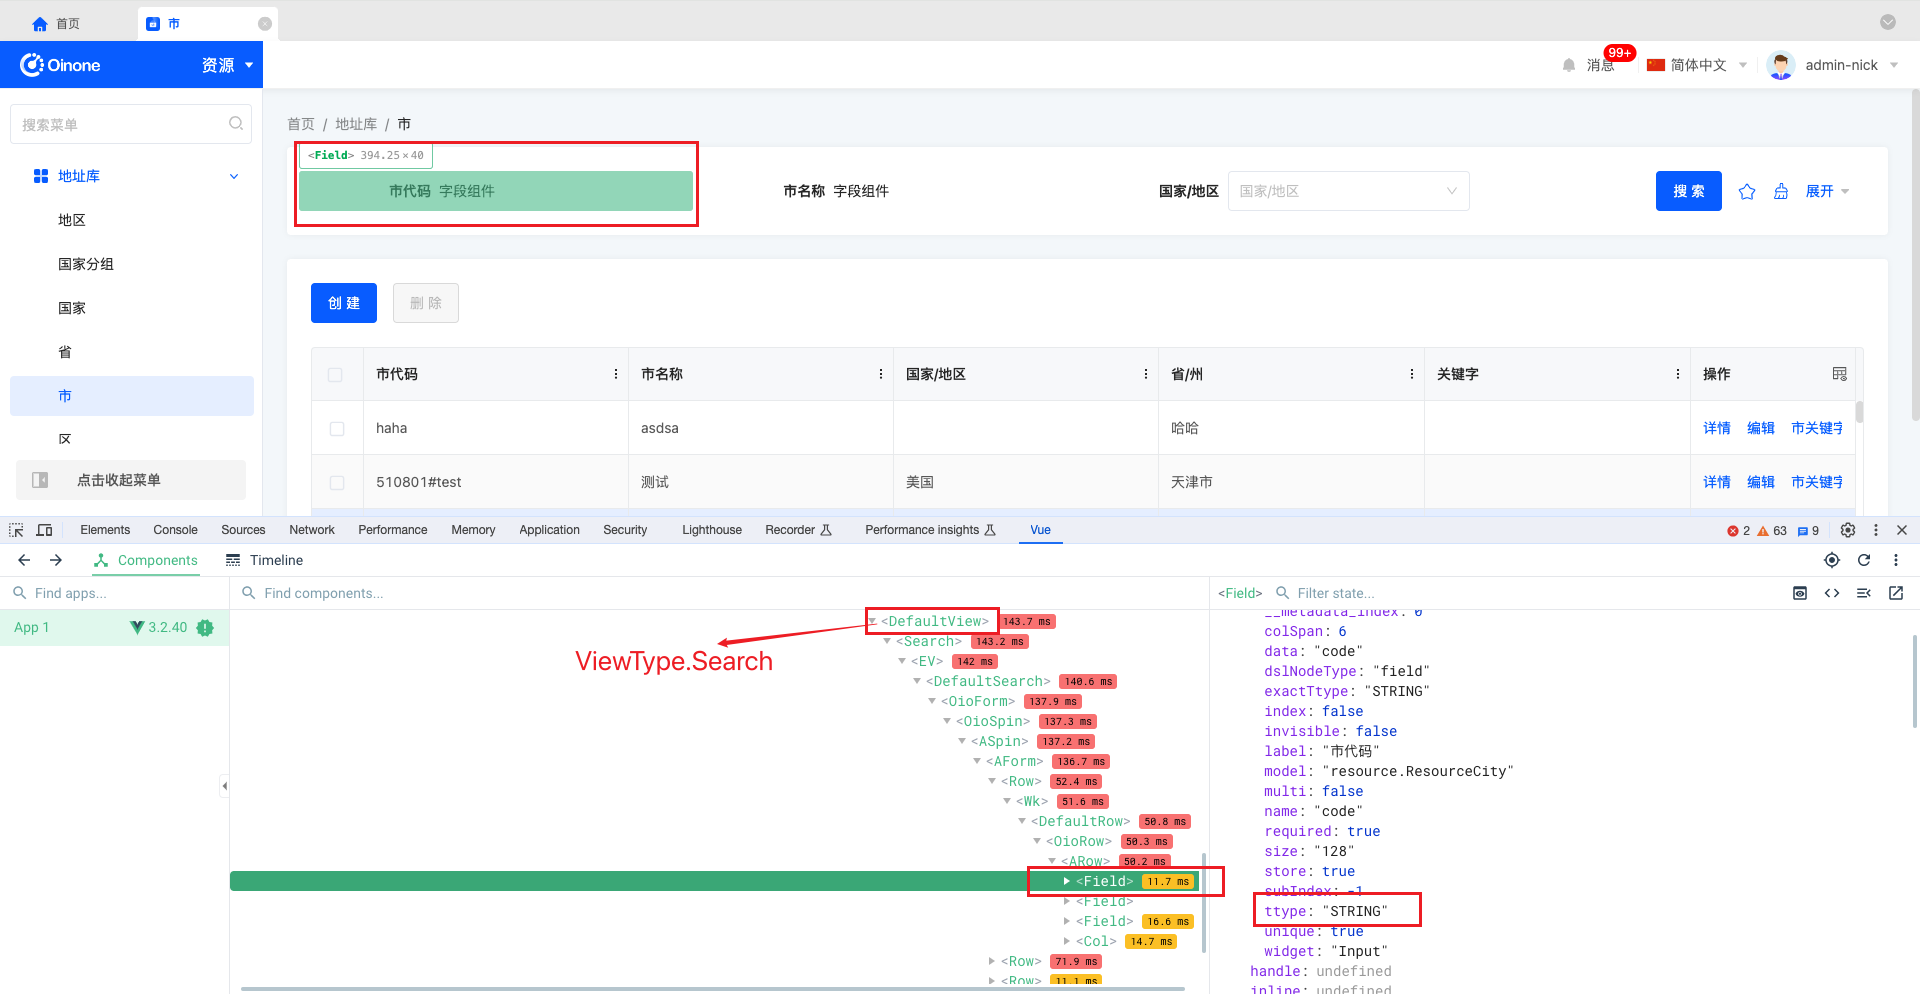
效果

image.png

图3-5-7-24 自定义字段效果示例

Oinone社区 作者:史, 昂原创文章,如若转载,请注明出处:https://doc.oinone.top/oio4/9269.html

访问Oinone官网:https://www.oinone.top获取数式Oinone低代码应用平台体验

Like (0)
史, 昂's avatar史, 昂数式管理员
Previous 2024年5月23日 am9:09
Next 2024年5月23日 am9:11

相关推荐

  • 资源

    翻译应用是管理翻译规则的应用,以模型为基础、维护字段的翻译值,支持导入、导出 1. 操作步骤 Step1:导出所有翻译项; Step2:线下翻译; Step3:导入翻译项; Step4:刷新远程资源; Step5:页面右上角可切换语言,查看翻译效果。 2. 新增翻译 翻译是具体到模型字段,其中需要区分出是否字典; 源语言、目标语言,是在资源中维护的语言,可在资源中维护需要翻译的语言; 翻译项则是模型字段,默认翻译项为激活状态,关闭后维护的翻译项无效。 3. 导出、导入 不勾选导出:导出所有需要翻译的翻译项,包括模块、字段,源术语、翻译值等,其中如果已经翻译过的内容,会体现在翻译值中; 勾选导出:导出勾选模型的翻译项。 导入:导入翻译项,平台会根据模型拆分为多条数据。 4. 刷新远程资源 导入翻译项后,点击“刷新远程资源”按钮。 5. 查看翻译内容 页面右上角切换语言,查看翻译效果。

    2024年6月20日
    1.6K00
  • 4.1.17 框架之网关协议-GraphQL协议

    GraphQL 是一个用于 API 的查询语言,是一个使用基于类型系统来执行查询的服务端运行时(类型系统由你的数据定义)。GraphQL 并没有和任何特定数据库或者存储引擎绑定,而是依靠你现有的代码和数据支撑。 一个 GraphQL 服务是通过定义类型和类型上的字段来创建的,然后给每个类型上的每个字段提供解析函数。例如,一个 GraphQL 服务告诉我们当前登录用户是 me,这个用户的名称可能像这样: type Query { me: User } type User { id: ID name: String } 图4-1-17-1 GraphQL定义类型和字段示意 一并的还有每个类型上字段的解析函数: function Query_me(request) { return request.auth.user; } function User_name(user) { return user.getName(); } 图4-1-17-2 每个类型上字段的解析函数示意 一旦一个 GraphQL 服务运行起来(通常在 web 服务的一个 URL 上),它就能接收 GraphQL 查询,并验证和执行。接收到的查询首先会被检查确保它只引用了已定义的类型和字段,然后运行指定的解析函数来生成结果。 例如这个查询: { me { name } } 图4-1-17-3 GraphQL查询请求示意 会产生这样的JSON结果: { "me": { "name": "Luke Skywalker" } } 图4-1-17-4 GraphQL查询结果示意 了解更多 https://graphql.cn/learn/

    Oinone 7天入门到精通 2024年5月23日
    1.5K00
  • 3.3.6 枚举与数据字典

    枚举是大家在系统开发中经常用的一种类型,在oinone中也对枚举类型进行了支持,同时也做了相应的加强。希望通过本文能让大家对枚举的使用,有更全面的认知 一、枚举系统与数据字典 枚举是列举出一个有穷序列集的所有成员的程序。在元数据中,我们使用数据字典进行描述。 协议约定 枚举需要实现IEnum接口和使用@Dict注解进行配置,通过配置@Dict注解的dictionary属性来设置数据字典的唯一编码。前端使用枚举的displayName来展示,枚举的name来进行交互;后端使用枚举的value来进行交互(包括默认值设置也使用枚举的value)。 枚举会存储在元数据的数据字典表中。枚举分为两类:1.异常类;2.业务类。异常类枚举用于定义程序中的错误提示,业务类枚举用于定义业务中某个字段值的有穷有序集。 编程式用法 图3-3-6-1 编程式用法 如果一个字段的类型被定义为枚举,则该字段就可以使用该枚举来进行可选项约束(options)。该字段的可选项为枚举所对应数据字典的子集。 可继承枚举 继承BaseEnum可以实现java不支持的继承枚举。同时可继承枚举也可以用编程式动态创建枚举项。 可继承枚举也可以兼容无代码枚举。 图3-3-6-2 可继承枚举 二进制枚举 可以通过@Dict注解设置数据字典的bit属性或者实现BitEnum接口来标识该枚举值为2的次幂。 二、enum不可继承枚举(举例) 我们在介绍抽象基类中AbstractDemoCodeModel和AbstractDemoIdModel就引入了数据状态(DataStatusEnum)字段,并设置了必填和默认值为DISABLED。DataStatusEnum实现了IEnum接口,并用@Dict(dictionary = DataStatusEnum.dictionary, displayName = "数据状态")进行了注解。为什么不能继承呢?因为JAVA语言的限制导致enum是不可继承的 package pro.shushi.pamirs.core.common.enmu; import pro.shushi.pamirs.meta.annotation.Dict; import pro.shushi.pamirs.meta.common.enmu.IEnum; @Dict(dictionary = DataStatusEnum.dictionary, displayName = "数据状态") public enum DataStatusEnum implements IEnum<String> { DRAFT("DRAFT", "草稿", "草稿"), NOT_ENABLED("NOT_ENABLED", "未启用", "未启用"), ENABLED("ENABLED", "已启用", "已启用"), DISABLED("DISABLED", "已禁用", "已禁用"); public static final String dictionary = "partner.DataStatusEnum"; private String value; private String displayName; private String help; DataStatusEnum(String value, String displayName, String help) { this.value = value; this.displayName = displayName; this.help = help; } public String getValue() { return value; } public String getDisplayName() { return displayName; } public String getHelp() { return help; } } 图3-3-6-3 不可继承枚举 三、BaseEnum可继承枚举(举例) Step1 新增CatShapeExEnum继承CatShapeEnum枚举 package pro.shushi.pamirs.demo.api.enumeration; import pro.shushi.pamirs.meta.annotation.Dict; @Dict(dictionary = CatShapeExEnum.DICTIONARY,displayName = "萌猫体型Ex") public class CatShapeExEnum extends CatShapeEnum { public static final String DICTIONARY ="demo.CatShapeExEnum"; public final static CatShapeExEnum MID =create("MID",3,"中","中"); } 图3-3-6-4 新增CatShapeExEnum继承CatShapeEnum枚举 Step2 修改PetCatType的shape字段类型为CatShapeExEnum package pro.shushi.pamirs.demo.api.model; import pro.shushi.pamirs.demo.api.enumeration.CatShapeExEnum; import pro.shushi.pamirs.meta.annotation.Field; import pro.shushi.pamirs.meta.annotation.Model; @Model.MultiTableInherited(type = PetCatType.KIND_CAT) @Model.model(PetCatType.MODEL_MODEL) @Model(displayName="萌猫品种",labelFields = {"name"}) public class PetCatType extends PetType { public static final String MODEL_MODEL="demo.PetCatType"; public static final String KIND_CAT="CAT"; @Field(displayName = "宠物分类",defaultValue…

    2024年5月23日
    3.8K00
  • 1.1 Oinone的萌芽

    在信息化时代,中国并没有涌现出一家世界知名的软件公司。这是因为像SAP、Oracle、IBM、Salesforce、NetSuite、Odoo等西方巨头所拥有的最佳实践在业务、技术和模式方面,给予了它们在企业信息化建设中高额利润的优势。中国软件业在这个时代的角色是学习和追随者,而最优秀的追随者是金蝶和用友,它们能在国家推行会计电算化的机遇中占据领先地位。但是,追随者始终只是追随者,没有真正的突破。 我自己进入软件行业的经历可以追溯到2015年。当时资本市场非常热门,大家都在创业。我认为这是一个时代的机会,就像国家改革开放一样。于是,我和很多同事一起开始了创业之旅。在数式之前,我加入并创办了三家公司:500mi、数列和端点。整个过程给了我宝贵的经验和启示,帮助我找到了最终想要的方向。 在500mi公司时,我从技术岗位转型为业务经营,起步并不顺利。然而,我从这份经历中获得了一堂重要的课:做自己擅长的事情,有助于渡过创业启动期最艰难的阶段。同时,市场调研为我提供了一个信号:传统企业对于IT的需求正逐渐向互联网靠拢。这个信号像注入了一剂强心剂,激励我继续前行。 2016年,我和三个曾在阿里工作的同事一起创办了一家新公司——数列,我们决定专注于我们最擅长的领域,即软件服务商。在没有任何商务资源的情况下,我们第一年就完成了1000多万的合同,这相较之前是一个非常成功的开端。然而,对于公司未来的发展方向,我们花费了长达大半年的时间进行思考:应该坚持做底层的PaaS还是专注于企业可见的上层应用和业务产品?我倾向于后者。尽管我们持续存在分歧,但凭借着多年的革命友情,最终我们友好地分道扬镳。数列此前的成功让我更加坚信:在数字化时代,软件需求将会有井喷式的增长,数字化软件服务将是未来5-10年的重要方向。而在这个领域,专业的技能将是应对未来不确定性的真正力量。 提到数字化,就不得不提阿里巴巴提出的中台理念。中台理念在15年前被阿里巴巴提出,当时引起了广泛的关注和讨论。企业之所以认同中台理念,是因为他们的核心需求已经从内部转向外部:从关注管理、流程、效率的提升,转向关注外部协同、运营、创新。他们已经不再只担心企业的效率和成本,而是担心自己是否有能力跟上时代的快速变化。现今做生意的渠道已经不再是单一的线下渠道,而是包括淘宝、天猫、京东、拼多多、抖音、快手等多个线上渠道,以及海外市场,这种变化速度非常快。而中台的核心理念是敏捷响应、低成本快速创新,正好解决了企业主的核心焦虑。 企业的视角正在从内部管理向业务在线和生态在线(协同)转变,这种转变带来了一系列新的需求(如下图1-1所示)。这种转变不仅是为了支持现有业务的发展,也为企业未来的业务发展和创新提供了支持,并将变化实时反映到上下游合作伙伴中。 图1-1 企业视角转变带来一系列新的诉求 在2017年下半年,阿里云收购了端点科技,打算重启阿里软件。那个时候,市场上涌现出一批中台厂商,整个行业也比较混乱,很多人对互联网架构本身的理解不够深入,快速学习拿到阿里云认证后就开始做定制化的中台架构开发,但最终的效果无法达到预期。因此,阿里云和端点科技的联姻是为了弥补阿里云没有向外输出上层应用产品能力的缺陷。多年来,软件市场一直被国外厂商掌控,中国一直缺乏一个强大的本土软件公司。阿里收购端点,承载着无数中国人的软件梦想。在这种背景下,我回到了阿里体系,加入了端点科技。后来,我参与了许多中台项目,深刻地认识到搭建中台技术架构和一些基础能力,为上层应用场景落地并不难。但是,当客户接手扩展中台能力和新的上层应用场景时,效果往往不尽如人意,这并不是中台架构理念的问题,而是因为传统企业客户的IT能力大多较弱,这是一个硬伤。许多文章都在讲述中台战略,长篇大论地描述组织中台、技术中台、业务中台、数据中台,我们不去评论这些方法论的对错,从技术角度回到初衷,我们只关注一个问题:技术是为商业服务的,中台如何快速满足企业业务多变的需求? 我们经历了多个行业的中台建设,每次都向客户强调第一阶段是打好基础,因此需要较长的周期,并且每个项目都需要顶级架构师来把控整体项目。如何找到互联网架构与传统软件良好结合点,降低对组织的要求,实现中台架构的标准化输出?这是我回归阿里后致力于解决的问题。然而,随着阿里云对端点战略发展思路的变化,阿里不再提供SaaS服务,而只愿意做平台被其他企业集成。因此,我离开了端点,并决定把自己的技术思考转化为现实,于是数式科技诞生了。 在数字化时代,无论是业务、技术还是商业模式的最佳实践,都源自中国。中国已经从追随者转变为互联网领域的全面引领者。我们有理由相信,中国一定会崛起一家世界级的软件公司,而Oinone将始终以此为愿景。

    2024年5月23日
    2.5K00
  • 4.1.24 框架之分库分表

    随着数据库技术的发展如分区设计、分布式数据库等,业务层的分库分表的技术终将成老一辈程序员的回忆,谈笑间扯扯蛋既羡慕又自吹地说到“现在的研发真简单,连分库分表都不需要考虑了”。竟然这样为什么要写这篇文章呢?因为现今的数据库虽能解决大部分场景的数据量问题,但涉及核心业务数据真到过亿数据后性能加速降低,能给的方案都还有一定的局限性,或者说性价比不高。相对性价比比较高的分库分表,也会是现阶段一种不错的补充。言归正传oinone的分库分表方案是基于Sharding-JDBC的整合方案,所以大家得先具备一点Sharding-JDBC的知识。 一、分表(举例) 做分库分表前,大家要有一个明确注意的点就是分表字段的选择,它是非常重要的,与业务场景非常相关。在明确了分库分表字段以后,甚至在功能上都要做一些妥协。比如分库分表字段在查询管理中做为查询条件是必须带上的,不然效率只会更低。 Step1 新建ShardingModel模型 ShardingModel模型是用于分表测试的模型,我们选定userId作为分表字段。分表字段不允许更新,所以这里更新策略设置类永不更新,并在设置了在页面修改的时候为readonly package pro.shushi.pamirs.demo.api.model; import pro.shushi.pamirs.boot.base.ux.annotation.field.UxWidget; import pro.shushi.pamirs.boot.base.ux.annotation.view.UxForm; import pro.shushi.pamirs.meta.annotation.Field; import pro.shushi.pamirs.meta.annotation.Model; import pro.shushi.pamirs.meta.enmu.FieldStrategyEnum; @Model.model(ShardingModel.MODEL_MODEL) @Model(displayName = "分表模型",summary="分表模型",labelFields ={"name"} ) public class ShardingModel extends AbstractDemoIdModel { public static final String MODEL_MODEL="demo.ShardingModel"; @Field(displayName = "名称") private String name; @Field(displayName = "用户id",summary = "分表字段",immutable=true/* 不可修改 **/) @UxForm.FieldWidget(@UxWidget(readonly = "scene == 'redirectUpdatePage'"/* 在编辑页面只读 **/ )) @Field.Advanced(updateStrategy = FieldStrategyEnum.NEVER) private Long userId; } 图4-1-24-1 新建ShardingModel模型 Step2 配置分表策略 配置ShardingModel模型走分库分表的数据源pamirsSharding 为pamirsSharding配置数据源以及sharding规则 a. pamirs.sharding.define用于oinone的数据库表创建用 b. pamirs.sharding.rule用于分表规则配置 pamirs: load: sessionMode: true framework: system: system-ds-key: base system-models: – base.WorkerNode data: default-ds-key: pamirs ds-map: base: base modelDsMap: "[demo.ShardingModel]": pamirsSharding #配置模型对应的库 图4-1-24-2 指定模型对应数据源 pamirs: sharding: define: data-sources: ds: pamirs pamirsSharding: pamirs #申明pamirsSharding库对应的pamirs数据源 models: "[trigger.PamirsSchedule]": tables: 0..13 "[demo.ShardingModel]": tables: 0..7 table-separator: _ rule: pamirsSharding: #配置pamirsSharding库的分库分表规则 actual-ds: – pamirs #申明pamirsSharding库对应的pamirs数据源 sharding-rules: # Configure sharding rule ,以下配置跟sharding-jdbc配置一致 – tables: demo_core_sharding_model: #demo_core_sharding_model表规则配置 actualDataNodes: pamirs.demo_core_sharding_model_${0..7} tableStrategy: standard: shardingColumn: user_id shardingAlgorithmName: table_inline shardingAlgorithms: table_inline: type: INLINE props: algorithm-expression: demo_core_sharding_model_${(Long.valueOf(user_id) % 8)} props: sql.show: true 图4-1-24-3 分库分表规则配置 Step3 配置测试入口 修改DemoMenus类增加一行代码,为测试提供入口 @UxMenu("分表模型")@UxRoute(ShardingModel.MODEL_MODEL) class ShardingModelMenu{} 图4-1-24-4 配置测试入口 Step4 重启看效果 自行尝试增删改查 观察数据库表与数据分布 图4-1-24-5 自行尝试增删改查 图4-1-24-6 观察数据库表与数据分布 二、分库分表(举例) Step1 新建ShardingModel2模型 ShardingModel2模型是用于分库分表测试的模型,我们选定userId作为分表字段。分库分表字段不允许更新,所以这里更新策略设置类永不更新,并在设置了在页面修改的时候为readonly package pro.shushi.pamirs.demo.api.model; import pro.shushi.pamirs.boot.base.ux.annotation.field.UxWidget; import pro.shushi.pamirs.boot.base.ux.annotation.view.UxForm; import…

    2024年5月23日
    1.6K00

Leave a Reply

Please Login to Comment