4.1.25 框架之搜索引擎

一、使用场景

在碰到大数据量并且需要全文检索的场景,我们在分布式架构中基本会架设ElasticSearch来作为一个常规解决方案。在oinone体系中增强模型就是应对这类场景,其背后也是整合了ElasticSearch。

二、整体介绍

oinone与es整合设计图
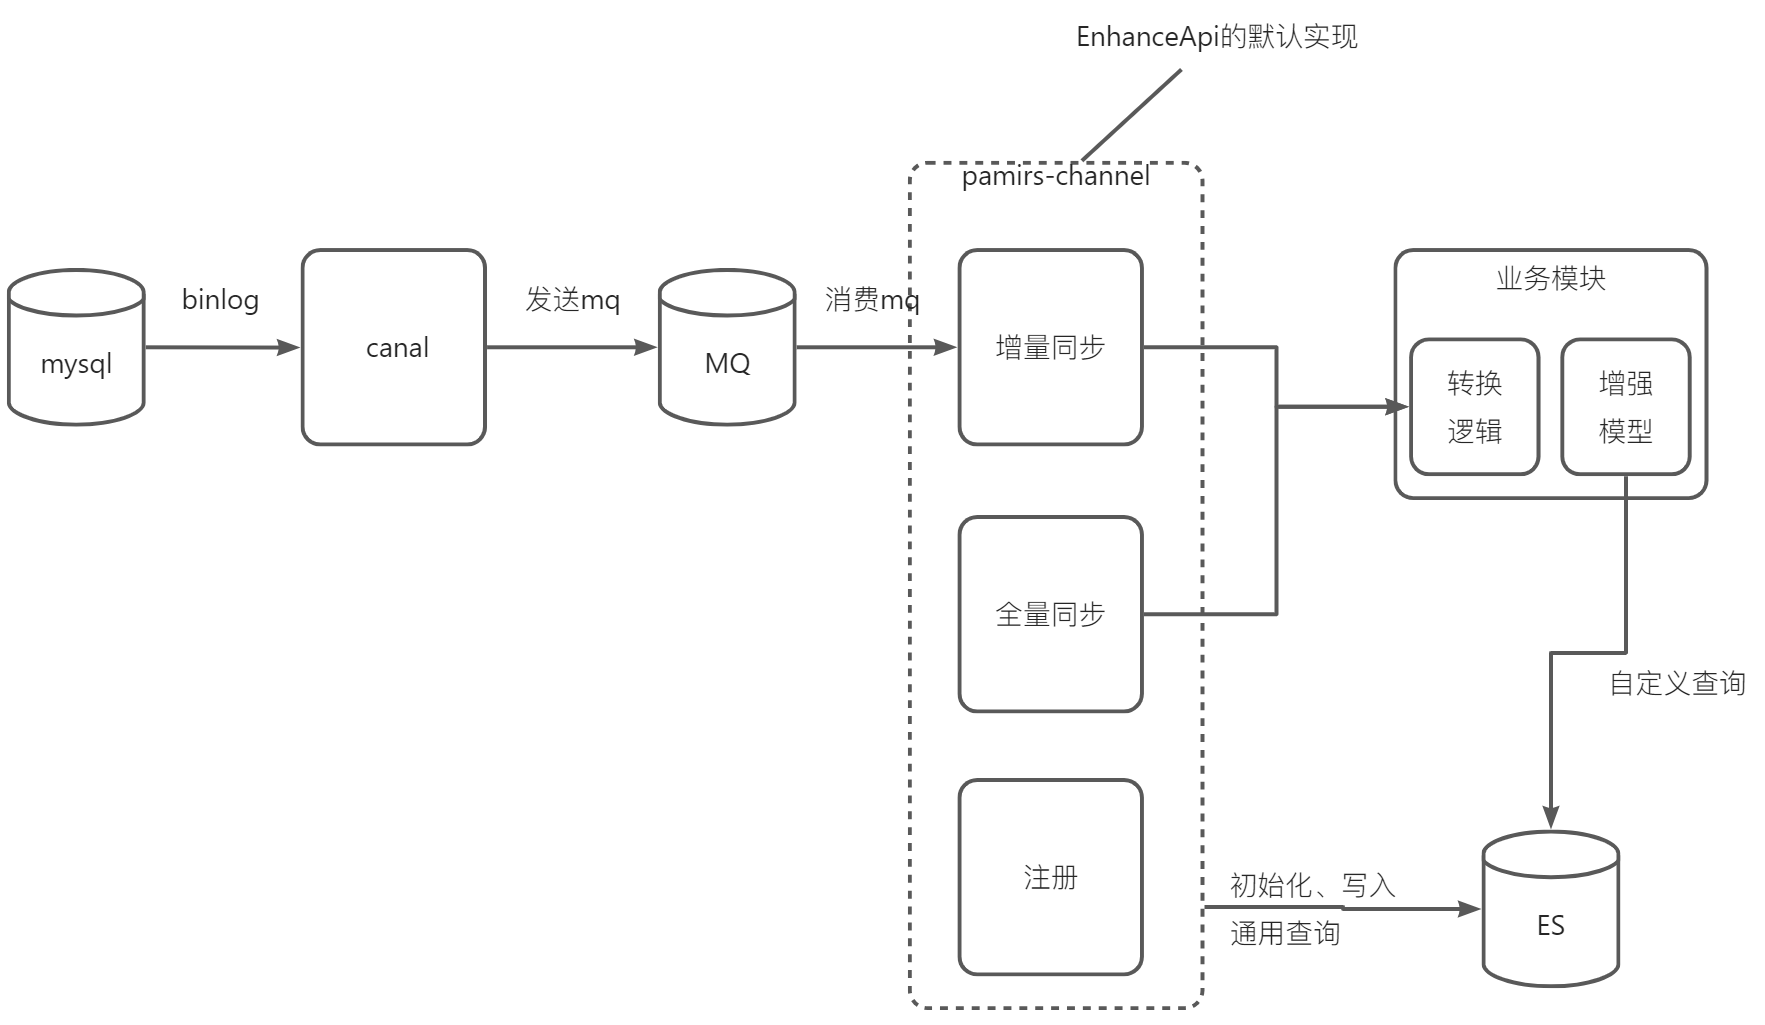
4.1.25 框架之搜索引擎

图4-1-25-1 Oinone与es整合设计图

基础环境安装

Canal安装

详见4.1.10【函数之触发与定时】一文

修改Canal配置并重启

新增Canal的实例【destinaion: pamirs】,监听分表模型的binlog【filter: demo.demo_core_sharding_model……】用于增量同步

pamirs:
  middleware:
    data-source:
      jdbc-url: jdbc:mysql://localhost:3306/canal_tsdb?useUnicode=true&characterEncoding=utf-8&verifyServerCertificate=false&useSSL=false&requireSSL=false
      driver-class-name: com.mysql.cj.jdbc.Driver
      username: root
      password: oinone
  canal:
    ip: 127.0.0.1
    port: 1111
    metricsPort: 1112
    zkClusters:
      - 127.0.0.1:2181
    destinations:
      - destinaion: pamirschangedata
        name: pamirschangedata
        desc: pamirschangedata
        slaveId: 1235
        filter: demo\.demo_core_pet_talent
        dbUserName: root
        dbPassword: oinone
        memoryStorageBufferSize: 65536
        topic: CHANGE_DATA_EVENT_TOPIC
        dynamicTopic: false
        dbs:
          - { address: 127.0.0.1, port: 3306 }
      - destinaion: pamirs
        id: 1234
        name: pamirs
        desc: pamirs
        slaveId: 1234
        filter: demo\.demo_core_sharding_model_0,demo\.demo_core_sharding_model_1,demo\.demo_core_sharding_model_2,demo\.demo_core_sharding_model_3,demo\.demo_core_sharding_model_4,demo\.demo_core_sharding_model_5,demo\.demo_core_sharding_model_6,demo\.demo_core_sharding_model_7
        dbUserName: root
        dbPassword: oinone
        memoryStorageBufferSize: 65536
        topic: BINLOG_EVENT_TOPIC
        dynamicTopic: false
        dbs:
          - { address: 127.0.0.1, port: 3306 }
    tsdb:
      enable: true
      jdbcUrl: "jdbc:mysql://127.0.0.1:3306/canal_tsdb"
      userName: root
      password: oinone
    mq: rocketmq
    rocketmq:
      namesrv: 127.0.0.1:9876
      retryTimesWhenSendFailed: 5
dubbo:
  application:
    name: canal-server
    version: 1.0.0
  registry:
    address: zookeeper://127.0.0.1:2181
  protocol:
    name: dubbo
    port: 20881
  scan:
    base-packages: pro.shushi  
server:
  address: 0.0.0.0
  port: 10010
  sessionTimeout: 3600

图4-1-25-2 修改Canal配置并重启

ES安装

  1. 下载安装包官方下载地址,也可以直接下载elasticsearch-8.4.1-darwin-x86_64.tar.gz.txt(361.7 MB),下载后去除后缀.txt,然后解压文件

  2. 替换安装目录/config下的[elasticsearch.yml](elasticsearch)(1 KB),主要是文件中追加了三个配置

xpack.security.enabled: false
xpack.security.http.ssl.enabled: false
xpack.security.transport.ssl.enabled: false

图4-1-25-3 elasticsearc.yml追加三个配置

  1. 启动

a. 导入环境变量(ES运行时需要JDK18及以上版本JDK运行环境, ES安装包中包含了一个JDK18版本)

# export JAVA_HOME=/Users/oinone/Documents/oinone/es/elasticsearch-8.4.1/jdk.app/Contents/Home/
export JAVA_HOME=ES解压安装目录/jdk.app/Contents/Home/

图4-1-25-4 导入环境变量

b. 运行ES

## nohup /Users/oinone/Documents/oinone/es/elasticsearch-8.4.1/bin/elasticsearch >> $TMPDIR/elastic.log 2>&1 &
nohup ES安装目录/bin/elasticsearch >> $TMPDIR/elastic.log 2>&1 & 

图4-1-25-5 运行ES

  1. 停止ES
lsof -nP -iTCP:9300 -sTCP:LISTEN | grep java | awk '{print $2;}' | xargs kill

图4-1-25-6 停止ES

ES控制台安装

  1. 下载cerebro-0.9.4.tgz.txt(54.6 MB)文件,下载后去除后缀.txt,然后解压文件,解压之后执行 bin/cerebro 或者 bin/cerebro.bat (windows)

  2. 进入cerebro-0.9.4/bin目录下执行以下命令

./cerebro

图4-1-25-7 启动ES控制台

  1. 启动后访问地址: http://localhost:9000

image.png

图4-1-25-8 访问ES控制台cerebro页面

  1. Node address 填入es服务地址
http://127.0.0.1:9200
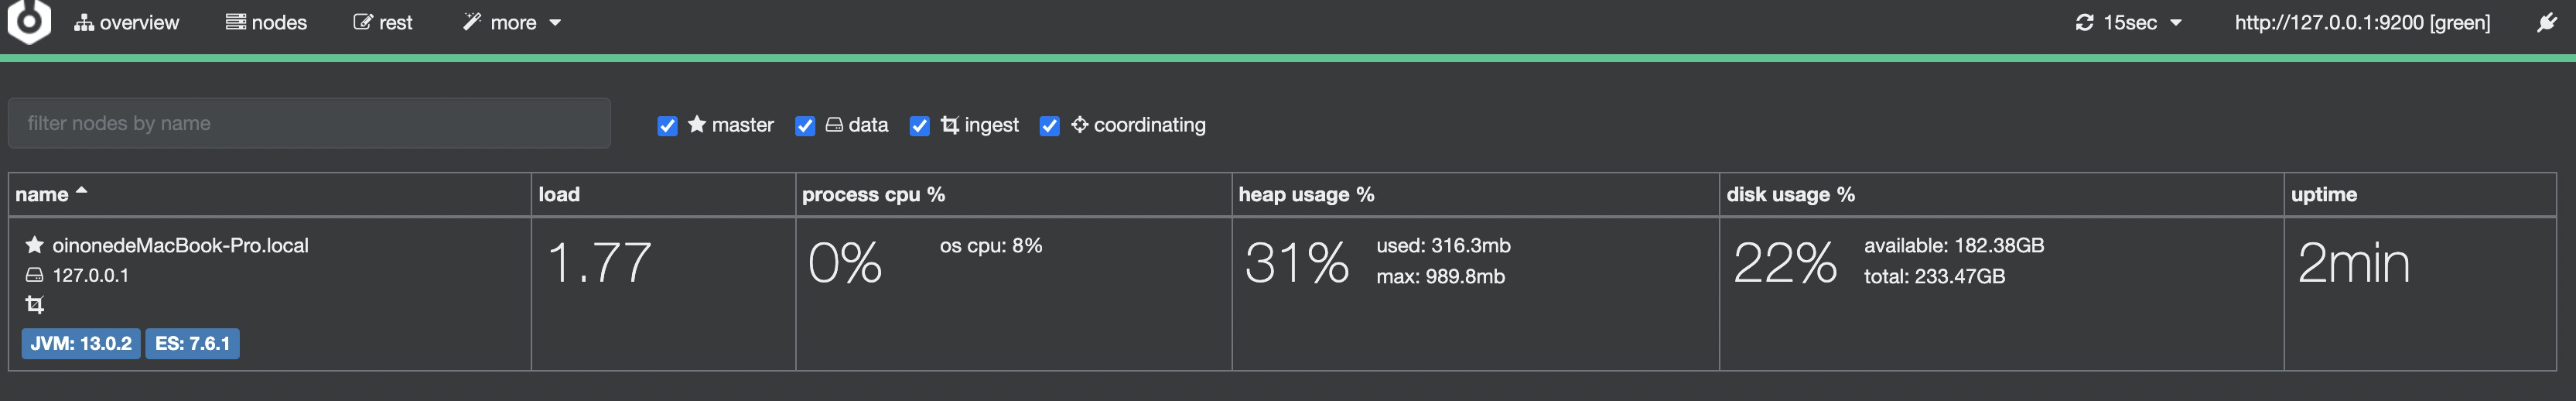
图4-1-25-9 输入ES服务地址

image.png

图4-1-25-10 Cerebro连接es成功

恭喜es环境搭建完毕,我们开始进入学习

三、第一个增强模型(举例)

Step1 相关依赖包引入boot工程

  1. boot工程需要指定ES客户端包版本,不指定版本会隐性依赖顶层spring-boot依赖管理指定的低版本

  2. boot工程加入pamris-channel的工程依赖

<dependency>
    <groupId>org.elasticsearch.client</groupId>
    <artifactId>elasticsearch-rest-client</artifactId>
    <version>8.4.1</version>
</dependency>
<dependency>
    <groupId>jakarta.json</groupId>
    <artifactId>jakarta.json-api</artifactId>
    <version>2.1.1</version>
</dependency>

<dependency>
    <groupId>pro.shushi.pamirs.core</groupId>
    <artifactId>pamirs-channel-core</artifactId>
</dependency>

图4-1-25-11 相关依赖包引入boot工程

Step2 在pamirs-demo-api中增加入pamirs-channel-api的依赖

<dependency>
    <groupId>pro.shushi.pamirs.core</groupId>
    <artifactId>pamirs-channel-api</artifactId>
</dependency>

图4-1-25-12 在pamirs-demo-api中增加入pamirs-channel-api的依赖

Step3 修改application-dev.yml

在pamirs-demo-boot的application-dev.yml文件中增加配置pamirs.boot.modules增加channel,即在启动模块中增加channel模块。同时注意es的配置,是否跟es的服务一致

pamirs:
    boot:
    modules:
        - channel
  elastic:
    url: 127.0.0.1:9200

图4-1-25-13 修改application-dev.yml

Step4 DemoModule增加对ChannelModule的依赖

@Module(dependencies = {ChannelModule.MODULE_MODULE})

图4-1-25-14 DemoModule增加对ChannelModule的依赖

Step5 为ShardingModel新建一个增强模型

在大数据量的情况下,我们经常会通过ES来提升查询速度

package pro.shushi.pamirs.demo.api.enhance;

import pro.shushi.pamirs.channel.enmu.IncrementEnum;
import pro.shushi.pamirs.channel.meta.Enhance;
import pro.shushi.pamirs.channel.meta.EnhanceModel;
import pro.shushi.pamirs.demo.api.model.ShardingModel;
import pro.shushi.pamirs.meta.annotation.Model;
import pro.shushi.pamirs.meta.enmu.ModelTypeEnum;

@Model(displayName = "测试EnhanceModel")
@Model.model(ShardingModelEnhance.MODEL_MODEL)
@Model.Advanced(type = ModelTypeEnum.PROXY, inherited = {EnhanceModel.MODEL_MODEL})
@Enhance(shards = "3", replicas = "1", reAlias = true,increment= IncrementEnum.OPEN)
public class ShardingModelEnhance extends ShardingModel {
    public static final String MODEL_MODEL="demo.ShardingModelEnhance";
}

图4-1-25-15 为ShardingModel新建一个增强模型

Step6 为增强模型增加菜单入口

@UxMenu("增强模型")@UxRoute(ShardingModelEnhance.MODEL_MODEL) class ShardingModelEnhanceMenu{}

图4-1-25-16 为增强模型增加菜单入口

Step7 重启系统看效果

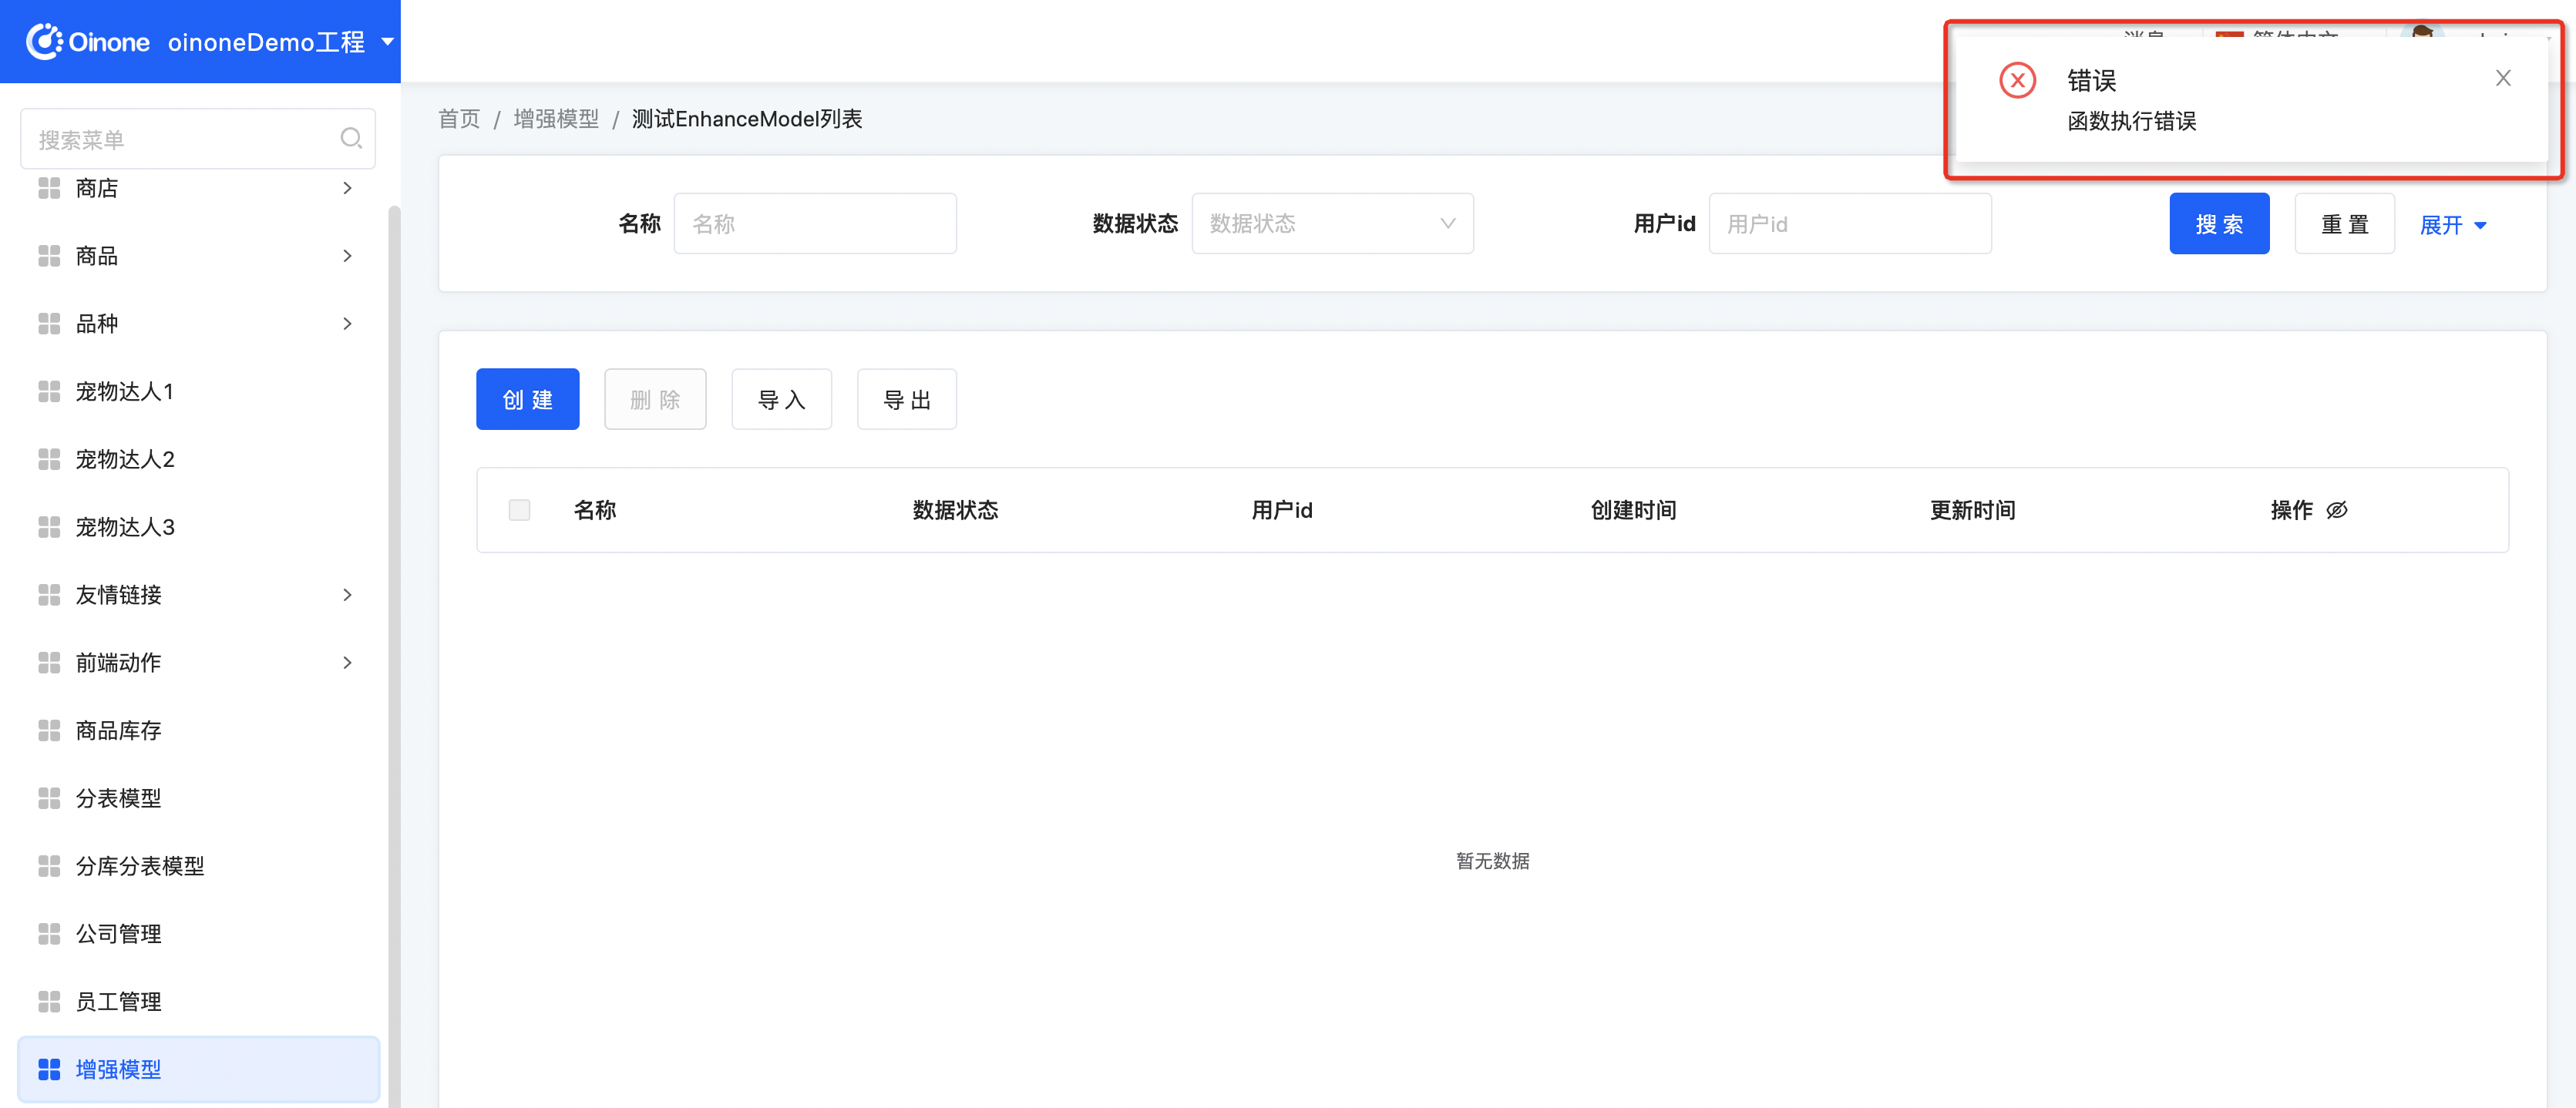
  1. 第一次访问页面会报错,因为针对该增强模型的相关初始化工作还未完成

image.png

图4-1-25-17 首次访问页面报错

  1. 进入【传输增强模型】应用,访问增强模型列表我们会发现一条记录,并点击【全量同步】初始化ES,并全量dump数据
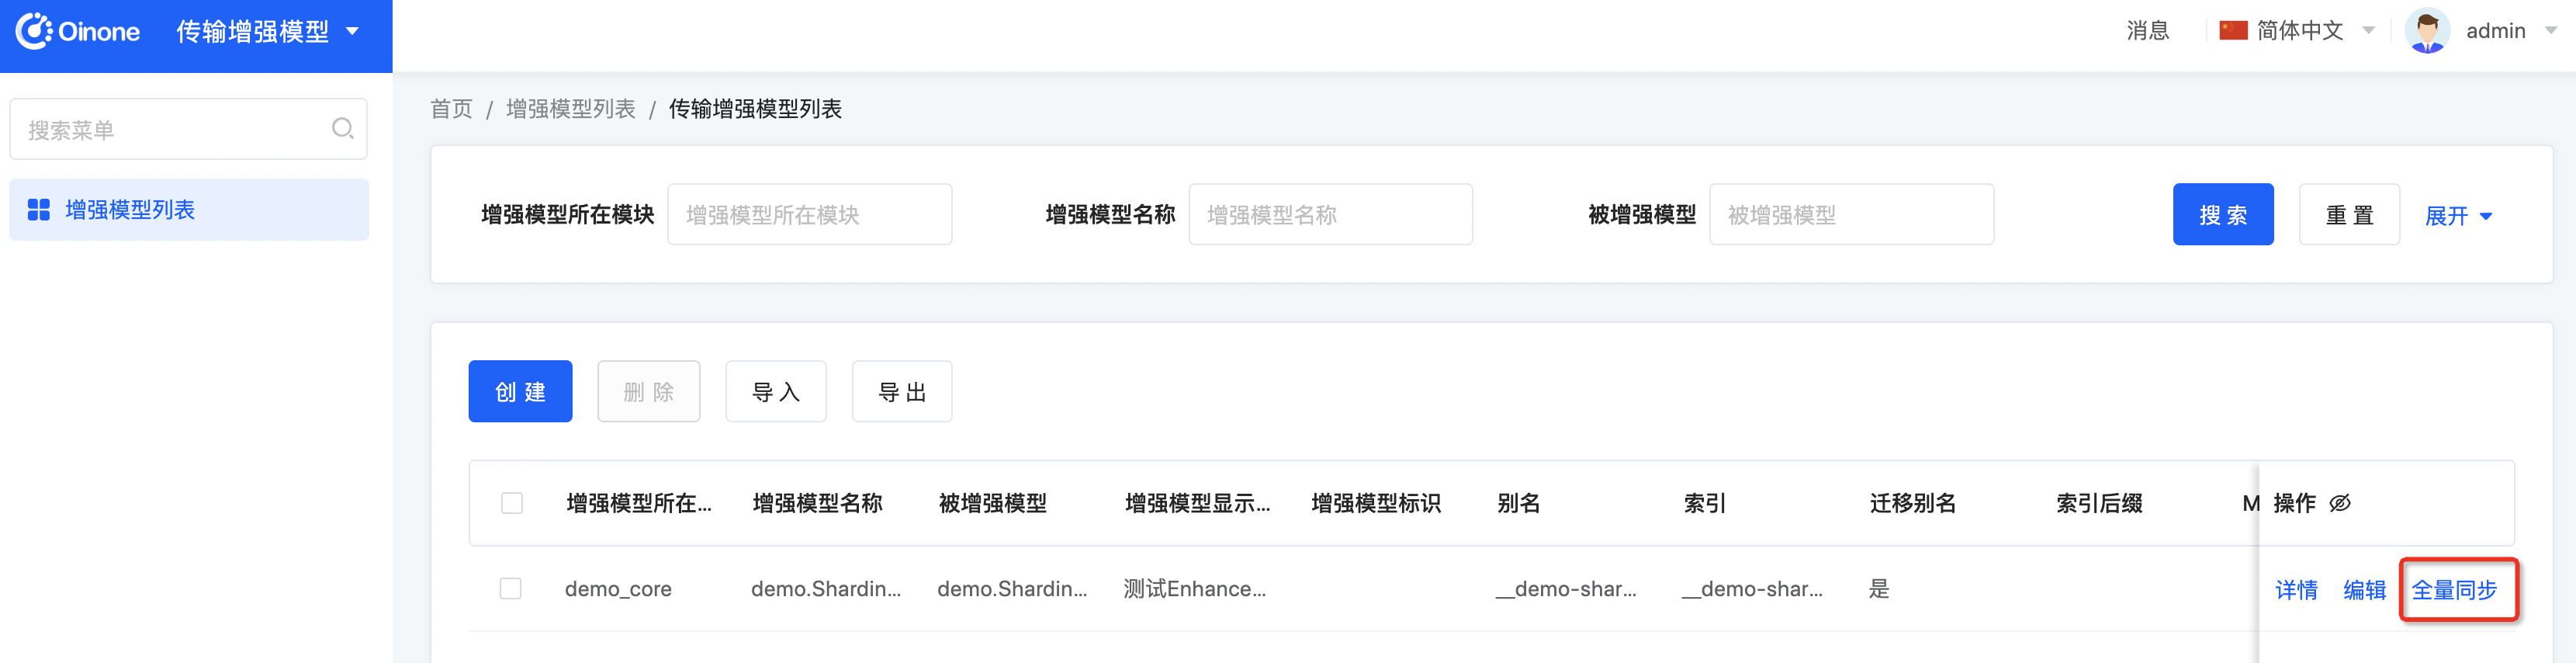
image.png

图4-1-25-18 全量dump数据

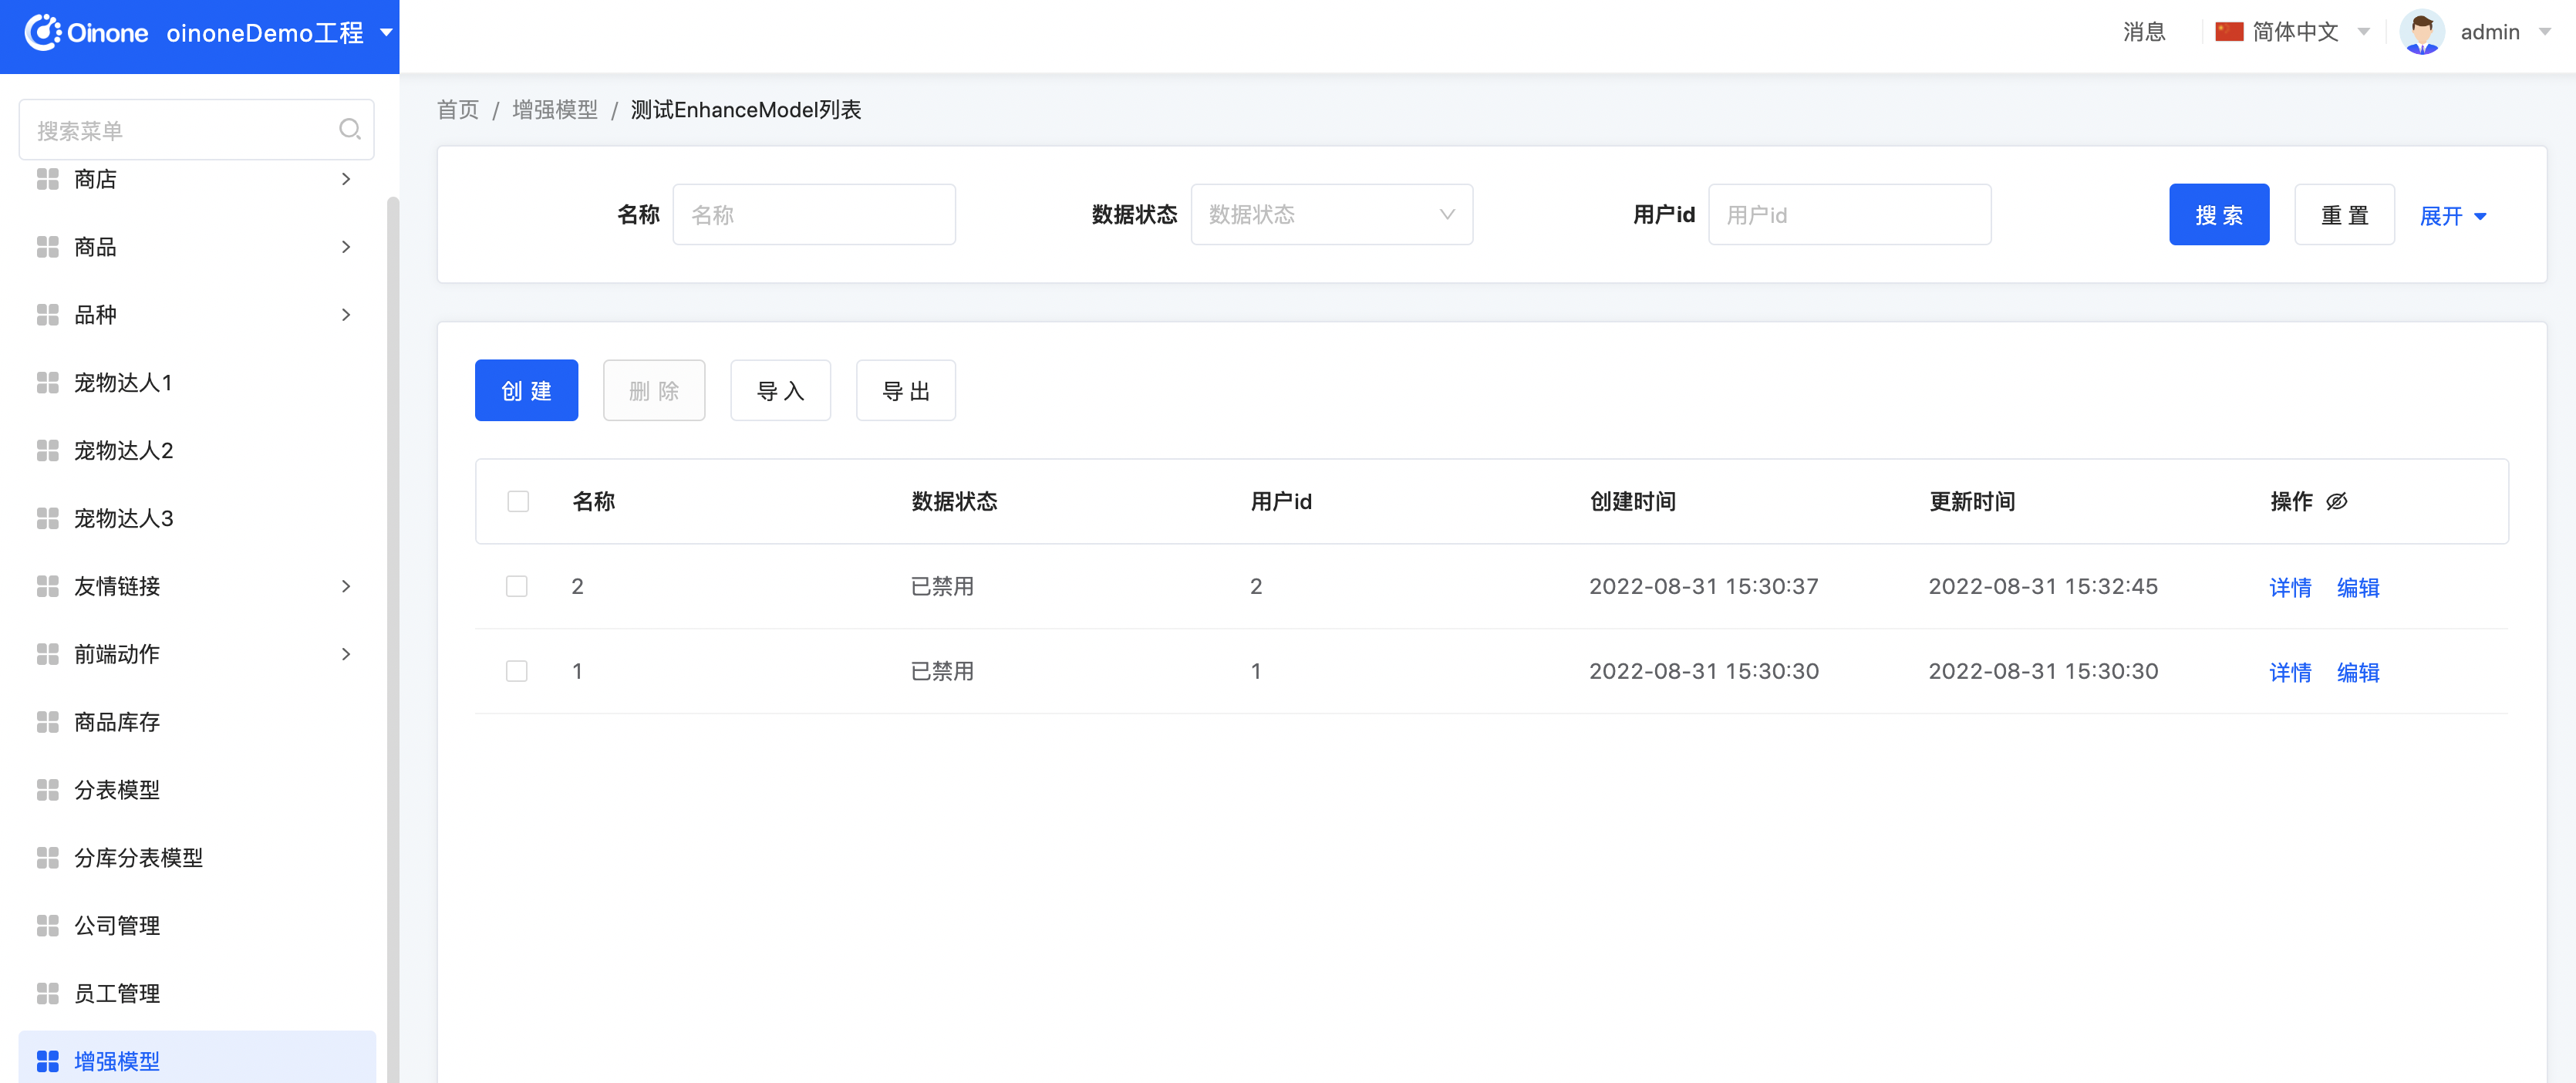
  1. 再次回到Demo应用,进入增强模型页面,可以正常访问并进增删改查操作

image.png

图4-1-25-19 再次回到Demo应用

对数据进行修改,我们可以看到以下日志

image.png

图4-1-25-20 数据修改后的日志

四、个性化dump逻辑

有时候我们dump逻辑是有个性化需求,那么我们可以重写模型的synchronize方法,函数重写特性我们在3.4.3【函数的相关特性】一文中的“面向对象-继承与多态”部分中已经有详细介绍。

Step1 重写ShardingModelEnhance模型的synchronize方法

下面例子中我们给ShardingModelEnhance模型增加一个nick字段,在同步搜索引擎的时候把name赋值给nick字段。

package pro.shushi.pamirs.demo.api.enhance;

import pro.shushi.pamirs.channel.enmu.IncrementEnum;
import pro.shushi.pamirs.channel.meta.Enhance;
import pro.shushi.pamirs.channel.meta.EnhanceModel;
import pro.shushi.pamirs.demo.api.model.ShardingModel;
import pro.shushi.pamirs.meta.annotation.Field;
import pro.shushi.pamirs.meta.annotation.Function;
import pro.shushi.pamirs.meta.annotation.Model;
import pro.shushi.pamirs.meta.enmu.FunctionTypeEnum;
import pro.shushi.pamirs.meta.enmu.ModelTypeEnum;

import java.util.List;

@Model(displayName = "测试EnhanceModel")
@Model.model(ShardingModelEnhance.MODEL_MODEL)
@Model.Advanced(type = ModelTypeEnum.PROXY, inherited = {EnhanceModel.MODEL_MODEL})
@Enhance(shards = "3", replicas = "1", reAlias = true,increment= IncrementEnum.OPEN)
public class ShardingModelEnhance extends ShardingModel {
    public static final String MODEL_MODEL="demo.ShardingModelEnhance";

    @Field(displayName = "nick")
    private String nick;

    @Function.Advanced(displayName = "同步数据", type = FunctionTypeEnum.UPDATE)
    @Function(summary = "数据同步函数")
    public List<ShardingModelEnhance> synchronize(List<ShardingModelEnhance> data) {
        for(ShardingModelEnhance shardingModelEnhance:data){
            shardingModelEnhance.setNick(shardingModelEnhance.getName());
        }
        return data;
    }
}

图4-1-25-21 重写ShardingModelEnhance模型的synchronize方法

Step2 重启应用看效果

我们修改记录数据,可以看到nick字段也自动赋值了。如果针对老数据记录,我们需要把新增的字段都自动填充,可以进入【传输增强模型】应用,访问增强模型列表,找到对应的记录并点击【全量同步】
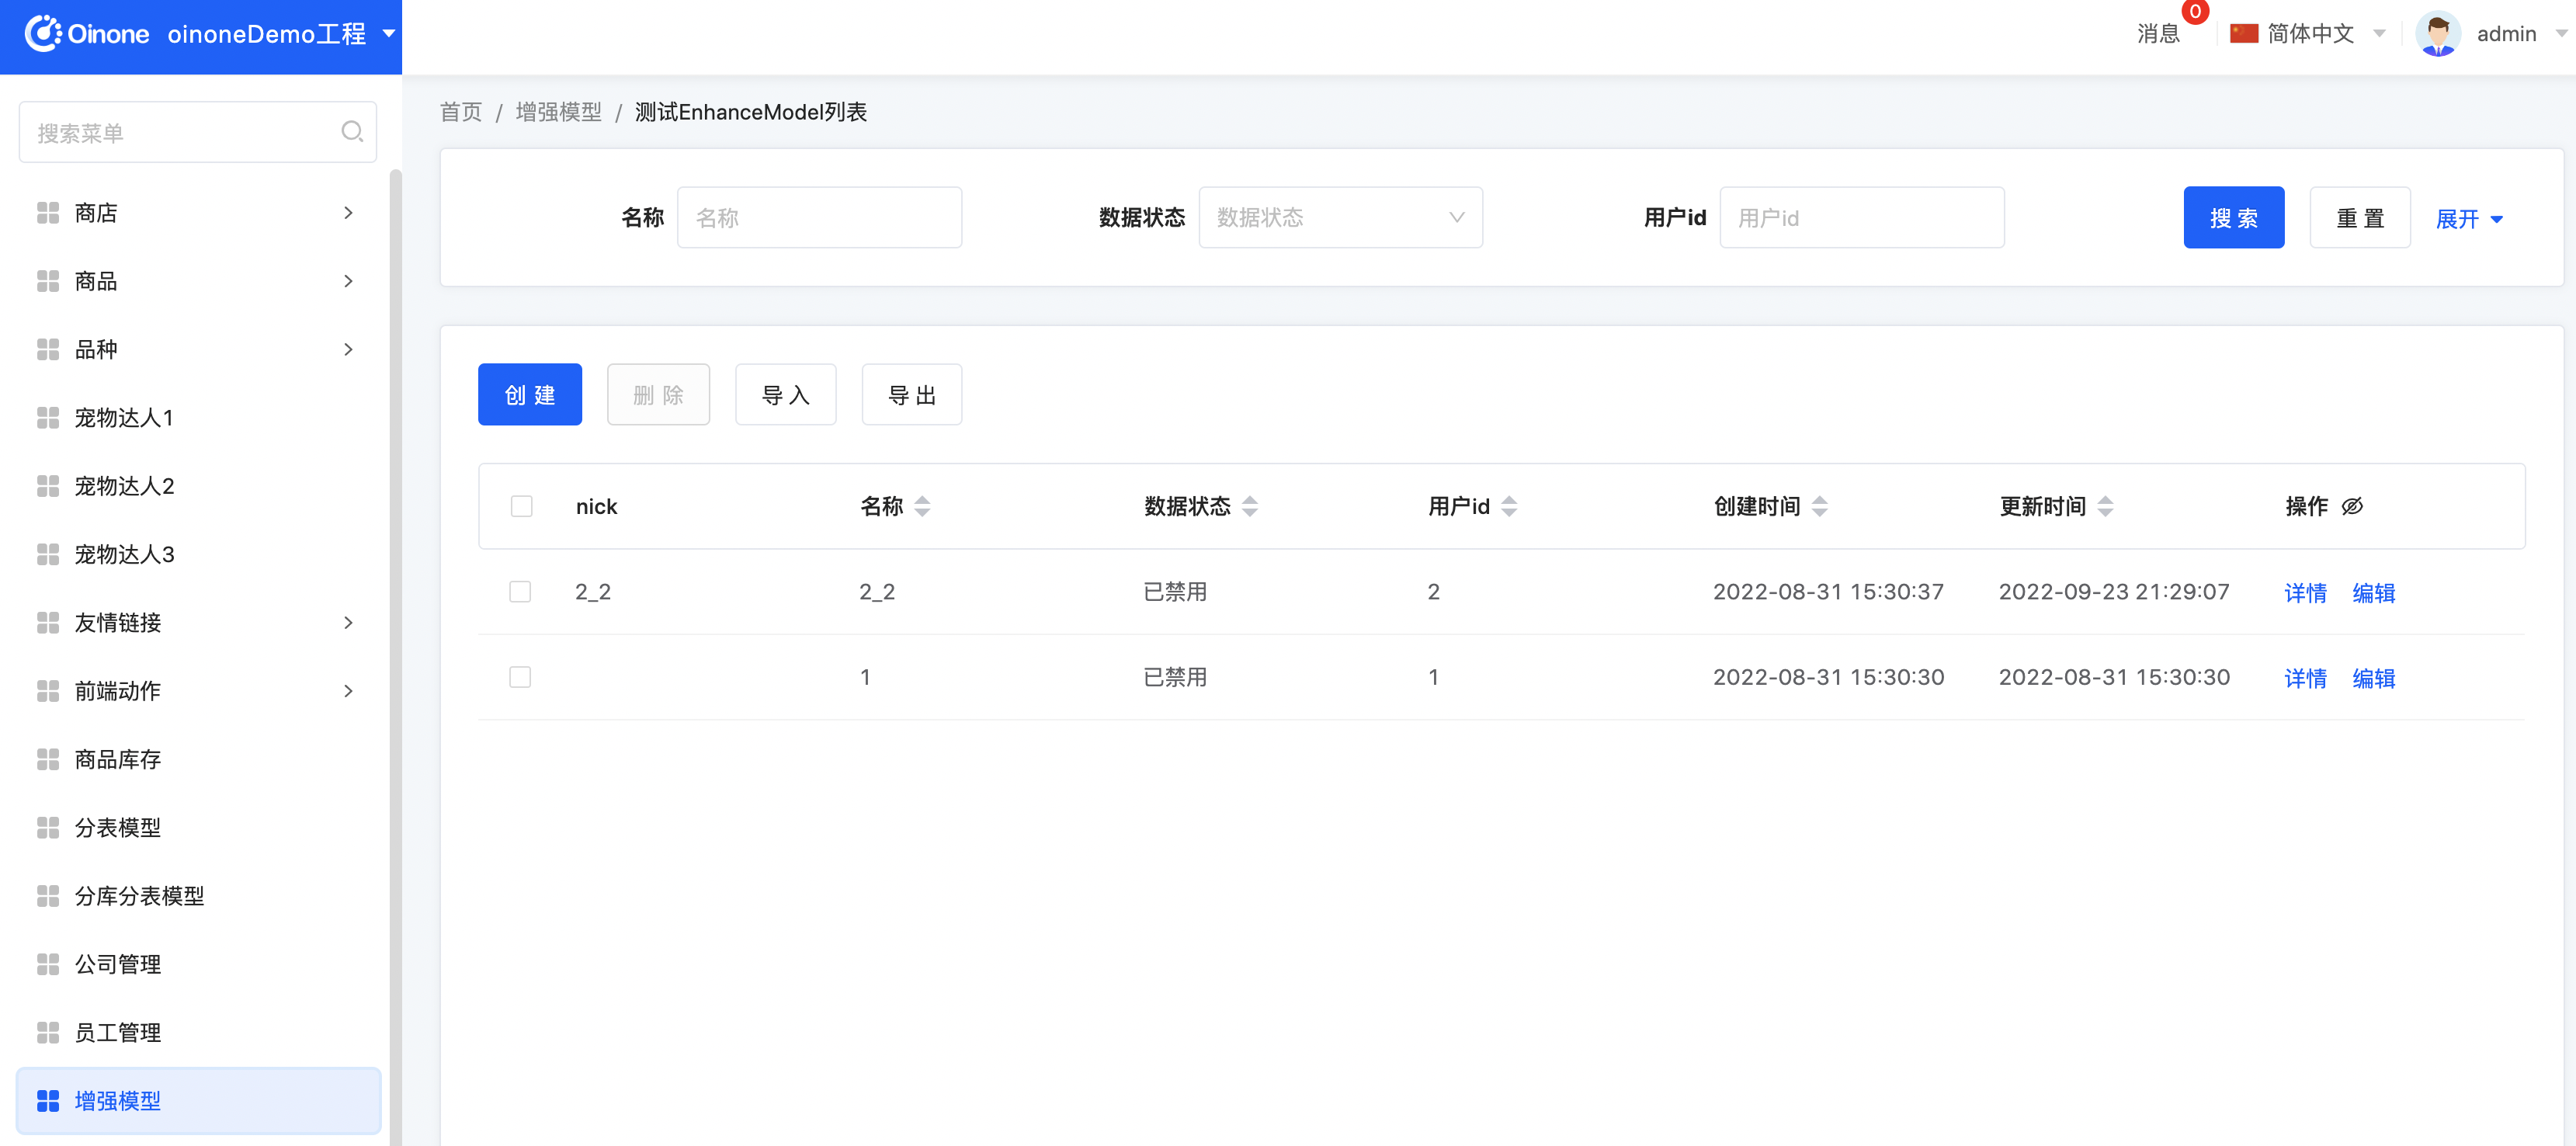
image.png

图4-1-25-22 示例效果

五、给搜索增加个性化逻辑

如果我们需要在查询方法中增加逻辑,在前面的教程中一般是重写queryPage函数,但对于增强模型我们需要重写的是search函数。

Step1 重写ShardingModelEnhance模型的search方法

@Function(
        summary = "搜索函数",
        openLevel = {FunctionOpenEnum.LOCAL, FunctionOpenEnum.REMOTE, FunctionOpenEnum.API}
)
@pro.shushi.pamirs.meta.annotation.Function.Advanced(
        type = {FunctionTypeEnum.QUERY},
        category = FunctionCategoryEnum.QUERY_PAGE,
        managed = true
)
public  Pagination<ShardingModelEnhance> search(Pagination<ShardingModelEnhance> page, IWrapper<ShardingModelEnhance> queryWrapper) {
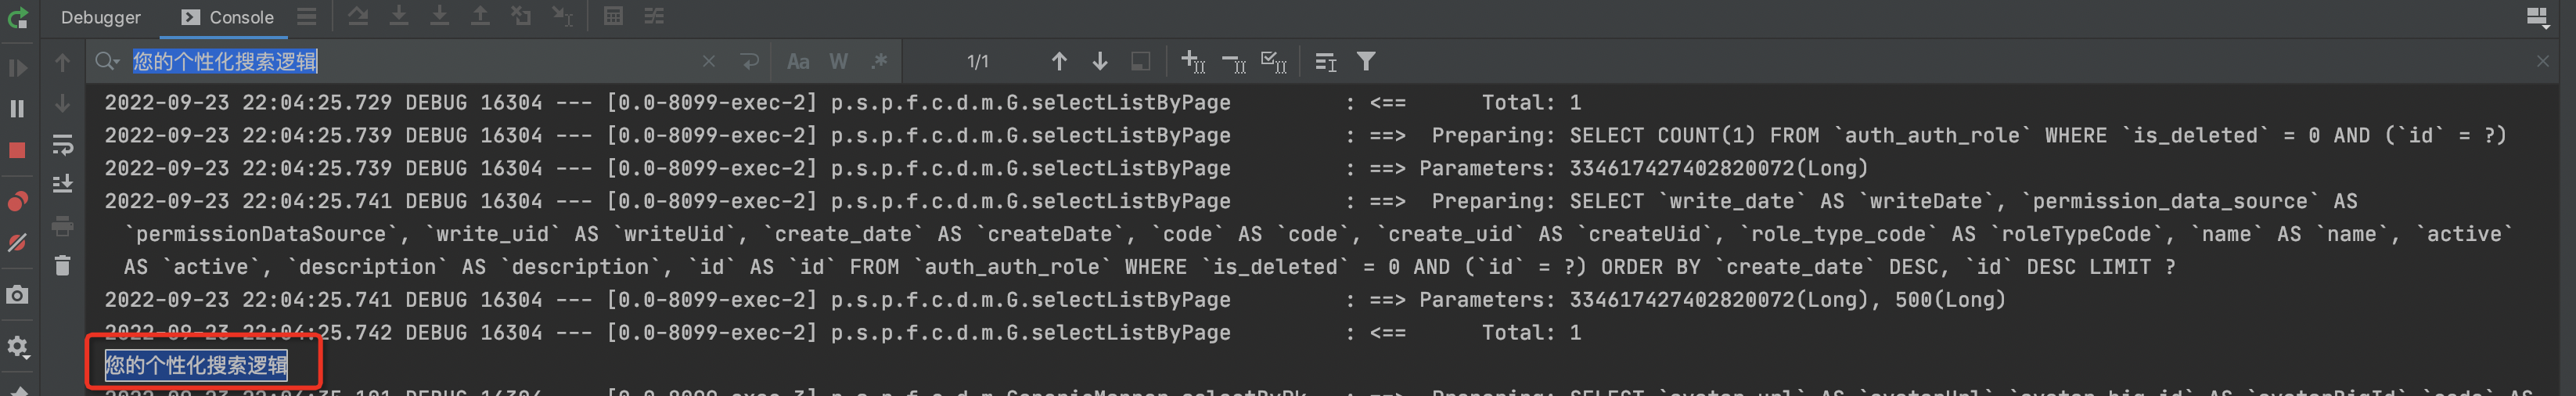
    System.out.println("您的个性化搜索逻辑");
    return ((IElasticRetrieve) CommonApiFactory.getApi(IElasticRetrieve.class)).search(page, queryWrapper);
}

图4-1-25-23 重写ShardingModelEnhance模型的search方法

Step2 重启应用看效果

image.png

图4-1-25-24 示例效果

Oinone社区 作者:史, 昂原创文章,如若转载,请注明出处:https://doc.oinone.top/oio4/9300.html

访问Oinone官网:https://www.oinone.top获取数式Oinone低代码应用平台体验

Like (0)
史, 昂's avatar史, 昂数式管理员
Previous 2024年5月23日
Next 2024年5月23日

相关推荐

  • 7.4 Oinone的低无一体

    基础介绍 前面我们学习了基于低代码开发平台进行快速开发,以及通过oinone的设计器进行零代码开发两种模式。当然低无一体不是简单地说两种模式还指:低无两种模式可以融合。 在做核心产品的时候以低代码开发为主,以无代码为辅助。见低代码开发的基础入门篇中设计器的结合一文 在做实施或临时性需求则是以无代码为主,以低代码为辅助 本文主要介绍第二种模式,它是www.oinone.top官网在SaaS模式下的专有特性。满足客户安装标品后通过设计器进行适应性修改后,但对于一些特殊场景还是需要通过代码进行完善或开发 在该模式下,我们提供了jar模式和代码托管两种模式,客户只要选择需要进行代码开发的模块,点击生产SDK,下载扩展工程模版,按Oinone低代码开发平台规范进行研发,后上传扩展工程即可。 操作手册 低无一体这个模块是连接无代码设计器的桥梁,可以为一个模块或应用设计低代码的逻辑,可以在界面设计器或流程设计器中使用低代码的逻辑。 1.选择模块 首先需要在下拉单选中选择需要低代码的模块或应用。 下拉选中只展示在「应用中心」中已安装的模块或应用,可前往「应用中心」安装后继续低代码操作。 选择模块中不展示系统的基础模块或应用,因为这些模块或应用无法自定义模型。 2.模块信息 模块信息展示的是选择模块的基础信息:模块名称、模块编码、模块作者、模块版本、包的前缀、工程模板下载地址,下载地址仅在上传jar包模式时候用到。 3.低无一体操作 低无一体支持了两种使用模式:上传jar包模式、源码托管模式。 上传控制工程或创建研发分支动作完成会生成一条数据,可以对单条数据进行部署、卸载、修改、删除。 3.1 上传jar包模式 在这个模式下,需要做四步动作。 生成SDK,点击按钮之后,会把模块的当前模型状态打成一个SDK包,SDK最新生成时间更新。当模型变更但未生成SDK时,使用低无一体就会出错,请重新生成SDK并修改扩展工程。生成SDK通常需要1分钟左右,若第一次使用低无一体模块,可能需要更长时间,请耐心等待。 下载扩展工程模板,点击按钮之后,会将SDK包和工程模板生成一个下载链接,复制模块信息中的卸载地址打开即可下载。 技术人员在工程模板的基础上写低代码逻辑。 上传扩展工程,点击按钮展开弹窗,在弹窗中设置标签、备注,并将最终的jar包上传,完成上传之后表格中就会新增一条数据。 上传jar包模式下,模板工程中代码需要注意的点参考下图: 3.2 源码托管模式 在这个模式下,需要做三步动作。 生成SDK,点击按钮之后,会把模块的当前模型状态打成一个SDK包,SDK最新生成时间更新。当模型变更但未生成SDK时,使用低无一体就会出错,请重新生成SDK并修改扩展工程。生成SDK通常需要1分钟左右,若第一次使用低无一体模块,可能需要更长时间,请耐心等待。 创建研发分支,点击按钮展开弹窗。首次创建时需要设置git账号名称、git账号邮箱来创建一个账号,另外在弹窗中设置分支名称、标签、备注,完成创建后表格中就会新增一条数据。 通过表格中的Gitlab地址,技术人员写低代码逻辑。 3.3 行内操作 部署:工程状态为未部署、部署失败、已卸载时展示行内的部署按钮,点击之后进行部署,工程状态变为部署中。部署过程大致需要5-10分钟,请耐心等待。部署完成之后,会生成一个新的模块:“原模块名称”扩展工程。 卸载:工程状态为已部署时展示行内的卸载按钮,点击之后会卸载这个已部署的工程,工程状态变为已卸载。同一模块只能有一个已部署的工程(与选择的模式无关),若需要使用新的工程请先卸载已部署的工程。 修改:行内操作修改按钮始终展示,只允许修改标签、备注。 删除:工程状态为未部署、部署失败、已卸载时展示行内的删除按钮,点击之后删除这一条工程记录。 3.4 部署效果 低无一体部署成功之后,可以进入对应模块的模型页面中使用提交动作来使用低代码逻辑,也可以在流程设计器中的引用逻辑节点中使用低代码逻辑。

    2024年5月23日
    3.4K00
  • 4.1.5 模型之持久层配置

    一、批量操作 批量操作包括批量创建与批量更新。批量操作的提交类型系统默认值为batchCommit。 批量提交类型: useAffectRows,循环单次单条脚本提交,返回实际影响行数 useAndJudgeAffectRows,循环单次单条脚本提交,返回实际影响行数,若实际影响行数与输入不一致,抛出异常 collectionCommit,将多个单条更新脚本拼接成一个脚本提交,不能返回实际影响行数 batchCommit,使用单条更新脚本批量提交,不能返回实际影响行数。 全局配置 pamirs: mapper: batch: batchCommit 图4-1-5-1 全局配置 运行时配置 非乐观锁模型系统默认采用batchCommit提交更新操作;乐观锁模型默认采用useAndJudgeAffectRows提交更新操作。也可以使用以下方式在运行时改变批量提交方式。 Spider.getDefaultExtension(BatchApi.class).run(() -> { 更新逻辑 }, 批量提交类型枚举); 图4-1-5-2 运行时配置 运行时校正 如果模型配置了数据库自增主键,而批量新增的批量提交类型为batchCommit,则系统将批量提交类型变更为collectionCommit(如果使用batchCommit,则需要单条提交以获得正确的主键返回值,性能有所损失)。 如果模型配置了乐观锁,而批量更新的批量提交类型为collectionCommit或者batchCommit,则系统将批量提交类型变更为useAndJudgeAffectRows。也可以失效乐观锁,让系统不做批量提交类型变更处理。 二、乐观锁(举例) 在一些会碰到并发修改的数据,往往需要进行并发控制,一般数据库层面有两种一种是悲观锁、一种是乐观锁。oinone对乐观锁进行了良好支持 定义方式 乐观锁的两种定义方式: 通过快捷继承VersionModel,构建带有乐观锁,唯一编码code且主键为id的模型。 可以在字段上使用@Field.Version注解来标识该模型更新数据时使用乐观锁 如果更新的实际影响行数与入参数量不一致,则会抛出异常,错误码为10150024。如果是批量更新数据,为了返回准确的实际影响行数,批量更新由批量提交改为循环单条数据提交更新,性能有所损失。 失效乐观锁 一个模型在某些场景下需要使用乐观锁来更新数据,而另一些场景不需要使用乐观锁来更新数据,则可以使用以下方式在一些场景下失效乐观锁。更多元位指令用法详见4.1.9【函数之元位指令】一文。 PamirsSession.directive().disableOptimisticLocker(); try{ 更新逻辑 } finally { PamirsSession.directive().enableOptimisticLocker(); } 图4-1-5-3 失效乐观锁 不抛乐观锁异常 将批量提交类型设置为useAffectRows即可,这样可改由外层逻辑对返回的实际影响行数进行自主判断。 Spider.getDefaultExtension(BatchApi.class).run(() -> { 更新逻辑,返回实际影响行数 }, BatchCommitTypeEnum.useAffectRows); 图4-1-5-4 将批量提交类型设置为useAffectRows 构建第一个VersionModel Step1 新建PetItemInventroy模型,继承快捷模型VersionModel package pro.shushi.pamirs.demo.api.model; import pro.shushi.pamirs.meta.annotation.Field; import pro.shushi.pamirs.meta.annotation.Model; import pro.shushi.pamirs.meta.base.common.VersionModel; import java.math.BigDecimal; @Model.model(PetItemInventroy.MODEL_MODEL) @Model(displayName = "宠物商品库存",summary="宠物商品库存",labelFields = {"itemName"}) public class PetItemInventroy extends VersionModel { public static final String MODEL_MODEL="demo.PetItemInventroy"; @Field(displayName = "商品名称") private String itemName; @Field(displayName = "库存数量") private BigDecimal quantity; } 图4-1-5-5 新建PetItemInventroy模型 Step2 修改DemoMenu,增加访问入口 @UxMenu("商品库存")@UxRoute(PetItemInventroy.MODEL_MODEL) class PetItemInventroyMenu{} 图4-1-5-6 修改DemoMenu Step3 重启看效果 体验一:页面上新增、修改数据库字段中的opt_version会自动加一 图4-1-5-7 示例效果一 图4-1-5-8 示例效果二 图4-1-5-9 示例效果三 图4-1-5-10 示例效果四 体验二:同时打两个页面,依次点击,您会发现一个改成功,一个没有改成功。但页面都没有报错,只是update返回影响行数一个为1,另一个为0而已。 图4-1-5-11 编辑宠物商品库存 图4-1-5-12 宠物商品库存列表 注:增加了乐观锁,我们在写代码的时候一定要注意,单记录更新操作的时候要去判断返回结果(影响行数),不然没改成功,程序是不会抛错的。不像batch接口默认会报错 Step4 预留任务:重写PetItemInventroy的update函数 留个任务,请各位小伙伴自行测试玩玩,这样会更有体感 package pro.shushi.pamirs.demo.core.action; import org.springframework.stereotype.Component; import pro.shushi.pamirs.demo.api.enumeration.DemoExpEnumerate; import pro.shushi.pamirs.demo.api.model.PetItemInventroy; import pro.shushi.pamirs.demo.api.model.PetTalent; import pro.shushi.pamirs.meta.annotation.Function; import pro.shushi.pamirs.meta.annotation.Model; import pro.shushi.pamirs.meta.common.exception.PamirsException; import pro.shushi.pamirs.meta.constant.FunctionConstants; import pro.shushi.pamirs.meta.enmu.FunctionOpenEnum; import pro.shushi.pamirs.meta.enmu.FunctionTypeEnum; import java.util.ArrayList; import java.util.List; @Model.model(PetItemInventroy.MODEL_MODEL) @Component public class PetItemInventroyAction { @Function.Advanced(type= FunctionTypeEnum.UPDATE) @Function.fun(FunctionConstants.update) @Function(openLevel = {FunctionOpenEnum.API}) public PetItemInventroy update(PetItemInventroy data){ List<PetItemInventroy> inventroys = new ArrayList<>(); inventroys.add(data); //批量更新会,自动抛错 int i =…

    2024年5月23日
    2.0K00
  • 3.3 Oinone以模型为驱动

    模型(model):Oinone一切从模型出发,是数据及对行为的载体: 是对所需要描述的实体进行必要的简化,并用适当的变现形式或规则把它的主要特征描述出来所得到的系统模仿品。模型由元信息、字段、数据管理器和自定义函数构成; 符合面向对象设计原则包括:封装、继承、多态。 本章会带大家快速而全方位地认识Oinone的模型。会从以下几个维度去对模型展开详细介绍。 构建第一个Model 模型的类型 模型的数据管理器 模型的继承 模型编码生成器 枚举与数据字典 字段序列化方式 字段类型之基础与复合 字段类型之关系与引用

    Oinone 7天入门到精通 2024年5月23日
    1.8K00
  • 3.2.3 应用中心

    在App Finder 中点击应用中心可以进入oinone的应用中心,可以看到oinone平台所有应用列表、应用大屏、以及技术可视化。 一、应用列表 标准版本不支持在线安装,只能通过boot工程的yml文件来配置安装模块。在 www.oinone.top 官方SaaS平台客户可以在线管理应用生命周期如:安装、升级、卸载。同时针对已安装应用可以进行无代码设计(前提安装了设计器),针对应用类的模块则可进行收藏,收藏后会在App Finder中的我收藏的应用中出现。在应用列表中可以看到我们已经安装的应用以及模块,我们oinoneDemo工程也在其中。 图3-2-35 Oinone的应用列表 图3-2-36 应用收藏后会在App Finder的【我收藏的应用】中出现 二、应用大屏 但我们的测试应用没有设置应用类目,则无法在应用大屏中呈现。 图3-2-37 未设置应用类目则无法在应用大屏中呈现 三、技术可视化 在技术可视化页面,出展示已经安装模块的元数据,并进行分类呈现 图3-2-38 云数据分类呈现

    2024年5月23日
    3.2K00
  • 1.2 Oinone的致敬

    占在巨人的肩膀上,天地孤影任我行 1.2.1 数字化时代Oinone接棒Odoo 在数字化时代,中国在互联网化的应用、技术的领先毋庸置疑,但在软件的工程化、产品化输出方面仍有许多改进的空间。这时,我了解到了Odoo——一个国外非常优秀的开源ERP厂商,全球ERP用户数量排名第一,百级别员工服务全球客户。Odoo的工程化能力和商业模式深深吸引了我,它是软件行业典型的产品制胜和长期主义者的胜利之一。 在2019年,也就是数式刚成立的时候,我们跟很多投资人聊起公司的对标是谁,我不是要成为数字化时代的SAP,而是要成为Odoo。然而,当时大部分国内投资人并不了解Odoo,尽管它已经是全球最大的ERP厂商之一,因为当时Odoo还没有明确的估值。直到2021年7月份获得Summit Partners的2.15亿美元投资后,Odoo才正式成为IT独角兽企业。 Odoo对我们提供了极大的启示,因此我们致敬Odoo,同样选择开源,每年对产品进行升级发布。如今,Odoo15已经发布,而Oinone也已推出第三版,恰好相隔12年,这是一个时代的接棒,从信息化升迁至数字化。 1.2.2Oinone与Odoo的不同之处 技术方面的不同 在技术上,Oinone和Odoo有相同之处,也有不同之处。它们都基于元数据驱动的软件系统,但是它们在如何让元数据运作的机制上存在巨大差异。Odoo是企业管理场景的单体应用,而Oinone则致力于企业商业场景的云原生应用。因此,它们在技术栈的选择、前后端协议设计、架构设计等方面存在差异。 场景方面的不同 在场景上,Oinone和Odoo呈现许多差异。相对于SAP这些老牌ERP厂商,Odoo算是西方在企业级软件领域的后起之秀,其软件构建方式、开源模式和管理理念在国外取得了非凡的成就。然而,在国内,Odoo并没有那么成功或者并没有那么知名。国内做Odoo的伙伴普遍认为,Odoo与中国用户的交互风格不符,收费模式设计以及外汇管制使商业活动受到限制,本地化服务不到位,国内生态没有形成合力,伙伴们交流合作都非常少。另外,Odoo在场景方面主要围绕内部流程管理,与国内老牌ERP如用友、金蝶重叠,市场竞争激烈。相比之下,Oinone看准了企业视角由内部管理转向业务在线、生态在线(协同)带来的新变化,聚焦新场景,利用云、端等新技术的发展,从企业内外部协同入手,以业务在线驱动企业管理流程升级。它先立足于国内,做好国内生态服务,再着眼未来的国际化。 无代码设计器的定位 在无代码设计器的定位上,Odoo的无代码设计器是一个非常轻量的辅助工具,因为ERP场景下,一个企业实施完以后基本几年不会变,流程稳定度非常高。相反,Oinone为适应"企业业务在线化后,所有的业务变化与创新都需要通过系统来触达上下游,从而敏捷响应快速创新"的时代背景,重点打造出五大设计器。(如下图1-2所示)。 图1-2 Oinone五大设计器 在数字化时代中国软件将接棒世界,而Oinone也要接棒Odoo,把数字化业务与技术的最佳实践赋能给企业,帮助企业数字化转型不走弯路!

    2024年5月23日
    2.8K00

Leave a Reply

Please Login to Comment