2.4.3 Oinone独特性之低无一体

当今企业软件开发行业,低代码和无代码已经成为热门话题。它们的优势很明显:加速软件开发周期、减少代码开发时间、降低开发成本、易于维护等等。而 Oinone 作为一个低无一体的开发平台,更是在这些优势上做出了巨大的创新。

技术亮点

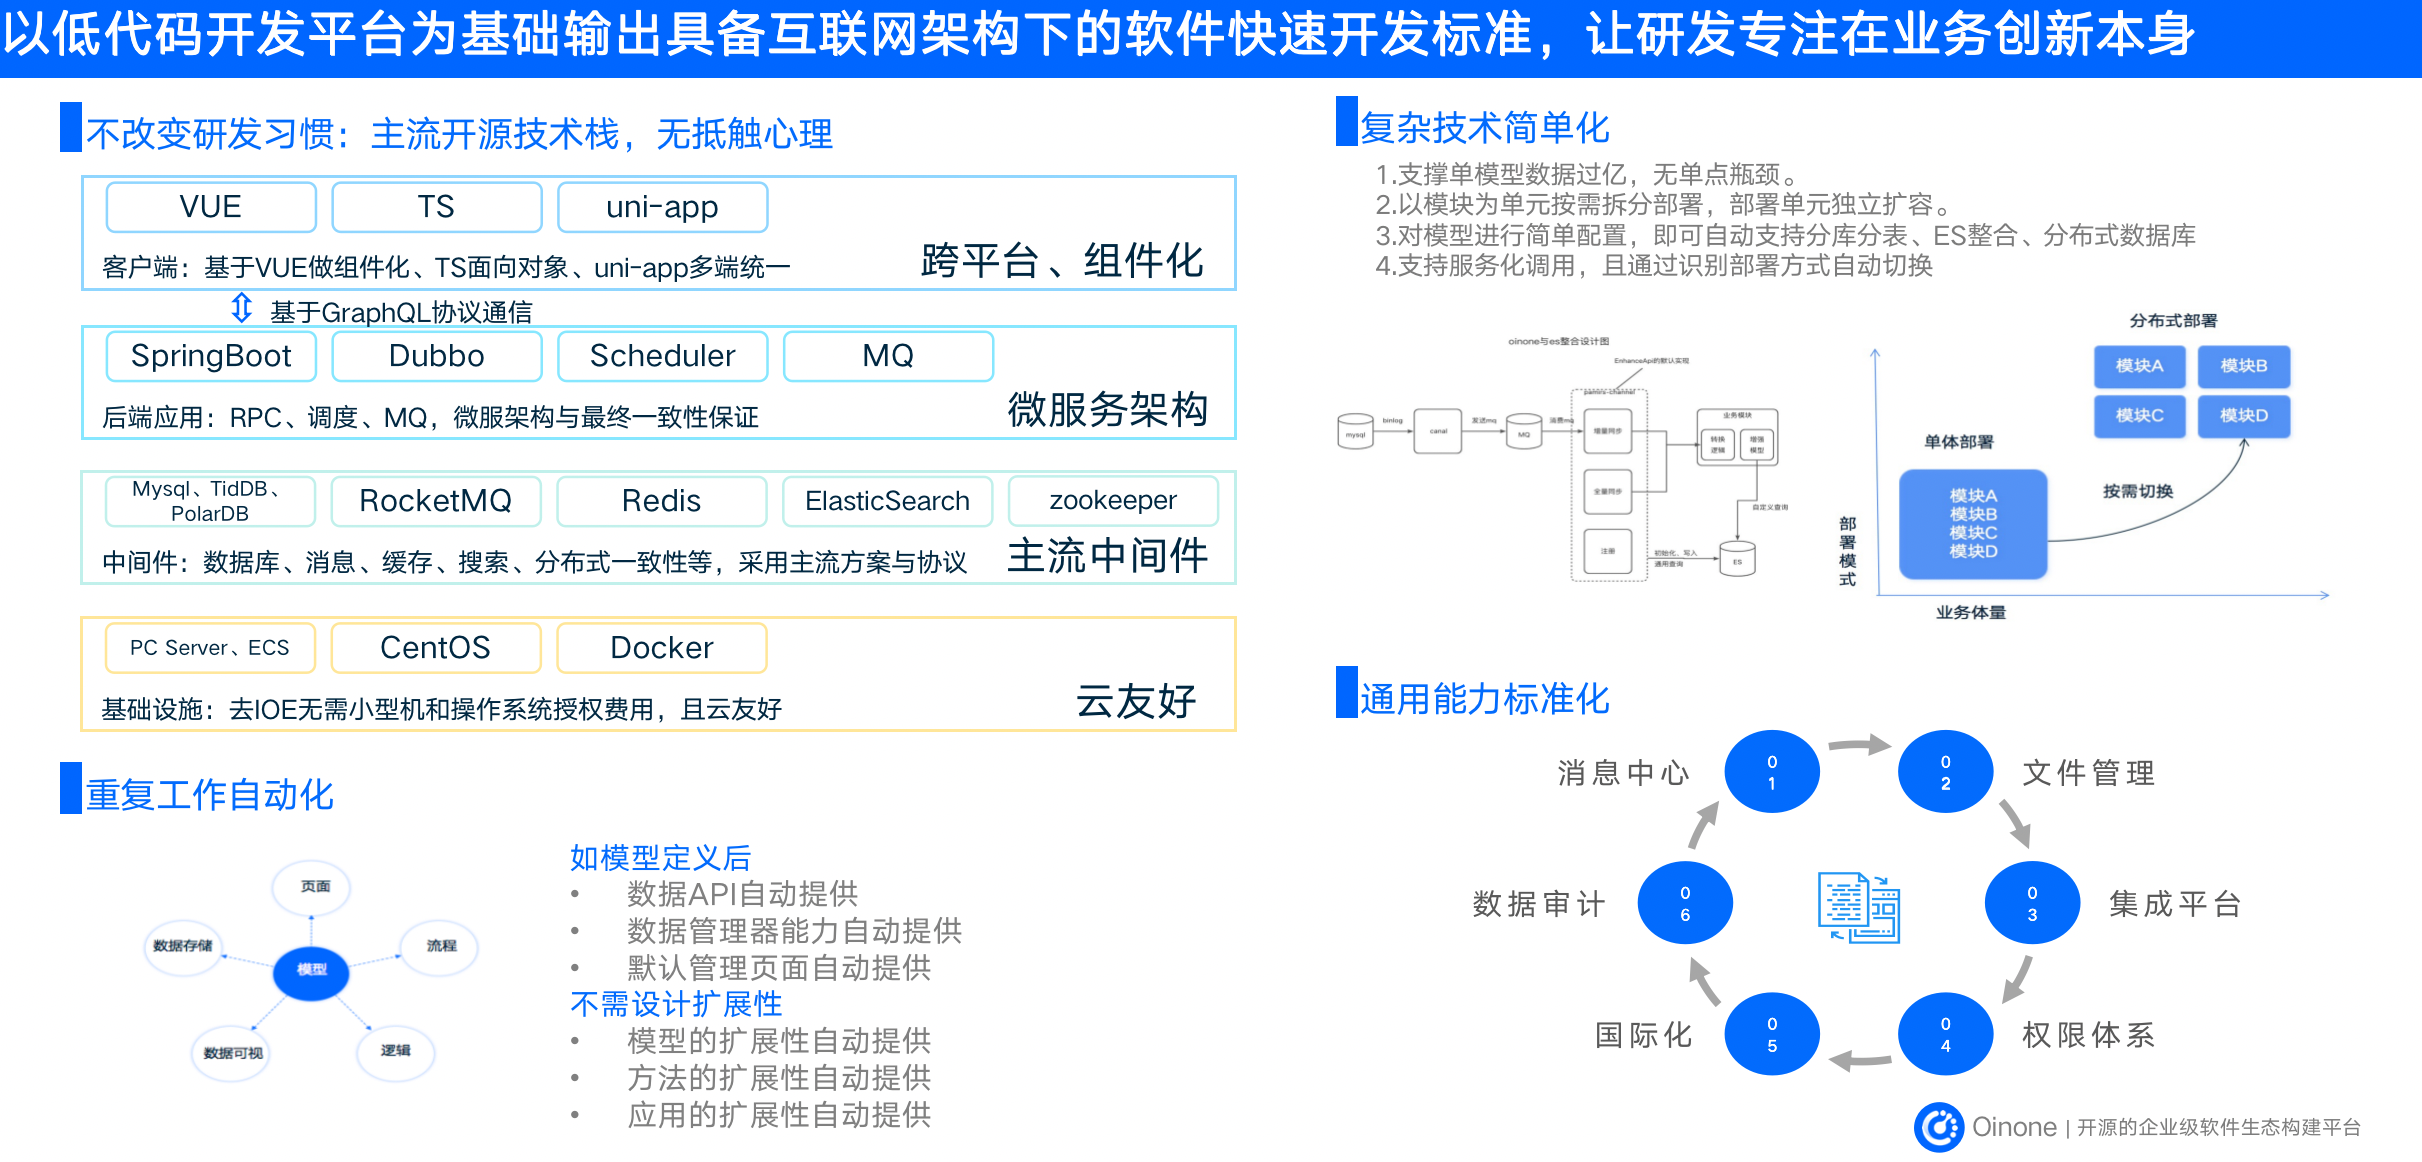
低代码-在不改变研发习惯的前提下,提升效率降低难度(如下图2-15所示)

一、提高专业开发人员效率

低代码开发模式大大降低了繁琐、重复的工作,模型定义完后,数据 API、数据管理器、基础管理的界面都不需要再进行开发。同时,低代码模式让分布式微服务架构的系统开发变得简单,研发人员不需要考虑分布式部署能力和大数据能力,也不需要去关心一些业务无关的通用能力,如权限、导入导出、国际化翻译、消息、审计等。这样,开发人员可以专注于业务研发,从而大幅提高开发效率。

二、提升系统扩展性

在研发标品的时候,低代码模式让开发人员不再需要关心系统的扩展性。与传统模式不同,低代码模式更加注重元数据的管理,这样就可以更好地保障系统扩展性。

三、保留研发人员习惯

Oinone 平台非常开放,满足开发人员的各种习惯,比如原有的 IDE 环境、熟悉的 Spring Boot 工程结构等。而且在 Oinone 的低代码模式下,研发人员还可以通过无代码方式,在线可视化地修改应用。这样,即使在使用低代码模式的情况下,开发人员也可以保留原有的习惯,提升开发效率。

四、提供更加开放的解决方案

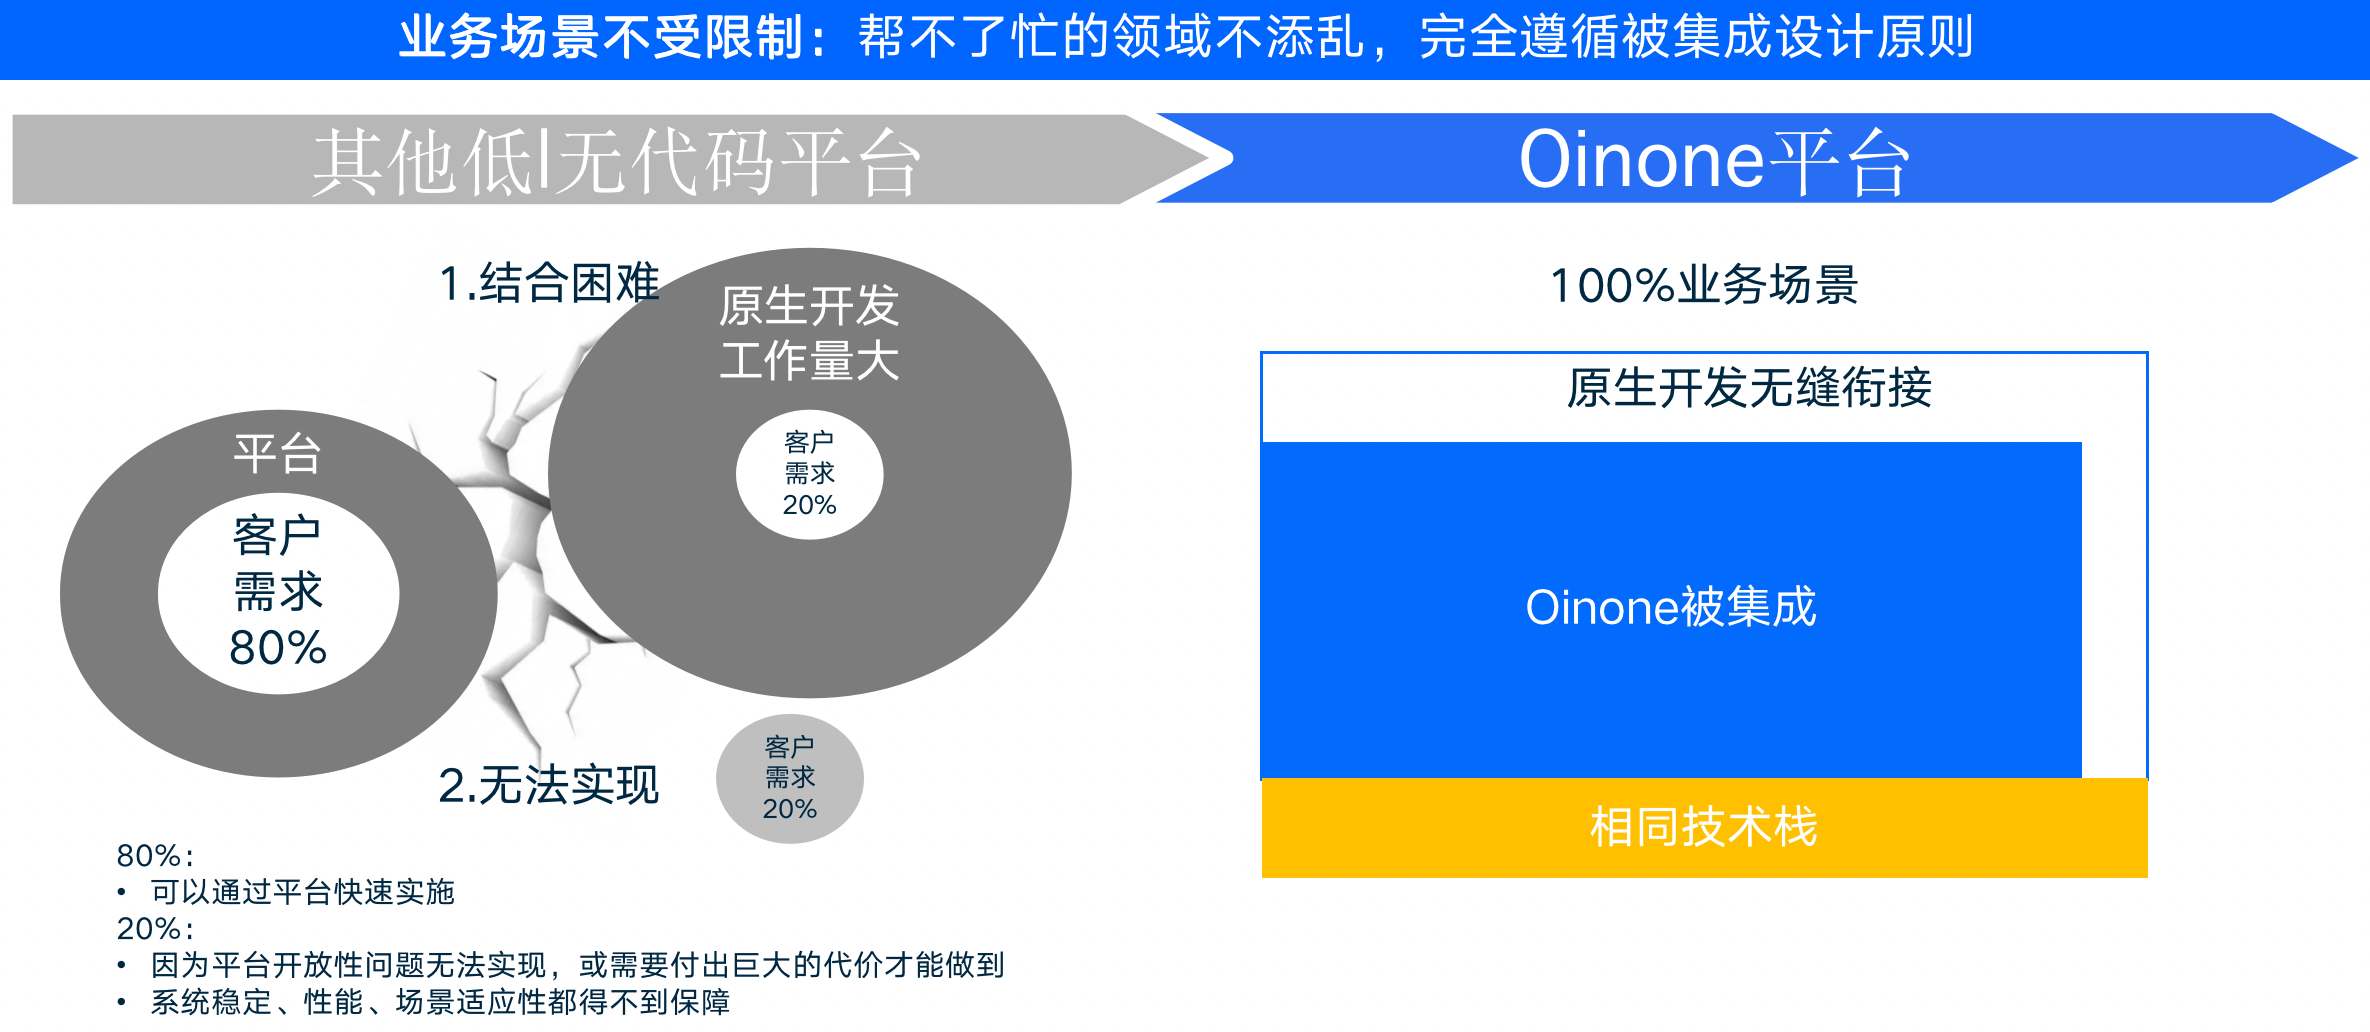
Oinone 提供了非常开放的解决方案,让开发人员可以自由定制和组合各种功能。当行业出现特殊的功能需求时,开发人员可以整合成平台组件,并集成到应用中。Oinone的低代码模式具有高度的开放性和灵活性,这使得它在与其他低代码平台的比较中具有明显的优势。相比其他低代码平台,Oinone不会在无法满足特定需求的情况下限制开发人员的创造力(如下图2-16所示)。
2.4.3 Oinone独特性之低无一体

图2-15 Oinone低代码特性介绍

2.4.3 Oinone独特性之低无一体

图2-16 Oinone低代码的被集成特性示意图

无代码-五大设计器覆盖研发方方面面,让业务、实施也能参与

它是LCDP的产品化呈现,是冰山露在外面大家看得到的,核心还是在LCDP本身。这部分实时在演进迭代,如您有想体验最新版本,可以在Oinone官网https://www.oinone.top注册

设计器 说明 产品展示
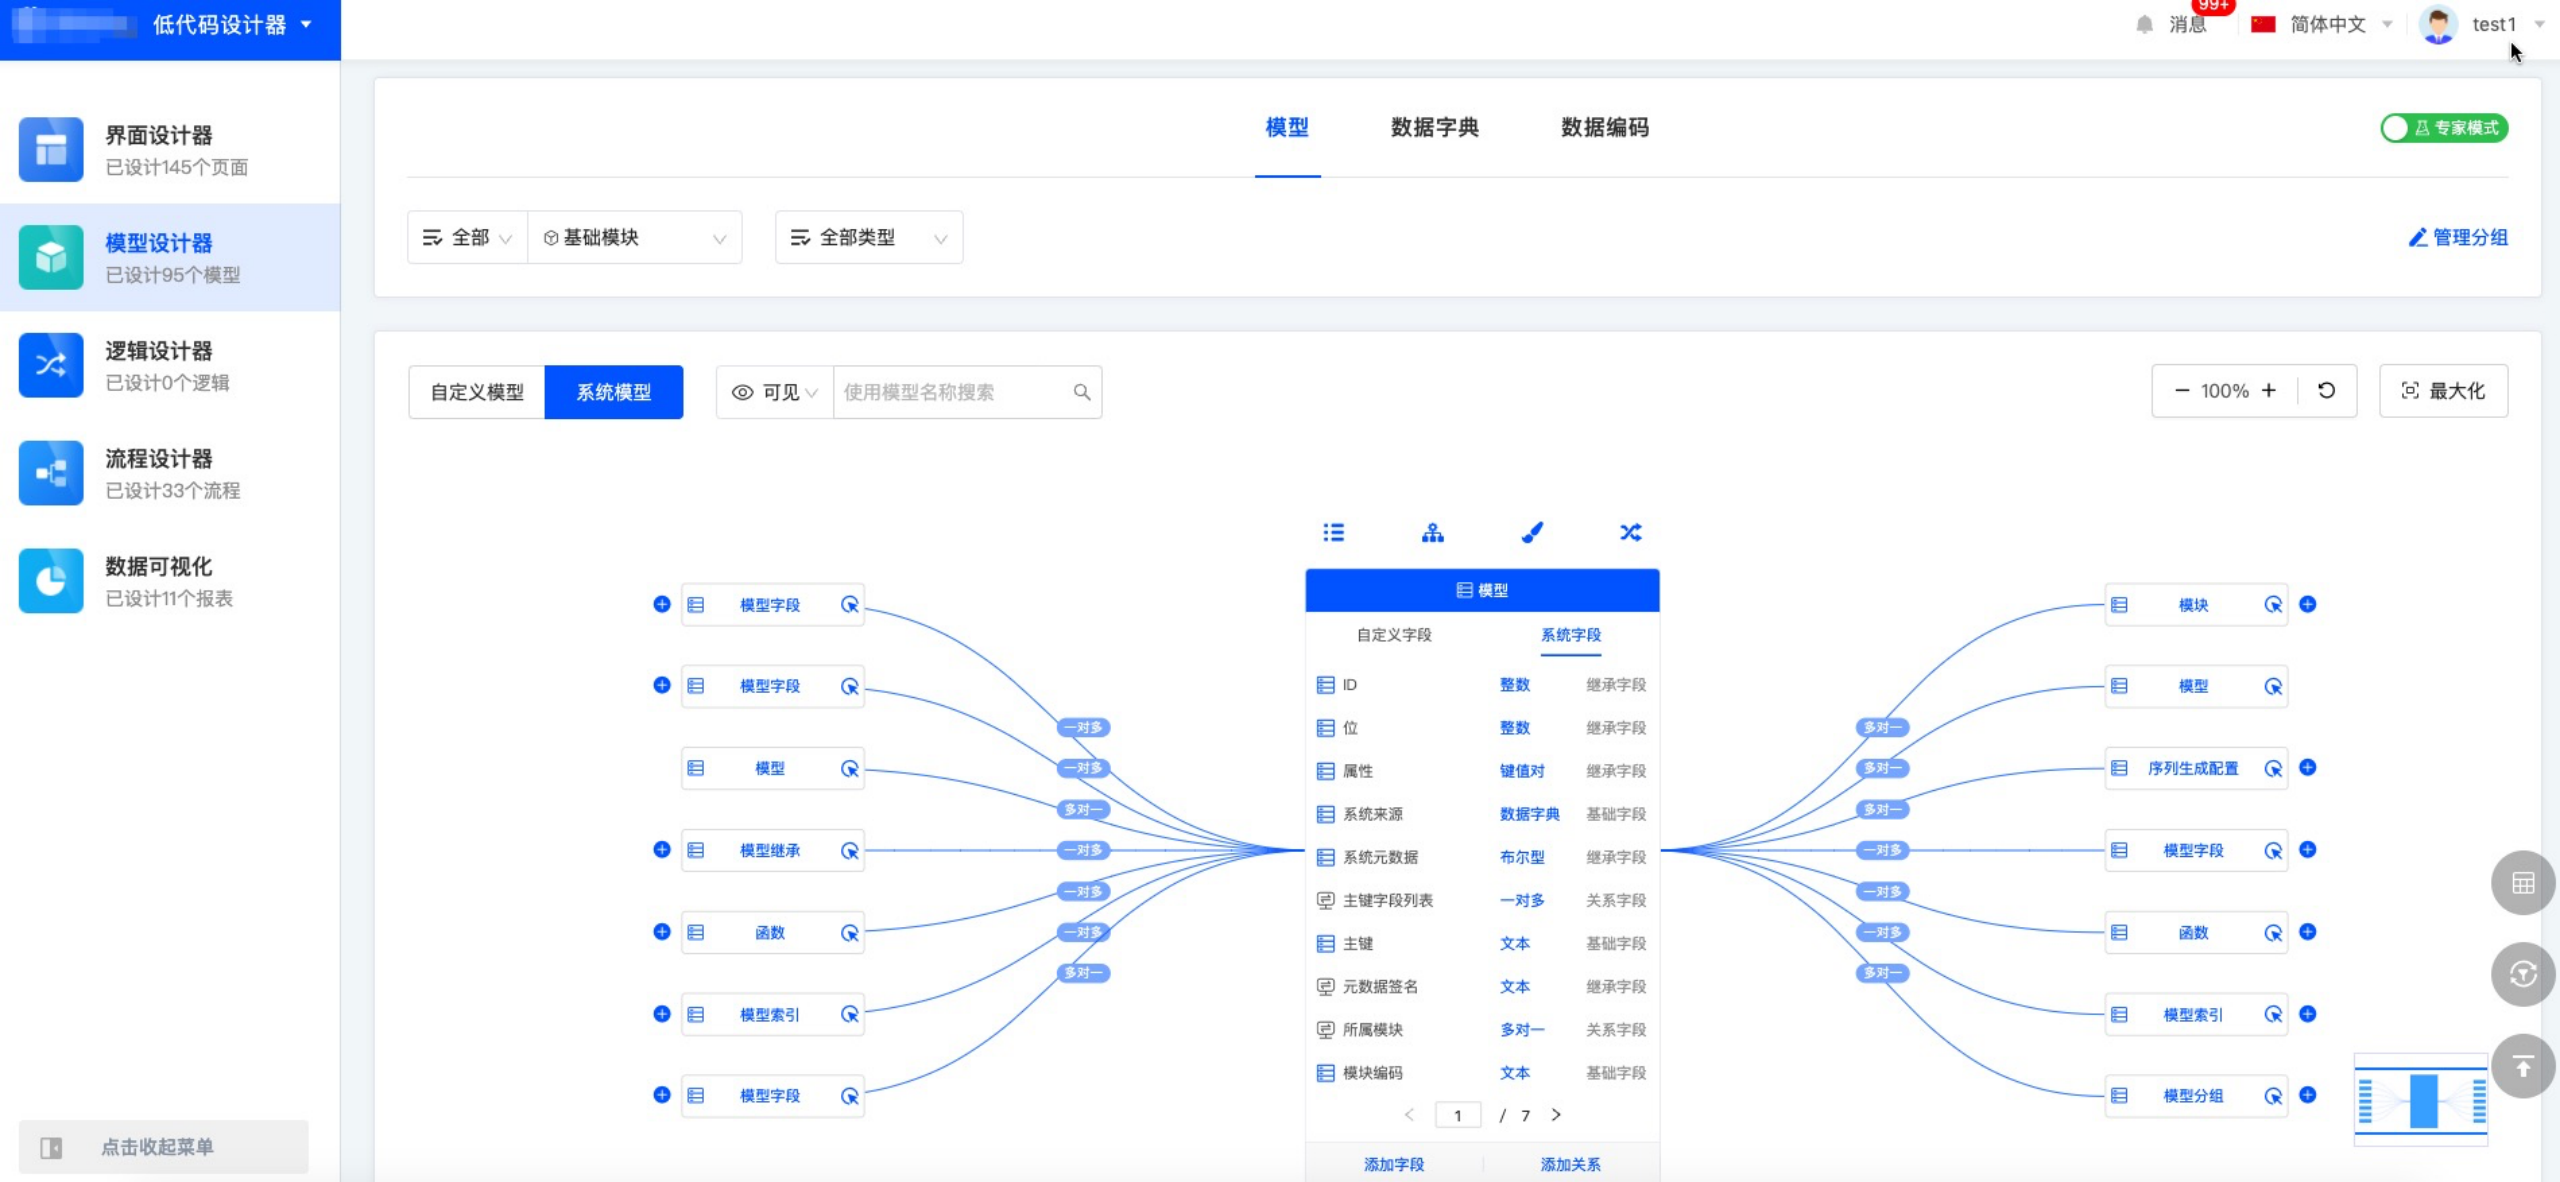
模型设计器 1.以模型为驱动,当有模型、数据字典、数据编码等设计功能,我们就可以完整地定义产品数据模型,模型设计器默认整体呈现区别于普通ER图,以当前模型为核心视角展开,可以点击关联模型切换主视角。2.多种模式可切换:专家与经典切换,图与表模式的切换 2.4.3 Oinone独特性之低无一体
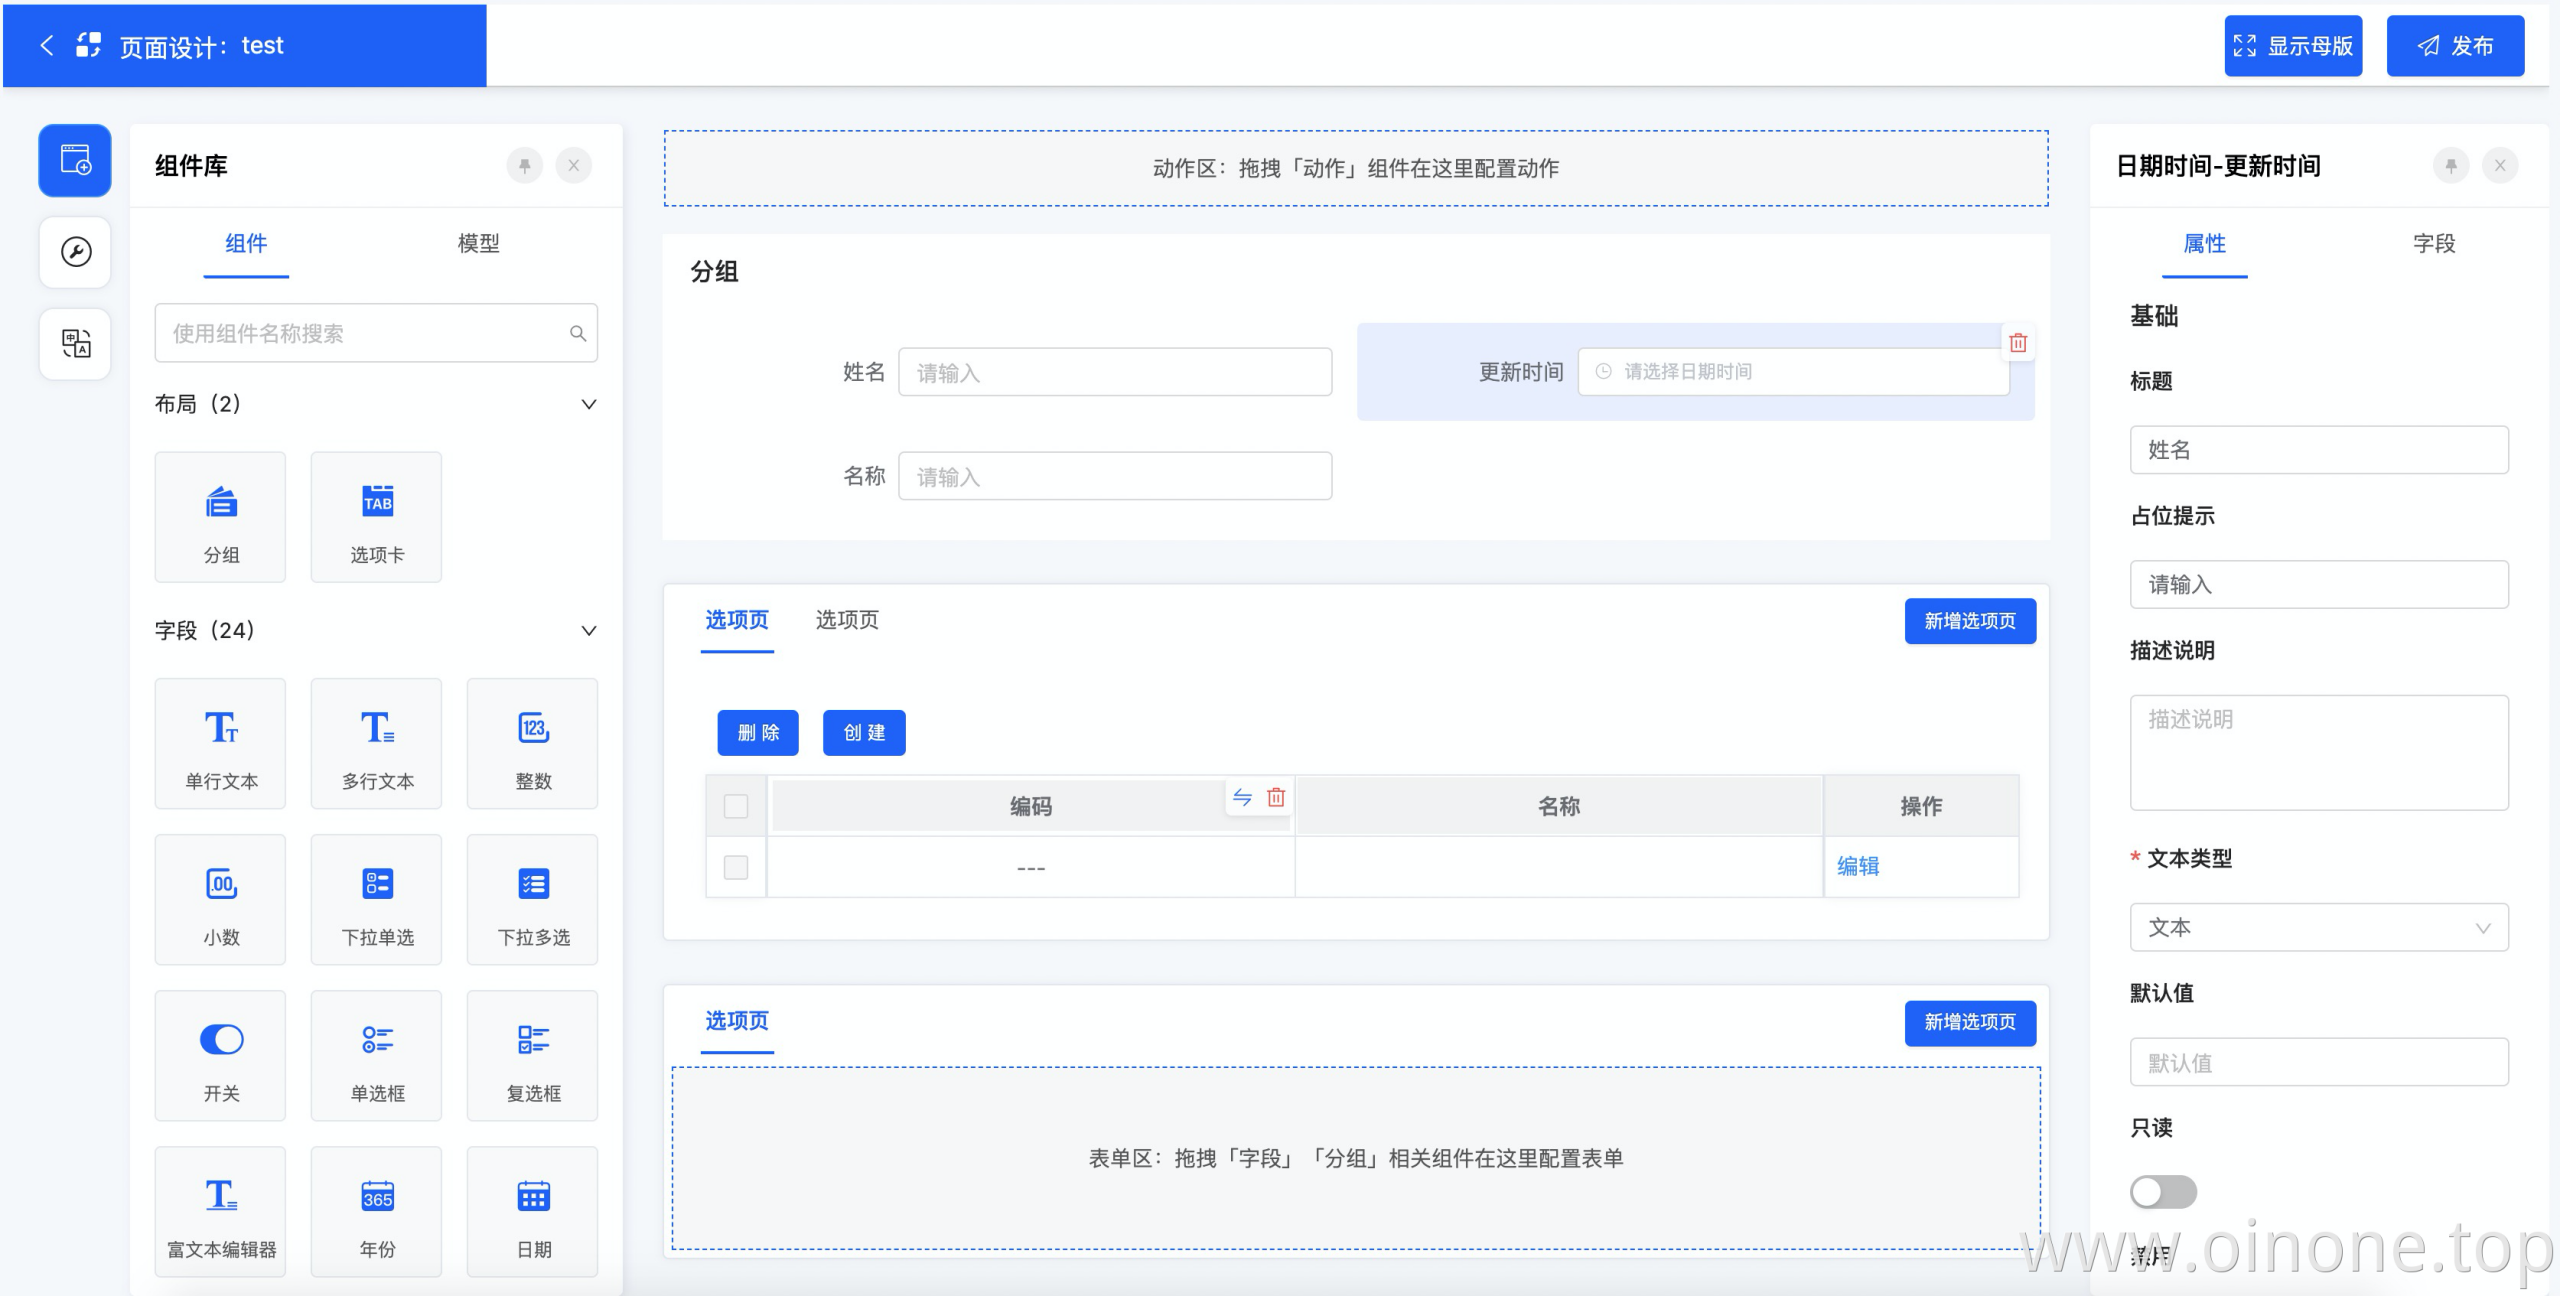
界面设计器 1.界面设计器旨在帮助用户快速搭建页面;2.所见即所得和根据不同视图类型设计契合的搭建交互就变得尤为重要;3.多端页面设计能力。 2.4.3 Oinone独特性之低无一体
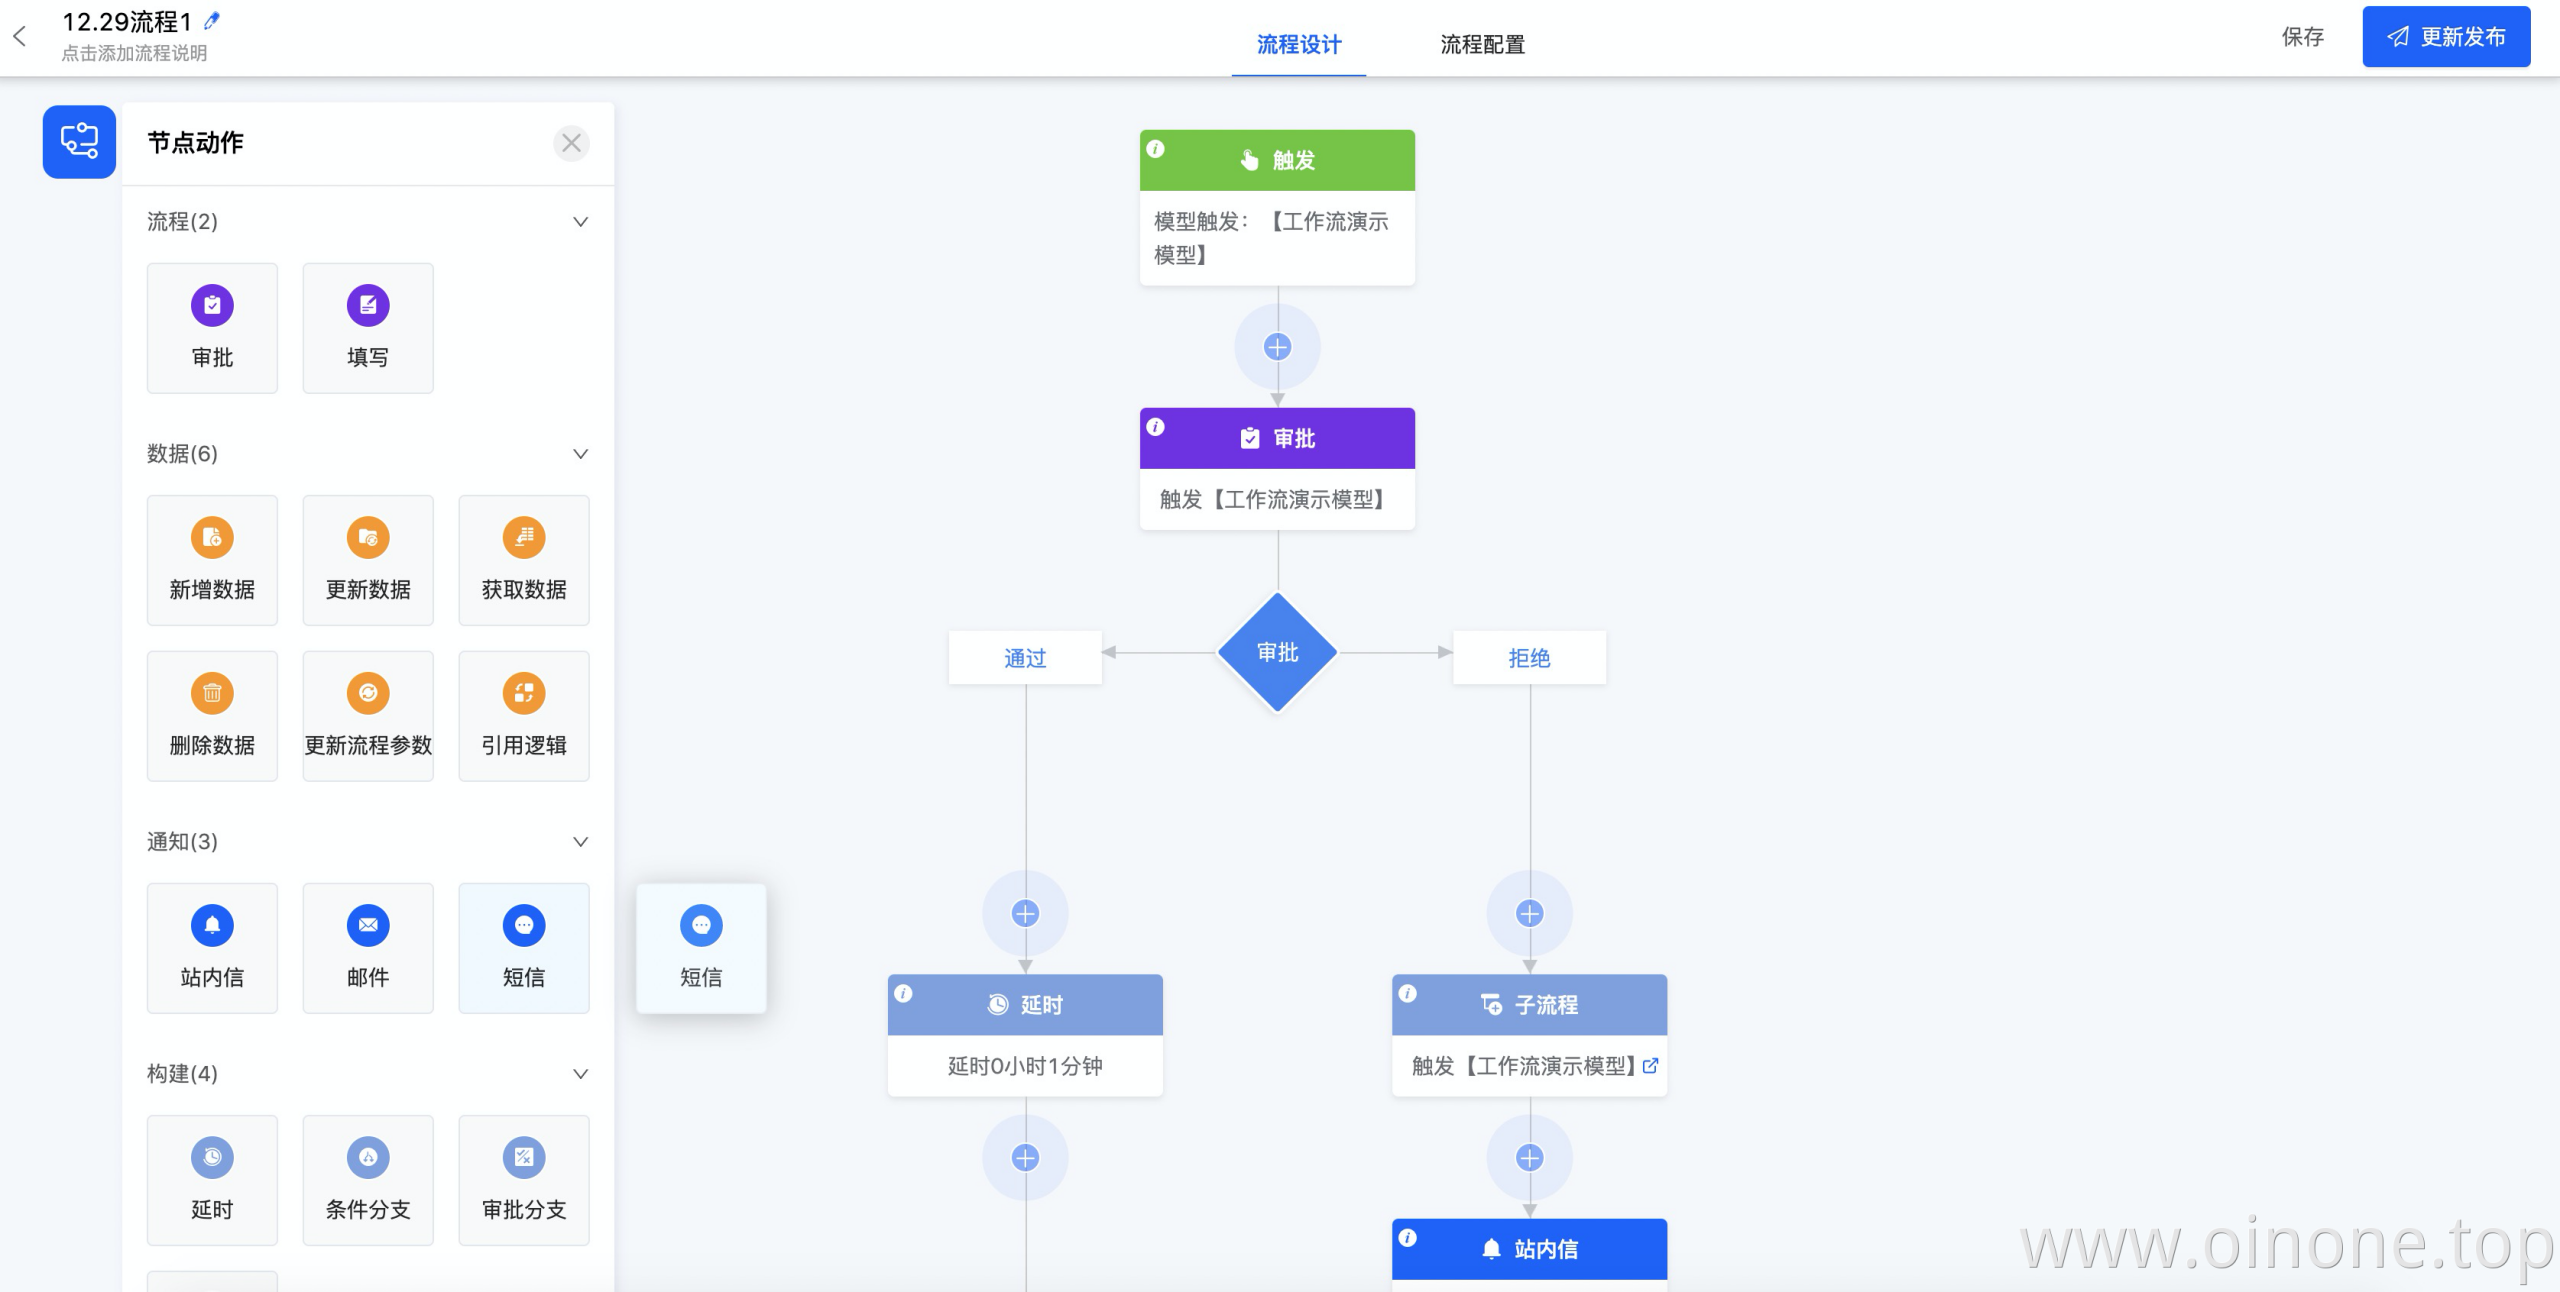
流程设计器 1.为业务流程和审批流程提供可自动执行的流程模型,通过定义流转过程中的各个动作、规则,以此实现流程自动化;2.流程可以跨应用设计,不同应用的模型之间可以通过同一流程执行。 2.4.3 Oinone独特性之低无一体
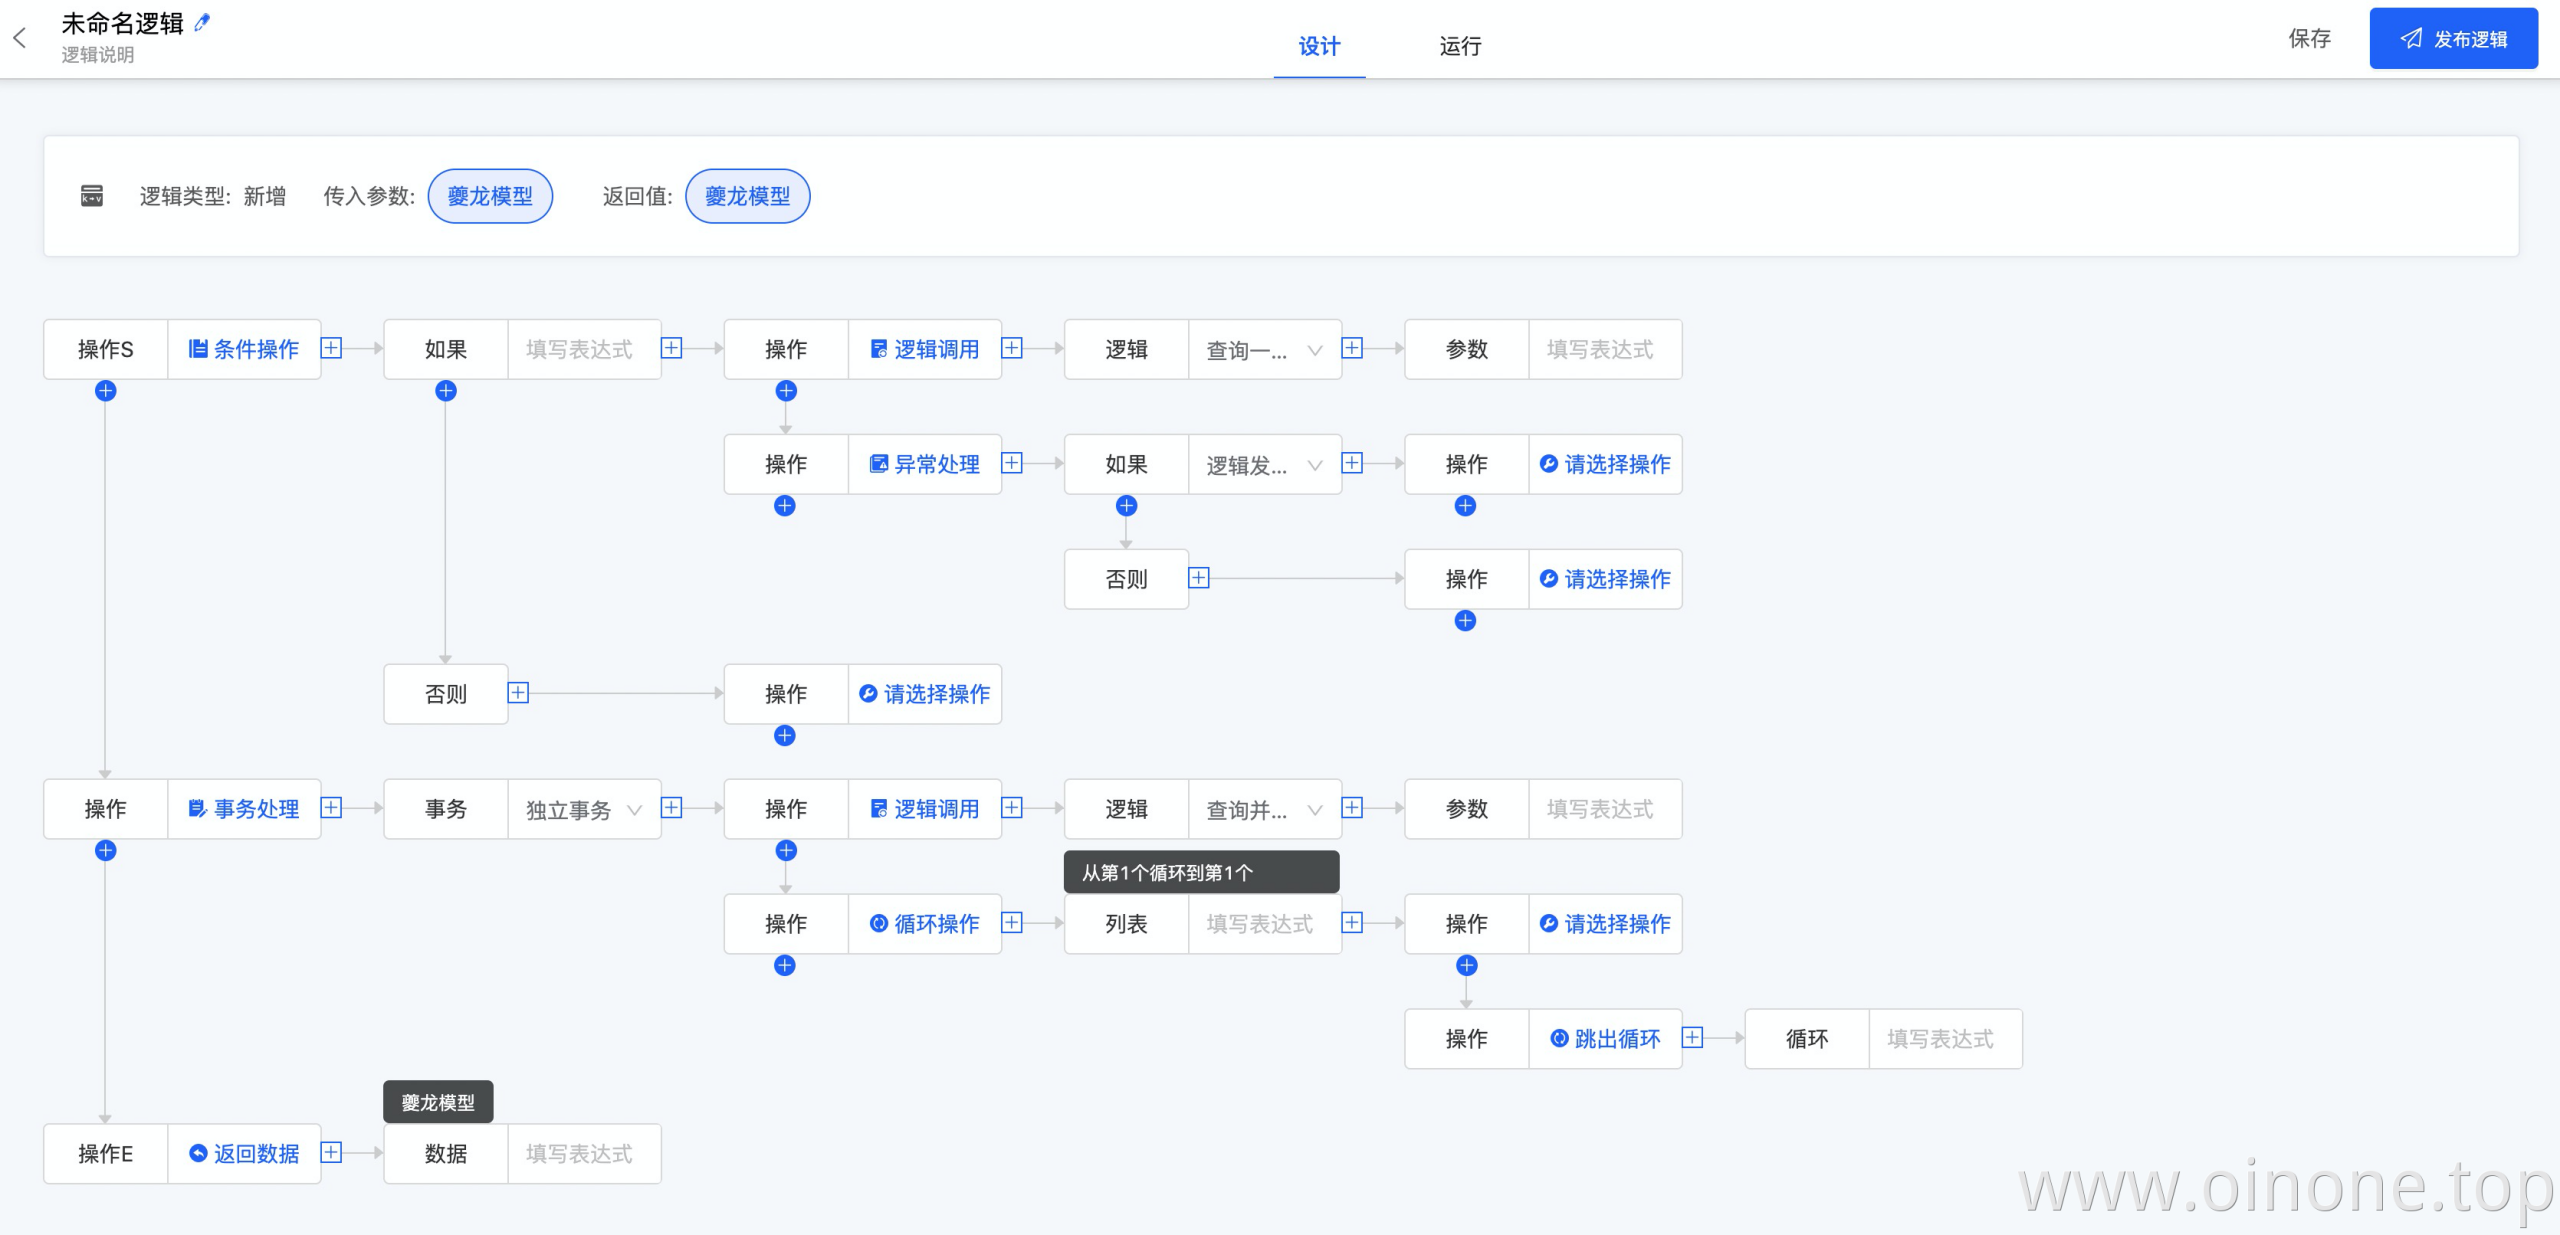
逻辑设计器 1.组件化、可视化逻辑编排,逻辑动态变更、动态管理,实施验证。 2.4.3 Oinone独特性之低无一体
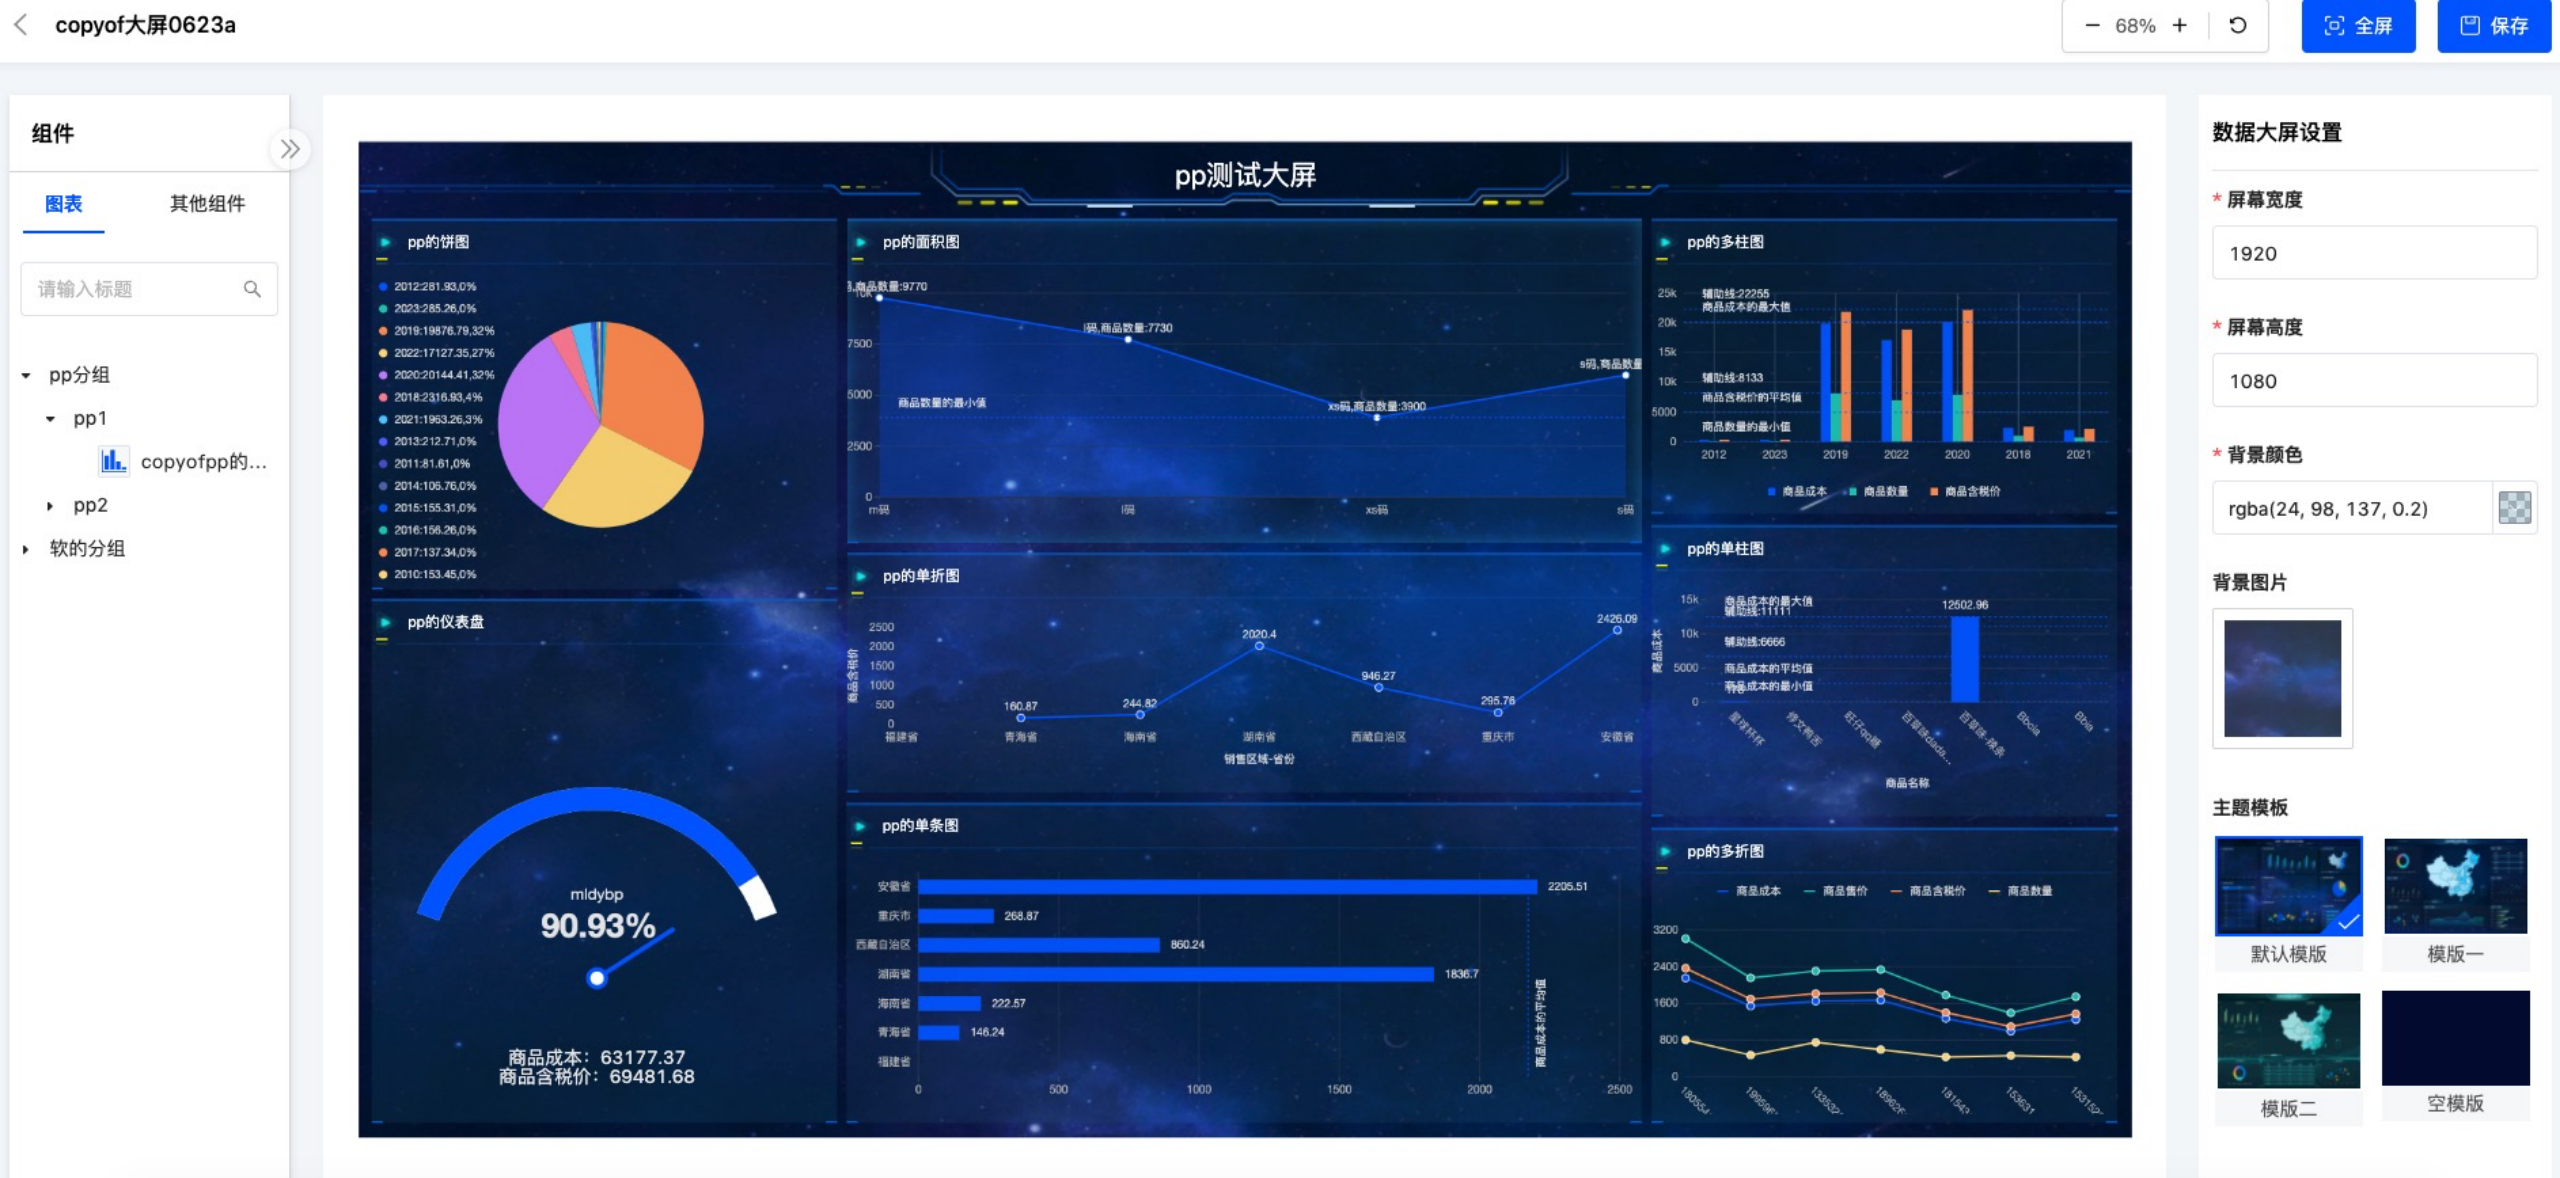
数据可视化 1.从内部系统模型获取数据内容后,根据业务需求自定义图表,目的是为企业提供更高效的数据分析工具;2.可以智取业务系统模型,系统自动解析选择的模型、接口、表格中的字段后进行数据分析;3.降低对数据分析人员的研发能力要求,提升数据分析的效率 2.4.3 Oinone独特性之低无一体

表2-3 Oinone无代码-五大设计器简述

真正的低无一体,体现在一体化的融合能力上

在开发核心产品时,我们主要采用低代码开发,辅以无代码的开发方式。你可以参考我们的低代码开发基础入门教程中3.5.5【设计器的结合】的文章。

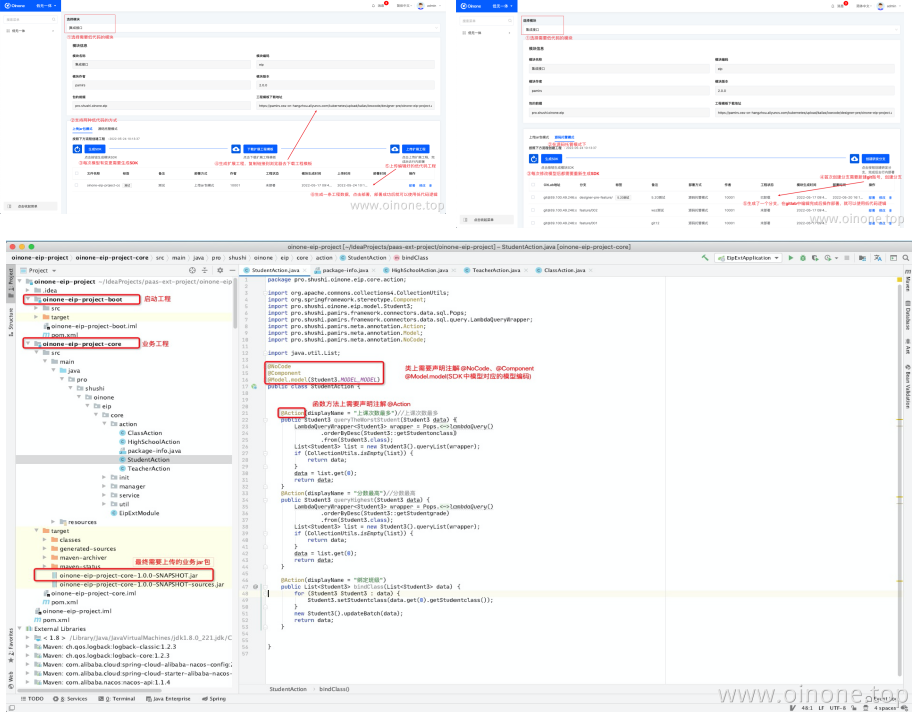
而在实施或者处理临时需求时,我们主要采用无代码的开发方式,低代码作为辅助。这种模式比较特殊,只在SaaS模式下提供。如果你发现某个客户个性化部分无法通过无代码设计器完成,我们提供了一个“低无一体”模块,可以反向生成API代码,生成对应的扩展工程和API依赖包,再由专业研发人员基于扩展工程,利用API包进行开发并上传至平台,可以参考关于7.4【Oinone的低无一体】的文章。

场景 融合形式 具体操作
标准产品以低代码开发为主,以无代码为辅助 标品开发时结合无代码设计器来完成页面开发,可以把设计后的页面元数据装载为标准产品的一部分。详细教程见:3.5.5【设计器的结合】一文 2.4.3 Oinone独特性之低无一体
项目交付以无代码为主,以低代码为辅助 当有特殊需求设计器无法支持时,则可以通过低无一体应用的代码模式来完成。支持了两种使用模式:上传jar包模式、源码托管模式。详细教程见:7.4【Oinone的低无一体】一文 2.4.3 Oinone独特性之低无一体

表2-4 不同场景适配方式说明

实现原理

本章节我们将从以下三个方面来解读Oinone的低无一体。

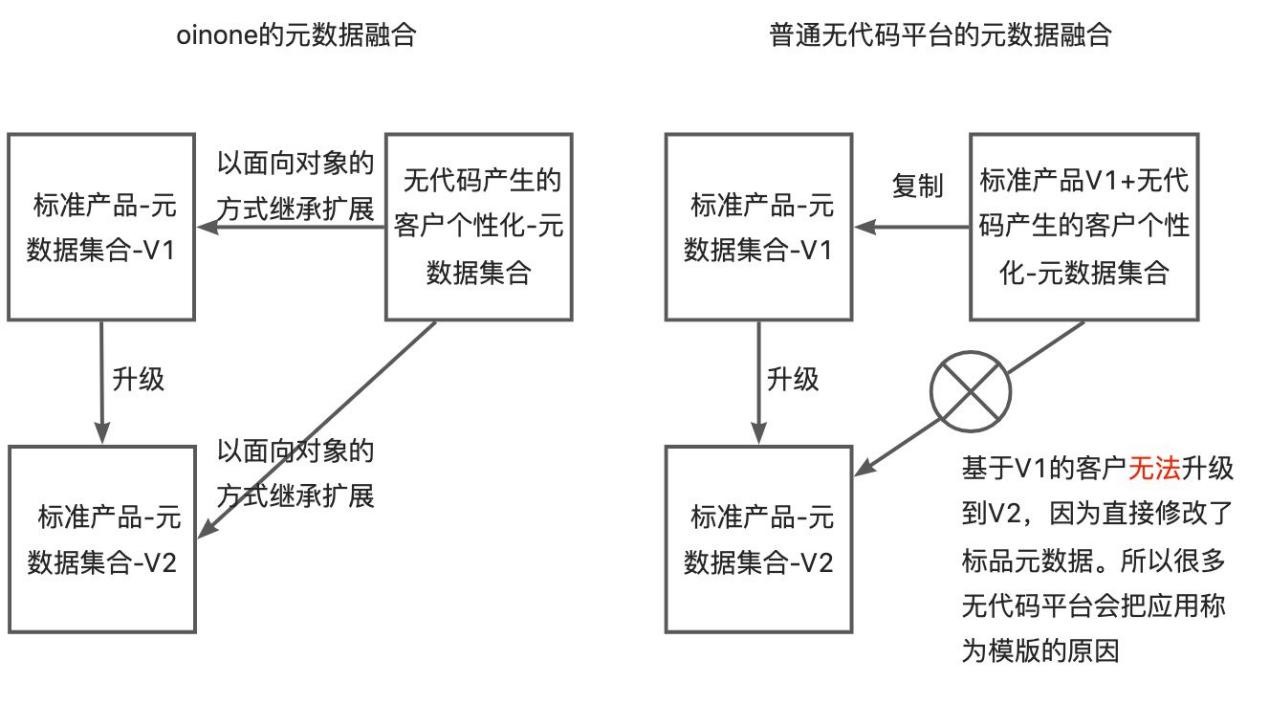
一:低无一体的设计原则及好处:真正的低无一体平台应该确保标准产品迭代与个性化保持独立,让软件企业具备为客户提供在线化的快速响应、个性化定制、持续更新等服务的能力,让企业客户能够真正自主做到敏捷响应和快速创新。所以Oinone的元数据融合方案跟其他平台有所区别(如下图2-17所示)。
2.4.3 Oinone独特性之低无一体

图2-17 Oinone与其他平台的元数据融合对比图

二:低无一体中低与无的关系:无代码是低代码平台的图形化呈现,是低代码的一个子集,它将无限接近低代码的能力,同时也将成为低代码平台的必备特征,是通过低代码开发的标准产品的二开配套工具。

三:低无一体中低与无的定位:通过表2-3可以看出,低代码和无代码在Oinone的体系中相互融合,共同构成了一个完整的低无一体模式,提供更加开放、灵活和可扩展的解决方案,让用户能够更加轻松地完成开发和实施。

低代码模式 无代码模式
用户群体 专业研发 产品经理、需求分析师、直接业务人员
支撑场景 企业全场景软件以及二开 企业全场景软件以及二开,专业化场景比较高的则需低代码支持
核心能力 不改变研发习惯,提升研发效率 可视化编程无需专业编程语言知识
核心定位 开发标准模块 标准模块的二开无标品支撑场景的新模块开发

表2-3 Oinone低代码开发平台的两种开发模式对比

Oinone社区 作者:史, 昂原创文章,如若转载,请注明出处:https://doc.oinone.top/oio4/9222.html

访问Oinone官网:https://www.oinone.top获取数式Oinone低代码应用平台体验

Like (0)
史, 昂's avatar史, 昂数式管理员
Previous 2024年5月23日
Next 2024年5月23日

相关推荐

  • 4.1.7 函数之元数据详解

    介绍Function相关元数据,以及对应代码注解方式。大家还是可以通读下,以备不时之需 如您还不了解Function的定义,可以先看下2.3【oinone独特之源,元数据与设计原则】对Function的描述,本节主要带大家了解Function元数据构成,能让小伙伴非常清楚oinone从哪些维度来描述Function, 一、元数据说明 FunctionDefinition 元素数据构成 含义 对应注解 备注 namespace 函数命名空间 @Fun("") @Model.model("") @Fun或@Model.model name 技术名称 @Function( name=””, scene={}, summary=””, openLevel=FunctionOpenEnum.REMOTE ) scene 可用场景 见:FunctionSceneEnum description 描述 openLevel 开放级别 见:FunctionOpenEnum fun 编码 @Function.fun("") displayName 显示名称 @Function.Advanced( displayName=””, type=FunctionTypeEnum.UPDATE, dataManager=false, language=FunctionLanguageEnum.JAVA, isBuiltin=false, category=FunctionCategoryEnum.OTHER, group=”pamirs”, version=”1.0.0″, timeout=5000, retries=0, isLongPolling=false, longPollingKey=”userId” longPollingTimeout=1 ) type 函数类型默认:4(改) 见 FunctionTypeEnum dataManager 数据管理器函数默认:false language 函数语言默认:DSL 见FunctionLanguageEnum isBuiltin 是否内置函数 默认:false category 分类 默认:OTHER 见:FunctionCategoryEnum group 系统分组 默认:pamirs version 系统版本 默认:1.0.0 timeout 超时时间 默认:5000 retries 重试次数 默认:0 isLongPolling 是否支持long polling,默认false longPollingKey 支持从上下文中获取字段作为key longPollingTimeout long polling超时时间 默认值为1 transactionConfig 事务配置 JSON存储 见TransactionConfig 配置@PamirsTransactional source 来源 系统推断值,见:FunctionSourceEnum extPointList 函数包含扩展点 系统推断值 module 所属模块 系统推断值 bitOptions 位 系统推断值 attributes 属性 系统推断值 imports 上下文引用 系统推断值 context 上下文变量 系统推断值 codes 函数内容 系统推断值 beanName bean名称 系统推断值 rule 前端规则 系统推断值,一般Action.rule传递下来的 clazz 函数位置 系统推断值 method 函数方法 系统推断值 argumentList 函数参数 系统推断值,List<Argument> returnType 返回值类型 系统推断值 表4-1-7-1 FunctionDefinition TransactionConfig 函数事务管理之配置项事务,具体事务使用详见4.1.8【函数之事务管理】一文。 元素数据构成 含义 对应注解 备注 transactionManager 事务管理器 @PamirsTransactional( transactionManager=””, enableXa=false, isolation=Isolation.DEFAULT, propagation=Propagation.REQUIRED, timeout=-1, readOnly=false, rollbackFor={}, rollbackForClassName={}, noRollbackFor={}, noRollbackForClassName={}, rollbackForExpCode={}, noRollbackForExpCode={} ) enableXa 分布式事务默认为false isolation 事务隔离级别 propagation 事务传递类型 timeout 过期时间 默认:-1 readOnly 只读 默认:false rollbackForExpCode 回滚异常编码 rollbackForExpCode 忽略异常编码 namespace 函数命名空间 系统推断值 fun 函数编码 系统推断值 active…

    Oinone 7天入门到精通 2024年5月23日
    1.9K00
  • 4.4 Oinone的分布式体验进阶

    在分布式开发中,每个人基本只负责自己相关的模块开发。所以每个研发就都需要一个环境,比如一般公司会有(N个)项目环境、1个日常环境、1个预发环境、1个线上环境。在整项目环境的时候就特别麻烦,oinone的好处是在于每个研发可以通过boot工程把需要涉及的模块都启动在一个jvm中进行开发,并不依赖任何环境,在项目开发中,特别方便。但当公司系统膨胀到一定规模,大到很多人都不知道有哪些模块,或者公司出于安全策略考虑,或者因为启动速度的原因(毕竟模块多了启动的速度也会降下来)。本文就给大家介绍oinone与经典分布式组织模式的兼容性 一、模块启动的最小集 我们来改造SecondModule模块,让该模块的用户权限相关都远程走DemoModule Step1 修改SecondModule的启动工程application-dev.yml文件 除了base、second_core两个模块保留,其他模块都去除了。 pamirs: boot: init: true sync: true modules: – base – second_core 图4-4-1 SecondModule的application-dev.yml仅配置两个模块 Step2 去除boot工程的依赖 去除SecondModule启动工程的pom依赖 <!– <dependency> <groupId>pro.shushi.pamirs.core</groupId> <artifactId>pamirs-resource-core</artifactId> </dependency> <dependency> <groupId>pro.shushi.pamirs.core</groupId> <artifactId>pamirs-user-core</artifactId> </dependency> <dependency> <groupId>pro.shushi.pamirs.core</groupId> <artifactId>pamirs-auth-core</artifactId> </dependency> <dependency> <groupId>pro.shushi.pamirs.core</groupId> <artifactId>pamirs-message-core</artifactId> </dependency> <dependency> <groupId>pro.shushi.pamirs.core</groupId> <artifactId>pamirs-international</artifactId> </dependency> <dependency> <groupId>pro.shushi.pamirs.core</groupId> <artifactId>pamirs-business-core</artifactId> </dependency> <dependency> <groupId>pro.shushi.pamirs.core</groupId> <artifactId>pamirs-apps-core</artifactId> </dependency> –> 图4-4-2 去除boot工程多余的依赖 Step3 重启SecondModule 这【远程模型】和【远程代理】均能访问正常 图4-4-3 远程模型和远程代理菜单均能访问正常 Step4 SecondModule增加对模块依赖 我们让SecondModule增加用户和权限模块的依赖,期待效果是:SecondModule会对用户和权限的访问都会走Dome应用,因为Demo模块的启动工程中包含了user、auth模块。 修改pamirs-second-api的pom文件增加对user和auth的api包依赖 <dependency> <groupId>pro.shushi.pamirs.core</groupId> <artifactId>pamirs-user-api</artifactId> </dependency> <dependency> <groupId>pro.shushi.pamirs.core</groupId> <artifactId>pamirs-auth-api</artifactId> </dependency> 图4-4-4 修改pamirs-second-api的pom文件 修改SecondModule类,增加依赖定义 @Module( dependencies = {ModuleConstants.MODULE_BASE, AuthModule.MODULE_MODULE, UserModule.MODULE_MODULE} ) 图4-4-5 配置SecondModule的依赖 Step5 修改RemoteTestModel模型 为RemoteTestModel模型增加user字段 @Field.many2one @Field(displayName = "用户") private PamirsUser user; 图4-4-6 为RemoteTestModel模型增加user字段 Step6 重启系统看效果 mvn install pamirs-second工程,因为需要让pamirs-demo工程能依赖到最新的pamirs-second-api包 重启pamirs-second和pamirs-demo 两个页面都正常 图4-4-7 示例效果一 图4-4-8 示例效果二 二、PmetaOnline的NEVER指令(开发时环境共享) 我们在4.1.2【模块之启动指令】一文中介绍过 “-PmetaOnline指令”,该参数用于设置元数据在线的方式,如果不使用该参数,则profile属性的默认值请参考服务启动可选项。-PmetaOnline参数可选项为: NEVER – 不持久化元数据,会将pamirs.boot.options中的updateModule、reloadMeta和updateMeta属性设置为false MODULE – 只注册模块信息,会将pamirs.boot.options中的updateModule属性设置为true,reloadMeta和updateMeta属性设置为false ALL – 注册持久化所有元数据,会将pamirs.boot.options中的updateModule、reloadMeta和updateMeta属性设置为true oinone的默认模式下元数据都是注册持久化到DB的,但当我们在分布式场景下新开发模块或者对已有模块进行本地化开发时,做为开发阶段我们肯定是希望复用原有环境,但不对原有环境照成影响。那么-PmetaOnline就很有意义。让我们还没有经过开发自测的代码产生的元数据仅限于开发本地环境,而不是直接影响整个大的项目环境 PmetaOnline指令设置为NEVER(举例) Step1 为DemoCore新增一个DevModel模型 package pro.shushi.pamirs.demo.api.model; import pro.shushi.pamirs.meta.annotation.Field; import pro.shushi.pamirs.meta.annotation.Model; @Model.model(DevModel.MODEL_MODEL) @Model(displayName = "开发阶段模型",summary="开发阶段模型,当PmetaOnline指令设置为NEVER时,本地正常启动但元数据不落库",labelFields={"name"}) public class DevModel extends AbstractDemoCodeModel{ public static final String MODEL_MODEL="demo.DevModel"; @Field(displayName = "名称") private String name; } 图4-4-9 为DemoCore新增一个DevModel模型 Step2 为DevModel模型配置菜单 @UxMenu("开发模型")@UxRoute(DevModel.MODEL_MODEL) class DevModelProxyMenu{} 图4-4-10 为DevModel模型配置菜单 Step3 启动Demo应用时指定-PmetaOnline 图4-4-11 启动Demo应用时指定-PmetaOnline Step4 重启系统看效果 查看元数据 图4-4-12 DB查看元数据变化 菜单与页面能正常操作 图4-4-13 开发模型菜单可正常操作 图4-4-14 开发模型详情页面可正常操作 Step5 Never模式需注意的事项 业务库需设定为本地开发库,这样才不会影响公共环境,因为对库表结构的修改还是会正常进行的 如果不小心影响了公共环境,需要对公共环境进行重启恢复 系统新产生的元数据(如:例子中的【开发模式】菜单)不受权限管控 三、分布式开发约定 设计约定 跨模块的存储模型间继承,在部署时需要跟依赖模块配置相同数据源。这个涉及模块规划问题,比如业务上的user扩展模块,需要跟user模块一起部署。…

    2024年5月23日
    1.7K00
  • 3.4.3.2 面向切面-拦截器

    一、拦截器 拦截器为平台满足条件的函数以非侵入方式根据优先级扩展函数执行前和执行后的逻辑。 使用方法上的@Hook注解可以标识方法为拦截器。前置扩展点需要实现HookBefore接口;后置扩展点需要实现HookAfter接口。入参包含当前拦截函数定义与该函数的入参。拦截器可以根据函数定义与入参增加处理逻辑。 拦截器分为前置拦截器和后置拦截器,前者的出入参为所拦截函数的入参,后者的出入参为所拦截函数的出参。可以使用@Hook注解或Hook模型的非必填字段module、model、fun、函数类型、active来筛选出对当前拦截方法所需要生效的拦截器。若未配置任何过滤属性,拦截器将对所有函数生效。 根据拦截器的优先级priority属性可以对拦截器的执行顺序进行调整。priority数字越小,越先执行。 二、前置拦截(举例) 增加一个前置拦截,对PetShop的sayHello函数进行前置拦截,修改函数的入参的shopName属性,在其前面增加"hookbefore:"字符串。并查看效果 Step1 新增PetShopSayHelloHookBefore实现HookBefore接口 为run方法增加@Hook注解 配置module={DemoModule.MODULE_MODULE},这里module代表的是执行模块,该Hook只匹配由DemoModule模块为发起入口的请求 配置model={PetShop.MODEL_MODEL},该Hook只匹配PetShop模型 配置fun={"sayHello"},该Hook只匹配函数编码为sayHello的函数 package pro.shushi.pamirs.demo.core.hook; import org.springframework.stereotype.Component; import pro.shushi.pamirs.demo.api.DemoModule; import pro.shushi.pamirs.demo.api.model.PetShop; import pro.shushi.pamirs.meta.annotation.Hook; import pro.shushi.pamirs.meta.api.core.faas.HookBefore; import pro.shushi.pamirs.meta.api.dto.fun.Function; @Component public class PetShopSayHelloHookBefore implements HookBefore { @Override @Hook(module = {DemoModule.MODULE_MODULE},model = {PetShop.MODEL_MODEL},fun = {"sayHello"}) public Object run(Function function, Object… args) { if(args!=null && args[0]!=null){ PetShop arg = (PetShop)args[0]; arg.setShopName("hookbefore:"+ arg.getShopName()); } return args; } } 图3-4-3-5 新增PetShopSayHelloHookBefore实现HookBefore接口 Step2 重启查看效果 用graphQL工具Insomnia查看效果,如果访问提示未登陆,则请先登陆。详见3.4.1【构建第一个Function】一文 用 http://127.0.0.1:8090/pamirs/base 访问,结果我们会发现PetShopSayHelloHookBefore不起作用。是因为本次请求是以base模块作为发起模块,而我们用module={DemoModule.MODULE_MODULE}声明了该Hook只匹配由DemoModule模块为发起入口的请求 图3-4-3-6 示例效果 用 http://127.0.0.1:8090/pamirs/demoCore 访问,前端是以模块名作为访问入口不是模块编码这里大家要注意下 图3-4-3-7 示例效果 用 http://127.0.0.1:8090/pamirs/demoCore 访问,更换到petShop的子模型petShopProxy来访问sayHello函数,结果我们发现是没有效果的。因为配置model={PetShop.MODEL_MODEL},该Hook只匹配PetShop模型 三、后置拦截(举例) 增加一个后置拦截,对PetShop的sayHello函数进行后置拦截,修改函数的返回结果的shopName属性,在其后面增加"hookAfter:"字符串。并查看效果 Step1 新增PetShopSayHelloHookAfter实现HookAfter接口 为run方法增加@Hook注解 配置model={PetShop.MODEL_MODEL},该Hook只匹配PetShop模型 配置fun={"sayHello"},该Hook只匹配函数编码为sayHello的函数 package pro.shushi.pamirs.demo.core.hook; import org.springframework.stereotype.Component; import pro.shushi.pamirs.demo.api.model.PetShop; import pro.shushi.pamirs.meta.annotation.Hook; import pro.shushi.pamirs.meta.api.core.faas.HookAfter; import pro.shushi.pamirs.meta.api.dto.fun.Function; @Component public class PetShopSayHelloHookAfter implements HookAfter { @Override @Hook(model = {PetShop.MODEL_MODEL},fun = {"sayHello"}) public Object run(Function function, Object ret) { if (ret == null) { return null; } PetShop result =null; if (ret instanceof Object[]) { Object[] rets = (Object[])((Object[])ret); if (rets.length == 1) { result = (PetShop)rets[0]; } } else { result = (PetShop)ret; } result.setShopName(result.getShopName()+":hookAfter"); return result; } } 3-4-3-8 新增PetShopSayHelloHookAfter实现HookAfter接口 Step2 重启查看效果 用 http://127.0.0.1:8090/pamirs/base 访问,结果我们会发现PetShopSayHelloHookAfter是起作用。PetShopSayHelloHookBefore没有配置模块过滤。 3-4-3-9 示例效果 用访问,结果我们会发现PetShopSayHelloHookAfte和PetShopSayHelloHookBefore同时起作用 3-4-3-10 示例效果 我们会发现HookAfter只对结果做了修改,所以message中可以看到hookbefore,但看不到hookAfter 四、注意点 不管前置拦截器,还是后置拦截器都可以配置多个,根据拦截器的优先级priority属性可以对拦截器的执行顺序进行调整。priority数字越小,越先执行。小伙伴们可以自行尝试 拦截器必须是jar依赖,不然执行会报错。特别是有的小伙伴配置了一个没有过滤条件的拦截器,就要非常小心 模块启动yml文件可以过滤不需要执行的hook,具体配置详见4.1.1【模块之yml文件结构详解】一文 调用入口不是由前端发起而是后端编程中直接调用,默认不会生效,如果要生效请参考4.1.9【函数之元位指令】一文

    2024年5月23日
    1.7K00
  • 4.3 Oinone的分布式体验

    在oinone的体系中分布式比较独特,boot工程中启动模块中包含就走本地,不包含就走远程,本文带您体验下分布式部署以及分布式部署需要注意点。 看下面例子之前先把话术统一下:启动或请求SecondModule代表启动或请求pamirs-second-boot工程,启动或请求DemoModule代表启动或请求pamirs-demo-boot工程,并没有严格意义上启动哪个模块之说,只有启动工程包含哪个模块。 一、构建SecondModule模块 Step1 构建模块工程 参考3.2.1【构建第一个Module】一文,利用脚手架工具构建一个SecondModule,记住需要修改脚本。 脚本修改如下: #!/bin/bash # 项目生成脚手架 # 用于新项目的构建 # 脚手架使用目录 # 本地 local # 本地脚手架信息存储路径 ~/.m2/repository/archetype-catalog.xml archetypeCatalog=local # 以下参数以pamirs-second为例 # 新项目的groupId groupId=pro.shushi.pamirs.second # 新项目的artifactId artifactId=pamirs-second # 新项目的version version=1.0.0-SNAPSHOT # Java包名前缀 packagePrefix=pro.shushi # Java包名后缀 packageSuffix=pamirs.second # 新项目的pamirs platform version pamirsVersion=4.6.0 # Java类名称前缀 javaClassNamePrefix=Second # 项目名称 module.displayName projectName=OinoneSecond # 模块 MODULE_MODULE 常量 moduleModule=second_core # 模块 MODULE_NAME 常量 moduleName=SecondCore # spring.application.name applicationName=pamirs-second # tomcat server address serverAddress=0.0.0.0 # tomcat server port serverPort=8090 # redis host redisHost=127.0.0.1 # redis port redisPort=6379 # 数据库名 db=demo # zookeeper connect string zkConnectString=127.0.0.1:2181 # zookeeper rootPath zkRootPath=/second mvn archetype:generate \ -DinteractiveMode=false \ -DarchetypeCatalog=${archetypeCatalog} \ -DarchetypeGroupId=pro.shushi.pamirs.archetype \ -DarchetypeArtifactId=pamirs-project-archetype \ -DarchetypeVersion=4.6.0 \ -DgroupId=${groupId} \ -DartifactId=${artifactId} \ -Dversion=${version} \ -DpamirsVersion=${pamirsVersion} \ -Dpackage=${packagePrefix}.${packageSuffix} \ -DpackagePrefix=${packagePrefix} \ -DpackageSuffix=${packageSuffix} \ -DjavaClassNamePrefix=${javaClassNamePrefix} \ -DprojectName="${projectName}" \ -DmoduleModule=${moduleModule} \ -DmoduleName=${moduleName} \ -DapplicationName=${applicationName} \ -DserverAddress=${serverAddress} \ -DserverPort=${serverPort} \ -DredisHost=${redisHost} \ -DredisPort=${redisPort} \ -Ddb=${db} \ -DzkConnectString=${zkConnectString} \ -DzkRootPath=${zkRootPath} 图4-3-1 构建一个名为SecondModule的模块 脚步执行生成工程如下: 图4-3-2 SecondModule的工程结构 Step2 调整配置 修改application-dev.yml文件 修改SecondModule的application-dev.yml的内容 base库换成与DemoModule一样的配置,配置项为:pamirs.datasource.base pamirs: datasource: base: driverClassName: com.mysql.cj.jdbc.Driver type: com.alibaba.druid.pool.DruidDataSource url: jdbc:mysql://127.0.0.1:3306/demo_base?useSSL=false&allowPublicKeyRetrieval=true&useServerPrepStmts=true&cachePrepStmts=true&useUnicode=true&characterEncoding=utf8&serverTimezone=Asia/Shanghai&autoReconnect=true&allowMultiQueries=true username: root # 数据库用户 password: oinone # 数据库用户对应的密码 initialSize: 5 maxActive: 200 minIdle: 5 maxWait: 60000 timeBetweenEvictionRunsMillis: 60000…

    2024年5月23日
    1.9K00
  • 流程

    1. 流程介绍 日常工作和生活中到处都存在各种各样的流程,例如业务开展中的产品研发流程、产品制作流程、订单发货流程等,也有管控分险的费用报销流程、员工请假审批流程、项目立项流程等。流程设计器可以帮助公司实现流程的数字化,规范流程操作,减少人工操作并留存痕迹,提高工作效率和安全性。 2. 流程的组成 流程设计器主要包含基本操作和流程设计两个部分。前者包含了流程的新增、删除、复制、停用/启用、编辑、搜索。后者包含单一流程的基础信息修改、流程设计、参数配置、保存、发布。 2.1 流程的基本操作 流程页面有两种显示方式,默认为平铺显示的模式,可以点击切换为列表详情显示的模式。 2.1.1 新增 平铺显示和列表详情模式下点击左上角的创建按钮即可新增一个流程,点击后进入流程设计页面,流程名默认为“未命名流程”,可自行修改。 2.1.2 删除 遇到流程创建有误,没有使用过且将来也不会使用该流程,可以删除流程。需要注意的是,删除流程的前提是该流程已停用,并且该流程从未执行过。 2.1.3 复制 遇到流程节点动作相似度较高的情况可以使用复制流程的功能,点击按钮后生成一个“原流程名-复制”的流程,并且进入新流程的流程设计界面。 2.1.4 停用/启用 流程需要更新或暂时不用时可以使用停用功能。流程停用后将不会执行流程中的动作,正在执行中的流程不受停用影响,会正常执行直到流程结束。 点击启用按钮,流程恢复启用状态,可正常触发。 2.1.5 编辑 点击编辑进入该流程的设计页面。 2.1.6 搜索 页面最上方的是搜索区,可以按照流程名称、触发方式、启用状态、更新状态进行筛选搜素,点击重置按钮修改搜索条件。

    2024年1月20日
    2.4K00

Leave a Reply

Please Login to Comment