数据字典

1. 什么是数据字典

数据字典是一些固定字典项的集合,可作为多选或单选的选项,例如人员性别、员工属相、杭州市下属的行政区等都是数据字典。

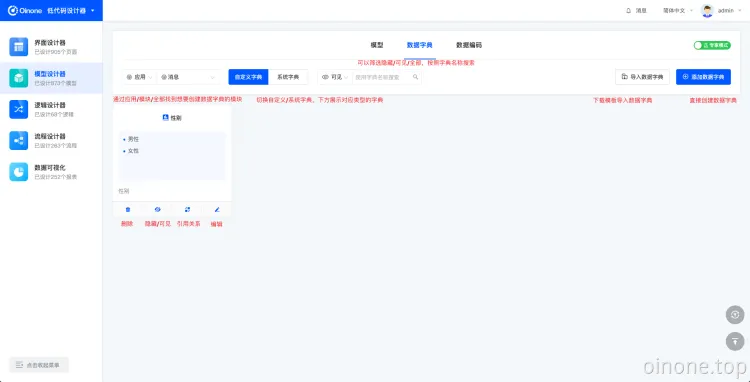
选择一个应用/模块下的一个小模块,可以查看其中包含的自定义字典(自建的数据字典)和系统字典。可以通过导入或添加创建自定义字典。

image.png

2. 数据字典基本操作

  • 删除:系统字典不支持删除,无法批量删除自定义数据字典,若数据字典已经被字段、页面等引用时,也无法删除这个数据字典。
  • 隐藏/可见:自定义字典、系统字典都可以操作隐藏和可见,隐藏和可见不影响数据字典在字段、页面等处的使用。
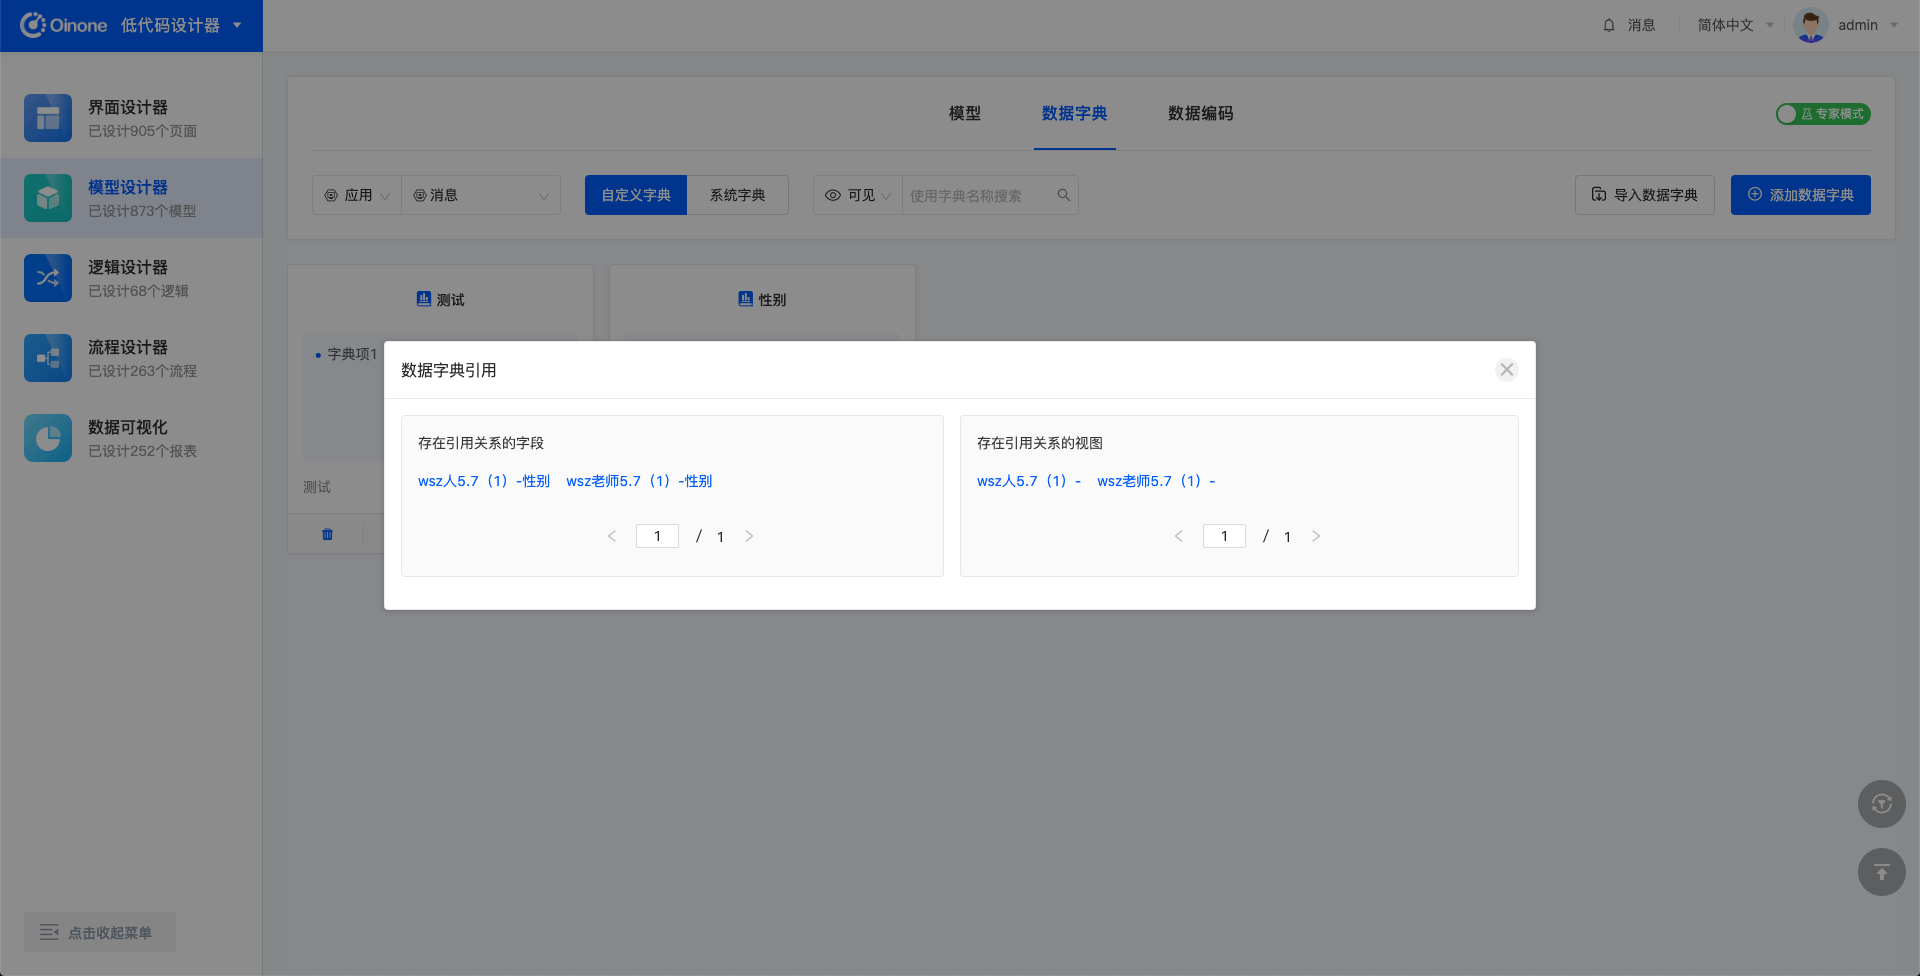
  • 查看引用关系:点击查看引用关系,展开弹窗,展示该数据字典和字段、视图的引用关系。

image.png

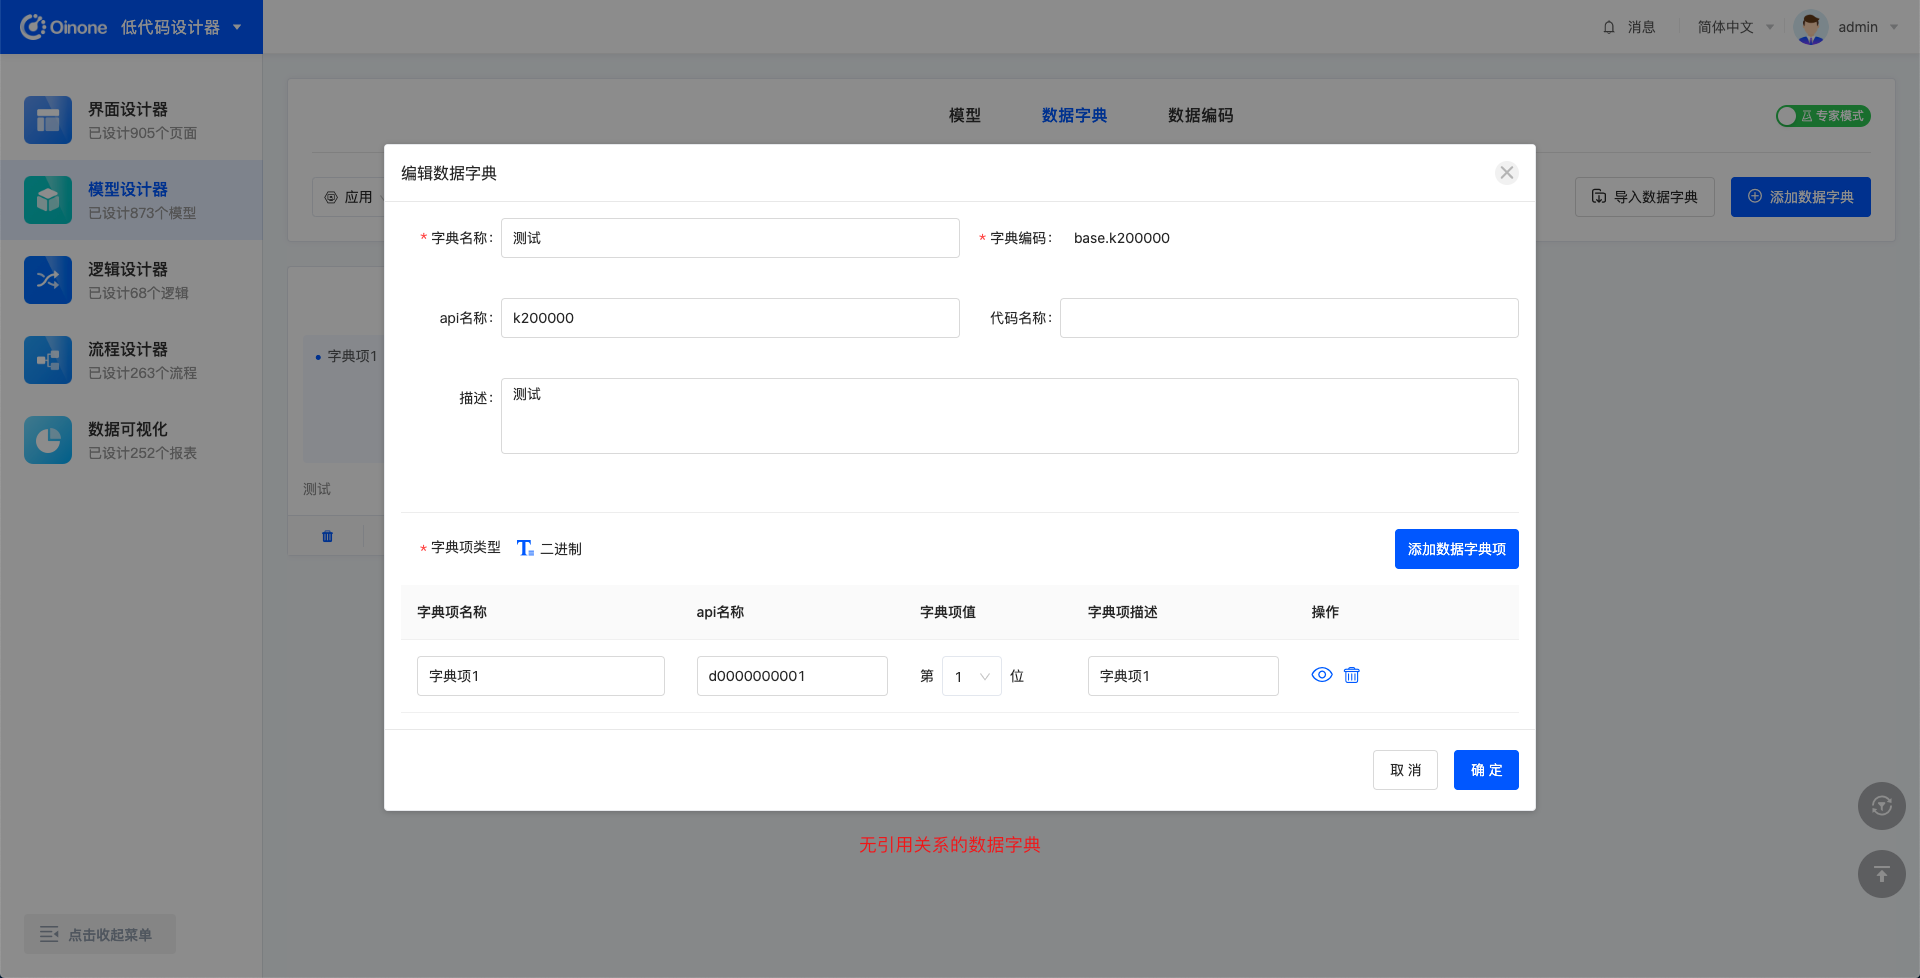
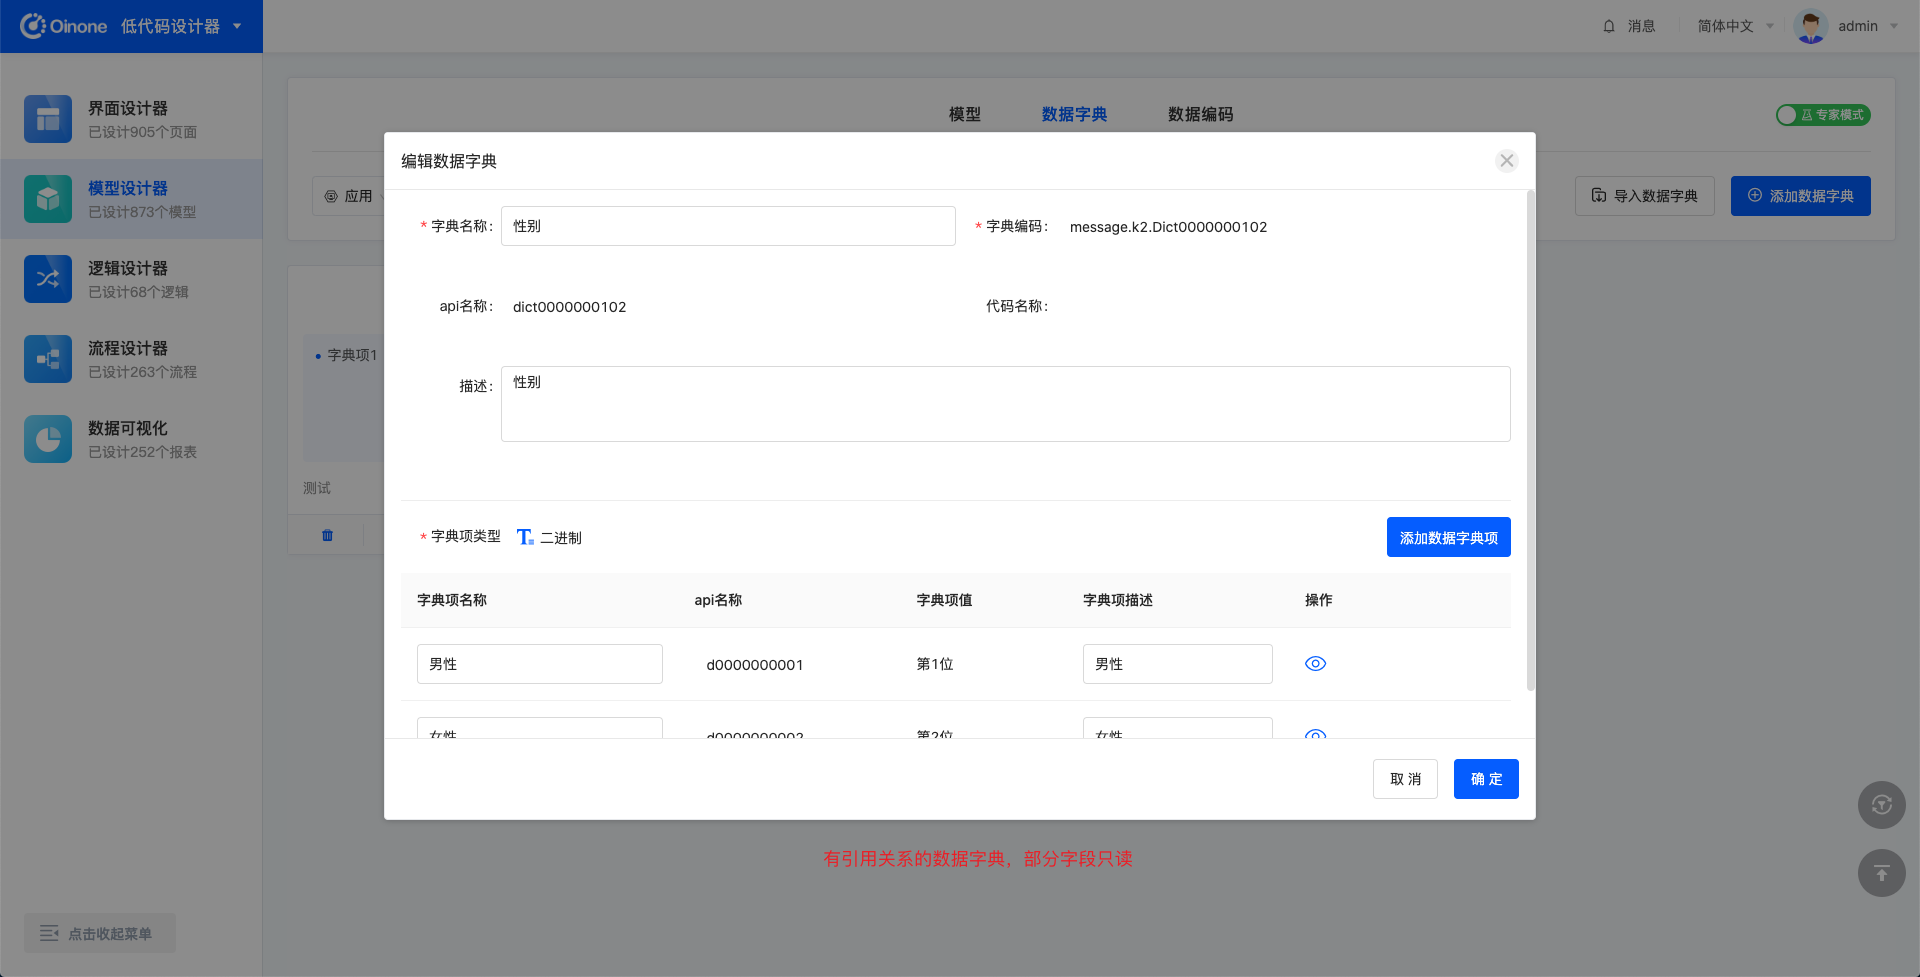
  • 修改:若数据字典已经被引用,无法删除其中的字典项。若无引用关系则可以任意修改。

image.png

image.png

3. 数据字典导入

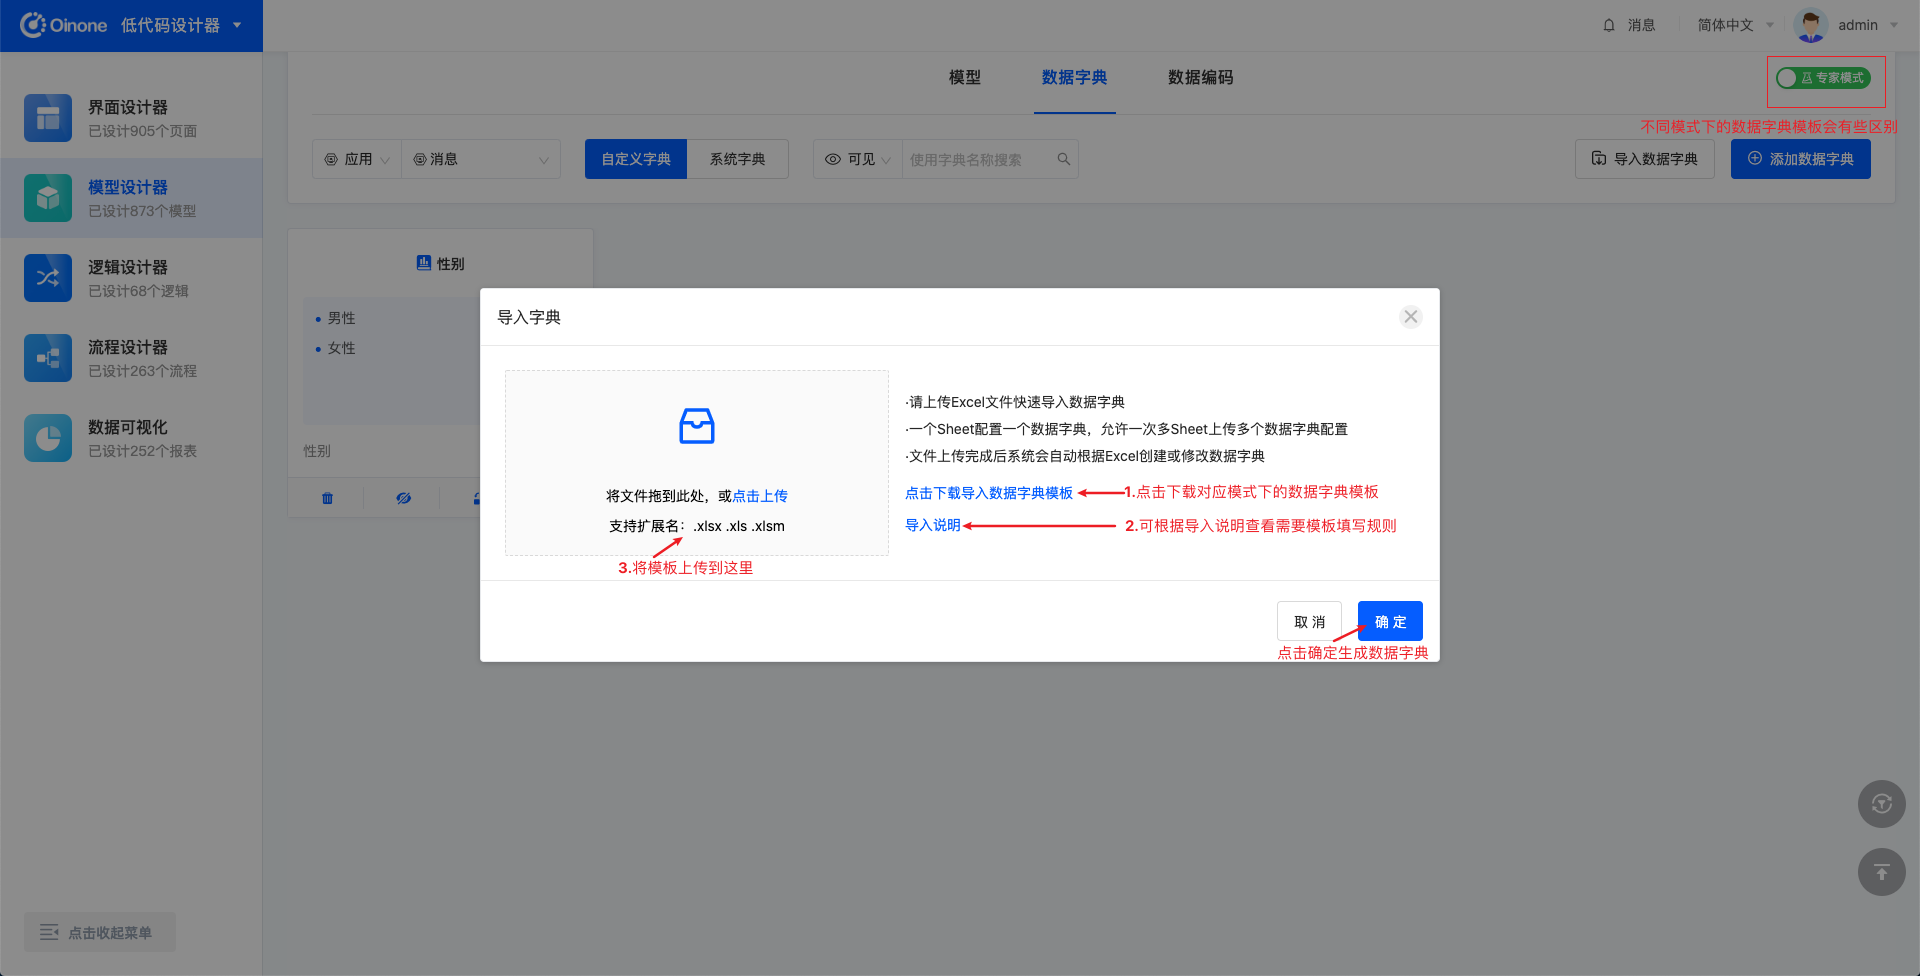
  • 点击“导入数据字典”按钮,弹出窗口,可根据图中引导进行数据字典的导入。
  • 在经典模式下,导入数据字典会新建数据字典。
  • 在专家模式下,数据字典导入的模板中包含字段“字典编码”,若导入的字典编码不存在则会新建数据字典,若导入的字典编码已存在则会修改字典编码的设置,新建和修改的动作会校验是否符合规范。

image.png

4. 数据字典创建

4.1 专家模式(低代码模式)

image.png

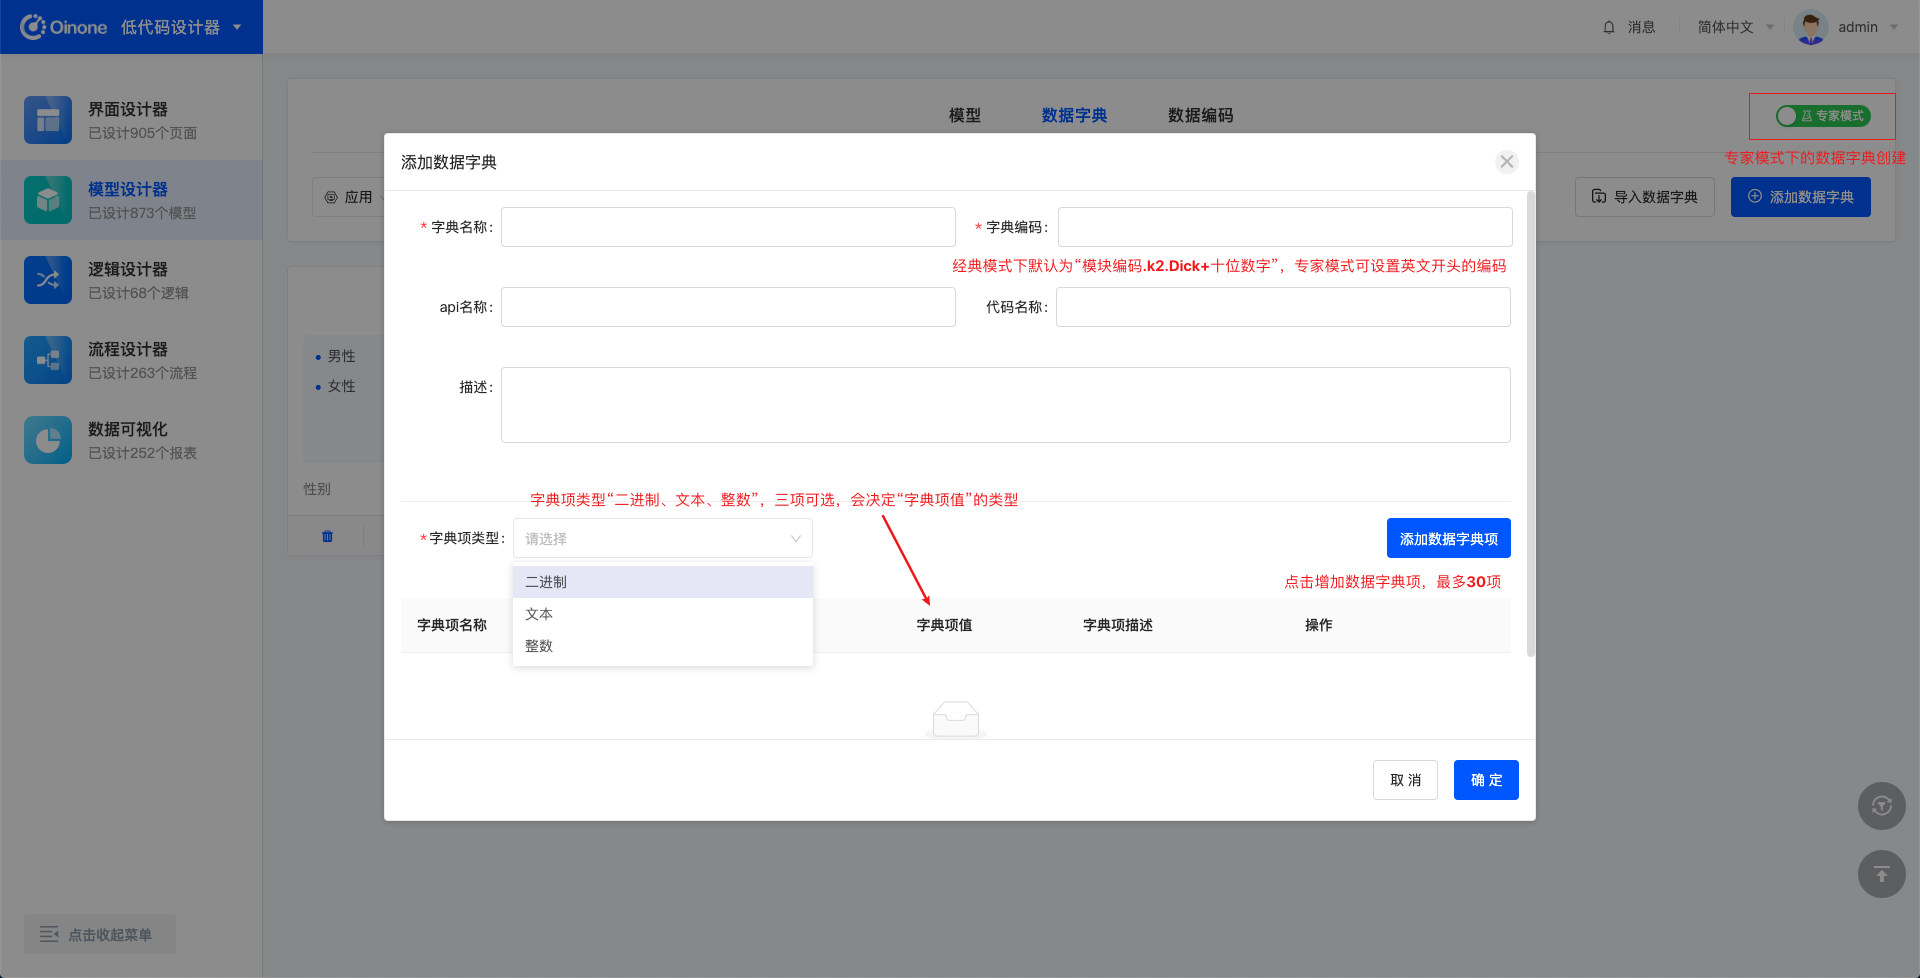
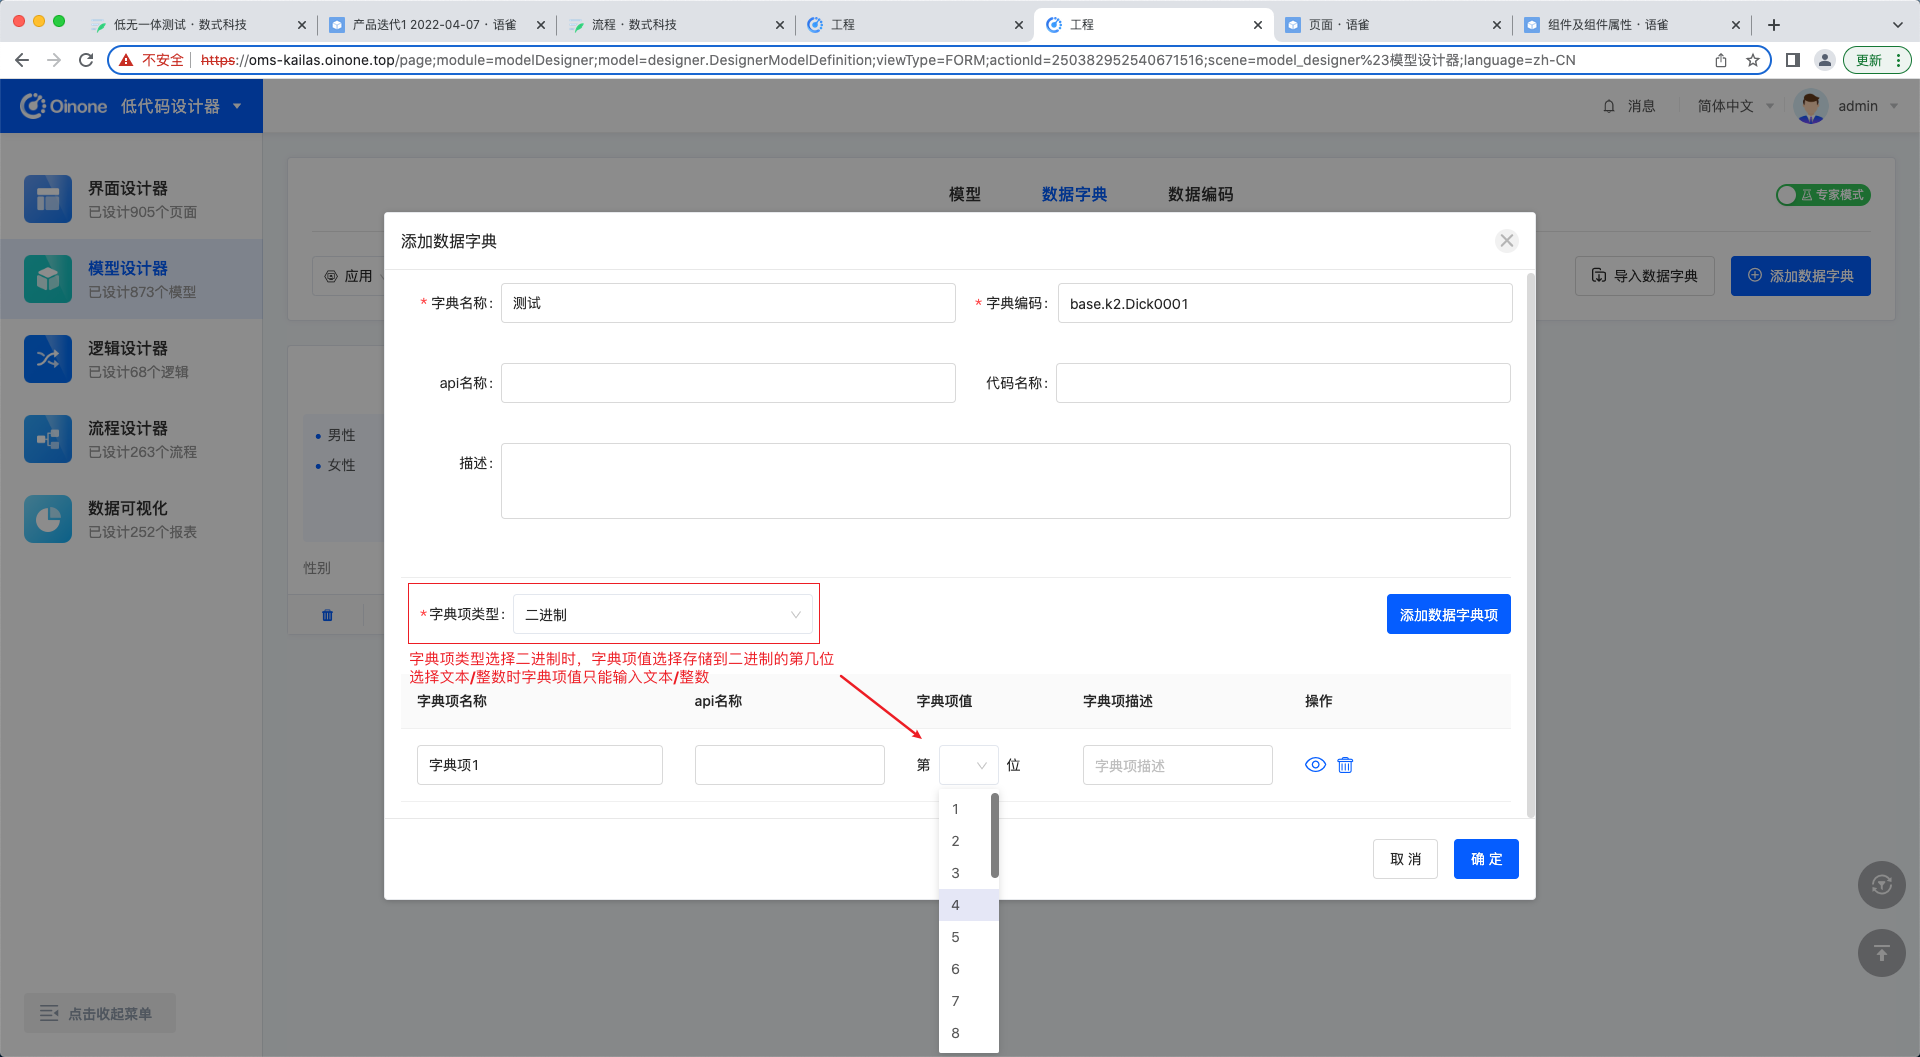
  • 字典项类型有“二进制、文本、整数”三种可选,选择二进制时,字典项值需要选择存储在数据库二进制中的第几位。系统根据字典项值去查找字典项名称,因此字典项值不可重复。

image.png

  • 数据字典的api名称、代码名称、描述可不填,部分系统会赋默认值。
  • 字典项中字典项名称和字典项值必填,api名称和字典项描述不填系统会赋默认值。

4.2 经典模式(无代码模式)

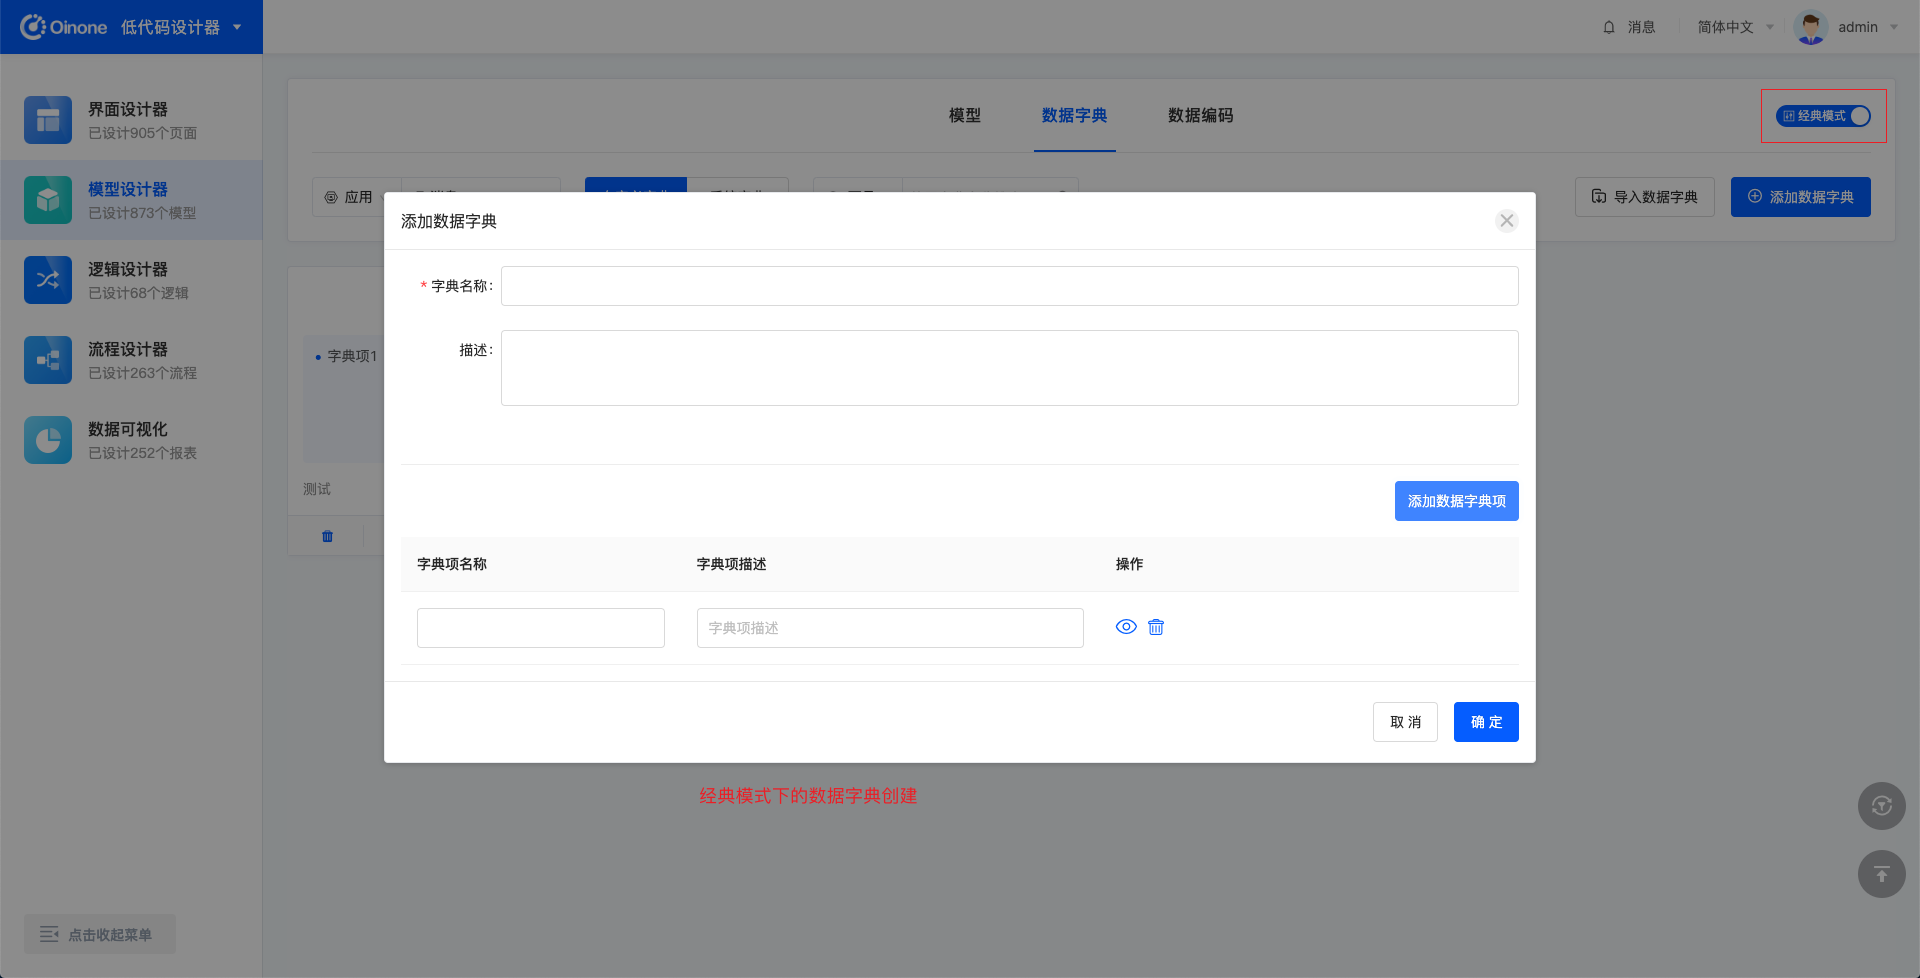
  • 经典模式下只需要填写字典名称,添加字典项即可。系统会自动将字典项类型设置为“二进制”,并将字典项按照创建的先后顺序设置字典项值的位数。字典项类型、字典项值释义可参照专家模式的解释。

image.png

Oinone社区 作者:史, 昂原创文章,如若转载,请注明出处:https://doc.oinone.top/oio4/9400.html

访问Oinone官网:https://www.oinone.top获取数式Oinone低代码应用平台体验

Like (0)
史, 昂's avatar史, 昂数式管理员
Previous 2024年6月20日 am9:49
Next 2024年6月20日 am9:49

相关推荐

  • 开发者

    1.开发者 1.1 Webhook 通过webhook流程节点可以向第三方系统发送请求。 1.1.1 请求方式 支持GET、POST两种请求方式。 1.1.2 URL 在Webhook URL中填写发送请求的HTTP地址。 1.1.3 Headers&Body Headers的value支持通过表达式配置变量 Body的数据类型支持KEY_VALUE和APPLICATION_JSON两种。

    2024年6月20日
    2.5K00
  • 6.3 数据审计(改)

    在业务应用中我们经常需要为一些核心数据的变更做审计追踪,记录字段的前后变化、操作IP、操作人、操作地址等等。数据审计模块为此提供了支撑和统一管理。它在成熟的企业的核心业务系统中,需求是比较旺盛的。接下来我们开始学习下数据审计模块 准备工作 pamirs-demo-core的pom文件中引入pamirs-data-audit-api包依赖 <dependency> <groupId>pro.shushi.pamirs.core</groupId> <artifactId>pamirs-data-audit-api</artifactId> </dependency> pamirs-demo-boot的pom文件中引入pamirs-data-audit-core和pamirs-third-party-map-core包依赖,数据审计会记录操作人的地址信息,所以也依赖了pamirs-third-party-map-core <dependency> <groupId>pro.shushi.pamirs.core</groupId> <artifactId>pamirs-data-audit-core</artifactId> </dependency> <dependency> <groupId>pro.shushi.pamirs.core.map</groupId> <artifactId>pamirs-third-party-map-core</artifactId> </dependency> pamirs-demo-boot的application-dev.yml文件中增加配置pamirs.boot.modules增加data_audit 和third_party_map,即在启动模块中增加data_audit和third_party_map模块 pamirs: boot: modules: – data_audit – tp_map 为third_party_map模块增加高德接口api,下面e439dda234467b07709f28b57f0a9bd5换成自己的key pamirs: eip: map: gd: key: e439dda234467b07709f28b57f0a9bd5 数据审计 注解式(举例) Step1 新增PetTalentDataAudit数据审计定义类 package pro.shushi.pamirs.demo.core.init.audit; import pro.shushi.pamirs.data.audit.api.annotation.DataAudit; import pro.shushi.pamirs.demo.api.model.PetTalent; @DataAudit( model = PetTalent.MODEL_MODEL,//需要审计的模型 modelName = "宠物达人" ,//模型名称,默认模型对应的displayName //操作名称 optTypes = {PetTalentDataAudit.PETTALENT_CREATE,PetTalentDataAudit.PETTALENT_UDPATE}, fields={"nick","picList.id","picList.url","petShops.id","petShops.shopName"}//需要审计的字段,关系字段用"."连结 ) public class PetTalentDataAudit { public static final String PETTALENT_CREATE ="宠物达人创建"; public static final String PETTALENT_UDPATE ="宠物达人修改"; Step2 修改PetTalentAction的update方法 做审计日志埋点:手工调用 OperationLogBuilder.newInstance().record()方法。需要注意的是这里需要把原有记录的数据值先查出来做对比 @Function.Advanced(type= FunctionTypeEnum.UPDATE) @Function.fun(FunctionConstants.update) @Function(openLevel = {FunctionOpenEnum.API}) public PetTalent update(PetTalent data){ //记录日志 OperationLogBuilder.newInstance(PetTalent.MODEL_MODEL, PetTalentDataAudit.PETTALENT_UDPATE).record(data.queryById().fieldQuery(PetTalent::getPicList).fieldQuery(PetTalent::getPetShops),data); PetTalent existPetTalent = new PetTalent().queryById(data.getId()); if(existPetTalent !=null){ existPetTalent.fieldQuery(PetTalent::getPicList); existPetTalent.fieldQuery(PetTalent::getPetShops); existPetTalent.relationDelete(PetTalent::getPicList); existPetTalent.relationDelete(PetTalent::getPetShops); } data.updateById(); data.fieldSave(PetTalent::getPicList); data.fieldSave(PetTalent::getPetShops); return data; } Step3 重启看效果 修改宠物达人记录对应的字段,然后进入审计模块查看日志

    2024年5月23日
    1.7K00
  • 特别说明

    教材进度 目前还在编写整改中,特别是目录上带(改)字样的 本版本教材针对4.0,相对3.0增加的特性有: 通用能力部分:比如权限、审计、国际化、系统配置、集成可视化等 新版权限:交互优化,同时支持子管理员 新版审计,支持在线配置审计规则 系统配置,提供多种风格,让伙伴基础风格不在需要自定义主题和组件 新增集成设计器,通过连接器让应用api和数据库集成资产化管理,通过数据流进行接口逻辑编排,并提供统一的开放平台 设计器部分: 加强界面设计器部分对移动端、主题、自定义组件等支持,同时完善对数据管理操作、增加各类常用业务组件,加强对树形与及联的支持,表格视图搜索优化 流程设计器增加:审批员选择自定义逻辑、转交人选择自定义逻辑,支持手工触发、支持数据事务、支持调用模型函数 可视化设计器:增加自定义图表功能、增强下钻能力 模块管理:增加新增、多端配置等支持 内核机制: 性能优化:通过gql层面解决业务研发过程中1+N性能问题,权限性能优化,分布式缓存性能优化,整体性能提升2倍以上 针对多租户应用无状态的支持,低无一体支持本地调试 5.0的核心新特性预告,特性会在开发过程中陆续推出供大家体验,但完整体验时间为2024年6月份 新增打印设计功能 导出的默认交互增强以及导入导出模版设计 默认导入导出在交互时可以指定字段 导入导出模版可图形化设计 多模型AI集成设计器器 自定义组件、自定义图表交互友好性增强 自定义组件,属性面板设计模版化,解决设计组件属性面板的时候不知道有哪些默认属性。 增强组件与动作的结合灵活性 组件增加是否有子组件的通用属性,有子组件的组件具备组件拖拽区 增强UX注解能力,原本只有设计器支持的,后端UX注解也进行对应支持 后端低无一体功能开放(原本该功能只在saas版本上提供),方便咱们做应急和简单应用的时,以无代码为主,低代码为辅的模式。通过低无一体可以通过低代码的方式来解决无代码无法支撑的功能。 工作流增强 增加循环审批节点 增加分支汇集节点增强并行流程能力,比如分支汇集节点可以设置:所有并行节点处理完或只要一条处理完就继续执行。

    2024年5月23日
    2.5K00
  • 3.4.1 构建第一个Function

    Function做为oinone的可管理的执行逻辑单元,是无处不在的 在3.3.3【模型的数据管理器】和3.3.2【模型类型】一文中的代理模型部分,涉及到包括在Action中自定义函数(action背后都对应一个Function)、重写queryPage的函数、以及独立抽取的公共逻辑函数,Function做为oinone的可管理的执行逻辑单元,是无处不在的。这也是为什么说oinone以函数为内在的原因。 一、构建第一个Function 因为数据管理器和数据构造器是oinone为模型自动赋予的Function,是内在数据管理能力。模型其他Function都需要用以下四种方式主动定义 伴随模型新增函数(举例) 它是跟模型的java类定义在一起,复用模型的命名空间。 Step1 为PetShop增加一个名为sayHello的Function package pro.shushi.pamirs.demo.api.model; …… //import @Model.model(PetShop.MODEL_MODEL) @Model(displayName = "宠物店铺",summary="宠物店铺",labelFields ={"shopName"} ) @Model.Code(sequence = "DATE_ORDERLY_SEQ",prefix = "P",size=6,step=1,initial = 10000,format = "yyyyMMdd") public class PetShop extends AbstractDemoIdModel { public static final String MODEL_MODEL="demo.PetShop"; …… //省略其他代码 @Function(openLevel = FunctionOpenEnum.API) @Function.Advanced(type=FunctionTypeEnum.QUERY) public PetShop sayHello(PetShop shop){ PamirsSession.getMessageHub().info("Hello:"+shop.getShopName()); return shop; } } 图3-4-1-1 代码示例 Step2 重启看效果 用graphQL工具Insomnia查看效果 用Insomnia模拟登陆 a. 创建一个login请求,用于保存login请求,为后续模拟登陆保留快捷方式 图3-4-1-2 创建一个login请求 b. 下面为登陆请求的GraphQL,请在post输入框中输入。如果请求输入框提示错误可以,可以点击schema 的Refresh Schema来刷新文档 mutation { pamirsUserTransientMutation { login(user: {login: "admin", password: "admin"}) { broken errorMsg errorCode errorField } } } 图3-4-1-3 登陆请求的GraphQL c. 点击Send按钮,我们可以看到登陆成功的反馈信息 图3-4-1-4 登陆成功的反馈信息 用Insomnia模拟访问PetShop的sayHello方法,gql的返回中,我们可以看到两个核心返回 a. 一是方法正常返回的shopName b. 二是“PamirsSession.getMessageHub().info("Hello:"+shop.getShopName())”代码执行的结果,在messages中有一个消息返回,更多消息机制详见4.1.23【框架之信息传递】 query{ petShopQuery{ sayHello(shop:{shopName:"cpc"}){ shopName } } } 图3-4-1-5 用Insomnia模拟访问PetShop的sayHello 图3-4-1-6 代码执行结果 用Insomnia模拟访问PetShopProxy的sayHello方法 效果同用Insomnia模拟访问PetShop的sayHello方法,体现Function的继承特性。 独立新增函数绑定到模型(举例) 独立方法定义类,并采用Model.model或Fun注解,但是value都必须是模型的编码,如@Model.model(PetShop.MODEL_MODEL)或@Fun(PetShop.MODEL_MODEL) Step1 提取PetShop的sayHello方法独立到PetShopService中 注释掉PetShop的sayHello方法 package pro.shushi.pamirs.demo.api.model; …… //import @Model.model(PetShop.MODEL_MODEL) @Model(displayName = "宠物店铺",summary="宠物店铺",labelFields ={"shopName"} ) @Model.Code(sequence = "DATE_ORDERLY_SEQ",prefix = "P",size=6,step=1,initial = 10000,format = "yyyyMMdd") public class PetShop extends AbstractDemoIdModel { public static final String MODEL_MODEL="demo.PetShop"; …… //省略其他代码 // @Function(openLevel = FunctionOpenEnum.API) // @Function.Advanced(type=FunctionTypeEnum.QUERY) // public PetShop sayHello(PetShop shop){ // PamirsSession.getMessageHub().info("Hello:"+shop.getShopName()); // return shop; // } } 图3-4-1-7 注释掉PetShop的sayHello 新增PetShopService接口类 接口的方法上要加上@Function注解,这样另模块依赖api包的时候,会自动注册远程服务的消费者 package pro.shushi.pamirs.demo.api.service; import pro.shushi.pamirs.demo.api.model.PetShop; import pro.shushi.pamirs.meta.annotation.Fun; import pro.shushi.pamirs.meta.annotation.Function; @Fun(PetShop.MODEL_MODEL) //@Model.model(PetShop.MODEL_MODEL) public interface…

    2024年5月23日
    2.0K00
  • 1.3 Oinone的生态思考

    以“企业级软件生态”的方式去帮助企业建立“一站式的商业智能软件”。 通过观察信息化到数字化的软件行业发展历程(如下图1-3所示),我们可以发现,企业真正需要的是一站式的软件产品。然而,一站式的软件产品往往都是从单个领域的需求满足开始,这在信息化时代和数字化时代都是如此。在信息化时代,以ERP为终点的一站式趋势逐渐形成;而在数字化时代,中台概念的提出则标志着一站式的趋势重新开始。本文将从企业数字化转型所面临的困境出发,探讨Oinone的生态思考。 图1-3 从信息化到数字化软件行业发展历程 1.3.1 与中台的渊源 中台概念的提出标志着企业数字化改造进入了一个新的时代。随着数字化转型不断深入,企业面临着严重的数据割裂、系统隔离等问题。在这样的背景下,“敏捷响应,低成本地快速创新”成为了推动一站式商业智能软件的内在诉求。需要澄清的是,互联网中台架构只是一种企业解决数据割裂、系统隔离,建立一站式商业智能软件的技术概念之一,并不是技术标准。而且这种方式只适用于企业自建模式。在多供应商环境下,则会适得其反,导致建立更复杂的烟囱系统。 阿里于15年提出中台架构概念,抓住了企业数字化转型的核心诉求,即“敏捷响应,低成本快速创新”。然而,阿里作为一家生态公司,在16年时基本上是带着合作伙伴来给企业交付,但由于伙伴对互联网技术的理解和能力的限制,基本上都做得不好,甚至失败。在2017年,阿里成立了原生交付团队,希望能够树立一些标杆案例。我和公司的核心成员也都来自于这个团队。在做完几个客户后,我发现阿里也做不好,但这次做不好的原因不是技术不行或项目上不了线,而是上线以后预期的效果没有达到,其本质是企业的IT组织能力无法驾驭复杂的互联网中台架构。当无法驾驭的时候,所谓的目标“敏捷响应,快速创新”就无从说起了。结果客户会反馈以下三类问题: 不是说敏捷响应吗?为什么改个需求这么慢,不但时间更长,付出的成本也更高了?是因为中台架构需要一定的技术能力和经验才能有效地应用,就像一个只会骑自行车的人给他一辆汽车或者飞机,他也不能驾驭它们,更不用说是手动挡的。 不是说能力中心吗?当引入新供应商或有新场景开发的时候,为什么前期做的能力中心不能支撑了?是因为能力中心是一种面向业务的能力组织方式,它将不同的业务能力抽象出来,以服务的形式对内提供。然而,由于业务场景的差异,不同的业务需要的能力也会不同,因此能力中心需要不断迭代和升级。对于新引入的供应商或新场景开发,需要根据实际情况对能力中心进行定制化和扩展化,但谁来负责呢?新项目的供应商还是客户自己? 不是说性能好吗?为什么我投入的物理资源更多了?是因为中台架构采用微服务来解决单点瓶颈问题,提高系统性能和可用性,但是在初始阶段,投入的资源可能会更多。每个模块至少需要两个实例来保障高可用性,因此物理资源的投入量可能会比以前更多。 1.3.2 找解决方案 在考虑解决方案之前,我们需要思考企业数字化软件的最终状态将是什么样子。目前有两种主要的方案(如下图1-4所示): 第一种是以自建研发团队为核心。中国的大型企业已经开始尝试这种模式,看起来似乎是一个时下比较流行的可行性方案。然而,绝大多数企业由于成本、人才团队等原因而难以坚持下去,只能与供应商合作开发。 第二种是以供应商为核心。由于大多数企业无法选择第一种路径,他们必须接受目前分散的情况,并通过系统集成尽可能拉通各个系统。尽管如此,在数字化时代中,真正意义上的一站式商业智能软件供应商还未出现。 图1-4 企业数字化桎梏和囹圄 对企业来说,这两种方案都非常艰难,但在大规模数字化历程中又不得不做出选择。此外,我们还能清晰看到以下几点: "敏捷响应,低成本地快速创新"成为企业推动一站式商业智能软件的内在诉求 目前没有一家软件供应商能满足企业所有外围商业场景,也不可能有这样的供应商 绝大部分企业需要软件供应商,而不是自建 如何突破这种局面也成为中国软件行业发展的一个机遇。因此,我的思考是: 我们的目标不是依托于提升研发人员的能力,而是降低互联网架构的门槛,让更多企业真正拥有“敏捷响应,低成本快速创新”的能力。 我们的目标不是输出中台方法论,而是提供中台建设的技术平台。 我们的目标不是只服务大企业,而是真正赋能不同IT组织能力的企业,让它们都具备持续创新的能力。 今天,许多中台软件公司告诉企业:“中台是持续演进和快速迭代的过程,因此企业需要组建中台架构团队来实现,而他们则通过中台项目落地将中台建设方法论传授给企业。”这句话的前半部分是正确的,因为我们之前提到企业需要具备敏捷响应业务的能力,即应变能力,因为应变是不断变化的。然而,后半部分是不正确的,因为今天的企业已经有能力组建团队,那么这些中台软件公司到底有什么用呢?企业真的缺少方法论吗?在19年,我就提出了自己的看法:没有低代码能力的中台公司都在收取智商税,都在欺诈,因为很多企业根本找不到足够懂互联网架构的人才。明白流氓在哪里了吗?这些流氓公司赚了很多钱,最后责怪企业无法招到人才,这是企业的责任。因此,仍然认为“最好的赋能是降低门槛,而不是让客户提高技术水平”。 最终,我们得出了一个服务模式的想法:构建企业级的软件生态。企业级软件生态的确切定义是:通过开放的方式,让企业本身以及不同的软件供应商共同参与,遵循相同的技术和数据规范,打造一体化、无需集成的各类企业级软件。如果要打造企业级软件生态,我们列出了六个要点(如下图1-5所示)。 图1-5 打造企业级软件生态需要具备的六大能力 我很幸运地有机会通过“企业级软件生态”的方式,为企业建立“一站式的商业支持平台”提供帮助。我们的Oinone平台结合了低代码开发、通用数据模型和业务产品的优势(如下图1-6所示)。 图1-6 Oinone = 低代码开发平台 + 通用数据模型 + 业务产品 我们对Oinone一站式低代码商业支撑平台展开介绍,它大致分为4部分: 以低代码开发平台为基础,输出具备互联网架构下的软件快速开发标准。这可以帮助企业快速构建符合互联网架构标准的应用程序,从而实现快速响应和低成本创新。 以通用数据模型为基础,满足不同软件基于同一套数据标准的扩展能力。这可以确保不同软件系统之间的数据兼容性和互操作性,避免数据孤岛和信息隔离。 在业务产品层面上,企业和伙伴基于相同的技术标准和数据标准共同提供解决方案。这可以帮助企业和伙伴共同开发出符合标准的商业支撑平台,以提高业务效率和创新能力。 最后是无代码设计器,用于满足项目开展中,超出业务标品范围之外的需求,或者针对标品的临时需求。这可以帮助业务人员在不需要专业软件支持的情况下,自主解决业务需求,并支持部门间的协同工作。 1.3.3 生态建设 Oinone致力于打造全球最大的无需集成的商业应用程序及其生态系统,通过开源内核、汇集数千名开发人员和业务专家,为企业提供成本效益、一体化、模块化的解决方案,解决所有商业需求,让不同技术之间的合作变得简单易行,摆脱烦恼的集成问题。 在客户和场景领域,我们严格限定了自身的专注领域。针对超大型头部企业,我们专注于树立标杆,而对于大、中、小型企业,则交由我们的伙伴来支持。小微企业可以通过我们的开源社区版获得覆盖。在企业数字化转型的核心领域中,我们的解决方案涵盖了数字化交易场景、全渠道订单履约场景、数字化采购场景、数字化营销等产品。在其他领域,我们完全交由伙伴来建设。由于我们自身在企业协同商务领域拥有深厚的背景,因此在该领域提供的产品拥有特别的优势。 企业数字化转型核心领域 图1-7 企业数字化转型核心领域

    2024年5月23日
    2.7K00

Leave a Reply

Please Login to Comment