自定义组件

1. 定义组件介绍

平台提供了大多数的通用组件,面对企业个性话需求、复杂的业务场景,我们也提供了自定义组件的能力,帮助企业更快实施业务需求。

自定义组件包含“组件画廊”“组件排序”“元件画廊”“元件属性设计”四个页面。

1.1 组件与元件

在介绍如何自定义组件前,需要先了解以下概念:

组件:页面设计的组件库中看到的是组件。每个组件都有自己的属性面板,通过属性、字段决定组件逻辑,而自定义组件就是需要构建出组件自身的属性信息,再结合业务配置组件的属性、使用组件。

一个组件在不同的业务类型、视图类型、单值/多值,其属性面板是不同的,不同业务类型、视图类型、单值/多值的组合我们成为元件,多种组合即为多个元件,所以一个组件包括多个元件。
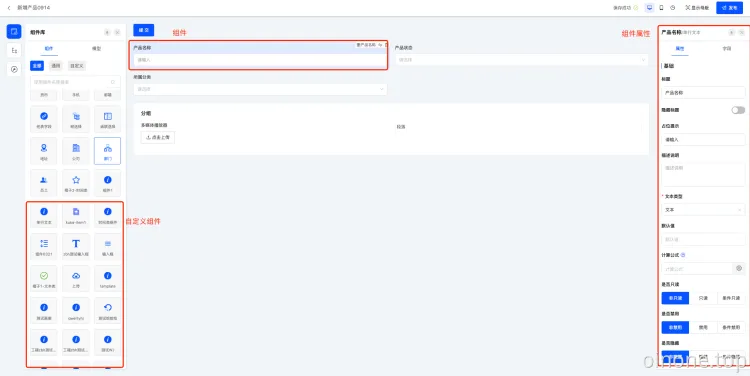
image.png

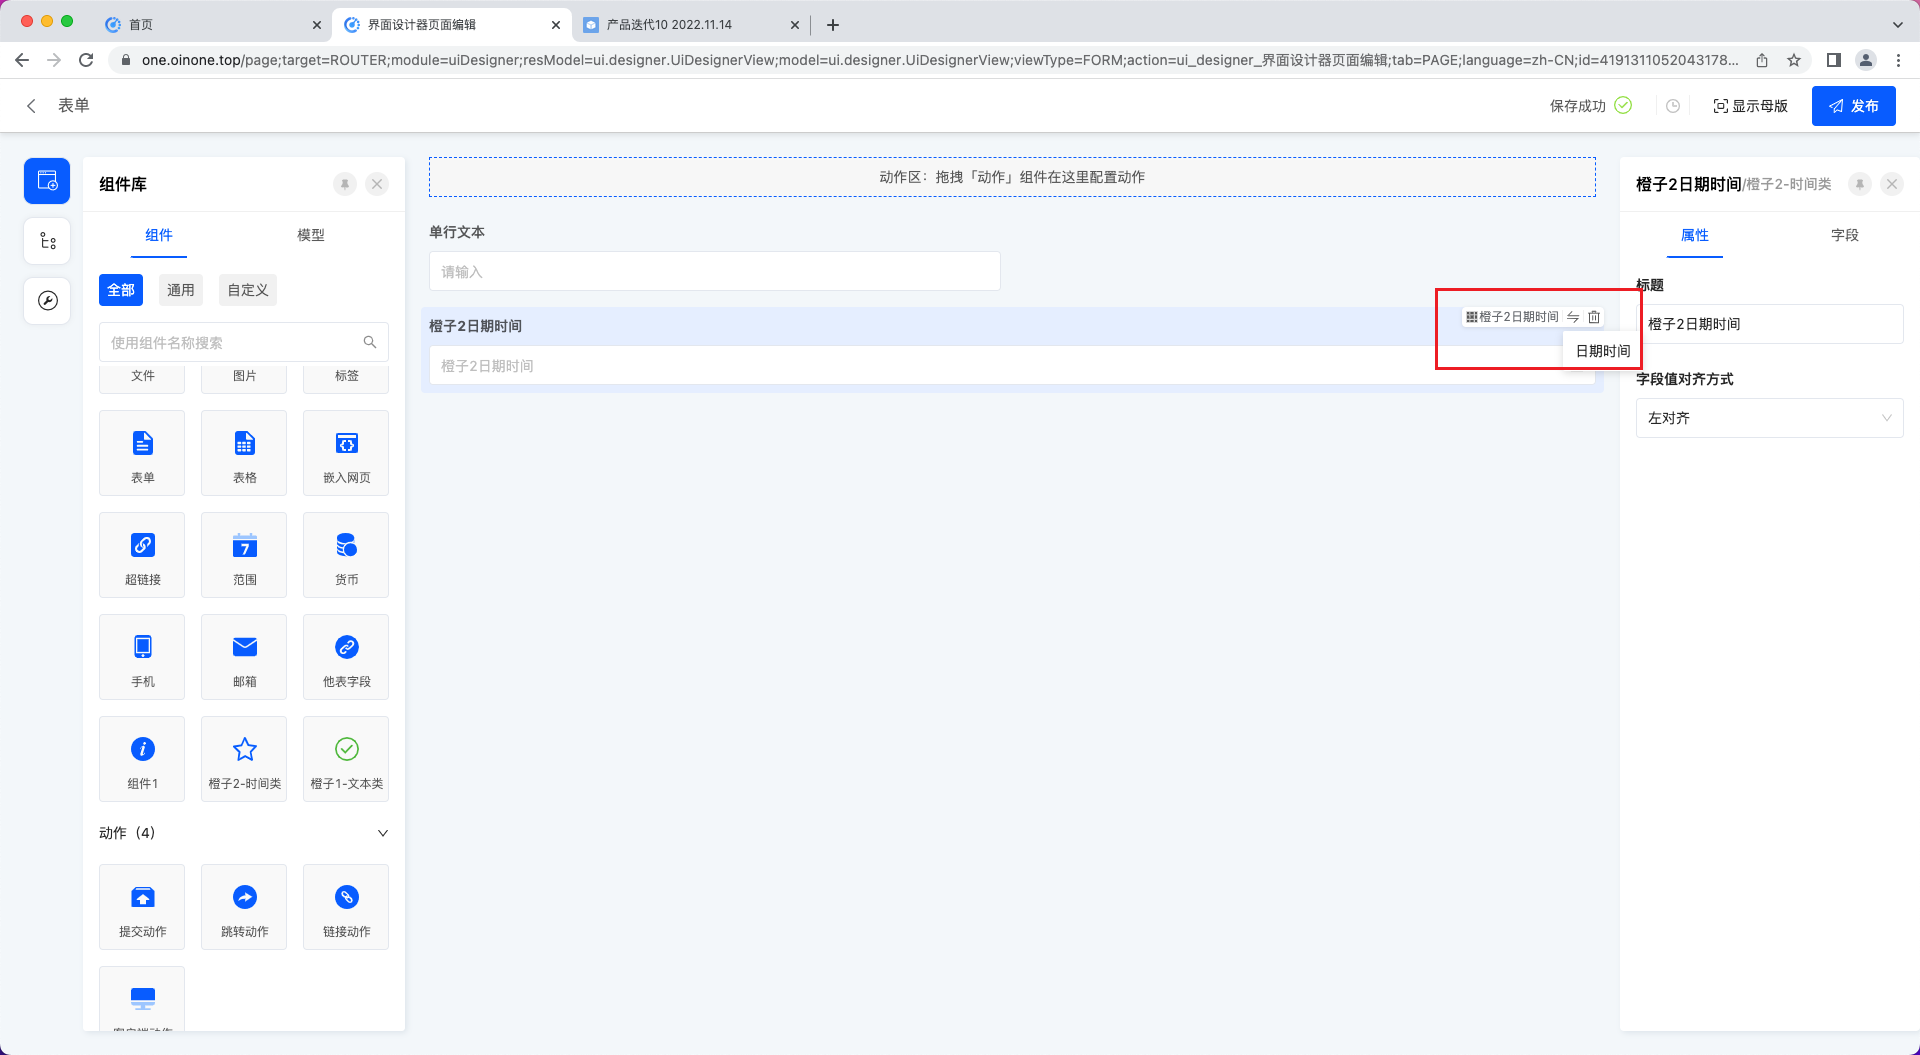
元件:一个组件可以对应多个元件。在创建时明确元件所适用的字段业务类型、单/多值、视图类型,在画布中切换元件时,会结合当前组件的字段业务类型、单/多值、所在视图类型确定可以使用哪一个元件。
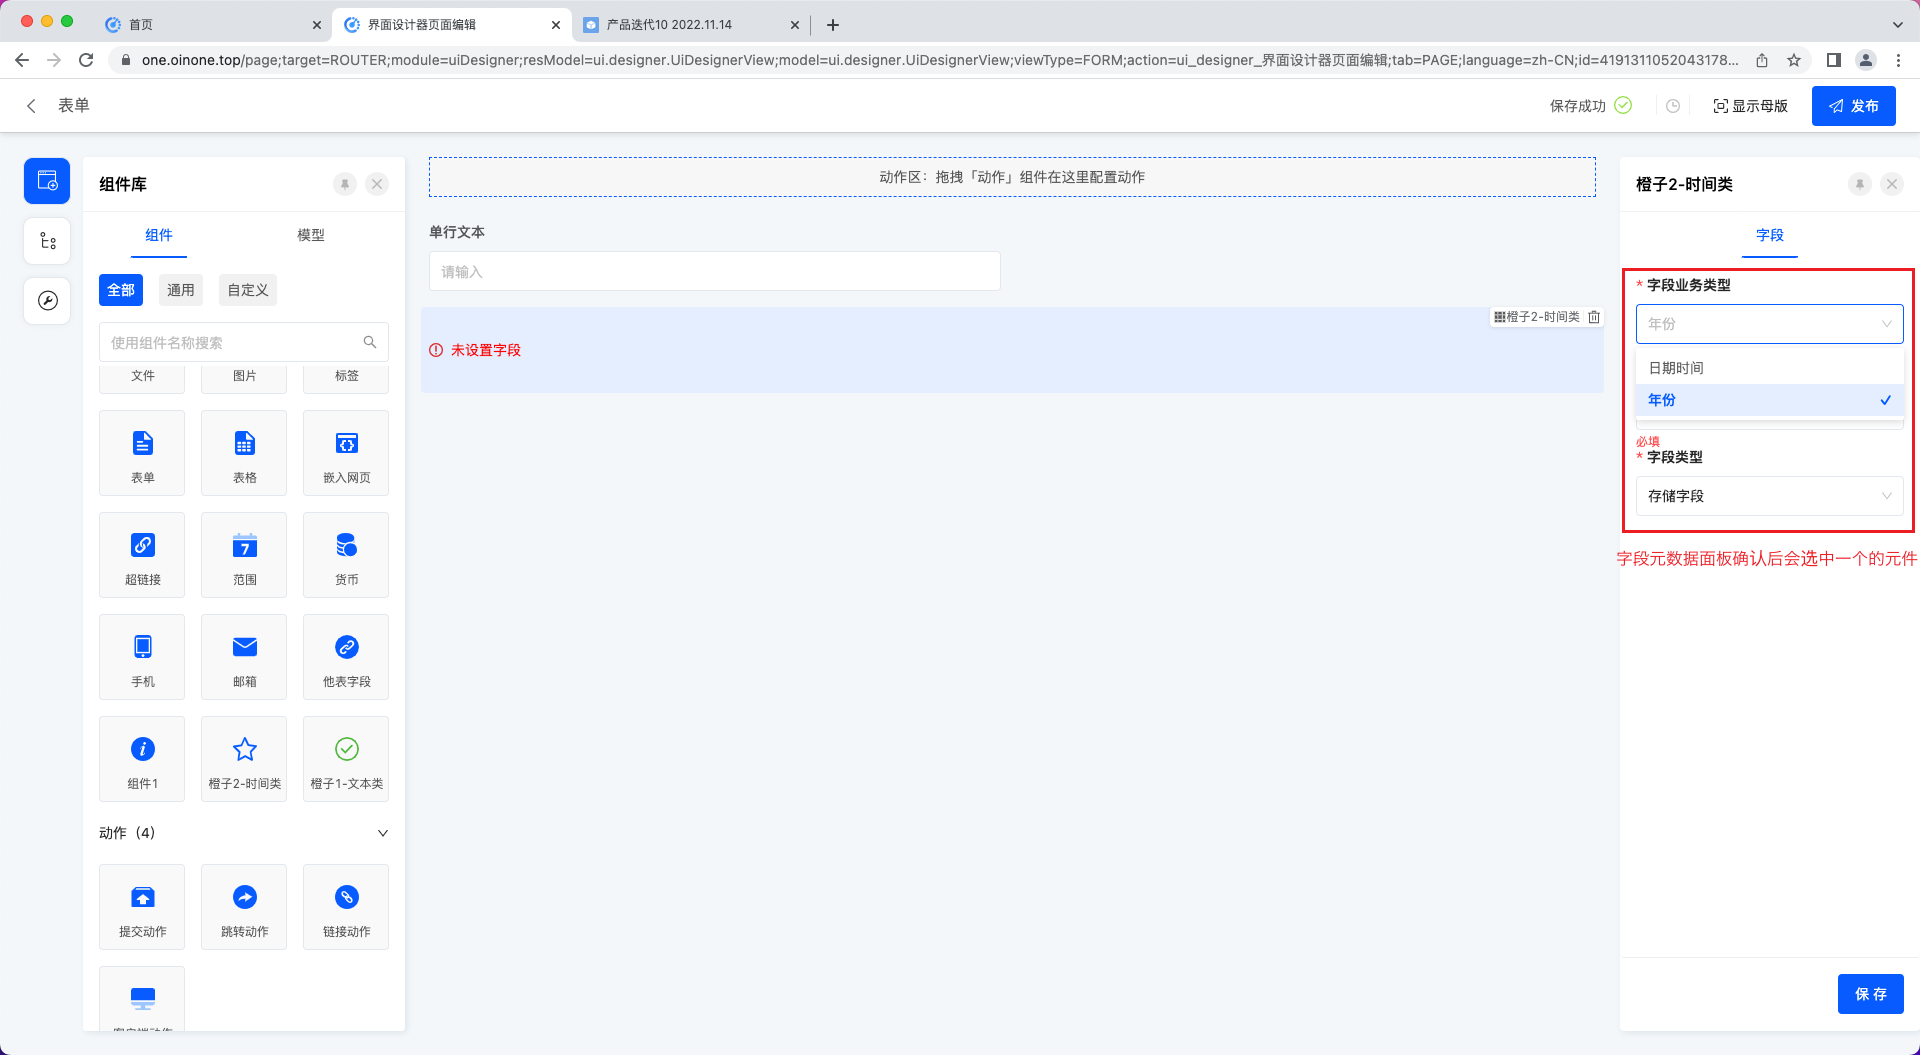
image.png

image.png此处切换的也是元件。

示例:创建一个“下拉选”的组件,其中可以包含“下拉单选”“下拉多选”两个元件。“下拉选”组件从组件库中拖入时,设置单值时使用“下拉单选”元件,设置多值时使用“下拉多选”元件。
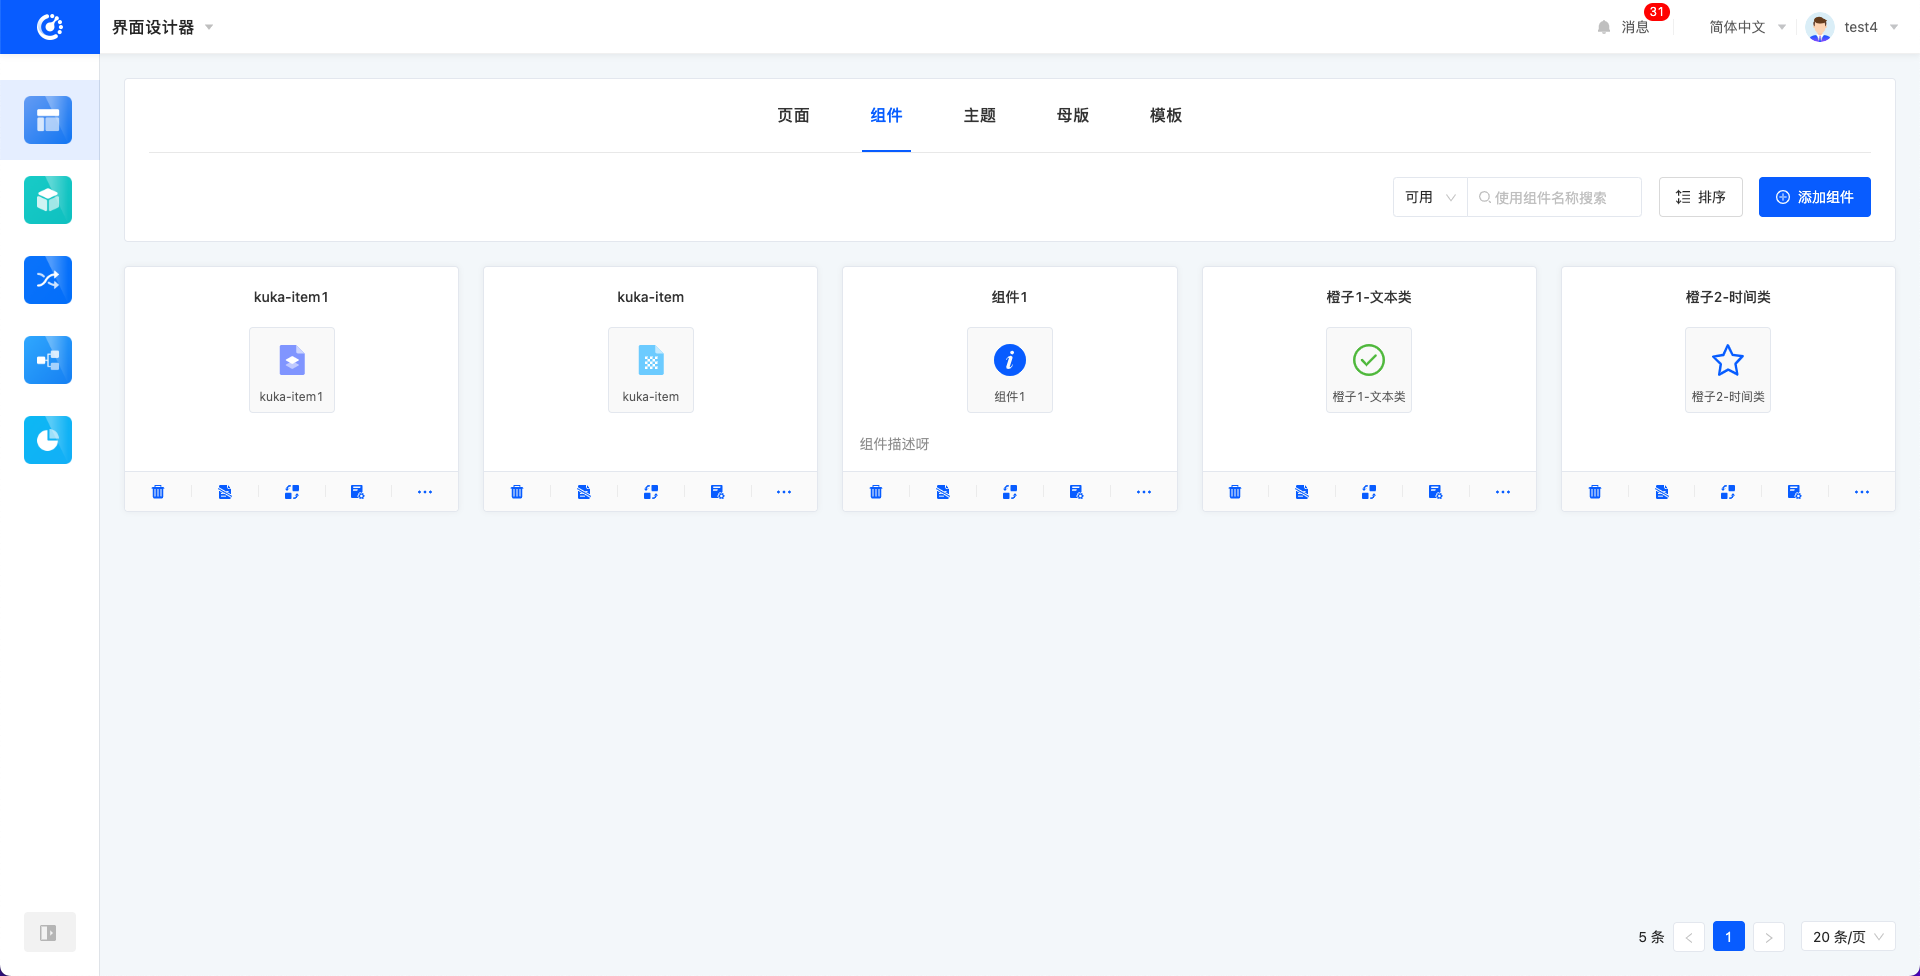
image.png

2. 组件管理

2.1 组件创建

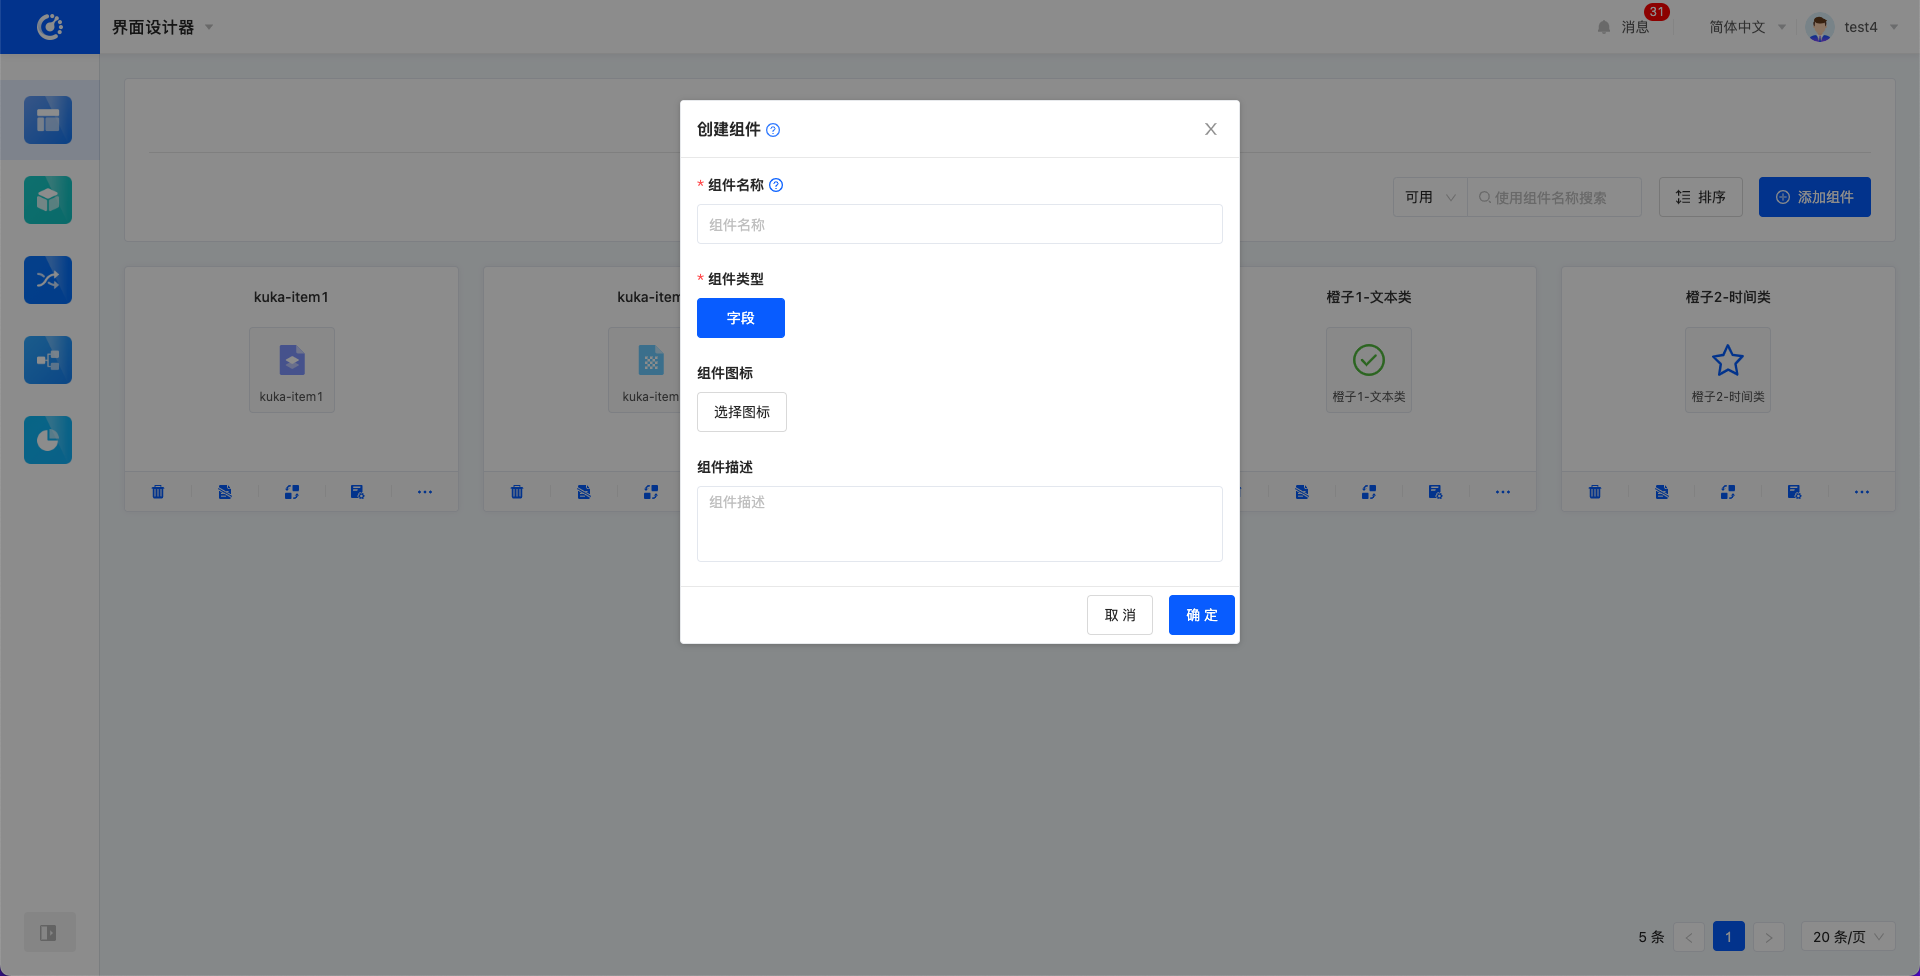
  • 在组件画廊页面,点击添加组件,在弹窗中完善信息创建组件。

image.png

2.2 组件操作

  • 自定义组件支持“搜索、删除、作废、查看引用关系、管理元件、编辑、低无一体、排序”的操作。
  • 搜索:默认搜索可见组件,可切换“全部、可用、废弃”搜索组件,也可使用组件名称搜索。
  • 删除:若组件未被引用,则可以直接删除。
  • 作废:组件作废后,不可在画布中展示,不可在组件切换时使用,但已使用的数据不影响。
  • 查看引用关系:可以查看存在引用关系的页面,支持点击跳转到对应页面的设计页面。仅当组件无引用关系时才支持删除。
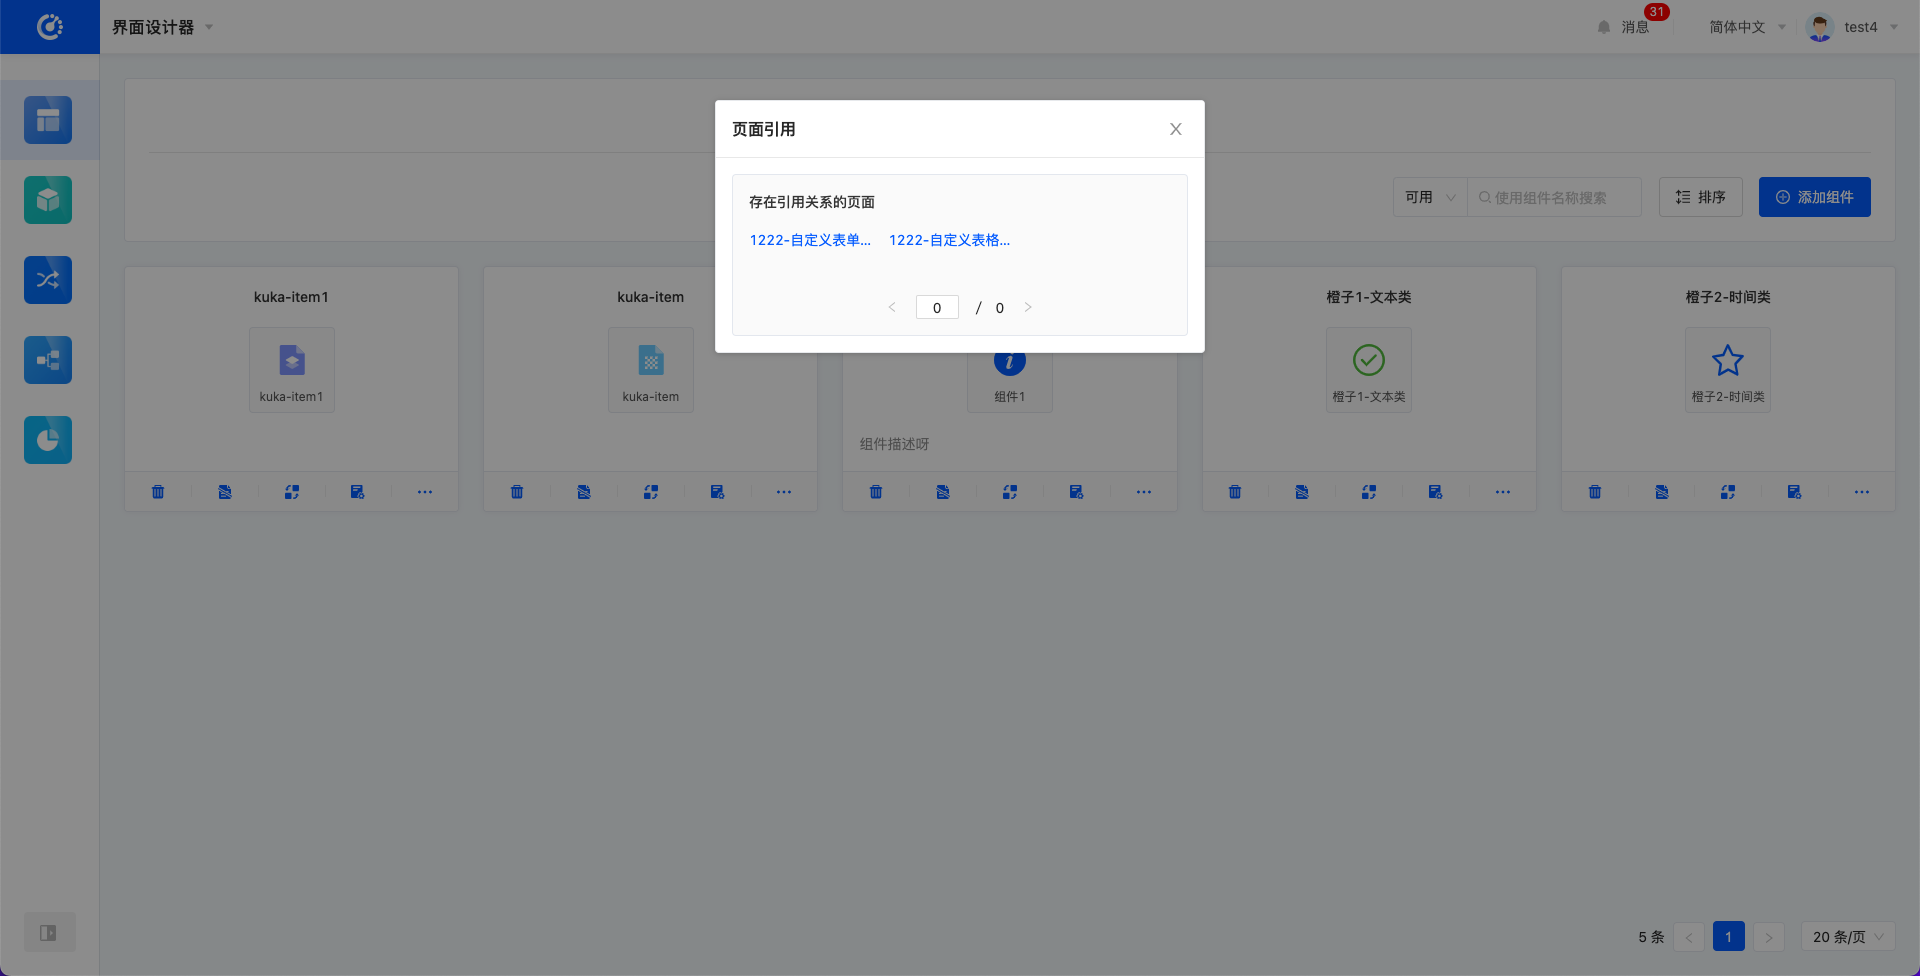
image.png

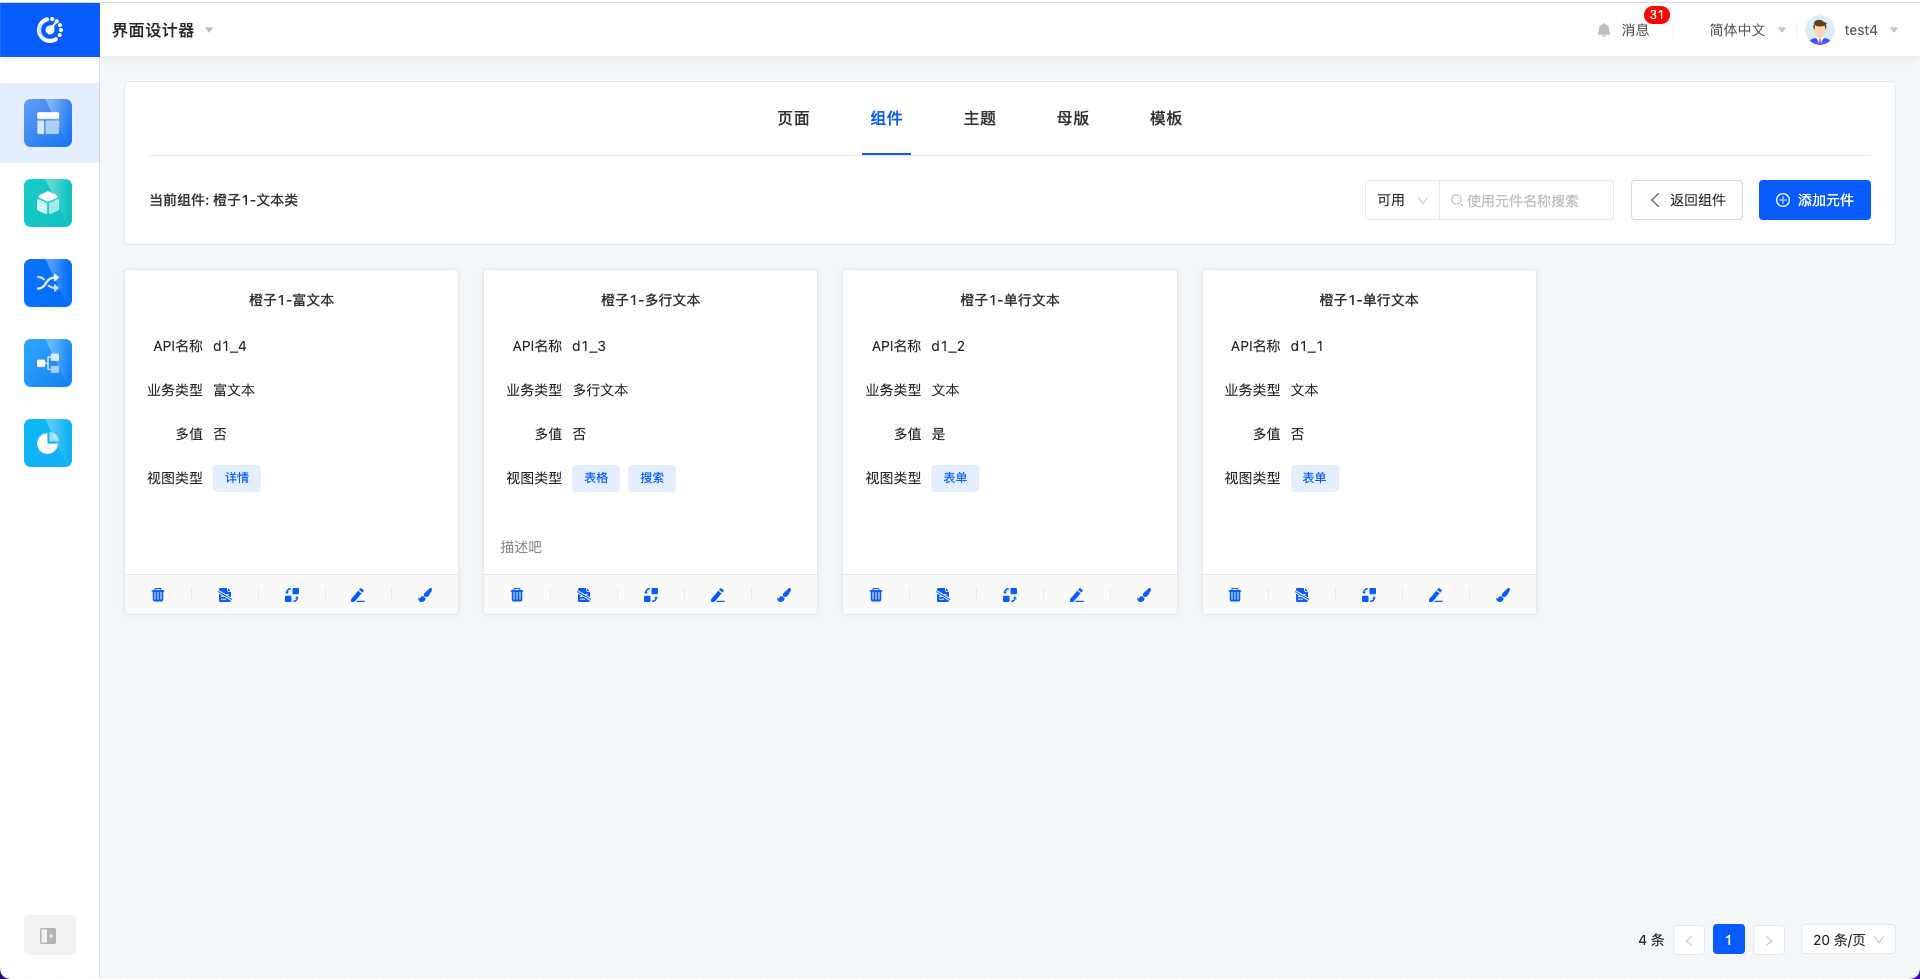
  • 管理元件:点击进入元件的管理页面。

image.png

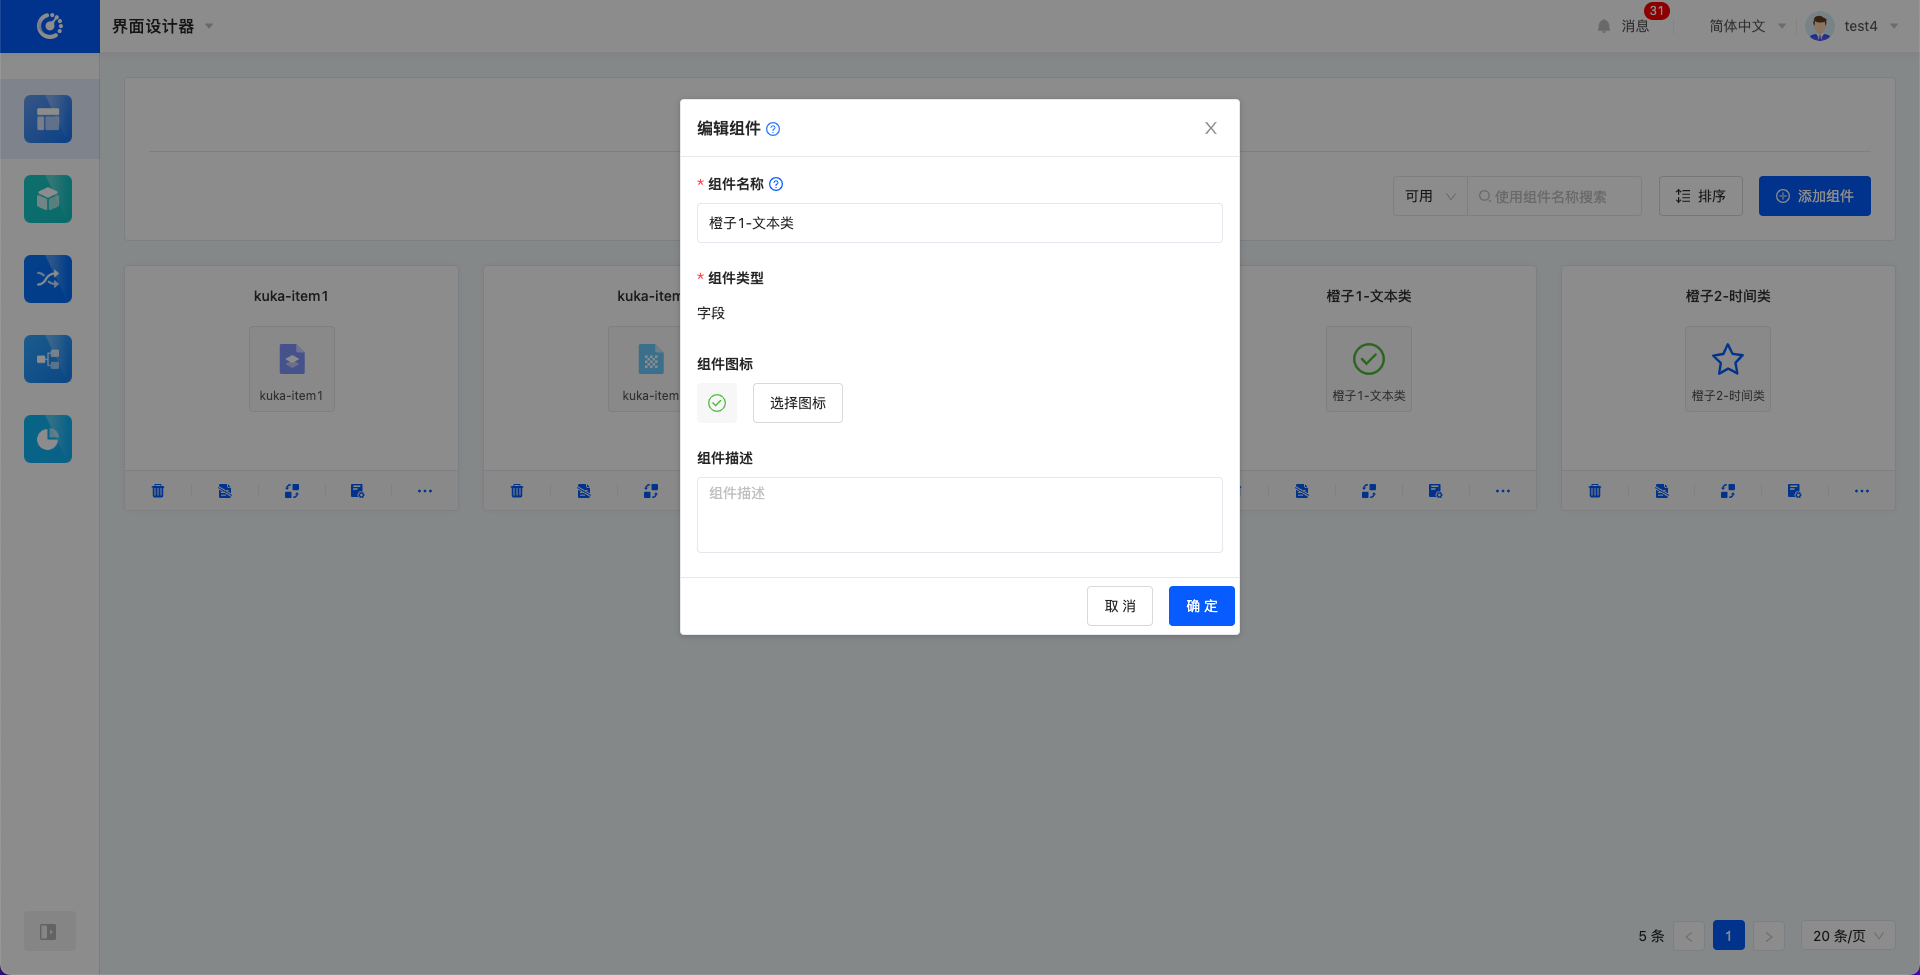
  • 编辑:可修改组件名称、组件图表、组件描述。

image.png

  • 低无一体:比较复杂,在第5章中单独讲解。
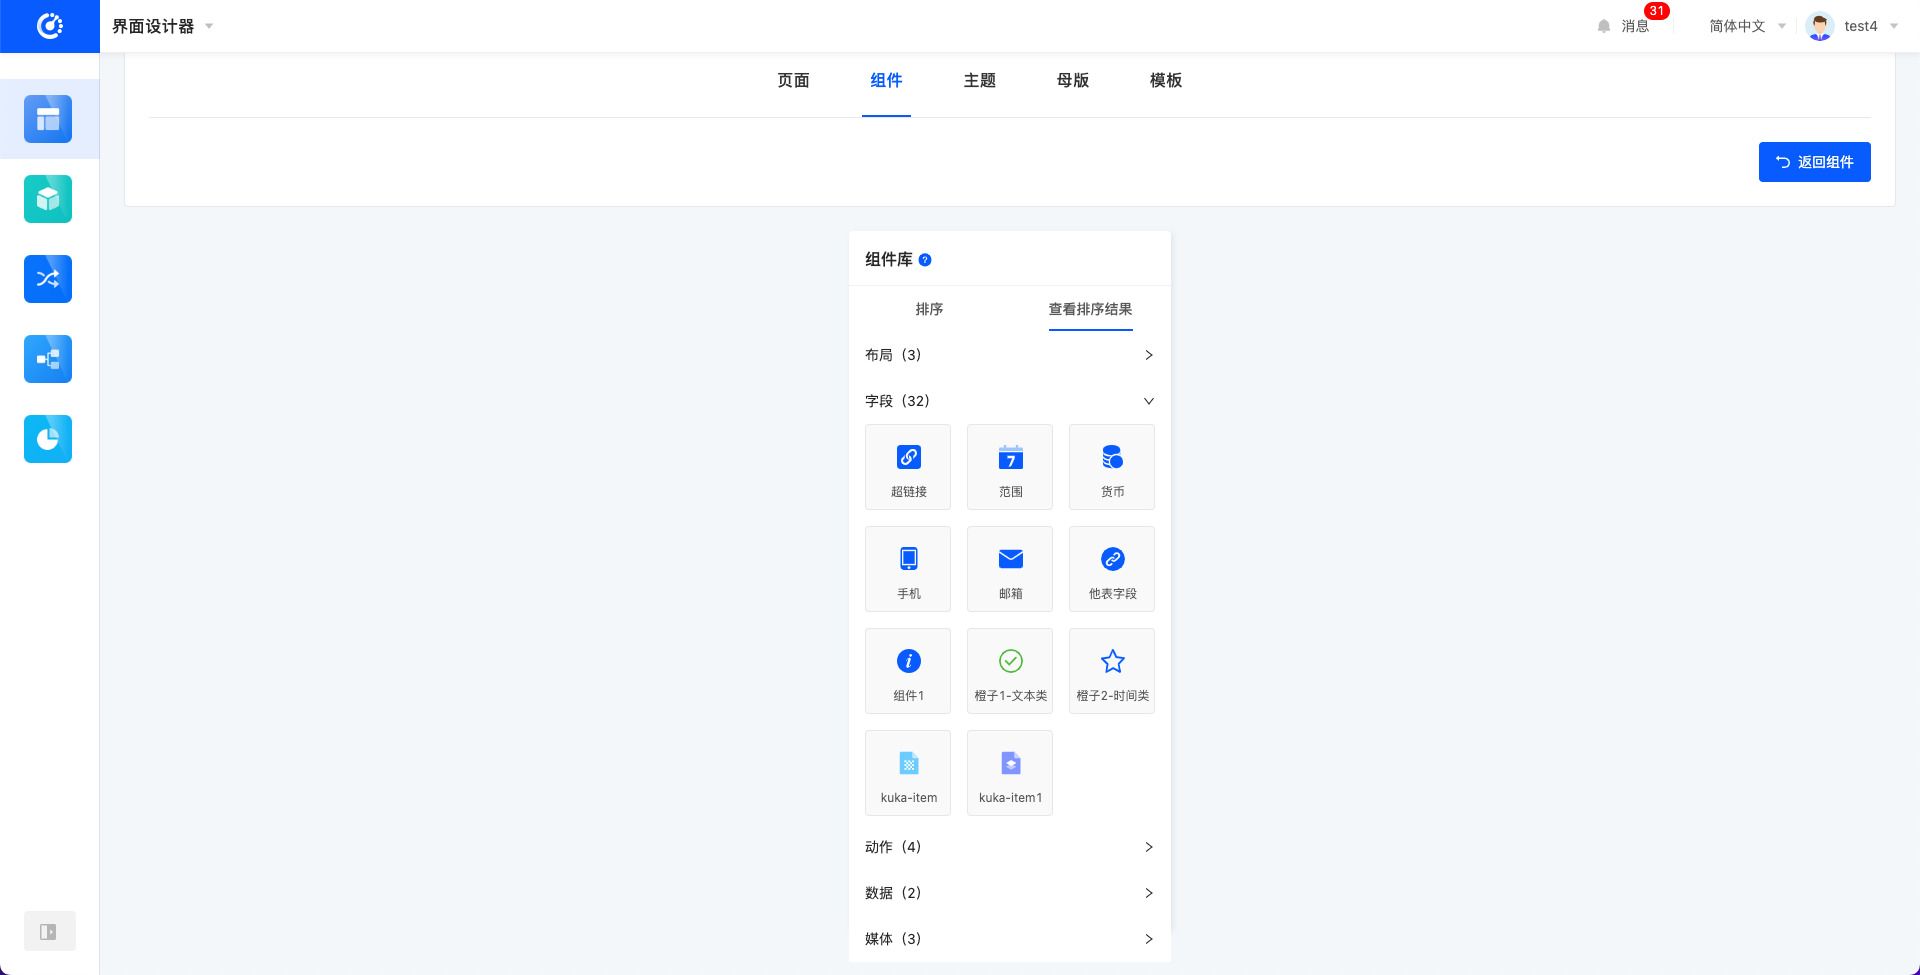
  • 排序:进入排序页,可拖动排序自定义组件。自定义组件会插在系统组件之后。可以点击“查看排序结果”选项页查看最终排序结果。排序同样会更新画布中的组件库顺序。
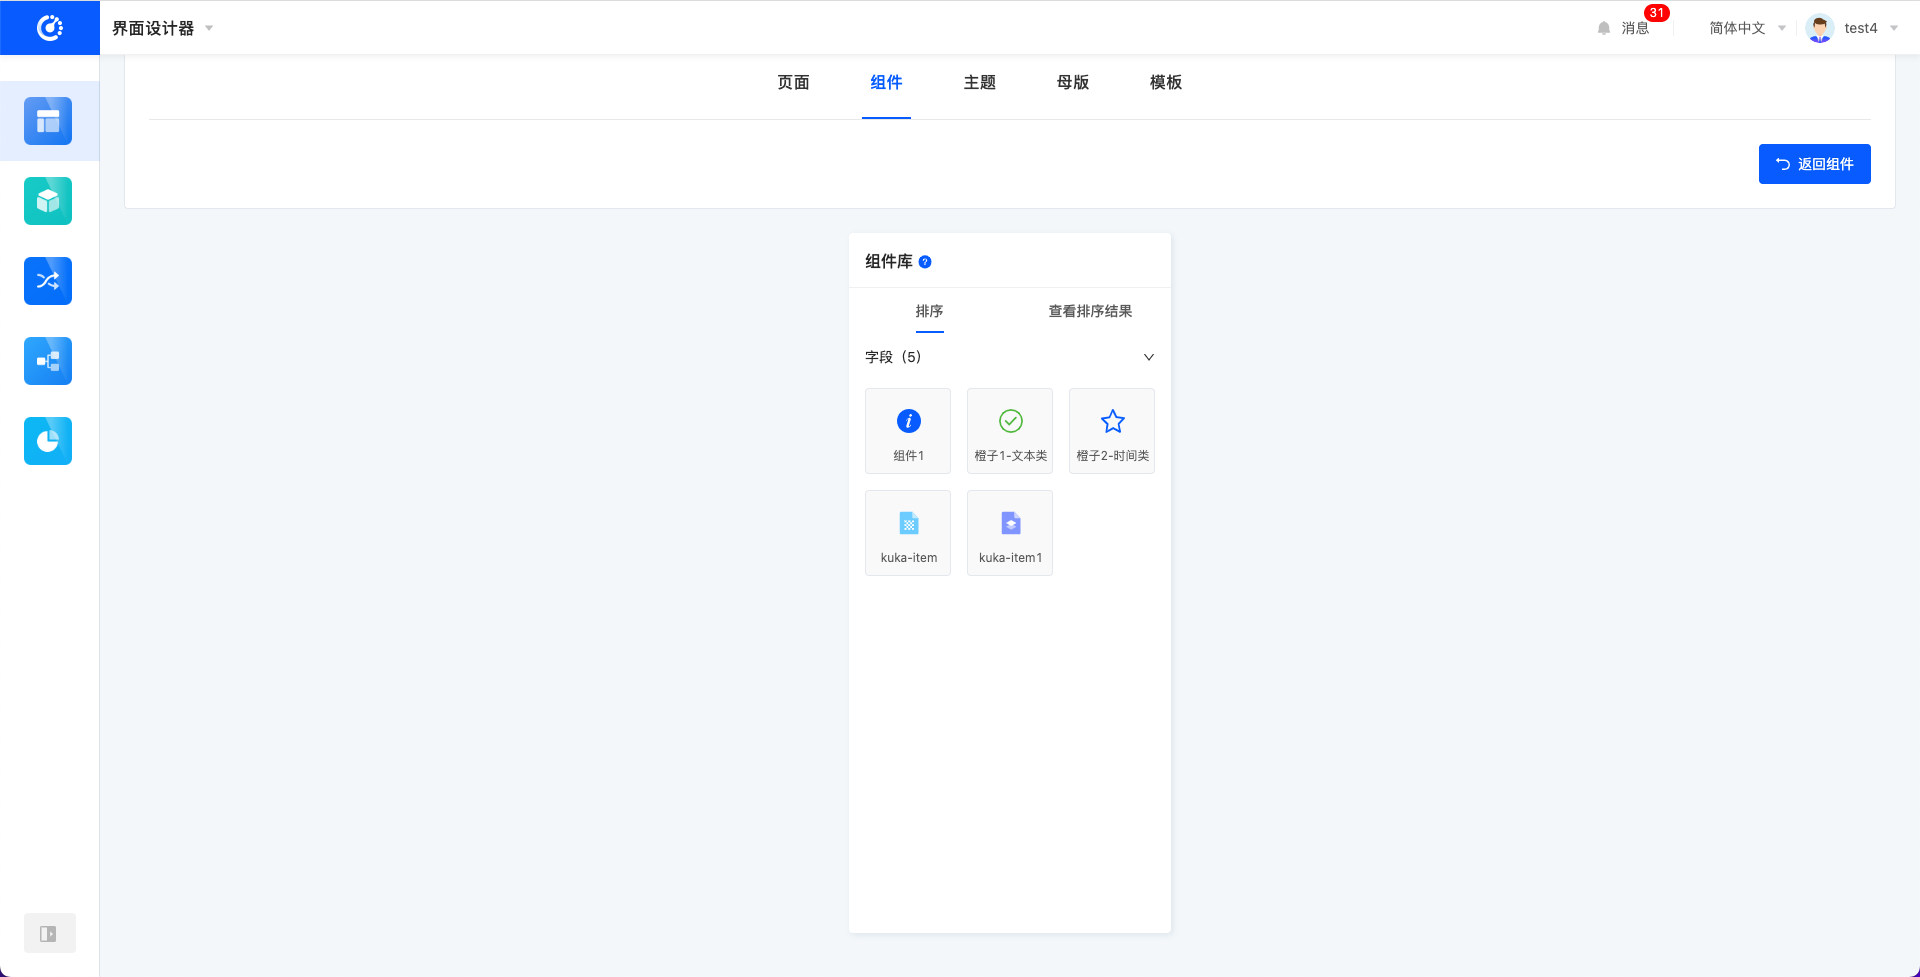
image.png

image.png

3. 元件管理

3.1 元件创建

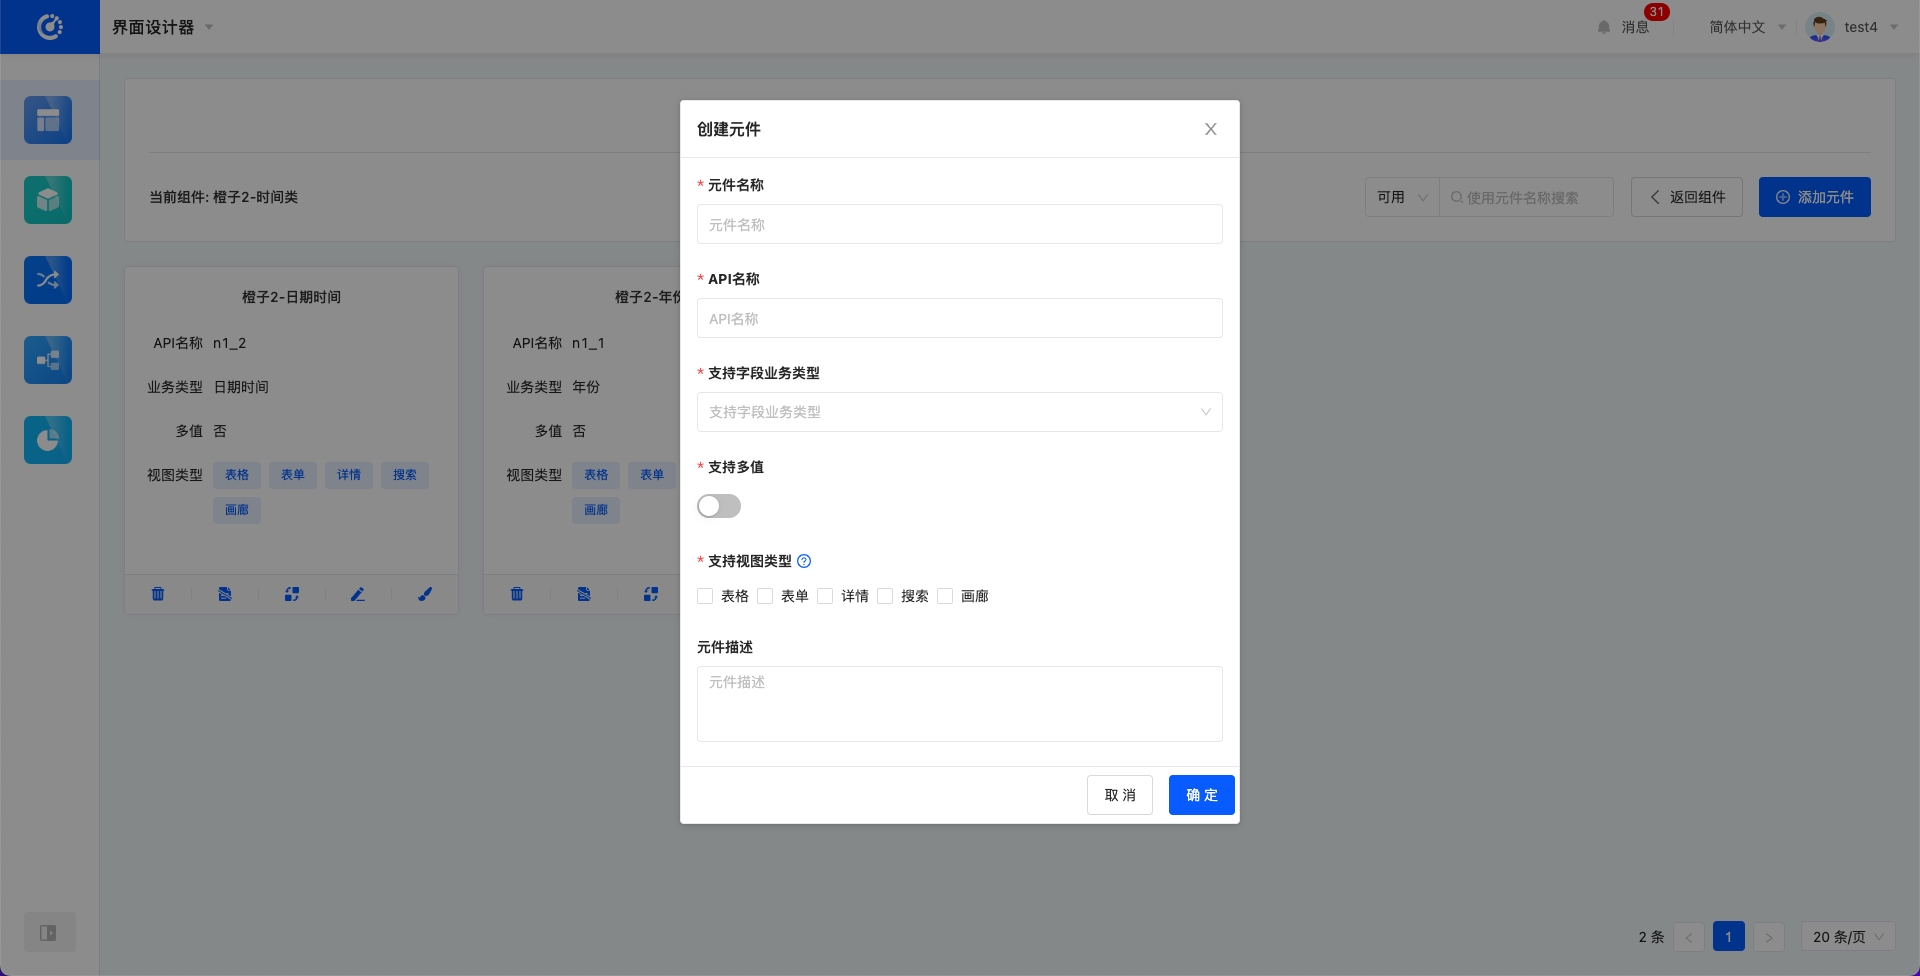
  • 在元件画廊页面,点击添加元件,在弹窗中完善信息创建一个元件。

image.png

3.2 元件操作

  • 元件支持“删除、作废、查看引用关系、编辑、设计元件属性”的操作。
  • 删除:若元件未被引用,则可以直接删除。
  • 作废:元件作废后,不影响原来已使用的元件,无法新添加、使用该元件。
  • 查看引用关系:可以查看存在引用关系的页面,支持点击跳转到对应页面的设计页面。仅当元件无引用关系时才支持删除。此处的引用关系数量会小于等于组件引用关系的数量。
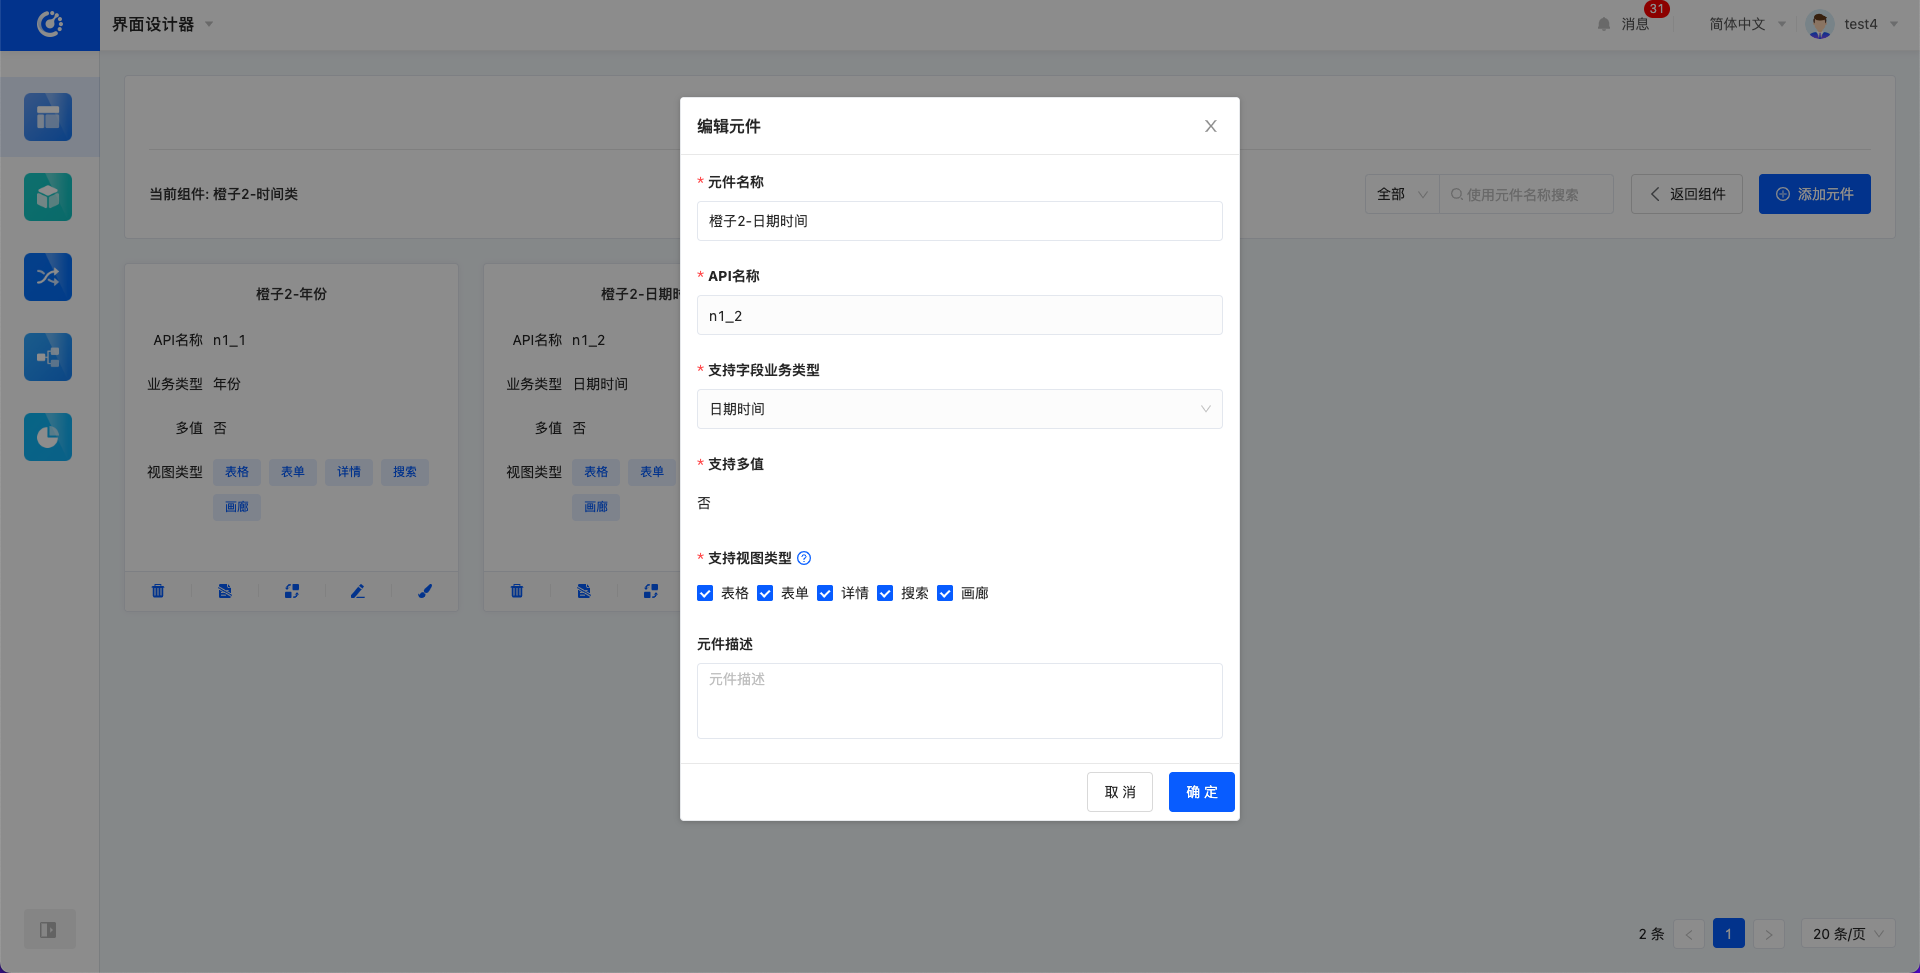
  • 编辑:可修改元件名称、支持视图类型、元件描述。

image.png

  • 设计元件属性:比较复杂,将在第4章中单独讲解。

4. 设计元件属性

  • 元件属性设计页面主要操作集中在这三部分,分别是①视图切换②属性面板设计区③复制功能
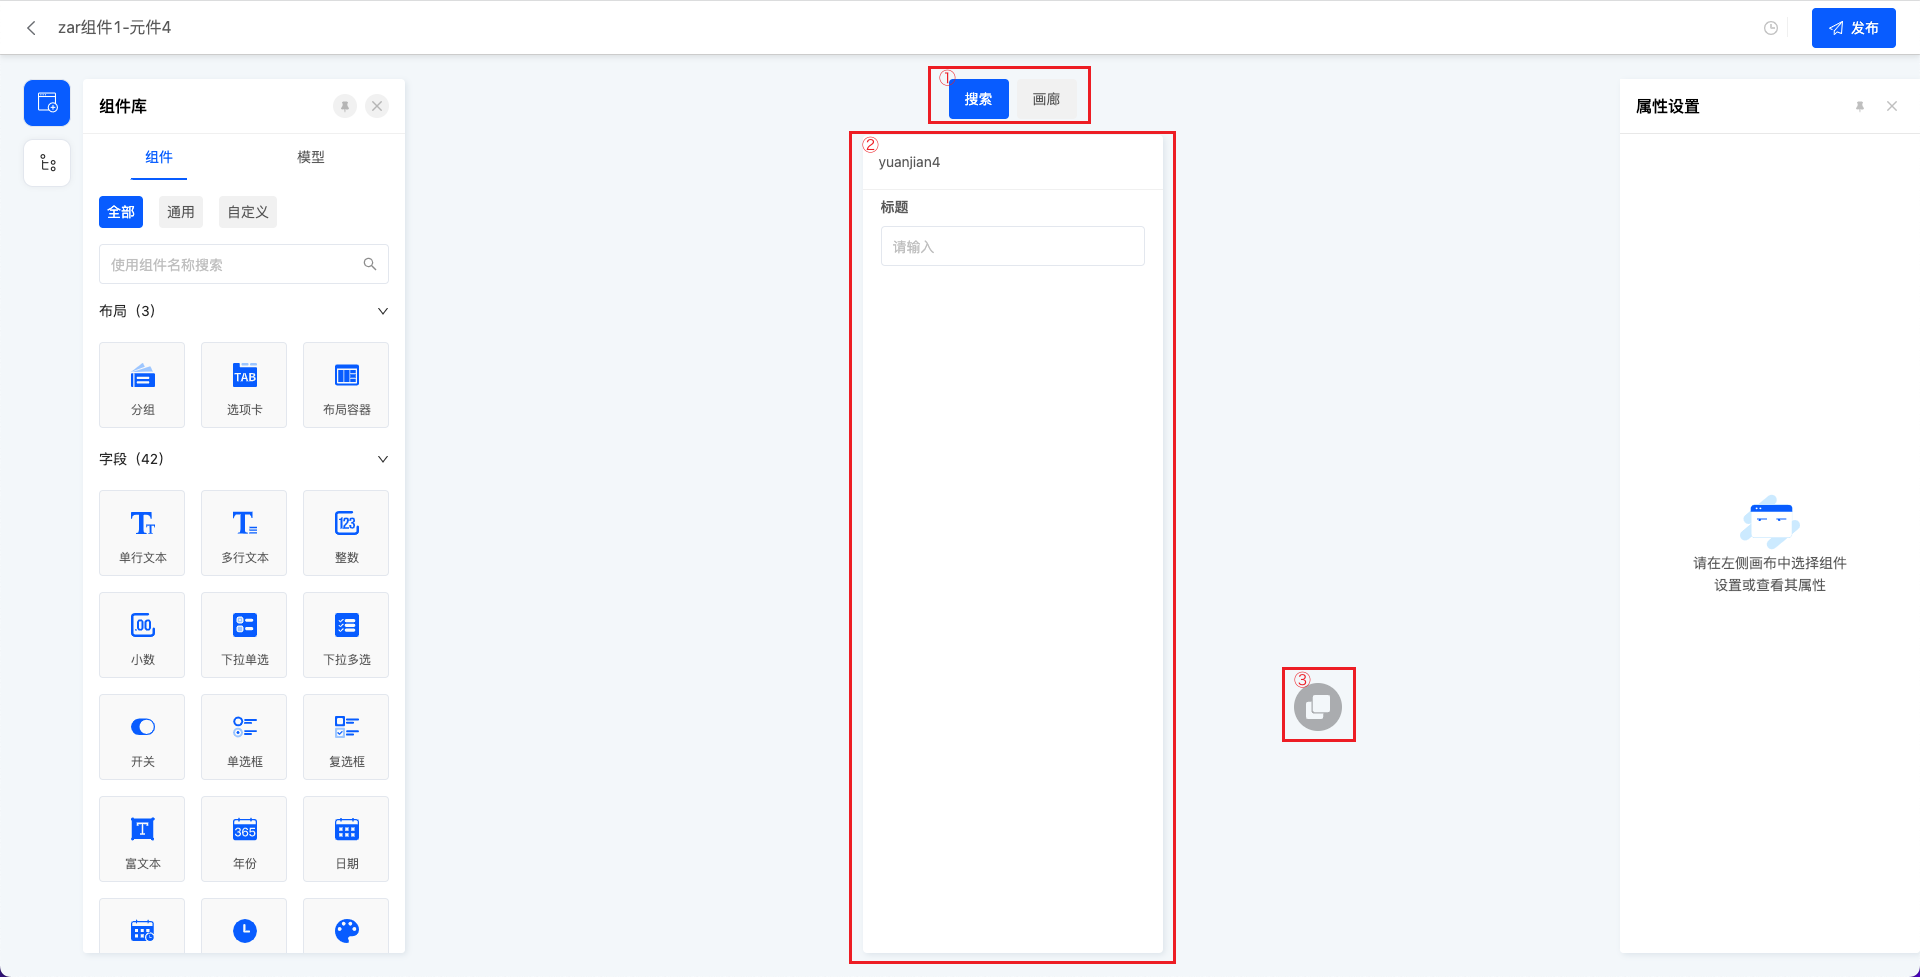
image.png

  • 视图切换:元件创建时选择的支持视图类型,在①区域平铺可切换对应视图的属性面板进行设计。
  • 属性面板设计区:可将组件拖入属性面板设计区进行设计,设计的是自定义组件的属性面板,左侧组件库和页面设计的组件库相同,仍然支持创建字段或使用模型字段,右侧进行元数据面板、属性面板设置。
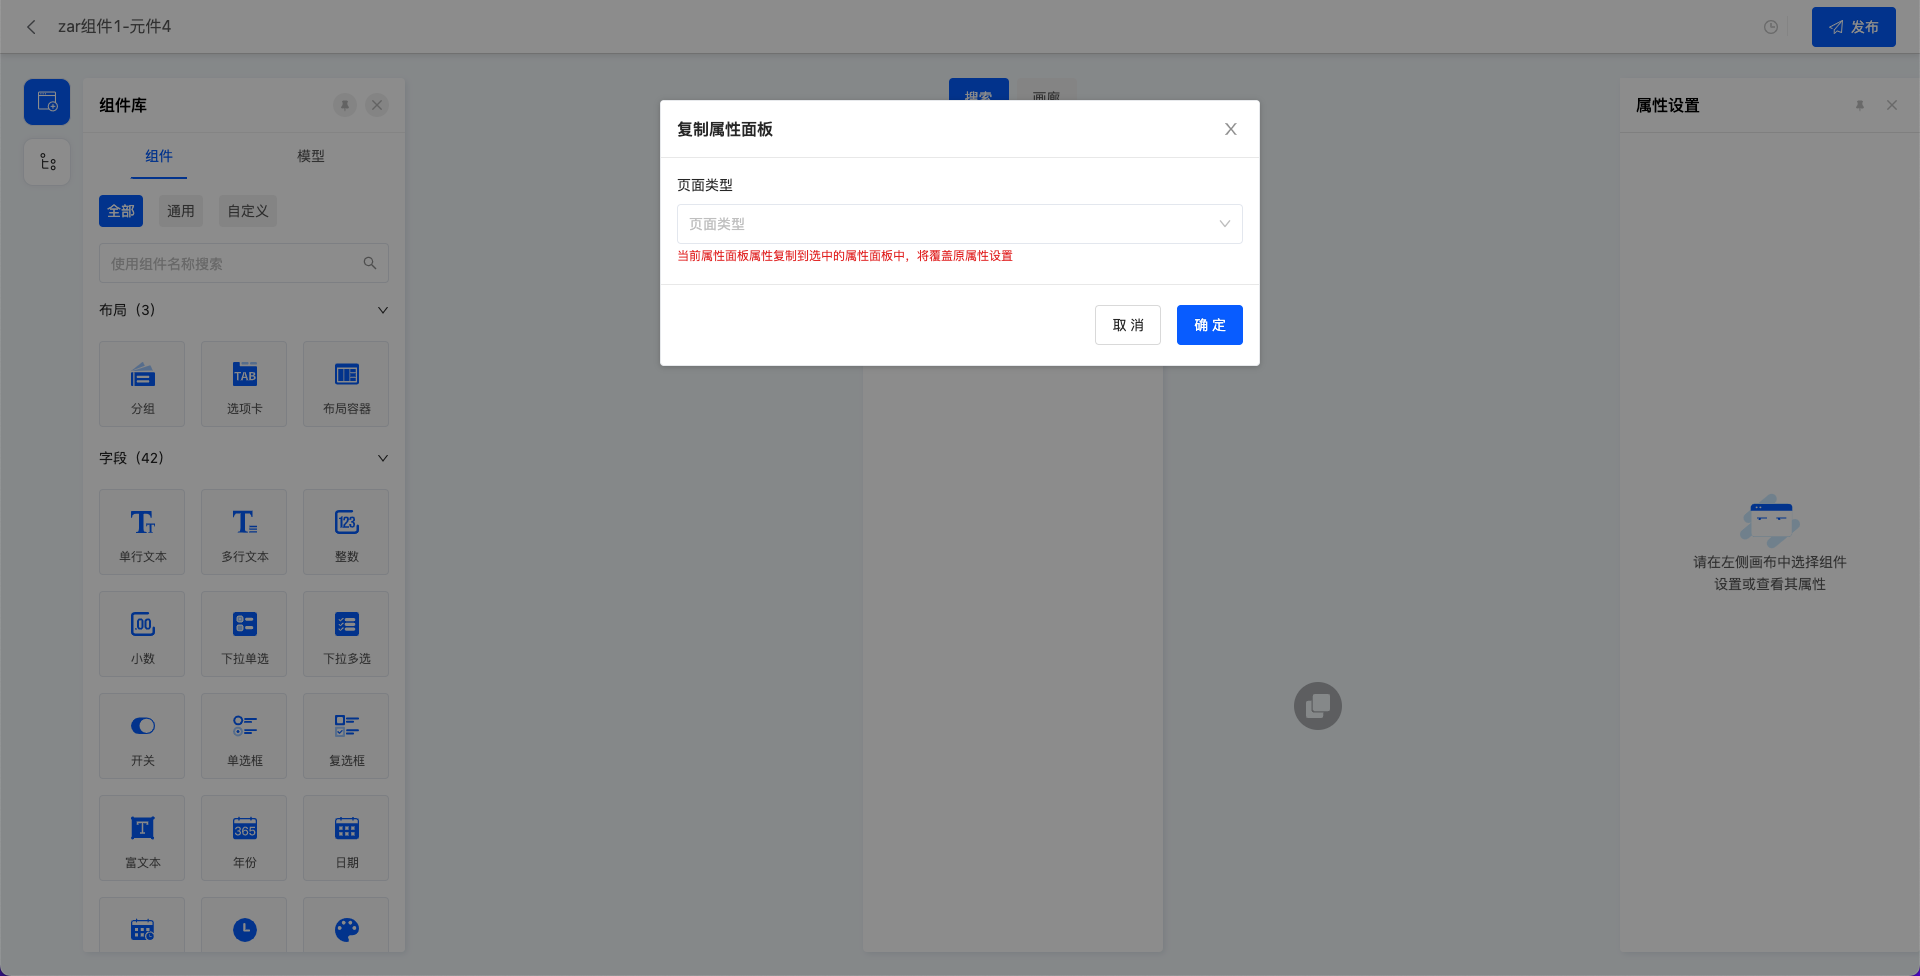
  • 复制功能:可将已设置好的属性面板复制到其他视图,提高设计效率。

image.png

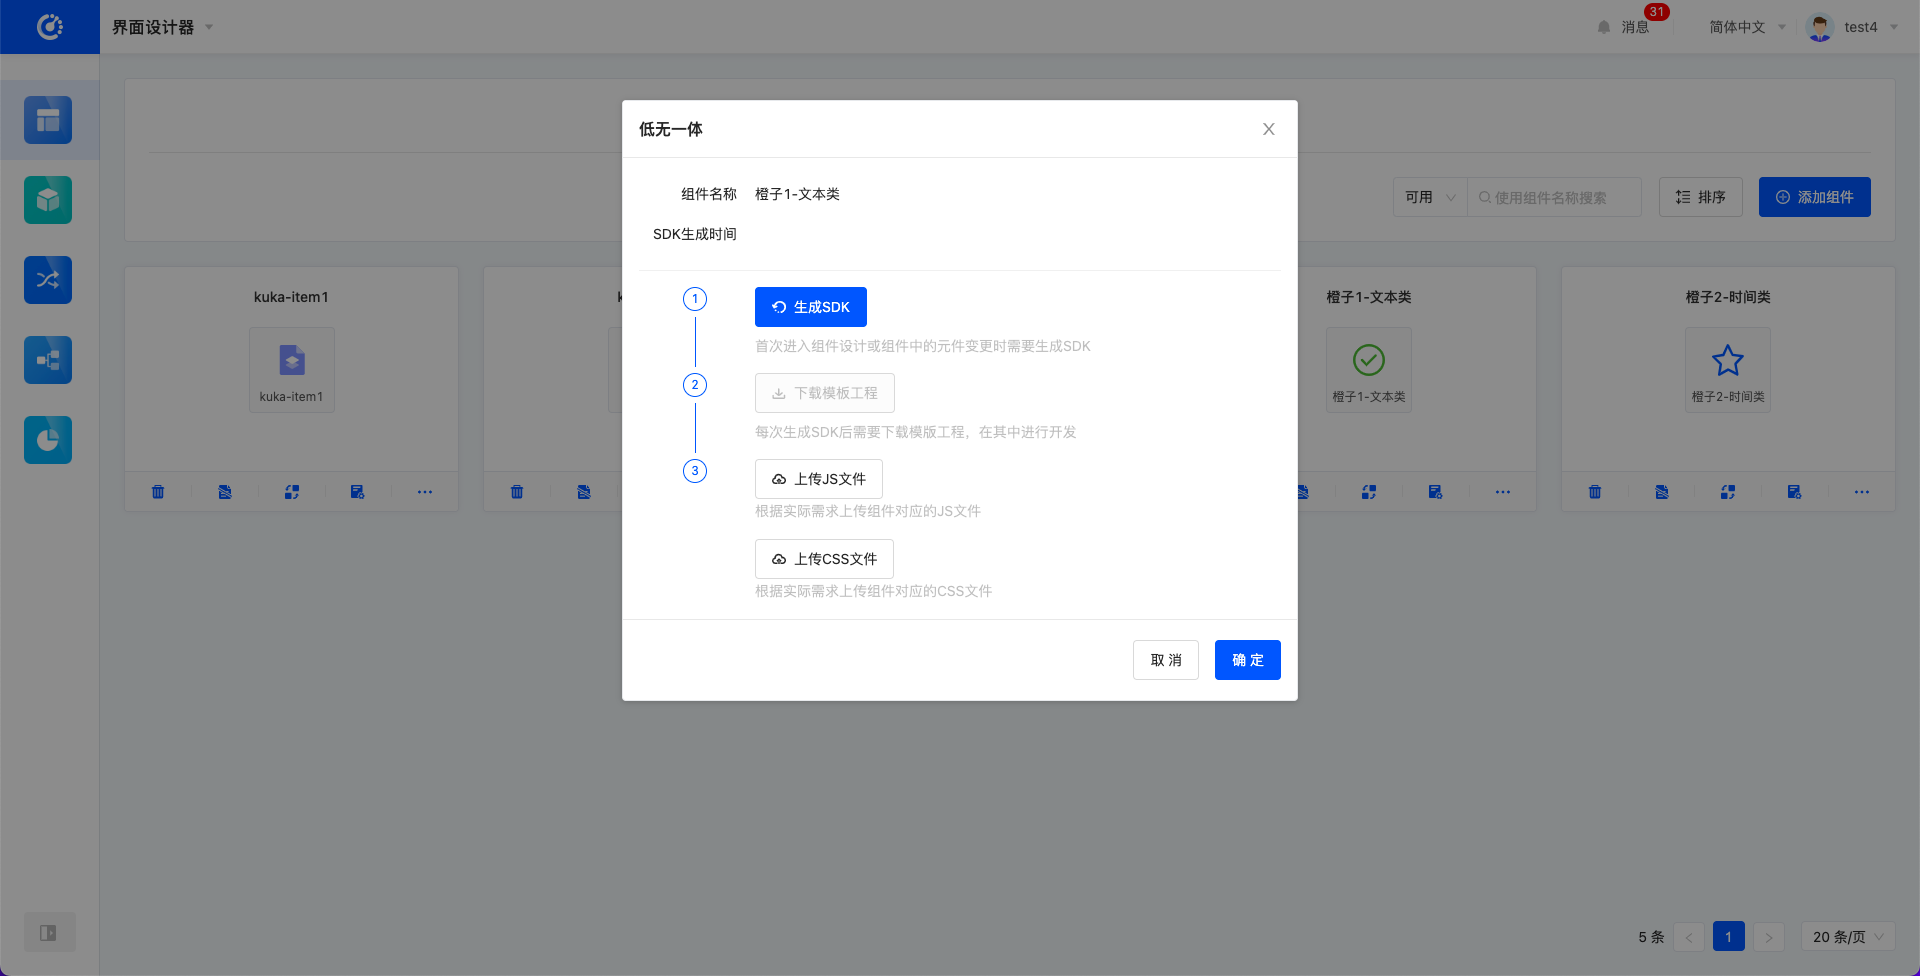
5. 低无一体

  • 低无一体简单讲就是组件代码上传,通过载入代码使组件在设计页面和实现页面可见和交互。
  • 系统内置的属性不满足需求时,要用低无一体写代码,定制属性,比如从模型中拖拽设计就是内置的属性,从组件库中设置,就要配合低无一体,否则无效。
  1. 首次进入组件设计或组件中的元件变更时需要生成SDK。

image.png

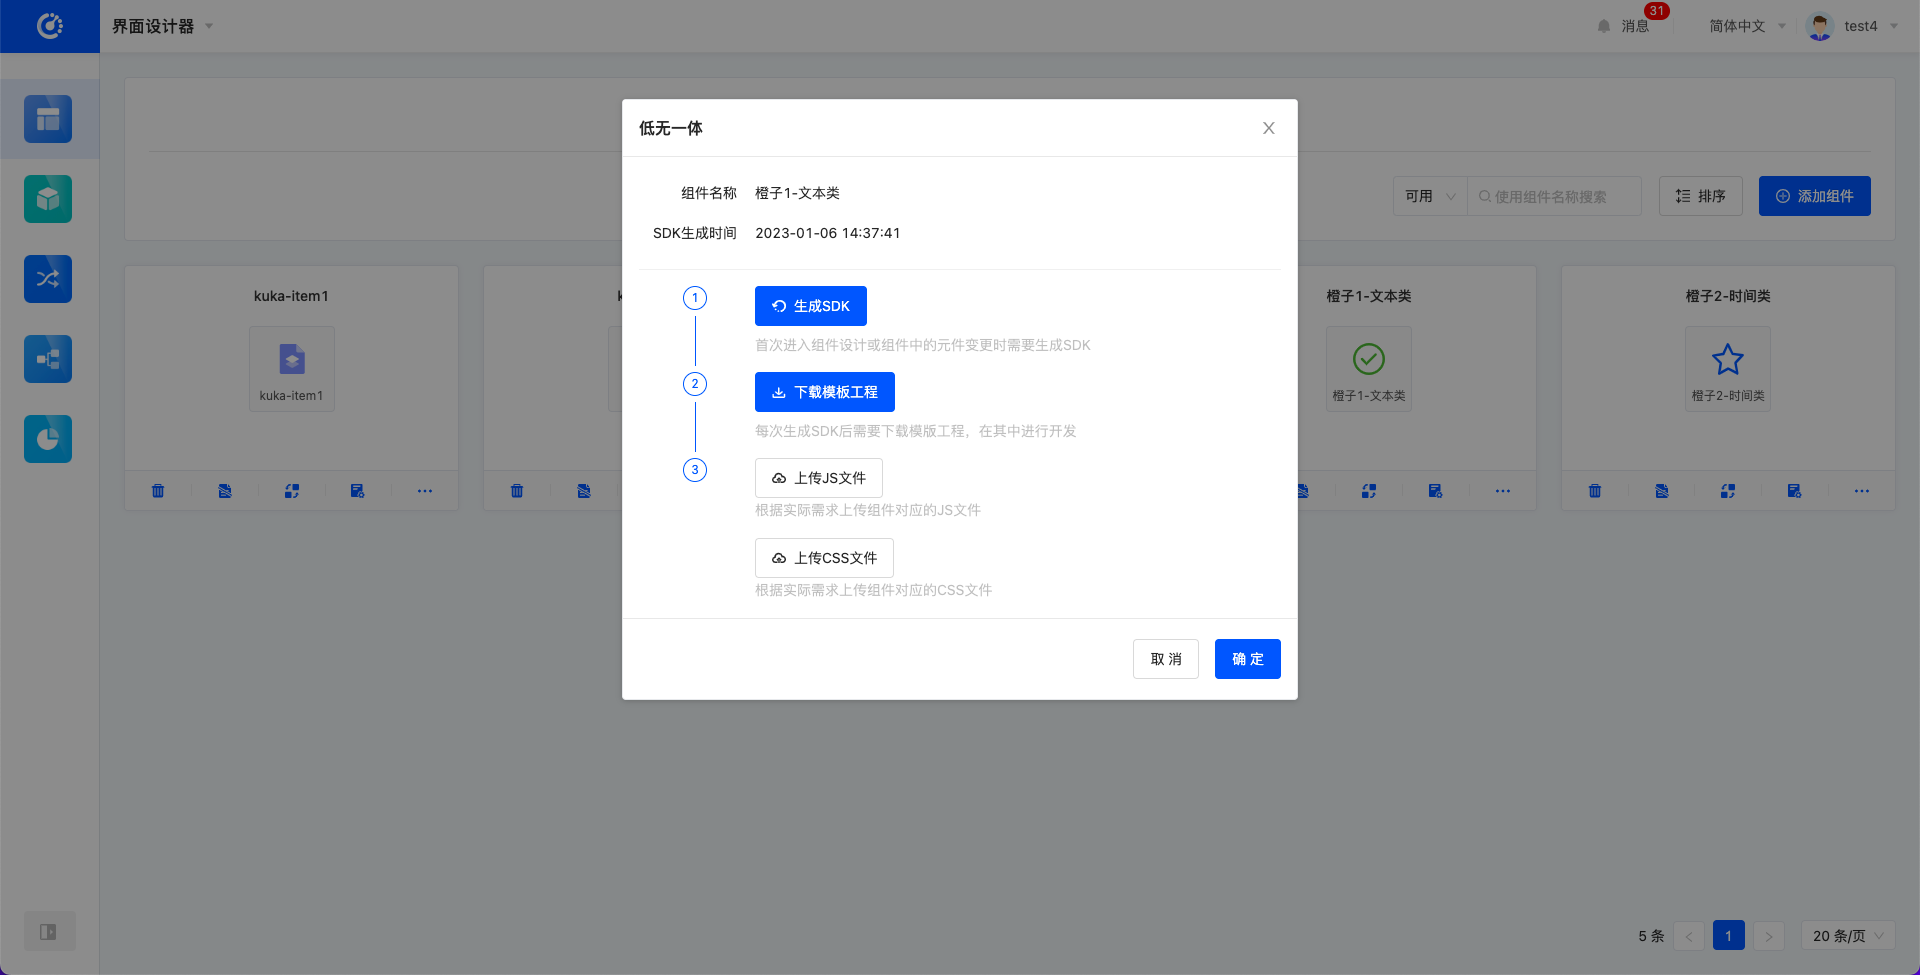
  1. 生成结束后展示SDK生成时间,并且“下载模版工程”按钮可用。

image.png

  1. 点击下载模版工程,会自动下载模板工程。

  2. 在模版工程中编写前端代码。

  3. 根据实际需求上传JS、CSS文件后提交即可。

Oinone社区 作者:史, 昂原创文章,如若转载,请注明出处:https://doc.oinone.top/oio4/9409.html

访问Oinone官网:https://www.oinone.top获取数式Oinone低代码应用平台体验

Like (0)
史, 昂's avatar史, 昂数式管理员
Previous 2024年6月20日 am9:49
Next 2024年6月20日

相关推荐

  • 4.1.2 模块之启动指令

    针对不同启动指令的组合可以满足不同场景需求,下面列举了几个常规组合方式,小伙伴们务必把这几种模式都尝试一遍,会更有体感 本节为小伙伴讲解oinone模块的几种启动方式,它是为能灵活地应对企业市场的不同场景需求,为op(本地化部署)、saas和研发提供个性化支撑。也为oinone独特性之单体与分布式的灵活切换提供基础支撑 一、部署参数 参数 名称 默认值 说明 -Plifecycle 生命周期部署指令 RELOAD 可选项:无/INSTALL/PACKAGE/RELOAD/DDL安装-install为AUTO;upgrade为FORCE打包-install为AUTO;upgrade为FORCE;profile为PACKAGE重启-install、upgrade、profile为READONLY打印变更DDL-install为AUTO;upgrade为FORCE;profile为DDL 表4-1-2-1 部署参数 如果在启动命令中配置了部署参数,可不再设置服务参数和可选项参数。下图为在启动命令中添加部署参数的示例。 图4-1-2-1 在启动命令中添加部署参数的示例 二、使用场景 针对不同启动指令的组合可以满足不同场景需求,下面列举了几个常规组合方式,小伙伴们务必把这几种模式都尝试一遍,会更有体感。 场景一:DDL(1)+RELOAD(N)应对专有DBA 因为很多公司数据库是由专门的DBA来管理的,不允许应用直接变更数据库相关配置、表结构、初始化数据。而oinone是基于元数据驱动的,任何模型、行为的变化都会自动转化成对物理存储的改变与元数据变化。 oinone为了适用企业op场景,特别增加了DDL模式。把发布上线分为两个步骤。 一:用DDL模式把涉及到数据库的变更与元数据初始化的脚本进行输出,交由客户公司DBA审批,并执行 二:用RELOAD模式,进行正常的应用重启工作,不进行安装、升级、以及数据库物理变革等操作。 #应用启动关闭自动DDL配置 pamirs.boot.profile: CUSTOMIZE pamirs.boot.options.rebuildTable: false pamirs.persistence.global.auto-create-database: false pamirs.persistence.global.auto-create-table: false 图4-1-2-2 应用启动关闭自动DDL模式 场景二:PACKAGE(1)+RELOAD(N)应对提升多机器实例效率 在机器规模相对大的场景中我们会碰到以下问题: 元数据差量计算、数据库变更、元数据变化保存都非常费时,如果每台机器都来一遍是非常费时费力的 分布式下多机器如果并发进行INSTALL,会导致数据库修改表结构、元数据变化保存锁死 所以我们可以选择一台机器用PACKAGE,其他机器采用RELOAD模式,做到合理规避问题,提升应用发布效率 场景三:INSTALL应对开发模式 研发在本地开发模式下INSTALL是最有效率的,把所需依赖模块一把启动和调试。 上线如果要用INSTALL需要注意,要逐台进行。当然也可以改进成INSTALL(1)+RELOAD(N)模式 三、启动命令解读 查看启动命令 可以在启动日志中查看当前所用启动命令。 图4-1-2-3 在启动日志中查看当前所用启动命令 生命周期管理-Plifecycle 除了通过启动YAML中pamirs.boot属性来设置启动参数,你还可以在应用启动命令中使用-Plifecycle参数来快捷控制模块生命周期的管理方式。该参数的可选项为RELOAD、INSTALL、CUSTOM_INSTALL、PACKAGE、DDL。 java -jar <your jar name>.jar -Plifecycle=RELOAD 启动命令优先级高于YAML中pamirs.boot属性中的install、upgrade和profile属性。如果不使用-Plifecycle参数,则使用YAML中pamirs.boot属性中的install、upgrade和profile属性配置。若YAML中未配置,则采用默认值。 启动配置项 默认值 RELOAD INSTALL CUSTOM_INSTALL PACKAGE DDL install AUTO READONLY AUTO AUTO AUTO AUTO upgrade AUTO READONLY FORCE FORCE FORCE FORCE profile CUSTOMIZE READONLY AUTO CUSTOMIZE PACKAGE DDL 表4-1-2-2 Plifecycle可选项与启动项对应表 profile属性请参考4.1.1【服务启动可选项】一文。只有pamirs.boot.profile=CUSTOMIZE时,在pamirs.boot.options中自定义的可选项才生效。 自动建表-PbuildTable java -jar <your jar name>.jar -PbuildTable=NEVER PbuildTable参数用于设置自动构建表结构的方式。如果不使用该参数,则options属性的默认值请参考4.1.1【服务启动可选项】一文。-PbuildTable参数可选项为: NEVER – 不自动构建表结构,会将pamirs.boot.options中的diffTable和rebuildTable属性设置为false EXTEND – 增量构建表结构,会将pamirs.boot.options中的diffTable属性设置为false,rebuildTable属性设置为true DIFF – 差量构建表结构,会将pamirs.boot.options中的diffTable和rebuildTable属性设置为true 模块在线 -PmoduleOnline java -jar <your jar name>.jar -PmoduleOnline=CHECK PmoduleOnline参数用于设置模块在线的方式。如果不使用该参数,则profile属性的默认值请参考4.1.1【服务启动可选项】一文。-PmoduleOnline参数可选项为: NEVER – 不读取存储在数据库中的模块信息,会将pamirs.boot.options中的reloadModule和checkModule属性设置为false READ – 读取存储在数据库中的模块信息,会将pamirs.boot.options中的checkModule属性设置为false,reloadModule属性设置为true CHECK – 读取存储在数据库中的模块信息并校验依赖模块是否已安装,会将pamirs.boot.options中的reloadModule和checkModule属性设置为true 元数据在线-PmetaOnline java -jar <your jar name>.jar -PmetaOnline=MODULE PmetaOnline参数用于设置元数据在线的方式,如果不使用该参数,则profile属性的默认值请参考4.1.1【服务启动可选项】一文。-PmetaOnline参数可选项为: NEVER – 不持久化元数据,会将pamirs.boot.options中的updateModule、reloadMeta和updateMeta属性设置为false MODULE – 只注册模块信息,会将pamirs.boot.options中的updateModule属性设置为true,reloadMeta和updateMeta属性设置为false ALL – 注册持久化所有元数据,会将pamirs.boot.options中的updateModule、reloadMeta和updateMeta属性设置为true 开放远程服务-PenableRpc PenableRpc参数用于设置是否开启远程服务。如果不使用该参数,则profile属性的默认值请参考4.1.1【服务启动可选项】一文。-PenableRpc参数可选项为true和false。该参数会将参数值设置到pamirs.boot.options中的publishService属性。 开启API服务-PopenApi PopenApi参数用于设置是否开启HTTP API服务。如果不使用该参数,则profile属性的默认值请参考4.1.1【服务启动可选项】一文。-PopenApi参数可选项为true和false。该参数会将参数值设置到pamirs.boot.options中的rebuildHttpApi属性。 开启字段校验-PcheckField PcheckField参数用于设置是否开启字段校验。-PcheckField参数可选项为true和false。由于通常应用的字段数量非常多,会延长系统启动时长,所以默认不会开启字段校验。 启用数据初始化服务-PinitData PinitData参数用于设置是否开启数据初始化服务。如果不使用该参数,则profile属性的默认值请参考4.1.1【服务启动可选项】一文。-PinitData参数可选项为true和false。该参数会将参数值设置到pamirs.boot.options中的updateData属性。 四、不使用自动构建数据库表功能 Oinone LCDP默认提供框架的所有服务,所以会自动构建数据库表。如果不需要使用Oinone的存储构建服务,可以设置YAML文件中关于自动建表的配置。这样就不会动态构建数据库表,你可以手动搭建数据库表。 通过配置启动YAML中pamirs.boot.options.rebuildTable为false彻底关闭自动建表功能。 pamirs: boot: options: rebuildTable: false 图4-1-2-4 不使用自动构建数据库表功能 也可以按需配置启动YAML中pamirs.persistence配置来关闭部分数据源的自动建表功能。persistence配置既可以针对全局也可以分数据源进行配置。 pamirs: persistence: global: # 是否自动创建数据库的全局配置,默认为true autoCreateDatabase: true # 是否自动创建数据表的全局配置,默认为true autoCreateTable: true <your ds key>: # 是否自动创建数据库的数据源配置,默认为true autoCreateDatabase: true # 是否自动创建数据表的数据源配置,默认为true…

    2024年5月23日
    1.4K00
  • 图表

    1. 业务场景 进入数据可视化后,默认处于图表列表页面,点击报表/数据大屏图标则可切换至对应列表;支持从模型获取数据后,过滤数据后创建可视化图表,维护的图表信息可以被报表、数据大屏、以及业务系统引用。 2. 操作流程 1)进入数据可视化,进入图表tab,维护分组信息; 2)在二级分组名称后点击“+”【添加图表】,对图表进行编辑设计; 3)创建完成后可以【编辑】图表; 4)图表完善后,可以点击【发布】图表,则图表此时可以被引用; 5)如果图表有更新,则可以点击【更新发布】,使业务系统引用对图表变为最新的图表信息; 6)如果图表数据不再可以公开使用,则需要通过【隐藏】功能将图表的引用权限收起,此时报表、数据大屏、前端业务系统均不可再引用该图表,但不影响已被引用的图表; 7)隐藏后可以【取消隐藏】,图表恢复隐藏前的状态和功能,可以被引用。 3. 操作流程图解 3.1 创建分组 1)操作流程:创建分组 2)操作路径:数据可视化-图表-创建分组 3)点击搜索框后的「+」创建一级分组,输入一级分组名称后,点击一级分组后的「+」创建二级分组,输入二级分组名称后,此时分组创建完成,可以在二级分组下创建图表 3.2 编辑分组名称 1)操作流程:选择分组-编辑分组名称 2)操作路径:数据可视化-图表-编辑分组名称 3)鼠标移动至需要修改的分组上,点击出现的「编辑图标」,可以修改分组名称,修改后分组名称实时更新 3.3 删除分组 1)操作流程:选择分组-删除分组 2)操作路径:数据可视化-图表-删除分组 3)鼠标移动至需要删除的分组上,当分组下无图表时出现「删除图标」,可以点击图标后删除分组,删除一级分组时对应所有的二级分组也会被删除,删除后消失,只有分组下没有图表的分组才能直接删除成功 3.4 创建图表 1)操作流程:选择二级分组-创建图表 2)操作路径:数据可视化-图表-二级分组-创建图表 3)鼠标移动至需要创建图表的二级分组上,出现「+」,点击图标后弹出“创建图表”弹窗,需要填写图表标题、模型、方法; a图表标题:最大支持20个字,支持汉字、数字、大小写字母、-;同个一级分组下不允许重复; b模型:需要选择来源数据对应的模型; c方法:选择模型后需要选择方法,方法是用来提取模型数据的逻辑; 4)选择成功后进入图表设计页面 3.5 编辑图表 1)操作流程:选择图表-编辑图表 2)操作路径:数据可视化-图表-二级分组-图表-编辑图表 3)只能编辑未发布或者已发布但没有被隐藏的图表,且存在三种编辑情况 a第一种:点击图表标题后的编辑图标,仅能编辑图表标题; b第二种:点击图表中的图表标题、图表副标题、图表描述后的编辑图标,可以直接编辑图表标题、图表副标题、图表描述; c第三种:点击【编辑】按钮,进入图表设计页面,带出已有的数据字段、样式、图表内容,编辑时的规则与创建时一致,编辑后可以点击保存进行更新,如果未保存直接返回,则编辑无效; 4)编辑后实时生效,图表信息保持展示最新效果 3.6 删除图表 1)操作流程:选择图表-删除图表 2)操作路径:数据可视化-图表-二级分组-图表-删除图表 3)未发布或者已发布但没有被隐藏的图表,并且没被前端或者报表引用,才展示图表菜单名称后的删除图标 4)删除后图表消失 3.7 复制 1)操作流程:选择图表-复制图表 2)操作路径:数据可视化-图表-二级分组-图表-复制图表 3)点击【复制】按钮,复制成功,名称为copy of 原图表标题,展示在原图表分组的最后一个 3.8 发布 1)操作流程:选择图表-发布图表 2)操作路径:数据可视化-图表-二级分组-图表-发布 3)选择单个未发布且没有被隐藏的图表,点击【发布】按钮,图表发布后可以被前端引用,图表状态变为已发布,展示最近发布时间; 4)如果图表发布后有更新内容,会展示的更新类型:更新图表信息/更新图表内容 3.9 查看最近一次发布的版本 1)操作流程:选择图表-查看最近一次发布的版本 2)操作路径:数据可视化-图表-二级分组-图表-查看最近一次发布的版本 3)当图表发布后有更新,在最近发布时间左侧展示【查看】,在最近发布时间下展示更新的类型,点击查看可以查看最近发布的版本 3.10 更新发布 1)操作流程:选择图表-更新发布图表 2)操作路径:数据可视化-图表-二级分组-图表-更新发布图表 3)选择单个已发布且没有被隐藏的图表,并且该图表在上次发布后有所更新,可以点击【更新发布】按钮,将最新的图表内容发布至业务系统,业务系统引用的图表为最新内容; 4)如果更新了内容,但未点击更新发布,则前端业务系统查看的图表仍为最近发布的图表 3.11 隐藏 1)操作流程:选择图表-隐藏图表 2)操作路径:数据可视化-图表-二级分组-图表-隐藏图表 3)图表默认不隐藏,点击图表左侧的是否隐藏可以切换,切换是否隐藏=是 a未发布的图表,较隐藏前,不可以操作【发布】,可以【取消隐藏】; b已发布的图表,较隐藏前,只能操作【导出图片、导出excel、取消隐藏】; 4)隐藏后的图表不可以被引用,但不影响已经被引用的数据 3.12 取消隐藏 1)操作流程:选择图表-取消隐藏图表 2)操作路径:数据可视化-图表-二级分组-图表-取消隐藏图表 3)隐藏后的图表可以取消隐藏,切换是否隐藏=否,取消隐藏后,图表恢复隐藏前的状态和功能,可以被引用 3.13 查看引用 1)流程:选择图表-查看被哪些报表/数据大屏/页面引用 2)操作路径:数据可视化-图表-二级分组-图表-更多-查看引用 3)选择具体的图表,查看当前图表被引用的所有信息 3.14 不允许别人编辑 1)流程:选择图表-不允许别人编辑 2)操作路径:数据可视化-图表-二级分组-图表-更多-不允许别人编辑 3)选择自己创建的图表,对图表是否允许其他人编辑进行设置;如果设置为不允许,则其他人无法编辑图表 3.15 不允许别人引用 1)流程:选择图表-更多-不允许别人引用 2)操作路径:数据可视化-图表-二级分组-图表-更多-不允许别人引用 3)选择自己创建的图表,对图表是否允许他人引用进行设置;如果设置为不允许,则其他人无法在报表、数据大屏、界面设计器引用到该图表 3.16 导出图片 1)操作流程:选择图表-导出图片 2)操作路径:数据可视化-图表-二级分组-图表-图表导出图片 3)选择图表后,点击【导出图片】按钮可以将当前图表导出为图片 3.17 导出EXCEL 1)操作流程:选择图表-导出EXCEL 2)操作路径:数据可视化-图表-二级分组-图表-图表导出EXCEL 3)选择图表后,点击【导出EXCEL】按钮可以将当前图表导出为EXCEL 4. 图表设计页面 4.1 修改模型、方法 1)操作流程:创建图表-进入图表设计页面 2)操作路径:数据可视化-图表-二级分组-图表-创建图表 3)在“创建图表”弹窗中选择了模型和方法后,可以在进入图表设计页面修改 4)图表设计页面,点击模型后的设置图标后,右侧弹出弹窗,可以修改模型和获取模型数据的方法,需要注意的是:修改模型后,图表信息会清空 4.2 维度 1)操作流程:创建图表-进入图表设计页面 2)操作路径:数据可视化-图表-二级分组-图表-创建图表 3)维度字段:布尔、文本、枚举、日期时间、年份、日期、时间、用户ID、手机号、邮箱 4.2.1 维度的添加 1)图表设计页面,点击维度后的「+」,右侧弹出弹窗,展示所有的维度字段,可以选择对应的字段进行分析 a拖动字段进入维度列表 b点击字段,则字段进入维度列表 2)不同的图表支持的维度个数不同,当维度字段个数已达上限后不可再添加;此时拖动新字段到旧字段上后,新字段会代替旧字段进行数据分析,且会保留相同的样式 4.2.2 维度的删除 1)维度选择后,鼠标放到维度字段上,显示「删除图标」 2)点击则字段删除成功,维度字段的效果消失 4.2.3 修改维度展示名称 1)维度选择后,鼠标放到维度字段上,显示「设置图标」 2)点击后下方弹出「修改展示名称」的设置选项,点击后右侧出现修改展示名称的弹窗,可以进行修改,在输入框下方可以查看原字段名称 4.3 数值 1)操作流程:创建图表-进入图表设计页面 2)操作路径:数据可视化-图表-二级分组-图表-创建图表 3)数值字段:整数、浮点数、金额、(连续的日期时间、年份、日期、时间) 4.3.1 数值的添加 1)图表设计页面,点击数值后的「+」,右侧弹出弹窗,展示所有的数值字段,可以选择对应的字段进行分析 a拖动字段进入数值列表 b点击字段,则字段进入数值列表 2)不同的图表支持的数值个数不同,当数值字段个数已达上限后不可再添加;此时拖动新字段到旧字段上后,新字段会代替旧字段进行数据分析,且会保留相同的样式 3)拖入的数值字段中,可以同时拖入整数、浮点数、金额;但是拖入字段类型=年份/日期时间/日期/时间后,不可以拖入其他字段类型的数值字段 4)饼图、漏斗图不可以在数值列表中拖入字段类型=年份/日期时间/日期/时间的字段 4.3.2 数值的删除 1)数值选择后,鼠标放到数值字段上,显示「删除图标」 2)点击则字段删除成功,数值字段的效果消失 4.3.3 修改数值展示名称 1)维度选择后,鼠标放到数值字段上,显示「设置图标」 2)点击后下方弹出可以设置的选项,点击「修改展示名称」选项,点击后右侧出现修改展示名称的弹窗,可以进行修改,在输入框下方可以查看原字段名称 4.3.4 修改数值聚合方式 1)维度选择后,鼠标放到数值字段上,显示「设置图标」 2)点击后下方弹出可以设置的选项,点击「聚合方式」选项,点击后右侧出现修改展示名称的弹窗,可以进行修改 3)默认是求和,可以修改为「无处理、最小值、最大值、平均值、计数」 a求和:将维度值对应的所有数值进行加和 b无处理:取维度值对应数值中的最近一条不为空的值 c最小值:取维度值对应数值中的最小值 d最大值:取维度值对应数值中的最大值 e平均值:取维度值对应数值的平均值 f计数:计算维度值对应的数值个数 4)修改后实时更新图表信息,会影响辅助线取数值字段时的值 4.3.5 修改数值数据格式 1)维度选择后,鼠标放到数值字段上,显示「设置图标」 2)点击后下方弹出可以设置的选项,点击「数据格式」选项,点击后右侧出现修改数据格式的弹窗,可以进行修改 3)可以设置字段的数据类型、单位;…

    2024年6月20日
    1.9K00
  • 3.3.10 字段类型之关系描述的特殊场景

    在3.3.9【字段类型之关系与引用】一文中已经描述了各种关系字段的常规写法,还有一些特殊场景如:关系映射中存在常量,或者M2M中间表是大于两个字段构成。 举例说明关系字段-高级用法 场景描述 PetTalent模型增加talentType字段,PetItem与PetTalent的多对多关系增加talentType(达人类型),PetItemRelPetTalent 中间表维护petItemId、petTalentId以及talentType,PetDogItem和PetCatItem分别重写petTalents 字段,关系中增加常量描述。示意图如下 实际操作步骤: Step1 新增 TalentTypeEnum package pro.shushi.pamirs.demo.api.enumeration; import pro.shushi.pamirs.meta.annotation.Dict; import pro.shushi.pamirs.meta.common.enmu.BaseEnum; @Dict(dictionary = TalentTypeEnum.DICTIONARY,displayName = "达人类型") public class TalentTypeEnum extends BaseEnum<TalentTypeEnum,Integer> { public static final String DICTIONARY ="demo.TalentTypeEnum"; public final static TalentTypeEnum DOG =create("DOG",1,"狗达人","狗达人"); public final static TalentTypeEnum CAT =create("CAT",2,"猫达人","猫达人"); } Step2 PetTalent模型增加talentType字段 package pro.shushi.pamirs.demo.api.model; import pro.shushi.pamirs.demo.api.enumeration.TalentTypeEnum; import pro.shushi.pamirs.meta.annotation.Field; import pro.shushi.pamirs.meta.annotation.Model; @Model.model(PetTalent.MODEL_MODEL) @Model(displayName = "宠物达人",summary="宠物达人",labelFields ={"name"}) public class PetTalent extends AbstractDemoIdModel{ public static final String MODEL_MODEL="demo.PetTalent"; @Field(displayName = "达人") private String name; @Field(displayName = "达人类型") private TalentTypeEnum talentType; } Step3 修改PetItem的petTalents字段,在关系描述中增加talentType(达人类型) @Field.many2many(relationFields = {"petItemId"},referenceFields = {"petTalentId","talentType"},through = "PetItemRelPetTalent") @Field.Relation(relationFields = {"id"}, referenceFields = {"id","talentType"}) @Field(displayName = "推荐达人",summary = "推荐该商品的达人们") private List<PetTalent> petTalents; Step4 PetDogItem增加petTalents字段,重写父类PetItem的关系描述 talentType配置为常量,填入枚举的值 增加domain描述用户页面选择的时候自动过滤出特定类型的达人,RSQL用枚举的name @Field.many2many(relationFields = {"petItemId"},referenceFields = {"petTalentId","talentType"},through = "PetItemRelPetTalent") @Field.Relation(relationFields = {"id"}, referenceFields = {"id","talentType"}) @Field(displayName = "推荐达人",summary = "推荐该商品的达人们") private List<PetTalent> petTalents; Step5 PetCatItem增加petTalents字段,重写父类PetItem的关系描述 talentType配置为常量,填入枚举的值 增加domain描述用户页面选择的时候自动过滤出特定类型的达人,RSQL用枚举的name @Field(displayName = "推荐达人") @Field.many2many( through = "PetItemRelPetTalent", relationFields = {"petItemId"}, referenceFields = {"petTalentId","talentType"} ) @Field.Relation(relationFields = {"id"}, referenceFields = {"id", "#2#"}, domain = " talentType == CAT") private List<PetTalent> petTalents; Step6 清除中间表demo_core_pet_item_rel_pet_talent的数据记录 清除PetItem与PetTalent的多对多中间表demo_core_pet_item_rel_pet_talent的数据记录 Step7 重启看效果 修改达人记录,选择不同达人类型 PetItem、PetCatItem、PetDogItem不同的交互页面

    2024年5月23日
    1.9K00
  • 第2章 Oinone的技术独特性

    本章的主要目的是通过分析企业商业支撑软件的项目特性和关注点,找到企业软件发展的另一个本质变化——新技术流派的产生。在对“互联网架构做为最佳实践为何失效”的思考基础上,我们分析互联网中台架构的发展历史以及企业实际现状,找出其水土不服的原因。进而引出Oinone的低代码开发平台如何结合互联网架构并完成创新,以满足企业数字化转型的需求。 具体而言,本章包括以下内容: 企业软件发展的另一个本质变化:新技术流派的产生; 最佳实践为何失效?Oinone如何打造具有企业特色的互联网架构; Oinone独特性之源:元数据与设计原则; Oinone独特性之单体与分布式的灵活切换; Oinone独特性之每一个需求都是一个模块; Oinone独特性之低无一体。

    Oinone 7天入门到精通 2024年5月23日
    7.5K00
  • 2.4.1 Oinone独特性之单体与分布式的灵活切换

    企业数字化转型需要处理分布式带来的复杂性和成本问题。尽管这些问题令人望而却步,但分布式架构对于大部分企业仍然是必须的选择。如果一个低代码平台缺乏分布式能力,那么它的性能就无法满足客户的要求。相比之下,Oinone平台通过对部署的创新(如图2-6所示),成功实现了分布式架构的支持,而且能够按照客户的业务发展需求,灵活选择不同的部署模式,同时节约企业成本,提升创新效率。这一创新是Oinone平台与其他低代码平台的重要区别,能够满足客户预期发展并兼顾成本效益。 图2-6 传统部署方式VS Oinone部署方式 实现原理 要实现灵活部署的特性,必须满足两个基本要求: 开发过程中不需要过多关注分布式技术,就像开发单体应用一样简单。代码在运行时应该能够根据模块是否在运行容器中,来决定路由走本地还是远程。这样可以大大减少研发人员的工作量和技术复杂度。 研发与部署要分离,即"开发单体应用一样开发分布式应用,而部署形式由后期决定"。为此,我们的工程结构支持多种启动模式,并逐一介绍了针对不同场景的工程结构类型(如下图2-7所示)。这样可以让客户在后期根据业务发展情况和需求,选择最适合的部署模式,从而达到灵活部署的目的。 图2-7 Oinone工程结构梳理 在整个工程结构上,我们秉承了Spring Boot的规范,不会改变大家的工程习惯。而Oinone的部署能力则可以让我们更灵活地应对各种情况。现在,我们来逐一介绍几种常规的工程结构以及它们适用的场景: 单模块工程结构(常规操作) a. 这是非常标准的Spring Boot工程,适用于简单的应用场景开发以及入门学习。 多模块工程结构(常规操作) a. 这是非常标准的多Spring Boot工程,可以实现分布式独立启动,适用于常规的分布式应用场景开发。 多模块工程结构-独立boot工程模式 a. 这种工程结构在多模块工程的基础上,通过独立的boot工程来支撑多部署方式。适用于中大型分布式应用场景开发。 b. 然而,随着工程越来越多,我们也会面临一些问题: ⅰ研发:环境准备非常困难,每个模块都要单独启动,研发调试跟踪困难。 ⅱ部署:分布式的高可靠性保证需要每个模块至少有两个部署节点,但在模块较多的情况下,起步成本非常高。同时,企业初期业务不稳定且规模较小,使用多模块工程的第二种模式会增加问题排查难度和成本。 c. 此时,Oinone的多模块工程下的独立boot工程模式部署就可以发挥其灵活性,让研发和业务起步阶段可以选择all-in-one模式,等到业务发展到一定规模的时候,只需要把线上部署模式切换成模块独立部署,而研发还可以保留all-in-one模式的优势。 d. 值得注意的是,分分合合的部署模式在传统互联网架构和低代码或无代码平台上都是有代价的,但是Oinone却可以灵活适配,只需要在boot工程的yml文件中写入需要加载的模块就可以解决。此处我们仅介绍多模块加载配置,选择性忽略其他无关配置,具体配置(如下图2-8所示)。 pamirs: boot: init: true sync: true modules: – base – resource – sequence – user – auth – web tenants: – pamirs 图2-8 Oinone yml配置图大型多场景工程结构-独立boot工程模式: a. 在多模块工程结构基础上的加强版,增加CDM层设计,让不同场景即保持数据统一,又保持逻辑独立。这种工程结构特别适用于大型企业软件开发,其中涉及到多个场景的情况,例如B端和C端的应用,或者跨不同业务线的应用,能够保证数据的一致性,同时也能够保持逻辑独立,避免不同场景间的代码冲突。 b. 这种工程结构是我们Oinone支撑“企业级软件生态”的核心,我们可以把场景A当作我们官方应用,场景B当作其他第三方伙伴应用。在这个工程结构下,我们的客户可以定制化开发自己的应用,同时我们也可以通过这种模式来支持我们的伙伴们进行开发,实现多方共赢。 c. 基于独立boot工程模式,我们同样对应多种部署模式应对不同情况,并统一管理所有伙伴应用。这种工程结构的优点是扩展性好,可以支持不同规模的应用,并且可以根据需要进行快速扩展或缩小规模,具有很高的灵活性。 基于标准产品的二开工程结构,是指基于标准产品进行二次开发,满足客户特定需求的工程结构。这种模式下,Oinone提供标准产品,客户可以根据自己的需求进行二次开发,实现定制化需求,同时可以利用我们的模块化开发特性,将每一个需求作为一个模块进行开发和管理。这种工程结构的优点是能够快速满足客户特定需求,同时也具有很好的可维护性和可扩展性,因为每个需求都是一个独立的模块,可以方便地进行维护和扩展。在下一篇“Oinone独特性之每一个需求都是一个模块”文章中有详细介绍。

    2024年5月23日
    2.7K00

Leave a Reply

Please Login to Comment