高级组件

本篇主要结合业务场景介绍高级组件的使用方法。

级联选择/树选择

级联选择与树选择是同一类业务场景、不同的交互体验,在这里我们一起说明。

业务场景

行业分类、产品类目/分类等自关联场景,案例以行业分类说明。

操作步骤

Step1:搭建模型

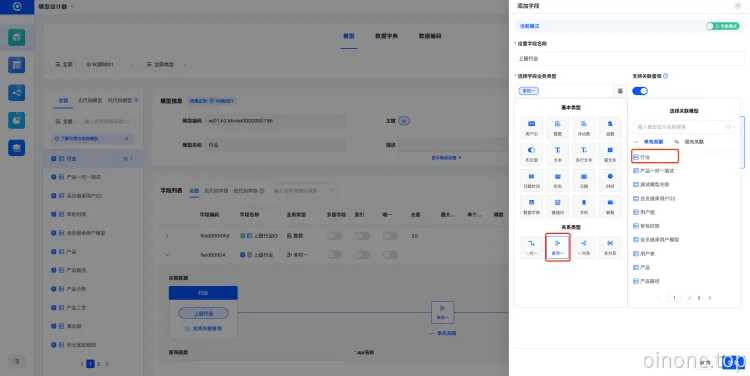
搭建行业模型,在行业模型中创建多对一字段“上级行业”,指多个子行业对应一个上级行业。如下图:

image.png

Step2:界面设计

  • 创建行业的表格视图,绑定菜单,并且在此视图中增加“跳转动作 - 新增行业”;
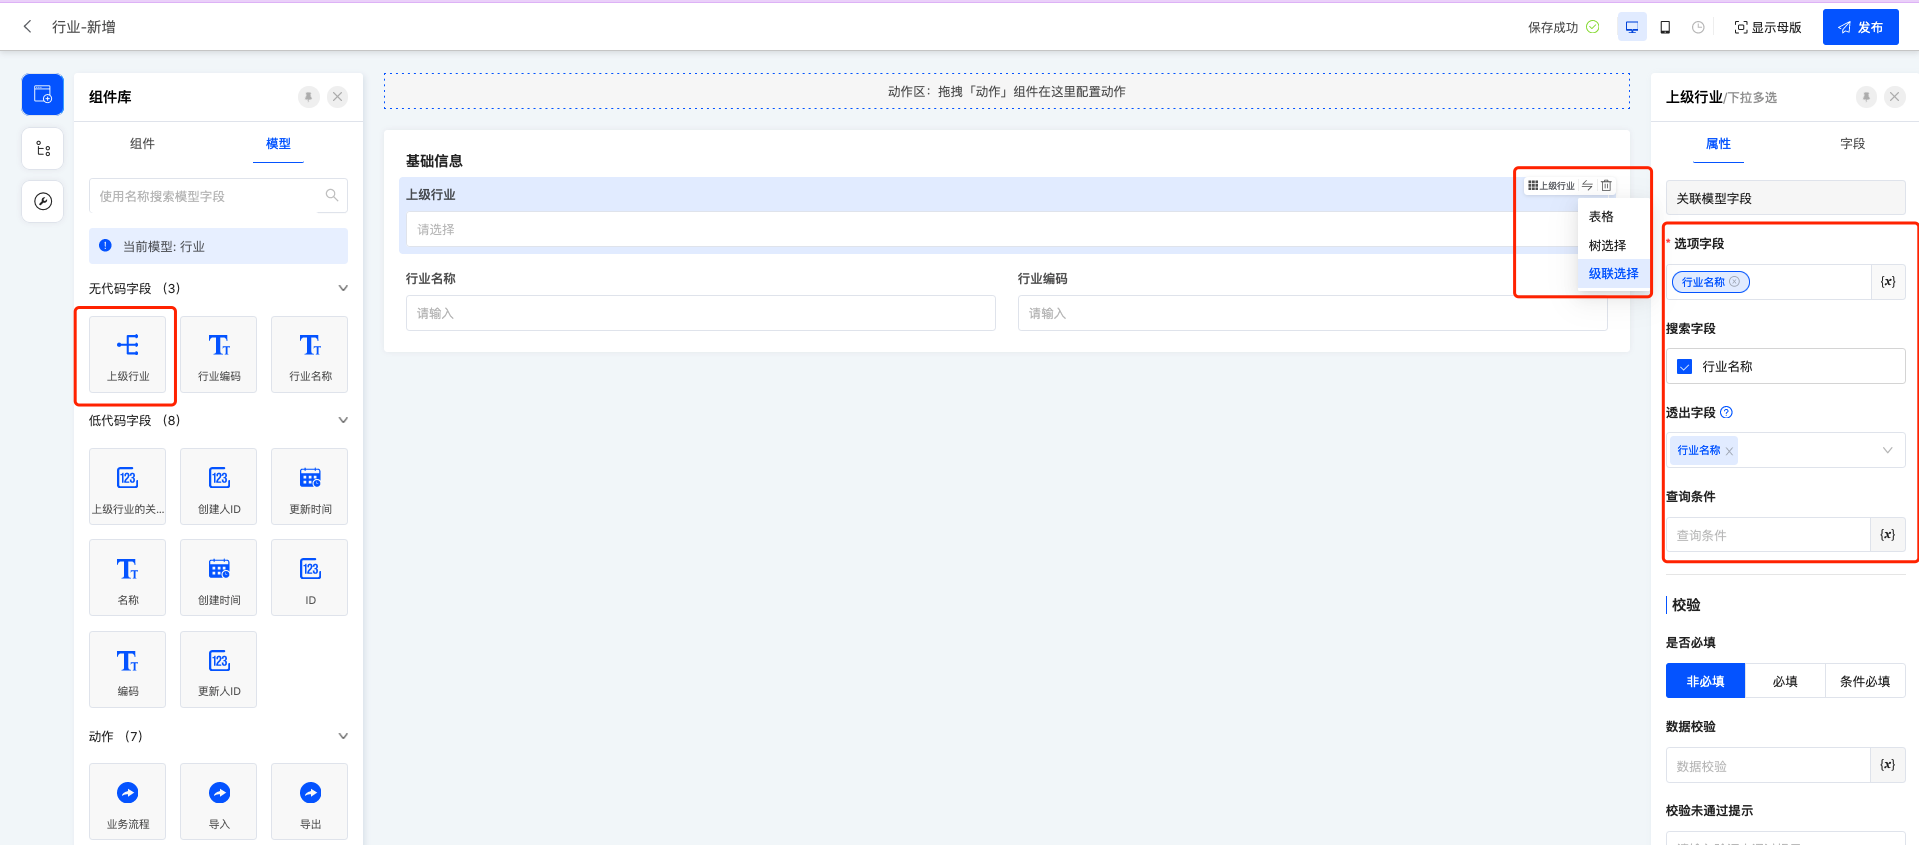
  • 创建新增行业表单,将“上级行业”拖进画布中,组件切换为“级联选择”,属性面板配置“选项字段、搜索字段、透出字段”,平台低代码为每个模型自动生成了名称、编码字段,如果不使用平台提供的名称、自建名称时,需要配置这三个字段;

image.png

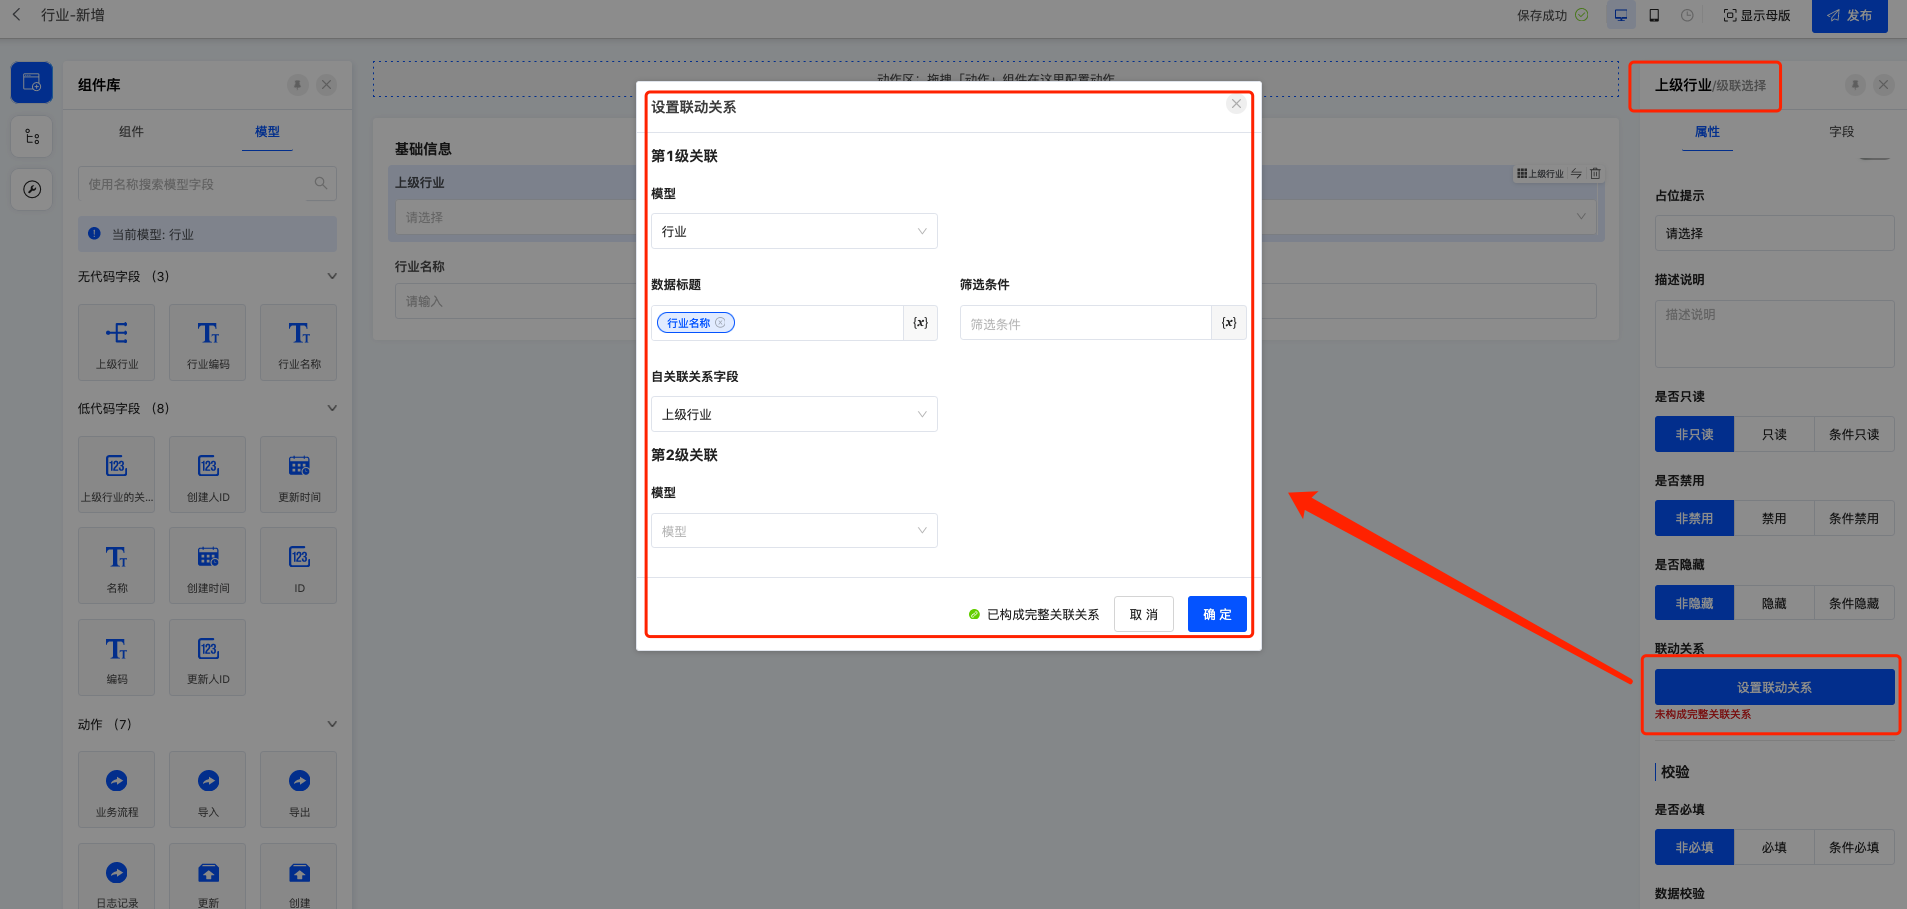
  • 为“上级行业”设置联动关系,自关联默认选择行业、标题定义为行业名称、自关联的字段为上级行业。

image.png

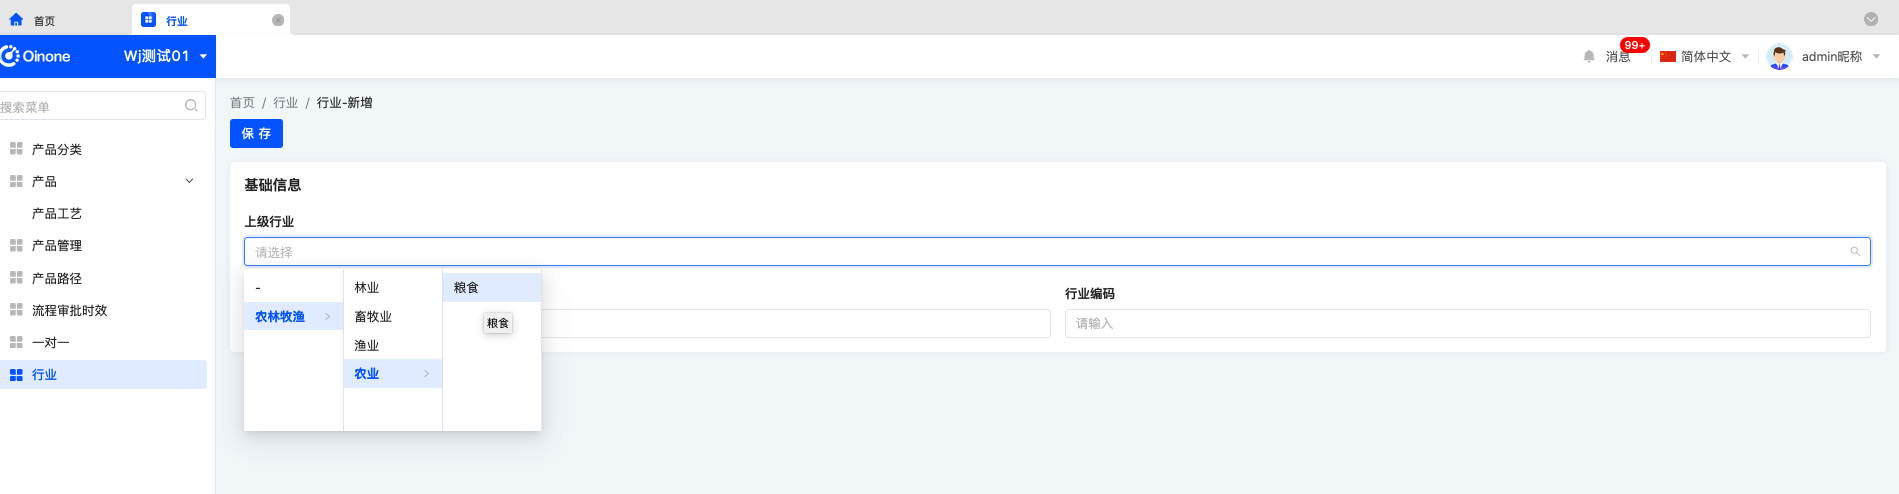
  • 配置后发布表格、表单视图,即可获得级联选择效果。
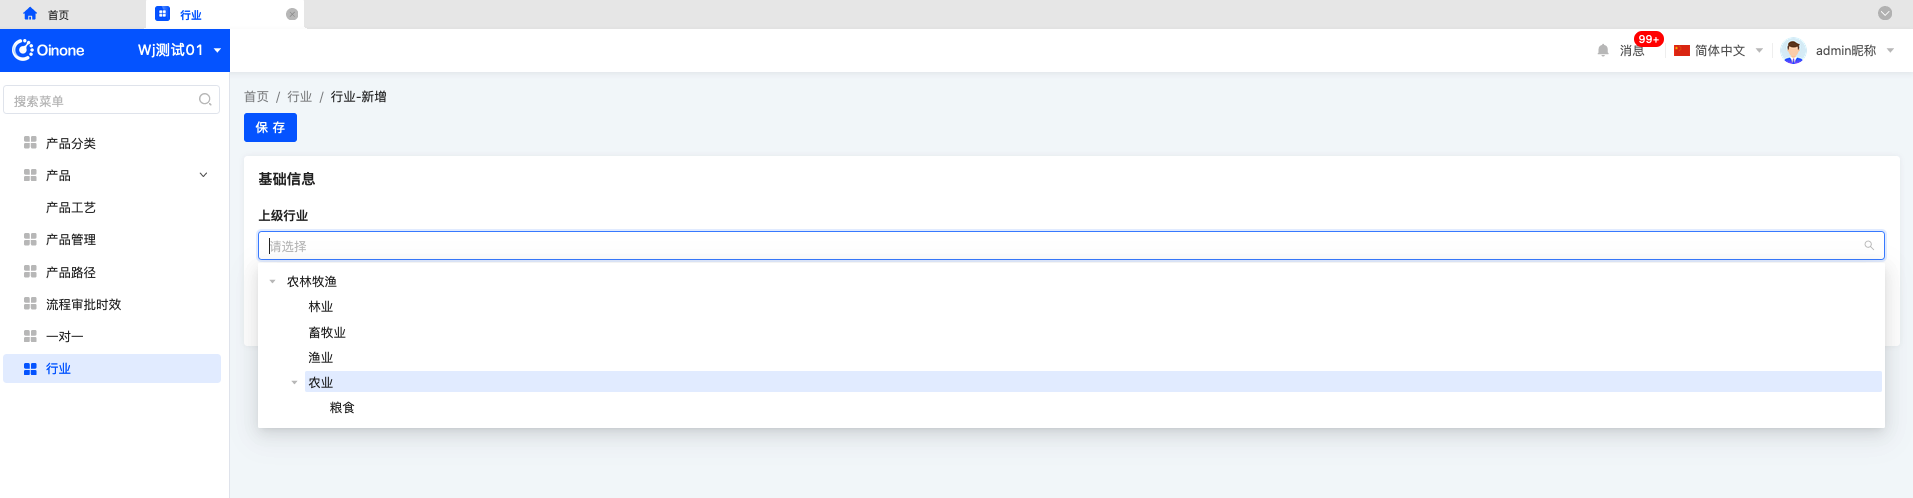
  • 表单视图中将“上级行业”切换为“树选择”组件,在发布后,即可获得树选择效果。

Step3:效果展示

级联选择

image.png

树选择

image.png

Oinone社区 作者:史, 昂原创文章,如若转载,请注明出处:https://doc.oinone.top/oio4/9408.html

访问Oinone官网:https://www.oinone.top获取数式Oinone低代码应用平台体验

Like (0)
史, 昂's avatar史, 昂数式管理员
Previous 2024年6月20日 am9:49
Next 2024年6月20日 am9:49

相关推荐

  • 组件属性

    1. 通用属性 介绍组件和其属性之前,先介绍一些大部分组件通用支持的一些基础属性。 1.2 标题 标题是字段在当前页面的展示名称,标题默认为字段名称,可以修改。 1.2 占位提示 在未填写内容时,输入框或选择框内的浅色提示文字,仅用于提示,不会影响字段的值。 1.3 描述说明 一个字段的描述信息,通常用于说明当前字段的范围、注意事项等。描述说明大部分在组件的下方显示,特殊的是,分组的描述说明在标题的左侧。 1.4 默认值 创建数据时,有些字段大概率都是相同值,可设置默认值,减少添加人员的操作步骤,提高录入数据效率。 1.5 只读 设为只读时,字段可见,但不可编辑。 除了只读和非只读的对立选项,也可以设置条件只读,在设置的条件下才只读,条件不符合则非只读。 1.6 禁用 设为禁用时,字段可见,但不可编辑。 除了禁用和非禁用的对立选项,也可以设置条件禁用,在设置的条件下才禁用,条件不符合则非禁用。 1.7 隐藏 设为隐藏时,字段不可见,也不可编辑。但是在页面设计时,隐藏的组件也会展示,效果如下图。 除了隐藏和非隐藏的对立选项,也可以设置条件隐藏,在设置的条件下才隐藏,条件不符合则非隐藏。 1.8 必填 控制字段在当前页面是否必填,若设置为必填则在标题前会有红色的*作为标识。除了必填和非必填的对立选项,也可以设置条件必填,在设置的条件下才必填,条件不符合则非必填。 1.9 标题排列方式 字段的标题可以自定义横向排列还是纵向排列。每个字段组件都支持设置,设置后之间互不影响。除了组件支持自定义,表单、分组、选项卡也可以设置排列方式,对于这种布局容器类组件,设置后会将其容器内的所有组件的标题排列方式都改为所设置的值。 1.10 宽度 定义在页面中的宽度:占整行的比例,一般可选项有1/4、1/3、1/2、2/3、3/4、1。 其中1/2表示占当前行的一半;1表示占当前行一整行;以此类推。部分组件特殊,如富文本仅支持宽度为1,即占一整行。 2. 分组 分组是一个布局类组件,类似一个容器,可以把业务含义相近的内容放在这个分组容器内。 2.1 属性 2.1.1 标题 分组可以定义一个标题名称,标题显示在分组左上角,可以不设置标题。 2.1.2 描述说明 分组的描述说明显示在分组标题右侧。 2.1.3 标题排列方式 分组中的标题排列方式属性并不是控制分组的标题,而是控制分组内组件的标题。设置后对分组内的所有组件生效。 3. 选项卡 选项卡是一个布局类组件,类似一个容器,每个选项卡可以添加多个选项页,可以把业务含义相近的内容放在选项卡的选项页容器内。 3.1 选项卡属性 3.1.1 选项页排列方式 选中选项卡,可选择选项卡中的选项页排列方式:水平排列、竖直排列。默认是水平排列,效果如下图。 3.1.2 标题排列方式 选项卡中的标题排列方式控制选项卡内组件的标题。设置后对选项卡内的所有组件生效。 3.2 选项页属性 3.2.1 标题 选中选项页,显示选项页的属性设置,选项卡中的每个选项页支持设置标题。 3.2.2 标题排列方式 选项页中的标题排列方式控制选项页内组件的标题。设置后对选项页内的所有组件生效。同一个选项卡,不同选项页之间的标题排列方式可以不同。 4. 单行文本 单行文本输入框,常用于记录名称、身份证号或其他普通的文字内容。 4.1 创建字段 单行文本仅支持创建「文本」业务类型的字段,填写规则、内容和模型设计器端创建字段一致。 4.2 表单属性 4.2.1 通用属性 在表单中,单行文本可以设置一些通用的属性:标题、占位提示、描述说明、默认值、只读、隐藏、禁用、必填、标题排列方式、宽度。 4.2.2 文本类型 文本类型选项为文本或密码。若设置为文本,输入时内容是可见的;若设置为密码,输入时是不可见的密码形态,如下图: 4.2.3 最小/大长度 设置输入框输入内容的长度,输入框会根据设置的值进行校验。 最大长度默认为创建字段时填写的长度,且设置的最大长度不可以大于字段的长度 最小长度默认为空,为空则为不限制最小长度 4.2.4 输入格式 设置输入格式为网址或者身份证时,会进行格式的校验 无:默认为无,不会校验内容 网址:进行网址校验 身份证:进行身份证号校验,设置后,需要输入正确的身份证号 4.2.5 显示计数器 当需要用户关注输入内容长度时,可以开启显示计数器,在输入时会实时显示当前内容的长度。 4.2.6 显示清除按钮 若开启了清除按钮,则在输入框有内容时,点击清除按钮一键清除已有内容 5. 多行文本 多行文本输入框,常用于记录字数较多的文字,如意见、复杂备注等。 5.1 创建字段 多行文本仅支持创建「多行文本」业务类型的字段,填写规则、内容和模型设计器端创建字段一致。 5.2 表单属性 5.2.1 通用属性 在表单中,单行文本可以设置一些通用的属性:标题、占位提示、描述说明、默认值、只读、隐藏、禁用、必填、标题排列方式、宽度。 5.2.2 最小/大长度 设置输入框输入内容的长度,输入框会根据设置的值进行校验。 -最大长度默认为创建字段时填写的长度,且设置的最大长度不可以大于字段的长度 -最小长度默认为空,为空则为不限制最小长度 5.2.3 显示计数器 当需要用户关注输入内容长度时,可以开启显示计数器,在输入时会实时显示当前内容的长度。 5.2.5 显示清除按钮 若开启了清除按钮,则在输入框有内容时,点击清除按钮一键清除已有内容 6. 整数 整数输入框,常用于输入整数的天数、数量等,如果会出现小数,请使用小数组件。 6.1 创建字段 整数仅支持创建「整数」业务类型的字段,填写规则、内容和模型设计器端创建字段一致。 6.2 表单属性 6.2.1 通用属性 在表单中,整数可以设置一些通用的属性:标题、占位提示、描述说明、默认值、只读、隐藏、禁用、必填、标题排列方式、宽度。 6.2.2 最小/大值 设置整数输入框输入内容的最值,输入框会根据设置的最值进行校验。 最大值可设置的范围根据字段填写的长度转换,如设置长度为3,则最大值最大不可以超过999 截图 6.2.3 显示千分位 数字过长时,不便于查看,可开启显示千分位。 7. 小数 小数输入框,常用于输入金额、单价等,会出现小数的数值。 7.1 创建字段 小数仅支持创建「浮点型」业务类型的字段,填写规则、内容和模型设计器端创建字段一致。 7.2 表单属性 7.2.1 通用属性 在表单中,小数可以设置一些通用的属性:标题、占位提示、描述说明、默认值、只读、隐藏、禁用、必填、标题排列方式、宽度。 7.2.2 最小/大值 设置小数输入框输入内容的最值,输入框会根据设置的最值进行校验。 最大值可设置的范围根据字段填写的长度转换,如设置长度为3,则最大值最大不可以超过999 7.2.3 保留小数位数 支持设置小数的保留位数,设置后在页面中输入内容时,将进行校验 可设置的保留小数位数不可大于该字段的精度,如字段精度为2,则组件属性中的小数位数最大只能为2; 7.2.4 显示千分位 数字过长时,不便于查看,可开启显示千分位。 8. 下拉单选 从多个选项中下拉选择一个数据,作为数据值。选项可以是关联模型的数据,也可以是数据字典或布尔型开关。 8.1 创建字段 下拉单选支持创建三种业务类型的字段,分别是:多对一、布尔型、数据字典。 多对一:创建字段时需要选择关联的模型,关联模型的数据将作为下拉选项; 布尔型:下拉选项默认只有是、否; 数据字典:创建字段时需要选择数据字典,其数据字典项将作为下拉选项 8.2 表单属性 8.2.1 通用属性 在表单中,下拉单选可以设置一些通用的属性:标题、占位提示、描述说明、只读、隐藏、禁用、必填、标题排列方式、宽度。 8.2.2 选项类型…

    2024年6月20日
    1.8K00
  • 3.5.7.2 自定义母版

    母版是什么 在业务系统中,母版是一种全局通用的组件,用于包裹每个页面的元素。这个概念类似于 PPT 中的母版,它定义了页面的整体结构、样式和布局,使得系统具有一致的外观和风格。 特点: 全局通用:母版是全局性的,适用于系统中的每个页面,确保一致性的用户体验。 包裹元素:母版包裹每个页面的元素,定义了整体的结构和布局。 外观一致性:通过统一的母版设计,系统达到外观和风格的一致性。 与 PPT 母版的类比: 在母版的概念上,与 PPT 中的母版类似,都是用于定义整体结构和样式,确保每个页面都具有一致的外观。 默认母版范围: 图3-5-7-20 默认母版范围 作用场景 在系统中,我们提供了多个纬度的母版,包括全局、应用和页面纬度。这样的设计允许根据不同的业务场景选择合适的母版纬度,以满足不同层次的定制需求。 母版纬度: 全局母版: 覆盖系统中所有页面,确保全局的一致性和统一的用户体验。 定义全局性的结构、样式和布局。 应用母版: 适用于特定应用或模块,定制化程度介于全局和页面之间。 允许在不同应用间实现一定的差异化。 页面母版: 面向具体页面,提供最大的定制化空间。 允许在不同页面中定义不同的结构和样式。 选择纬度: 业务场景决定:根据具体的业务场景和需求选择合适的母版纬度。 定制化需求:如果需要全局一致性,选择全局母版;如果在应用层面有特定需求,选择应用母版;如果需要最大的灵活性和定制化,选择页面母版。 参数说明: 在系统中,使用 registerMask 注册母版时,需要提供两个参数。第一个参数是母版的 XML,第二个参数用于控制母版的注册行为,包括 module、moduleName、model 和 actionName。 母版 XML(第一个参数): 提供母版的 XML 描述,定义了母版的结构和样式。 控制参数(第二个参数): module:指定模块的名称。 moduleName:指定模块的显示名称。 model:指定母版所属的模型。 actionName:指定母版的操作名称,可以是字符串或字符串数组。 全局母版 可以使用 registerMask 注册母版。当第二个参数为 {} 时,即代表注册全局母版。 示例工程目录 以下是需关注的工程目录示例,并确保导入导出依赖正确: 图3-5-7-21 全局纬度注册母版工程目录示例 示例代码 以下是一个示例代码: import { registerMask } from '@kunlun/dependencies'; /** * mask: 在做系统时,我们通常会把外层的布局(菜单、顶部导航)等抽出公共组件,公共组件会抽离全局通用。类似ppt母版的概念即为Mask * registerMask 第二个入参为{}即注册了全局得母版 * * 和默认母版相比移除右上角消息、语言切换、用户 * `<block> * <widget widget="notification" /> * <widget widget="divider" /> * <widget widget="language" /> * <widget widget="divider" /> * <widget widget="user" /> * </block>` */ const registerGlobalMask = () => { registerMask(` <mask> <multi-tabs /> <header> <widget widget="app-switcher" /> </header> <container> <sidebar> <widget widget="nav-menu" height="100%" /> </sidebar> <content> <breadcrumb /> <block width="100%"> <widget width="100%" widget="main-view" /> </block> </content> </container> </mask>`, {}); } registerGlobalMask(); 图3-5-7-22 全局纬度注册母版代码示例 复制这段代码执行下registerGlobalMask()试试看吧 效果 右上角消息、语言切换、用户被移除。 图3-5-7-23 全局纬度注册母版效果示例 应用母版 在系统中,可以使用 registerMask 注册母版。当第二个参数为 {moduleName: ‘resource’} 时,即注册了 resource(资源)应用的母版。 示例工程目录 以下是需关注的工程目录示例,更新导出./moduleMask: 图3-5-7-24 应用纬度注册母版工程目录示例 示例代码 以下是一个示例代码: /** * registerMask 第二个入参为{moduleName: 'resource'}即注册了resource(资源)应用的母版 * * resource来源: 通常是浏览器url上的module * * 和默认模版相比拿掉了菜单 * `<sidebar> * <widget widget="nav-menu" height="100%"…

    2024年5月23日
    1.9K00
  • 4.1.5 模型之持久层配置

    一、批量操作 批量操作包括批量创建与批量更新。批量操作的提交类型系统默认值为batchCommit。 批量提交类型: useAffectRows,循环单次单条脚本提交,返回实际影响行数 useAndJudgeAffectRows,循环单次单条脚本提交,返回实际影响行数,若实际影响行数与输入不一致,抛出异常 collectionCommit,将多个单条更新脚本拼接成一个脚本提交,不能返回实际影响行数 batchCommit,使用单条更新脚本批量提交,不能返回实际影响行数。 全局配置 pamirs: mapper: batch: batchCommit 图4-1-5-1 全局配置 运行时配置 非乐观锁模型系统默认采用batchCommit提交更新操作;乐观锁模型默认采用useAndJudgeAffectRows提交更新操作。也可以使用以下方式在运行时改变批量提交方式。 Spider.getDefaultExtension(BatchApi.class).run(() -> { 更新逻辑 }, 批量提交类型枚举); 图4-1-5-2 运行时配置 运行时校正 如果模型配置了数据库自增主键,而批量新增的批量提交类型为batchCommit,则系统将批量提交类型变更为collectionCommit(如果使用batchCommit,则需要单条提交以获得正确的主键返回值,性能有所损失)。 如果模型配置了乐观锁,而批量更新的批量提交类型为collectionCommit或者batchCommit,则系统将批量提交类型变更为useAndJudgeAffectRows。也可以失效乐观锁,让系统不做批量提交类型变更处理。 二、乐观锁(举例) 在一些会碰到并发修改的数据,往往需要进行并发控制,一般数据库层面有两种一种是悲观锁、一种是乐观锁。oinone对乐观锁进行了良好支持 定义方式 乐观锁的两种定义方式: 通过快捷继承VersionModel,构建带有乐观锁,唯一编码code且主键为id的模型。 可以在字段上使用@Field.Version注解来标识该模型更新数据时使用乐观锁 如果更新的实际影响行数与入参数量不一致,则会抛出异常,错误码为10150024。如果是批量更新数据,为了返回准确的实际影响行数,批量更新由批量提交改为循环单条数据提交更新,性能有所损失。 失效乐观锁 一个模型在某些场景下需要使用乐观锁来更新数据,而另一些场景不需要使用乐观锁来更新数据,则可以使用以下方式在一些场景下失效乐观锁。更多元位指令用法详见4.1.9【函数之元位指令】一文。 PamirsSession.directive().disableOptimisticLocker(); try{ 更新逻辑 } finally { PamirsSession.directive().enableOptimisticLocker(); } 图4-1-5-3 失效乐观锁 不抛乐观锁异常 将批量提交类型设置为useAffectRows即可,这样可改由外层逻辑对返回的实际影响行数进行自主判断。 Spider.getDefaultExtension(BatchApi.class).run(() -> { 更新逻辑,返回实际影响行数 }, BatchCommitTypeEnum.useAffectRows); 图4-1-5-4 将批量提交类型设置为useAffectRows 构建第一个VersionModel Step1 新建PetItemInventroy模型,继承快捷模型VersionModel package pro.shushi.pamirs.demo.api.model; import pro.shushi.pamirs.meta.annotation.Field; import pro.shushi.pamirs.meta.annotation.Model; import pro.shushi.pamirs.meta.base.common.VersionModel; import java.math.BigDecimal; @Model.model(PetItemInventroy.MODEL_MODEL) @Model(displayName = "宠物商品库存",summary="宠物商品库存",labelFields = {"itemName"}) public class PetItemInventroy extends VersionModel { public static final String MODEL_MODEL="demo.PetItemInventroy"; @Field(displayName = "商品名称") private String itemName; @Field(displayName = "库存数量") private BigDecimal quantity; } 图4-1-5-5 新建PetItemInventroy模型 Step2 修改DemoMenu,增加访问入口 @UxMenu("商品库存")@UxRoute(PetItemInventroy.MODEL_MODEL) class PetItemInventroyMenu{} 图4-1-5-6 修改DemoMenu Step3 重启看效果 体验一:页面上新增、修改数据库字段中的opt_version会自动加一 图4-1-5-7 示例效果一 图4-1-5-8 示例效果二 图4-1-5-9 示例效果三 图4-1-5-10 示例效果四 体验二:同时打两个页面,依次点击,您会发现一个改成功,一个没有改成功。但页面都没有报错,只是update返回影响行数一个为1,另一个为0而已。 图4-1-5-11 编辑宠物商品库存 图4-1-5-12 宠物商品库存列表 注:增加了乐观锁,我们在写代码的时候一定要注意,单记录更新操作的时候要去判断返回结果(影响行数),不然没改成功,程序是不会抛错的。不像batch接口默认会报错 Step4 预留任务:重写PetItemInventroy的update函数 留个任务,请各位小伙伴自行测试玩玩,这样会更有体感 package pro.shushi.pamirs.demo.core.action; import org.springframework.stereotype.Component; import pro.shushi.pamirs.demo.api.enumeration.DemoExpEnumerate; import pro.shushi.pamirs.demo.api.model.PetItemInventroy; import pro.shushi.pamirs.demo.api.model.PetTalent; import pro.shushi.pamirs.meta.annotation.Function; import pro.shushi.pamirs.meta.annotation.Model; import pro.shushi.pamirs.meta.common.exception.PamirsException; import pro.shushi.pamirs.meta.constant.FunctionConstants; import pro.shushi.pamirs.meta.enmu.FunctionOpenEnum; import pro.shushi.pamirs.meta.enmu.FunctionTypeEnum; import java.util.ArrayList; import java.util.List; @Model.model(PetItemInventroy.MODEL_MODEL) @Component public class PetItemInventroyAction { @Function.Advanced(type= FunctionTypeEnum.UPDATE) @Function.fun(FunctionConstants.update) @Function(openLevel = {FunctionOpenEnum.API}) public PetItemInventroy update(PetItemInventroy data){ List<PetItemInventroy> inventroys = new ArrayList<>(); inventroys.add(data); //批量更新会,自动抛错 int i =…

    2024年5月23日
    1.9K00
  • 1.3 Oinone的生态思考

    以“企业级软件生态”的方式去帮助企业建立“一站式的商业智能软件”。 通过观察信息化到数字化的软件行业发展历程(如下图1-3所示),我们可以发现,企业真正需要的是一站式的软件产品。然而,一站式的软件产品往往都是从单个领域的需求满足开始,这在信息化时代和数字化时代都是如此。在信息化时代,以ERP为终点的一站式趋势逐渐形成;而在数字化时代,中台概念的提出则标志着一站式的趋势重新开始。本文将从企业数字化转型所面临的困境出发,探讨Oinone的生态思考。 图1-3 从信息化到数字化软件行业发展历程 1.3.1 与中台的渊源 中台概念的提出标志着企业数字化改造进入了一个新的时代。随着数字化转型不断深入,企业面临着严重的数据割裂、系统隔离等问题。在这样的背景下,“敏捷响应,低成本地快速创新”成为了推动一站式商业智能软件的内在诉求。需要澄清的是,互联网中台架构只是一种企业解决数据割裂、系统隔离,建立一站式商业智能软件的技术概念之一,并不是技术标准。而且这种方式只适用于企业自建模式。在多供应商环境下,则会适得其反,导致建立更复杂的烟囱系统。 阿里于15年提出中台架构概念,抓住了企业数字化转型的核心诉求,即“敏捷响应,低成本快速创新”。然而,阿里作为一家生态公司,在16年时基本上是带着合作伙伴来给企业交付,但由于伙伴对互联网技术的理解和能力的限制,基本上都做得不好,甚至失败。在2017年,阿里成立了原生交付团队,希望能够树立一些标杆案例。我和公司的核心成员也都来自于这个团队。在做完几个客户后,我发现阿里也做不好,但这次做不好的原因不是技术不行或项目上不了线,而是上线以后预期的效果没有达到,其本质是企业的IT组织能力无法驾驭复杂的互联网中台架构。当无法驾驭的时候,所谓的目标“敏捷响应,快速创新”就无从说起了。结果客户会反馈以下三类问题: 不是说敏捷响应吗?为什么改个需求这么慢,不但时间更长,付出的成本也更高了?是因为中台架构需要一定的技术能力和经验才能有效地应用,就像一个只会骑自行车的人给他一辆汽车或者飞机,他也不能驾驭它们,更不用说是手动挡的。 不是说能力中心吗?当引入新供应商或有新场景开发的时候,为什么前期做的能力中心不能支撑了?是因为能力中心是一种面向业务的能力组织方式,它将不同的业务能力抽象出来,以服务的形式对内提供。然而,由于业务场景的差异,不同的业务需要的能力也会不同,因此能力中心需要不断迭代和升级。对于新引入的供应商或新场景开发,需要根据实际情况对能力中心进行定制化和扩展化,但谁来负责呢?新项目的供应商还是客户自己? 不是说性能好吗?为什么我投入的物理资源更多了?是因为中台架构采用微服务来解决单点瓶颈问题,提高系统性能和可用性,但是在初始阶段,投入的资源可能会更多。每个模块至少需要两个实例来保障高可用性,因此物理资源的投入量可能会比以前更多。 1.3.2 找解决方案 在考虑解决方案之前,我们需要思考企业数字化软件的最终状态将是什么样子。目前有两种主要的方案(如下图1-4所示): 第一种是以自建研发团队为核心。中国的大型企业已经开始尝试这种模式,看起来似乎是一个时下比较流行的可行性方案。然而,绝大多数企业由于成本、人才团队等原因而难以坚持下去,只能与供应商合作开发。 第二种是以供应商为核心。由于大多数企业无法选择第一种路径,他们必须接受目前分散的情况,并通过系统集成尽可能拉通各个系统。尽管如此,在数字化时代中,真正意义上的一站式商业智能软件供应商还未出现。 图1-4 企业数字化桎梏和囹圄 对企业来说,这两种方案都非常艰难,但在大规模数字化历程中又不得不做出选择。此外,我们还能清晰看到以下几点: "敏捷响应,低成本地快速创新"成为企业推动一站式商业智能软件的内在诉求 目前没有一家软件供应商能满足企业所有外围商业场景,也不可能有这样的供应商 绝大部分企业需要软件供应商,而不是自建 如何突破这种局面也成为中国软件行业发展的一个机遇。因此,我的思考是: 我们的目标不是依托于提升研发人员的能力,而是降低互联网架构的门槛,让更多企业真正拥有“敏捷响应,低成本快速创新”的能力。 我们的目标不是输出中台方法论,而是提供中台建设的技术平台。 我们的目标不是只服务大企业,而是真正赋能不同IT组织能力的企业,让它们都具备持续创新的能力。 今天,许多中台软件公司告诉企业:“中台是持续演进和快速迭代的过程,因此企业需要组建中台架构团队来实现,而他们则通过中台项目落地将中台建设方法论传授给企业。”这句话的前半部分是正确的,因为我们之前提到企业需要具备敏捷响应业务的能力,即应变能力,因为应变是不断变化的。然而,后半部分是不正确的,因为今天的企业已经有能力组建团队,那么这些中台软件公司到底有什么用呢?企业真的缺少方法论吗?在19年,我就提出了自己的看法:没有低代码能力的中台公司都在收取智商税,都在欺诈,因为很多企业根本找不到足够懂互联网架构的人才。明白流氓在哪里了吗?这些流氓公司赚了很多钱,最后责怪企业无法招到人才,这是企业的责任。因此,仍然认为“最好的赋能是降低门槛,而不是让客户提高技术水平”。 最终,我们得出了一个服务模式的想法:构建企业级的软件生态。企业级软件生态的确切定义是:通过开放的方式,让企业本身以及不同的软件供应商共同参与,遵循相同的技术和数据规范,打造一体化、无需集成的各类企业级软件。如果要打造企业级软件生态,我们列出了六个要点(如下图1-5所示)。 图1-5 打造企业级软件生态需要具备的六大能力 我很幸运地有机会通过“企业级软件生态”的方式,为企业建立“一站式的商业支持平台”提供帮助。我们的Oinone平台结合了低代码开发、通用数据模型和业务产品的优势(如下图1-6所示)。 图1-6 Oinone = 低代码开发平台 + 通用数据模型 + 业务产品 我们对Oinone一站式低代码商业支撑平台展开介绍,它大致分为4部分: 以低代码开发平台为基础,输出具备互联网架构下的软件快速开发标准。这可以帮助企业快速构建符合互联网架构标准的应用程序,从而实现快速响应和低成本创新。 以通用数据模型为基础,满足不同软件基于同一套数据标准的扩展能力。这可以确保不同软件系统之间的数据兼容性和互操作性,避免数据孤岛和信息隔离。 在业务产品层面上,企业和伙伴基于相同的技术标准和数据标准共同提供解决方案。这可以帮助企业和伙伴共同开发出符合标准的商业支撑平台,以提高业务效率和创新能力。 最后是无代码设计器,用于满足项目开展中,超出业务标品范围之外的需求,或者针对标品的临时需求。这可以帮助业务人员在不需要专业软件支持的情况下,自主解决业务需求,并支持部门间的协同工作。 1.3.3 生态建设 Oinone致力于打造全球最大的无需集成的商业应用程序及其生态系统,通过开源内核、汇集数千名开发人员和业务专家,为企业提供成本效益、一体化、模块化的解决方案,解决所有商业需求,让不同技术之间的合作变得简单易行,摆脱烦恼的集成问题。 在客户和场景领域,我们严格限定了自身的专注领域。针对超大型头部企业,我们专注于树立标杆,而对于大、中、小型企业,则交由我们的伙伴来支持。小微企业可以通过我们的开源社区版获得覆盖。在企业数字化转型的核心领域中,我们的解决方案涵盖了数字化交易场景、全渠道订单履约场景、数字化采购场景、数字化营销等产品。在其他领域,我们完全交由伙伴来建设。由于我们自身在企业协同商务领域拥有深厚的背景,因此在该领域提供的产品拥有特别的优势。 企业数字化转型核心领域 图1-7 企业数字化转型核心领域

    2024年5月23日
    2.7K00
  • 3.3.10 字段类型之关系描述的特殊场景

    在3.3.9【字段类型之关系与引用】一文中已经描述了各种关系字段的常规写法,还有一些特殊场景如:关系映射中存在常量,或者M2M中间表是大于两个字段构成。 举例说明关系字段-高级用法 场景描述 PetTalent模型增加talentType字段,PetItem与PetTalent的多对多关系增加talentType(达人类型),PetItemRelPetTalent 中间表维护petItemId、petTalentId以及talentType,PetDogItem和PetCatItem分别重写petTalents 字段,关系中增加常量描述。示意图如下 实际操作步骤: Step1 新增 TalentTypeEnum package pro.shushi.pamirs.demo.api.enumeration; import pro.shushi.pamirs.meta.annotation.Dict; import pro.shushi.pamirs.meta.common.enmu.BaseEnum; @Dict(dictionary = TalentTypeEnum.DICTIONARY,displayName = "达人类型") public class TalentTypeEnum extends BaseEnum<TalentTypeEnum,Integer> { public static final String DICTIONARY ="demo.TalentTypeEnum"; public final static TalentTypeEnum DOG =create("DOG",1,"狗达人","狗达人"); public final static TalentTypeEnum CAT =create("CAT",2,"猫达人","猫达人"); } Step2 PetTalent模型增加talentType字段 package pro.shushi.pamirs.demo.api.model; import pro.shushi.pamirs.demo.api.enumeration.TalentTypeEnum; import pro.shushi.pamirs.meta.annotation.Field; import pro.shushi.pamirs.meta.annotation.Model; @Model.model(PetTalent.MODEL_MODEL) @Model(displayName = "宠物达人",summary="宠物达人",labelFields ={"name"}) public class PetTalent extends AbstractDemoIdModel{ public static final String MODEL_MODEL="demo.PetTalent"; @Field(displayName = "达人") private String name; @Field(displayName = "达人类型") private TalentTypeEnum talentType; } Step3 修改PetItem的petTalents字段,在关系描述中增加talentType(达人类型) @Field.many2many(relationFields = {"petItemId"},referenceFields = {"petTalentId","talentType"},through = "PetItemRelPetTalent") @Field.Relation(relationFields = {"id"}, referenceFields = {"id","talentType"}) @Field(displayName = "推荐达人",summary = "推荐该商品的达人们") private List<PetTalent> petTalents; Step4 PetDogItem增加petTalents字段,重写父类PetItem的关系描述 talentType配置为常量,填入枚举的值 增加domain描述用户页面选择的时候自动过滤出特定类型的达人,RSQL用枚举的name @Field.many2many(relationFields = {"petItemId"},referenceFields = {"petTalentId","talentType"},through = "PetItemRelPetTalent") @Field.Relation(relationFields = {"id"}, referenceFields = {"id","talentType"}) @Field(displayName = "推荐达人",summary = "推荐该商品的达人们") private List<PetTalent> petTalents; Step5 PetCatItem增加petTalents字段,重写父类PetItem的关系描述 talentType配置为常量,填入枚举的值 增加domain描述用户页面选择的时候自动过滤出特定类型的达人,RSQL用枚举的name @Field(displayName = "推荐达人") @Field.many2many( through = "PetItemRelPetTalent", relationFields = {"petItemId"}, referenceFields = {"petTalentId","talentType"} ) @Field.Relation(relationFields = {"id"}, referenceFields = {"id", "#2#"}, domain = " talentType == CAT") private List<PetTalent> petTalents; Step6 清除中间表demo_core_pet_item_rel_pet_talent的数据记录 清除PetItem与PetTalent的多对多中间表demo_core_pet_item_rel_pet_talent的数据记录 Step7 重启看效果 修改达人记录,选择不同达人类型 PetItem、PetCatItem、PetDogItem不同的交互页面

    2024年5月23日
    1.9K00

Leave a Reply

Please Login to Comment