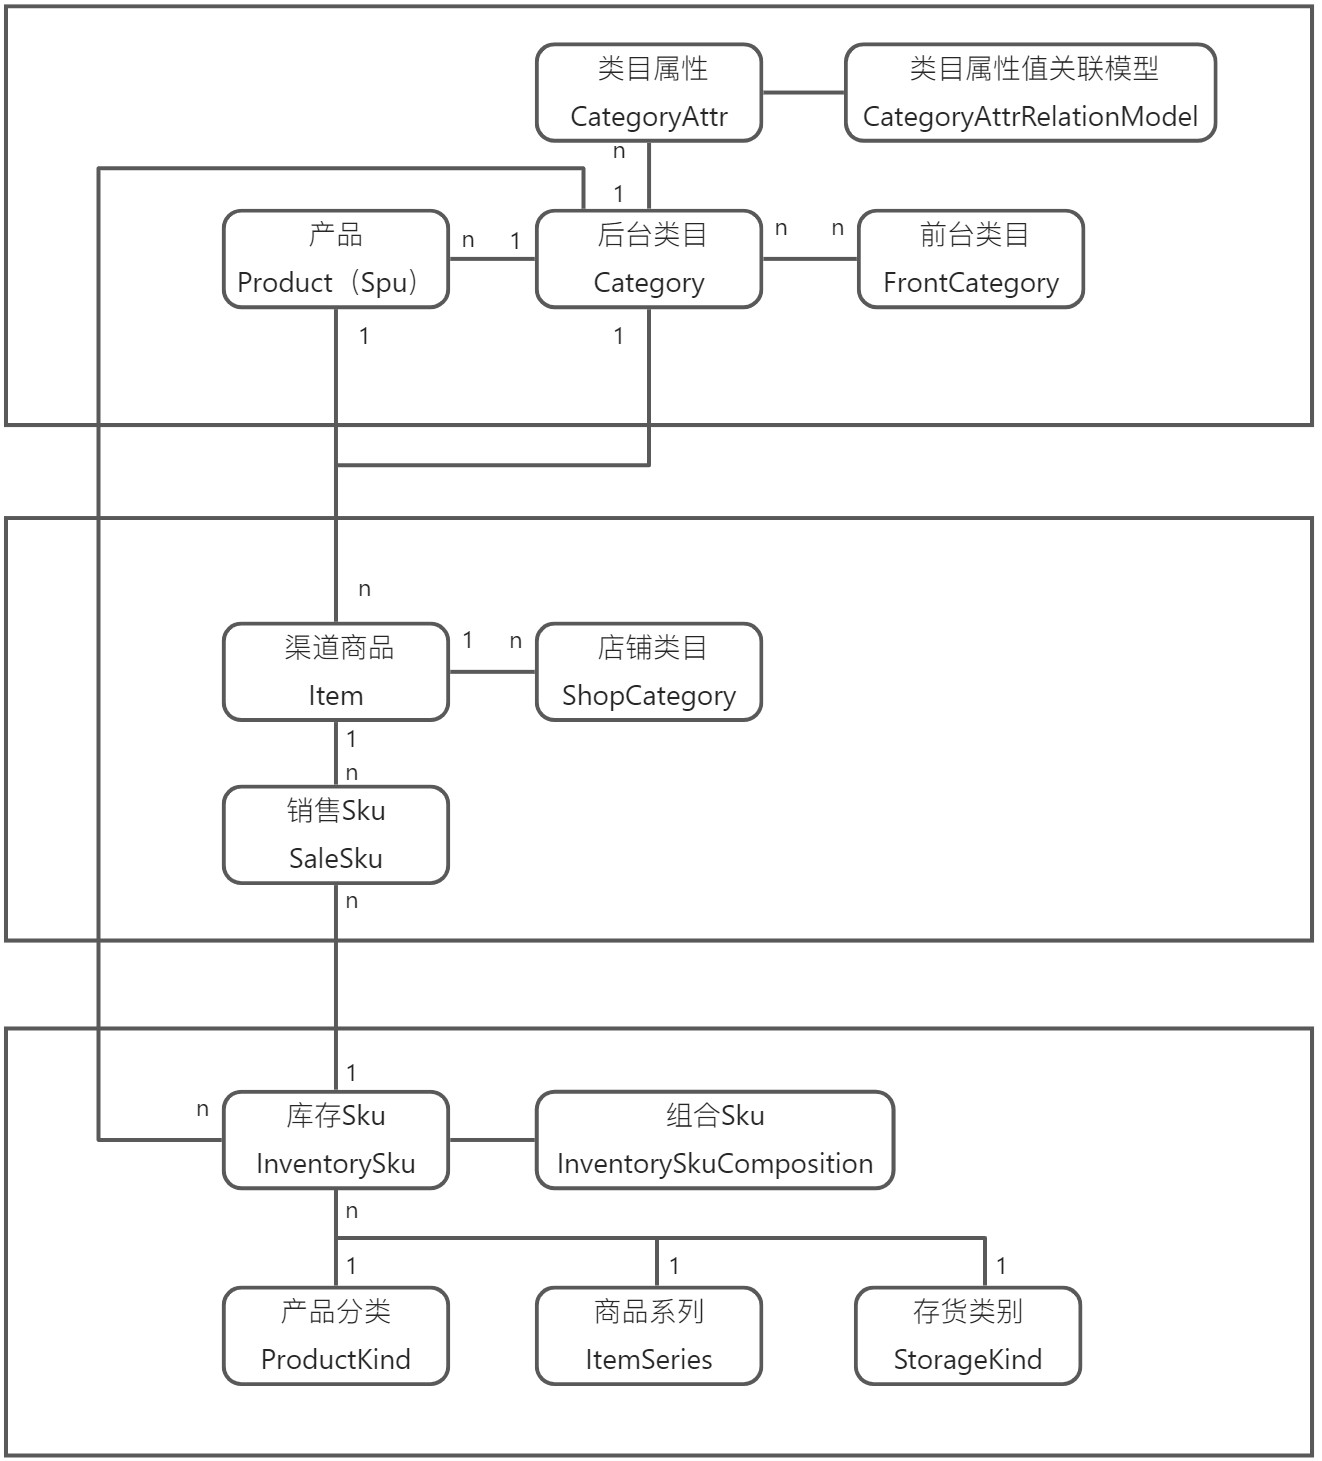
5.6 商业支撑之商品域

一、基础介绍

当业务在线化后,用于内部管理的产品主数据,叠加一堆销售属性变成了商品被推倒了前台,成为导购链路中最最重要的信息载体。看似最基础和最简单的商品模块也有很多门道。主要集中在以下几个方面:

  1. 商品的属性如何管理、呈现、参与导购(类目、搜索的过滤条件)

  2. 如何解决固定不变的内部管理需求与基于销售特性长期变化的运营需求之间的矛盾

  3. 在多渠道情况渠道商品,如何映射到实际sku进行履约

二、模型介绍

5.6 商业支撑之商品域

图5-6-1 模型介绍

  1. 类目属性,解决“商品的属性如何管理、呈现、参与导购(类目、搜索的过滤条件)”

  2. 前后台类目设计,解决“如何解决固定不变的内部管理需求与基于销售特性长期变化的运营需求之间的矛盾”

  3. 销售Sku和库存Sku设计,解决“在多渠道情况渠道商品,如何映射到实际sku进行履约”

要把这些问题搞清楚,得先把名词统一下:

领域 名称 oinone的定义 说明 举例
平台运营视角 Spu Product –>Spu2.1.9 –> 3.0.0 SPU(Standard Product Unit):标准化产品单元。SPU是商品信息聚合的最小单位,是一组可复用、易检索的标准化信息的集合,该集合描述了一个产品的特性 iPhone X可以确定一个产品
后台类目 后台类目(Category) 商品分类分级管理,以及规范该类目下公共属性可以分为普通属性、销售属性 比如类目:3c数码/手机销售属性:内存大小、颜色等普通属性:分辨率
前台类目 前台类目(FrontCategory) 平台导购类目 通过前台类目关联后台类目或后台类目属性,用于满足运营需求
大体上SPU处于最上层、Item属于下一级,而SKU属于最低一层。SPU是平台层面,Item是商家层面,SKU是商家的Item确定销售属性SPU非必须,在平台类交易中,平台方为了规范商家发布商品信息,进行统一运营时需要
商家销售视角 Item 渠道商品(Item) 简单来说是:SPU加上归属商家、以及商家自有的价格与描述 商家A的iPhone X
Sku 销售Sku(SaleSku) SKU=Stock Keeping Unit(库存保有单位)。是对每一个产品和服务的唯一标示符,该系统的使用SKU的值根于数据管理,使公司能够跟踪系统,如仓库和零售商店或产品的库存情况。 iPhone X 64G 银色 则是一个SKU。
店铺类目 ShopCategory 商家店铺导购类目 在平台类电商,商家都会有自己独立的店铺主页,商家类目跟前台类目作用类似,只是局限影响范围为商家店铺内
销售SKU中会有一个InvSkuCode来关联InventorySku,比如:品牌上在不同渠道(淘宝、京东、自建电商)中会有不同的销售SKU,在从渠道同步销售SKU会根据外部code
商家管理视角 产品或库存Sku InventorySku 跟销售领域的sku的定义类似,但销售领域是为了规范购买行为,这里规范企业内部管理。 iPhone X 64G 银色
组合Sku InventorySkuComposition 空调有内外机组合而成,这就是一个组合sku
产品分类 ProductKind 企业内部管理划分
商品系列 ItemSeries 指互相关联或相似的产品,是按照一定的分类标准对企业生产经营的全部产品进行划分的结果。一个产品系列内往往包括多个产品项目。产品系列的划分标准有产品功能、消费上的连带性、面向的顾客群、分销渠道、价格范围等
存货类别 StorageKind 为了反映存货的组成内容,正确计算产品的生产成本以及销售成本,会计上必须对存货进行科学地分类,按存货的不同类别进行核算

表5-6-1 各领域名称说明

Oinone社区 作者:史, 昂原创文章,如若转载,请注明出处:https://doc.oinone.top/oio4/9321.html

访问Oinone官网:https://www.oinone.top获取数式Oinone低代码应用平台体验

Like (0)
史, 昂's avatar史, 昂数式管理员
Previous 2024年5月23日 am8:17
Next 2024年5月23日 am8:19

相关推荐

  • 1.3 Oinone的生态思考

    以“企业级软件生态”的方式去帮助企业建立“一站式的商业智能软件”。 通过观察信息化到数字化的软件行业发展历程(如下图1-3所示),我们可以发现,企业真正需要的是一站式的软件产品。然而,一站式的软件产品往往都是从单个领域的需求满足开始,这在信息化时代和数字化时代都是如此。在信息化时代,以ERP为终点的一站式趋势逐渐形成;而在数字化时代,中台概念的提出则标志着一站式的趋势重新开始。本文将从企业数字化转型所面临的困境出发,探讨Oinone的生态思考。 图1-3 从信息化到数字化软件行业发展历程 1.3.1 与中台的渊源 中台概念的提出标志着企业数字化改造进入了一个新的时代。随着数字化转型不断深入,企业面临着严重的数据割裂、系统隔离等问题。在这样的背景下,“敏捷响应,低成本地快速创新”成为了推动一站式商业智能软件的内在诉求。需要澄清的是,互联网中台架构只是一种企业解决数据割裂、系统隔离,建立一站式商业智能软件的技术概念之一,并不是技术标准。而且这种方式只适用于企业自建模式。在多供应商环境下,则会适得其反,导致建立更复杂的烟囱系统。 阿里于15年提出中台架构概念,抓住了企业数字化转型的核心诉求,即“敏捷响应,低成本快速创新”。然而,阿里作为一家生态公司,在16年时基本上是带着合作伙伴来给企业交付,但由于伙伴对互联网技术的理解和能力的限制,基本上都做得不好,甚至失败。在2017年,阿里成立了原生交付团队,希望能够树立一些标杆案例。我和公司的核心成员也都来自于这个团队。在做完几个客户后,我发现阿里也做不好,但这次做不好的原因不是技术不行或项目上不了线,而是上线以后预期的效果没有达到,其本质是企业的IT组织能力无法驾驭复杂的互联网中台架构。当无法驾驭的时候,所谓的目标“敏捷响应,快速创新”就无从说起了。结果客户会反馈以下三类问题: 不是说敏捷响应吗?为什么改个需求这么慢,不但时间更长,付出的成本也更高了?是因为中台架构需要一定的技术能力和经验才能有效地应用,就像一个只会骑自行车的人给他一辆汽车或者飞机,他也不能驾驭它们,更不用说是手动挡的。 不是说能力中心吗?当引入新供应商或有新场景开发的时候,为什么前期做的能力中心不能支撑了?是因为能力中心是一种面向业务的能力组织方式,它将不同的业务能力抽象出来,以服务的形式对内提供。然而,由于业务场景的差异,不同的业务需要的能力也会不同,因此能力中心需要不断迭代和升级。对于新引入的供应商或新场景开发,需要根据实际情况对能力中心进行定制化和扩展化,但谁来负责呢?新项目的供应商还是客户自己? 不是说性能好吗?为什么我投入的物理资源更多了?是因为中台架构采用微服务来解决单点瓶颈问题,提高系统性能和可用性,但是在初始阶段,投入的资源可能会更多。每个模块至少需要两个实例来保障高可用性,因此物理资源的投入量可能会比以前更多。 1.3.2 找解决方案 在考虑解决方案之前,我们需要思考企业数字化软件的最终状态将是什么样子。目前有两种主要的方案(如下图1-4所示): 第一种是以自建研发团队为核心。中国的大型企业已经开始尝试这种模式,看起来似乎是一个时下比较流行的可行性方案。然而,绝大多数企业由于成本、人才团队等原因而难以坚持下去,只能与供应商合作开发。 第二种是以供应商为核心。由于大多数企业无法选择第一种路径,他们必须接受目前分散的情况,并通过系统集成尽可能拉通各个系统。尽管如此,在数字化时代中,真正意义上的一站式商业智能软件供应商还未出现。 图1-4 企业数字化桎梏和囹圄 对企业来说,这两种方案都非常艰难,但在大规模数字化历程中又不得不做出选择。此外,我们还能清晰看到以下几点: "敏捷响应,低成本地快速创新"成为企业推动一站式商业智能软件的内在诉求 目前没有一家软件供应商能满足企业所有外围商业场景,也不可能有这样的供应商 绝大部分企业需要软件供应商,而不是自建 如何突破这种局面也成为中国软件行业发展的一个机遇。因此,我的思考是: 我们的目标不是依托于提升研发人员的能力,而是降低互联网架构的门槛,让更多企业真正拥有“敏捷响应,低成本快速创新”的能力。 我们的目标不是输出中台方法论,而是提供中台建设的技术平台。 我们的目标不是只服务大企业,而是真正赋能不同IT组织能力的企业,让它们都具备持续创新的能力。 今天,许多中台软件公司告诉企业:“中台是持续演进和快速迭代的过程,因此企业需要组建中台架构团队来实现,而他们则通过中台项目落地将中台建设方法论传授给企业。”这句话的前半部分是正确的,因为我们之前提到企业需要具备敏捷响应业务的能力,即应变能力,因为应变是不断变化的。然而,后半部分是不正确的,因为今天的企业已经有能力组建团队,那么这些中台软件公司到底有什么用呢?企业真的缺少方法论吗?在19年,我就提出了自己的看法:没有低代码能力的中台公司都在收取智商税,都在欺诈,因为很多企业根本找不到足够懂互联网架构的人才。明白流氓在哪里了吗?这些流氓公司赚了很多钱,最后责怪企业无法招到人才,这是企业的责任。因此,仍然认为“最好的赋能是降低门槛,而不是让客户提高技术水平”。 最终,我们得出了一个服务模式的想法:构建企业级的软件生态。企业级软件生态的确切定义是:通过开放的方式,让企业本身以及不同的软件供应商共同参与,遵循相同的技术和数据规范,打造一体化、无需集成的各类企业级软件。如果要打造企业级软件生态,我们列出了六个要点(如下图1-5所示)。 图1-5 打造企业级软件生态需要具备的六大能力 我很幸运地有机会通过“企业级软件生态”的方式,为企业建立“一站式的商业支持平台”提供帮助。我们的Oinone平台结合了低代码开发、通用数据模型和业务产品的优势(如下图1-6所示)。 图1-6 Oinone = 低代码开发平台 + 通用数据模型 + 业务产品 我们对Oinone一站式低代码商业支撑平台展开介绍,它大致分为4部分: 以低代码开发平台为基础,输出具备互联网架构下的软件快速开发标准。这可以帮助企业快速构建符合互联网架构标准的应用程序,从而实现快速响应和低成本创新。 以通用数据模型为基础,满足不同软件基于同一套数据标准的扩展能力。这可以确保不同软件系统之间的数据兼容性和互操作性,避免数据孤岛和信息隔离。 在业务产品层面上,企业和伙伴基于相同的技术标准和数据标准共同提供解决方案。这可以帮助企业和伙伴共同开发出符合标准的商业支撑平台,以提高业务效率和创新能力。 最后是无代码设计器,用于满足项目开展中,超出业务标品范围之外的需求,或者针对标品的临时需求。这可以帮助业务人员在不需要专业软件支持的情况下,自主解决业务需求,并支持部门间的协同工作。 1.3.3 生态建设 Oinone致力于打造全球最大的无需集成的商业应用程序及其生态系统,通过开源内核、汇集数千名开发人员和业务专家,为企业提供成本效益、一体化、模块化的解决方案,解决所有商业需求,让不同技术之间的合作变得简单易行,摆脱烦恼的集成问题。 在客户和场景领域,我们严格限定了自身的专注领域。针对超大型头部企业,我们专注于树立标杆,而对于大、中、小型企业,则交由我们的伙伴来支持。小微企业可以通过我们的开源社区版获得覆盖。在企业数字化转型的核心领域中,我们的解决方案涵盖了数字化交易场景、全渠道订单履约场景、数字化采购场景、数字化营销等产品。在其他领域,我们完全交由伙伴来建设。由于我们自身在企业协同商务领域拥有深厚的背景,因此在该领域提供的产品拥有特别的优势。 企业数字化转型核心领域 图1-7 企业数字化转型核心领域

    2024年5月23日
    2.7K00
  • 7.1 设计器总览

    设计器转为非专业研发设计,在Oinone3.0版本中已经完成元数据完整在线化,真正做到低无一体。对于设计器的定位我们开篇就介绍过,它是LCDP的产品化呈现,是冰山露在外面大家看得到的,核心还是在LCDP本身。我们先目睹下设计器的一些产品页面,如您有想体验,可以在Oinone官网注册 模型设计器 Oinone以模型为驱动,当有模型、数据字典、数据编码等设计功能,我们就可以完整地定义产品数据模型,模型设计器整体呈现区别于普通ER图,以当前模型为核心视角展开,可以点击关联模型切换主视角。这样的好处在于突出当前设计,聚焦设计本身。同时模型上预留了几个核心入口如:分类管理、继承拓扑图、页面设计、逻辑设计等。另外我们在体验上区分了专家模式和经典模式,顾名思义,专家模式的功能会更加丰富,对专业知识的要求也会更高。专家模式下一般会增加一些跟业务无关的配置如:索引设置等调优行为 逻辑设计器 从图灵完备的角度上说,要支持功能越完备,使用越复杂。我们优先从图灵完备的角度出发,所以我们第一版逻辑设计器相对比较复杂,第二版本规划中会类似模型设计器推出专家版和经典版。 界面设计器 界面设计器第一版会先支撑后端页面在线自定义,后边将陆续推出前端页面、多端能力。为了支持多端和2C页面的设计,我们对前后端协议做了比较大的改造。目前设计器已经支持完全基于V3的前后端协议。 数据可视化 数据可视化支持从内部系统模型获取数据内容后,根据业务需求自定义图表,目的是为企业提供更高效的数据分析工具。 与市场同类产品相比,我们的数据可视化产品:不需要前置维护数据源、进行数据转换;可智取业务系统模型,系统自动解析选择的模型、接口、表格中的字段后进行数据分析;降低对数据分析人员研发能力要求的同时,也提升了数据分析的效率。 流程设计器 Oinone流程设计器为业务流程和审批流程提供了可自动执行的流程模型:通过定义流转过程中的各个动作、规则,以此实现流程自动化。在Oinone流程设计器中,流程可以跨应用设计,不同应用的模型之间可以通过同一流程执行。

    2024年5月23日
    2.2K00
  • 4.1.8 函数之事务管理

    一、事务管理介绍 函数Function支持事务字段为isTransaction(默认为false),事务传播行为propagationBehavior(默认PROPAGATION_SUPPORTS),事务隔离级别isolationLevel(默认使用数据库默认的事务隔离级别),所以不会默认为函数添加事务。另外事务配置提供全局配置。 平台事务管理兼容Spring声明式与编程式事务,支持多数据源事务管理。事务管理中多数据源嵌套独立事务,不会造成死锁风险。使用多数据源或分表操作,不会导致脏读。如果需要多数据源分布式事务,请使用PamirsTransational分布式事务管理方案(@PamirsTransational(enableXa=true))。分布式事务一般用于量小的跨模块配置管理场景 使用方式 声明式事务,使用@PamirsTransactional注解在需要事务管理的类或方法上标注。在非无代码场景下,与@Transactional注解功能一致。 编程式事务,使用PamirsTransactionTemplate即可。在非无代码场景下,与TransactionTemplate功能一致。 配置式事务,使用TxConfig模型在模块安装时初始化存储事务配置数据。 事务特性 原子性 (atomicity):强调事务的不可分割. 一致性 (consistency):事务的执行的前后数据的完整性保持一致. 隔离性 (isolation):一个事务执行的过程中,不应该受到其他事务的干扰 持久性(durability) :事务一旦结束,数据就持久到数据库 事务隔离级别 事务隔离级别指的是一个事务对数据的修改与另一个并行的事务的隔离程度,当多个事务同时访问相同数据时,如果没有采取必要的隔离机制,就可能发生以下问题: 问题 描述 脏读 一个事务读到另一个事务未提交的更新数据,所谓脏读,就是指事务A读到了事务B还没有提交的数据,比如银行取钱,事务A开启事务,此时切换到事务B,事务B开启事务–>取走100元,此时切换回事务A,事务A读取的肯定是数据库里面的原始数据,因为事务B取走了100块钱,并没有提交,数据库里面的账务余额肯定还是原始余额,这就是脏读 不可重复读 在一个事务里面的操作中发现了未被操作的数据 比方说在同一个事务中先后执行两条一模一样的select语句,期间在此次事务中没有执行过任何DDL语句,但先后得到的结果不一致,这就是不可重复读 幻读 是指当事务不是独立执行时发生的一种现象,例如第一个事务对一个表中的数据进行了修改,这种修改涉及到表中的全部数据行。 同时,第二个事务也修改这个表中的数据,这种修改是向表中插入一行新数据。那么,以后就会发生操作第一个事务的用户发现表中还有没有修改的数据行,就好象 发生了幻觉一样。 表4-1-8-1 事务隔离级别 Pamirs(Spring)支持的隔离级别 隔离级别 描述 DEFAULT 使用数据库本身使用的隔离级别 ORACLE(读已提交) MySQL(可重复读) READ_UNCOMITTED 读未提交(脏读)最低的隔离级别,一切皆有可能。 READ_COMMITED 读已提交,ORACLE默认隔离级别,有不可重复读以及幻读风险。 REPEATABLE_READ 可重复读,解决不可重复读的隔离级别,但还是有幻读风险。 SERLALIZABLE 串行化,最高的事务隔离级别,不管多少事务,挨个运行完一个事务的所有子事务之后才可以执行另外一个事务里面的所有子事务,这样就解决了脏读、不可重复读和幻读的问题了 表4-1-8-2 隔离级别与描述 隔离级别 脏读可能性 不可重复读可能性 幻读可能性 加锁度 READ_UNCOMITTED 是 是 是 否 READ_COMMITED 否 是 是 否 REPEATABLE_READ 否 否 是 否 SERLALIZABLE 否 否 否 是 表4-1-8-3 隔离级别说明表 事务的传播行为 保证同一个事务中 PROPAGATION_REQUIRED 支持当前事务,如果不存在 就新建一个(默认) PROPAGATION_SUPPORTS 支持当前事务,如果不存在,就不使用事务 PROPAGATION_MANDATORY 支持当前事务,如果不存在,抛出异常 保证没有在同一个事务中 PROPAGATION_REQUIRES_NEW 如果有事务存在,挂起当前事务,创建一个新的事务 PROPAGATION_NOT_SUPPORTED 以非事务方式运行,如果有事务存在,挂起当前事务 PROPAGATION_NEVER 以非事务方式运行,如果有事务存在,抛出异常 PROPAGATION_NESTED 如果当前事务存在,则嵌套事务执行 A中嵌套B事务,嵌套PROPAGATION_REQUIRES_NEW方法勿与A在同类中。 异常状态 PROPAGATION_REQUIRES_NEW (两个独立事务) PROPAGATION_NESTED (B的事务嵌套在A的事务中) PROPAGATION_REQUIRED (同一个事务) A抛异常 B正常 A回滚,B正常提交 A与B一起回滚 A与B一起回滚 A正常 B抛异常 1.如果A中捕获B的异常,并没有继续向上抛异常,则B先回滚,A再正常提交; 2.如果A未捕获B的异常,默认则会将B的异常向上抛,则B先回滚,A再回滚 B先回滚,A再正常提交 A与B一起回滚 A抛异常B抛异常 B先回滚,A再回滚 A与B一起回滚 A与B一起回滚 A正常 B正常 B先提交,A再提交 A与B一起提交 A与B一起提交 表4-1-8-4 事务传播行为 二、声明式事务(举例) Step1 修改PetShopBatchUpdateAction 用@PamirsTransactional或者@Transactional注解来声明事务,PamirsTransactional跟Spring的Transactional区别在于PamirsTransactional支持多库事务,但此多库事务为非严格的分布式多库事务,之所以选择这个方案,原因如下 a. 不损害任何性能。 b. 事务保障率超过4个9 c. 经过阿里的大厂验证,特别是在阿里的结算平台中得到了很好的验证 @PamirsTransactional更多配置项请详见4.1.7【函数之元数据详解】一文,自己多试试。同时@PamirsTransactional百分百兼容@Transactional @Action(displayName = "确定",bindingType = ViewTypeEnum.FORM,contextType = ActionContextTypeEnum.SINGLE) @PamirsTransactional //@Transactional public PetShopBatchUpdate conform(PetShopBatchUpdate data){ if(data.getPetShopList() == null || data.getPetShopList().size()==0){ throw PamirsException.construct(DemoExpEnumerate.PET_SHOP_BATCH_UPDATE_SHOPLIST_IS_NULL).errThrow(); } List<PetShopProxy> proxyList = data.getPetShopList(); for(PetShopProxy petShopProxy:proxyList){ petShopProxy.setDataStatus(data.getDataStatus()); } new PetShopProxy().updateBatch(proxyList); throw PamirsException.construct(DemoExpEnumerate.SYSTEM_ERROR).errThrow(); // return data; } 图4-1-8-1 修改PetShopBatchUpdateAction Step2 重启看效果 进入店铺管理列表页,选择记录点击【批量更新数据状态】按钮,修改记录的数据状态为【未启用】,提交看效果。期望效果为:提示系统异常,数据修改失败 图4-1-8-2 数据状态显示已启用 图4-1-8-3 批量更新数据状态…

    2024年5月23日
    1.8K00
  • 4.1.25 框架之搜索引擎

    一、使用场景 在碰到大数据量并且需要全文检索的场景,我们在分布式架构中基本会架设ElasticSearch来作为一个常规解决方案。在oinone体系中增强模型就是应对这类场景,其背后也是整合了ElasticSearch。 二、整体介绍 oinone与es整合设计图 图4-1-25-1 Oinone与es整合设计图 基础环境安装 Canal安装 详见4.1.10【函数之触发与定时】一文 修改Canal配置并重启 新增Canal的实例【destinaion: pamirs】,监听分表模型的binlog【filter: demo.demo_core_sharding_model……】用于增量同步 pamirs: middleware: data-source: jdbc-url: jdbc:mysql://localhost:3306/canal_tsdb?useUnicode=true&characterEncoding=utf-8&verifyServerCertificate=false&useSSL=false&requireSSL=false driver-class-name: com.mysql.cj.jdbc.Driver username: root password: oinone canal: ip: 127.0.0.1 port: 1111 metricsPort: 1112 zkClusters: – 127.0.0.1:2181 destinations: – destinaion: pamirschangedata name: pamirschangedata desc: pamirschangedata slaveId: 1235 filter: demo\.demo_core_pet_talent dbUserName: root dbPassword: oinone memoryStorageBufferSize: 65536 topic: CHANGE_DATA_EVENT_TOPIC dynamicTopic: false dbs: – { address: 127.0.0.1, port: 3306 } – destinaion: pamirs id: 1234 name: pamirs desc: pamirs slaveId: 1234 filter: demo\.demo_core_sharding_model_0,demo\.demo_core_sharding_model_1,demo\.demo_core_sharding_model_2,demo\.demo_core_sharding_model_3,demo\.demo_core_sharding_model_4,demo\.demo_core_sharding_model_5,demo\.demo_core_sharding_model_6,demo\.demo_core_sharding_model_7 dbUserName: root dbPassword: oinone memoryStorageBufferSize: 65536 topic: BINLOG_EVENT_TOPIC dynamicTopic: false dbs: – { address: 127.0.0.1, port: 3306 } tsdb: enable: true jdbcUrl: "jdbc:mysql://127.0.0.1:3306/canal_tsdb" userName: root password: oinone mq: rocketmq rocketmq: namesrv: 127.0.0.1:9876 retryTimesWhenSendFailed: 5 dubbo: application: name: canal-server version: 1.0.0 registry: address: zookeeper://127.0.0.1:2181 protocol: name: dubbo port: 20881 scan: base-packages: pro.shushi server: address: 0.0.0.0 port: 10010 sessionTimeout: 3600 图4-1-25-2 修改Canal配置并重启 ES安装 下载安装包官方下载地址,也可以直接下载elasticsearch-8.4.1-darwin-x86_64.tar.gz.txt(361.7 MB),下载后去除后缀.txt,然后解压文件 替换安装目录/config下的[elasticsearch.yml](elasticsearch)(1 KB),主要是文件中追加了三个配置 xpack.security.enabled: false xpack.security.http.ssl.enabled: false xpack.security.transport.ssl.enabled: false 图4-1-25-3 elasticsearc.yml追加三个配置 启动 a. 导入环境变量(ES运行时需要JDK18及以上版本JDK运行环境, ES安装包中包含了一个JDK18版本) # export JAVA_HOME=/Users/oinone/Documents/oinone/es/elasticsearch-8.4.1/jdk.app/Contents/Home/ export JAVA_HOME=ES解压安装目录/jdk.app/Contents/Home/ 图4-1-25-4 导入环境变量 b. 运行ES ## nohup /Users/oinone/Documents/oinone/es/elasticsearch-8.4.1/bin/elasticsearch >> $TMPDIR/elastic.log 2>&1 & nohup ES安装目录/bin/elasticsearch >> $TMPDIR/elastic.log 2>&1 & 图4-1-25-5 运行ES 停止ES lsof…

    2024年5月23日
    1.7K00
  • 流程设计

    1.流程设计 进入流程设计页之后可以进行流程名称、流程说明的编辑,可以进行流程设计,流程参数配置,保存和发布。 1.1 流程配置 点击进入流程配置页面,若需要配置一些参数供流程使用,可在此添加和删除。删除流程参数时,若该参数已在流程中被使用则无法删除。参数支持文本、数值、日期、布尔四种类型。 1.2 保存 点击后流程设计进行存档,流程设计不完整也支持保存,下次进入流程设计回到保存的页面。 1.3 发布 第一次发布时右上角发布显示文字为发布流程,后续发布按钮显示文字为更新发布。发布后流程才会按照设计触发,首次发布和更新发布的逻辑一致,若流程中有未解决的错误则无法发布不成功,发布成功后页面跳转到显示全部流程的页面,流程状态为已启用、已更新。

    2024年6月20日
    1.6K00

Leave a Reply

Please Login to Comment