4.1.5 模型之持久层配置

一、批量操作

批量操作包括批量创建与批量更新。批量操作的提交类型系统默认值为batchCommit。

批量提交类型:

  • useAffectRows,循环单次单条脚本提交,返回实际影响行数
  • useAndJudgeAffectRows,循环单次单条脚本提交,返回实际影响行数,若实际影响行数与输入不一致,抛出异常
  • collectionCommit,将多个单条更新脚本拼接成一个脚本提交,不能返回实际影响行数
  • batchCommit,使用单条更新脚本批量提交,不能返回实际影响行数。

全局配置

pamirs:
    mapper:
    batch: batchCommit

图4-1-5-1 全局配置

运行时配置

非乐观锁模型系统默认采用batchCommit提交更新操作;乐观锁模型默认采用useAndJudgeAffectRows提交更新操作。也可以使用以下方式在运行时改变批量提交方式。

Spider.getDefaultExtension(BatchApi.class).run(() -> {
    更新逻辑
}, 批量提交类型枚举);

图4-1-5-2 运行时配置

运行时校正

如果模型配置了数据库自增主键,而批量新增的批量提交类型为batchCommit,则系统将批量提交类型变更为collectionCommit(如果使用batchCommit,则需要单条提交以获得正确的主键返回值,性能有所损失)。

如果模型配置了乐观锁,而批量更新的批量提交类型为collectionCommit或者batchCommit,则系统将批量提交类型变更为useAndJudgeAffectRows。也可以失效乐观锁,让系统不做批量提交类型变更处理。

二、乐观锁(举例)

在一些会碰到并发修改的数据,往往需要进行并发控制,一般数据库层面有两种一种是悲观锁、一种是乐观锁。oinone对乐观锁进行了良好支持

定义方式

乐观锁的两种定义方式:

  • 通过快捷继承VersionModel,构建带有乐观锁,唯一编码code且主键为id的模型。

  • 可以在字段上使用@Field.Version注解来标识该模型更新数据时使用乐观锁

如果更新的实际影响行数与入参数量不一致,则会抛出异常,错误码为10150024。如果是批量更新数据,为了返回准确的实际影响行数,批量更新由批量提交改为循环单条数据提交更新,性能有所损失。

失效乐观锁

一个模型在某些场景下需要使用乐观锁来更新数据,而另一些场景不需要使用乐观锁来更新数据,则可以使用以下方式在一些场景下失效乐观锁。更多元位指令用法详见4.1.9【函数之元位指令】一文。

PamirsSession.directive().disableOptimisticLocker();
try{
    更新逻辑
} finally {
    PamirsSession.directive().enableOptimisticLocker();
}

图4-1-5-3 失效乐观锁

不抛乐观锁异常

将批量提交类型设置为useAffectRows即可,这样可改由外层逻辑对返回的实际影响行数进行自主判断。

Spider.getDefaultExtension(BatchApi.class).run(() -> {
    更新逻辑,返回实际影响行数
}, BatchCommitTypeEnum.useAffectRows);

图4-1-5-4 将批量提交类型设置为useAffectRows

构建第一个VersionModel

Step1 新建PetItemInventroy模型,继承快捷模型VersionModel

package pro.shushi.pamirs.demo.api.model;

import pro.shushi.pamirs.meta.annotation.Field;
import pro.shushi.pamirs.meta.annotation.Model;
import pro.shushi.pamirs.meta.base.common.VersionModel;

import java.math.BigDecimal;

@Model.model(PetItemInventroy.MODEL_MODEL)
@Model(displayName = "宠物商品库存",summary="宠物商品库存",labelFields = {"itemName"})
public class PetItemInventroy extends VersionModel {
    public static final String MODEL_MODEL="demo.PetItemInventroy";

    @Field(displayName = "商品名称")
    private String itemName;

    @Field(displayName = "库存数量")
    private BigDecimal quantity;

}

图4-1-5-5 新建PetItemInventroy模型

Step2 修改DemoMenu,增加访问入口

@UxMenu("商品库存")@UxRoute(PetItemInventroy.MODEL_MODEL) class PetItemInventroyMenu{}

图4-1-5-6 修改DemoMenu

Step3 重启看效果

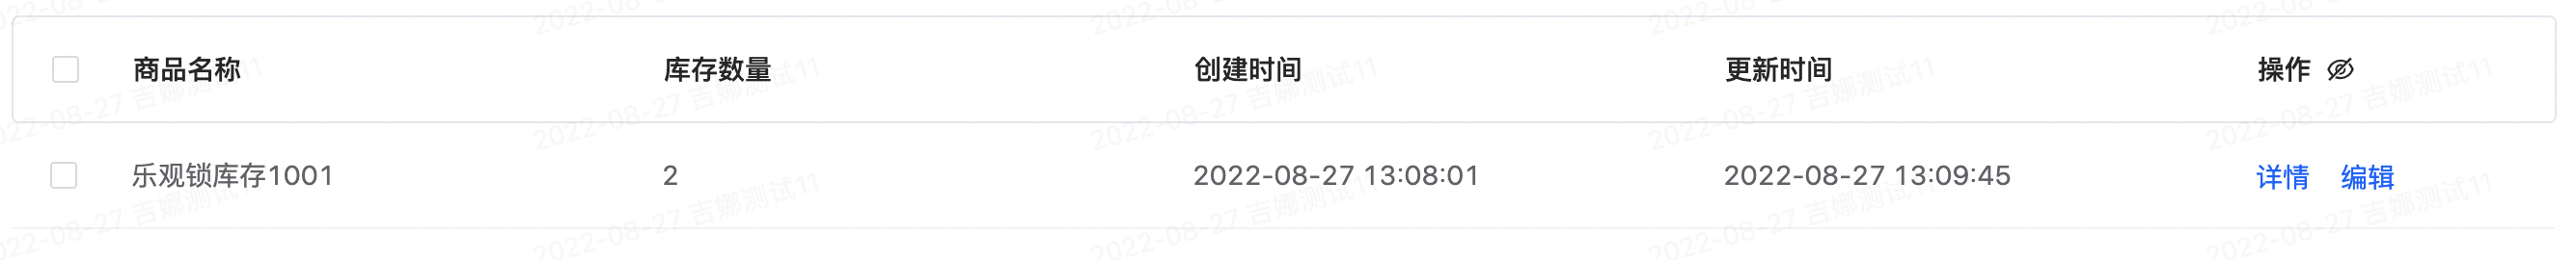
体验一:页面上新增、修改数据库字段中的opt_version会自动加一

image.png

图4-1-5-7 示例效果一

image.png

图4-1-5-8 示例效果二

image.png

图4-1-5-9 示例效果三

image.png

图4-1-5-10 示例效果四

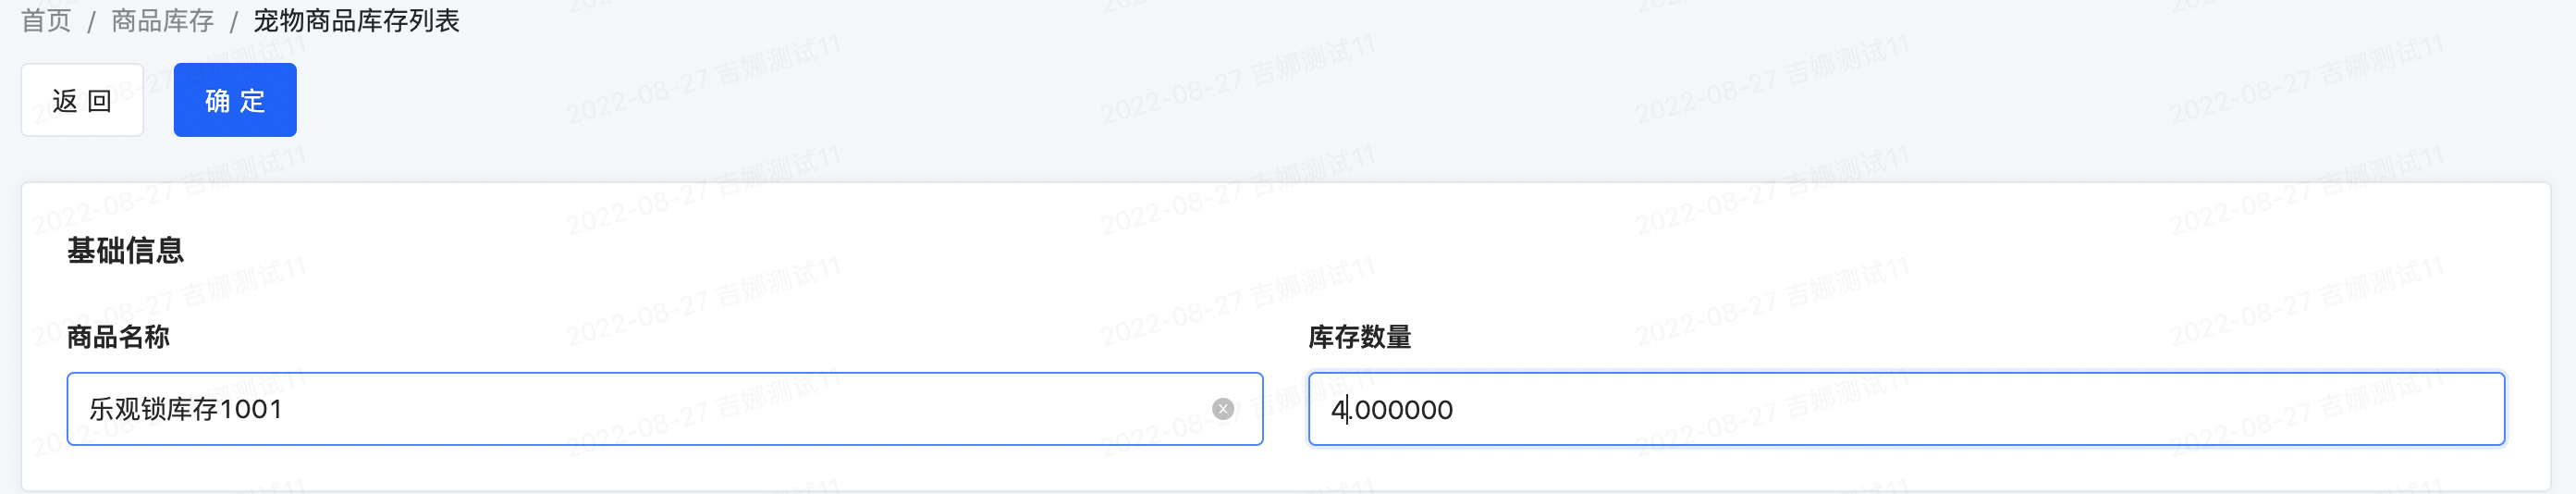
体验二:同时打两个页面,依次点击,您会发现一个改成功,一个没有改成功。但页面都没有报错,只是update返回影响行数一个为1,另一个为0而已。
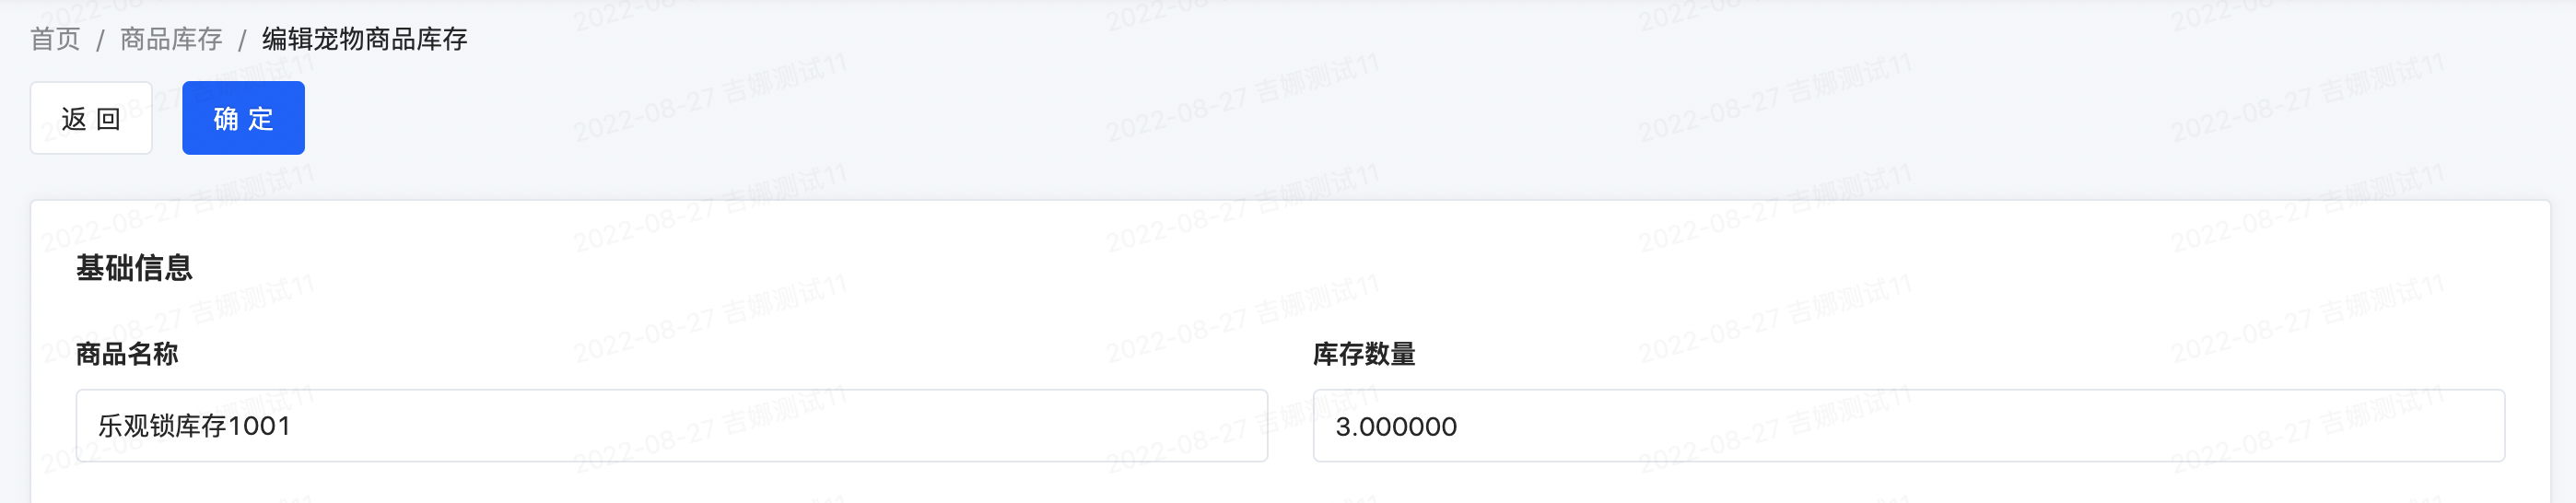
image.png

图4-1-5-11 编辑宠物商品库存

image.png

图4-1-5-12 宠物商品库存列表

注:增加了乐观锁,我们在写代码的时候一定要注意,单记录更新操作的时候要去判断返回结果(影响行数),不然没改成功,程序是不会抛错的。不像batch接口默认会报错

Step4 预留任务:重写PetItemInventroy的update函数

留个任务,请各位小伙伴自行测试玩玩,这样会更有体感

package pro.shushi.pamirs.demo.core.action;

import org.springframework.stereotype.Component;
import pro.shushi.pamirs.demo.api.enumeration.DemoExpEnumerate;
import pro.shushi.pamirs.demo.api.model.PetItemInventroy;
import pro.shushi.pamirs.demo.api.model.PetTalent;
import pro.shushi.pamirs.meta.annotation.Function;
import pro.shushi.pamirs.meta.annotation.Model;
import pro.shushi.pamirs.meta.common.exception.PamirsException;
import pro.shushi.pamirs.meta.constant.FunctionConstants;
import pro.shushi.pamirs.meta.enmu.FunctionOpenEnum;
import pro.shushi.pamirs.meta.enmu.FunctionTypeEnum;

import java.util.ArrayList;
import java.util.List;

@Model.model(PetItemInventroy.MODEL_MODEL)
@Component
public class PetItemInventroyAction {

    @Function.Advanced(type= FunctionTypeEnum.UPDATE)
    @Function.fun(FunctionConstants.update)
    @Function(openLevel = {FunctionOpenEnum.API})
    public PetItemInventroy update(PetItemInventroy data){
        List<PetItemInventroy> inventroys = new ArrayList<>();
        inventroys.add(data);
        //批量更新会,自动抛错
        int i = data.updateBatch(inventroys);
        //单记录更新,不自动抛售需要自行判断
//        int i = data.updateById();
//        if(i!=1){
//            throw PamirsException.construct(DemoExpEnumerate.PET_ITEM_INVENTROY_UPDATE_VERSION_ERROR).errThrow();
//        }
        return data;
    }

}

图4-1-5-13 重写PetItemInventroy的update函数

注意事项:

如果是自定义页面需要把optVersion字段配置到视图的xml中去,可以配置为隐藏 。例子中因为默认页面已经自动带上了optVersion,所以容易被人忽视掉。

Oinone社区 作者:史, 昂原创文章,如若转载,请注明出处:https://doc.oinone.top/oio4/9280.html

访问Oinone官网:https://www.oinone.top获取数式Oinone低代码应用平台体验

Like (0)
史, 昂's avatar史, 昂数式管理员
Previous 2024年5月23日 am8:58
Next 2024年5月23日

相关推荐

  • 流程类

    1.流程类 1.1 审批 审批节点配置步骤: 添加审批节点 选择审批的模型和视图 设置审批人和通过方式 设置审批人在审批时的操作权限和数据权限 1.1.1 审批节点 审批节点只能放置在有数据可审批的流程链路上,审批分支只能放置在审批节点后。 1.1.2 审批模型和视图 可选的审批模型包含添加的审批节点之前的所有能获取到数据的模型。可选视图为该选择的数据模型关联的界面设计器中视图类型为表单的页面。 1.1.3 审批人和通过方式 审批人可在个人、部门、角色和模型中的字段里复选。当某人在不同类型人员选择中被重复选中,只会收到一次审批的代办。若为多人审批,审批是同步进行的。 单人审批: 通过方式:唯一通过方式,同意通过,拒绝否决 多人审批: 通过方式:或签/会签(默认或签) a. 或签(一名审批人同意或拒绝即可) 任意一位审批人操作通过或否决后流程就结束,其他审批人无法进入审批操作,但是会弹出消息提示审批结果。 场景:紧急且影响不大的审批可以由任意一位领导层或签。 b. 会签(需所有审批人同意才为同意,一名审批人拒绝即为拒绝) 场景:影响比较重大的审批,一票否决的形式决定是否通过。 c. 会签(一名审批人同意即为同意,需所有审批人拒绝才为拒绝) 场景:需要评估项目可操作性时,若有领导觉得有意义就通过,进入下一步评估,全员否决就否决项目。 1.1.4 操作&数据权限 操作权限 可设置是否必填拒绝原因、是否允许转交、是否允许加签、是否允许退回。 选择允许转交或允许加签之后,可选择添加人员的候选名单,不填默认所有人都可选。 选择允许退回后,可以选择退回到该审批节点之前的任意审批节点。ps:需所有审批人拒绝才为拒绝的会签不允许退回。 数据权限 选择视图后自动显示该视图下的数据字段,可选择的权限为查看、编辑、隐藏数据字段,默认可查看全部字段。 1.1.5 参与人重复 勾选参与人重复的场景时,满足场景的审批流程会由系统自动审批通过。 1.2 填写 当流程需要某些人提交数据才能继续时,可以使用填写这个动作。区别于数据类中的操作,填写这个动作只能修改当前触发模型中关联的视图表单,而数据类中的更新数据可以修改其他模型中的数据。 和审批动作相似,填写动作需要选择填写的模型和视图表单,需要选择填写人,可以选择添加转交权限。另外,填写动作必须包含一个及以上的可编辑的数据权限供操作人填写。

    2024年5月23日
    2.6K00
  • 4.1.2 模块之启动指令

    针对不同启动指令的组合可以满足不同场景需求,下面列举了几个常规组合方式,小伙伴们务必把这几种模式都尝试一遍,会更有体感 本节为小伙伴讲解oinone模块的几种启动方式,它是为能灵活地应对企业市场的不同场景需求,为op(本地化部署)、saas和研发提供个性化支撑。也为oinone独特性之单体与分布式的灵活切换提供基础支撑 一、部署参数 参数 名称 默认值 说明 -Plifecycle 生命周期部署指令 RELOAD 可选项:无/INSTALL/PACKAGE/RELOAD/DDL安装-install为AUTO;upgrade为FORCE打包-install为AUTO;upgrade为FORCE;profile为PACKAGE重启-install、upgrade、profile为READONLY打印变更DDL-install为AUTO;upgrade为FORCE;profile为DDL 表4-1-2-1 部署参数 如果在启动命令中配置了部署参数,可不再设置服务参数和可选项参数。下图为在启动命令中添加部署参数的示例。 图4-1-2-1 在启动命令中添加部署参数的示例 二、使用场景 针对不同启动指令的组合可以满足不同场景需求,下面列举了几个常规组合方式,小伙伴们务必把这几种模式都尝试一遍,会更有体感。 场景一:DDL(1)+RELOAD(N)应对专有DBA 因为很多公司数据库是由专门的DBA来管理的,不允许应用直接变更数据库相关配置、表结构、初始化数据。而oinone是基于元数据驱动的,任何模型、行为的变化都会自动转化成对物理存储的改变与元数据变化。 oinone为了适用企业op场景,特别增加了DDL模式。把发布上线分为两个步骤。 一:用DDL模式把涉及到数据库的变更与元数据初始化的脚本进行输出,交由客户公司DBA审批,并执行 二:用RELOAD模式,进行正常的应用重启工作,不进行安装、升级、以及数据库物理变革等操作。 #应用启动关闭自动DDL配置 pamirs.boot.profile: CUSTOMIZE pamirs.boot.options.rebuildTable: false pamirs.persistence.global.auto-create-database: false pamirs.persistence.global.auto-create-table: false 图4-1-2-2 应用启动关闭自动DDL模式 场景二:PACKAGE(1)+RELOAD(N)应对提升多机器实例效率 在机器规模相对大的场景中我们会碰到以下问题: 元数据差量计算、数据库变更、元数据变化保存都非常费时,如果每台机器都来一遍是非常费时费力的 分布式下多机器如果并发进行INSTALL,会导致数据库修改表结构、元数据变化保存锁死 所以我们可以选择一台机器用PACKAGE,其他机器采用RELOAD模式,做到合理规避问题,提升应用发布效率 场景三:INSTALL应对开发模式 研发在本地开发模式下INSTALL是最有效率的,把所需依赖模块一把启动和调试。 上线如果要用INSTALL需要注意,要逐台进行。当然也可以改进成INSTALL(1)+RELOAD(N)模式 三、启动命令解读 查看启动命令 可以在启动日志中查看当前所用启动命令。 图4-1-2-3 在启动日志中查看当前所用启动命令 生命周期管理-Plifecycle 除了通过启动YAML中pamirs.boot属性来设置启动参数,你还可以在应用启动命令中使用-Plifecycle参数来快捷控制模块生命周期的管理方式。该参数的可选项为RELOAD、INSTALL、CUSTOM_INSTALL、PACKAGE、DDL。 java -jar <your jar name>.jar -Plifecycle=RELOAD 启动命令优先级高于YAML中pamirs.boot属性中的install、upgrade和profile属性。如果不使用-Plifecycle参数,则使用YAML中pamirs.boot属性中的install、upgrade和profile属性配置。若YAML中未配置,则采用默认值。 启动配置项 默认值 RELOAD INSTALL CUSTOM_INSTALL PACKAGE DDL install AUTO READONLY AUTO AUTO AUTO AUTO upgrade AUTO READONLY FORCE FORCE FORCE FORCE profile CUSTOMIZE READONLY AUTO CUSTOMIZE PACKAGE DDL 表4-1-2-2 Plifecycle可选项与启动项对应表 profile属性请参考4.1.1【服务启动可选项】一文。只有pamirs.boot.profile=CUSTOMIZE时,在pamirs.boot.options中自定义的可选项才生效。 自动建表-PbuildTable java -jar <your jar name>.jar -PbuildTable=NEVER PbuildTable参数用于设置自动构建表结构的方式。如果不使用该参数,则options属性的默认值请参考4.1.1【服务启动可选项】一文。-PbuildTable参数可选项为: NEVER – 不自动构建表结构,会将pamirs.boot.options中的diffTable和rebuildTable属性设置为false EXTEND – 增量构建表结构,会将pamirs.boot.options中的diffTable属性设置为false,rebuildTable属性设置为true DIFF – 差量构建表结构,会将pamirs.boot.options中的diffTable和rebuildTable属性设置为true 模块在线 -PmoduleOnline java -jar <your jar name>.jar -PmoduleOnline=CHECK PmoduleOnline参数用于设置模块在线的方式。如果不使用该参数,则profile属性的默认值请参考4.1.1【服务启动可选项】一文。-PmoduleOnline参数可选项为: NEVER – 不读取存储在数据库中的模块信息,会将pamirs.boot.options中的reloadModule和checkModule属性设置为false READ – 读取存储在数据库中的模块信息,会将pamirs.boot.options中的checkModule属性设置为false,reloadModule属性设置为true CHECK – 读取存储在数据库中的模块信息并校验依赖模块是否已安装,会将pamirs.boot.options中的reloadModule和checkModule属性设置为true 元数据在线-PmetaOnline java -jar <your jar name>.jar -PmetaOnline=MODULE PmetaOnline参数用于设置元数据在线的方式,如果不使用该参数,则profile属性的默认值请参考4.1.1【服务启动可选项】一文。-PmetaOnline参数可选项为: NEVER – 不持久化元数据,会将pamirs.boot.options中的updateModule、reloadMeta和updateMeta属性设置为false MODULE – 只注册模块信息,会将pamirs.boot.options中的updateModule属性设置为true,reloadMeta和updateMeta属性设置为false ALL – 注册持久化所有元数据,会将pamirs.boot.options中的updateModule、reloadMeta和updateMeta属性设置为true 开放远程服务-PenableRpc PenableRpc参数用于设置是否开启远程服务。如果不使用该参数,则profile属性的默认值请参考4.1.1【服务启动可选项】一文。-PenableRpc参数可选项为true和false。该参数会将参数值设置到pamirs.boot.options中的publishService属性。 开启API服务-PopenApi PopenApi参数用于设置是否开启HTTP API服务。如果不使用该参数,则profile属性的默认值请参考4.1.1【服务启动可选项】一文。-PopenApi参数可选项为true和false。该参数会将参数值设置到pamirs.boot.options中的rebuildHttpApi属性。 开启字段校验-PcheckField PcheckField参数用于设置是否开启字段校验。-PcheckField参数可选项为true和false。由于通常应用的字段数量非常多,会延长系统启动时长,所以默认不会开启字段校验。 启用数据初始化服务-PinitData PinitData参数用于设置是否开启数据初始化服务。如果不使用该参数,则profile属性的默认值请参考4.1.1【服务启动可选项】一文。-PinitData参数可选项为true和false。该参数会将参数值设置到pamirs.boot.options中的updateData属性。 四、不使用自动构建数据库表功能 Oinone LCDP默认提供框架的所有服务,所以会自动构建数据库表。如果不需要使用Oinone的存储构建服务,可以设置YAML文件中关于自动建表的配置。这样就不会动态构建数据库表,你可以手动搭建数据库表。 通过配置启动YAML中pamirs.boot.options.rebuildTable为false彻底关闭自动建表功能。 pamirs: boot: options: rebuildTable: false 图4-1-2-4 不使用自动构建数据库表功能 也可以按需配置启动YAML中pamirs.persistence配置来关闭部分数据源的自动建表功能。persistence配置既可以针对全局也可以分数据源进行配置。 pamirs: persistence: global: # 是否自动创建数据库的全局配置,默认为true autoCreateDatabase: true # 是否自动创建数据表的全局配置,默认为true autoCreateTable: true <your ds key>: # 是否自动创建数据库的数据源配置,默认为true autoCreateDatabase: true # 是否自动创建数据表的数据源配置,默认为true…

    2024年5月23日
    1.5K00
  • 【附件一】下载说明

    章节说明 下载内容 下载地址 备注 3.1.1环境准备>环境准备(Mac版) 安装 jdk 1.8 https://www.oracle.com/java/technologies/downloads/#java8 安装 mysql 8.0.26 https://dev.mysql.com/downloads/mysql/ 安装 idea社区版2020.2.4 https://www.jetbrains.com/idea/download/other.html 安装idea插件 请移至Oinone官网https://www.oinone.top/对应页面下载或联系Oinone官方客服 根据各自Idea版本下载对应插件,下载文件后去除.txt后缀 安装 git 2.2.0 https://sourceforge.net/projects/git-osx-installer/files/git-2.15.0-intel-universal-mavericks.dmg/download?use_mirror=nchc 安装 GraphQL的客户端工具 Insomnia 请移至Oinone官网https://www.oinone.top/对应页面下载或联系Oinone官方客服 下载文件后修改文件名去除.txt后缀 安装 maven https://archive.apache.org/dist/maven/maven-3/3.8.1/binaries/ 安装脚本zk https://archive.apache.org/dist/zookeeper/zookeeper-3.5.8/apache-zookeeper-3.5.8-bin.tar.gz 安装脚本rocketmq https://archive.apache.org/dist/rocketmq/4.7.1/rocketmq-all-4.7.1-bin-release.zip 安装脚本redis https://download.redis.io/releases/redis-5.0.2.tar.gz 安装nvm https://github.com/nvm-sh/nvm/blob/master/README.md 3.1.1环境搭建>环境准备(Windows版) 安装JDK 1.8 https://www.oracle.com/java/technologies/downloads/#java8 安装 Apache Maven 3.8+ https://maven.apache.org/download.cgi 下载settings-develop.xml 请移至Oinone官网https://www.oinone.top/对应页面下载或联系Oinone官方客服 下载到 C:\Users\你的用户名.m2 目录中并重命名为settings.xml 安装 Jetbrains IDEA 2020.2.4 https://www.jetbrains.com/idea/download/other.html 安装 Jetbrains IDEA 2020.2.4需下载插件 https://pan.baidu.com/share/init?surl=HNzSxxH0KncvglkfITUrsA 提取密码: mdji 安装idea插件 请移至Oinone官网https://www.oinone.top/对应页面下载或联系Oinone官方客服 根据各自Idea版本下载对应插件,下载文件后去除.txt后缀 安装MySQL 8 https://dev.mysql.com/downloads/mysql/ 安装Git https://git-scm.com/download/win 安装GraphQL测试工具Insomnia https://github.com/Kong/insomnia/releases 安装RocketMQ https://rocketmq.apache.org/download/ 安装ElasticSearch 版本 8.4.1 https://www.elastic.co/cn/downloads/past-releases/elasticsearch-7-6-1 安装Redis https://download.redis.io/releases/ Zookeeper安装 https://dlcdn.apache.org/zookeeper/zookeeper-3.8.0/apache-zookeeper-3.8.0-bin.tar.gz 安装nodejs 版本12.12.0 https://nodejs.org/dist/v12.12.0/node-v12.12.0-win-x64.zip 安装cnpm https://www.npmjs.com/package/cnpm 3.2.1Oinone一模块为组织>构建第一个Module 安装archetype-project-generate.sh脚本 请移至Oinone官网https://www.oinone.top/对应页面下载或联系Oinone官方客服 3.5.5Oinone以交互为外在>设计器的结合 安装Docker https://www.docker.com/get-started/ 下载结构包:Oinone-op-ds.zip 请移至Oinone官网https://www.oinone.top/对应页面下载或联系Oinone官方客服 4.1.10后端高级特性>函数之触发与定时 下载canal中间件:pamirs-middleware-canal-deployer-3.0.1.zi 请移至Oinone官网https://www.oinone.top/对应页面下载或联系Oinone官方客服 4.1.11后端高级特性>函数之异步执行 下载tbSchedule的控制台jar包:pamirs-middleware-schedule-console-3.0.1.jar.txt 请移至Oinone官网https://www.oinone.top/对应页面下载或联系Oinone官方客服 下载schedule.json 请移至Oinone官网https://www.oinone.top/对应页面下载或联系Oinone官方客服 下载以下文件放在pamirs-demo-boot的src/main/resources/init目录下 4.1.25后端高级特性>框架之搜索引擎 ES安装 方式一:官方下载安装包:https://www.elastic.co/cn/downloads/past-releases/elasticsearch-8-4-1 下载后去除后缀.txt,然后解压文件 方式二:请移至Oinone官网https://www.oinone.top/对应页面下载或联系Oinone官方客服

    Oinone 7天入门到精通 2024年5月23日
    2.4K00
  • 4.1.19 框架之网关协议-后端占位符

    在我们日常开发中会有碰到一些特殊场景,需要由前端来传一些如“当前用户Id”、“当前用户code”诸如此类只有后端才知道值的参数,那么后端占位符就是来解决类似问题的。如前端传${currentUserId},后端会自动替换为当前用户Id。 Step1 后端定义占位符 我们新建一个UserPlaceHolder继承AbstractPlaceHolderParser,用namespace来定义一个“currentUserId”的占位符,其对应值由value()决定为“PamirsSession.getUserId().toString()”,active要为真才有效,priority为优先级 package pro.shushi.pamirs.demo.core.placeholder; import org.springframework.stereotype.Component; import pro.shushi.pamirs.meta.api.session.PamirsSession; import pro.shushi.pamirs.user.api.AbstractPlaceHolderParser; @Component public class UserPlaceHolder extends AbstractPlaceHolderParser { @Override protected String value() { return PamirsSession.getUserId().toString(); } @Override public Integer priority() { return 10; } @Override public Boolean active() { return Boolean.TRUE; } @Override public String namespace() { return "currentUserId"; } } 图4-1-19-1 后端定义占位符 Step2 前端使用后端占位符 我们经常在o2m和m2m中会设置domain来过滤数据,这里案例就是在field中设置来过滤条件,domain="createUid == $#{currentUserId}",注意这里用的是$#{currentUserId} 而不是${currentUserId},这是前端为了区分真正变量和后端占位符,提交的时候会把#过滤掉提交。修改宠物达人表格视图的Template中search部分 <template slot="search" cols="4"> <field data="name" label="达人"/> <field data="petTalentSex" multi="true" label="达人性别"/> <field data="creater" /> <!– <field data="petShops" label="宠物商店" domain="createUid == ${activeRecord.creater.id}"/>–> <field data="petShops" label="宠物商店" domain="createUid == $#{currentUserId}"/> <field data="dataStatus" label="数据状态" multi="true"> <options> <option name="DRAFT" displayName="草稿" value="DRAFT" state="ACTIVE"/> <option name="NOT_ENABLED" displayName="未启用" value="NOT_ENABLED" state="ACTIVE"/> <option name="ENABLED" displayName="已启用" value="ENABLED" state="ACTIVE"/> <option name="DISABLED" displayName="已禁用" value="DISABLED" state="ACTIVE"/> </options> </field> <field data="createDate" label="创建时间"/> <field data="unStore" /> </template> 图4-1-19-2 前端使用后端占位符 Step3 重启看效果 请求上都带上了createUid==${currentUserId} 图4-1-19-3 示例效果

    2024年5月23日
    2.6K00
  • 4.1.24 框架之分库分表

    随着数据库技术的发展如分区设计、分布式数据库等,业务层的分库分表的技术终将成老一辈程序员的回忆,谈笑间扯扯蛋既羡慕又自吹地说到“现在的研发真简单,连分库分表都不需要考虑了”。竟然这样为什么要写这篇文章呢?因为现今的数据库虽能解决大部分场景的数据量问题,但涉及核心业务数据真到过亿数据后性能加速降低,能给的方案都还有一定的局限性,或者说性价比不高。相对性价比比较高的分库分表,也会是现阶段一种不错的补充。言归正传oinone的分库分表方案是基于Sharding-JDBC的整合方案,所以大家得先具备一点Sharding-JDBC的知识。 一、分表(举例) 做分库分表前,大家要有一个明确注意的点就是分表字段的选择,它是非常重要的,与业务场景非常相关。在明确了分库分表字段以后,甚至在功能上都要做一些妥协。比如分库分表字段在查询管理中做为查询条件是必须带上的,不然效率只会更低。 Step1 新建ShardingModel模型 ShardingModel模型是用于分表测试的模型,我们选定userId作为分表字段。分表字段不允许更新,所以这里更新策略设置类永不更新,并在设置了在页面修改的时候为readonly package pro.shushi.pamirs.demo.api.model; import pro.shushi.pamirs.boot.base.ux.annotation.field.UxWidget; import pro.shushi.pamirs.boot.base.ux.annotation.view.UxForm; import pro.shushi.pamirs.meta.annotation.Field; import pro.shushi.pamirs.meta.annotation.Model; import pro.shushi.pamirs.meta.enmu.FieldStrategyEnum; @Model.model(ShardingModel.MODEL_MODEL) @Model(displayName = "分表模型",summary="分表模型",labelFields ={"name"} ) public class ShardingModel extends AbstractDemoIdModel { public static final String MODEL_MODEL="demo.ShardingModel"; @Field(displayName = "名称") private String name; @Field(displayName = "用户id",summary = "分表字段",immutable=true/* 不可修改 **/) @UxForm.FieldWidget(@UxWidget(readonly = "scene == 'redirectUpdatePage'"/* 在编辑页面只读 **/ )) @Field.Advanced(updateStrategy = FieldStrategyEnum.NEVER) private Long userId; } 图4-1-24-1 新建ShardingModel模型 Step2 配置分表策略 配置ShardingModel模型走分库分表的数据源pamirsSharding 为pamirsSharding配置数据源以及sharding规则 a. pamirs.sharding.define用于oinone的数据库表创建用 b. pamirs.sharding.rule用于分表规则配置 pamirs: load: sessionMode: true framework: system: system-ds-key: base system-models: – base.WorkerNode data: default-ds-key: pamirs ds-map: base: base modelDsMap: "[demo.ShardingModel]": pamirsSharding #配置模型对应的库 图4-1-24-2 指定模型对应数据源 pamirs: sharding: define: data-sources: ds: pamirs pamirsSharding: pamirs #申明pamirsSharding库对应的pamirs数据源 models: "[trigger.PamirsSchedule]": tables: 0..13 "[demo.ShardingModel]": tables: 0..7 table-separator: _ rule: pamirsSharding: #配置pamirsSharding库的分库分表规则 actual-ds: – pamirs #申明pamirsSharding库对应的pamirs数据源 sharding-rules: # Configure sharding rule ,以下配置跟sharding-jdbc配置一致 – tables: demo_core_sharding_model: #demo_core_sharding_model表规则配置 actualDataNodes: pamirs.demo_core_sharding_model_${0..7} tableStrategy: standard: shardingColumn: user_id shardingAlgorithmName: table_inline shardingAlgorithms: table_inline: type: INLINE props: algorithm-expression: demo_core_sharding_model_${(Long.valueOf(user_id) % 8)} props: sql.show: true 图4-1-24-3 分库分表规则配置 Step3 配置测试入口 修改DemoMenus类增加一行代码,为测试提供入口 @UxMenu("分表模型")@UxRoute(ShardingModel.MODEL_MODEL) class ShardingModelMenu{} 图4-1-24-4 配置测试入口 Step4 重启看效果 自行尝试增删改查 观察数据库表与数据分布 图4-1-24-5 自行尝试增删改查 图4-1-24-6 观察数据库表与数据分布 二、分库分表(举例) Step1 新建ShardingModel2模型 ShardingModel2模型是用于分库分表测试的模型,我们选定userId作为分表字段。分库分表字段不允许更新,所以这里更新策略设置类永不更新,并在设置了在页面修改的时候为readonly package pro.shushi.pamirs.demo.api.model; import pro.shushi.pamirs.boot.base.ux.annotation.field.UxWidget; import pro.shushi.pamirs.boot.base.ux.annotation.view.UxForm; import…

    2024年5月23日
    1.6K00

Leave a Reply

Please Login to Comment