3.1.1 环境准备(Mac版)

工欲善其事,必先利其器。

在进行学习前,大家务必先检查环境。为了降低大家环境准备难度,基础环境全程用安装包无脑模式进行环境配置,安装请从附件下载(提供mac版本安装包,其他操作系统请自行网上下载与安装)。

后端相关

基础环境准备

安装 jdk 1.8 (下载地址见书籍【附件一】)

安装 mysql 8.0.26 (下载地址见书籍【附件一】)

  1. 安装mysql,并配置环境变量详见本文中的【环境变量设置】部分

  2. 如果mysql启动失败则,在命令行加执行以下命令

Shell
mysqld --initalize-insecure
sudo chmod -R a+rwx /usr/local/mysql/data/

图3-1-1 mysql启动失败需执行的命令

安装 idea社区版 (官方下载链接见书籍【附件一】)

  1. 根据不同版本下载不同的idea插件 (联系Oinone官方客服)

b. 点击Preferences菜单(快捷键 comand+,)

c. 选择Plugins,进入插件管理页面,接下来按图操作就可以了

d. 3.1.1 环境准备(Mac版)
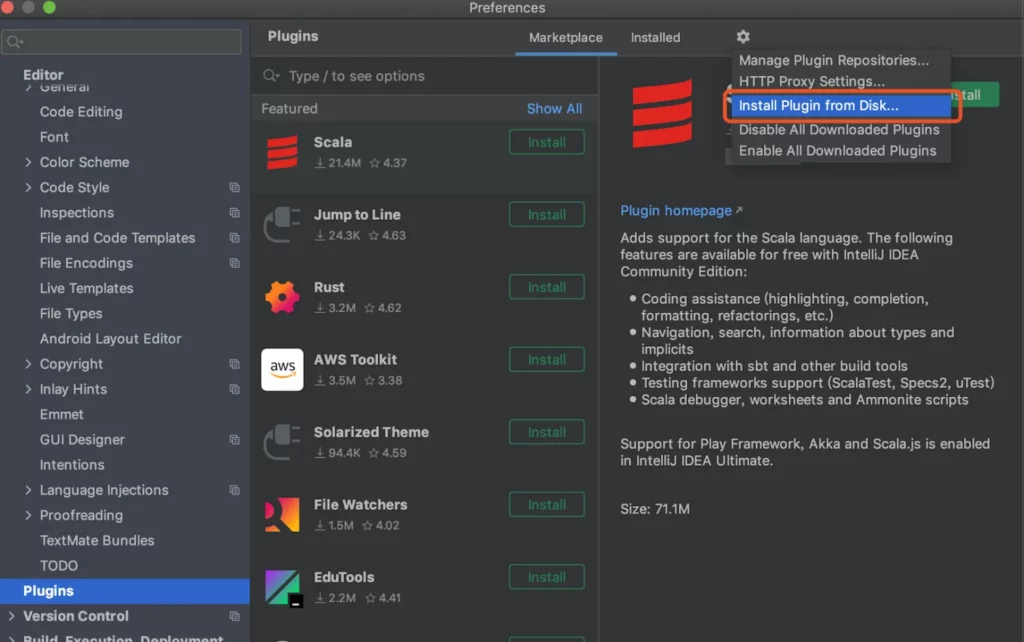
图3-1-3 插件管理页面操作示意

e. 选择.zip文件,不需要解压

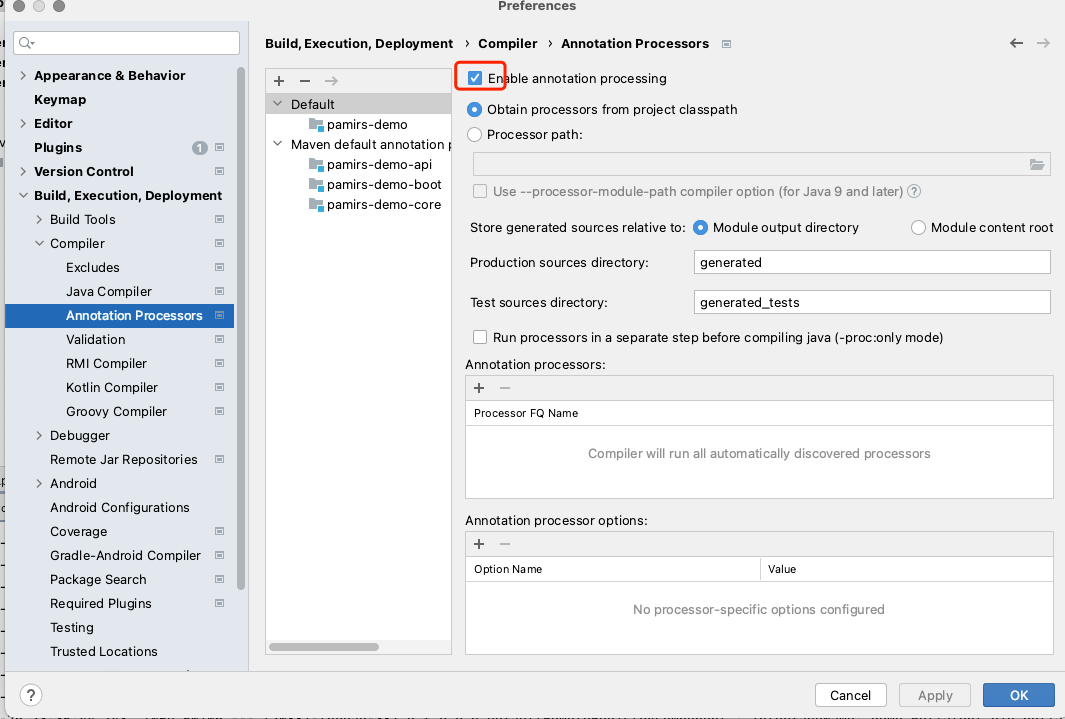
  1. 如果安装了Lombok,请禁用

  2. idea的Java Complier,不然java反射获取方法入参名会变成arg*,导致元数据默认取值出错。或者pom中加入Complier插件,此方法为正解,不然上线也会有问题,我们学习的工程都会选用mvn插件方式
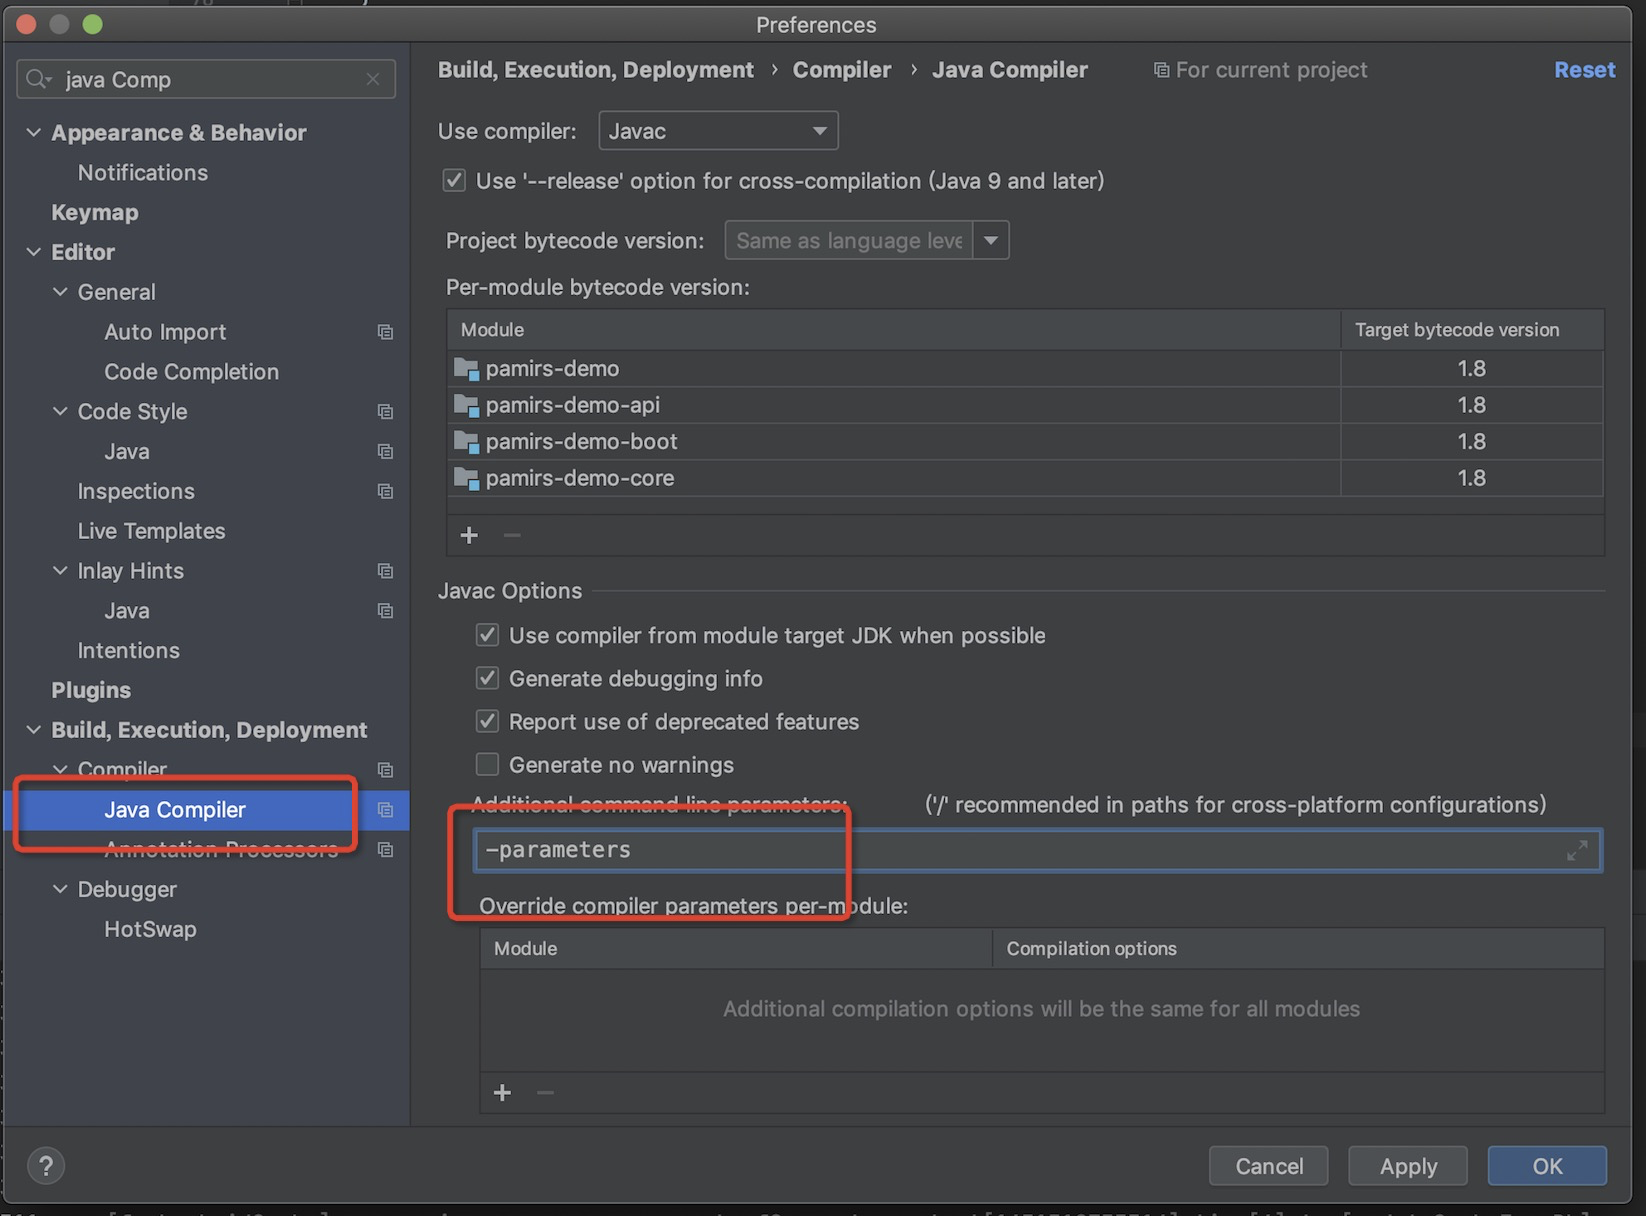
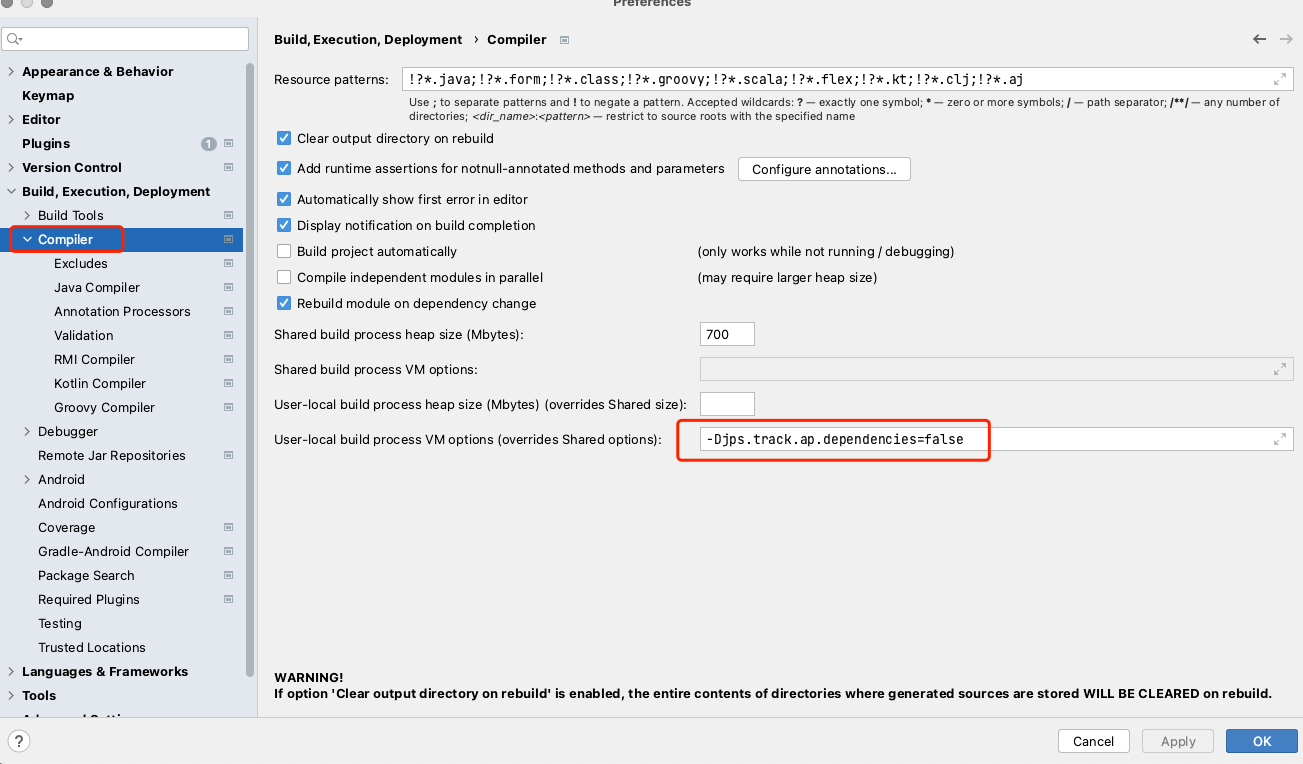
3.1.1 环境准备(Mac版)

图3-1-4 界面操作示意图

3.1.1 环境准备(Mac版)

图3-1-5 界面操作示意图

3.1.1 环境准备(Mac版)

图3-1-6 界面操作示意图

<plugin>
    <groupId>org.apache.maven.plugins</groupId>
    <artifactId>maven-compiler-plugin</artifactId>
    <configuration>
        <compilerArgument>-parameters</compilerArgument>
        <source>${maven.compiler.source}</source>
        <target>${maven.compiler.source}</target>
        <encoding>${project.build.sourceEncoding}</encoding>
    </configuration>
</plugin>

图3-1-7 pom文件代码

安装 dataGrip 最新版本的

过期就去删“ ~/Library/Application\ Support/JetBrains/DataGrip202xxxx”相关的目录,无限期试用,或者安装其他mysql GUI 工具

安装 git 2.2.0(下载地址见书籍【附件一】)

安装 GraphQL的客户端工具 Insomnia

第一次使用可以参考3.2.1【构建第一个Module】一文中在模块启动后如何用该工具验证后端启动成功,更多使用技巧自行百度,Insomnia.Core-2022.4.2.dmg.txt(186.9 MB)(下载地址见书籍【附件一】),下载文件后修改文件名去除.txt后缀

安装 maven ,并配置环境变量(下载地址见书籍【附件一】)

  1. 配置mvn的settings,下载附件settings-open.xml,并重命名为settings.xml,建议直接放在~/.m2/下面。下载地址见oinone开源社区群公告,也可以联系oinone合作伙伴或服务人员

  2. 把settings.xml拷贝一份到maven安装目录conf目录下

环境变量设置 vi ~/.bash_profile ,并执行 source ~/.bash_profile

##按实际情况设置
export PATH=$PATH:/usr/local/mysql/bin
export PATH=$PATH:/usr/local/mysql/support-files
export JAVA_HOME=/Library/Java/JavaVirtualMachines/jdk1.8.0_0221.jdk/Contents/Home
##替换掉${mavenHome},为你的实际maven的安装路径
export M2_HOME=${mavenHome}
export PATH=$PATH:$M2_HOME/bin

图3-1-8 环境变量设置

  1. 查看主机名
#查看主机名
echo $HOSTNAME

图3-1-9 查看主机名

  1. 根据主机名,配置/etc/hosts文件。此步如果没有配置,可能导致mac机器在启动模块时出现dubbo超时,从而导致系统启动巨慢,记得把oinonedeMacBook-Pro.local换成自己的主机名
#oinonedeMacBook-Pro.local 需要换成自己对应的主机名,自己的主机名用 echo $HOSMNAME
127.0.0.1 oinonedeMacBook-Pro.local
::1 oinonedeMacBook-Pro.local

图3-1-10 配置/etc/hosts文件

必备中间件安装脚本(rocketmq、zk、redis)

zk 下载并解压(下载地址见书籍【附件一】)

  1. vi ~/.bash_profile ,追加以下两行,并执行 source ~/.bash_profile
#### 替换掉${basePath},为你的实际安装路径
export ZOOKEEPER_HOME=${basePath}/apache-zookeeper-3.5.8-bin
export PATH=$PATH:$ZOOKEEPER_HOME/bin

图3-1-11 配置zk环境变量

  1. 启动zk
##启动
zkServer.sh start
##停止
zkServer.sh stop

图3-1-12 启停zk

rocketmq (下载地址见书籍【附件一】)

  1. vi ~/.bash_profile ,追加以下两行,并执行 source ~/.bash_profile
#### 替换掉${basePath},为你的实际安装路径
export ROECET_MQ_HOME=${basePath}/rocketmq-all-4.7.1-bin-release
export PATH=$PATH:$ROECET_MQ_HOME:$ROECET_MQ_HOME/bin

图3-1-13 配置rocketmq环境变量

  1. 到bin目录下修改配置文件 runserver.sh 和 runbroker.sh
##注释掉下面一行
##choose_gc_log_directory
##修改java启动所需内存,按自己实际情况改,1g或者512m
JAVA_OPT = "${JAVA_OPT} -server -Xms1g -Xmx1g -Xmn1g -XX:MetaspaceSize=128m -XX:MaxMetaspaceSize=320m"

图3-1-14 bin目录下修改配置文件

  1. 启停rocketmq
##启动 nameserver
nohup mqnamesrv &
##启动 broker
nohup mqbroker -n localhost:9876 &

##停止
mqshutdown broker
mqshutdown namesrv

图3-1-15 启停rocketmq

redis

CPU差异 下载地址
默认 redis-5.0.2 下载地址
m系列的cpu 5.x版本不支持 redis-6.2.8 下载地址

表3-1-2 redis下载地址

  1. 安装
## 替换掉${redisHome},为你的实际安装路径
cd ${redisHome}
make
make install PREFIX=${redisHome}

图3-1-16 安装redis

  1. vi ~/.bash_profile ,追加以下两行,并执行 source ~/.bash_profile
##替换掉${redisHome},为你的实际安装路径
export REDIS_HOME=${redisHome}
export PATH=$PATH:$REDIS_HOME/bin

图3-1-17 配置redis环境变量

  1. 启停
##启动
nohup redis-server &
##停止
redis-cli shutdown

图3-1-18 启停redis

晋级中间件安装脚本(canal,es)

canal、es相关的安装与使用,我们放到后续教程中TBD再介绍,它们是非必须的,只有用到异步事件、增强模型等高级特性时,才需要安装。

前端环境准备

  1. 安装nvm,便于node的版本管理 http://nvm.sh
curl -o- https://pamirs.oss-cn-hangzhou.aliyuncs.com/pamirs/software/install.sh | bash

图3-1-19 安装nvm

  1. vi ~/.bash_profile ,在文件后面追加以下内容(如图3-1-20所示),并执行 source ~/.bash_profile
export NVM_DIR="$([ -z "${XDG_CONFIG_HOME-}" ] && printf %s "${HOME}/.nvm" || printf %s "${XDG_CONFIG_HOME}/nvm")"
[ -s "$NVM_DIR/nvm.sh" ] && \. "$NVM_DIR/nvm.sh" # This loads nvm

图3-1-20 配置nvm环境变量

  1. 用nvm 安装nodejs 版本12.12.0
#看nvm是否安装成功
nvm -v
nvm install 12.12.0

图3-1-21 安装nodejs

  1. vi ~/.bash_profile ,追加以下一行,并执行 source ~/.bash_profile
nvm use 12.12.00

图3-1-22 配置nodejs的环境变量

  1. 安装vue-cli
#@vue/cli需要固定,安装成功后可vue -V查看
sudo npm install @vue/cli@4.5.17 -g

图3-1-23 安装vue-cli

  1. 配置npm 源
#通过config命令,其他方式自行百度
npm config set registry http://nexus.shushi.pro/repository/kunlun/

图3-1-24 配置npm源

  1. 登录npm账号
npm login --registry "http://nexus.shushi.pro/repository/kunlun/"
npm info underscore #(如果上面配置正确这个命令会有字符串response)

图3-1-25 登陆npm源

username、password、email 请见oinone开源社区群公告,也可以联系oinone合作伙伴或服务人员

  1. 安装cnpm参考 https://www.npmjs.com/package/cnpm
    sudo npm install cnpm -g --registry=https://registry.npmmirror.com

    图3-1-26 安装cnpm

至此所有环境准备好了,我们就正式要进入学习如何使用oinone进行业务开发了

其他说明

解决一些新版mac系统默认是zsh而不是bash,“每次都需source ~/.bash_profile”的问题,vi ~/.zshrc新建.zshrc文件,添加内容为source ~/.bash_profile,保存退出后执行 source ~/.zshrc 命令。或者把.bash_profile的内容复制到.zshrc文件去

Oinone社区 作者:史, 昂原创文章,如若转载,请注明出处:https://doc.oinone.top/oio4/9225.html

访问Oinone官网:https://www.oinone.top获取数式Oinone低代码应用平台体验

Like (0)
史, 昂's avatar史, 昂数式管理员
Previous 2024年5月23日 am9:57
Next 2024年5月23日

相关推荐

  • 第2章 Oinone的技术独特性

    本章的主要目的是通过分析企业商业支撑软件的项目特性和关注点,找到企业软件发展的另一个本质变化——新技术流派的产生。在对“互联网架构做为最佳实践为何失效”的思考基础上,我们分析互联网中台架构的发展历史以及企业实际现状,找出其水土不服的原因。进而引出Oinone的低代码开发平台如何结合互联网架构并完成创新,以满足企业数字化转型的需求。 具体而言,本章包括以下内容: 企业软件发展的另一个本质变化:新技术流派的产生; 最佳实践为何失效?Oinone如何打造具有企业特色的互联网架构; Oinone独特性之源:元数据与设计原则; Oinone独特性之单体与分布式的灵活切换; Oinone独特性之每一个需求都是一个模块; Oinone独特性之低无一体。

    Oinone 7天入门到精通 2024年5月23日
    7.5K00
  • 4.1.9 函数之元位指令

    元位指令系统是通过给请求上下文的指令位字段作按位与标记来对函数处理下发对应指令的系统。 一、元位指令介绍 元位指令系统是通过给请求上下文的指令位字段作按位与标记来对函数处理下发对应指令的系统。 元位指令系统分为请求上下文指令和数据指令两种。 数据指令 数据指令基本都是系统内核指令。业务开发时用不到这里就不介绍了。前20位都是系统内核预留 请求上下文指令 请求上下文指令:使用session上下文中非持久化META_BIT属性设置指令。 位 指令 指令名 前端默认值 后端默认值 描述 20 builtAction 内建动作 否 否 是否是平台内置定义的服务器动作对应操作:PamirsSession.directive().disableBuiltAction(); PamirsSession.directive().enableBuiltAction(); 21 unlock 失效乐观锁 否 否 系统对带有乐观锁模型默认使用乐观锁对应操作:PamirsSession.directive().enableOptimisticLocker(); PamirsSession.directive().disableOptimisticLocker(); 22 check 数据校验 是 否 系统后端操作默认不进行数据校验,标记后生效数据校验对应操作:PamirsSession.directive().enableCheck(); PamirsSession.directive().disableCheck(); 23 defaultValue 默认值计算 是 否 是否自动填充默认值对应操作:PamirsSession.directive().enableDefaultValue(); PamirsSession.directive().disableDefaultValue(); 24 extPoint 执行扩展点 是 否 前端请求默认执行扩展点,可以标记忽略扩展点。后端编程式调用数据管理器默认不执行扩展点对应操作:PamirsSession.directive().enableExtPoint(); PamirsSession.directive().disableExtPoint(); 25 hook 拦截 是 否 是否进行函数调用拦截对应操作:PamirsSession.directive().enableHook(); PamirsSession.directive().disableHook(); 26 authenticate 鉴权 是 否 系统默认进行权限校验与过滤,标记后使用权限校验对应操作:PamirsSession.directive().sudo(); PamirsSession.directive().disableSudo(); 27 ormColumn ORM字段别名 否 否 系统指令,请勿设置 28 usePkStrategy 使用PK策略 是 否 使用PK是否空作为采用新增还是更新的持久化策略对应操作:PamirsSession.directive().enableUsePkStrategy(); PamirsSession.directive().disableUsePkStrategy(); 29 fromClient 是否客户端调用 是 否 是否客户端(前端)调用对应操作:PamirsSession.directive().enableFromClient(); PamirsSession.directive().disableFromClient(); 30 sync 同步执行函数 否 否 异步执行函数强制使用同步方式执行(仅对Spring Bean有效) 31 ignoreFunManagement 忽略函数管理 否 否 忽略函数管理器处理,防止Spring调用重复拦截对应操作:PamirsSession.directive().enableIgnoreFunManagement(); PamirsSession.directive().disableIgnoreFunManagement(); 表4-1-9-1 请求上下文指令 二、使用指令 普通模式 PamirsSession.directive().disableOptimisticLocker(); try{ 更新逻辑 } finally { PamirsSession.directive().enableOptimisticLocker(); } 图4-1-9-1 普通模式代码示意 批量设置模式 Models.directive().run(() -> {此处添加逻辑}, SystemDirectiveEnum.AUTHENTICATE) 图4-1-9-2 批量设置模式代码示意 三、使用举例 我们在4.1.5【模型之持久层配置】一文中提到过失效乐观锁,我们在这里就尝试下吧。 Step1 修改PetItemInventroyAction 手动失效乐观锁 package pro.shushi.pamirs.demo.core.action; import org.springframework.stereotype.Component; import pro.shushi.pamirs.demo.api.model.PetItemInventroy; import pro.shushi.pamirs.meta.annotation.Function; import pro.shushi.pamirs.meta.annotation.Model; import pro.shushi.pamirs.meta.api.session.PamirsSession; import pro.shushi.pamirs.meta.constant.FunctionConstants; import pro.shushi.pamirs.meta.enmu.FunctionOpenEnum; import pro.shushi.pamirs.meta.enmu.FunctionTypeEnum; import java.util.ArrayList; import java.util.List; @Model.model(PetItemInventroy.MODEL_MODEL) @Component public class PetItemInventroyAction { @Function.Advanced(type= FunctionTypeEnum.UPDATE) @Function.fun(FunctionConstants.update) @Function(openLevel = {FunctionOpenEnum.API}) public PetItemInventroy update(PetItemInventroy data){ List<PetItemInventroy> inventroys = new ArrayList<>(); inventroys.add(data); PamirsSession.directive().disableOptimisticLocker(); try{ //批量更新会,自动抛错 int i = data.updateBatch(inventroys); //单记录更新,不自动抛售需要自行判断 // int i = data.updateById();…

    2024年5月23日
    1.6K00
  • 2.4.1 Oinone独特性之单体与分布式的灵活切换

    企业数字化转型需要处理分布式带来的复杂性和成本问题。尽管这些问题令人望而却步,但分布式架构对于大部分企业仍然是必须的选择。如果一个低代码平台缺乏分布式能力,那么它的性能就无法满足客户的要求。相比之下,Oinone平台通过对部署的创新(如图2-6所示),成功实现了分布式架构的支持,而且能够按照客户的业务发展需求,灵活选择不同的部署模式,同时节约企业成本,提升创新效率。这一创新是Oinone平台与其他低代码平台的重要区别,能够满足客户预期发展并兼顾成本效益。 图2-6 传统部署方式VS Oinone部署方式 实现原理 要实现灵活部署的特性,必须满足两个基本要求: 开发过程中不需要过多关注分布式技术,就像开发单体应用一样简单。代码在运行时应该能够根据模块是否在运行容器中,来决定路由走本地还是远程。这样可以大大减少研发人员的工作量和技术复杂度。 研发与部署要分离,即"开发单体应用一样开发分布式应用,而部署形式由后期决定"。为此,我们的工程结构支持多种启动模式,并逐一介绍了针对不同场景的工程结构类型(如下图2-7所示)。这样可以让客户在后期根据业务发展情况和需求,选择最适合的部署模式,从而达到灵活部署的目的。 图2-7 Oinone工程结构梳理 在整个工程结构上,我们秉承了Spring Boot的规范,不会改变大家的工程习惯。而Oinone的部署能力则可以让我们更灵活地应对各种情况。现在,我们来逐一介绍几种常规的工程结构以及它们适用的场景: 单模块工程结构(常规操作) a. 这是非常标准的Spring Boot工程,适用于简单的应用场景开发以及入门学习。 多模块工程结构(常规操作) a. 这是非常标准的多Spring Boot工程,可以实现分布式独立启动,适用于常规的分布式应用场景开发。 多模块工程结构-独立boot工程模式 a. 这种工程结构在多模块工程的基础上,通过独立的boot工程来支撑多部署方式。适用于中大型分布式应用场景开发。 b. 然而,随着工程越来越多,我们也会面临一些问题: ⅰ研发:环境准备非常困难,每个模块都要单独启动,研发调试跟踪困难。 ⅱ部署:分布式的高可靠性保证需要每个模块至少有两个部署节点,但在模块较多的情况下,起步成本非常高。同时,企业初期业务不稳定且规模较小,使用多模块工程的第二种模式会增加问题排查难度和成本。 c. 此时,Oinone的多模块工程下的独立boot工程模式部署就可以发挥其灵活性,让研发和业务起步阶段可以选择all-in-one模式,等到业务发展到一定规模的时候,只需要把线上部署模式切换成模块独立部署,而研发还可以保留all-in-one模式的优势。 d. 值得注意的是,分分合合的部署模式在传统互联网架构和低代码或无代码平台上都是有代价的,但是Oinone却可以灵活适配,只需要在boot工程的yml文件中写入需要加载的模块就可以解决。此处我们仅介绍多模块加载配置,选择性忽略其他无关配置,具体配置(如下图2-8所示)。 pamirs: boot: init: true sync: true modules: – base – resource – sequence – user – auth – web tenants: – pamirs 图2-8 Oinone yml配置图大型多场景工程结构-独立boot工程模式: a. 在多模块工程结构基础上的加强版,增加CDM层设计,让不同场景即保持数据统一,又保持逻辑独立。这种工程结构特别适用于大型企业软件开发,其中涉及到多个场景的情况,例如B端和C端的应用,或者跨不同业务线的应用,能够保证数据的一致性,同时也能够保持逻辑独立,避免不同场景间的代码冲突。 b. 这种工程结构是我们Oinone支撑“企业级软件生态”的核心,我们可以把场景A当作我们官方应用,场景B当作其他第三方伙伴应用。在这个工程结构下,我们的客户可以定制化开发自己的应用,同时我们也可以通过这种模式来支持我们的伙伴们进行开发,实现多方共赢。 c. 基于独立boot工程模式,我们同样对应多种部署模式应对不同情况,并统一管理所有伙伴应用。这种工程结构的优点是扩展性好,可以支持不同规模的应用,并且可以根据需要进行快速扩展或缩小规模,具有很高的灵活性。 基于标准产品的二开工程结构,是指基于标准产品进行二次开发,满足客户特定需求的工程结构。这种模式下,Oinone提供标准产品,客户可以根据自己的需求进行二次开发,实现定制化需求,同时可以利用我们的模块化开发特性,将每一个需求作为一个模块进行开发和管理。这种工程结构的优点是能够快速满足客户特定需求,同时也具有很好的可维护性和可扩展性,因为每个需求都是一个独立的模块,可以方便地进行维护和扩展。在下一篇“Oinone独特性之每一个需求都是一个模块”文章中有详细介绍。

    2024年5月23日
    2.7K00
  • 3.4.3.3 SPI机制-扩展点

    扩展点结合拦截器的设计,oinone可以点、线、面一体化管理Function 扩展点用于扩展函数逻辑。扩展点类似于SPI机制(Service Provider Interface),是一种服务发现机制。这一机制为函数逻辑的扩展提供了可能。 一、构建第一个扩展点 自定义扩展点(举例) 在我们日常开发中,随着对业务理解的深入,往往还在一些逻辑中会预留扩展点,以便日后应对不同需求时可以灵活替换某一小块逻辑。 在3.3.4【模型的继承】一文中的PetCatItemQueryService,是独立新增函数只作公共逻辑单元。现在我们给它的实现类增加一个扩展点。在PetCatItemQueryServiceImpl的queryPage方法中原本会先查询PetCatType列表,我们这里假设这个逻辑随着业务发展未来会发生变化,我们可以预先预留【查询萌猫类型扩展点】 Step1 新增扩展点定义PetCatItemQueryCatTypeExtpoint 扩展点命名空间:在接口上用@Ext声明扩展点命名空间。会优先在本类查找@Ext,若为空则往接口向上做遍历查找,返回第一个查找到的@Ext.value注解值,使用该值再获取函数的命名空间;如果未找到,则返回扩展点全限定类名。所以我们这里扩展点命名空间为:pro.shushi.pamirs.demo.api.extpoint.PetCatItemQueryCatTypeExtpoint 扩展点技术名称:先取@ExtPoint.name,若为空则取扩展点接口方法名。所以我们这里技术名为queryCatType package pro.shushi.pamirs.demo.api.extpoint; import pro.shushi.pamirs.demo.api.model.PetCatType; import pro.shushi.pamirs.meta.annotation.Ext; import pro.shushi.pamirs.meta.annotation.ExtPoint; import java.util.List; @Ext public interface PetCatItemQueryCatTypeExtpoint { @ExtPoint(displayName = "查询萌猫类型扩展点") List<PetCatType> queryCatType(); } 图3-4-3-11 新增扩展点定义PetCatItemQueryCatTypeExtpoint Step2 修改PetCatItemQueryServiceImpl(用Ext.run模式调用) 修改queryPage,增加扩展点的使用代码。扩展点的使用有两种方式 方法一,使用命名空间和扩展点名称调用Ext.run(namespace, fun, 参数); 方法二,使用函数式接口调用Ext.run(函数式接口, 参数); 我们这里用了第二种方式 用PetCatItemQueryCatTypeExtpoint的全限定类名作为扩展点的命名空间(namespace) 用queryCatType的方法名作为扩展点的技术名称(name) 根据namespace+name去找到匹配扩展点实现,并根据规则是否匹配,以及优先级唯一确定一个扩展点实现去执行逻辑 package pro.shushi.pamirs.demo.core.service; ……省略依赖包 @Model.model(PetCatItem.MODEL_MODEL) @Component public class PetCatItemAction extends DataStatusBehavior<PetCatItem> { @Override protected PetCatItem fetchData(PetCatItem data) { return data.queryById(); } @Action(displayName = "启用") public PetCatItem dataStatusEnable(PetCatItem data){ data = super.dataStatusEnable(data); data.updateById(); return data; } @Function.Advanced(displayName = "查询模型数据的默认过滤条件", type = FunctionTypeEnum.QUERY, managed = true) @Function(openLevel = {LOCAL}) public String queryFilters() { StringBuilder sqlWhereCondition = new StringBuilder(); // List<PetCatType> typeList = new PetCatType().queryList(); List<PetCatType> typeList = Ext.run(PetCatItemQueryCatTypeExtpoint::queryCatType, new Object[]{}); if(!CollectionUtils.isEmpty(typeList)){ // sqlWhereCondition.append("type_id"); sqlWhereCondition.append(PStringUtils.fieldName2Column(LambdaUtil.fetchFieldName(PetCatItem::getTypeId))); sqlWhereCondition.append(StringUtils.SPACE).append(SqlConstants.IN).append(CharacterConstants.LEFT_BRACKET); for(PetCatType petCatType: typeList){ sqlWhereCondition.append(petCatType.getId()).append(CharacterConstants.SEPARATOR_COMMA); } sqlWhereCondition.deleteCharAt(sqlWhereCondition.lastIndexOf(CharacterConstants.SEPARATOR_COMMA)); sqlWhereCondition.append(StringUtils.SPACE).append(CharacterConstants.RIGHT_BRACKET); } return sqlWhereCondition.toString(); } ……省略其他函数 } 图3-4-3-12 修改PetCatItemQueryServiceImpl Step3 新增扩展点实现PetCatItemQueryCatTypeExtpointOne 扩展点命名空间要与扩展点定义一致,用@Ext(PetCatItemQueryCatTypeExtpoint.class) @ExtPoint.Implement声明这是在@Ext声明的命名空间下,且技术名为queryCatType的扩展点实现 package pro.shushi.pamirs.demo.core.extpoint; import pro.shushi.pamirs.demo.api.extpoint.PetCatItemQueryCatTypeExtpoint; import pro.shushi.pamirs.demo.api.model.PetCatType; import pro.shushi.pamirs.meta.annotation.Ext; import pro.shushi.pamirs.meta.annotation.ExtPoint; import pro.shushi.pamirs.meta.api.session.PamirsSession; import java.util.List; @Ext(PetCatItemQueryCatTypeExtpoint.class) public class PetCatItemQueryCatTypeExtpointOne implements PetCatItemQueryCatTypeExtpoint { @Override @ExtPoint.Implement(displayName = "查询萌猫类型扩展点的默认实现") public List<PetCatType> queryCatType() { PamirsSession.getMessageHub().info("走的是第一个扩展点"); List<PetCatType> typeList = new PetCatType().queryList(); return typeList; } } 图3-4-3-13 新增扩展点实现PetCatItemQueryCatTypeExtpointOne Step4…

    2024年5月23日
    2.0K00
  • 通知类

    1.通知类 1.1 站内信 当流程节点需要向用户发送消息或提示时使用站内信这个节点动作。接收人的选取类似审批节点的审批人,通知内容必填,配置完成,保存即可。 节点触发后,接收人会在全渠道运营平台-工作台-我的消息中查看到站内信。 1.2 邮件 当需要向指定邮箱发送邮件时使用邮件这个节点动作。可直接输入邮箱号,或者按照员工、部门、角色来选择,给接收人登记的邮箱发送邮件,也可以选择模型中的邮箱来发送邮件,若人员重复时只会发送一次邮件。填写主题,填写正文时可以调用当前流程中的一些模型字段的变量。 1.3 短信 发送短信需要在工作流-系统设置-短信模板中创建一个短信模板,阿里云模版新增需要一段时间审核,审核通过后就可以正常使用短信节点。短信的接收人与邮件的操作方式一致,之后选择短信模板,并且确定好变量的对应关系即可。

    2024年6月20日
    2.8K00

Leave a Reply

Please Login to Comment