2.4.2 Oinone独特性之每一个需求都可以是一个模块

我们的Oinone平台采用模型驱动的方式,并符合面向对象设计原则,每个需求都可以是一个独立模块,可以独立安装、升级和卸载。这让系统真正像乐高积木一样搭建,具有高度的灵活性和可维护性。

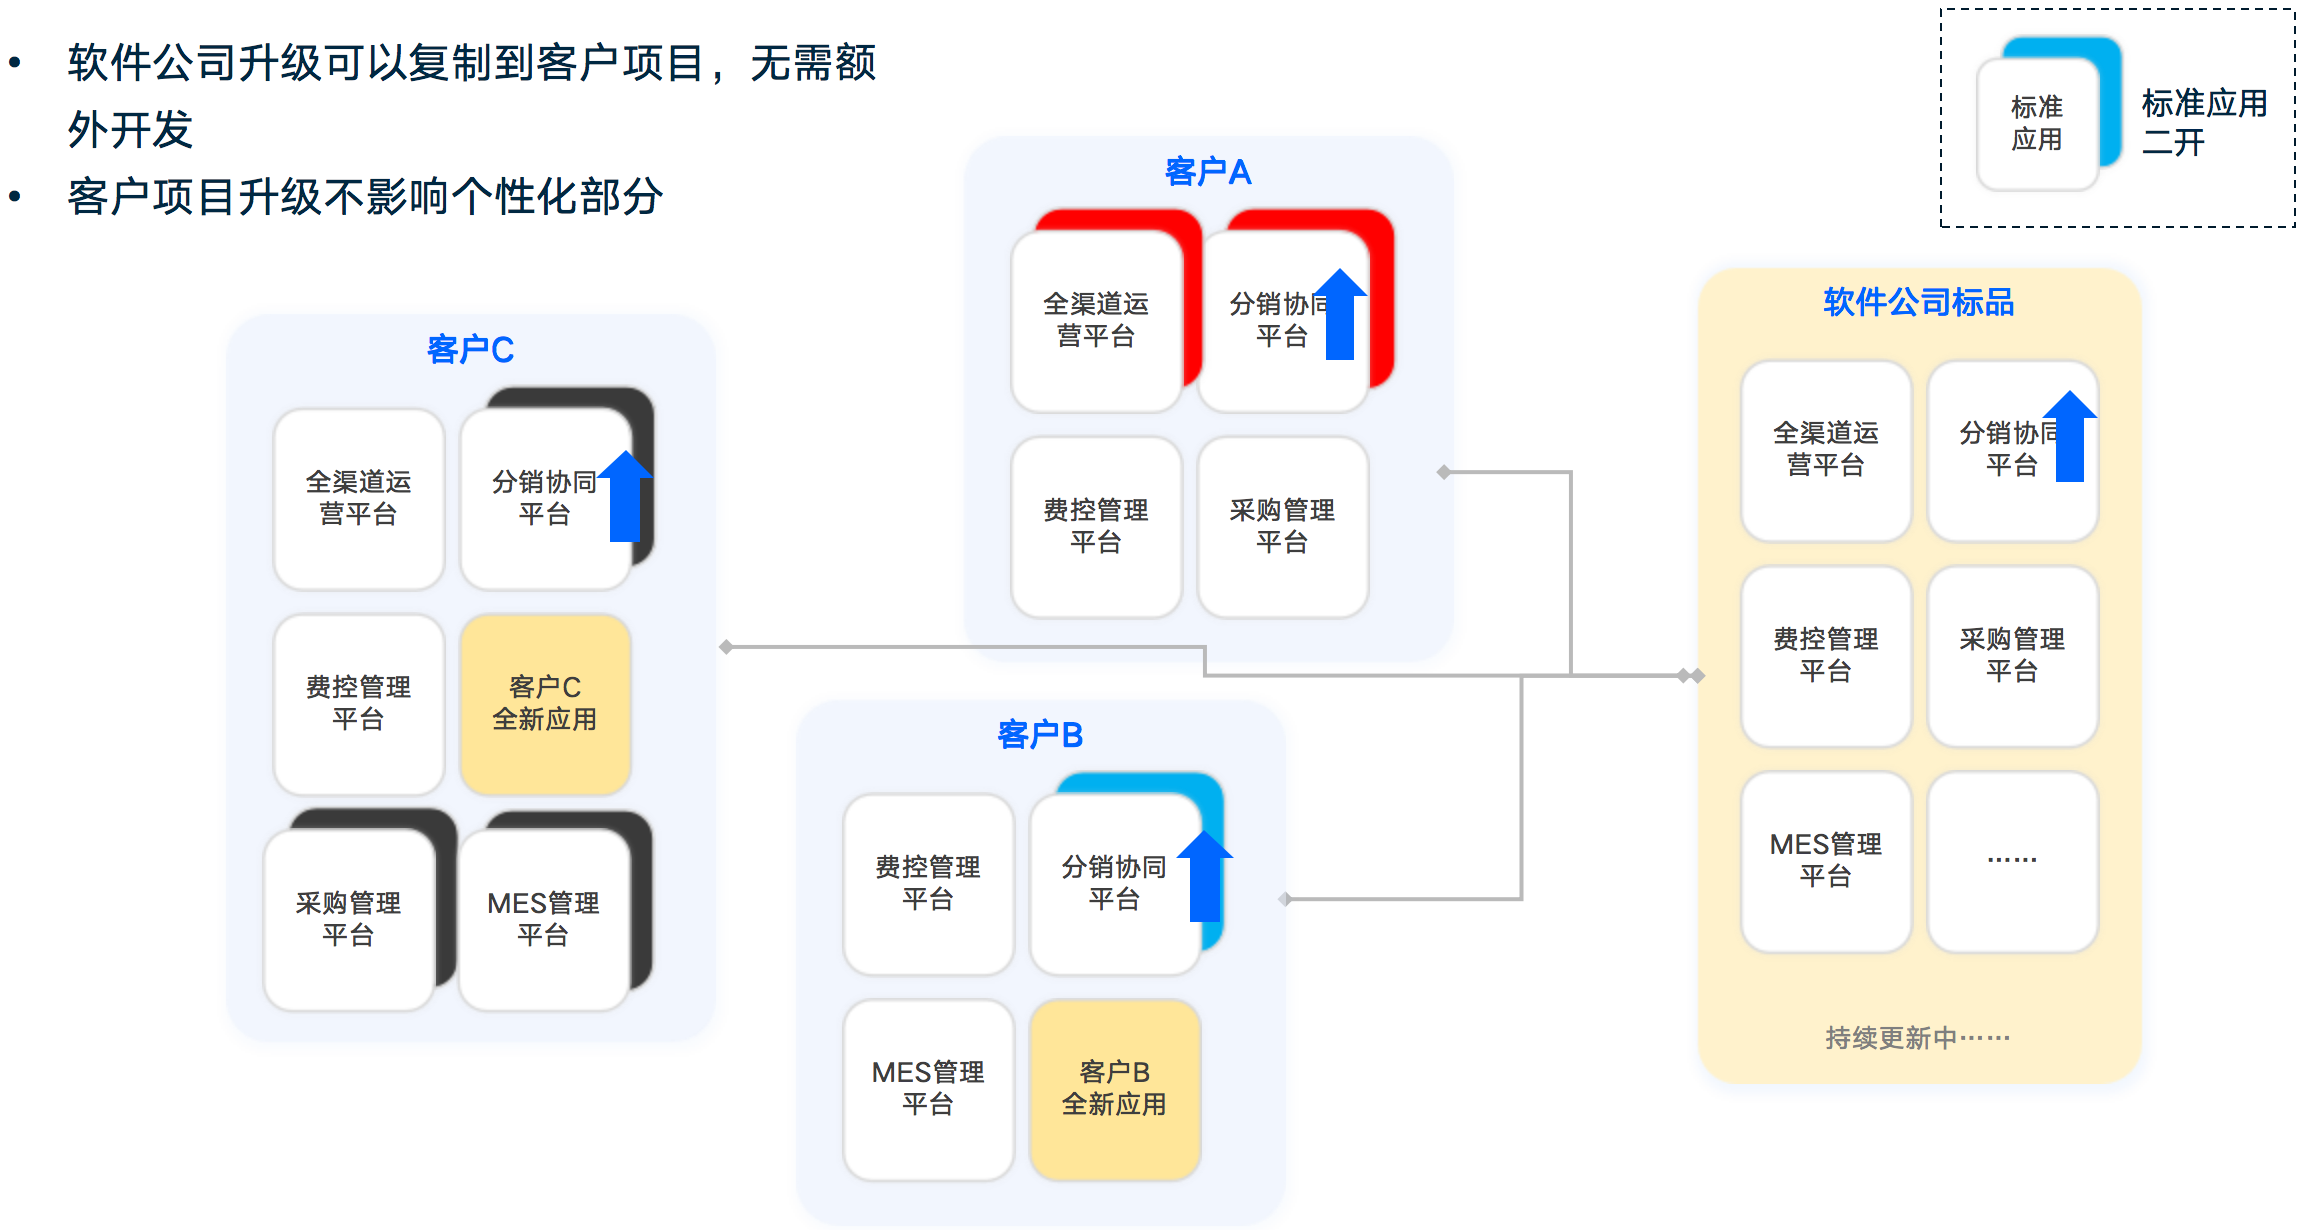
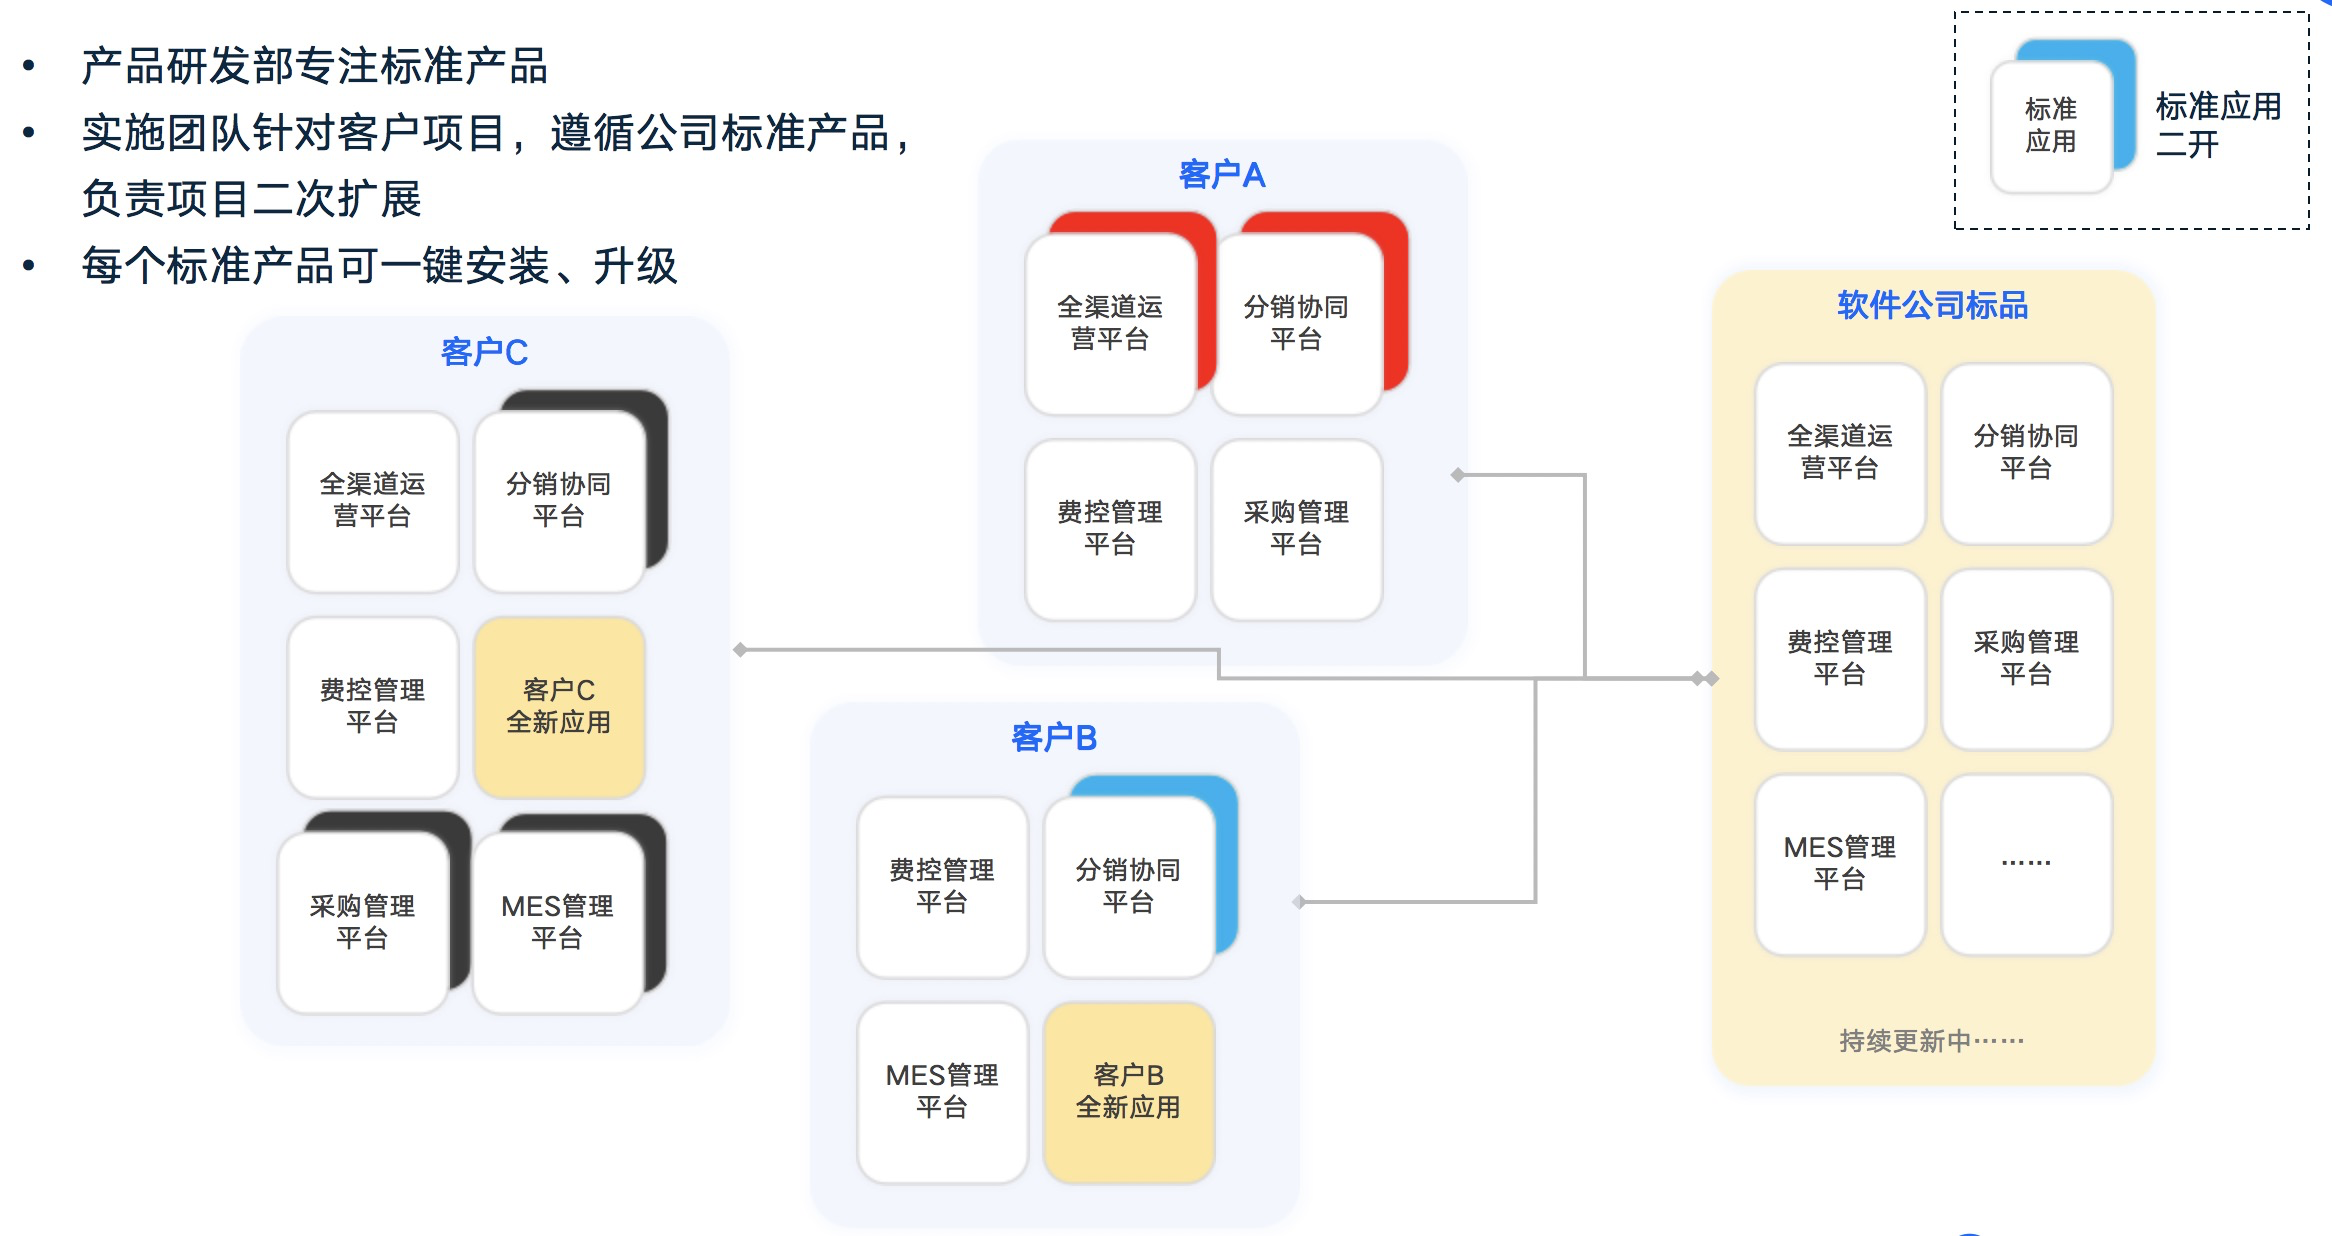
与大部分低代码或无代码平台不同的是,它们的应用市场上的应用往往是模板式的,也就是说,这是一个拷贝,个性化只能在应用上直接修改,而且一旦修改就不能升级。这对于软件公司和客户来说都非常痛苦。客户无法享受到软件公司产品的升级功能,而软件公司在服务大量客户时,也会面临不同版本的维护问题,成本也非常高。而我们的Oinone平台完全避免了这些问题,让客户和软件公司都可以从中受益(如下图2-9、2-10所示)。
2.4.2 Oinone独特性之每一个需求都可以是一个模块

图2-9软件公司与客户项目的关系-让标准与个性化共存

2.4.2 Oinone独特性之每一个需求都可以是一个模块

图2-10 软件公司与客户项目的关系-让升级无忧

实现原理

在满足客户个性化定制需求时,传统的方法通常是直接修改标准产品源码,但这样做会带来一个问题:标准产品无法持续升级。相反,无论是在OP模式还是SaaS模式下,Oinone都采用全新的模块为客户进行个性化开发,保持标准产品和个性化模块的独立维护和升级。这是因为在元数据设计时,Oinone采用了面向对象的设计原则,实现了元数据设计与面向对象设计思想的完美融合。

面向对象设计的核心特征包括封装、继承、多态,而Oinone的元数据设计完全融入了这些思想。下面是几个例子,说明Oinone的元数据设计如何体现面向对象设计的核心特征,并带来了什么好处:

  1. 继承:在继承原有模型的字段、逻辑、展示的情况下,增加一段代码来扩展模型的字段、逻辑、展示。

  2. 多态:在继承原有模型的字段、逻辑、展示的情况下,增加一段代码来覆盖模型的原有字段、逻辑、展示。

  3. 封装:外部无需关心模型内部如何实现,只需按照不同场景调用模型对应开放级别的字段、逻辑、展示。

这些特征和优势使得Oinone在满足客户个性化需求时更加灵活和可持续,同时使得标准产品的维护和升级变得更加容易和高效。

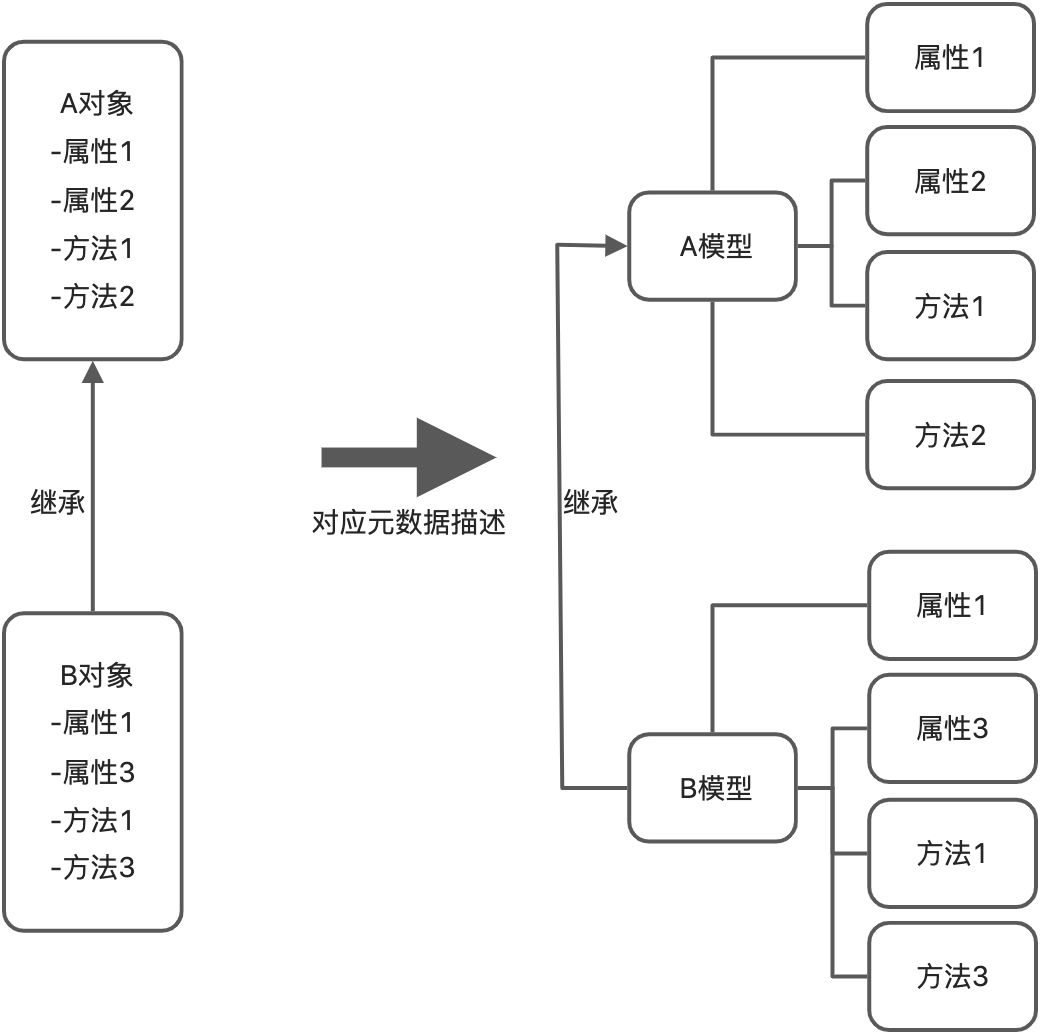
在Java语言设计中,万物皆对象,一切都以对象为基础。而Oinone的元数据设计则是以模型为出发点,作为数据和行为的承载体。如下图2-11清晰地描述了Java面向对象编程中封装、继承、多态在Oinone元数据中的对应关系。Oinone元数据描述了B对象继承A对象并拥有其所有属性和方法,并覆盖了A对象的属性1和方法1,同时新增了属性3和方法3。

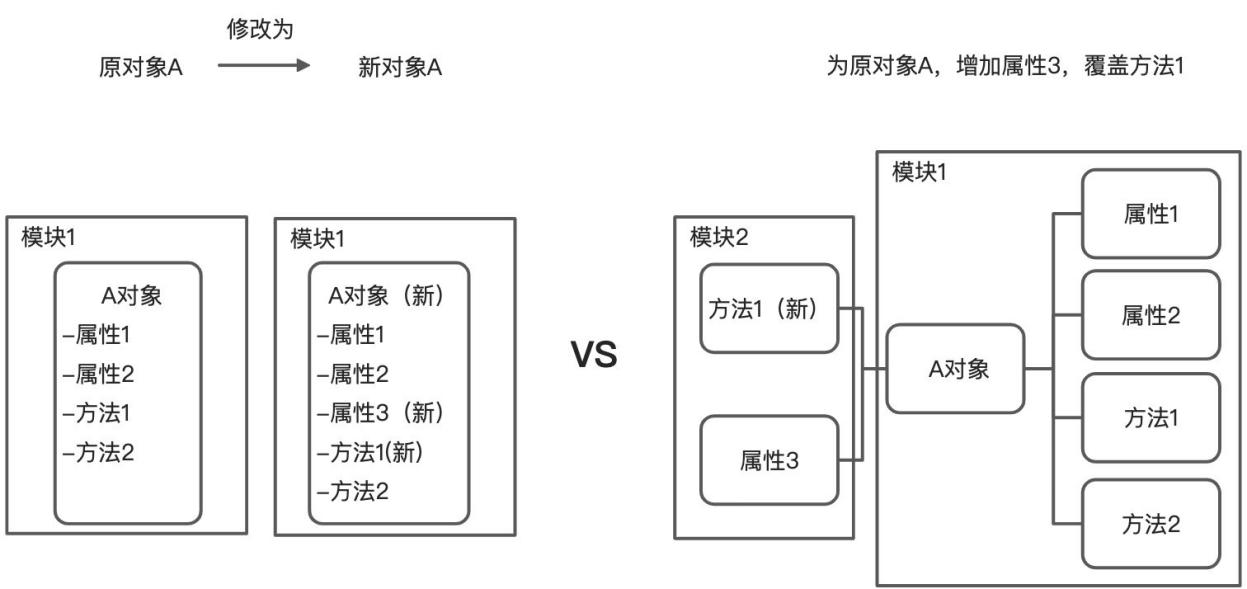
此外,Oinone的面向对象特性是用元数据来描述的。一方面,我们基于Java编码规范收集相关元数据,以保持不改变Java编程习惯。另一方面,方法和对象的挂载是松耦合的,只要按照元数据规范进行挂载,就能轻松地将其附加到模型上。在不改变原有A对象的情况下,我们可以直接增加方法和属性(如下图2-12所示)。
2.4.2 Oinone独特性之每一个需求都可以是一个模块

图2-11 java面向对象在Oinone元数据中对应

2.4.2 Oinone独特性之每一个需求都可以是一个模块

图2-12 java对象的修改 VS Oinone元数据模型的修改

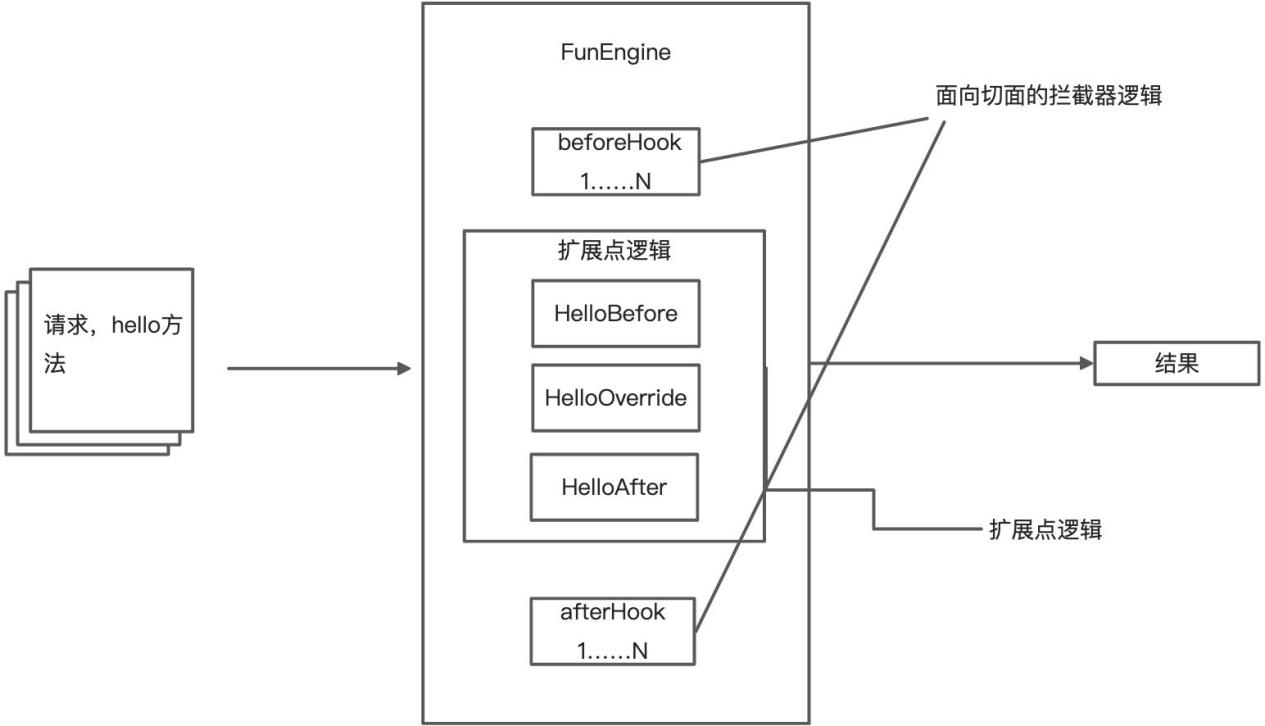
Oinone函数不仅支持面向对象的继承和多态特性,还提供了面向切面的拦截器和SPI机制的扩展点,以应对方法逻辑的覆盖和扩展,以及系统层面的逻辑扩展(如下图2-13所示)。这些扩展功能可以独立地在模块中维护。

其中,拦截器可以在不侵入函数逻辑的情况下,根据优先级为满足条件的函数添加执行前和执行后的逻辑。

扩展点是一种类似于SPI机制的逻辑扩展机制,用于扩展函数的逻辑。通过这一机制,可以对函数逻辑进行灵活的扩展,以满足不同的业务需求。
2.4.2 Oinone独特性之每一个需求都可以是一个模块

图2-13 Oinone函数拦截与扩展机制

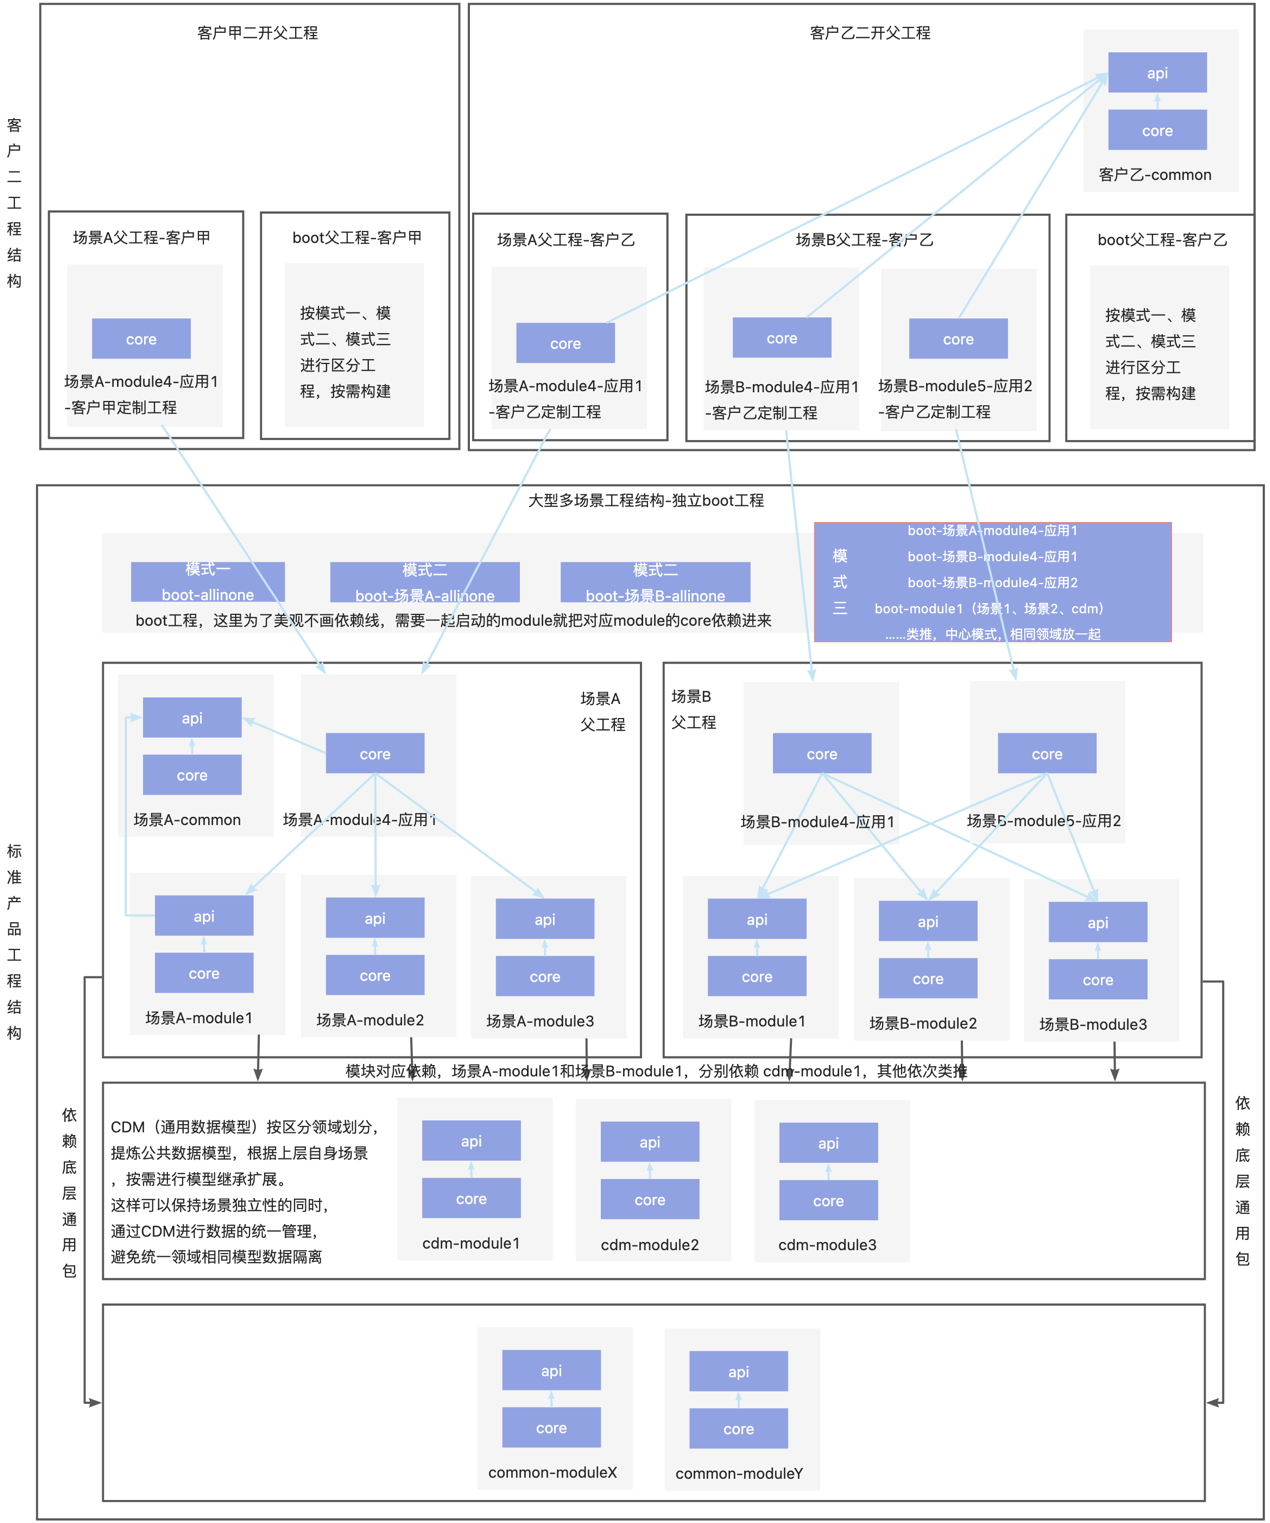
不管是对象、属性还是方法,都可以以独立的模块方式来扩展,这就使得每一个需求都可以成为一个独立的模块,方便我们在研发标准产品时进行模块化的划分,同时也让我们在以低代码模式为客户进行二次开发时,能够更好地支持“标准产品迭代与个性化保持独立”的需求。在2.4.3【oinone独特性之低无一体】一文中,我们也提到了这个特性,但那是在低无一体的情况下,通过元数据融合来实现的。让我们看看基于低代码开发模式下,典型的Oinone二次开发工程结构(如下图2-14所示),就可以更好地理解这个特性啦!
2.4.2 Oinone独特性之每一个需求都可以是一个模块

图2-14 Oinone典型的二开工程结构

Oinone社区 作者:史, 昂原创文章,如若转载,请注明出处:https://doc.oinone.top/oio4/9221.html

访问Oinone官网:https://www.oinone.top获取数式Oinone低代码应用平台体验

Like (0)
史, 昂's avatar史, 昂数式管理员
Previous 2024年5月23日 am10:01
Next 2024年5月23日 am10:03

相关推荐

  • 高级组件

    本篇主要结合业务场景介绍高级组件的使用方法。 级联选择/树选择 级联选择与树选择是同一类业务场景、不同的交互体验,在这里我们一起说明。 业务场景 行业分类、产品类目/分类等自关联场景,案例以行业分类说明。 操作步骤 Step1:搭建模型 搭建行业模型,在行业模型中创建多对一字段“上级行业”,指多个子行业对应一个上级行业。如下图: Step2:界面设计 创建行业的表格视图,绑定菜单,并且在此视图中增加“跳转动作 – 新增行业”; 创建新增行业表单,将“上级行业”拖进画布中,组件切换为“级联选择”,属性面板配置“选项字段、搜索字段、透出字段”,平台低代码为每个模型自动生成了名称、编码字段,如果不使用平台提供的名称、自建名称时,需要配置这三个字段; 为“上级行业”设置联动关系,自关联默认选择行业、标题定义为行业名称、自关联的字段为上级行业。 配置后发布表格、表单视图,即可获得级联选择效果。 表单视图中将“上级行业”切换为“树选择”组件,在发布后,即可获得树选择效果。 Step3:效果展示 级联选择 树选择

    2024年6月20日
    2.7K00
  • 3.4.3.2 面向切面-拦截器

    一、拦截器 拦截器为平台满足条件的函数以非侵入方式根据优先级扩展函数执行前和执行后的逻辑。 使用方法上的@Hook注解可以标识方法为拦截器。前置扩展点需要实现HookBefore接口;后置扩展点需要实现HookAfter接口。入参包含当前拦截函数定义与该函数的入参。拦截器可以根据函数定义与入参增加处理逻辑。 拦截器分为前置拦截器和后置拦截器,前者的出入参为所拦截函数的入参,后者的出入参为所拦截函数的出参。可以使用@Hook注解或Hook模型的非必填字段module、model、fun、函数类型、active来筛选出对当前拦截方法所需要生效的拦截器。若未配置任何过滤属性,拦截器将对所有函数生效。 根据拦截器的优先级priority属性可以对拦截器的执行顺序进行调整。priority数字越小,越先执行。 二、前置拦截(举例) 增加一个前置拦截,对PetShop的sayHello函数进行前置拦截,修改函数的入参的shopName属性,在其前面增加"hookbefore:"字符串。并查看效果 Step1 新增PetShopSayHelloHookBefore实现HookBefore接口 为run方法增加@Hook注解 配置module={DemoModule.MODULE_MODULE},这里module代表的是执行模块,该Hook只匹配由DemoModule模块为发起入口的请求 配置model={PetShop.MODEL_MODEL},该Hook只匹配PetShop模型 配置fun={"sayHello"},该Hook只匹配函数编码为sayHello的函数 package pro.shushi.pamirs.demo.core.hook; import org.springframework.stereotype.Component; import pro.shushi.pamirs.demo.api.DemoModule; import pro.shushi.pamirs.demo.api.model.PetShop; import pro.shushi.pamirs.meta.annotation.Hook; import pro.shushi.pamirs.meta.api.core.faas.HookBefore; import pro.shushi.pamirs.meta.api.dto.fun.Function; @Component public class PetShopSayHelloHookBefore implements HookBefore { @Override @Hook(module = {DemoModule.MODULE_MODULE},model = {PetShop.MODEL_MODEL},fun = {"sayHello"}) public Object run(Function function, Object… args) { if(args!=null && args[0]!=null){ PetShop arg = (PetShop)args[0]; arg.setShopName("hookbefore:"+ arg.getShopName()); } return args; } } 图3-4-3-5 新增PetShopSayHelloHookBefore实现HookBefore接口 Step2 重启查看效果 用graphQL工具Insomnia查看效果,如果访问提示未登陆,则请先登陆。详见3.4.1【构建第一个Function】一文 用 http://127.0.0.1:8090/pamirs/base 访问,结果我们会发现PetShopSayHelloHookBefore不起作用。是因为本次请求是以base模块作为发起模块,而我们用module={DemoModule.MODULE_MODULE}声明了该Hook只匹配由DemoModule模块为发起入口的请求 图3-4-3-6 示例效果 用 http://127.0.0.1:8090/pamirs/demoCore 访问,前端是以模块名作为访问入口不是模块编码这里大家要注意下 图3-4-3-7 示例效果 用 http://127.0.0.1:8090/pamirs/demoCore 访问,更换到petShop的子模型petShopProxy来访问sayHello函数,结果我们发现是没有效果的。因为配置model={PetShop.MODEL_MODEL},该Hook只匹配PetShop模型 三、后置拦截(举例) 增加一个后置拦截,对PetShop的sayHello函数进行后置拦截,修改函数的返回结果的shopName属性,在其后面增加"hookAfter:"字符串。并查看效果 Step1 新增PetShopSayHelloHookAfter实现HookAfter接口 为run方法增加@Hook注解 配置model={PetShop.MODEL_MODEL},该Hook只匹配PetShop模型 配置fun={"sayHello"},该Hook只匹配函数编码为sayHello的函数 package pro.shushi.pamirs.demo.core.hook; import org.springframework.stereotype.Component; import pro.shushi.pamirs.demo.api.model.PetShop; import pro.shushi.pamirs.meta.annotation.Hook; import pro.shushi.pamirs.meta.api.core.faas.HookAfter; import pro.shushi.pamirs.meta.api.dto.fun.Function; @Component public class PetShopSayHelloHookAfter implements HookAfter { @Override @Hook(model = {PetShop.MODEL_MODEL},fun = {"sayHello"}) public Object run(Function function, Object ret) { if (ret == null) { return null; } PetShop result =null; if (ret instanceof Object[]) { Object[] rets = (Object[])((Object[])ret); if (rets.length == 1) { result = (PetShop)rets[0]; } } else { result = (PetShop)ret; } result.setShopName(result.getShopName()+":hookAfter"); return result; } } 3-4-3-8 新增PetShopSayHelloHookAfter实现HookAfter接口 Step2 重启查看效果 用 http://127.0.0.1:8090/pamirs/base 访问,结果我们会发现PetShopSayHelloHookAfter是起作用。PetShopSayHelloHookBefore没有配置模块过滤。 3-4-3-9 示例效果 用访问,结果我们会发现PetShopSayHelloHookAfte和PetShopSayHelloHookBefore同时起作用 3-4-3-10 示例效果 我们会发现HookAfter只对结果做了修改,所以message中可以看到hookbefore,但看不到hookAfter 四、注意点 不管前置拦截器,还是后置拦截器都可以配置多个,根据拦截器的优先级priority属性可以对拦截器的执行顺序进行调整。priority数字越小,越先执行。小伙伴们可以自行尝试 拦截器必须是jar依赖,不然执行会报错。特别是有的小伙伴配置了一个没有过滤条件的拦截器,就要非常小心 模块启动yml文件可以过滤不需要执行的hook,具体配置详见4.1.1【模块之yml文件结构详解】一文 调用入口不是由前端发起而是后端编程中直接调用,默认不会生效,如果要生效请参考4.1.9【函数之元位指令】一文

    2024年5月23日
    1.8K00
  • 3.3.10 字段类型之关系描述的特殊场景

    在3.3.9【字段类型之关系与引用】一文中已经描述了各种关系字段的常规写法,还有一些特殊场景如:关系映射中存在常量,或者M2M中间表是大于两个字段构成。 举例说明关系字段-高级用法 场景描述 PetTalent模型增加talentType字段,PetItem与PetTalent的多对多关系增加talentType(达人类型),PetItemRelPetTalent 中间表维护petItemId、petTalentId以及talentType,PetDogItem和PetCatItem分别重写petTalents 字段,关系中增加常量描述。示意图如下 实际操作步骤: Step1 新增 TalentTypeEnum package pro.shushi.pamirs.demo.api.enumeration; import pro.shushi.pamirs.meta.annotation.Dict; import pro.shushi.pamirs.meta.common.enmu.BaseEnum; @Dict(dictionary = TalentTypeEnum.DICTIONARY,displayName = "达人类型") public class TalentTypeEnum extends BaseEnum<TalentTypeEnum,Integer> { public static final String DICTIONARY ="demo.TalentTypeEnum"; public final static TalentTypeEnum DOG =create("DOG",1,"狗达人","狗达人"); public final static TalentTypeEnum CAT =create("CAT",2,"猫达人","猫达人"); } Step2 PetTalent模型增加talentType字段 package pro.shushi.pamirs.demo.api.model; import pro.shushi.pamirs.demo.api.enumeration.TalentTypeEnum; import pro.shushi.pamirs.meta.annotation.Field; import pro.shushi.pamirs.meta.annotation.Model; @Model.model(PetTalent.MODEL_MODEL) @Model(displayName = "宠物达人",summary="宠物达人",labelFields ={"name"}) public class PetTalent extends AbstractDemoIdModel{ public static final String MODEL_MODEL="demo.PetTalent"; @Field(displayName = "达人") private String name; @Field(displayName = "达人类型") private TalentTypeEnum talentType; } Step3 修改PetItem的petTalents字段,在关系描述中增加talentType(达人类型) @Field.many2many(relationFields = {"petItemId"},referenceFields = {"petTalentId","talentType"},through = "PetItemRelPetTalent") @Field.Relation(relationFields = {"id"}, referenceFields = {"id","talentType"}) @Field(displayName = "推荐达人",summary = "推荐该商品的达人们") private List<PetTalent> petTalents; Step4 PetDogItem增加petTalents字段,重写父类PetItem的关系描述 talentType配置为常量,填入枚举的值 增加domain描述用户页面选择的时候自动过滤出特定类型的达人,RSQL用枚举的name @Field.many2many(relationFields = {"petItemId"},referenceFields = {"petTalentId","talentType"},through = "PetItemRelPetTalent") @Field.Relation(relationFields = {"id"}, referenceFields = {"id","talentType"}) @Field(displayName = "推荐达人",summary = "推荐该商品的达人们") private List<PetTalent> petTalents; Step5 PetCatItem增加petTalents字段,重写父类PetItem的关系描述 talentType配置为常量,填入枚举的值 增加domain描述用户页面选择的时候自动过滤出特定类型的达人,RSQL用枚举的name @Field(displayName = "推荐达人") @Field.many2many( through = "PetItemRelPetTalent", relationFields = {"petItemId"}, referenceFields = {"petTalentId","talentType"} ) @Field.Relation(relationFields = {"id"}, referenceFields = {"id", "#2#"}, domain = " talentType == CAT") private List<PetTalent> petTalents; Step6 清除中间表demo_core_pet_item_rel_pet_talent的数据记录 清除PetItem与PetTalent的多对多中间表demo_core_pet_item_rel_pet_talent的数据记录 Step7 重启看效果 修改达人记录,选择不同达人类型 PetItem、PetCatItem、PetDogItem不同的交互页面

    2024年5月23日
    1.9K00
  • 组件属性

    1. 通用属性 介绍组件和其属性之前,先介绍一些大部分组件通用支持的一些基础属性。 1.2 标题 标题是字段在当前页面的展示名称,标题默认为字段名称,可以修改。 1.2 占位提示 在未填写内容时,输入框或选择框内的浅色提示文字,仅用于提示,不会影响字段的值。 1.3 描述说明 一个字段的描述信息,通常用于说明当前字段的范围、注意事项等。描述说明大部分在组件的下方显示,特殊的是,分组的描述说明在标题的左侧。 1.4 默认值 创建数据时,有些字段大概率都是相同值,可设置默认值,减少添加人员的操作步骤,提高录入数据效率。 1.5 只读 设为只读时,字段可见,但不可编辑。 除了只读和非只读的对立选项,也可以设置条件只读,在设置的条件下才只读,条件不符合则非只读。 1.6 禁用 设为禁用时,字段可见,但不可编辑。 除了禁用和非禁用的对立选项,也可以设置条件禁用,在设置的条件下才禁用,条件不符合则非禁用。 1.7 隐藏 设为隐藏时,字段不可见,也不可编辑。但是在页面设计时,隐藏的组件也会展示,效果如下图。 除了隐藏和非隐藏的对立选项,也可以设置条件隐藏,在设置的条件下才隐藏,条件不符合则非隐藏。 1.8 必填 控制字段在当前页面是否必填,若设置为必填则在标题前会有红色的*作为标识。除了必填和非必填的对立选项,也可以设置条件必填,在设置的条件下才必填,条件不符合则非必填。 1.9 标题排列方式 字段的标题可以自定义横向排列还是纵向排列。每个字段组件都支持设置,设置后之间互不影响。除了组件支持自定义,表单、分组、选项卡也可以设置排列方式,对于这种布局容器类组件,设置后会将其容器内的所有组件的标题排列方式都改为所设置的值。 1.10 宽度 定义在页面中的宽度:占整行的比例,一般可选项有1/4、1/3、1/2、2/3、3/4、1。 其中1/2表示占当前行的一半;1表示占当前行一整行;以此类推。部分组件特殊,如富文本仅支持宽度为1,即占一整行。 2. 分组 分组是一个布局类组件,类似一个容器,可以把业务含义相近的内容放在这个分组容器内。 2.1 属性 2.1.1 标题 分组可以定义一个标题名称,标题显示在分组左上角,可以不设置标题。 2.1.2 描述说明 分组的描述说明显示在分组标题右侧。 2.1.3 标题排列方式 分组中的标题排列方式属性并不是控制分组的标题,而是控制分组内组件的标题。设置后对分组内的所有组件生效。 3. 选项卡 选项卡是一个布局类组件,类似一个容器,每个选项卡可以添加多个选项页,可以把业务含义相近的内容放在选项卡的选项页容器内。 3.1 选项卡属性 3.1.1 选项页排列方式 选中选项卡,可选择选项卡中的选项页排列方式:水平排列、竖直排列。默认是水平排列,效果如下图。 3.1.2 标题排列方式 选项卡中的标题排列方式控制选项卡内组件的标题。设置后对选项卡内的所有组件生效。 3.2 选项页属性 3.2.1 标题 选中选项页,显示选项页的属性设置,选项卡中的每个选项页支持设置标题。 3.2.2 标题排列方式 选项页中的标题排列方式控制选项页内组件的标题。设置后对选项页内的所有组件生效。同一个选项卡,不同选项页之间的标题排列方式可以不同。 4. 单行文本 单行文本输入框,常用于记录名称、身份证号或其他普通的文字内容。 4.1 创建字段 单行文本仅支持创建「文本」业务类型的字段,填写规则、内容和模型设计器端创建字段一致。 4.2 表单属性 4.2.1 通用属性 在表单中,单行文本可以设置一些通用的属性:标题、占位提示、描述说明、默认值、只读、隐藏、禁用、必填、标题排列方式、宽度。 4.2.2 文本类型 文本类型选项为文本或密码。若设置为文本,输入时内容是可见的;若设置为密码,输入时是不可见的密码形态,如下图: 4.2.3 最小/大长度 设置输入框输入内容的长度,输入框会根据设置的值进行校验。 最大长度默认为创建字段时填写的长度,且设置的最大长度不可以大于字段的长度 最小长度默认为空,为空则为不限制最小长度 4.2.4 输入格式 设置输入格式为网址或者身份证时,会进行格式的校验 无:默认为无,不会校验内容 网址:进行网址校验 身份证:进行身份证号校验,设置后,需要输入正确的身份证号 4.2.5 显示计数器 当需要用户关注输入内容长度时,可以开启显示计数器,在输入时会实时显示当前内容的长度。 4.2.6 显示清除按钮 若开启了清除按钮,则在输入框有内容时,点击清除按钮一键清除已有内容 5. 多行文本 多行文本输入框,常用于记录字数较多的文字,如意见、复杂备注等。 5.1 创建字段 多行文本仅支持创建「多行文本」业务类型的字段,填写规则、内容和模型设计器端创建字段一致。 5.2 表单属性 5.2.1 通用属性 在表单中,单行文本可以设置一些通用的属性:标题、占位提示、描述说明、默认值、只读、隐藏、禁用、必填、标题排列方式、宽度。 5.2.2 最小/大长度 设置输入框输入内容的长度,输入框会根据设置的值进行校验。 -最大长度默认为创建字段时填写的长度,且设置的最大长度不可以大于字段的长度 -最小长度默认为空,为空则为不限制最小长度 5.2.3 显示计数器 当需要用户关注输入内容长度时,可以开启显示计数器,在输入时会实时显示当前内容的长度。 5.2.5 显示清除按钮 若开启了清除按钮,则在输入框有内容时,点击清除按钮一键清除已有内容 6. 整数 整数输入框,常用于输入整数的天数、数量等,如果会出现小数,请使用小数组件。 6.1 创建字段 整数仅支持创建「整数」业务类型的字段,填写规则、内容和模型设计器端创建字段一致。 6.2 表单属性 6.2.1 通用属性 在表单中,整数可以设置一些通用的属性:标题、占位提示、描述说明、默认值、只读、隐藏、禁用、必填、标题排列方式、宽度。 6.2.2 最小/大值 设置整数输入框输入内容的最值,输入框会根据设置的最值进行校验。 最大值可设置的范围根据字段填写的长度转换,如设置长度为3,则最大值最大不可以超过999 截图 6.2.3 显示千分位 数字过长时,不便于查看,可开启显示千分位。 7. 小数 小数输入框,常用于输入金额、单价等,会出现小数的数值。 7.1 创建字段 小数仅支持创建「浮点型」业务类型的字段,填写规则、内容和模型设计器端创建字段一致。 7.2 表单属性 7.2.1 通用属性 在表单中,小数可以设置一些通用的属性:标题、占位提示、描述说明、默认值、只读、隐藏、禁用、必填、标题排列方式、宽度。 7.2.2 最小/大值 设置小数输入框输入内容的最值,输入框会根据设置的最值进行校验。 最大值可设置的范围根据字段填写的长度转换,如设置长度为3,则最大值最大不可以超过999 7.2.3 保留小数位数 支持设置小数的保留位数,设置后在页面中输入内容时,将进行校验 可设置的保留小数位数不可大于该字段的精度,如字段精度为2,则组件属性中的小数位数最大只能为2; 7.2.4 显示千分位 数字过长时,不便于查看,可开启显示千分位。 8. 下拉单选 从多个选项中下拉选择一个数据,作为数据值。选项可以是关联模型的数据,也可以是数据字典或布尔型开关。 8.1 创建字段 下拉单选支持创建三种业务类型的字段,分别是:多对一、布尔型、数据字典。 多对一:创建字段时需要选择关联的模型,关联模型的数据将作为下拉选项; 布尔型:下拉选项默认只有是、否; 数据字典:创建字段时需要选择数据字典,其数据字典项将作为下拉选项 8.2 表单属性 8.2.1 通用属性 在表单中,下拉单选可以设置一些通用的属性:标题、占位提示、描述说明、只读、隐藏、禁用、必填、标题排列方式、宽度。 8.2.2 选项类型…

    2024年6月20日
    1.8K00
  • 3.4.1 构建第一个Function

    Function做为oinone的可管理的执行逻辑单元,是无处不在的 在3.3.3【模型的数据管理器】和3.3.2【模型类型】一文中的代理模型部分,涉及到包括在Action中自定义函数(action背后都对应一个Function)、重写queryPage的函数、以及独立抽取的公共逻辑函数,Function做为oinone的可管理的执行逻辑单元,是无处不在的。这也是为什么说oinone以函数为内在的原因。 一、构建第一个Function 因为数据管理器和数据构造器是oinone为模型自动赋予的Function,是内在数据管理能力。模型其他Function都需要用以下四种方式主动定义 伴随模型新增函数(举例) 它是跟模型的java类定义在一起,复用模型的命名空间。 Step1 为PetShop增加一个名为sayHello的Function package pro.shushi.pamirs.demo.api.model; …… //import @Model.model(PetShop.MODEL_MODEL) @Model(displayName = "宠物店铺",summary="宠物店铺",labelFields ={"shopName"} ) @Model.Code(sequence = "DATE_ORDERLY_SEQ",prefix = "P",size=6,step=1,initial = 10000,format = "yyyyMMdd") public class PetShop extends AbstractDemoIdModel { public static final String MODEL_MODEL="demo.PetShop"; …… //省略其他代码 @Function(openLevel = FunctionOpenEnum.API) @Function.Advanced(type=FunctionTypeEnum.QUERY) public PetShop sayHello(PetShop shop){ PamirsSession.getMessageHub().info("Hello:"+shop.getShopName()); return shop; } } 图3-4-1-1 代码示例 Step2 重启看效果 用graphQL工具Insomnia查看效果 用Insomnia模拟登陆 a. 创建一个login请求,用于保存login请求,为后续模拟登陆保留快捷方式 图3-4-1-2 创建一个login请求 b. 下面为登陆请求的GraphQL,请在post输入框中输入。如果请求输入框提示错误可以,可以点击schema 的Refresh Schema来刷新文档 mutation { pamirsUserTransientMutation { login(user: {login: "admin", password: "admin"}) { broken errorMsg errorCode errorField } } } 图3-4-1-3 登陆请求的GraphQL c. 点击Send按钮,我们可以看到登陆成功的反馈信息 图3-4-1-4 登陆成功的反馈信息 用Insomnia模拟访问PetShop的sayHello方法,gql的返回中,我们可以看到两个核心返回 a. 一是方法正常返回的shopName b. 二是“PamirsSession.getMessageHub().info("Hello:"+shop.getShopName())”代码执行的结果,在messages中有一个消息返回,更多消息机制详见4.1.23【框架之信息传递】 query{ petShopQuery{ sayHello(shop:{shopName:"cpc"}){ shopName } } } 图3-4-1-5 用Insomnia模拟访问PetShop的sayHello 图3-4-1-6 代码执行结果 用Insomnia模拟访问PetShopProxy的sayHello方法 效果同用Insomnia模拟访问PetShop的sayHello方法,体现Function的继承特性。 独立新增函数绑定到模型(举例) 独立方法定义类,并采用Model.model或Fun注解,但是value都必须是模型的编码,如@Model.model(PetShop.MODEL_MODEL)或@Fun(PetShop.MODEL_MODEL) Step1 提取PetShop的sayHello方法独立到PetShopService中 注释掉PetShop的sayHello方法 package pro.shushi.pamirs.demo.api.model; …… //import @Model.model(PetShop.MODEL_MODEL) @Model(displayName = "宠物店铺",summary="宠物店铺",labelFields ={"shopName"} ) @Model.Code(sequence = "DATE_ORDERLY_SEQ",prefix = "P",size=6,step=1,initial = 10000,format = "yyyyMMdd") public class PetShop extends AbstractDemoIdModel { public static final String MODEL_MODEL="demo.PetShop"; …… //省略其他代码 // @Function(openLevel = FunctionOpenEnum.API) // @Function.Advanced(type=FunctionTypeEnum.QUERY) // public PetShop sayHello(PetShop shop){ // PamirsSession.getMessageHub().info("Hello:"+shop.getShopName()); // return shop; // } } 图3-4-1-7 注释掉PetShop的sayHello 新增PetShopService接口类 接口的方法上要加上@Function注解,这样另模块依赖api包的时候,会自动注册远程服务的消费者 package pro.shushi.pamirs.demo.api.service; import pro.shushi.pamirs.demo.api.model.PetShop; import pro.shushi.pamirs.meta.annotation.Fun; import pro.shushi.pamirs.meta.annotation.Function; @Fun(PetShop.MODEL_MODEL) //@Model.model(PetShop.MODEL_MODEL) public interface…

    2024年5月23日
    2.0K00

Leave a Reply

Please Login to Comment