流程触发

1. 流程触发

新增的流程设计页面默认包含两个节点,一个是流程的触发节点:确定流程开始的条件;另一个是流程结束的节点。

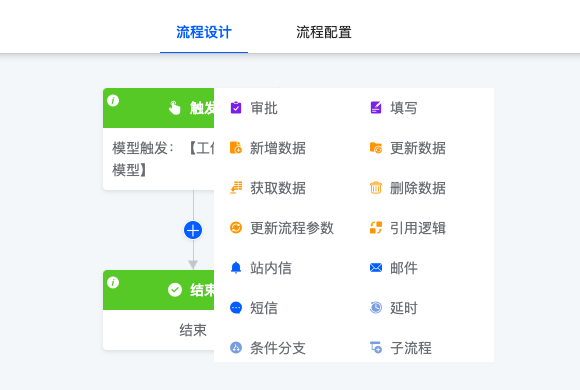
流程触发方式有模型触发、定时触发、日期触发三种方式,未设置流程触发方式时无法继续添加后续流程节点,同时无法进行流程发布,如左下图。触发方式设置完成后,可从左侧菜单栏拖入或流程箭头中的加号点击添加节点动作,如右下图。
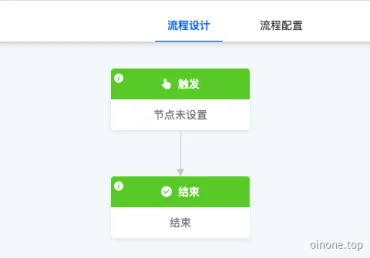
image.png

image.png

1.1 模型触发

模型触发适用于模型中的数据字段变化开始流程的场景,比如员工请假审批流程。

模型触发的场景有数据的增删改,也可以对模型中的单个或多个字段进行条件筛选,若包含更新数据的场景可以设置选择更新字段,只有设置的字段更新才会触发流程,若不设置选择更新字段或者筛选条件,则模型中任一字段发生设置场景的变化时都会触发流程。
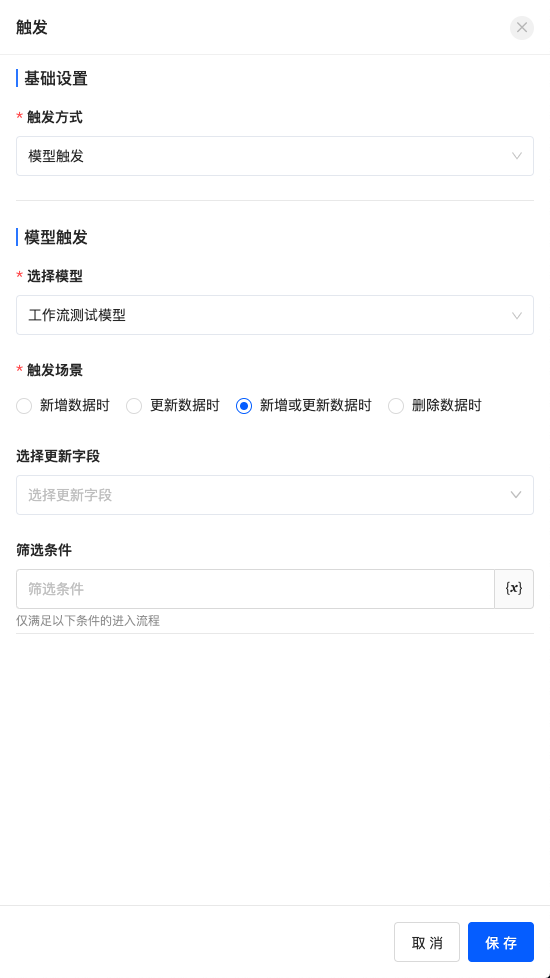
image.png

1.2 定时触发

定时触发适用于周期性调用流程的场景,比如仓库周期性盘点的流程。

需要设置一个流程第一次执行的时间,配置好循环的周期间隔。特殊的是选择周为周期时,当前周选中的日期也会执行流程。例:开始时间:2022-01-14(周四) 循环周期间隔:1周 自定义设置为周一到周五,则2022-01-15(本周五)也会执行流程操作。
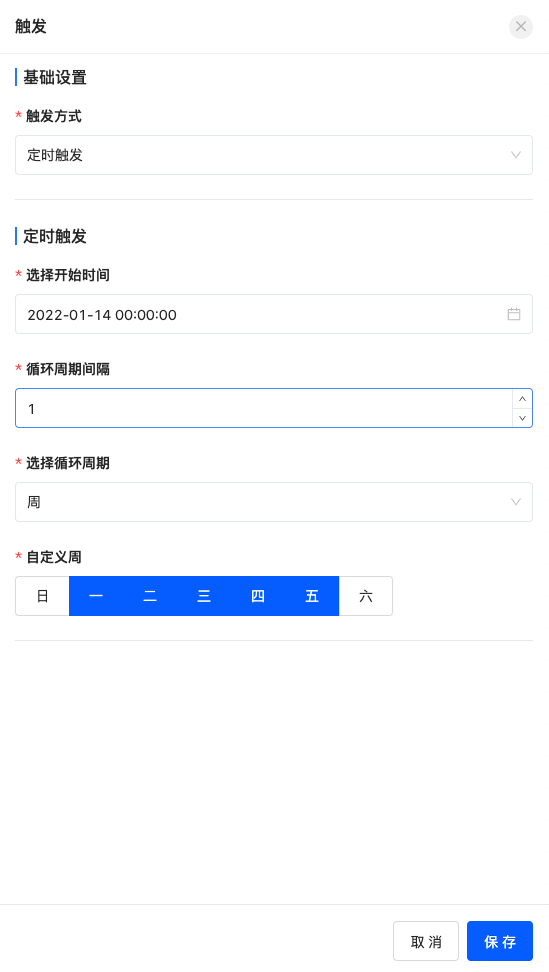
image.png

1.3 日期触发

日期触发适用于模型中的日期时间字段引发流程的场景,比如给员工发生日祝福短信的流程。

设置日期触发时,若指定字段只包含日期,则必须要指定时刻,如左下图。例如给员工发生日祝福短信时根据模型中的员工生日数据获取到了执行流程的日期,需要制定开始该流程执行的具体时刻。若指定字段包含日期和时间,则不填写指定时刻时默认按照字段中的时刻开始执行流程,如右下图。例如办理业务后短信回访收集评价时根据模型中的业务完成时间,立即或延时发送短息。
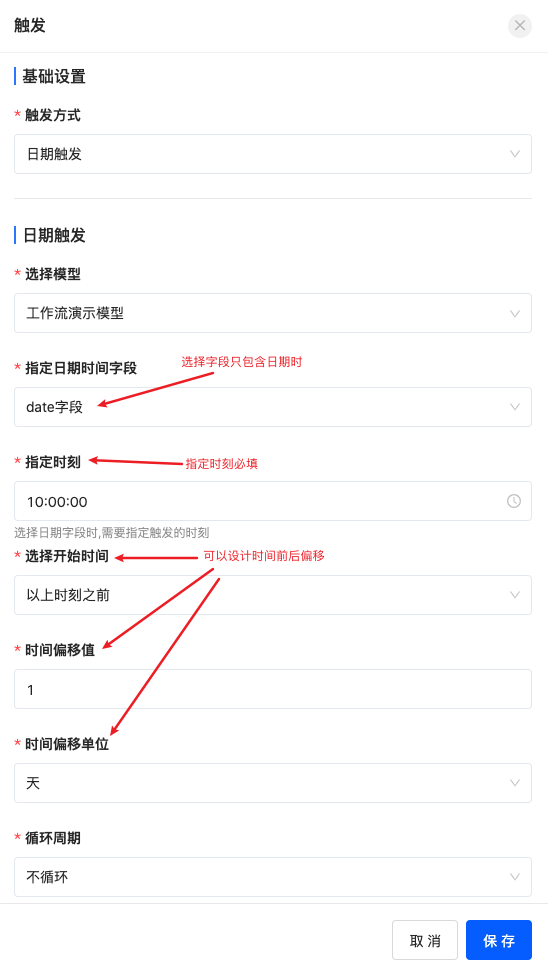
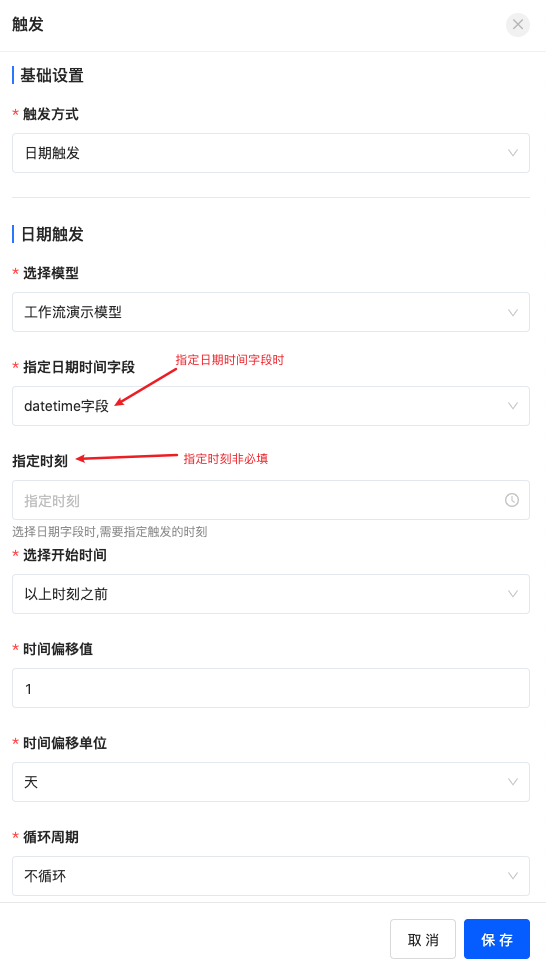
image.png

image.png

Oinone社区 作者:史, 昂原创文章,如若转载,请注明出处:https://doc.oinone.top/oio4/9413.html

访问Oinone官网:https://www.oinone.top获取数式Oinone低代码应用平台体验

Like (0)
史, 昂's avatar史, 昂数式管理员
Previous 2024年6月20日 am9:49
Next 2024年6月20日

相关推荐

  • 【附件一】下载说明

    章节说明 下载内容 下载地址 备注 3.1.1环境准备>环境准备(Mac版) 安装 jdk 1.8 https://www.oracle.com/java/technologies/downloads/#java8 安装 mysql 8.0.26 https://dev.mysql.com/downloads/mysql/ 安装 idea社区版2020.2.4 https://www.jetbrains.com/idea/download/other.html 安装idea插件 请移至Oinone官网https://www.oinone.top/对应页面下载或联系Oinone官方客服 根据各自Idea版本下载对应插件,下载文件后去除.txt后缀 安装 git 2.2.0 https://sourceforge.net/projects/git-osx-installer/files/git-2.15.0-intel-universal-mavericks.dmg/download?use_mirror=nchc 安装 GraphQL的客户端工具 Insomnia 请移至Oinone官网https://www.oinone.top/对应页面下载或联系Oinone官方客服 下载文件后修改文件名去除.txt后缀 安装 maven https://archive.apache.org/dist/maven/maven-3/3.8.1/binaries/ 安装脚本zk https://archive.apache.org/dist/zookeeper/zookeeper-3.5.8/apache-zookeeper-3.5.8-bin.tar.gz 安装脚本rocketmq https://archive.apache.org/dist/rocketmq/4.7.1/rocketmq-all-4.7.1-bin-release.zip 安装脚本redis https://download.redis.io/releases/redis-5.0.2.tar.gz 安装nvm https://github.com/nvm-sh/nvm/blob/master/README.md 3.1.1环境搭建>环境准备(Windows版) 安装JDK 1.8 https://www.oracle.com/java/technologies/downloads/#java8 安装 Apache Maven 3.8+ https://maven.apache.org/download.cgi 下载settings-develop.xml 请移至Oinone官网https://www.oinone.top/对应页面下载或联系Oinone官方客服 下载到 C:\Users\你的用户名.m2 目录中并重命名为settings.xml 安装 Jetbrains IDEA 2020.2.4 https://www.jetbrains.com/idea/download/other.html 安装 Jetbrains IDEA 2020.2.4需下载插件 https://pan.baidu.com/share/init?surl=HNzSxxH0KncvglkfITUrsA 提取密码: mdji 安装idea插件 请移至Oinone官网https://www.oinone.top/对应页面下载或联系Oinone官方客服 根据各自Idea版本下载对应插件,下载文件后去除.txt后缀 安装MySQL 8 https://dev.mysql.com/downloads/mysql/ 安装Git https://git-scm.com/download/win 安装GraphQL测试工具Insomnia https://github.com/Kong/insomnia/releases 安装RocketMQ https://rocketmq.apache.org/download/ 安装ElasticSearch 版本 8.4.1 https://www.elastic.co/cn/downloads/past-releases/elasticsearch-7-6-1 安装Redis https://download.redis.io/releases/ Zookeeper安装 https://dlcdn.apache.org/zookeeper/zookeeper-3.8.0/apache-zookeeper-3.8.0-bin.tar.gz 安装nodejs 版本12.12.0 https://nodejs.org/dist/v12.12.0/node-v12.12.0-win-x64.zip 安装cnpm https://www.npmjs.com/package/cnpm 3.2.1Oinone一模块为组织>构建第一个Module 安装archetype-project-generate.sh脚本 请移至Oinone官网https://www.oinone.top/对应页面下载或联系Oinone官方客服 3.5.5Oinone以交互为外在>设计器的结合 安装Docker https://www.docker.com/get-started/ 下载结构包:Oinone-op-ds.zip 请移至Oinone官网https://www.oinone.top/对应页面下载或联系Oinone官方客服 4.1.10后端高级特性>函数之触发与定时 下载canal中间件:pamirs-middleware-canal-deployer-3.0.1.zi 请移至Oinone官网https://www.oinone.top/对应页面下载或联系Oinone官方客服 4.1.11后端高级特性>函数之异步执行 下载tbSchedule的控制台jar包:pamirs-middleware-schedule-console-3.0.1.jar.txt 请移至Oinone官网https://www.oinone.top/对应页面下载或联系Oinone官方客服 下载schedule.json 请移至Oinone官网https://www.oinone.top/对应页面下载或联系Oinone官方客服 下载以下文件放在pamirs-demo-boot的src/main/resources/init目录下 4.1.25后端高级特性>框架之搜索引擎 ES安装 方式一:官方下载安装包:https://www.elastic.co/cn/downloads/past-releases/elasticsearch-8-4-1 下载后去除后缀.txt,然后解压文件 方式二:请移至Oinone官网https://www.oinone.top/对应页面下载或联系Oinone官方客服

    Oinone 7天入门到精通 2024年5月23日
    2.4K00
  • 4.1.10 函数之触发与定时(改)

    函数的触发和定时在很多场景中会用到,也是一个oinone的基础能力。比如我们的流程产品中在定义流程触发时就会让用户选择模型触发还是时间触发,就是用到了函数的触发与定时能力。 整体链路示意图(如下图4-1-10-1 所示),本文只讲trigger里的两类任务,一个是触发任务,一个是定时任务,异步任务放在4.1.11【函数之异步执行】一文中单独去介绍。 图4-1-10-1 整体链路示意图 一、触发任务TriggerTaskAction(举例) 触发任务的创建,使用pamirs-middleware-canal监听mysql的binlog事件,通过rocketmq发送变更数据消息,收到MQ消息后,创建TriggerAutoTask。 触发任务的执行,使用TBSchedule拉取触发任务后,执行相应函数。 注意:pamirs-middleware-canal监听的数据库表必须包含触发模型的数据库表。 Step1 下载canal中间件 下载pamirs-middleware-canal-deployer-3.0.1.zip,去.txt后缀为pamirs-middleware-canal-deployer-3.0.1.zip,解压文件如下: 图4-1-10-2 下载canal中间件 Step2 引入依赖pamirs-core-trigger模块 pamirs-demo-api增加pamirs-trigger-api <dependency> <groupId>pro.shushi.pamirs.core</groupId> <artifactId>pamirs-trigger-api</artifactId> </dependency> 图4-1-10-3 pamirs-trigger-api依赖包 DemoModule在模块依赖定义中增加@Module(dependencies={TriggerModule.MODULE_MODULE}) @Component @Module( name = DemoModule.MODULE_NAME, displayName = "oinoneDemo工程", version = "1.0.0", dependencies = {ModuleConstants.MODULE_BASE, CommonModule.MODULE_MODULE, UserModule.MODULE_MODULE, TriggerModule.MODULE_MODULE} ) @Module.module(DemoModule.MODULE_MODULE) @Module.Advanced(selfBuilt = true, application = true) @UxHomepage(PetShopProxy.MODEL_MODEL) public class DemoModule implements PamirsModule { ……其他代码 } 图4-1-10-4 模块依赖中增加Trigger模块 pamirs-demo-boot 增加pamirs-trigger-core和pamirs-trigger-bridge-tbschedule的依赖 <dependency> <groupId>pro.shushi.pamirs.core</groupId> <artifactId>pamirs-trigger-core</artifactId> </dependency> <dependency> <groupId>pro.shushi.pamirs.core</groupId> <artifactId>pamirs-trigger-bridge-tbschedule</artifactId> </dependency> 图4-1-10-5 增加pamirs-trigger-core和pamirs-trigger-bridge-tbschedule的依赖 修改pamirs-demo-boot的applcation-dev.yml 修改pamris.event.enabled和pamris.event.schedule.enabled为true pamirs_boot_modules增加启动模块:trigger pamirs: event: enabled: true schedule: enabled: true rocket-mq: namesrv-addr: 127.0.0.1:9876 boot: init: true sync: true modules: – base – common – sequence – resource – user – auth – message – international – business – trigger – demo_core 图4-1-10-6 启动模块中增加trigger模块 Step3 启动canal中间件 canal的库表需要手工建 create schema canal_tsdb collate utf8mb4_bin 图4-1-10-7 canal的建库语句 CREATE TABLE IF NOT EXISTS `meta_snapshot` ( `id` bigint(20) unsigned NOT NULL AUTO_INCREMENT COMMENT '主键', `gmt_create` datetime NOT NULL COMMENT '创建时间', `gmt_modified` datetime NOT NULL COMMENT '修改时间', `destination` varchar(128) DEFAULT NULL COMMENT '通道名称', `binlog_file` varchar(64) DEFAULT NULL COMMENT 'binlog文件名', `binlog_offest` bigint(20) DEFAULT NULL COMMENT 'binlog偏移量', `binlog_master_id` varchar(64) DEFAULT NULL COMMENT 'binlog节点id', `binlog_timestamp` bigint(20) DEFAULT NULL…

    2024年5月23日
    2.0K00
  • 2.1 数字化时代软件业的另一个本质变化

    随着企业从信息化向数字化转变,软件公司提供的产品也由传统的企业管理软件向企业商业支撑软件发展。这一变化带来了许多技术上的挑战和机遇。在之前的章节中,我们提到企业的视角已经从内部管理转向业务在线和生态在线协同,这也带来了一系列新的需求。但是,我们常常会忽视这一变化所带来的对系统要求的变化。在本章中,我们将探讨这些技术上的变化,以及这些变化所带来的机遇和挑战。 图2-1 从信息化到数字化软件本质变化 在信息化时代,企业的业务围绕着内部管理效率展开,借鉴国外优秀的管理经验,企业将其管理流程固化下来,典型的例子是ERP项目。这类项目上线后往往长期稳定,不轻易更改,因此信息化时代软件的技术流派侧重于通过模型对业务进行全面支持。例如,SAP具有丰富的配置能力,将已有企业管理思想抽象到极致。其功能基本上可以通过配置来实现,因此其模型设计特别复杂。但是,我们也应该清楚地了解到,配置是面向已知问题的。在数字化时代,创新和业务迭代速度非常快,这种方法可能就不太适合了。我们知道,模型抽象是在设计时具有前瞻性的,一旦不适合,修改起来就会异常困难。 随着数字化时代的到来,企业主的关注点已经从单一企业内部管理转变为了围绕企业上下游价值链的协同展开。这种变化给企业信息化系统提出了更高的要求,例如业务需求的响应速度、系统性能和用户体验等方面。现在,企业对软件不仅是管理需求的承载,更是业务在线化的承载。传统的重模型设计软件模式已经不再适用,因为业务本身不断创新和变化。因此,数字化时代需要新的软件技术流派,这种流派必须是轻模型加上低代码技术的结合体。通过模型抽象80%的通用场景,剩余的20%个性化需求可以通过技术手段来完成。这样的设计可以让每家企业的研发人员轻松理解模型,而不像ERP模型那样异常复杂,无法进行修改。此外,配合低代码技术可以快速研发和上线。如果说配置化是面向已知问题的,那么低代码就是面向未知问题设计的。虽然低代码的概念可以追溯到上个世纪80年代,当时是为了满足企业内部部门之间有协同需求,但又没有专业软件支撑,定制化开发又不划算的辅助场景。但现在它的核心原因是企业数字化的核心场景不稳定,变化很快,每家企业都有强烈的个性化需求。因此,低代码成为解决这些问题的核心手段,数字化时代的低代码需要具备处理复杂场景的能力,而不仅仅是围绕着内部管理展开。 企业在数字化转型的过程中需要考虑到不仅是成熟的全链路业务解决方案,还要应对数字化场景的快速变化和持续创新的需求。为此,Oinone打造了一站式低代码商业支撑平台,从业务与技术两个维度来帮助企业建立开放、链接、安全的数字化平台。这将在水平和垂直两个维度上全面推动企业数字化转型。 另外,低代码的另一个好处是完成了软件本身的数字化建设。通过基于元数据设计,元数据成为软件中数据、逻辑和交互的数据,软件结合AI可以有更多的创造可能。想象一下,AI了解软件的元数据后可以自我运作,人在极少情况下才需要参与,人机交互也会发生大的改变。未来的软件交互不再需要研发提前预设,而是能够实现用户所需即所呈现的效果。作为一家帮助企业进行数字化转型的软件公司,请问您的数字化转型是否已经完成呢?

    2024年5月23日
    1.7K00
  • 4.2.4 框架之网络请求-HttpClient

    oinone提供统一的网络请求底座,基于graphql二次封装 一、初始化 import { HttpClient } from '@kunlun/dependencies'; const http = HttpClient.getInstance(); http.setMiddleware() // 必须设置,请求回调。具体查看文章https://shushi.yuque.com/yqitvf/oinone/vwo80g http.setBaseURL() // 必须设置,后端请求的路径 图4-2-4-1 初始化代码示例 二、HttpClient详细介绍 获取实例 import { HttpClient } from '@kunlun/dependencies'; const http = HttpClient.getInstance(); 图4-2-4-2 获取实例 接口地址 import { HttpClient } from '@kunlun/dependencies'; const http = HttpClient.getInstance(); http.setBaseURL('接口地址'); http.getBaseURL(); // 获取接口地址 图4-2-4-3 接口地址 请求头 import { HttpClient } from '@kunlun/dependencies'; const http = HttpClient.getInstance(); http.setHeader({key: value}); 图4-2-4-4 请求头 variables import { HttpClient } from '@kunlun/dependencies'; const http = HttpClient.getInstance(); http.setExtendVariables((moduleName: string) => { return customFuntion(); }); 图4-2-4-5 variables 回调 import { HttpClient } from '@kunlun/dependencies'; const http = HttpClient.getInstance(); http.setMiddleware([middleware]); 图4-2-4-6 回调 业务使用-query private http = HttpClient.getInstance(); private getTestQuery = async () => { const query = `gql str`; const result = await this.http.query('module name', query); console.log(result) return result.data[`xx`]['xx']; // 返回的接口,打印出result对象层次返回 }; 图4-2-4-7 业务使用-query 业务使用-mutate private http = HttpClient.getInstance(); private getTestMutate = async () => { const mutation = `gql str`; const result = await this.http.mutate('module name', mutation); console.log(result) return result.data[`xx`]['xx']; // 返回的接口,打印出result对象层次返回 }; 图4-2-4-8 业务使用-mutate 三、如何使用HttpClient 初始化 在项目目录src/main.ts下初始化httpClient 初始化必须要做的事: 设置服务接口链接 设置接口请求回调 业务实战 前文说到自定义新增宠物表单,让我们在这个基础上加入我们的httpClient; 第一步新增service.ts 图4-2-4-8 新增service.ts service.ts import { HttpClient }…

    2024年5月23日
    2.5K00
  • 1.4 Oinone对软件特性的思考

    我在个人的微信公众号上《浅谈企业IT架构的十年困局》一文中写了“企业或者软件公司在工程领域都关注哪些特征,而这些特征又应与具体研发人员的个体能力无关”的相关内容。收到很多业内人士的留言,也引起了很多同行的共鸣,所以今天在这里也打算针对这个话题,跟大家再做个深入的探讨。 一、首先为什么强调要跟研发个体能力无关 我们先来看一个故事: 轮扁是春秋时期齐国的木工,齐桓公召其入宫打造物件。有一天,齐桓公在堂上看书,轮扁在堂下用椎、凿等工具做车轮。 齐桓公看书看到得意处,不由得读出声来。轮扁听到读书声,想了想,放下手里的工具,走上堂来,在齐桓公面前几步远的地方停下,恭恭敬敬地说:“请恕臣斗胆问一下,君王读的是什么书?”齐桓公没想到这个老木匠会走上堂来,倒有点意外。不过看在他年纪大的份上,倒也不去斥责他,就回答说:“寡人读的是圣人写的书。”轮扁问:“圣人还在吗?”齐桓公说:“已经死了。”轮扁说:“这样看起来,君王所读的,不过是古人的糟粕而已!”齐桓公勃然大怒,说:“寡人读书,你一个做车轮的怎么敢议论?你说,这书上怎么会是古人的糟粕?说出道理便罢,说不出道理便难逃一死!” 轮扁不慌不忙地说:“臣是根据臣所从事的活计而明白这个道理的。砍削轮子,榫头做得宽了则松滑而不牢固,做得太紧就必然涩滞而安不进去,臣制作的榫头松紧适宜,是因为心里怎样想的手便怎样去做。然而尽管所需要的分寸度数心里都明白,要把它用言辞表达出来却实在不可能,全靠自己手与心的配合。所以,臣无法将其中的奥秘传授给儿子,臣的儿子也无法从臣这里学到其中的奥秘。因此,臣如今七十多岁了,还只好亲手去干制作轮子的活。这样看来,古人之道的精华都已随着古人死去而无法传世,那么君王所读的,不就是古人的糟粕了吗?” 这就是著名的成语故事——轮扁斫轮,出自《庄子·天道》。庄子通过轮扁的言论,深刻地揭示了高妙之技的难以言传。 而当我们转换视角,在企业数字化转型领域,无论是软件公司还是甲方IT团队,核心上是应用级开发需求,更多的精力应该放在业务场景理解、需求把控以及业务系统实现上。但往往在一个项目进入研发之前,会花很大力气在技术架构设计、技术栈选型、通用能力对接、扩展点设计这些跟业务场景无关的技术事项上,且需要高级别的架构师来主导。大部分情况下,架构师会选开源框架来实现,慢慢沉淀为企业的研发标准体系,所以底层架构的能力往往依赖架构师个人能力。不禁发现他们与轮扁有着异曲同工之处。架构师所积累的个人经验和技术能力,往往难以通过简单的手把手教学、技术评审会完全传递给团队中的其他成员。即使有所传授,其效率也可能仅达到50%,并且随着团队成员数量的增加,这种效率还可能持续递减。因此,我们需要更多地依赖于技术手段,将架构师的经验和能力固化下来,形成一套可复制、可推广的标准技术产品。这样,每个团队成员都能够通过学习和运用这些技术,达到至少70%的传递效率,从而确保团队整体技术水平的稳步提升。这也正是开篇所强调的,企业或软件公司在工程领域所关注的特征,应当与具体研发人员的个体能力相剥离,而更多地依赖于标准化、系统化的技术手段,来确保团队整体的高效运作。 二、软件公司在工程化领域都关注哪些特征 接下来,我将从技术角度深入剖析设计初衷和技术实现原理,以展现技术公司应当“被标准化的特征”究竟长什么样。 先做个名称解释,下文中涉及“标品”、“升级”、“扩展逻辑”,这是站在软件公司角度出发描述的,如果是企业内部可以把标品理解为特定业务应用平台,升级则是业务应用平台的正常规划迭代,扩展逻辑理解为脱离平台发展的临时性需求。 1. 可逆计算 可逆计算,在应用上的特征图 场景:调查发现企业研发至少有40%的精力在跟各条业务线的团队在评审项目需求,判断需求是否合理。而且业务线对需求完善时间要求紧,每天盯着研发进度,经常问“这个需求什么时候支持,我们等着用”。导致产研部门的研发抱怨产品节奏乱,无法按照自身节奏进行迭代,被项目推着走,没有时间思考,人手不足,加班多,工作压力大…… 价值:该特性很好的规避了研发因为时间紧迫,写的一些临时代码腐蚀核心业务系统。它需要做到不论从数据模型、业务逻辑、交互展示都能有扩展能力,并且这些扩展能力与个体研发无关才行。它同时所描述的也是一个具备差量计算能力的软件架构模式,它允许用户通过添加或移除扩展包来定制标准应用,同时保持应用的可逆性和独立性。这种架构模式的核心优势在于其灵活性和可维护性,使得应用的定制和恢复变得简单而高效。 技术原理:它所描述的是一个基于元数据驱动和差量计算的软件架构模式,它允许用户通过添加或移除扩展包来定制标准应用,同时保持应用的可逆性和独立性。这种架构模式的核心优势在于其灵活性和可维护性,通过元数据来驱动应用的构建和变更,使得应用的定制和恢复变得简单而高效 在这种架构中,元数据起到了至关重要的作用。元数据是关于数据的数据,它描述了数据的结构、属性、关系等信息。在软件应用中,元数据可以用来描述应用的组件、功能、配置等信息。通过元数据驱动应用可以根据元数据的描述来动态地构建和配置自身的功能和结构 差量计算则是实现应用可逆性的关键。当添加或移除扩展包时,系统会根据扩展包中的元数据与标准应用的元数据进行差量计算,确定需要添加或移除的功能和组件。这种差量计算可以确保在添加扩展包后,应用能够保持原有的功能和稳定性,同时新增扩展包带来的新功能,而在去除扩展包时,应用能够恢复到原始的标准状态,不会留下任何冗余或冲突的代码和配置。 为了实现这种架构模式,元数据注册表和分布式部署能力是非常重要的。元数据注册表需要能够存储和管理大量的元数据信息,并且提供高效的查询和更新机制。分布式部署能力则能够确保应用在不同的环境中都能够稳定运行,并且能够快速地响应扩展包的添加和移除操作,即差量(扩展包》可独立存在又相互作用。 总的来说,这种基于元数据驱动和差量计算的软件架构模式为应用的定制和恢复提供了强大的支持,使得应用能够根据不同的需求进行灵活的定制和扩展。同时,它也提高了应用的可维护性和可靠性,降低了开发和维护的成本 2. 协同演进 协同演进,在应用上的特征图 场景:它所描述的场景是一个复杂的软件升级过程,其中涉及了标准应用的升级以及用户个性化扩展的保留。通过面向对象的方式扩展标准应用的功能,可以在升级过程中保持用户自定义逻辑的完整性,并同时集成新版本中的新特性。 价值:很多号称产品型的软件公司,在交付客户项目的时候,都是从标品复制一个分支,然后客户个性化直接在这个分支上改。这种模式会带来两个问题: 是当客户数量变大,每个客户的版本都不一致,维护成本很高; 是当标品升级带来的新特性无法复制给客户,导致客户满意度下降甚至流失。协同演进就是要解决这个问题。 技术原理:它需要在第一个差量计算的特性基础上才能得以完成,同时在这种升级能力中,元数据驱动和模型驱动是关键所在。元数据驱动确保了应用能够理解和处理不同版本之间的变化,包括功能的增删改以及结构的调整。模型驱动则提供了描述和管理应用结构、组件和行为的能力,它不仅能够描述模型间的关系,还能够支持面向对象的特性,如继承、重写和重载等。 具体来说,当标准应用从V1升级到V2时,元数据驱动机制会首先识别和分析两个版本之间的差异。对于用户应用1中已经扩展的A功能,由于采用了面向对象的方式进行扩展,因此在升级过程中,A+逻辑作为A功能的重写或重载版本会被保留下来。同时,V2版本中新增的B功能也会被集成到用户应用1中,因为它是作为标准应用的新特性而存在的。 这种升级能力的实现依赖于一个强大的元数据注册表和模型管理能力。元数据注册表需要能够存储和管理不同版本应用的元数据信息,包括功能、组件、结构等。模型管理能力则需要能够解析和应用这些元数据,以生成正确的应用结构和行为。同时,还需要一套高效的升级机制来确保升级过程的平滑和可靠。 总的来说,通过元数据驱动和模型驱动的结合,可以实现标准应用的平滑升级,同时保留用户个性化扩展的完整性。这种能力对于提高软件的可维护性、可扩展性和用户满意度具有重要意义 3. 公民研发和专业研发共同参与 专业研发与公民研发共同参与,在应用上的特征图 场景:它所描述是在应用开发的整个生命周期中,专业研发专注在标品的长期规划与迭代,当出现临时性的需求或者应急性的辅助场景则由非专业人士进行即公民研发方式进行。这种模式下,专业研发可以按照规划有节奏的迭代产品,做更高级的事情,不至于忙于应对临时性的事务没有深度思考,更加避免了因为临时代码堆积导致产品从内部腐化。同时利用独立的扩展逻辑包和无代码方式解决了业务的紧迫感,毕竟业务需求的合理性是很难争论出高低的。它在前两个特性基础上让研发效能进一步得到释放。 价值:它的本质是,在专业研发在以低代码的方式下实现应用,并通过无代码的方式,快速扩展逻辑功能和创建辅助性应用。整个过程无缝衔接,我们给他取个名字专业名称叫:“低无一体”。它大大降低了技术门槛,使得专业和非专业的研发人员都能参与到应用扩展和定制中来。此外,它还提高了业务响应能力,使得企业能够更快速地适应市场变化和客户需求。 技术原理:它的核心要求就是元数据在线,元数据在线能力是指能够实时地、在线地管理和操作元数据,这种能力为企业或组织带来了诸多优势。通过无 代码的方式,用户可以更加灵活地进行应用的个性化扩展,以应对各种应急性需求,从而显著提升业务的响应能力。此外,元数据在线管理还确保核心应用、核心应用扩展以及辅助应用都是基于一套统一的技术体系构建的,这为不同角色的用户(包括专业和非专业的研发人员)提供了多样化的参与方式。同时,元数据在线管理需要符合开闭原则,这确保了系统的稳定性和可扩展性,使得新的功能或需求可以通过添加新的元数据或配置来实现,而非修改现有系统。 这种低代码开发与无代码一体化的优势在于,它大大降低了技术门槛,使得专业和非专业的研发人员都能参与到应用扩展和定制中来。此外,它还提高了业务响应能力,使得企业能够更快速地适应市场变化和客户需求。 总之,从用户应用到业务实施的过程通过元数据在线得到了优化和升级。低代码开发与无代码一体化的优势使得整个过程更加高效、灵活和易于维护,为企业带来了显著的价值和竞争优势。 4. 基于平台级别的AOP能力出现反向集成 反向集成,在应用上的特征图 场景:平台级别的AOP(面向切面编程)能力允许开发者在应用程序的特定点“切入”额外的逻辑,而无需修改原有的业务代码。这种能力特别适用于横向追加平台逻辑,即在多个不同服务或功能点插入通用的处理逻辑,如日志记录、权限检查、审计、多租户、多语言等。过往在微服务架构中,这些能力都需要业务系统各自主动去对接,有了平台级别的AOP能力,则这些通用能力可以反向为所有业务系统增加特性能力,无需业务系统研发感知。这种现象我们称之为“反向集成”,能让业务研发更加专注在业务研发本身,不需要关心与业务无关的通用功能上。 价值:AOP的核心思想是将这些横切关注点(cross-cutting concerns)从业务逻辑中分离出来,使得业务代码更加清晰和专注于其核心功能。在平台级别的AOP中,标准化协议是实现这一能力的关键。平台具备统一的入口和扩展能力是非常重要的,因为它允许开发者在不修改现有代码的情况下添加新功能或修改现有功能的行为。这种能力对于快速响应业务需求变化、减少维护成本和提高代码质量都是非常有益的。 技术原理:标准化协议确保了不同组件之间的通信与语义是统一的,从而使得AOP能够更容易地实施。例如: a前后端通信要标准协议(与端无关): 这意味着无论前端是使用Web、移动应用还是其他类型的客户端,后端服务都应该能够以一种标准的方式与之通信。 bORM层要有标准协议(与数据库无关): 对象关系映射 (ORM)层应该提供一个标准的接口来与数据库进行交互,这样无论底层使用哪种数据库(如MySQL、PostgreSQL、Oracle等),上层的业务逻辑都不需要改变。 cRPC需要标准协议(与Dubbo和Spring Cloud无关): 远程过程调用 (RPC)应该遵循一种标准协议,以便不同的服务可以无缝地进行通信,而不受特定框架 (如Dubbo、Spring Cloud等)的限制。 d所有逻辑调用统一fun调用: 这意味着平台上的所有功能调用都应该通过一个统一的入口点(如一个函数或方法)进行,这样AOP就可以在这个入口点切入额外的逻辑。 总的来说,平台级别的AOP能力通过标准化协议和统一的调用入口,为开发者提供了一种强大而灵活的方式来管理和扩展平台的逻辑功能。 5. 应用研发与部署无关 应用研发与部署无关,在应用上的特征图 场景:现在研发在选择部署方式的时候往往会选择分布式部署,或者你的客户招标需求里就写着“微服务”,构建一个微服务系统并不是一件容易的事,构建的复杂度远远超过单体系统,开发人员需要付出一定的学习成本去掌握更多的架构知识和框架知识。服务与服务之间通过HTTP协议或者消息传递机制通信,开发者需要选出最佳的通信机制,并解决网络服务较差时带来的风险。另外服务与服务之间相互依赖,如果修改某一个服务,会对另一个服务产生影响,如果掌控不好。会产生不必要的麻烦。由于服务的依赖性,测试也会变得很复杂,比如修改一个比较基础的服务,可能需要重启所有的服务才能完成测试。前段时间有篇很火的文章,《从微服务转为单体架构、成本降低 90%!》,无论是选择何种部署方式,我认为这都应该跟应用研发无关。 价值:应用研发与部署无关的理念确实为现代软件架构带来了显著的优势,它使得研发团队能够专注于业务逻辑和功能实现,而无需担心具体的部署细节。这种分离带来了灵活性、效率以及成本效益的多重提升。应该采用一种同时支持分布式和单体部署、且可以自由切换的架构,我们称之为可分可合。 首先,可分可合的能力使得系统能够灵活应对业务量的变化。在业务量小的时候,可以采用单体部署的方式,简化部署流程,降低初期成本。随着业务量的增长,系统可以平滑地过渡到分布式部署,通过拆分微服务来提高系统的处理能力和扩展性。这种灵活性确保了系统既能满足未来发展的需要,又能兼顾当下的成本效益。 其次,应用级别扩容的能力使得系统性能不再受限。通过增加微服务实例或调整资源配置,系统可以按需进行扩容,从而确保在业务高峰期或突发流量下仍能保持稳定的性能。这种按需扩容的方式不仅提高了系统的可靠性,还降低了运维成本。 技术原理:核心在于逻辑调用的统一执行和智能判断。通过如funEngine这一统一调用引擎,系统能够智能地选择最适合当前业务场景和性能需求的fun调用方式。无论是同步调用、异步调用还是基于消息队列的调用方式,funEngine都能进行智能决策,确保调用的高效性和可靠性。这种统一调用的方式简化了开发过程,降低了开发难度,同时也提高了系统的可维护性和可扩展性。 此外如果作为低代码或者其他研发平台来说。被集成特性也是实现该特性的关键所在。它提供了一套标准化的接口和协议,使得其他系统或应用能够轻松地与其进行集成。这种平台框架化的特性能够作为一个统一的、可扩展的框架来支撑整个系统的运行。 综上所述,具备可分可合的能力、应用级别扩容以及逻辑调用的统一执行和被集成特性,共同构成了应用研发与部署无关这一核心特性。该特性使得软件系统能够灵活地应对业务变化,实现高效、可扩展和可维护的运行,从而满足客户的长期发展需求并兼顾当下的成本效益。

    2024年5月23日
    2.6K10

Leave a Reply

Please Login to Comment