
1.2 Oinone的致敬

占在巨人的肩膀上,天地孤影任我行

1.2.1 数字化时代Oinone接棒Odoo

在数字化时代,中国在互联网化的应用、技术的领先毋庸置疑,但在软件的工程化、产品化输出方面仍有许多改进的空间。这时,我了解到了Odoo——一个国外非常优秀的开源ERP厂商,全球ERP用户数量排名第一,百级别员工服务全球客户。Odoo的工程化能力和商业模式深深吸引了我,它是软件行业典型的产品制胜和长期主义者的胜利之一。

在2019年,也就是数式刚成立的时候,我们跟很多投资人聊起公司的对标是谁,我不是要成为数字化时代的SAP,而是要成为Odoo。然而,当时大部分国内投资人并不了解Odoo,尽管它已经是全球最大的ERP厂商之一,因为当时Odoo还没有明确的估值。直到2021年7月份获得Summit Partners的2.15亿美元投资后,Odoo才正式成为IT独角兽企业。

Odoo对我们提供了极大的启示,因此我们致敬Odoo,同样选择开源,每年对产品进行升级发布。如今,Odoo15已经发布,而Oinone也已推出第三版,恰好相隔12年,这是一个时代的接棒,从信息化升迁至数字化。

1.2.2Oinone与Odoo的不同之处

  1. 技术方面的不同

在技术上,Oinone和Odoo有相同之处,也有不同之处。它们都基于元数据驱动的软件系统,但是它们在如何让元数据运作的机制上存在巨大差异。Odoo是企业管理场景的单体应用,而Oinone则致力于企业商业场景的云原生应用。因此,它们在技术栈的选择、前后端协议设计、架构设计等方面存在差异。

  1. 场景方面的不同

在场景上,Oinone和Odoo呈现许多差异。相对于SAP这些老牌ERP厂商,Odoo算是西方在企业级软件领域的后起之秀,其软件构建方式、开源模式和管理理念在国外取得了非凡的成就。然而,在国内,Odoo并没有那么成功或者并没有那么知名。国内做Odoo的伙伴普遍认为,Odoo与中国用户的交互风格不符,收费模式设计以及外汇管制使商业活动受到限制,本地化服务不到位,国内生态没有形成合力,伙伴们交流合作都非常少。另外,Odoo在场景方面主要围绕内部流程管理,与国内老牌ERP如用友、金蝶重叠,市场竞争激烈。相比之下,Oinone看准了企业视角由内部管理转向业务在线、生态在线(协同)带来的新变化,聚焦新场景,利用云、端等新技术的发展,从企业内外部协同入手,以业务在线驱动企业管理流程升级。它先立足于国内,做好国内生态服务,再着眼未来的国际化。

  1. 无代码设计器的定位

在无代码设计器的定位上,Odoo的无代码设计器是一个非常轻量的辅助工具,因为ERP场景下,一个企业实施完以后基本几年不会变,流程稳定度非常高。相反,Oinone为适应"企业业务在线化后,所有的业务变化与创新都需要通过系统来触达上下游,从而敏捷响应快速创新"的时代背景,重点打造出五大设计器。(如下图1-2所示)。
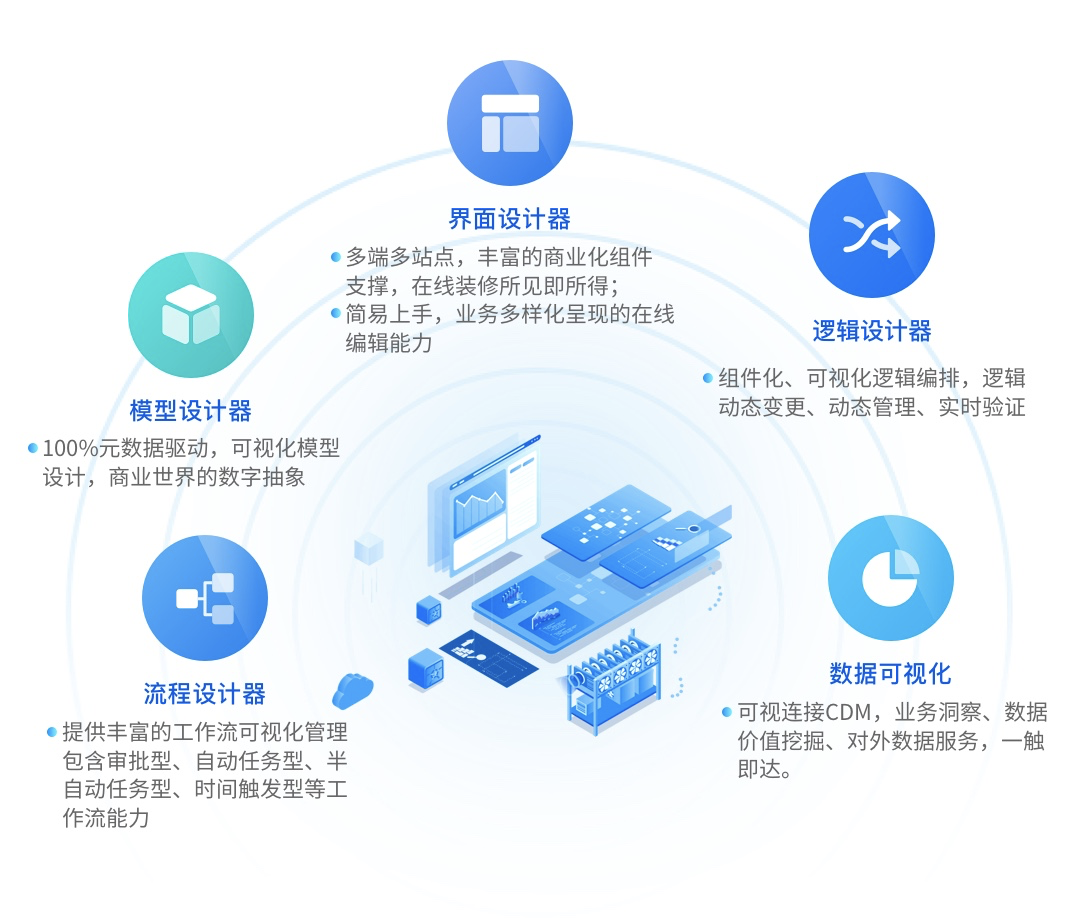
image.png

图1-2 Oinone五大设计器

在数字化时代中国软件将接棒世界,而Oinone也要接棒Odoo,把数字化业务与技术的最佳实践赋能给企业,帮助企业数字化转型不走弯路!

Oinone社区 作者:史, 昂原创文章,如若转载,请注明出处:https://doc.oinone.top/oio4/9211.html

访问Oinone官网:https://www.oinone.top获取数式Oinone低代码应用平台体验

Like (0)
史, 昂's avatar史, 昂数式管理员
Previous 2024年5月23日 am10:11
Next 2024年5月23日 am10:13

相关推荐

  • 3.3.2 模型的类型

    本文会介绍不同类型模型以及其简单的应用场景,方便大家理解不同类型模型的用途 模型分为元模型和业务模型。元数据是指描述应用程序运行所必需的数据、规则和逻辑的数据集;元模型是指用于描述内核元数据的一套模式集合;业务模型是指用于描述业务应用元数据的一套模式集合。 元模型分为模块域、模型域和函数域三个域。域的划分规则是根据元模型定义数据关联关系的离散性来判断,离散程度越小越聚集到一个域。在4.1.4【模块元数据详解】一文中介绍的ModuleDefinition就是元模型。而我们在开发中涉及的就是业务模型 一、模型类型 抽象模型:往往是提供公共能力和字段的模型,它本身不会直接用于构建协议和基础设施(如表结构等)。 传输模型:用于表现层和应用层之间的数据交互,本身不会存储,没有默认的数据管理器,只有数据构造器。 存储模型:存储模型用于定义数据表结构和数据的增删改查(数据管理器)功能,是直接与连接器进行交互的数据容器。 代理模型:用于代理存储模型的数据管理器能力的同时,扩展出非存储数据信息的交互功能的模型。 二、模型定义种类 模型定义就是模型描述,不同定义类型,代表计算描述模型的元数据的规则不同 静态模型定义:模型元数据不持久化、不进行模型定义的计算(默认值、主键、继承、关联关系) 静态计算模型定义:模型元数据不持久化但初始化时进行模型定义计算获得最终的模型定义 动态模型定义:模型元数据持久化且初始化时进行模型定义计算获得最终的模型定义 静态模型定义需要使用@Model.Static进行注解;静态计算模型定义使用@Model.Static(compute=true)进行注解;动态模型定义不注解@Model.Static注解。 三、安装与更新 使用@Model.model来配置模型的不可变更编码。模型一旦安装,无法在对该模型编码值进行修改,之后的模型配置更新会依据该编码进行查找并更新;如果仍然修改该注解的配置值,则系统会将该模型识别为新模型,存储模型会创建新的数据库表,而原表将会rename为废弃表。 如果模型配置了@Base注解,表明在【oinone的设计器】中该模型配置不可变更;如果字段配置了@Base注解,表明在【oinone的设计器】中该字段配置不可变更。 四、基础配置 模型基类 所有的模型都需要继承以下模型中的一种,来表明模型的类型,同时继承以下模型的默认数据管理器(详见3.3.3模型的数据管理器一节)。 继承BaseModel,构建存储模型,默认无id属性。 继承BaseRelation,构建多对多关系模型,默认无id属性。 继承TransientModel,构建临时模型(传输模型),临时模型没有数据管理器,也没有id属性。 继承EnhanceModel,构建数据源为ElasticSearch的增强模型。 快捷继承 继承IdModel,构建主键为id的模型。继承IdModel的模型会数据管理器会增加queryById方法(根据id查询单条记录) 继承CodeModel,构建带有唯一编码code的主键为id的模型。可以使用@Model.Code注解配置编码生成规则。也可以直接覆盖CodeModel的generateCode方法或者自定义新增的前置扩展点自定义编码生成逻辑。继承CodeModel的模型会数据管理器会增加queryByCode方法(根据唯一编码查询单条记录) 继承VersionModel,构建带有乐观锁,唯一编码code且主键为id的模型。 继承IdRelation,构建主键为id的多对多关系模型。 模型继承关系图 图3-3-2-1 模型继承关系图 AbstractModel抽象基类是包含createDate创建时间、writeDate更新时间、createUid创建用户ID、writeUid更新用户ID、aggs聚合结果和activePks批量主键列表等基础字段的抽象模型。 TransientModel传输模型抽象基类是所有传输模型的基类,传输模型不存储,没有数据管理器。 TransientRelation传输关系模型是所有传输关系模型的基类,传输关系模型不存储,用于承载多对多关系,没有数据管理器。 BaseModel存储模型基类提供数据管理器功能,数据模型主键可以不是ID。 IdModel带id模型抽象基类,在BaseModel数据管理器基础之上提供根据ID查询、更新、删除数据的功能。 BaseRelation关系模型抽象基类用于承载多对多关系,是多对多关系的中间模型,数据模型主键可以不是ID。 IdRelation带id关系模型抽象基类,在BaseRelation数据管理器基础之上提供根据ID查询、更新、删除数据的功能。 CodeModel带code模型抽象基类,提供按配置生成业务唯一编码功能,根据code查询、更新、删除数据的功能。 EnhanceModel增强模型,提供全文检索能力。此模型会在4.1.25【框架之搜索引擎】一文中展开介绍。 五、抽象模型(举例) 抽象模型本身不会直接用于构建协议和基础设施(如表结构等),而是通过继承的机制供子模型复用其字段和函数。子模型可以是所有类型的模型。 比如demo模块要管理的一些公共模型字段,我们可以建一个AbstractDemoIdModel和AbstractDemoCodeModel,demo模块中的实体模型就可以继承它们。我们来为demo模块的模型统一增加一个数据状态这么一个字段,用做数据的生效与失效管理。 Step1 引入DataStatusEnum类 pamirs-demo-api的pom.xml包增加依赖,便于引入DataStatusEnum类,当然也可以自己建,这里只是oinone提供了统一的数据记录状态的枚举,以及相应的通用方法,这边就直接引入 <dependency> <groupId>pro.shushi.pamirs.core</groupId> <artifactId>pamirs-core-common</artifactId> </dependency> 图3-3-2-2 引入通用类库 Step2 修改DemoModule DataStatusEnum枚举类本身也会做为数据字典,以元数据的方式被管理起来,当一个模块依赖另一个模块的元数据相关对象,则需要改模块的模块依赖定义。为DemoModule增加CommonModule的依赖注解 package pro.shushi.pamirs.demo.api; import org.springframework.stereotype.Component; import pro.shushi.pamirs.boot.base.ux.annotation.action.UxRoute; import pro.shushi.pamirs.boot.base.ux.annotation.navigator.UxHomepage; import pro.shushi.pamirs.core.common.CommonModule; import pro.shushi.pamirs.demo.api.model.PetShop; import pro.shushi.pamirs.meta.annotation.Module; import pro.shushi.pamirs.meta.base.PamirsModule; import pro.shushi.pamirs.meta.common.constants.ModuleConstants; @Component @Module( name = DemoModule.MODULE_NAME, displayName = "oinoneDemo工程", version = "1.0.0", dependencies = {ModuleConstants.MODULE_BASE, CommonModule.MODULE_MODULE} ) @Module.module(DemoModule.MODULE_MODULE) @Module.Advanced(selfBuilt = true, application = true) @UxHomepage(@UxRoute(PetShop.MODEL_MODEL)) public class DemoModule implements PamirsModule { public static final String MODULE_MODULE = "demo_core"; public static final String MODULE_NAME = "DemoCore"; @Override public String[] packagePrefix() { return new String[]{ "pro.shushi.pamirs.demo"}; } } 图3-3-2-3 定义模块依赖 Step3 新建AbstractDemoCodeModel和AbstractDemoIdModel 并新增AbstractDemoIdModel和AbstractDemoCodeModel分别继承IdModel和CodeModel,实现IDataStatus接口不是必须的,刚好DataStatus有配套的通用逻辑,暂时也先加进去,具体使用会在本文的【代理模型】这段介绍 package pro.shushi.pamirs.demo.api.model; import pro.shushi.pamirs.core.common.behavior.IDataStatus; import pro.shushi.pamirs.core.common.enmu.DataStatusEnum; import pro.shushi.pamirs.meta.annotation.Field; import pro.shushi.pamirs.meta.annotation.Model; import pro.shushi.pamirs.meta.annotation.sys.Base; import pro.shushi.pamirs.meta.base.common.CodeModel; import pro.shushi.pamirs.meta.enmu.ModelTypeEnum; @Base @Model.model(AbstractDemoCodeModel.MODEL_MODEL) @Model.Advanced(type = ModelTypeEnum.ABSTRACT) @Model(displayName = "AbstractDemoCodeModel") public abstract class AbstractDemoCodeModel extends CodeModel implements IDataStatus { public static final String MODEL_MODEL="demo.AbstractDemoCodeModel"; @Base @Field.Enum @Field(displayName = "数据状态",defaultValue = "DISABLED",required =…

    2024年5月23日
    2.2K00
  • 3.3.8 字段类型之基础与复合

    模型字段是描述实体的特征属性,本文介绍重点介绍字段的基础类型与复合类型 使用@Field注解来描述模型的字段。如果未配置字段类型,系统会根据Java代码的字段声明类型来自动获取业务类型。建议配置displayName属性来描述字段在前端的显示名称。可以使用defaultValue配置字段的默认值。 一、安装与更新 使用@Field.field来配置字段的不可变更编码。字段一旦安装,无法在对该字段编码值进行修改,之后的字段配置更新会依据该编码进行查找并更新;如果仍然修改该注解的配置值,则系统会将该字段识别为新字段,存储模型会创建新的数据库表字段,而原字段将会rename为废弃字段。 二、字段类型 类型系统由基本类型、复合(组件)类型、引用类型和关系类型四种类型系统构成。通过类型系统描述应用程序、数据库和前端视觉视图如何进行交互,数据及数据间关系如何处理的协议。其中引用类型和关系类型介绍详见3.3.9【字段类型之关系与引用】一文,字段命名规范参见3.3.1【构建第一个Model】一文,这里不再赘述。 基本类型 业务类型 Java类型 数据库类型 规则说明 BINARY ByteByte[] TINYINTBLOB 二进制类型,不推荐使用 INTEGER ShortIntegerLongBigInteger smallintintbigintdecimal(size,0) 整数, 包括整数(10-11位有效数字)、长整数(19-20位有效数字)和大整数(超过19位)。【数据库规则】:默认使用int;如果size小于6则使用smallint;如果size超过6则使用int;如果size超过10位数字,即大于11(包含符号位),则使用长整数bigint;如果size超过19位数字,即大于20(包含符号位),则使用大数decimal。若未配置size,则按Java类型推测。【前端交互规则】:整数使用Number类型,长整数和大整数前后端协议使用字符串类型。 FLOAT FloatDoubleBigDecimal float(M,D)double(M,D)decimal(M,D) 浮点数,?包括单精度浮点数(7-8位有效数字)、双精度浮点数(15-16位有效数字)和大数(超过15位)。【数据库规则】:默认使用单精度浮点数float;如果size超过7位数字,即大于等于8,则使用双精度浮点数double;如果size超过15位数字,即大于等于16,则使用大数decimal。若未配置size,则按Java类型推测。【前端交互规则】:单精度浮点数float和双精度浮点数double使用Number类型(因为都使用IEEE754协议64位进行存储),大数前后端协议使用字符串类型。 BOOLEAN Boolean tinyint(1) 布尔类型,值为1,true(真)或0,false(假) ENUM Enum 与数据字典指定基本类型一致 【前端交互规则】:可选项从ModelField的options字段获取,options字段值为字段指定数据字典子集的JSON序列化字符串。前后端传递的是可选项的name,数据库存储使用可选项的value。multi属性为true,则使用多选控件;multi属性为false,则使用单元控件 STRING String varchar(size) 字符串,size为长度限制默认值参考,前端可以view中覆盖该配置 TEXT String text 多行文本,编辑态组件为多行文本框,长度限制为配置项size值 HTML String text 富文本编辑器 DATETIME java.util.Datejava.sql.Timestamp datetime(fraction)timestamp(fraction) 日期时间类型【数据库规则】:日期和时间的组合,时间格式为?YYYY-MM-DD HH:MM:SS[.fraction],默认精确到秒,在默认的秒精确度上,可以带小数,最多带6位小数,即可以精确到?microseconds (6 digits) precision。可以通过设置fraction来设置精确小数位数,最终存储在字段的decimal属性上。【前端交互规则】:前端默认使用日期时间控件,根据日期时间类型格式化格式format格式化日期时间 YEAR java.util.Date year 年份类型日期类型【数据库规则】:默认“YYYY”格式表示的日期值【前端交互规则】:前端默认使用年份控件,根据日期类型格式化格式format格式化日期 DATE java.util.Datejava.sql.Date datedate 日期类型【数据库规则】:默认“YYYY-MM-DD”格式表示的日期值【前端交互规则】:前端默认使用日期控件,根据日期类型格式化格式format格式化日期 TIME java.util.Datejava.sql.Time time(fraction)time(fraction) 时间类型【数据库规则】:默认“HH:MM:SS”格式表示的时间值【前端交互规则】:前端默认使用时间控件,根据日期类型格式化格式format格式化日期 表3-3-8-1 字段基本类型 复合类型 业务类型 Java类型 数据库类型 规则说明 MONEY BigDecimal decimal(M,D) 金额,前端使用金额控件,可以使用currency设置币种字段 表3-3-8-2 字段复合类型 不可变更字段 使用immutable属性来描述该字段前后端都无法进行更新操作,系统会忽略不可变更字段的更新操作。 自动生成编码的字段 详见3.3.5【模型编码生成器】一文。 字段的序列化与反序列化 使用@Field注解的serialize属性来配置非字符串类型属性的序列化与反序列化方式,最终会以序列化后的字符串持久化到存储中。 详见3.3.7【字段之序列化方式】一文 前端默认配置 可以使用@Field注解中的以下属性来配置前端的默认视觉与交互规则,也可以在前端设置覆盖以下配置。 @Field(required),是否必填 @Field(invisible),是否不可见 @Field(priority),字段优先级,列表的列使用该属性进行排序 更多前端默认视图配置详见:3.5.4【Ux注解详解】一文,如:readonly是否只读等。 举例 回顾我们前面学习例子 现有PetShop代码如下 package pro.shushi.pamirs.demo.api.model; import pro.shushi.pamirs.core.common.enmu.DataStatusEnum; import pro.shushi.pamirs.demo.api.enumeration.PetShopOptionEnum; import pro.shushi.pamirs.meta.annotation.Field; import pro.shushi.pamirs.meta.annotation.Model; import java.sql.Time; import java.util.List; @Model.model(PetShop.MODEL_MODEL) @Model(displayName = 宠物店铺,summary=宠物店铺,labelFields ={shopName} ) @Model.Code(sequence = DATE_ORDERLY_SEQ,prefix = P,size=6,step=1,initial = 10000,format = yyyyMMdd) public class PetShop extends AbstractDemoIdModel { public static final String MODEL_MODEL=demo.PetShop; @Field(displayName = 店铺编码) private String code; @Field(displayName = 店铺编码2) @Field.Sequence(sequence = DATE_ORDERLY_SEQ,prefix = C,size=6,step=1,initial = 10000,format = yyyyMMdd) private String codeTwo; @Field(displayName = 店铺名称,required = true) private String shopName; @Field(displayName = 开店时间,required = true) private Time openTime; @Field(displayName = 闭店时间,required = true) private Time closeTime; @Field(displayName =…

    2024年5月23日
    1.8K00
  • 2.4.1 Oinone独特性之单体与分布式的灵活切换

    企业数字化转型需要处理分布式带来的复杂性和成本问题。尽管这些问题令人望而却步,但分布式架构对于大部分企业仍然是必须的选择。如果一个低代码平台缺乏分布式能力,那么它的性能就无法满足客户的要求。相比之下,Oinone平台通过对部署的创新(如图2-6所示),成功实现了分布式架构的支持,而且能够按照客户的业务发展需求,灵活选择不同的部署模式,同时节约企业成本,提升创新效率。这一创新是Oinone平台与其他低代码平台的重要区别,能够满足客户预期发展并兼顾成本效益。 图2-6 传统部署方式VS Oinone部署方式 实现原理 要实现灵活部署的特性,必须满足两个基本要求: 开发过程中不需要过多关注分布式技术,就像开发单体应用一样简单。代码在运行时应该能够根据模块是否在运行容器中,来决定路由走本地还是远程。这样可以大大减少研发人员的工作量和技术复杂度。 研发与部署要分离,即"开发单体应用一样开发分布式应用,而部署形式由后期决定"。为此,我们的工程结构支持多种启动模式,并逐一介绍了针对不同场景的工程结构类型(如下图2-7所示)。这样可以让客户在后期根据业务发展情况和需求,选择最适合的部署模式,从而达到灵活部署的目的。 图2-7 Oinone工程结构梳理 在整个工程结构上,我们秉承了Spring Boot的规范,不会改变大家的工程习惯。而Oinone的部署能力则可以让我们更灵活地应对各种情况。现在,我们来逐一介绍几种常规的工程结构以及它们适用的场景: 单模块工程结构(常规操作) a. 这是非常标准的Spring Boot工程,适用于简单的应用场景开发以及入门学习。 多模块工程结构(常规操作) a. 这是非常标准的多Spring Boot工程,可以实现分布式独立启动,适用于常规的分布式应用场景开发。 多模块工程结构-独立boot工程模式 a. 这种工程结构在多模块工程的基础上,通过独立的boot工程来支撑多部署方式。适用于中大型分布式应用场景开发。 b. 然而,随着工程越来越多,我们也会面临一些问题: ⅰ研发:环境准备非常困难,每个模块都要单独启动,研发调试跟踪困难。 ⅱ部署:分布式的高可靠性保证需要每个模块至少有两个部署节点,但在模块较多的情况下,起步成本非常高。同时,企业初期业务不稳定且规模较小,使用多模块工程的第二种模式会增加问题排查难度和成本。 c. 此时,Oinone的多模块工程下的独立boot工程模式部署就可以发挥其灵活性,让研发和业务起步阶段可以选择all-in-one模式,等到业务发展到一定规模的时候,只需要把线上部署模式切换成模块独立部署,而研发还可以保留all-in-one模式的优势。 d. 值得注意的是,分分合合的部署模式在传统互联网架构和低代码或无代码平台上都是有代价的,但是Oinone却可以灵活适配,只需要在boot工程的yml文件中写入需要加载的模块就可以解决。此处我们仅介绍多模块加载配置,选择性忽略其他无关配置,具体配置(如下图2-8所示)。 pamirs: boot: init: true sync: true modules: – base – resource – sequence – user – auth – web tenants: – pamirs 图2-8 Oinone yml配置图大型多场景工程结构-独立boot工程模式: a. 在多模块工程结构基础上的加强版,增加CDM层设计,让不同场景即保持数据统一,又保持逻辑独立。这种工程结构特别适用于大型企业软件开发,其中涉及到多个场景的情况,例如B端和C端的应用,或者跨不同业务线的应用,能够保证数据的一致性,同时也能够保持逻辑独立,避免不同场景间的代码冲突。 b. 这种工程结构是我们Oinone支撑“企业级软件生态”的核心,我们可以把场景A当作我们官方应用,场景B当作其他第三方伙伴应用。在这个工程结构下,我们的客户可以定制化开发自己的应用,同时我们也可以通过这种模式来支持我们的伙伴们进行开发,实现多方共赢。 c. 基于独立boot工程模式,我们同样对应多种部署模式应对不同情况,并统一管理所有伙伴应用。这种工程结构的优点是扩展性好,可以支持不同规模的应用,并且可以根据需要进行快速扩展或缩小规模,具有很高的灵活性。 基于标准产品的二开工程结构,是指基于标准产品进行二次开发,满足客户特定需求的工程结构。这种模式下,Oinone提供标准产品,客户可以根据自己的需求进行二次开发,实现定制化需求,同时可以利用我们的模块化开发特性,将每一个需求作为一个模块进行开发和管理。这种工程结构的优点是能够快速满足客户特定需求,同时也具有很好的可维护性和可扩展性,因为每个需求都是一个独立的模块,可以方便地进行维护和扩展。在下一篇“Oinone独特性之每一个需求都是一个模块”文章中有详细介绍。

    2024年5月23日
    2.8K00
  • 第2章 Oinone的技术独特性

    本章的主要目的是通过分析企业商业支撑软件的项目特性和关注点,找到企业软件发展的另一个本质变化——新技术流派的产生。在对“互联网架构做为最佳实践为何失效”的思考基础上,我们分析互联网中台架构的发展历史以及企业实际现状,找出其水土不服的原因。进而引出Oinone的低代码开发平台如何结合互联网架构并完成创新,以满足企业数字化转型的需求。 具体而言,本章包括以下内容: 企业软件发展的另一个本质变化:新技术流派的产生; 最佳实践为何失效?Oinone如何打造具有企业特色的互联网架构; Oinone独特性之源:元数据与设计原则; Oinone独特性之单体与分布式的灵活切换; Oinone独特性之每一个需求都是一个模块; Oinone独特性之低无一体。

    Oinone 7天入门到精通 2024年5月23日
    7.5K00
  • 特别说明

    教材进度 目前还在编写整改中,特别是目录上带(改)字样的 本版本教材针对4.0,相对3.0增加的特性有: 通用能力部分:比如权限、审计、国际化、系统配置、集成可视化等 新版权限:交互优化,同时支持子管理员 新版审计,支持在线配置审计规则 系统配置,提供多种风格,让伙伴基础风格不在需要自定义主题和组件 新增集成设计器,通过连接器让应用api和数据库集成资产化管理,通过数据流进行接口逻辑编排,并提供统一的开放平台 设计器部分: 加强界面设计器部分对移动端、主题、自定义组件等支持,同时完善对数据管理操作、增加各类常用业务组件,加强对树形与及联的支持,表格视图搜索优化 流程设计器增加:审批员选择自定义逻辑、转交人选择自定义逻辑,支持手工触发、支持数据事务、支持调用模型函数 可视化设计器:增加自定义图表功能、增强下钻能力 模块管理:增加新增、多端配置等支持 内核机制: 性能优化:通过gql层面解决业务研发过程中1+N性能问题,权限性能优化,分布式缓存性能优化,整体性能提升2倍以上 针对多租户应用无状态的支持,低无一体支持本地调试 5.0的核心新特性预告,特性会在开发过程中陆续推出供大家体验,但完整体验时间为2024年6月份 新增打印设计功能 导出的默认交互增强以及导入导出模版设计 默认导入导出在交互时可以指定字段 导入导出模版可图形化设计 多模型AI集成设计器器 自定义组件、自定义图表交互友好性增强 自定义组件,属性面板设计模版化,解决设计组件属性面板的时候不知道有哪些默认属性。 增强组件与动作的结合灵活性 组件增加是否有子组件的通用属性,有子组件的组件具备组件拖拽区 增强UX注解能力,原本只有设计器支持的,后端UX注解也进行对应支持 后端低无一体功能开放(原本该功能只在saas版本上提供),方便咱们做应急和简单应用的时,以无代码为主,低代码为辅的模式。通过低无一体可以通过低代码的方式来解决无代码无法支撑的功能。 工作流增强 增加循环审批节点 增加分支汇集节点增强并行流程能力,比如分支汇集节点可以设置:所有并行节点处理完或只要一条处理完就继续执行。

    2024年5月23日
    2.5K00

Leave a Reply

Please Login to Comment