4.4 Oinone的分布式体验进阶

在分布式开发中,每个人基本只负责自己相关的模块开发。所以每个研发就都需要一个环境,比如一般公司会有(N个)项目环境、1个日常环境、1个预发环境、1个线上环境。在整项目环境的时候就特别麻烦,oinone的好处是在于每个研发可以通过boot工程把需要涉及的模块都启动在一个jvm中进行开发,并不依赖任何环境,在项目开发中,特别方便。但当公司系统膨胀到一定规模,大到很多人都不知道有哪些模块,或者公司出于安全策略考虑,或者因为启动速度的原因(毕竟模块多了启动的速度也会降下来)。本文就给大家介绍oinone与经典分布式组织模式的兼容性

一、模块启动的最小集

我们来改造SecondModule模块,让该模块的用户权限相关都远程走DemoModule

Step1 修改SecondModule的启动工程application-dev.yml文件

除了base、second_core两个模块保留,其他模块都去除了。

pamirs:
    boot:
    init: true
    sync: true
    modules:
      - base
      - second_core

图4-4-1 SecondModule的application-dev.yml仅配置两个模块

Step2 去除boot工程的依赖

去除SecondModule启动工程的pom依赖

<!-- <dependency>
  <groupId>pro.shushi.pamirs.core</groupId>
  <artifactId>pamirs-resource-core</artifactId>
</dependency>
<dependency>
  <groupId>pro.shushi.pamirs.core</groupId>
  <artifactId>pamirs-user-core</artifactId>
</dependency>
<dependency>
  <groupId>pro.shushi.pamirs.core</groupId>
  <artifactId>pamirs-auth-core</artifactId>
</dependency>
<dependency>
  <groupId>pro.shushi.pamirs.core</groupId>
  <artifactId>pamirs-message-core</artifactId>
</dependency>
<dependency>
  <groupId>pro.shushi.pamirs.core</groupId>
  <artifactId>pamirs-international</artifactId>
</dependency>
<dependency>
  <groupId>pro.shushi.pamirs.core</groupId>
  <artifactId>pamirs-business-core</artifactId>
</dependency>
<dependency>
  <groupId>pro.shushi.pamirs.core</groupId>
  <artifactId>pamirs-apps-core</artifactId>
</dependency> -->

图4-4-2 去除boot工程多余的依赖

Step3 重启SecondModule

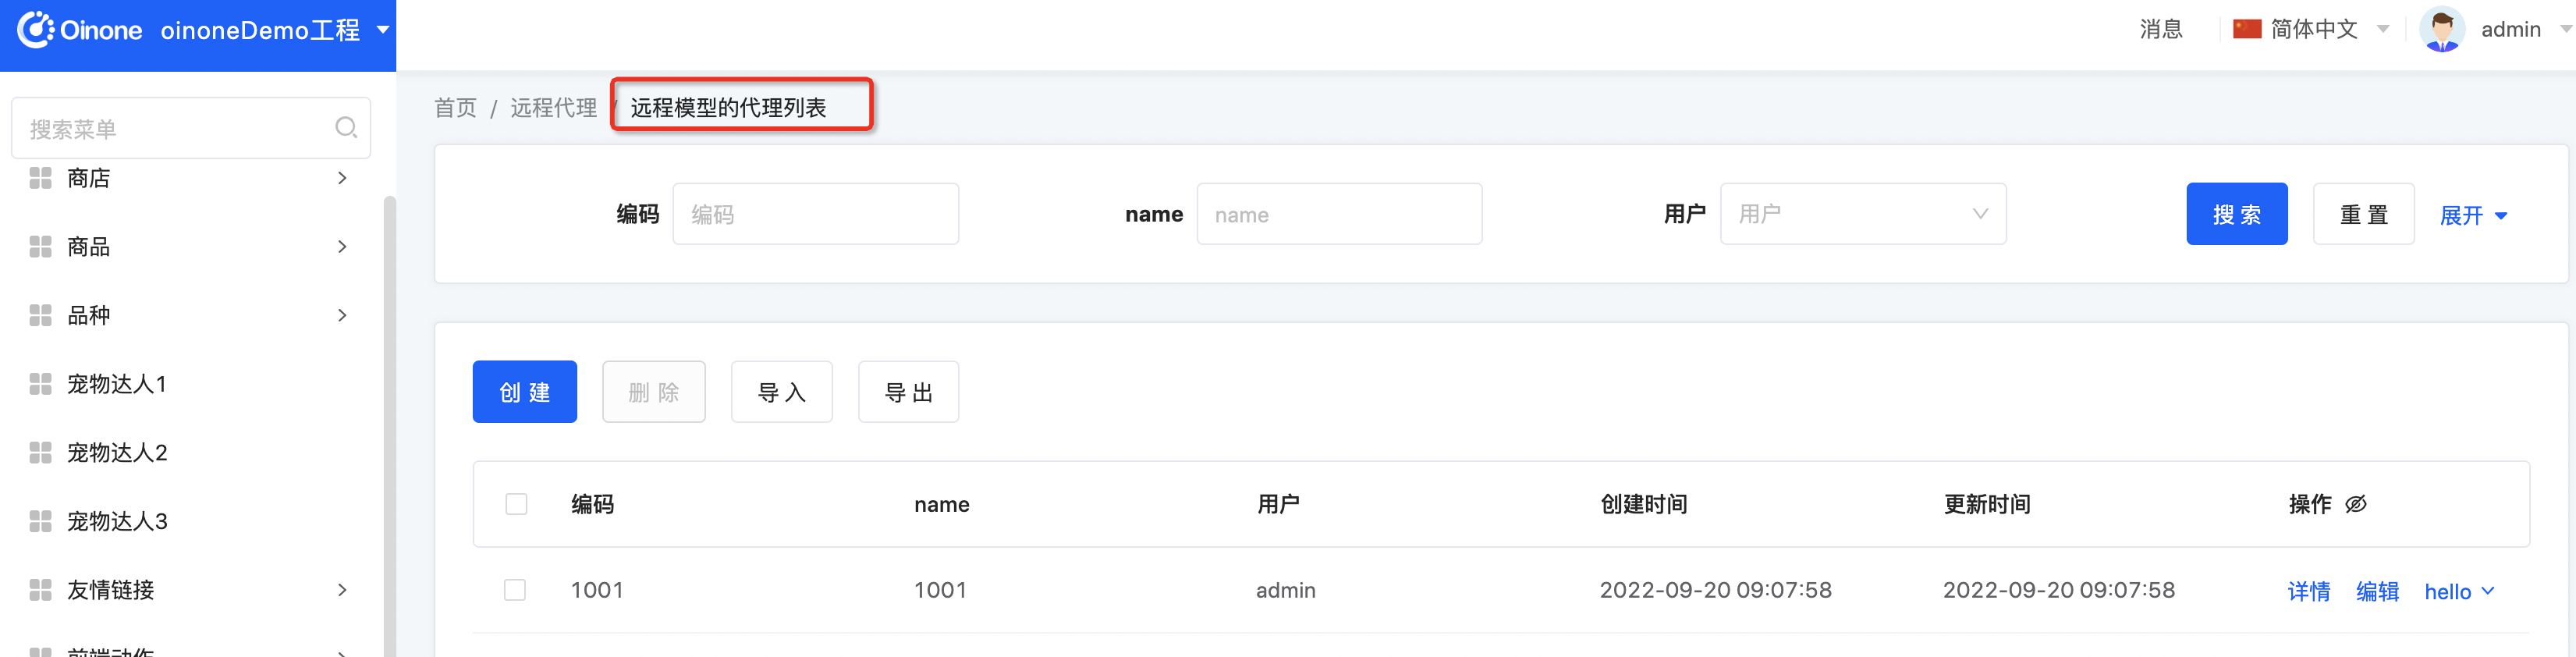
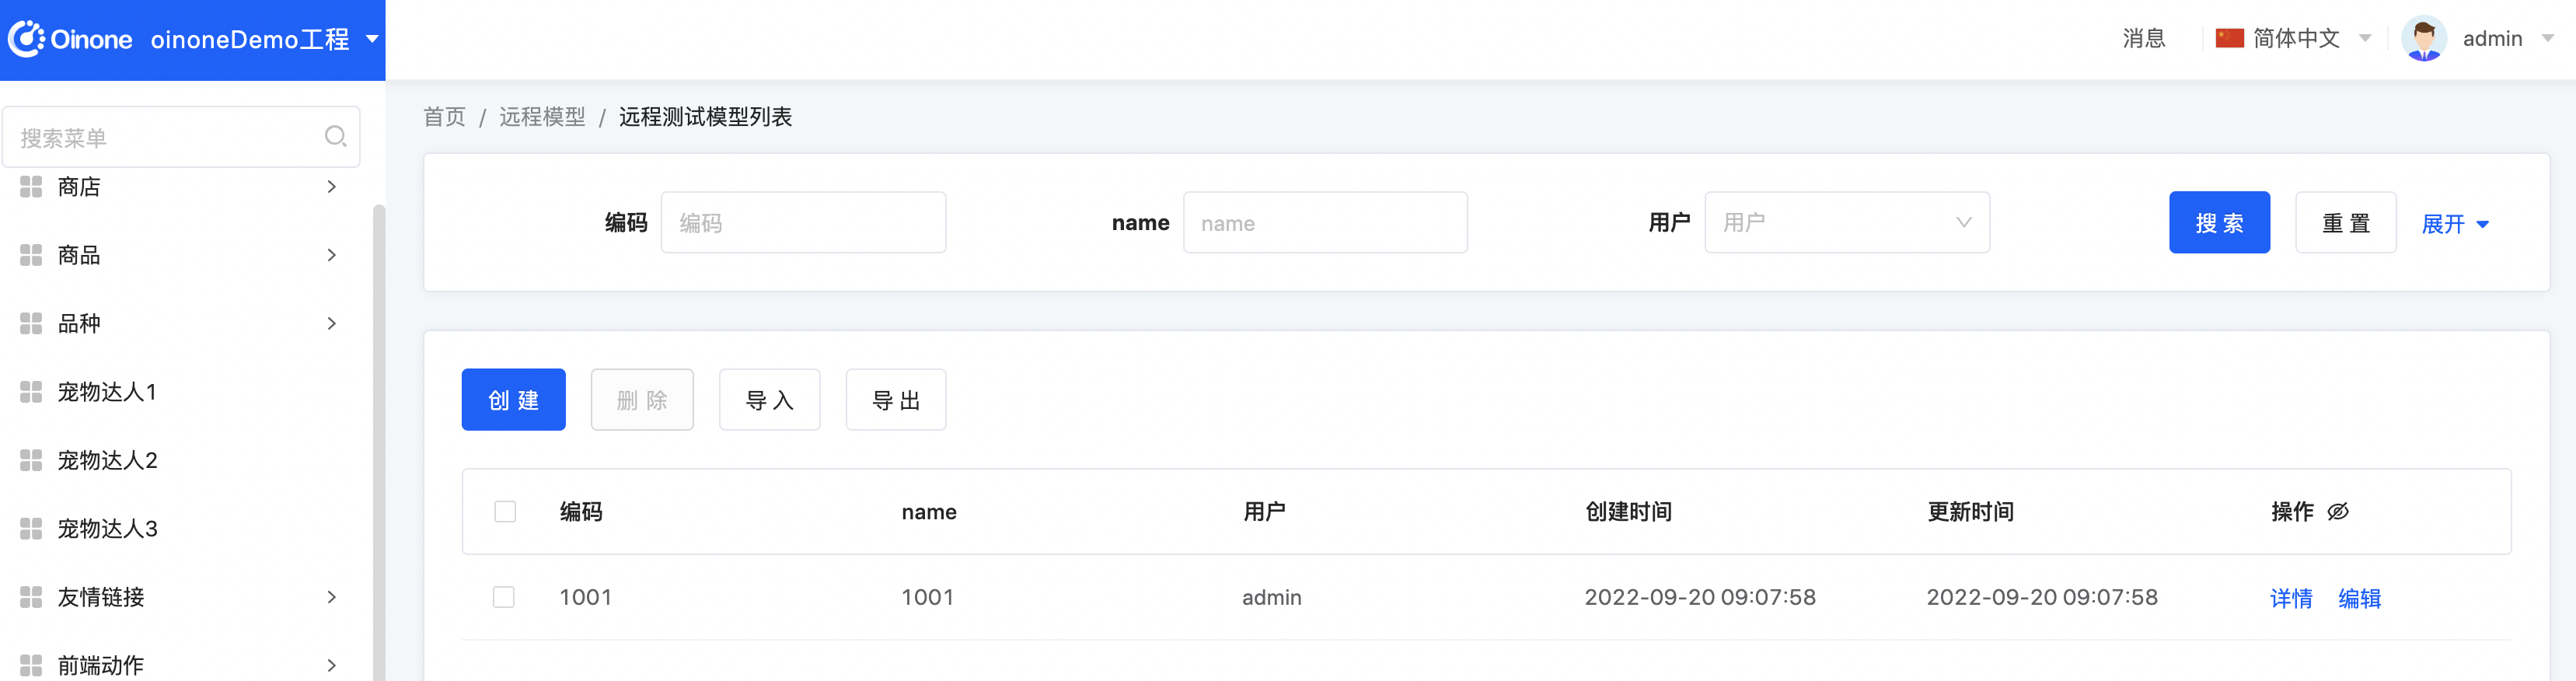
这【远程模型】和【远程代理】均能访问正常
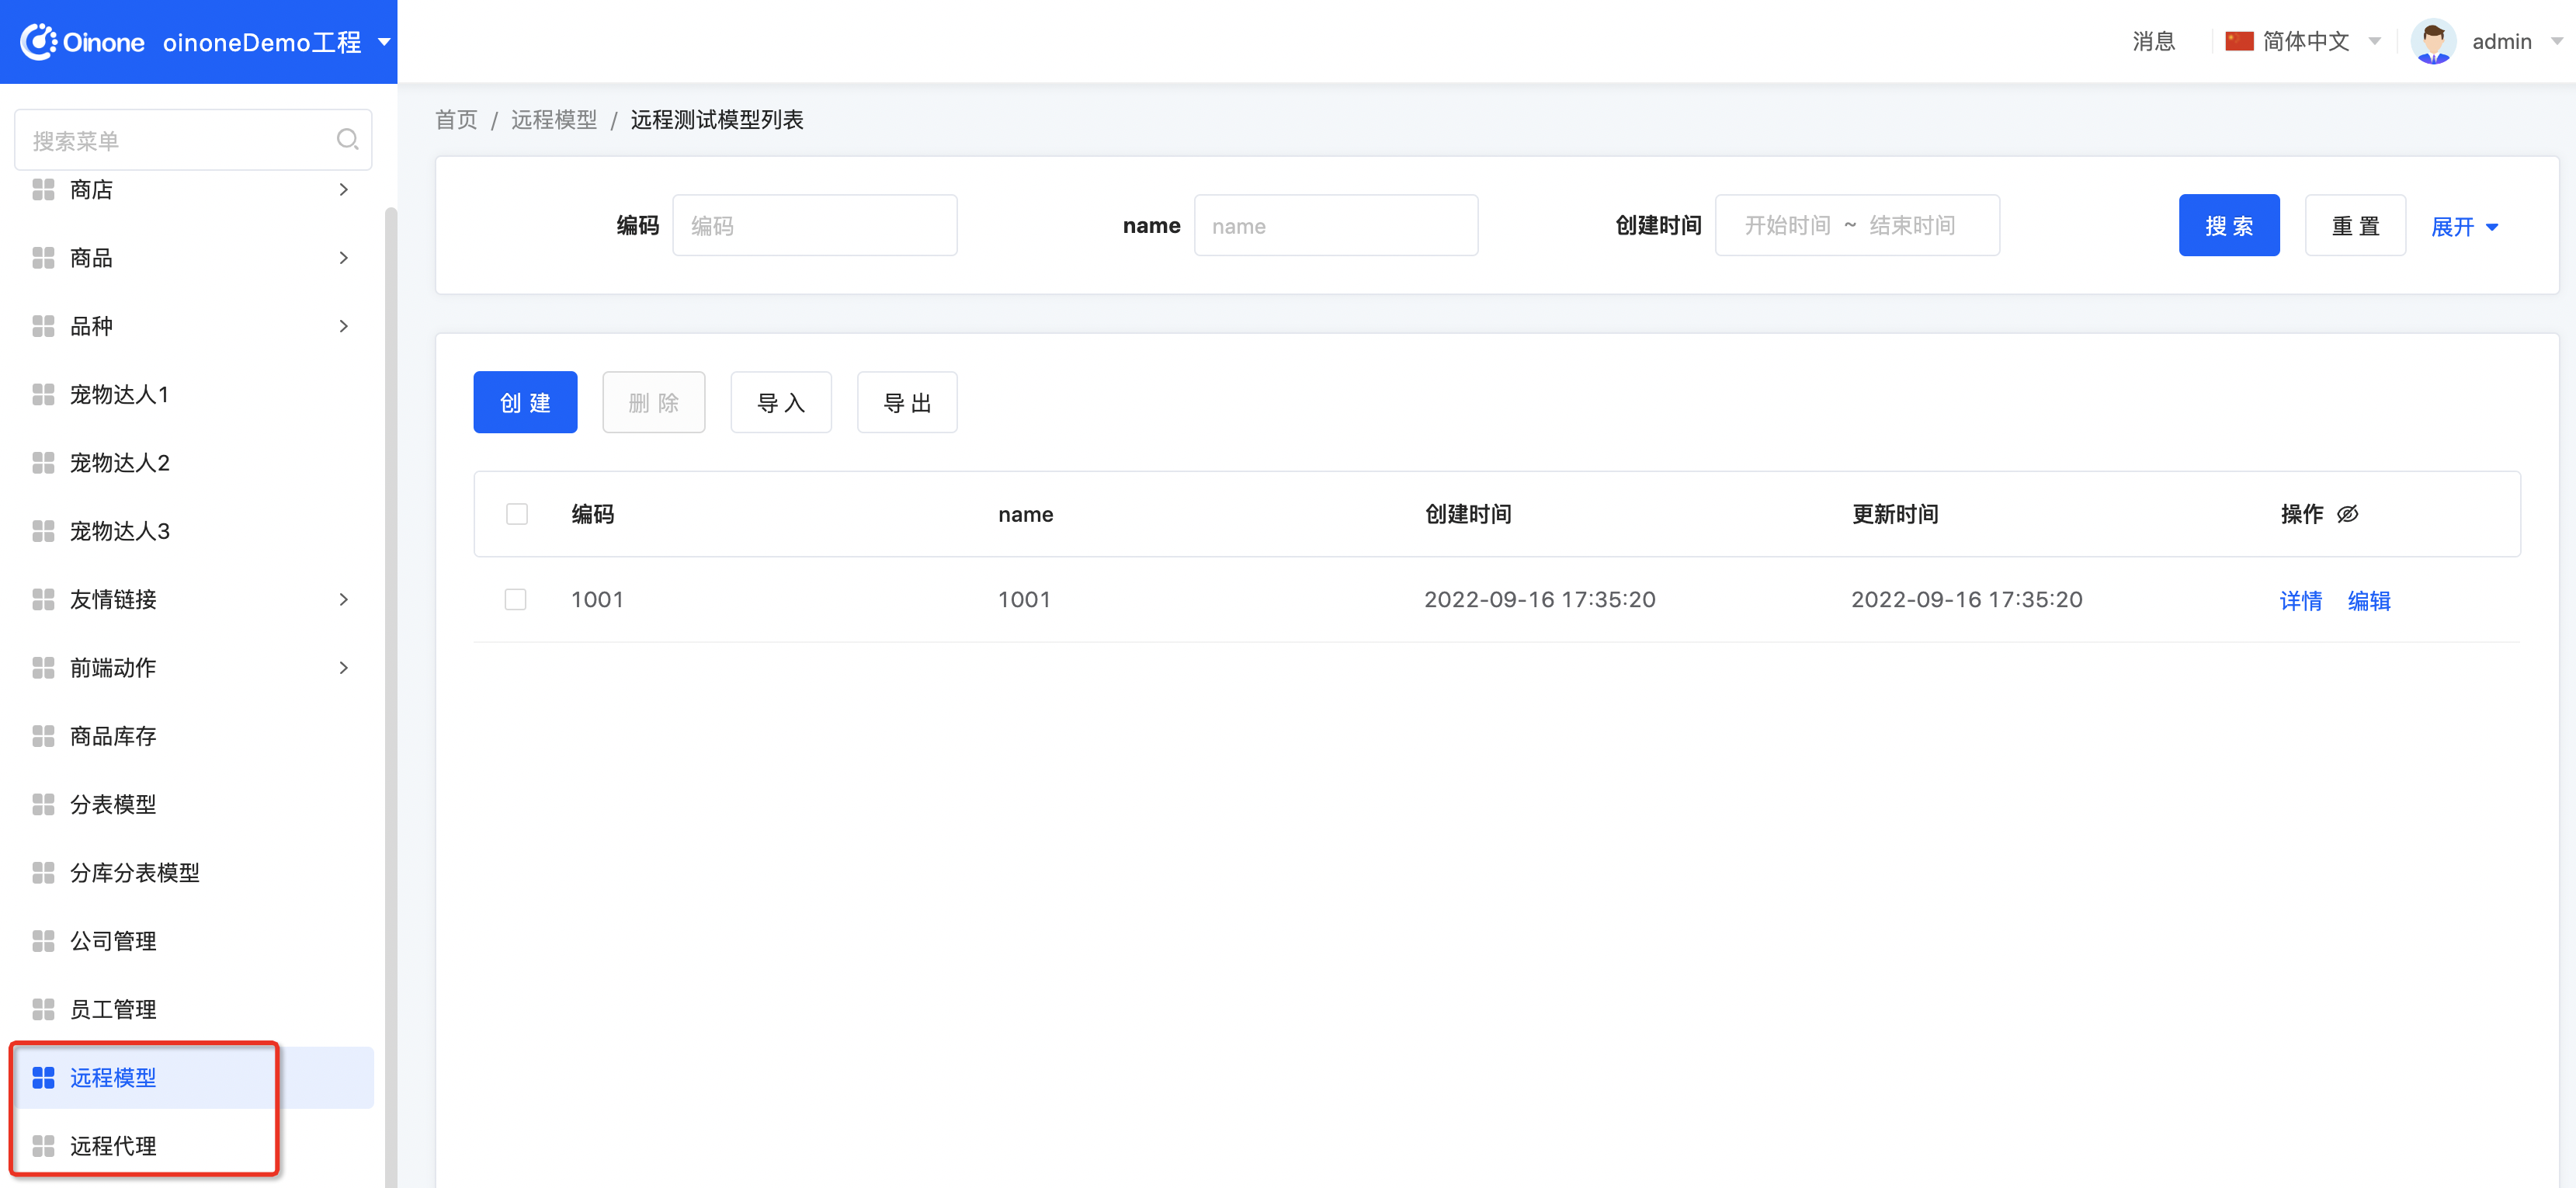
image.png

图4-4-3 远程模型和远程代理菜单均能访问正常

Step4 SecondModule增加对模块依赖

我们让SecondModule增加用户和权限模块的依赖,期待效果是:SecondModule会对用户和权限的访问都会走Dome应用,因为Demo模块的启动工程中包含了user、auth模块。

  1. 修改pamirs-second-api的pom文件增加对user和auth的api包依赖
<dependency>
  <groupId>pro.shushi.pamirs.core</groupId>
  <artifactId>pamirs-user-api</artifactId>
</dependency>
<dependency>
  <groupId>pro.shushi.pamirs.core</groupId>
  <artifactId>pamirs-auth-api</artifactId>
</dependency>

图4-4-4 修改pamirs-second-api的pom文件

  1. 修改SecondModule类,增加依赖定义
@Module(
    dependencies = {ModuleConstants.MODULE_BASE, AuthModule.MODULE_MODULE, UserModule.MODULE_MODULE}
)

图4-4-5 配置SecondModule的依赖

Step5 修改RemoteTestModel模型

为RemoteTestModel模型增加user字段

@Field.many2one
@Field(displayName = "用户")
private PamirsUser user;

图4-4-6 为RemoteTestModel模型增加user字段

Step6 重启系统看效果

  1. mvn install pamirs-second工程,因为需要让pamirs-demo工程能依赖到最新的pamirs-second-api包

  2. 重启pamirs-second和pamirs-demo

  3. 两个页面都正常

image.png

图4-4-7 示例效果一

image.png

图4-4-8 示例效果二

二、PmetaOnline的NEVER指令(开发时环境共享)

我们在4.1.2【模块之启动指令】一文中介绍过 “-PmetaOnline指令”,该参数用于设置元数据在线的方式,如果不使用该参数,则profile属性的默认值请参考服务启动可选项。-PmetaOnline参数可选项为:

  • NEVER - 不持久化元数据,会将pamirs.boot.options中的updateModule、reloadMeta和updateMeta属性设置为false
  • MODULE - 只注册模块信息,会将pamirs.boot.options中的updateModule属性设置为true,reloadMeta和updateMeta属性设置为false
  • ALL - 注册持久化所有元数据,会将pamirs.boot.options中的updateModule、reloadMeta和updateMeta属性设置为true

oinone的默认模式下元数据都是注册持久化到DB的,但当我们在分布式场景下新开发模块或者对已有模块进行本地化开发时,做为开发阶段我们肯定是希望复用原有环境,但不对原有环境照成影响。那么-PmetaOnline就很有意义。让我们还没有经过开发自测的代码产生的元数据仅限于开发本地环境,而不是直接影响整个大的项目环境

PmetaOnline指令设置为NEVER(举例)

Step1 为DemoCore新增一个DevModel模型

package pro.shushi.pamirs.demo.api.model;

import pro.shushi.pamirs.meta.annotation.Field;
import pro.shushi.pamirs.meta.annotation.Model;

@Model.model(DevModel.MODEL_MODEL)
@Model(displayName = "开发阶段模型",summary="开发阶段模型,当PmetaOnline指令设置为NEVER时,本地正常启动但元数据不落库",labelFields={"name"})
public class DevModel  extends AbstractDemoCodeModel{

    public static final String MODEL_MODEL="demo.DevModel";

    @Field(displayName = "名称")
    private String name;

}

图4-4-9 为DemoCore新增一个DevModel模型

Step2 为DevModel模型配置菜单

@UxMenu("开发模型")@UxRoute(DevModel.MODEL_MODEL) class DevModelProxyMenu{}

图4-4-10 为DevModel模型配置菜单

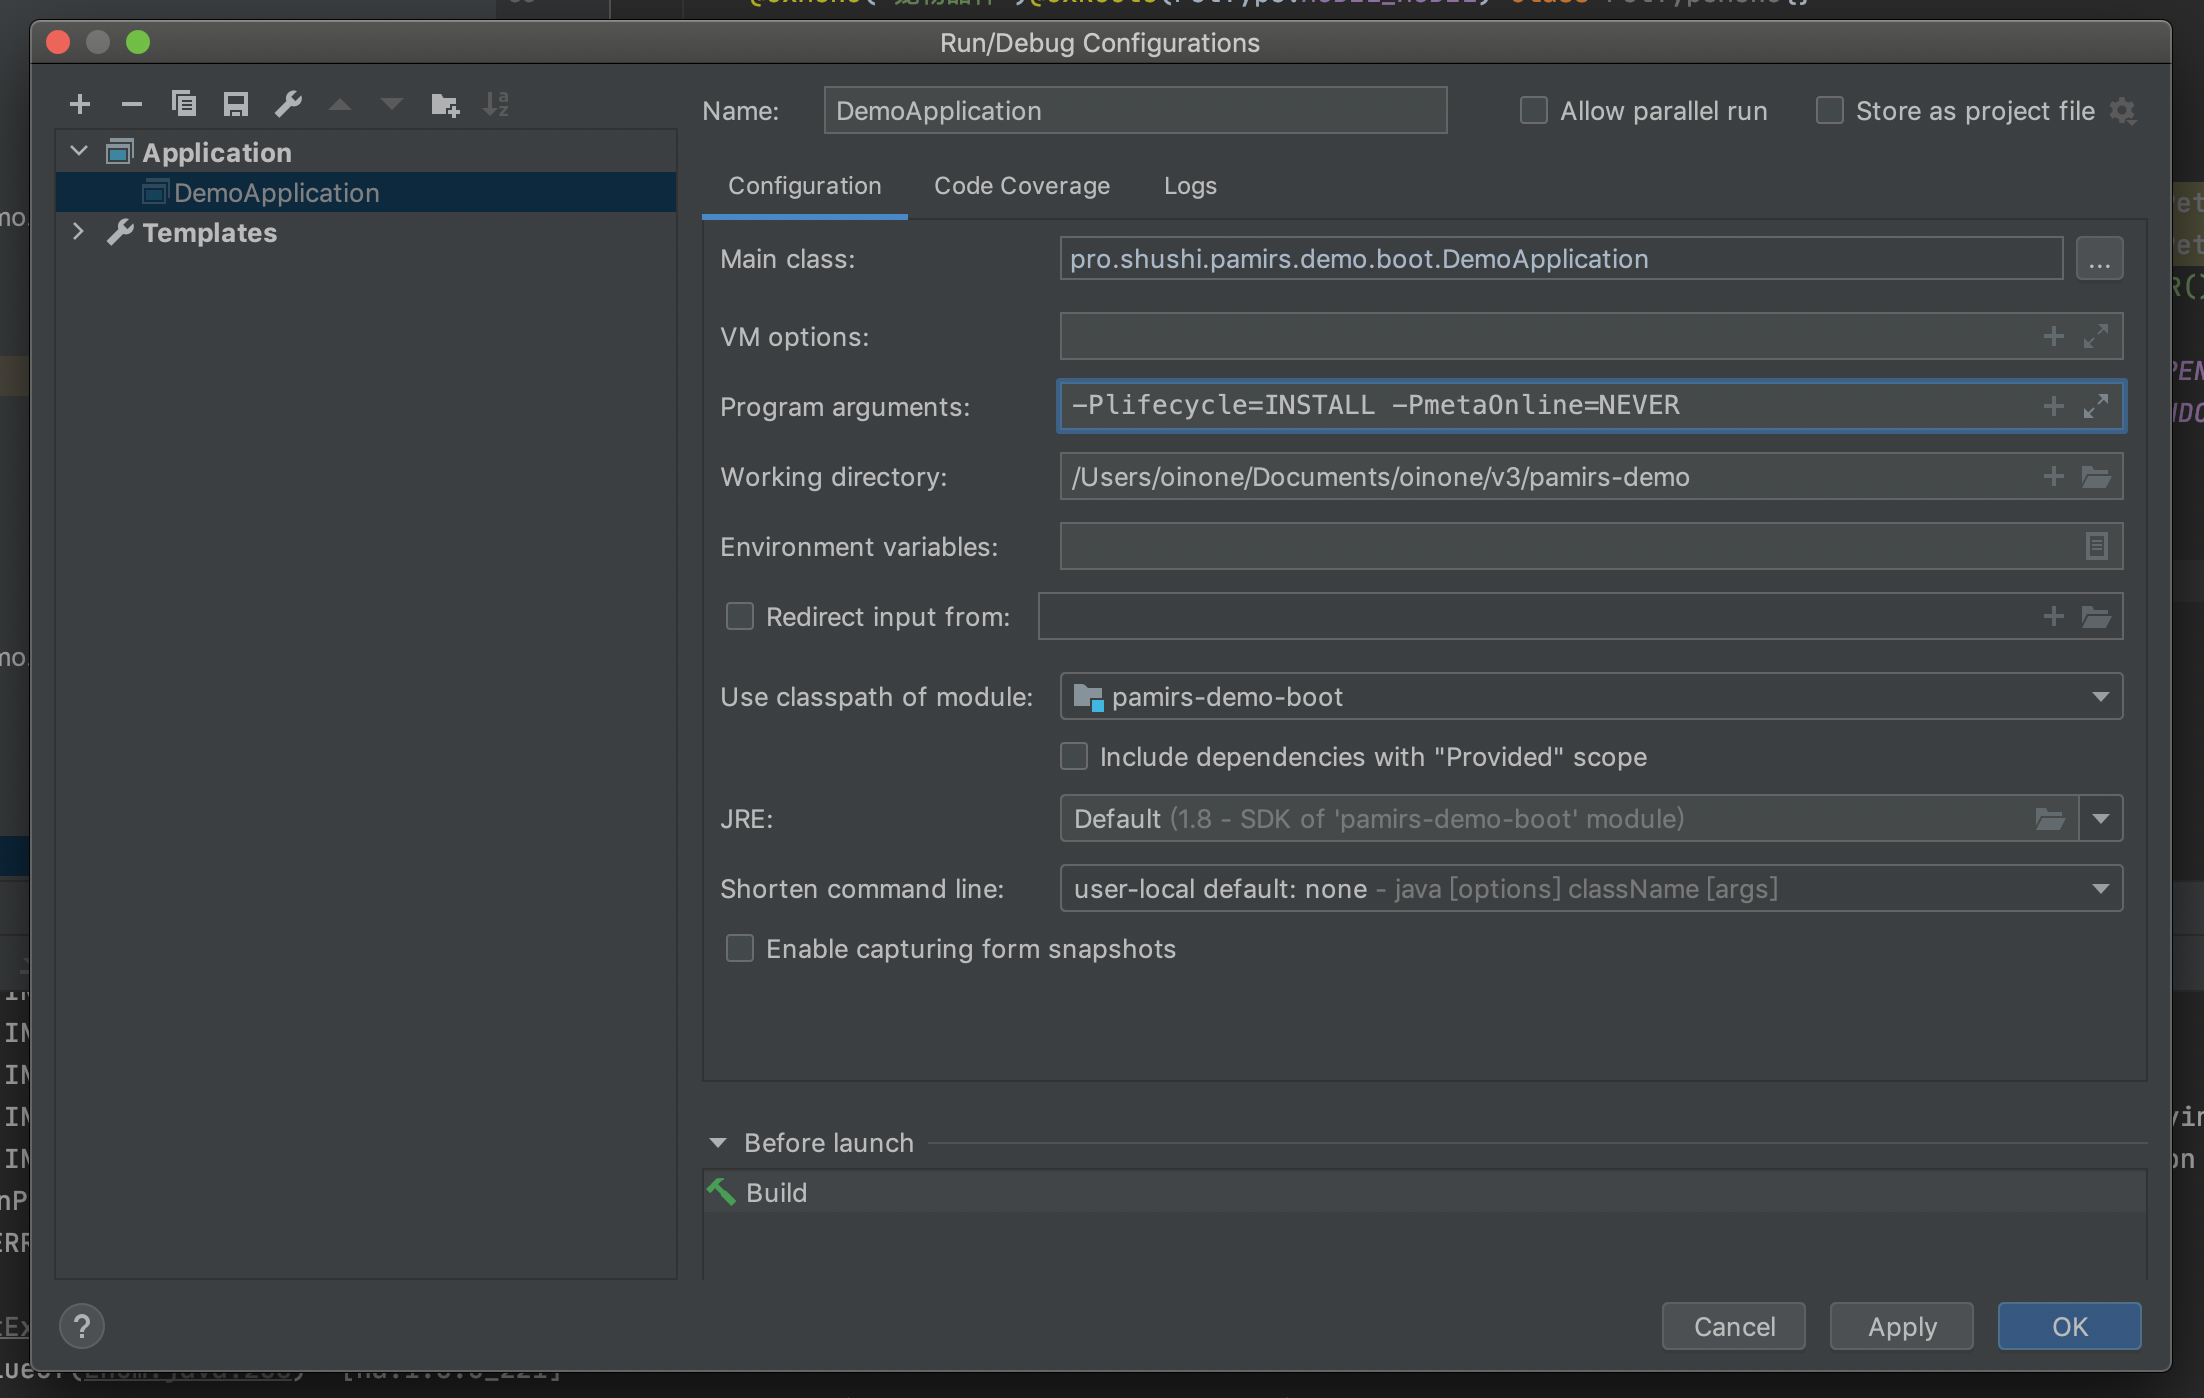
Step3 启动Demo应用时指定-PmetaOnline

image.png

图4-4-11 启动Demo应用时指定-PmetaOnline

Step4 重启系统看效果

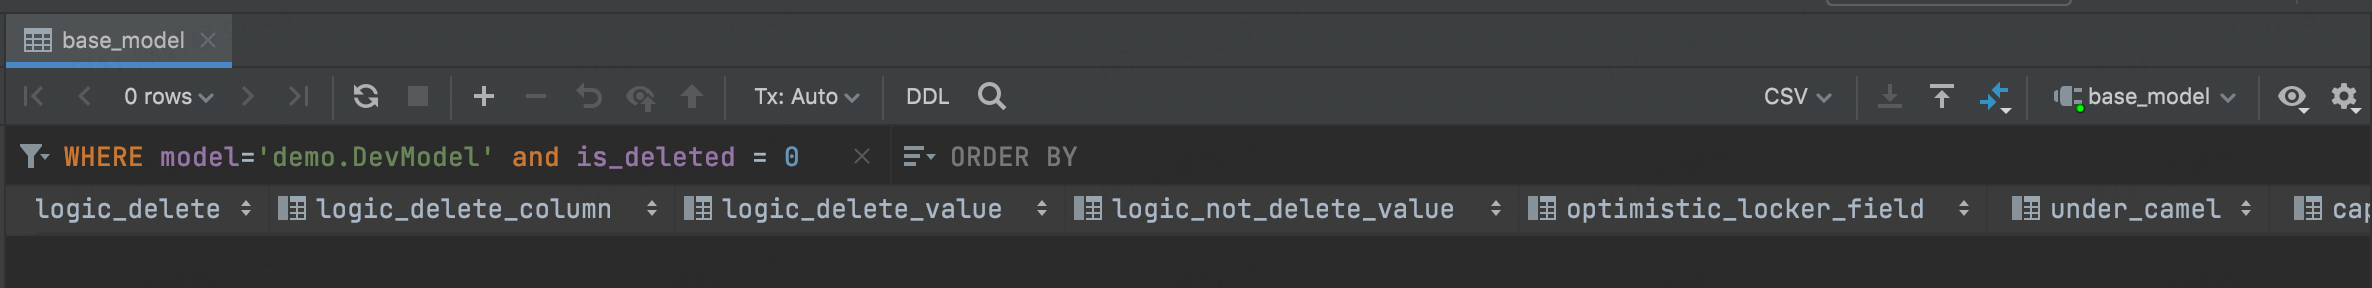
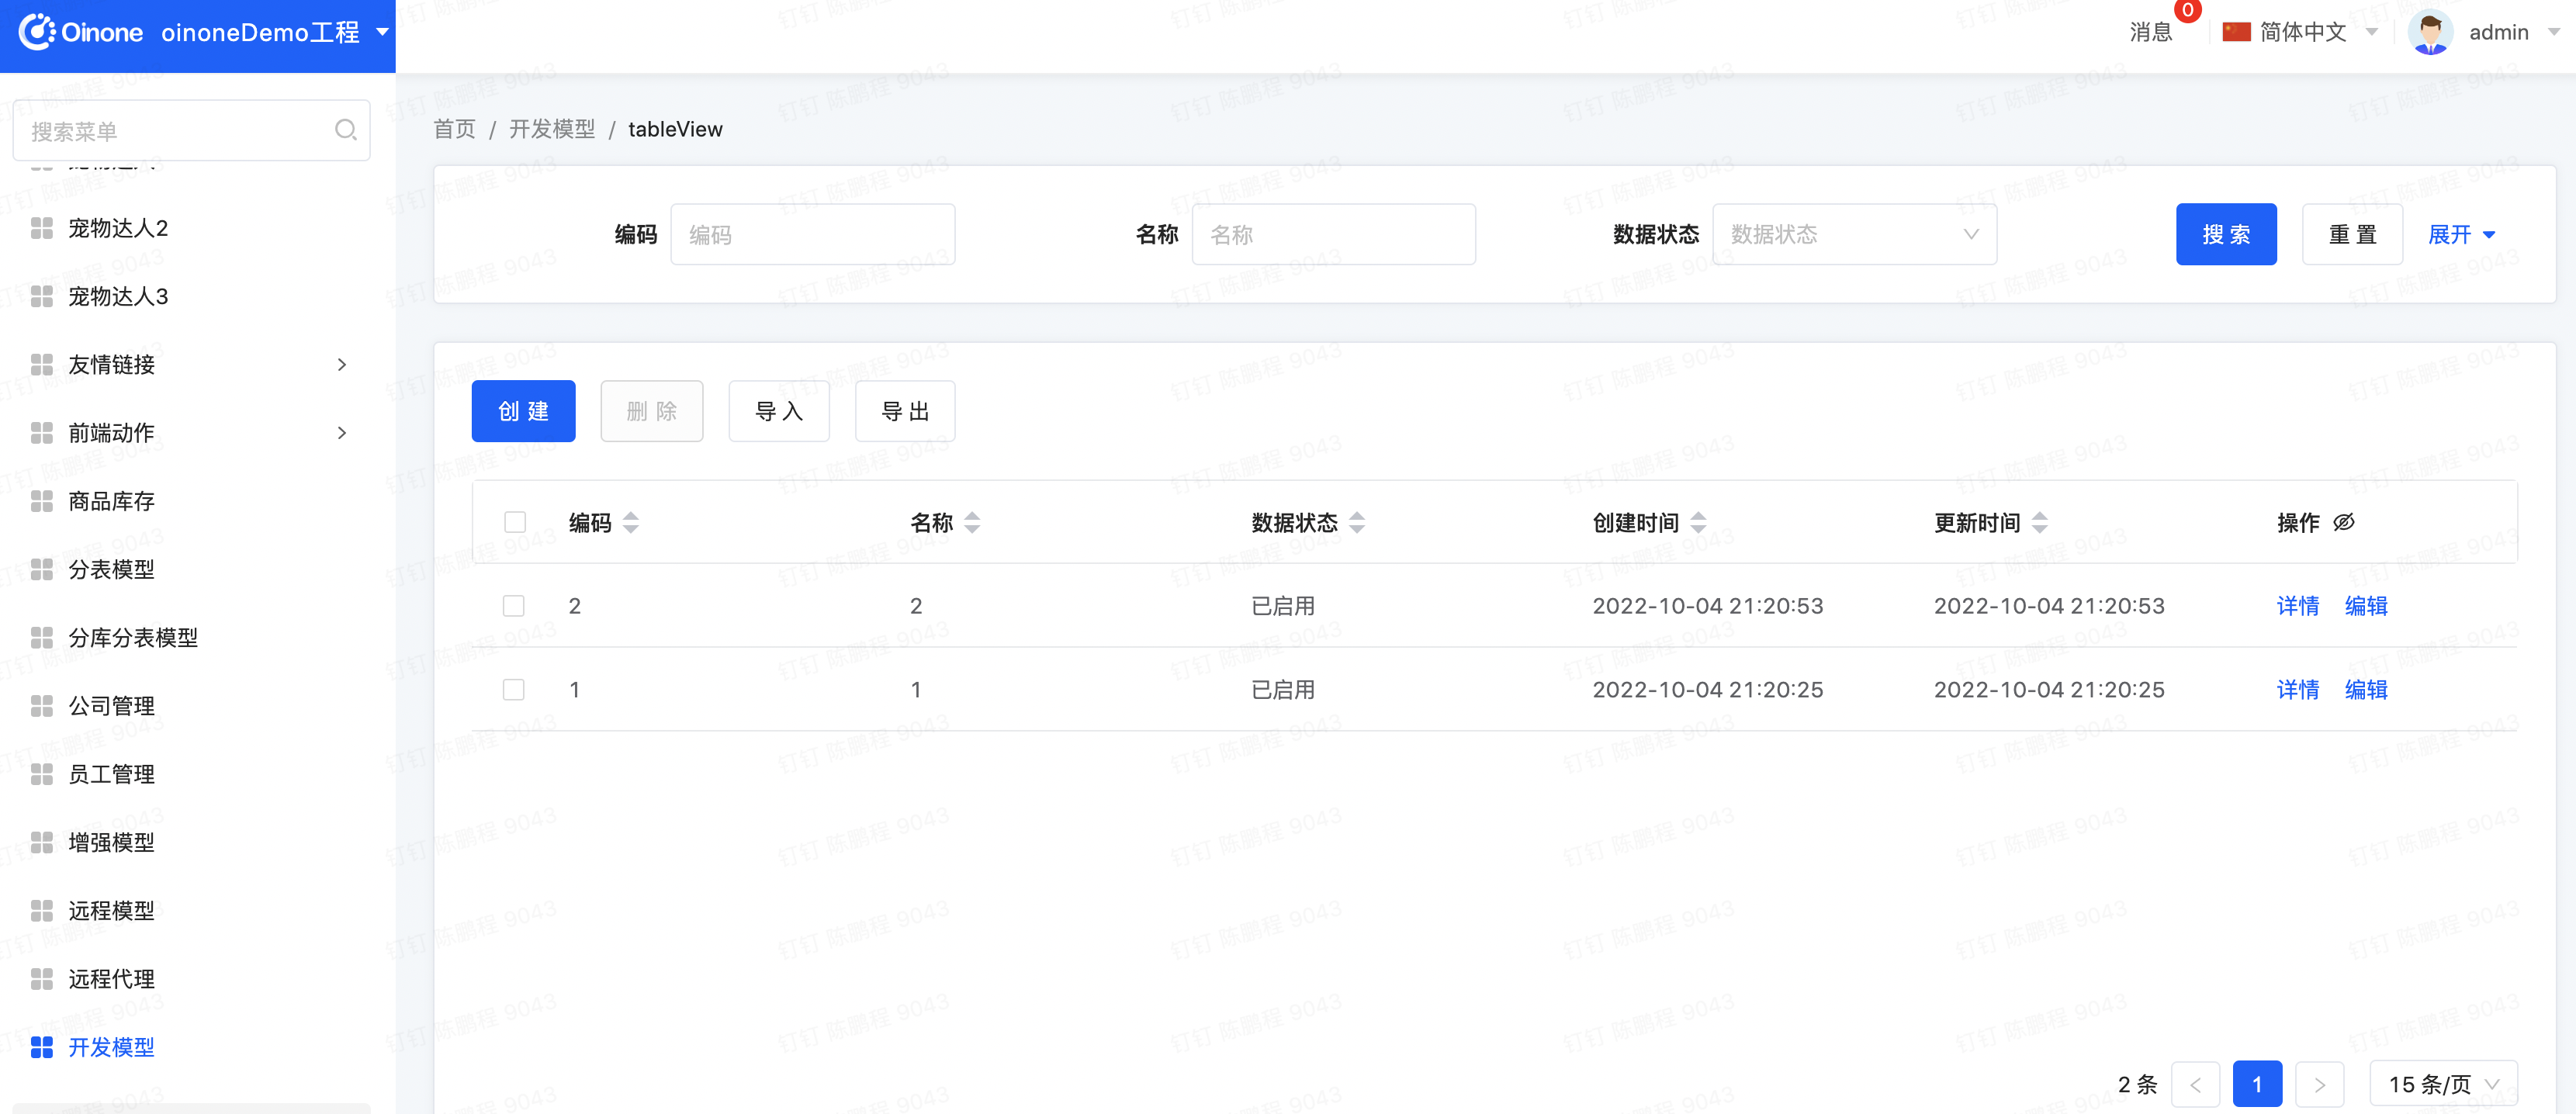
  1. 查看元数据

image.png图4-4-12 DB查看元数据变化

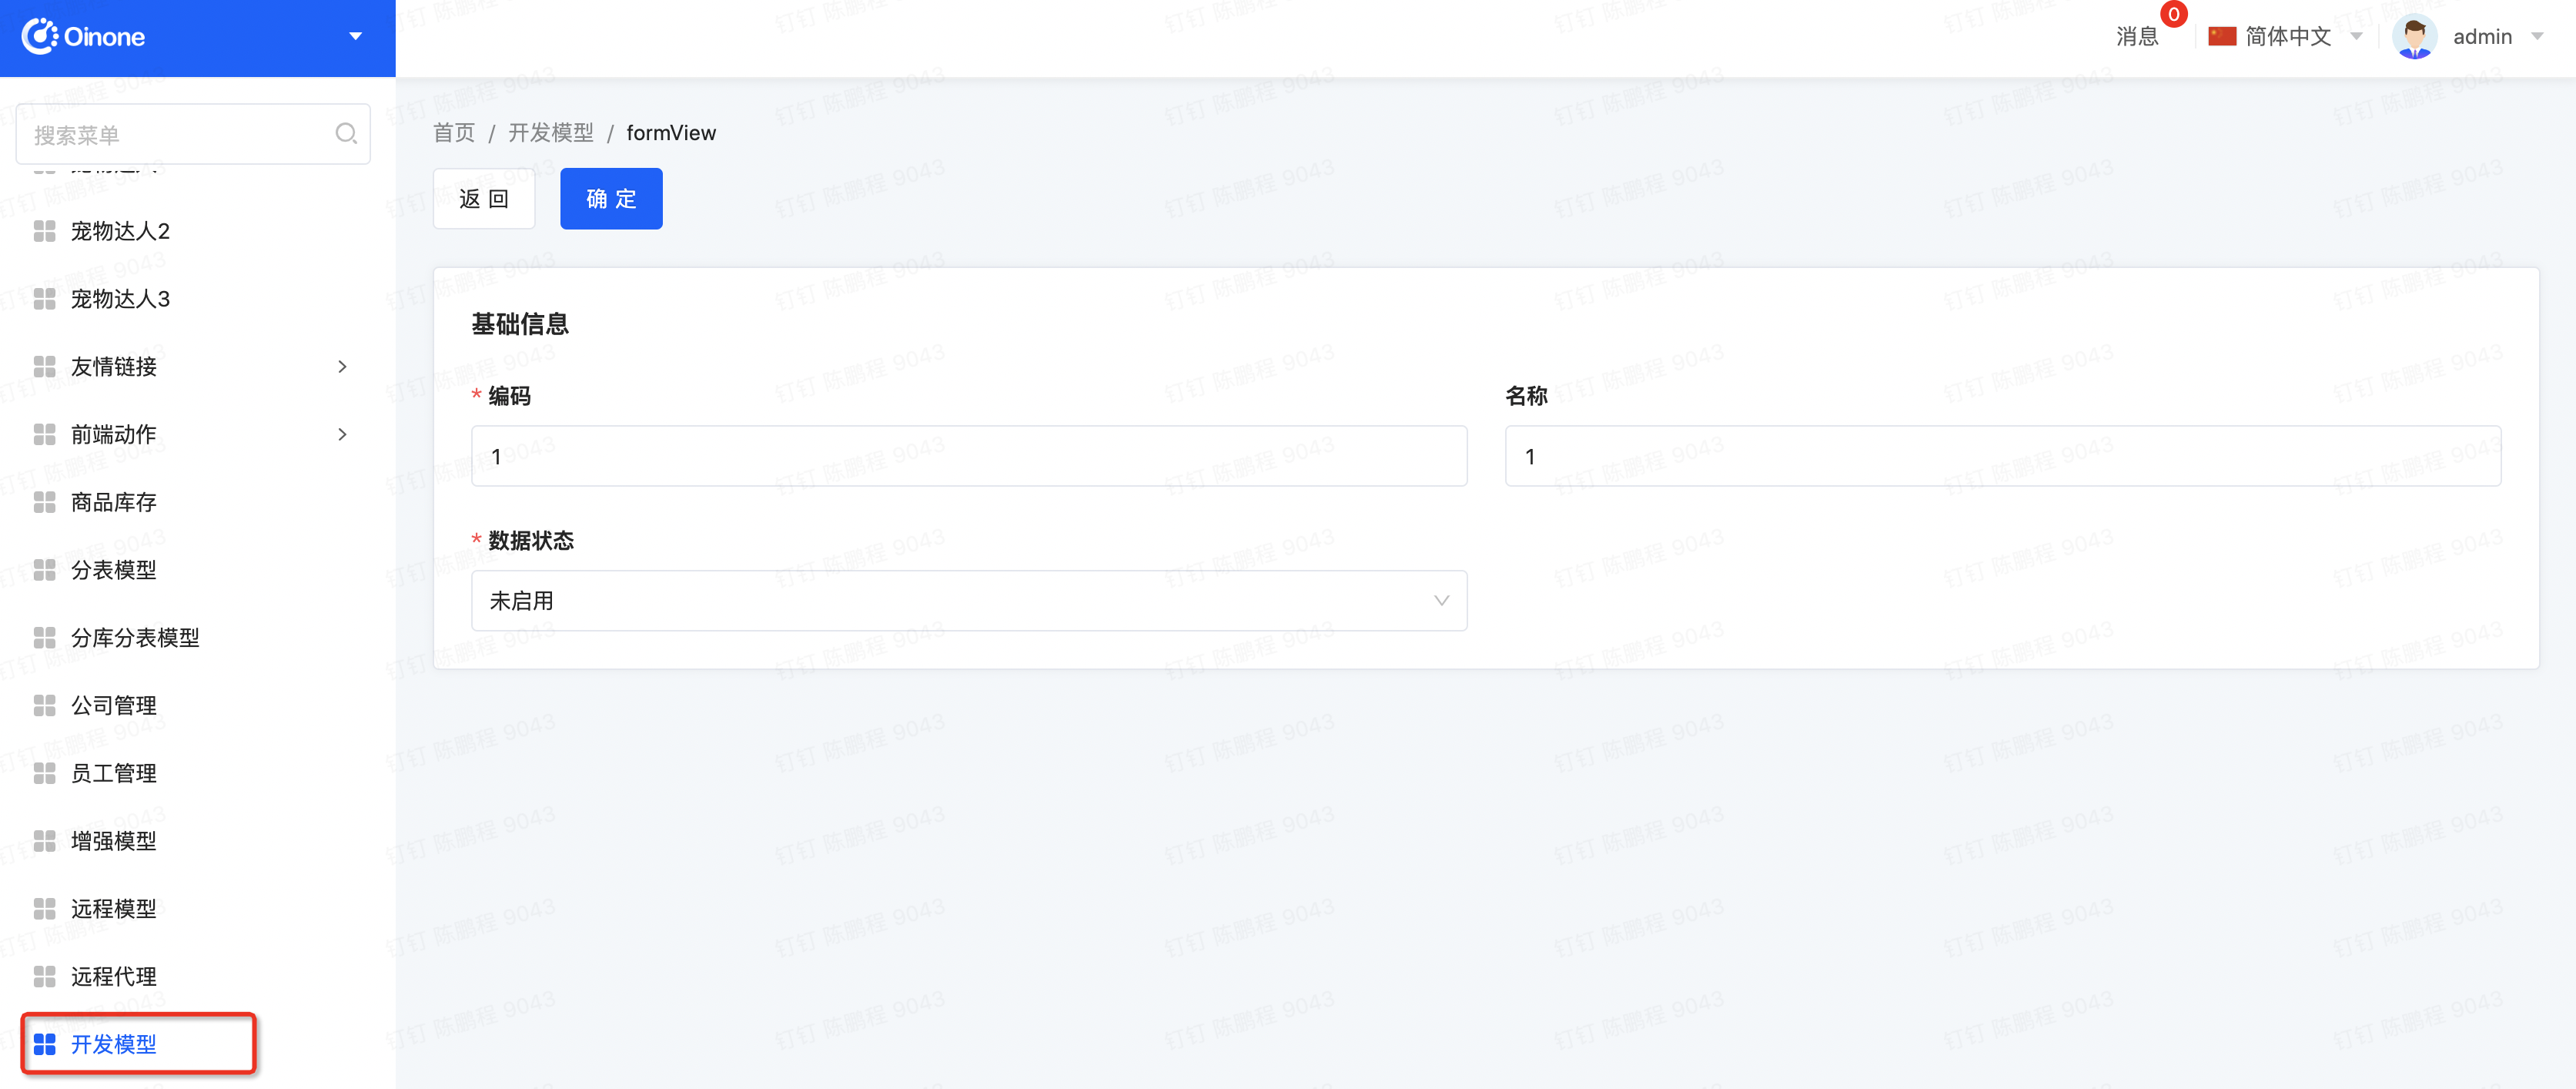
  1. 菜单与页面能正常操作

image.png

图4-4-13 开发模型菜单可正常操作

image.png

图4-4-14 开发模型详情页面可正常操作

Step5 Never模式需注意的事项

  1. 业务库需设定为本地开发库,这样才不会影响公共环境,因为对库表结构的修改还是会正常进行的

  2. 如果不小心影响了公共环境,需要对公共环境进行重启恢复

  3. 系统新产生的元数据(如:例子中的【开发模式】菜单)不受权限管控

三、分布式开发约定

设计约定

  1. 跨模块的存储模型间继承,在部署时需要跟依赖模块配置相同数据源。这个涉及模块规划问题,比如业务上的user扩展模块,需要跟user模块一起部署。

  2. 跨模块的多对多关系,配置中间表模型,在3.3.9【字段类型之关系与引用】一文中的“M2M字段”部分有详细介绍。

  3. 基础依赖:base。

  4. canal相关参考:4.1.10【函数之触发与定时】中提到的修改topic方案。

编码约定

  1. 跨模块间用service来调用,避免直接调用模型的数据管理器(如new 非本模块Model().queryPage等)。结构性代码可以用oinone提供研发辅助工具进行提效率

  2. 在3.4.1【构建第一个Function】一文中有提到,需要在API包中声明注解了@Fun注解的函数接口,并在接口的方法上加上@Function注解。

Oinone社区 作者:史, 昂原创文章,如若转载,请注明出处:https://doc.oinone.top/oio4/9311.html

访问Oinone官网:https://www.oinone.top获取数式Oinone低代码应用平台体验

Like (0)
史, 昂's avatar史, 昂数式管理员
Previous 2024年5月23日
Next 2024年5月23日

相关推荐

  • 3.3.8 字段类型之基础与复合

    模型字段是描述实体的特征属性,本文介绍重点介绍字段的基础类型与复合类型 使用@Field注解来描述模型的字段。如果未配置字段类型,系统会根据Java代码的字段声明类型来自动获取业务类型。建议配置displayName属性来描述字段在前端的显示名称。可以使用defaultValue配置字段的默认值。 一、安装与更新 使用@Field.field来配置字段的不可变更编码。字段一旦安装,无法在对该字段编码值进行修改,之后的字段配置更新会依据该编码进行查找并更新;如果仍然修改该注解的配置值,则系统会将该字段识别为新字段,存储模型会创建新的数据库表字段,而原字段将会rename为废弃字段。 二、字段类型 类型系统由基本类型、复合(组件)类型、引用类型和关系类型四种类型系统构成。通过类型系统描述应用程序、数据库和前端视觉视图如何进行交互,数据及数据间关系如何处理的协议。其中引用类型和关系类型介绍详见3.3.9【字段类型之关系与引用】一文,字段命名规范参见3.3.1【构建第一个Model】一文,这里不再赘述。 基本类型 业务类型 Java类型 数据库类型 规则说明 BINARY ByteByte[] TINYINTBLOB 二进制类型,不推荐使用 INTEGER ShortIntegerLongBigInteger smallintintbigintdecimal(size,0) 整数, 包括整数(10-11位有效数字)、长整数(19-20位有效数字)和大整数(超过19位)。【数据库规则】:默认使用int;如果size小于6则使用smallint;如果size超过6则使用int;如果size超过10位数字,即大于11(包含符号位),则使用长整数bigint;如果size超过19位数字,即大于20(包含符号位),则使用大数decimal。若未配置size,则按Java类型推测。【前端交互规则】:整数使用Number类型,长整数和大整数前后端协议使用字符串类型。 FLOAT FloatDoubleBigDecimal float(M,D)double(M,D)decimal(M,D) 浮点数,?包括单精度浮点数(7-8位有效数字)、双精度浮点数(15-16位有效数字)和大数(超过15位)。【数据库规则】:默认使用单精度浮点数float;如果size超过7位数字,即大于等于8,则使用双精度浮点数double;如果size超过15位数字,即大于等于16,则使用大数decimal。若未配置size,则按Java类型推测。【前端交互规则】:单精度浮点数float和双精度浮点数double使用Number类型(因为都使用IEEE754协议64位进行存储),大数前后端协议使用字符串类型。 BOOLEAN Boolean tinyint(1) 布尔类型,值为1,true(真)或0,false(假) ENUM Enum 与数据字典指定基本类型一致 【前端交互规则】:可选项从ModelField的options字段获取,options字段值为字段指定数据字典子集的JSON序列化字符串。前后端传递的是可选项的name,数据库存储使用可选项的value。multi属性为true,则使用多选控件;multi属性为false,则使用单元控件 STRING String varchar(size) 字符串,size为长度限制默认值参考,前端可以view中覆盖该配置 TEXT String text 多行文本,编辑态组件为多行文本框,长度限制为配置项size值 HTML String text 富文本编辑器 DATETIME java.util.Datejava.sql.Timestamp datetime(fraction)timestamp(fraction) 日期时间类型【数据库规则】:日期和时间的组合,时间格式为?YYYY-MM-DD HH:MM:SS[.fraction],默认精确到秒,在默认的秒精确度上,可以带小数,最多带6位小数,即可以精确到?microseconds (6 digits) precision。可以通过设置fraction来设置精确小数位数,最终存储在字段的decimal属性上。【前端交互规则】:前端默认使用日期时间控件,根据日期时间类型格式化格式format格式化日期时间 YEAR java.util.Date year 年份类型日期类型【数据库规则】:默认“YYYY”格式表示的日期值【前端交互规则】:前端默认使用年份控件,根据日期类型格式化格式format格式化日期 DATE java.util.Datejava.sql.Date datedate 日期类型【数据库规则】:默认“YYYY-MM-DD”格式表示的日期值【前端交互规则】:前端默认使用日期控件,根据日期类型格式化格式format格式化日期 TIME java.util.Datejava.sql.Time time(fraction)time(fraction) 时间类型【数据库规则】:默认“HH:MM:SS”格式表示的时间值【前端交互规则】:前端默认使用时间控件,根据日期类型格式化格式format格式化日期 表3-3-8-1 字段基本类型 复合类型 业务类型 Java类型 数据库类型 规则说明 MONEY BigDecimal decimal(M,D) 金额,前端使用金额控件,可以使用currency设置币种字段 表3-3-8-2 字段复合类型 不可变更字段 使用immutable属性来描述该字段前后端都无法进行更新操作,系统会忽略不可变更字段的更新操作。 自动生成编码的字段 详见3.3.5【模型编码生成器】一文。 字段的序列化与反序列化 使用@Field注解的serialize属性来配置非字符串类型属性的序列化与反序列化方式,最终会以序列化后的字符串持久化到存储中。 详见3.3.7【字段之序列化方式】一文 前端默认配置 可以使用@Field注解中的以下属性来配置前端的默认视觉与交互规则,也可以在前端设置覆盖以下配置。 @Field(required),是否必填 @Field(invisible),是否不可见 @Field(priority),字段优先级,列表的列使用该属性进行排序 更多前端默认视图配置详见:3.5.4【Ux注解详解】一文,如:readonly是否只读等。 举例 回顾我们前面学习例子 现有PetShop代码如下 package pro.shushi.pamirs.demo.api.model; import pro.shushi.pamirs.core.common.enmu.DataStatusEnum; import pro.shushi.pamirs.demo.api.enumeration.PetShopOptionEnum; import pro.shushi.pamirs.meta.annotation.Field; import pro.shushi.pamirs.meta.annotation.Model; import java.sql.Time; import java.util.List; @Model.model(PetShop.MODEL_MODEL) @Model(displayName = 宠物店铺,summary=宠物店铺,labelFields ={shopName} ) @Model.Code(sequence = DATE_ORDERLY_SEQ,prefix = P,size=6,step=1,initial = 10000,format = yyyyMMdd) public class PetShop extends AbstractDemoIdModel { public static final String MODEL_MODEL=demo.PetShop; @Field(displayName = 店铺编码) private String code; @Field(displayName = 店铺编码2) @Field.Sequence(sequence = DATE_ORDERLY_SEQ,prefix = C,size=6,step=1,initial = 10000,format = yyyyMMdd) private String codeTwo; @Field(displayName = 店铺名称,required = true) private String shopName; @Field(displayName = 开店时间,required = true) private Time openTime; @Field(displayName = 闭店时间,required = true) private Time closeTime; @Field(displayName =…

    2024年5月23日
    1.8K00
  • 2.1 数字化时代软件业的另一个本质变化

    随着企业从信息化向数字化转变,软件公司提供的产品也由传统的企业管理软件向企业商业支撑软件发展。这一变化带来了许多技术上的挑战和机遇。在之前的章节中,我们提到企业的视角已经从内部管理转向业务在线和生态在线协同,这也带来了一系列新的需求。但是,我们常常会忽视这一变化所带来的对系统要求的变化。在本章中,我们将探讨这些技术上的变化,以及这些变化所带来的机遇和挑战。 图2-1 从信息化到数字化软件本质变化 在信息化时代,企业的业务围绕着内部管理效率展开,借鉴国外优秀的管理经验,企业将其管理流程固化下来,典型的例子是ERP项目。这类项目上线后往往长期稳定,不轻易更改,因此信息化时代软件的技术流派侧重于通过模型对业务进行全面支持。例如,SAP具有丰富的配置能力,将已有企业管理思想抽象到极致。其功能基本上可以通过配置来实现,因此其模型设计特别复杂。但是,我们也应该清楚地了解到,配置是面向已知问题的。在数字化时代,创新和业务迭代速度非常快,这种方法可能就不太适合了。我们知道,模型抽象是在设计时具有前瞻性的,一旦不适合,修改起来就会异常困难。 随着数字化时代的到来,企业主的关注点已经从单一企业内部管理转变为了围绕企业上下游价值链的协同展开。这种变化给企业信息化系统提出了更高的要求,例如业务需求的响应速度、系统性能和用户体验等方面。现在,企业对软件不仅是管理需求的承载,更是业务在线化的承载。传统的重模型设计软件模式已经不再适用,因为业务本身不断创新和变化。因此,数字化时代需要新的软件技术流派,这种流派必须是轻模型加上低代码技术的结合体。通过模型抽象80%的通用场景,剩余的20%个性化需求可以通过技术手段来完成。这样的设计可以让每家企业的研发人员轻松理解模型,而不像ERP模型那样异常复杂,无法进行修改。此外,配合低代码技术可以快速研发和上线。如果说配置化是面向已知问题的,那么低代码就是面向未知问题设计的。虽然低代码的概念可以追溯到上个世纪80年代,当时是为了满足企业内部部门之间有协同需求,但又没有专业软件支撑,定制化开发又不划算的辅助场景。但现在它的核心原因是企业数字化的核心场景不稳定,变化很快,每家企业都有强烈的个性化需求。因此,低代码成为解决这些问题的核心手段,数字化时代的低代码需要具备处理复杂场景的能力,而不仅仅是围绕着内部管理展开。 企业在数字化转型的过程中需要考虑到不仅是成熟的全链路业务解决方案,还要应对数字化场景的快速变化和持续创新的需求。为此,Oinone打造了一站式低代码商业支撑平台,从业务与技术两个维度来帮助企业建立开放、链接、安全的数字化平台。这将在水平和垂直两个维度上全面推动企业数字化转型。 另外,低代码的另一个好处是完成了软件本身的数字化建设。通过基于元数据设计,元数据成为软件中数据、逻辑和交互的数据,软件结合AI可以有更多的创造可能。想象一下,AI了解软件的元数据后可以自我运作,人在极少情况下才需要参与,人机交互也会发生大的改变。未来的软件交互不再需要研发提前预设,而是能够实现用户所需即所呈现的效果。作为一家帮助企业进行数字化转型的软件公司,请问您的数字化转型是否已经完成呢?

    2024年5月23日
    1.7K00
  • 3.4 Oinone以函数为内在

    函数(Function):是oinone可管理的执行逻辑单元,跟模型绑定则对应模型的方法 描述满足数学领域函数定义,含有三个要素:定义域A、值域C{f(x),x属于A}和对应法则f。其中核心是对应法则f,它是函数关系的本质特征 满足面向对象原则,可设置不同开放级别,本地与远程智能切换。 本章会带大家更加详细地了解Function的方方面面,主要以几下几个维度 构建第一个Function 函数的开放级别与类型 函数的相关特性 函数元数据详解

    Oinone 7天入门到精通 2024年5月23日
    1.8K00
  • 李强

    我们常说“在今天所有的不确定性当中,数字化是最大的确定性”,数字化一定会全面改造所有的行业更是确定的。在菜鸟九年的探索中,我们最大的感受是“未来,任何一个物流企业都会是一个技术公司,真正拉开差距的是:技术与实体产业的结合有多深”。菜鸟“简单极致,贴地疾飞”的技术文化也深刻体现了这一点——好的技术要能解决实际问题。数字化并不是简单地上线一个或几个系统,这是一个贴近业务持续迭代的过程,伴随着这个过程,我相信会诞生非常多的创新技术。 在本书中我看到了工程思维在推进技术创新的缩影,把难的问题转化为简单的问题,用成熟实用的技术分而解之。高性能的微服务框架、CDM、元数据、低代码、无代码等,都是当下非常热门的技术课题,Oinone把这一切都有机地结合起来,形成了一种具备先进理念的全新一代软件产品,每一个特性都贴合企业数字化遇到的实际问题。Oinone的产品设计,把“大道至简,软件自造”贯穿始终,用最简单的方式,帮助企业驾驭数字化,相信会给企业带来不一样的体验。 就跟本书提到的“「企业视角由内部管理转向业务在线、生态在线(协同)带来一系列新的诉求」这一大背景下,以及云、端等新技术的发展,对研发人员的需求越来越大,同时要求越来越高,低代码平台是提升研发效率,降低研发成本的核心手段”,低代码已经不是需不需要的问题,而是怎么选的问题。菜鸟网络自身也在推进自有低代码开发平台,我们有幸邀请本书作者陈鹏程来到菜鸟网络进行了分享交流,收获非常大。如您正在选型低代码开发平台,向您推荐这本书,低无一体的Oinone肯定会打动您。 菜鸟网络CTO李强(在宽)

    Oinone 7天入门到精通 2024年5月23日
    2.6K00
  • 6.5 权限体系(改)

    做好企业级软件,首先得过权限这一关 在企业的IT部门沟通中,权限是避免不了。自嘲下在我们刚出来创业时,为了收获客户对我们技术能力的信任,每每与跟客户沟通时都会说我们是阿里出来的,但在权限设计这个环节不那么灵验,反而被打上了不懂B端权限设计的标签,会问很多问题。我就很奇怪难道大厂就没有内部管理系统了?大厂只有C端交易,没有B端交易?但从侧面说明权限不简单还特别重要。做好企业级软件,首先得过权限这一关。 整体介绍 对于平台运行来说,权限是必须,但我们的auth模块不是必须的,auth模块只是我们提供的一种默认实现,客户可以根据平台的spi机制进行替换。auth模块利用了平台的Hook特性做到与业务无关,在我们开发上层应用的时,是不用感知它的存在的。 auth模块涉及:功能权限、数据权限 数据权限:行权限和列权限。备注:数据权限的控制只能用于【存储模型】 表级权限:表达的语义是:是否该表可读/写(修改和新增) 列权限:表达的语义是:是否该列可读/写(修改和新增) 行权限:表达的语义是:是否对该行可读/写(修改)/删除 功能权限:表达的语义是ServerAction/Function是否可执行/展示,viewAction是否可展示,菜单是否可以显示 范围说明: 配置多个权限项的时候,取并集 配置多个角色的时候,取并集 模型设计 产品体验 Step1 创建角色 通过App Finder 切换至【权限】应用,点击新增按钮创建一个名为oinone的角色 Step2 创建数据权限项 在【权限项列表】菜单,点击【创建】按钮新增一个名为【宠物达人数据权限项】,同时宠物达人的数据权限设置为只能查看性别为男的记录 配置说明: 名称: 代表该项配置的权限的名字(必填)(必须是全系统唯一) 权限模型: 选择需要拦截的数据所在的表,即为模型,可以搜索使用 描述:对该权限项的描述 权限条件的配置: 满足全部:对条件一和条件二要同时满足的数据才能被看见 满足任一:对条件一和条件二要任意满足的数据都能被看见 读权限:对该数据是否有读取的权限 写权限:对该数据是否有修改的权限 删除权限:对该条件内的数据是否有删除的权限 Step3 为角色配置权限 编辑oinone角色,只开通oinoneDemo工程应用 选中【数据权限】选项卡点击【添加】按钮,勾选宠物达人数据权限项点击【确定】按钮 整体点击保存,回到列表页记得点击【权限生效】按钮 Step4 新建用户绑定角色 切换到用户中心模块,点击【创建】按钮填写必要信息,并在角色选中oinone权限组。 退出admin用户,用oinone登陆,权限效果: 只能看见demo模块 oinone登陆只能看到性别为男的宠物达人记录 admin用户登陆 oinone用户登陆 因为宠物达人的页面没有把性别字段放出来,我们看下数据库数据 auth模块扩展 在日常项目开发中,难免会碰到一些针对权限管理的特殊需求,或是为提升性能做的特殊逻辑。接下来我给大家介绍auth模块扩展性。 权限全局配置 对所有权限角色都做限制,而且不想让用户感知,可以实现PermissionFunApi接口,API接口实现的配置方式【只能用于支持全局的数据权限配置】 实现接口PermissionFunApi 将实现托管给SpringAOP 接口的具体实现看下图的代码 package pro.shushi.pamirs.demo.core.service; import org.springframework.stereotype.Component; import pro.shushi.pamirs.auth.api.service.PermissionFunApi; import pro.shushi.pamirs.demo.api.model.PetTalent; @Component public class PetTalentPermissionFunApi implements PermissionFunApi { @Override public String permissionDomain(Object… args) { //获取当前组织中 return "name == '张学友'"; } @Override public String nameSpace() { return PetTalent.MODEL_MODEL; } } 不参与权限控制 如果某一接口不想做权限控制,则可以在启动工程的application-dev.yml文件中配置不需要权限过滤的接口 pamirs: auth: fun-filter: – namespace: demo.PetTalent fun: queryPage 换一个没有配置宠物达人权限的用户(除管理员以外)进入系统,则也可以看到数据。注意【权限全局控制】还是生效的 API 1. 获取当前用户对该模型的行权限 Result<String> result = CommonApiFactory.getApi(AuthApi.class).canReadAccessData("Model"); 返回值为 { 'data':"name=in=('hahaha')" 'success':true … } 用法 : 场景:前端发起的请求都会经过权限拦截,后端代码逻辑发起的数据请求都是不经过任何权限的过滤,但是某些特殊情况需要在后端代码逻辑发起的数据请求也带上权限过滤 入参:请求的模型 出参:Result 数据结构中data会存储一段字符串,该字符串为Rsql 将该Rsql追加到wrapper中 Result<String> result = CommonApiFactory.getApi(AuthApi.class).canReadAccessData("base.UeModule"); String data=result.getData(); QueryWrapper<UeModule> wrapper = Pops.query(); wrapper.setEntity(ueModule); if (!StringUtils.isBlank(data)) { wrapper.apply(data); }

    2024年5月23日
    2.0K00

Leave a Reply

Please Login to Comment