
2.2 互联网架构作为最佳实践为何失效

如果把互联网架构比作社会主义,Oinone就是也要做有中国特色的社会主义,才能符合国情。

随着业务和生态的发展,企业对效率、性能、体验和智能化等方面的要求越来越高,但很多企业的系统面临着严重的系统架构落后和系统间割裂等问题,这些问题导致原有系统在业务发展下面临着效率和性能的双重挑战。与此同时,互联网平台的技术水平远远领先于传统企业系统,但是是否可以直接将互联网架构照搬到企业数字化转型中呢?显然,这是不合适的,因为互联网架构在企业数字化转型中面临着许多水土不服的问题。本章节将结合互联网中台架构的发展,分析这些问题的原因。

借鉴互联网中台理念

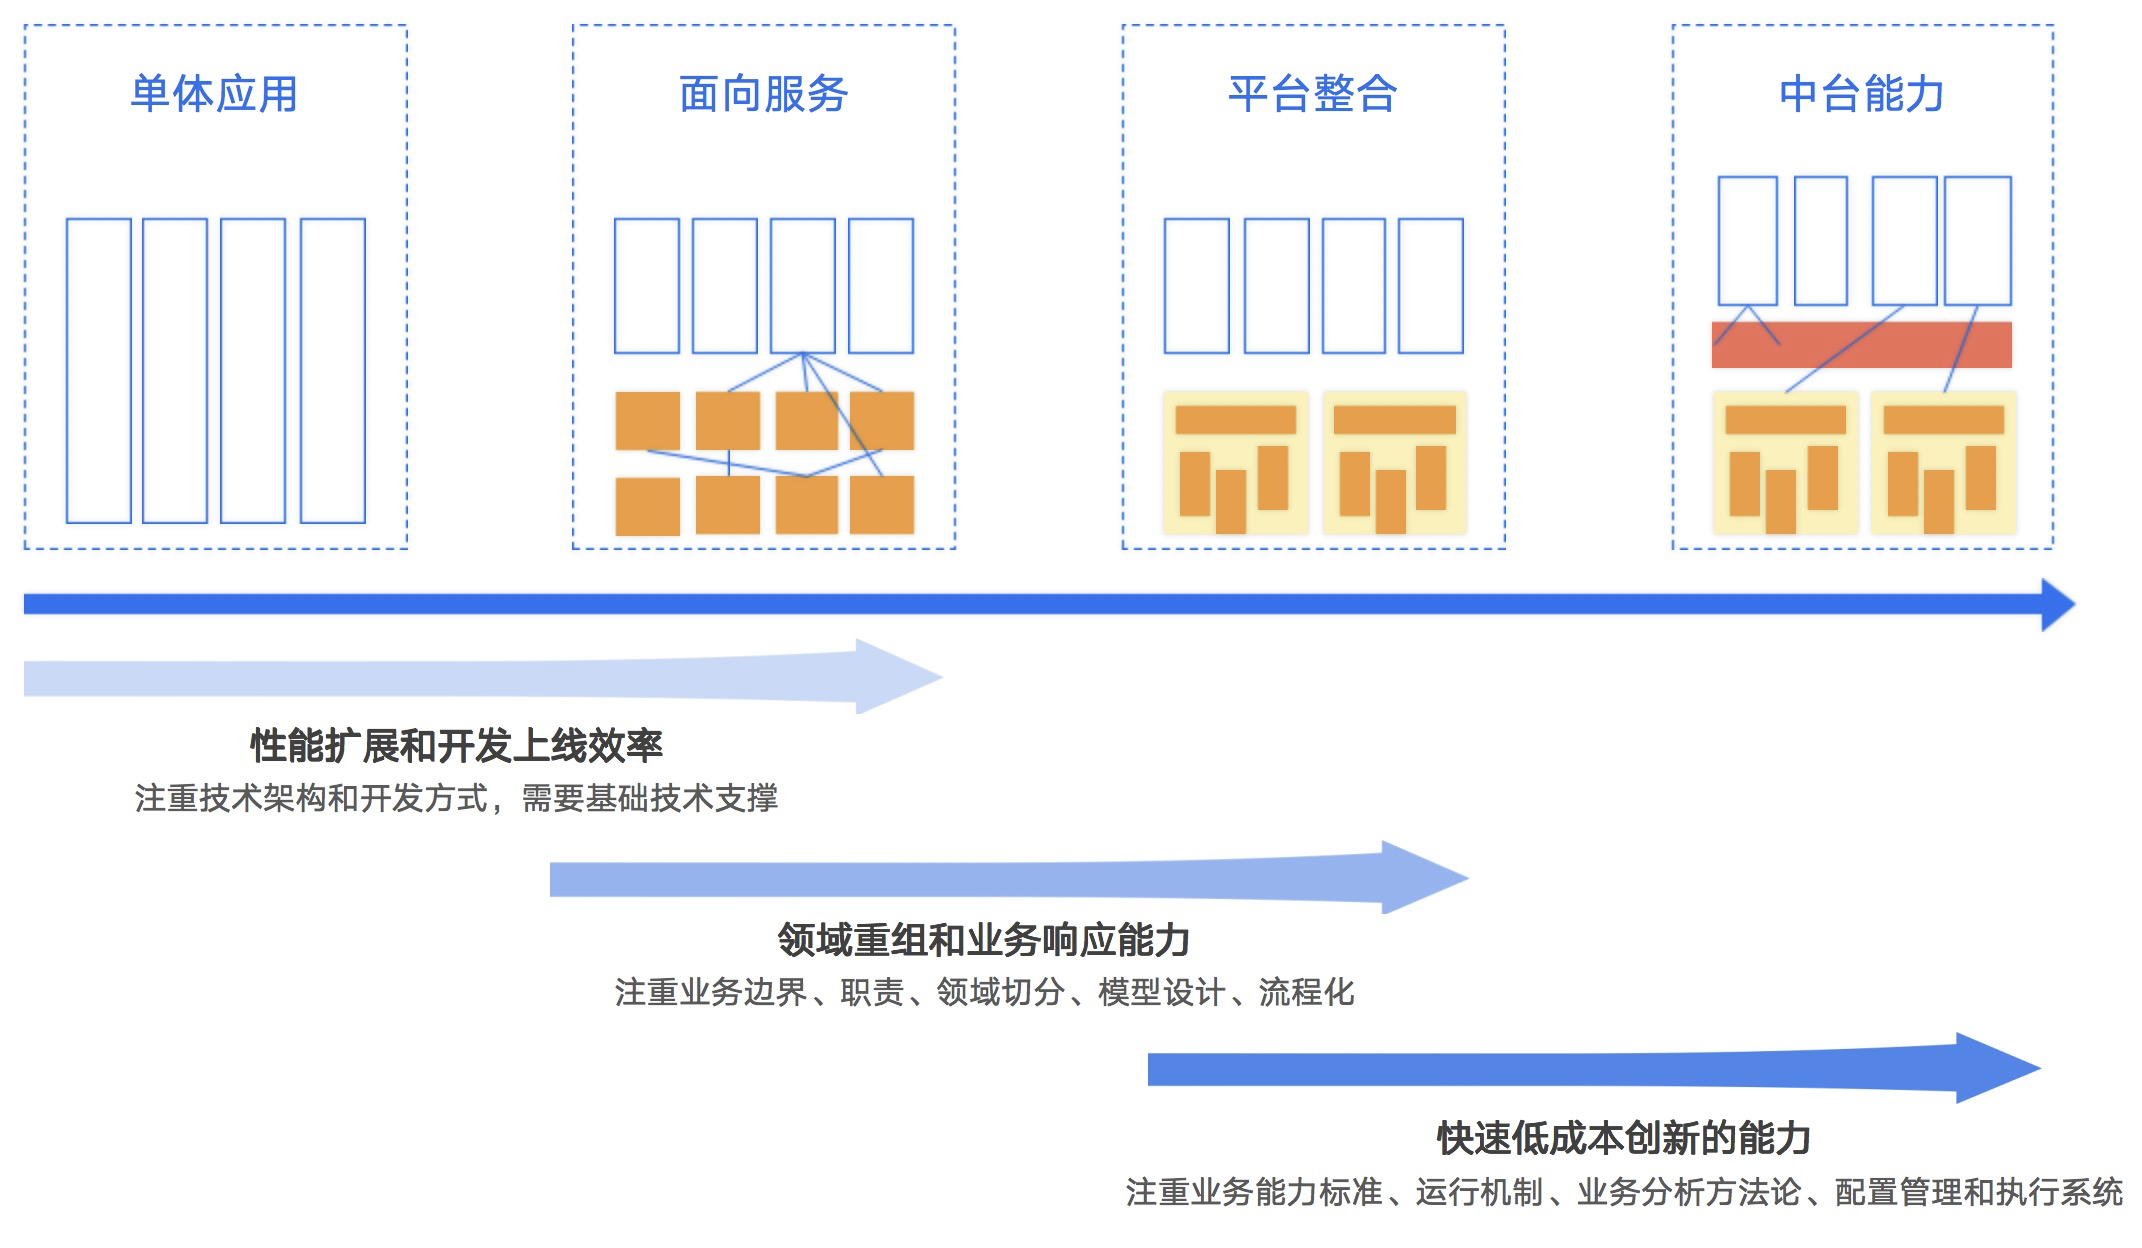
我们要先看互联网架构的发展,是如何一步步到今天提的中台架构概念的,每一步又解决了什么具体问题,我们以阿里架构变迁史为例来看下(如下图2-2所示):
2.2 互联网架构作为最佳实践为何失效

图2-2 阿里架构变迁史

在2009年,淘宝上线了五彩石项目,这标志着淘宝从单体应用向服务化应用的时代迈出了一步。那么,淘宝为什么要开发五彩石项目呢?因为当时淘宝面临两个非常严峻的问题,一个是性能问题,数据库连接不足,数据库成为了瓶颈;另一个是效率问题,当时淘宝有百余个研发人员,但核心系统只有一套测试、预发、线上环境,导致研发需求排队等待。在开始五彩石项目之前,淘宝还做了千岛湖项目,用来验证服务化架构的可行性,将用户中心独立出来。随后,淘宝开启了五彩石项目,目标是通过增加人力来提升效率,通过增加机器来提升性能。

随着淘宝的业务发展,他们又面临了一个问题:各个服务之间有很多重复的建设,效率低下。为了解决这个问题,淘宝开始从服务化转向平台化,并创立了“共享业务事业部”,将重复建设的公共业务分配给这个事业部,以避免成本浪费。这些公共业务包括商品平台、交易平台和结算平台等。平台化的目标是规避服务化没有规划导致的重复建设问题。

但是随着业务的快速发展,淘宝变成了一个拥有几十个事业部的巨型企业,而这带来了新的问题:效率问题。例如,如果需要在一个业务线上做出改动,需要与十几个平台进行沟通,这是非常低效的。同时,对于一个平台来说,需要面对来自不同事业部的需求,这需要平台研发人员具备理解和抽象所有业务线需求的能力,这让平台研发人员感觉回到了单体应用时代,所有的需求都要排队,即使增加人力也无法提高效率。这个问题主要表现在交易平台上。

为了解决这个问题,淘宝提出了中台的概念,中台是在一套规范下建立的,让具有专业技能的团队自主决策业务系统发展的平台。中台的目标是弱化平台的业务特性,提供通用能力。简而言之,就是将“共享业务”中的“业务”两个字去掉,只提供通用能力的平台

我们将每个阶段的核心目标总结为一句话:

  1. 从单体到服务:通过增加人员和机器来提高效率和性能;

  2. 从服务化到平台化:解决服务化阶段因缺乏规划而导致的重复建设问题;

  3. 平台化到中台化:在一套规范下,让各业务团队自行决定业务系统发展,适用于多个业务线或多个场景应用的独立发展。

类似地,在企业数字化转型过程中,也面临着类似的问题:

  1. 随着企业业务在线化,对系统性能和稳定性提出了更高的要求,但由于内部系统之间的割裂,导致很多重复建设。因此,我们需要进行服务化和平台化;

  2. 没有一个供应商能够解决企业所有的商业场景问题,所以需要多个供应商共同参与。我们可以将供应商类比为各业务线,在一套规范下让供应商或业务线自行决定业务系统的发展。

然而,阿里的中台架构方案并不能直接照搬到企业中。因为阿里的中台架构采用了平台共建模式,即让业务线基于平台设计的规范共同开发。这本质上还是平台主导模式,对企业来说历史包袱较大。在企业中,让不同背景的研发一起共建交易或商品平台是非常复杂的事情。平台化已经足够复杂,再加上共建会导致企业架构的负载过重,这对企业来说就不再是赋能,而是“内耗”。

互联网中台架构在企业实践中遇到的问题

在1.3《Oinone的生态思考》一文中,《与中台的渊源》部分提到,在阿里云为企业提供数字化项目时,客户经常会对以下三个问题提出质疑,这些问题非常突出:

1我们听说你们具备敏捷响应能力,但为什么改动需求如此缓慢?不仅所需时间更长,而且成本更高?

2我们听说你们有能力中心,但为什么当我们引入新供应商或开发新场景时,前期建立的能力中心无法支持我们?

3我们听说你们的性能很好,但为什么我们需要投入更多的物理资源来支持项目?

在探讨互联网架构的适用性时,我想提出以下两个问题:

1企业应用程序的性能问题是否与互联网平台公司遇到的性能问题相同?

2企业应用程序的开发效率问题是否与互联网平台公司遇到的效率问题相同?

通过比较企业和互联网之间的差异,我们可以了解水土不服的核心原因。

企业 互联网
企业IT组织能力无法与数字化转型的速度匹配,缺乏足够的人才支持。为了提高开发效率,企业需要寻找工具和技术来降低开发难度,同时提高个人开发效率 互联网企业拥有众多优秀的人才,需要解决团队协作和知识共享的问题,即协同开发的效率。
企业无法制定并主导技术规范,这导致了能力复用的不足。为了提高效率和减少开发成本,企业需要建立统一的技术规范和标准,以便能力复用和组织协同。 互联网企业可以自定义技术规范,因此能力复用更易于保障。
企业往往当前业务量相对小,期望数字化建设能打动业务发展,对业务发展的预期比较高,所以企业的诉求是即满足当下成本效应又能兼顾未来对发展预期 互联网企业起步时的系统目标负载就高,通常会忽略资源起步门槛的问题,当然也可以通过自动扩容、云计算等方式来解决初期的负载问题。

表2-1从企业与互联网的对比,看水土不服的核心原因

我们可以看到企业和互联网架构在很多方面存在着不同的需求和问题。因此,在提供数字化服务时,Oinone需要注意与企业的组织能力进行匹配,并根据企业自身的特性来提供在线化的服务能力。这就像在社会主义制度下需要有中国特色一样,Oinone也需要有适合中国企业的特色。

Oinone社区 作者:史, 昂原创文章,如若转载,请注明出处:https://doc.oinone.top/oio4/9217.html

访问Oinone官网:https://www.oinone.top获取数式Oinone低代码应用平台体验

Like (0)
史, 昂's avatar史, 昂数式管理员
Previous 2024年5月23日 am10:05
Next 2024年5月23日 am10:07

相关推荐

  • 3.1 环境搭建

    一、基础环境说明 内容 是否必须 说明 后端基础环境 JDK1.8 必须 java的基础运行环境, 要求高于1.8_221以上,低于这个版本需要覆盖jce (原因:https://www.cnblogs.com/jinloooong/p/10619353.html) Mysql 必须 8.0.26 版本以上需要注意点:修改:my.cnf (macOS ) / my.ini (windows)时区、大小写敏感设置lower_case_table_names = 2default-time-zone = ‘+08:00’ Idea 必须 需要注意点:1.禁用Lombok插件2.java Compiler 增加 -parameters(不然java反射获取方法入参名会变成arg*) 指令3.安装oinone插件 DB GUI 非必须 Datagrip、MySQLWorkbench、DBEaver 选其一 Insomnia 非必须 GraphQL测试工具 Git 必须 2.2.0以上 Maven 必须 3.6.3需要注意点:1配置mvn的settings文件下载地址见oinone开源社区群公告,也可以联系oinone合作伙伴或服务人员2把settings.xml拷贝一份到maven安装目录conf目录下 RocketMQ 必须 4.7.1以上 Redis 必须 5.0.2以上 Zookeeper 必须 3.5.8以上 前端基础环境 nvm 非必须 方便node的版本管理 nodejs 必须 版本要求为12.12.0注意事项:1.npm的源配置为http://nexus.shushi.pro/repository/kunlun/2.源的用户名、密码见oinone开源社区群公告,也可以联系oinone合作伙伴或服务人员 vue-cli 必须 vue脚手架工具 表3-1-1基础环境说明 其他:canal和Es的环境搭建见具体学习章节 二、基础知识准备 前端必备知识 vue3、typescript、graphql 后端必备知识 SpringBoot、MybatisPlus 表3-1-2基础知识准备 三、下载快速安装包 Mac版 Windows版 四、学习安装 推荐,虽然慢点对环境有比较深入的了解,对自身能力提升和日后排查问题都有好处。 mac见:3.1.1【环境准备(Mac版)】一文 windows见:3.1.2【环境准备(Windows版)】一文

    Oinone 7天入门到精通 2024年5月23日
    3.6K00
  • 3.5.3 Action的类型

    各类动作我们都碰到过,但都没有展开讲过。这篇文章我们来系统介绍下oinone涉及到的所有Action类型。 一、动作类型 服务器动作ServerAction 类似于Spring MVC的控制器Controller,通过模型编码和动作名称路由,定义存储模型或代理模型将为该模型自动生成动作名称为consturct,queryOne,queryPage,create,update,delete,deleteWithFieldBatch的服务器动作。定义传输模型将为该模型自动生成动作名称为consturct的服务器动作 窗口动作ViewAction 站内跳转,通过模型编码和动作名称路由。系统将为存储模型和代理模型自动生成动作名称为redirectDetailPage的跳转详情页窗口动作,动作名称为redirectListPage的跳转列表页窗口动作,动作名称为redirectCreatePage的跳转新增页窗口动作,动作名称为redirectUpdatePage的跳转更新页窗口动作。 跳转动作UrlAction 外链跳转 客户端动作ClientAction 调用客户端函数 二、默认动作 如果在UI层级,有开放新增语义函数,则会默认生成新增的窗口动作ViewAction,跳转到新增页面 如果在UI层级,有开放更新语义函数,则会默认生成修改的窗口动作ViewAction,跳转到更新页面 如果在UI层级,有开放删除语义函数,则会默认生成删除的客户端动作ClientAction,弹出删除确认对话框 三、第一个服务器动作ServerAction 回顾第一个ServerAction 第一个ServerAction是在3.3.2【模型的类型】一文中的“代理模型”部分出现的,再来看下当时的定义代码 package pro.shushi.pamirs.demo.core.action; ……引用类 @Model.model(PetShopProxy.MODEL_MODEL) @Component public class PetShopProxyAction extends DataStatusBehavior<PetShopProxy> { @Override protected PetShopProxy fetchData(PetShopProxy data) { return data.queryById(); } @Action(displayName = "启用") public PetShopProxy dataStatusEnable(PetShopProxy data){ data = super.dataStatusEnable(data); data.updateById(); return data; } ……其他代码 } 图3-5-3-1 回顾第一个ServerAction @Action注解将创建服务器动作,并@Model.model绑定 自定义ServerAction请勿使用get、set、unset开头命名方法或toString命名方法。 ServerAction之校验(举例) Step1 为动作配置校验表达式 使用@Validation注解为PetShopProxyAction的dataStatusEnable服务端动作进行校验表达式配置 package pro.shushi.pamirs.demo.core.action; ……引用类 @Model.model(PetShopProxy.MODEL_MODEL) @Component public class PetShopProxyAction extends DataStatusBehavior<PetShopProxy> { @Override protected PetShopProxy fetchData(PetShopProxy data) { return data.queryById(); } @Validation(ruleWithTips = { @Validation.Rule(value = "!IS_BLANK(data.code)", error = "编码为必填项"), @Validation.Rule(value = "LEN(data.shopName) < 128", error = "名称过长,不能超过128位"), }) @Action(displayName = "启用") public PetShopProxy dataStatusEnable(PetShopProxy data){ data = super.dataStatusEnable(data); data.updateById(); return data; } ……其他代码 } 图3-5-3-2 为动作配置校验表达式 注: ruleWithTips可以声明多个校验规则及错误提示; IS_BLANK和LEN为内置文本函数,更多内置函数详见4.1.12【函数之内置函数与表达式】一文; 当内置函数不满足时参考4.1.13【Action之校验】一文。 Step2 重启看效果 在商店管理页面点击【启用】得到了预期返回错误信息,显示"编码为必填项" 图3-5-3-3 在商店管理页面点击启用得到了预期返回错误信息 ServerAction之前端展示规则(举例) 既然后端对ServerAction发起提交做了校验,那能不能在前端就不展示呢?当然可以,我们现在就来试下。 Step1 配置PetShopProxyAction的dataStatusEnable的前端出现规则 用注解@Action.Advanced(invisible="!(activeRecord.code !== undefined && !IS_BLANK(activeRecord.code))")来表示,注意这里配对invisible是给前端识别的,所以写法上跟后端的校验有些不一样,但如内置函数IS_BLANK这些是前后端一致实现的,activeRecord在前端用于表示当前记录。 package pro.shushi.pamirs.demo.core.action; ……引用类 @Model.model(PetShopProxy.MODEL_MODEL) @Component public class PetShopProxyAction extends DataStatusBehavior<PetShopProxy> { @Override protected PetShopProxy fetchData(PetShopProxy data) { return data.queryById(); } @Validation(ruleWithTips = { @Validation.Rule(value = "!IS_BLANK(data.code)", error = "编码为必填项"), @Validation.Rule(value = "LEN(data.name) < 128", error = "名称过长,不能超过128位"), }) @Action(displayName = "启用") @Action.Advanced(invisible="!(activeRecord.code !== undefined…

    2024年5月23日
    1.8K00
  • 3.4.3.3 SPI机制-扩展点

    扩展点结合拦截器的设计,oinone可以点、线、面一体化管理Function 扩展点用于扩展函数逻辑。扩展点类似于SPI机制(Service Provider Interface),是一种服务发现机制。这一机制为函数逻辑的扩展提供了可能。 一、构建第一个扩展点 自定义扩展点(举例) 在我们日常开发中,随着对业务理解的深入,往往还在一些逻辑中会预留扩展点,以便日后应对不同需求时可以灵活替换某一小块逻辑。 在3.3.4【模型的继承】一文中的PetCatItemQueryService,是独立新增函数只作公共逻辑单元。现在我们给它的实现类增加一个扩展点。在PetCatItemQueryServiceImpl的queryPage方法中原本会先查询PetCatType列表,我们这里假设这个逻辑随着业务发展未来会发生变化,我们可以预先预留【查询萌猫类型扩展点】 Step1 新增扩展点定义PetCatItemQueryCatTypeExtpoint 扩展点命名空间:在接口上用@Ext声明扩展点命名空间。会优先在本类查找@Ext,若为空则往接口向上做遍历查找,返回第一个查找到的@Ext.value注解值,使用该值再获取函数的命名空间;如果未找到,则返回扩展点全限定类名。所以我们这里扩展点命名空间为:pro.shushi.pamirs.demo.api.extpoint.PetCatItemQueryCatTypeExtpoint 扩展点技术名称:先取@ExtPoint.name,若为空则取扩展点接口方法名。所以我们这里技术名为queryCatType package pro.shushi.pamirs.demo.api.extpoint; import pro.shushi.pamirs.demo.api.model.PetCatType; import pro.shushi.pamirs.meta.annotation.Ext; import pro.shushi.pamirs.meta.annotation.ExtPoint; import java.util.List; @Ext public interface PetCatItemQueryCatTypeExtpoint { @ExtPoint(displayName = "查询萌猫类型扩展点") List<PetCatType> queryCatType(); } 图3-4-3-11 新增扩展点定义PetCatItemQueryCatTypeExtpoint Step2 修改PetCatItemQueryServiceImpl(用Ext.run模式调用) 修改queryPage,增加扩展点的使用代码。扩展点的使用有两种方式 方法一,使用命名空间和扩展点名称调用Ext.run(namespace, fun, 参数); 方法二,使用函数式接口调用Ext.run(函数式接口, 参数); 我们这里用了第二种方式 用PetCatItemQueryCatTypeExtpoint的全限定类名作为扩展点的命名空间(namespace) 用queryCatType的方法名作为扩展点的技术名称(name) 根据namespace+name去找到匹配扩展点实现,并根据规则是否匹配,以及优先级唯一确定一个扩展点实现去执行逻辑 package pro.shushi.pamirs.demo.core.service; ……省略依赖包 @Model.model(PetCatItem.MODEL_MODEL) @Component public class PetCatItemAction extends DataStatusBehavior<PetCatItem> { @Override protected PetCatItem fetchData(PetCatItem data) { return data.queryById(); } @Action(displayName = "启用") public PetCatItem dataStatusEnable(PetCatItem data){ data = super.dataStatusEnable(data); data.updateById(); return data; } @Function.Advanced(displayName = "查询模型数据的默认过滤条件", type = FunctionTypeEnum.QUERY, managed = true) @Function(openLevel = {LOCAL}) public String queryFilters() { StringBuilder sqlWhereCondition = new StringBuilder(); // List<PetCatType> typeList = new PetCatType().queryList(); List<PetCatType> typeList = Ext.run(PetCatItemQueryCatTypeExtpoint::queryCatType, new Object[]{}); if(!CollectionUtils.isEmpty(typeList)){ // sqlWhereCondition.append("type_id"); sqlWhereCondition.append(PStringUtils.fieldName2Column(LambdaUtil.fetchFieldName(PetCatItem::getTypeId))); sqlWhereCondition.append(StringUtils.SPACE).append(SqlConstants.IN).append(CharacterConstants.LEFT_BRACKET); for(PetCatType petCatType: typeList){ sqlWhereCondition.append(petCatType.getId()).append(CharacterConstants.SEPARATOR_COMMA); } sqlWhereCondition.deleteCharAt(sqlWhereCondition.lastIndexOf(CharacterConstants.SEPARATOR_COMMA)); sqlWhereCondition.append(StringUtils.SPACE).append(CharacterConstants.RIGHT_BRACKET); } return sqlWhereCondition.toString(); } ……省略其他函数 } 图3-4-3-12 修改PetCatItemQueryServiceImpl Step3 新增扩展点实现PetCatItemQueryCatTypeExtpointOne 扩展点命名空间要与扩展点定义一致,用@Ext(PetCatItemQueryCatTypeExtpoint.class) @ExtPoint.Implement声明这是在@Ext声明的命名空间下,且技术名为queryCatType的扩展点实现 package pro.shushi.pamirs.demo.core.extpoint; import pro.shushi.pamirs.demo.api.extpoint.PetCatItemQueryCatTypeExtpoint; import pro.shushi.pamirs.demo.api.model.PetCatType; import pro.shushi.pamirs.meta.annotation.Ext; import pro.shushi.pamirs.meta.annotation.ExtPoint; import pro.shushi.pamirs.meta.api.session.PamirsSession; import java.util.List; @Ext(PetCatItemQueryCatTypeExtpoint.class) public class PetCatItemQueryCatTypeExtpointOne implements PetCatItemQueryCatTypeExtpoint { @Override @ExtPoint.Implement(displayName = "查询萌猫类型扩展点的默认实现") public List<PetCatType> queryCatType() { PamirsSession.getMessageHub().info("走的是第一个扩展点"); List<PetCatType> typeList = new PetCatType().queryList(); return typeList; } } 图3-4-3-13 新增扩展点实现PetCatItemQueryCatTypeExtpointOne Step4…

    2024年5月23日
    2.0K00
  • 4.1.14 Search之非存储字段条件

    search默认查询的是模型的queryPage函数,但我们有时候需要替换调用的函数,这个特性会在下个版本支持。其核心场景为当搜索条件中有非存储字段,如果直接用queryPage函数的rsql拼接就会报错,所以非存储字段不会增加在rsql中。本文介绍一个比较友好的临时替代方案。 非存储字段条件(举例) Step1 为PetTalent新增一个非存储字段unStore @Field(displayName = "非存储字段测试",store = NullableBoolEnum.FALSE) private String unStore; 图4-1-14-1 为PetTalent新增一个非存储字段unStore Step2 修改PetTalent的Table视图的Template 在标签内增加一个查询条件 <field data="unStore" /> 图4-1-14-2 修改PetTalent的Table视图的Template Step3 重启看效果 进入宠物达人列表页,在搜索框【非存储字段测试】输入查询内容,点击搜索跟无条件一致 Step4 修改PetTalentAction的queryPage方法 package pro.shushi.pamirs.demo.core.action; …… 引入依赖类 @Model.model(PetTalent.MODEL_MODEL) @Component public class PetTalentAction { ……其他代码 @Function.Advanced(type= FunctionTypeEnum.QUERY) @Function.fun(FunctionConstants.queryPage) @Function(openLevel = {FunctionOpenEnum.API}) public Pagination<PetTalent> queryPage(Pagination<PetTalent> page, IWrapper<PetTalent> queryWrapper){ QueryWrapper<PetTalent> queryWrapper1 = (QueryWrapper<PetTalent>) queryWrapper; Map<String, Object> queryData = queryWrapper.getQueryData(); String unStore = (String) queryData.get(LambdaUtil.fetchFieldName(PetTalent::getUnStore)); if (StringUtils.isNotEmpty(unStore)) { //转换查询条件 queryWrapper1.like( 图4-1-14-3 修改PetTalentAction的queryPage方法 Step5 重启看效果 在搜索框【非存储字段测试】输入查询内容,跟通过【达人】字段搜索的效果是一致的 图4-1-14-4 示例效果

    2024年5月23日
    2.4K00

Leave a Reply

Please Login to Comment