工作台

  • 有工作台权限的用户,默认登录页为工作台,也可以通过APP Finder进入工作台。

image.png

image.png

1. 快捷处理

  • 右上角消息中会气泡展示未处理或未读的操作,点击展开后可以点过去进行快捷处理。

image.png

2. 查看、处理流程

2.1 流程查看

  • 流程管理页面共同点:

1包含选项分类筛选

2包含标签筛选

3包含应用下拉选筛选

4包含根据流程名称搜素

image.png

  • 流程管理页面名词解释:
  1. 待办:当前登录用户未处理的流程节点

  2. 我发起的:当前登录用户人为触发的流程(模型触发)

  3. 抄送:抄送给当前登录用户的节点(审批/填写)

  4. 我已办结:由当前登录用户完成人工/自动同意、人工拒绝或人工填写的节点

  5. 无需办理:当前登录用户转交的任务/被退回、被撤销、被或签、被其他分支任务拒绝的还未办理的任务

  6. 站内信:当前登录用户收到的站内信

2.2 流程处理

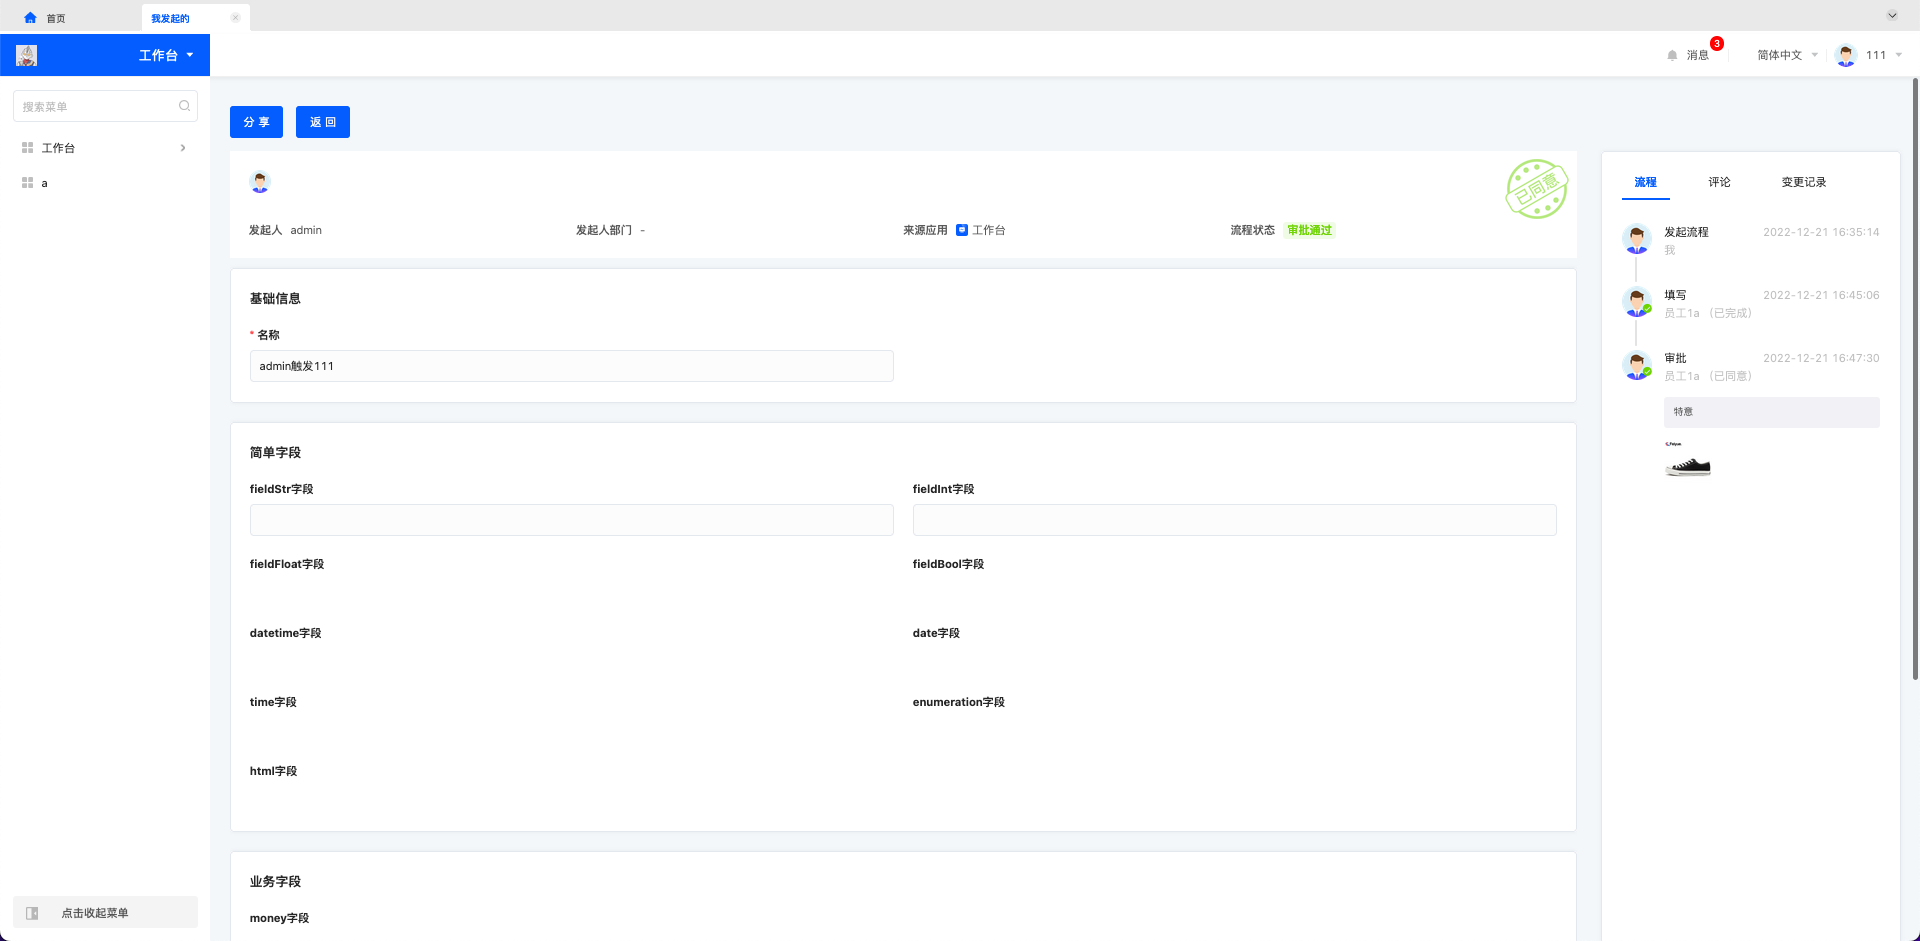
  • 每条流程数据下方有动作,点击进入流程处理页面,大致分为详情页和操作页。
  • 待办中点击“审批/填写”会进入流程操作页。审批操作页可能包含“同意、拒绝、退回、加签、转交、返回”,填写操作页可能包含“提交、暂存”,审批操作页包含哪些动作由流程设计决定。

image.png

image.png

  • 我发起的、抄送、我已办结、无需处理点击“查看”会进入流程详情页。

image.png

3. 应用快捷入口

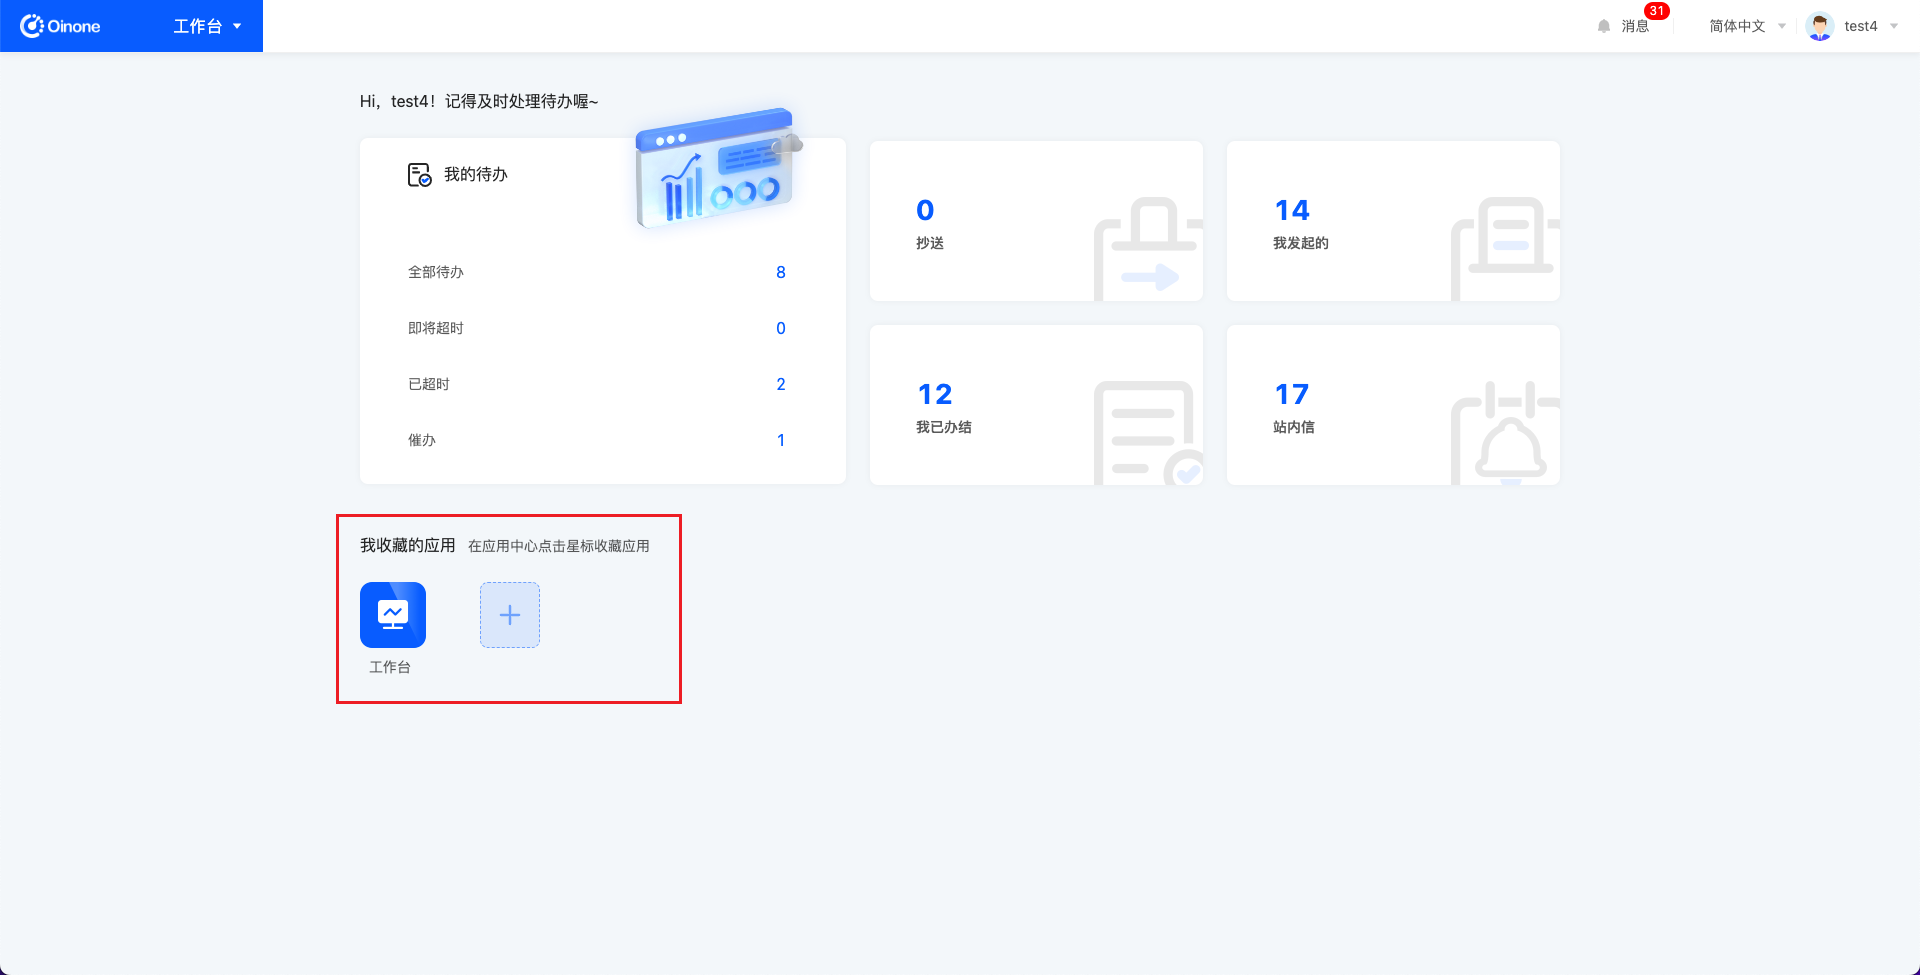
  • 应用中心中星标的收藏应用会展示在此处,点击可快捷进入应用。

image.png

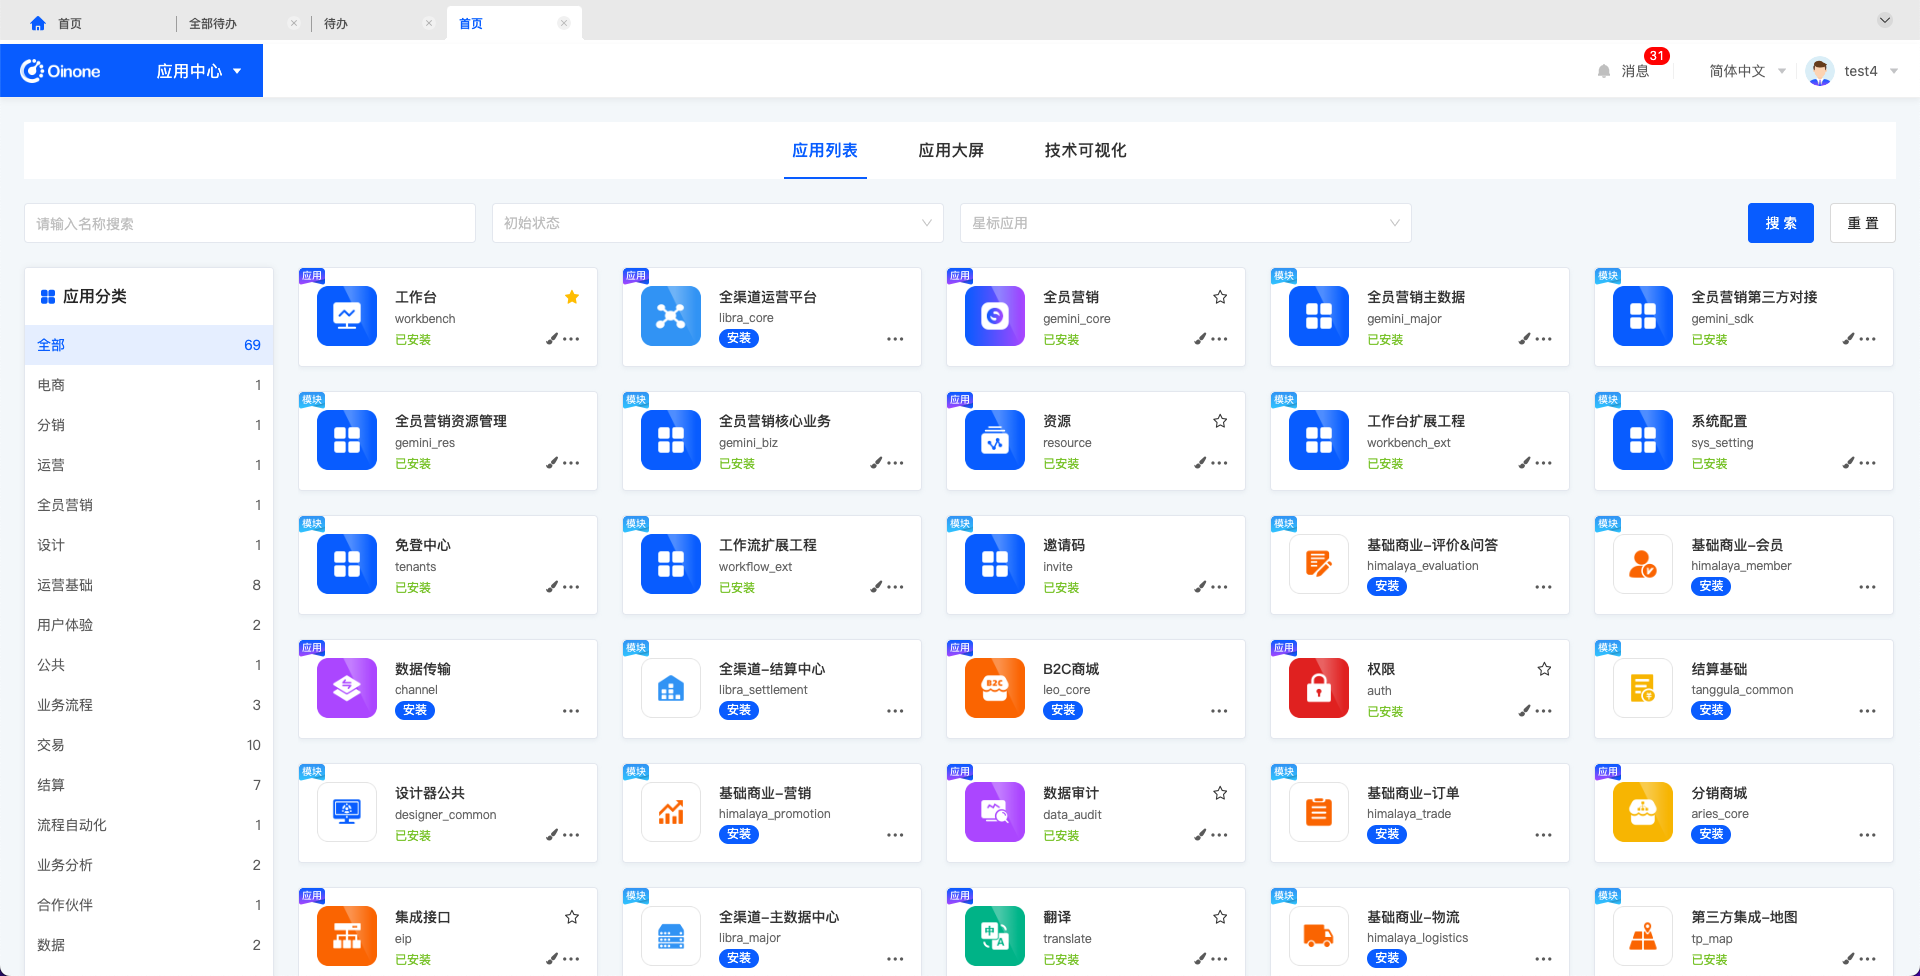
  • 应用中心中已安装的应用点击星标即可收藏。

image.png

Oinone社区 作者:史, 昂原创文章,如若转载,请注明出处:https://doc.oinone.top/oio4/9387.html

访问Oinone官网:https://www.oinone.top获取数式Oinone低代码应用平台体验

Like (0)
史, 昂's avatar史, 昂数式管理员
Previous 2024年6月20日 am12:28
Next 2024年6月20日 am9:48

相关推荐

  • 页面设计

    1. 功能说明 页面设计时界面设计器中「页面」模块的设计入口,在这个界面,进行页面的设置、搭建、设计、排版。 主要分为顶部操作栏、左侧工具栏、中部设计画布区、右侧属性面板。 2. 操作栏 进入页面设计,顶部显示了页面的标题,以及返回、发布等操作。 2.1 发布 页面设计完成后,点击「发布」运行页面生效。若不点击发布,页面也有自动保存的功能,但在发布前,自动保存也等同于草稿,不会正式生效。 发布时如果有属性不符合校验规则(必填的属性未填、输入的内容校验不通过),会发布失败,相应的字段会特殊标记,需要查看并修改属性。 2.2 显示/隐藏母版 进入页面设计时默认不展示母版,可以手动操作显示母版 3. 工具栏 左侧的工具栏中包括组件库、页面设置等模块。 3.1 组件库 组件库中包含组件和模型,组件是当前设计器支持的所有组件,模型是页面所在模型下的所有字段和动作。 3.1.1 组件 组件中展示了系统支持的所有组件。包含 1)布局类组件,如分组、选项卡等,使用布局组件可以将页面进字段分类、分页; 2)字段类组件,如单行文本、整数、日期等等,使用字段类组件时都会在模型下对应创建一个字段; 3)动作类组件,如跳转动作、提交动作、链接动作等。 3.1.2 模型 组件库顶部,由组件可切换为模型:模型选项下,会展示当前模型的所有字段,以及系统默认动作。可以直接拖拽字段至设计画布中,会应用形成某个组件,可对组件进行多样的属性设置,优化交互。 3.1.2 组件和模型有什么区别 1展示内容维度不同 组件中展示的内容是组件信息,如分组、选项卡、单行文本、文件上传等;模型中展示的是模型下已有的所有字段。 2使用功能不同 组件中的组件使用前需要在模型中创建一个字段,当然,创建好的字段也会存在于模型中;模型中的字段可直接使用,并且使用时会在设计画布中对应生成个默认组件。 3使用场景不同 如果模型中已经存在目标字段,应直接选择从模型中拖拽字段;如果模型中没有需要的字段,可以在页面中增加一个组件,实际上也是在新增一个字段。 3.2 页面设置 页面设置中可以修改当前页面的标题、分组、页面描述,同时也是给页面上传缩略图的唯一入口。 4. 设计画布 将组件或字段拖拽至设计画布区,会生成样式。点击组件,右侧可对其进行设置,大部分属性可实时在画布中展示效果。 5. 属性面板 右侧属性面板抽屉中可以设置属性或查看字段信息,通过不同的属性配置化实现组件的多样化。 5.1 属性 属性中包括基本信息(如标题、占位提示、描述说明等)、校验信息(如是否必填、长度校验等)、交互信息(如排序方式、是否展示计数器等) 5.2 字段 首次从组件中拖拽,会先展示字段信息,并且是需要先创建一个字段,字段创建成功后,再次切换字段选项,只读展示当前组件所对应的字段基本信息。同理,如果是直接从字段中拖拽,字段选项中,只读展示当前字段基本信息。

    2024年6月20日
    4.4K00
  • 1.5 Oinone与行业对比

    随着企业数字化转型的推进,软件公司获得了许多机会。尽管竞争日趋激烈,但由于需求旺盛,各种模式仍在不断涌现。因此,当前市场上存在各种各样的数字化转型解决方案,围绕企业的各个方面展开。每种解决方案都有其优点和缺点。本文将从定位、技术和产品等方面简单比较,帮助您从不同的视角了解Oinone的差异。 1.4.1 整体视角对比 一、与对标公司Odoo的对比 Odoo Oinone 定位 一站式全业务链管理平台:赋能企业信息化升级 一站式低代码商业支撑平台:赋能企业数字化升级 需求变化 关注单一企业的管理、流程、效率的提升 关注企业价值链的网络竞争,围绕外部协同、运营、数据、商业展开 技术更替 关注稳定、安全、功能丰富度 除了稳定、安全、功能丰富度以外,更强调需求响应速度、用户体验、系统承载极限与弹性扩展、智能化 表1-1 Oinone与对标公司Odoo的对比 二、与国内低代码或无代码公司对比 低代码或无代码公司 Oinone 定位 低代码开发工具:提供各类系统模版,基于模版快速搭建和个性化配置。但系统模版无法再升级 平台型SaaS:提供各类系统产品,产品安装后客户可以根据需求进行个性化调整,同时产品永远在线可升级 场景差异 只能支持企业内部人员使用,以完成部门级边缘系统为主,一般多为没有专业软件厂商支撑和强临时性特性 从内外部协同的商业场景出发,关注企业核心业务场景,适应【企业业务在线化后,所有的业务变化与创新都需要通过系统来触达上下游】的时代背景,以敏捷响应业务的变化与创新为目标 技术代差 单表支撑100万数据已是业内天花板 支撑单模型数据过亿,无单点瓶颈。封装互联网架构并且做到单体与分布式的灵活部署,为不同大小公司提供不同技术支撑 表1-2 Oinone与国内低代码/无代码公司对比 1.4.2 从技术角度对比 我们不会与其他无代码平台进行比较,因为它们不能解决业务复杂性的问题。相反,我们将重点介绍三种不同的低代码平台模式(如下图1-8所示)。 第一种模式是最基础的低代码平台,也被称为代码生成器。它通过预定义应用程序模板和必要的配置生成代码,简化了工程搭建并提供了一些基础逻辑。虽然在信息化时代内部流程标准化方面较为适合,但在数字化时代外部协同业务在线的情况下就不那么合适了。因为这种模式不能减少研发难度和提高效率,也无法体现敏捷迭代快速创新的优势。 第二种模式是经典的低代码平台,以元数据为基础,以模型为驱动。当无法满足需要时,通过特定方式将代码以插件的形式注入平台,作为低代码平台的内置逻辑,供设计器使用。它的优点在于降低了研发门槛,当无法满足需求时才需要编写代码。它可以实现企业内部的复杂流程和复杂逻辑,但其性能和工程管理存在局限性。性能问题使其不适合处理互联网化的在线业务,而工程管理问题则使其不适合处理快速变化的业务。这也是许多研发人员反对低代码的核心原因之一,因为研发人员变成了辅助角色,而软件工程是一门需要技术能力的学科,让没有技术能力的人主导是违反常理的。对于软件产品公司来说,产品需要迭代规划,需要多人协作,需要工程化管理。 第三种模式是oinone提出的基于互联网架构的低代码平台,它采用低无一体的设计。首先,oinone屏蔽了互联网架构带来的复杂性。其次,同样以元数据为基础,以模型为驱动,但是元数据的生成方式有两种:一种是使用无代码设计器(与经典低代码相同),另一种是通过代码来描述元数据。通过使用代码来描述元数据,可以无缝地与代码衔接,并在不改变研发习惯的情况下降低门槛、提高效率,并进行工程化管理。 最后总结来说:低无一体不仅仅是指两种模式的结合,还包括两种模式的融合应用方式。具体来说,这种融合应用方式可以分为两种情况: 当开发核心产品时,主要采用低代码开发,无代码设计器作为辅助。这种方式可以提高开发效率和代码质量,同时保证产品的快速迭代和升级。 当需要满足个性化或非产品支持的需求时,主要采用无代码设计器,低代码作为辅助。这种方式可以快速地满足客户需求,并且避免对产品的核心代码产生影响。 简单来说,低代码模式适用于产品的迭代升级,而无代码设计器则适用于满足个性化和非产品支撑的额外需求。低代码和无代码模式在整个软件生命周期中都有各自的价值,在不同场景下可以相互融合,发挥最大的优势。 图1-8 代码生成器、低代码平台与Oinone的优缺点对比 1.4.3 从产品角度对比 产品上的对比,从客户、场景满足度、再次销售三个方面来做简易的对比 一、Oinone vs 数字化软件服务商 客户 满足度 销售 Oinone 一站式商业智能软件,更高性价比、用户体验客户范围:5000万~5亿、5亿~100亿、标杆:100亿~1000亿、1000亿以上 满足企业核心业务需求,并联合伙伴一起满足企业所有需求,无需集成提供统一工作台、数据接口、底层协议,无论基于Oinone的开源框架还是增加其他应用都有很好的扩展性 支持OP+SaaS两种模式,收费方式不同:OP按买断方式进行,SaaS按效果付费跟账号数无关新的模块进行二次销售 数字化软件服务商 针对成熟的大型企业需投入巨大资源和成本客户范围:100亿~1000亿、1000亿以上 满足企业部分需求,无法输出技术标准,无法解决多供应商一起开发的问题,只能通过集成实现对接 OP模式进行销售,通过设置权限来进行来实现二次销售或无法进行二次销售 表1-3 Oinone vs 数字化软件服务商 二、Oinone vs 低代码或无代码行业 客户 满足度 销售 Oinone 一站式商业智能软件客户范围:5000万~5亿、5亿~100亿、标杆:100亿~1000亿、1000亿以上 从外部商业场景出发,强业务场景驱动,符合企业从信息化管理到业务创新的数字化转变的趋势。提供统一工作台、数据接口、底层协议,无论基于oinone的开源框架还是增加其他应用都有很好的扩展性 支持OP+SaaS两种模式,收费方式不同:OP按买断方式进行,SaaS按效果付费跟账号数无关新的模块进行二次销售 低代码或无代码公司 针对小微企业内部信息化管理诉求,以表单流程为主客户范围:5亿以下 满足企业部门级信息化的适应性需求,无法满足企业核心业务管理与业务创新诉求 按应用模块进行收费,新的模块进行二次销售 表1-4 Oinone vs 低代码或无代码行业 三、Oinone vs 国外对标公司Odoo 客户 满足度 销售 Oinone 一站式商业智能软件客户范围:5000万~5亿、5亿~100亿、标杆:100亿~1000亿、1000亿以上 从外部商业场景出发,强业务场景驱动,符合企业从信息化管理到业务创新的数字化转变的趋势。基线产品覆盖:采购、营销、服务、销售、交易等企业商业领域。主要涉及行业:零售品牌。其他领域或行业靠合作伙伴共建方式进行 支持OP+SaaS两种模式,收费方式不同:OP按买断方式进行,SaaS按效果付费跟账号数无关新的模块进行二次销售 Odoo 一站式企业管理软件客户范围:5000万~5亿、5亿~100亿、标杆:100亿~1000亿、1000亿以上 从企业内部管理需求出发,逐渐拥有互联网相关应用组件,但还是属于强内部管理、弱外部场景。基线产品覆盖:业务财务一体化、人财务、进销存。主要涉及行业:建造业。其他领域或行业靠合作伙伴共建方式进行 支持OP+SaaS两种模式,收费方式相同:按用户数+应用模块进行收费新的模块进行二次销售 表1-5 Oinone vs 国外对标公司Odoo

    2024年5月23日
    3.0K20
  • 4.1.24 框架之分库分表

    随着数据库技术的发展如分区设计、分布式数据库等,业务层的分库分表的技术终将成老一辈程序员的回忆,谈笑间扯扯蛋既羡慕又自吹地说到“现在的研发真简单,连分库分表都不需要考虑了”。竟然这样为什么要写这篇文章呢?因为现今的数据库虽能解决大部分场景的数据量问题,但涉及核心业务数据真到过亿数据后性能加速降低,能给的方案都还有一定的局限性,或者说性价比不高。相对性价比比较高的分库分表,也会是现阶段一种不错的补充。言归正传oinone的分库分表方案是基于Sharding-JDBC的整合方案,所以大家得先具备一点Sharding-JDBC的知识。 一、分表(举例) 做分库分表前,大家要有一个明确注意的点就是分表字段的选择,它是非常重要的,与业务场景非常相关。在明确了分库分表字段以后,甚至在功能上都要做一些妥协。比如分库分表字段在查询管理中做为查询条件是必须带上的,不然效率只会更低。 Step1 新建ShardingModel模型 ShardingModel模型是用于分表测试的模型,我们选定userId作为分表字段。分表字段不允许更新,所以这里更新策略设置类永不更新,并在设置了在页面修改的时候为readonly package pro.shushi.pamirs.demo.api.model; import pro.shushi.pamirs.boot.base.ux.annotation.field.UxWidget; import pro.shushi.pamirs.boot.base.ux.annotation.view.UxForm; import pro.shushi.pamirs.meta.annotation.Field; import pro.shushi.pamirs.meta.annotation.Model; import pro.shushi.pamirs.meta.enmu.FieldStrategyEnum; @Model.model(ShardingModel.MODEL_MODEL) @Model(displayName = "分表模型",summary="分表模型",labelFields ={"name"} ) public class ShardingModel extends AbstractDemoIdModel { public static final String MODEL_MODEL="demo.ShardingModel"; @Field(displayName = "名称") private String name; @Field(displayName = "用户id",summary = "分表字段",immutable=true/* 不可修改 **/) @UxForm.FieldWidget(@UxWidget(readonly = "scene == 'redirectUpdatePage'"/* 在编辑页面只读 **/ )) @Field.Advanced(updateStrategy = FieldStrategyEnum.NEVER) private Long userId; } 图4-1-24-1 新建ShardingModel模型 Step2 配置分表策略 配置ShardingModel模型走分库分表的数据源pamirsSharding 为pamirsSharding配置数据源以及sharding规则 a. pamirs.sharding.define用于oinone的数据库表创建用 b. pamirs.sharding.rule用于分表规则配置 pamirs: load: sessionMode: true framework: system: system-ds-key: base system-models: – base.WorkerNode data: default-ds-key: pamirs ds-map: base: base modelDsMap: "[demo.ShardingModel]": pamirsSharding #配置模型对应的库 图4-1-24-2 指定模型对应数据源 pamirs: sharding: define: data-sources: ds: pamirs pamirsSharding: pamirs #申明pamirsSharding库对应的pamirs数据源 models: "[trigger.PamirsSchedule]": tables: 0..13 "[demo.ShardingModel]": tables: 0..7 table-separator: _ rule: pamirsSharding: #配置pamirsSharding库的分库分表规则 actual-ds: – pamirs #申明pamirsSharding库对应的pamirs数据源 sharding-rules: # Configure sharding rule ,以下配置跟sharding-jdbc配置一致 – tables: demo_core_sharding_model: #demo_core_sharding_model表规则配置 actualDataNodes: pamirs.demo_core_sharding_model_${0..7} tableStrategy: standard: shardingColumn: user_id shardingAlgorithmName: table_inline shardingAlgorithms: table_inline: type: INLINE props: algorithm-expression: demo_core_sharding_model_${(Long.valueOf(user_id) % 8)} props: sql.show: true 图4-1-24-3 分库分表规则配置 Step3 配置测试入口 修改DemoMenus类增加一行代码,为测试提供入口 @UxMenu("分表模型")@UxRoute(ShardingModel.MODEL_MODEL) class ShardingModelMenu{} 图4-1-24-4 配置测试入口 Step4 重启看效果 自行尝试增删改查 观察数据库表与数据分布 图4-1-24-5 自行尝试增删改查 图4-1-24-6 观察数据库表与数据分布 二、分库分表(举例) Step1 新建ShardingModel2模型 ShardingModel2模型是用于分库分表测试的模型,我们选定userId作为分表字段。分库分表字段不允许更新,所以这里更新策略设置类永不更新,并在设置了在页面修改的时候为readonly package pro.shushi.pamirs.demo.api.model; import pro.shushi.pamirs.boot.base.ux.annotation.field.UxWidget; import pro.shushi.pamirs.boot.base.ux.annotation.view.UxForm; import…

    2024年5月23日
    1.6K00
  • 5.8 商业支撑之执行域

    一、基础介绍 执行域包括两个核心一是订单的产生,二是订单的履约。往往品牌商既有自营渠道(包括2c、2b)、又有第三方渠道。那么有两种设计思路: 把第三方渠道的订单当作自有渠道的订单产生一种特殊方式,开放订单创建接口,并统一履约。 好处:简单,在3方渠道不多、且自有渠道单一,并且逻辑相识时系统结构会简单 坏处: 当3方渠道的履约方式、库存分配方式、逆向逻辑等有差异时,会让自有渠道参杂很多不相干的逻辑引入不必要的复杂度 自有渠道不够独立和纯粹,自有渠道多样化时难以支撑 把商家自营渠道假设为特殊的第三方渠道,再建立统一的订单管理系统来对接渠道订单,并完成履约 好处:交易与履约逻辑分离,对未来发展有扩展性 坏处:引入一定复杂度 我们采用的是第二套方案,整体结构简易图如下 图5-8-1 方案整体结构简易图 二、模型介绍 图5-8-2 模型介绍 核心设计逻辑 首先我们看到上图交易域和履约域有很多相同父模型的子模型,交易域和履约域的父模型在CDM的在himalaya-trade里。履约域看oms(libra)对himalaya-trade扩展,交易域看b2c(leo)和b2b(aries)对对himalaya-trade扩展。libra、leo、aries是我们对上层业务产品的命名,取自黄道十二星座 交易域是多商家平台视角设计,有自身渠道必要的履约相关信息,完成自闭环。 履约域是从单一商家对接多渠道视角设计,有渠道交易订单同步后完成履约发货相关设计,完成自闭环。 履约域的合单拆单发货设计,渠道订单只能合单为履约单不可拆,履约单可以拆单发货不可合。用m2o和o2m的组合设计来降低难度,而非采用两个m2m的设计。

    2024年5月23日
    1.4K00
  • 4.5.2 研发辅助之SQL优化

    Oinone体系中是不需要针对模型写SQL的,默认提供了通用的数据管理器。在带来便利的情况下,也导致传统的sql审查就没办法开展。但是我们可以以技术的手段收集慢SQL和限制问题SQL执行。 慢SQL搜集目的:去发现非原则性问题的慢SQL,并进行整改 限制问题SQL执行:对应一些不规范的SQL系统上直接做限制,如果有特殊情况手动放开 一、发现慢SQL 这个功能并没有直接加入到oinone的版本中,需要业务自行写插件,插件代码如下。大家可以根据实际情况进行改造比如: 堆栈入口,例子中只是放了pamirs,可以根据实际情况改成业务包路径 对慢SQL的定义是5s还是3s,根据实际情况变 package pro.shushi.pamirs.demo.core.plugin; import org.apache.ibatis.executor.Executor; import org.apache.ibatis.mapping.MappedStatement; import org.apache.ibatis.plugin.*; import org.apache.ibatis.session.ResultHandler; import org.apache.ibatis.session.RowBounds; import org.springframework.stereotype.Component; import pro.shushi.pamirs.meta.annotation.fun.extern.Slf4j; @Intercepts({ @Signature(type = Executor.class,method = "query",args = {MappedStatement.class,Object.class, RowBounds.class, ResultHandler.class}) }) @Component @Slf4j public class SlowSQLAnalysisInterceptor implements Interceptor { @Override public Object intercept(Invocation invocation) throws Throwable { long start = System.currentTimeMillis(); Object result = invocation.proceed(); long end = System.currentTimeMillis(); if (end – start > 10000) {//大于10秒 try { StackTraceElement[] stackTraceElements = Thread.currentThread().getStackTrace(); StringBuffer slowLog = new StringBuffer(); slowLog.append(System.lineSeparator()); for (StackTraceElement element : stackTraceElements) { if (element.getClassName().indexOf("pamirs") > 0) { slowLog.append(element.getClassName()).append(":").append(element.getMethodName()).append(":").append(element.getLineNumber()).append(System.lineSeparator()); } } Object parameter = null; if (invocation.getArgs().length > 1) { parameter = invocation.getArgs()[1]; } MappedStatement mappedStatement = (MappedStatement) invocation.getArgs()[0]; BoundSql boundSql = mappedStatement.getBoundSql(parameter); Configuration configuration = mappedStatement.getConfiguration(); String originalSql = showSql(configuration, boundSql); originalSql = originalSql.replaceAll("\'", "").replace("\"", ""); log.warn("检测到的慢SQL为:" + originalSql); log.warn("业务慢SQL入口为:" + slowLog.toString()); } catch (Throwable e1) { //忽略 } } return result; } public String showSql(Configuration configuration, BoundSql boundSql) { Object parameterObject = boundSql.getParameterObject(); List<ParameterMapping> parameterMappings = boundSql.getParameterMappings(); String sql = boundSql.getSql().replaceAll("[\\s]+", " "); if (parameterMappings.size() > 0 && parameterObject != null) { TypeHandlerRegistry typeHandlerRegistry…

    Oinone 7天入门到精通 2024年5月23日
    2.1K00

Leave a Reply

Please Login to Comment