如何使用GQL工具正确发起请求

简介

本文将讲解一下如何正确发起GQL请求和GQL工具使用过程中的常见问题。

参数介绍

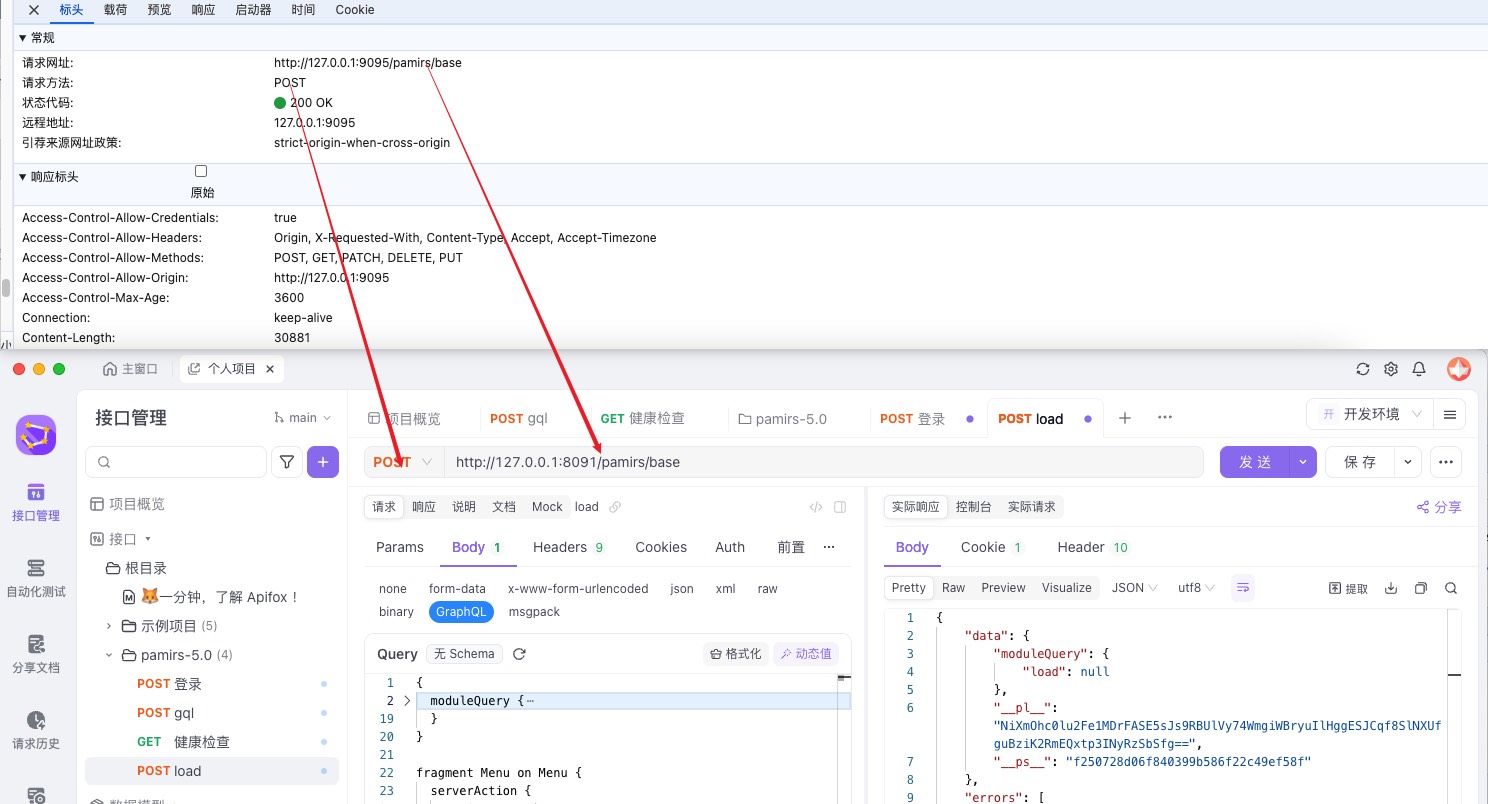
请求url和请求方法在浏览器的请求标头里面可以查到,保持一致就可以向服务正常发送请求,但还缺少请求体确定请求哪个接口。

如何使用GQL工具正确发起请求

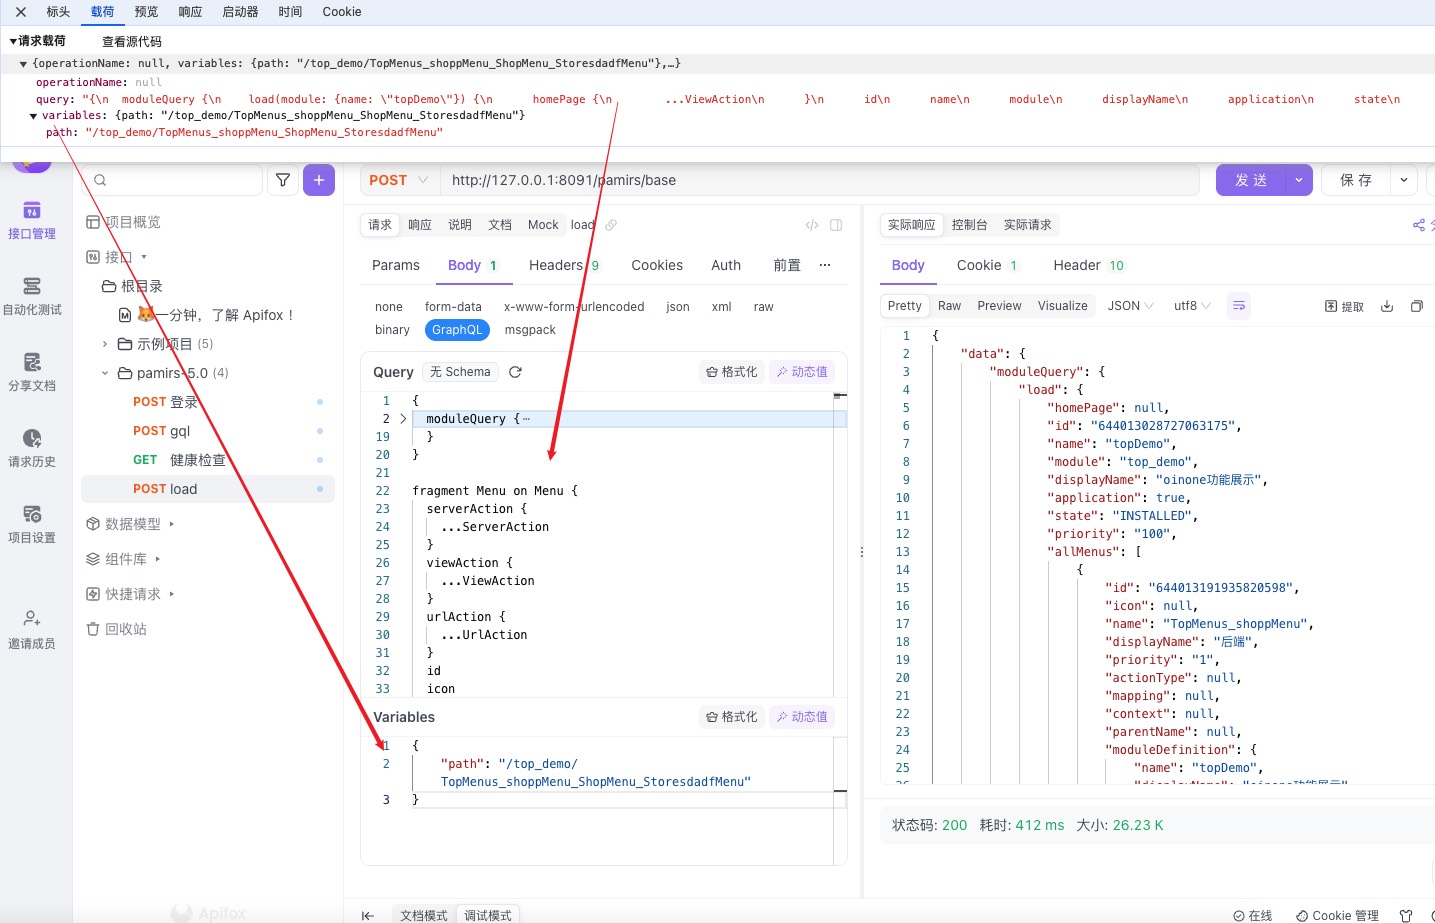
每个请求都包括两部分内容:1. Query 2. Variables
右键Query和Variables复制值直接拷贝到工具中就可以正常请求了。

如何使用GQL工具正确发起请求

注意:如果使用admin账号登录,请求的时候可以不携带Variables参数,因为admin没有权限控制,如果使用其他用户,就必须携带Variables参数,否则会被权限拦截。

Oinone社区 作者:yexiu原创文章,如若转载,请注明出处:https://doc.oinone.top/kai-fa-shi-jian/18579.html

访问Oinone官网:https://www.oinone.top获取数式Oinone低代码应用平台体验

Like (0)
yexiu's avataryexiu数式员工
Previous 2024年10月25日 am11:13
Next 2024年10月25日 pm6:00

相关推荐

  • 函数之触发与定时配置和示例

    异步任务总体介绍 函数的触发和定时在很多场景中会用到,也是一个oinone的基础能力。比如我们的流程产品中在定义流程触发时就会让用户选择模型触发还是时间触发,就是用到了函数的触发与定时能力。 触发任务TriggerTaskAction 触发任务的创建,使用sql-record模块监听mysql的binlog事件,通过rocketmq发送变更数据消息,收到MQ消息后,创建TriggerAutoTask。 触发任务的执行,使用TBSchedule拉取触发任务后,执行相应函数。 项目中引入依赖 1、项目的API工程引入依赖pamirs-core-trigger模块 <dependency> <groupId>pro.shushi.pamirs.core</groupId> <artifactId>pamirs-trigger-api</artifactId> </dependency> 2、DemoModule在模块依赖定义中增加@Module(dependencies={TriggerModule.MODULE_MODULE}) @Component @Module( name = DemoModule.MODULE_NAME, displayName = "oinoneDemo工程", version = "1.0.0", dependencies = {ModuleConstants.MODULE_BASE, CommonModule.MODULE_MODULE, UserModule.MODULE_MODULE, TriggerModule.MODULE_MODULE} ) @Module.module(DemoModule.MODULE_MODULE) @Module.Advanced(selfBuilt = true, application = true) @UxHomepage(PetShopProxy.MODEL_MODEL) public class DemoModule implements PamirsModule { ……其他代码 } 3、项目的boot工程引入依赖 <dependency> <groupId>pro.shushi.pamirs.core</groupId> <artifactId>pamirs-trigger-core</artifactId> </dependency> <dependency> <groupId>pro.shushi.pamirs.core</groupId> <artifactId>pamirs-trigger-bridge-tbschedule</artifactId> </dependency> <dependency> <groupId>pro.shushi.pamirs.core</groupId> <artifactId>pamirs-sql-record-core</artifactId> </dependency> yml文件修改(applcation-xxx.yml) a. 修改pamris.event.enabled和pamris.event.schedule.enabled为trueb. pamirs_boot_modules增加启动模块:trigger、sql_record pamirs: record: sql: #改成自己路径 store: /opt/pamirs/logs … event: enabled: true schedule: enabled: true rocket-mq: namesrv-addr: 127.0.0.1:9876 boot: init: true sync: true modules: – base -…… – trigger – sql_record -…… 新建触发任务 新建PetTalentTrigger类,当PetTalent模型的数据记录被新建时触发系统做一些事情 package pro.shushi.pamirs.demo.core.trigger; import pro.shushi.pamirs.demo.api.model.PetTalent; import pro.shushi.pamirs.meta.annotation.Fun; import pro.shushi.pamirs.meta.annotation.Function; import pro.shushi.pamirs.meta.annotation.fun.extern.Slf4j; import pro.shushi.pamirs.trigger.annotation.Trigger; import pro.shushi.pamirs.trigger.enmu.TriggerConditionEnum; @Fun(PetTalent.MODEL_MODEL) @Slf4j public class PetTalentTrigger { @Function @Trigger(displayName = “PetTalent创建时触发”,name = “PetTalent#Trigger#onCreate”,condition = TriggerConditionEnum.ON_CREATE) public PetTalent onCreate(PetTalent data){ log.info(data.getName() + “,被创建”); //可以增加逻辑 return data; } } 定时任务 定时任务是一种非常常见的模式,这里就不介绍概念了,直接进入示例环节 新建PetTalentAutoTask实现ScheduleAction getInterfaceName()需要跟taskAction.setExecuteNamespace定义保持一致,都是函数的命名空间 taskAction.setExecuteFun("execute");跟执行函数名“execute”一致 TaskType需配置为CYCLE_SCHEDULE_NO_TRANSACTION_TASK,把定时任务的schedule线程分开,要不然有一个时间长的任务会导致普通异步或触发任务全部延时。 package pro.shushi.pamirs.demo.core.task; import org.springframework.beans.factory.annotation.Autowired; import org.springframework.stereotype.Component; import pro.shushi.pamirs.core.common.enmu.TimeUnitEnum; import pro.shushi.pamirs.demo.api.model.PetTalent; import pro.shushi.pamirs.meta.annotation.Fun; import pro.shushi.pamirs.meta.annotation.Function; import pro.shushi.pamirs.meta.annotation.fun.extern.Slf4j; import pro.shushi.pamirs.meta.domain.fun.FunctionDefinition; import pro.shushi.pamirs.middleware.schedule.api.ScheduleAction; import pro.shushi.pamirs.middleware.schedule.common.Result; import pro.shushi.pamirs.middleware.schedule.domain.ScheduleItem; import pro.shushi.pamirs.middleware.schedule.eunmeration.TaskType; import pro.shushi.pamirs.trigger.enmu.TriggerTimeAnchorEnum; import pro.shushi.pamirs.trigger.model.ScheduleTaskAction; import pro.shushi.pamirs.trigger.service.ScheduleTaskActionService; @Slf4j @Component @Fun(PetTalent.MODEL_MODEL) public class PetTalentAutoTask implements…

    2024年5月25日
    1.8K00
  • 问题排查调试工具使用手册

    当前端发起对应用的访问时,如果出现错误,那么我们可以通过以下方式进行简易排查,如果排查不出来,则也可以把排查工具给出的信息发送给Oinone官方售后进行进一步分析。本文将通过模拟异常信息,来介绍排查工具,提供了哪些辅助信息帮我们来快速定位问题。 排查工具基础介绍 通过前端页面的 /debug 路由路径访问调试工具的页面,假设我们的前端页面访问地址为http://localhost:6800,那么我们的排查工具请求路径就是 http://localhost:6800/debug排查工具可以帮我们排查前端页面元数据异常和后端接口的异常 排查前端页面元数据 将问题页面浏览器地址栏内 page 后的部分复制到调试工具的 debug 路由后重新发起请求,如图可以看到调试工具展示的信息,可以根据这些信息排查问题。 排查后端接口 后端接口出现问题后,打开(在原页面)浏览器的调试工具,切换到“网络”的标签页,在左侧的历史请求列表中找到需要调试的请求,右键会弹出菜单,点击菜单中的 “复制”,再次展开该菜单,点击二级菜单中的“以 fetch 格式复制”,这样可以复制到调试所需要的信息 2.复制调试信息到“接口调试”标签页内的文本框内,点击“发起请求”按钮获取调试结果 我们可以看到页面展示了该接口的各种调试信息,我们可以据此排查问题。 场景化的排查思路 业务代码中存在代码bug 报错后发起调试请求,我们可以看到,调试工具直接给出了异常抛出的具体代码所在位置,此时再切换到“全部堆栈”下,可以看到是业务类的233行导致的空指针异常,查看代码后分析可得是data.getName().eqauls方法在调用前未做条件判断补全该判断后代码可以正常执行 业务代码中没有直接的错误,异常在平台代码中抛出 报错后发起调试请求可以看到异常不在业务代码内再切换到“全部堆栈”,可以看到具体异常信息,提示core_demo_item表出现了重复的主键,该表是DemoItem模型的我们还可以切换到“sql调试”的标签页,可以看到出错的具体sql语句经过分析可以得知是240行的data.create()�重复创建数据导致的。 三、排查工具无法定位怎么办 当我们通过排查工具还是没有定位到问题的时候,可以通过调试页面的“下载全部调试数据”和“下载调试数据”按钮将调试信息的数据发送给官方售后人员帮助我们定位排查问题。 点击页面最顶部的“下载全部调试数据”按钮,可以下载页面调试数据和接口调试数据点击“调试接口”标签页内的“下载调试数据”按钮,可以下载接口调试数据 四、排查工具细节

    2024年5月21日
    3.2K00
  • Oinone环境保护(v5.2.3以上)

    概述 Oinone平台为合作伙伴提供了环境保护功能,以确保在一套环境可以在较为安全前提下修改配置文件,启动多个JVM等部署操作。 本章内容主要介绍与环境保护功能相关的启动参数。 名词解释 本地开发环境:开发人员在本地启动业务工程的环境 公共环境:包含设计器镜像和业务工程的环境 环境保护参数介绍 【注意】参数是加在程序实参 (Program arguments)上,通常可能错误的加在Active Profiles上了 -PenvProtected=${value} 是否启用环境保护,默认为true。 环境保护是通过与最近一次保存在数据库的base_platform_environment表中数据进行比对,并根据每个参数的配置特性进行判断,在启动时将有错误的内容打印在启动日志中,以便于开发者进行问题排查。 除此之外,环境保护功能还提供了一些生产配置的优化建议,开发者可以在启动时关注这些日志,从而对生产环境的配置进行调优。 -PsaveEnvironments=${value} 是否将此次启动的环境参数保存到数据库,默认为true。 在某些特殊情况下,为了避免公共环境中的保护参数发生不必要的变化,我们可以选择不保存此次启动时的配置参数到数据库中,这样就不会影响其他JVM启动时发生校验失败而无法启动的问题。 -PstrictProtected=${value} 是否使用严格校验模式,默认为false 通常我们建议在公共环境启用严格校验模式,这样可以最大程度的保护公共环境的元数据不受其他环境干扰。 PS:在启用严格校验模式时,需避免内外网使用不同连接地址的场景。如无法避免,则无法启用严格校验模式。 常见问题 需要迁移数据库,并更换了数据库连接地址该如何操作? 将原有数据库迁移到新数据库。 修改配置文件中数据库的连接地址。 在启动脚本中增加-PenvProtected=false关闭环境保护。 启动JVM服务可以看到有错误的日志提示,但不会中断本次启动。 移除启动脚本中的-PenvProtected=false或将值改为true,下次启动时将继续进行环境保护检查。 可查看数据库中base_platform_environment表中对应数据库连接配置已发生修改,此时若其他JVM在启动前未正确修改,则无法启动。 本地开发时需要修改Redis连接地址到本地,但希望不影响公共环境的使用该如何操作? PS:由于Redis中的元数据缓存是根据数据库差量进行同步的,此操作会导致公共环境在启动时无法正确刷新Redis中的元数据缓存,需要配合pamirs.distribution.session.allMetaRefresh参数进行操作。如无特殊必要,我们不建议使用该形式进行协同开发,多次修改配置会导致出错的概率增加。 本地环境首次启动时,除了修改Redis相关配置外,还需要配置pamirs.distribution.session.allMetaRefresh=true,将本地新连接的Redis进行初始化。 在本地启动时,增加-PenvProtected=false -PsaveEnvironments=false启动参数,以确保本地启动不会修改公共环境的配置,并且可以正常通过环境保护检测。 本地环境成功启动并正常开发功能后,需要发布到公共环境进行测试时,需要先修改公共环境中业务工程配置pamirs.distribution.session.allMetaRefresh=true后,再启动业务工程。 启动一次业务工程后,将配置还原为pamirs.distribution.session.allMetaRefresh=false。

    2024年10月21日
    2.3K00
  • DsHint(指定数据源)和BatchSizeHint(指定批次数量)

    概述和使用场景 DsHintApi ,强制指定数据源, BatchSizeHintApi ,强制指定查询批量数量 API定义 DsHintApi public static DsHintApi model(String model/**模型编码*/) { // 具体实现 } public DsHintApi(Object dsKey/***数据源名称*/) { // 具体实现 } BatchSizeHintApi public static BatchSizeHintApi use(Integer batchSize) { // 具体实现 } 使用示例 1、【注意】代码中使用 try-with-resources语法; 否则可能会出现数据源错乱 2、DsHintApi使用示例包裹在try里面的所有查询都会强制使用指定的数据源 // 使用方式1: try (DsHintApi dsHintApi = DsHintApi.model(PetItem.MODEL_MODEL)) { List<PetItem> items = demoItemDAO.customSqlDemoItem(); PetShopProxy data2 = data.queryById(); data2.fieldQuery(PetShopProxy::getPetTalents); } // 使用方式2: try (DsHintApi dsHintApi = DsHintApi.use("数据源名称")) { List<PetItem> items = demoItemDAO.customSqlDemoItem(); PetShopProxy data2 = data.queryById(); data2.fieldQuery(PetShopProxy::getPetTalents); } 3、BatchSizeHintApi使用示例包裹在try里面的所有查询都会按照指定的batchSize进行查询 // 查询指定每次查询500跳 try (BatchSizeHintApi batchSizeHintApi = BatchSizeHintApi.use(500)) { PetShopProxy data2 = data.queryById(); data2.fieldQuery(PetShopProxy::getPetTalents); } // 查询指定不分页(batchSize=-1)查询。 请注意,你必须在明确不需要分页查询的情况下使用;如果数据量超大不分页可能会卡死。默认不指定分页数的情况下下平台会进行分页查询 try (BatchSizeHintApi batchSizeHintApi = BatchSizeHintApi.use(-1)) { PetShopProxy data2 = data.queryById(); data2.fieldQuery(PetShopProxy::getPetTalents); }

    2024年5月18日
    2.2K00
  • Oinone如何支持构建分布式项目

    分布式调用下的[强制]约束 1、[强制]分布式调用情况下base库和redis需共用;2、[强制]如果环境有设计器,设计器的base库和redis保持一致也需与项目中的保持一致;3、[强制]相同base库下,不同应用的相同模块的数据源需保持一致;4、[强制]项目中需引入分布式缓存包。参考下文的分布式包依赖 分布式支持 1、分布式包依赖 1) 父pom的依赖管理中先加入pamirs-distribution的依赖 <dependency> <groupId>pro.shushi.pamirs</groupId> <artifactId>pamirs-distribution</artifactId> <version>${pamirs.distribution.version}</version> <type>pom</type> <scope>import</scope> </dependency> 2) 启动的boot工程中增加pamirs-distribution相关包 <!– 分布式服务发布 –> <dependency> <groupId>pro.shushi.pamirs.distribution</groupId> <artifactId>pamirs-distribution-faas</artifactId> </dependency> <!– 分布式元数据缓存 –> <dependency> <groupId>pro.shushi.pamirs.distribution</groupId> <artifactId>pamirs-distribution-session</artifactId> </dependency> <dependency> <groupId>pro.shushi.pamirs.distribution</groupId> <artifactId>pamirs-distribution-gateway</artifactId> </dependency> 3)启动工程的Application中增加类注解@EnableDubbo @EnableDubbo public class XXXStdApplication { public static void main(String[] args) throws IOException { StopWatch stopWatch = new StopWatch(); stopWatch.start(); // ……………………………… log.info("XXXX Application loading…"); } } 2、修改bootstrap.yml文件 注意序列化方式:serialization: pamirs 以下只是一个示例(zk为注册中心),注册中心支持zk和Nacos;Nacos作为注册中心参考:https://doc.oinone.top/kai-fa-shi-jian/5835.html spring: profiles: active: dev application: name: pamirs-demo cloud: service-registry: auto-registration: enabled: false pamirs: default: environment-check: true tenant-check: true — spring: profiles: dev cloud: service-registry: auto-registration: enabled: false config: enabled: false uri: http://127.0.0.1:7001 label: master profile: dev nacos: server-addr: http://127.0.0.1:8848 discovery: enabled: false namespace: prefix: application file-extension: yml config: enabled: false namespace: prefix: application file-extension: yml dubbo: application: name: pamirs-demo version: 1.0.0 registry: address: zookeeper://127.0.0.1:2181 protocol: name: dubbo port: -1 serialization: pamirs scan: base-packages: pro.shushi cloud: subscribed-services: metadata-report: disabled: true 3、模块启动的最⼩集 pamirs: boot: init: true sync: true modules: – base – sequence – 业务工程的Module 4、业务模型间的依赖关系 服务调用方(即Client端),在启动yml中modules不安装服务提供方的Module 服务调用方(即Client端),项目的pom中只依赖服务提供方的API(即模型和API的定义) 服务调用方(即Client端),项目模块定义(即模型Module定义),dependencies中增加服务提供方的Modeule. 如下面示例代码中的FileModule @Module( name = DemoModule.MODULE_NAME, displayName = "oinoneDemo工程", version = "1.0.0", dependencies = {ModuleConstants.MODULE_BASE, CommonModule.MODULE_MODULE, FileModule.MODULE_MODULE, SecondModule.MODULE_MODULE/**服务提供方的模块定义*/ } )…

    2024年2月20日
    1.5K00

Leave a Reply

Please Login to Comment