
函数之触发与定时配置和示例

异步任务总体介绍

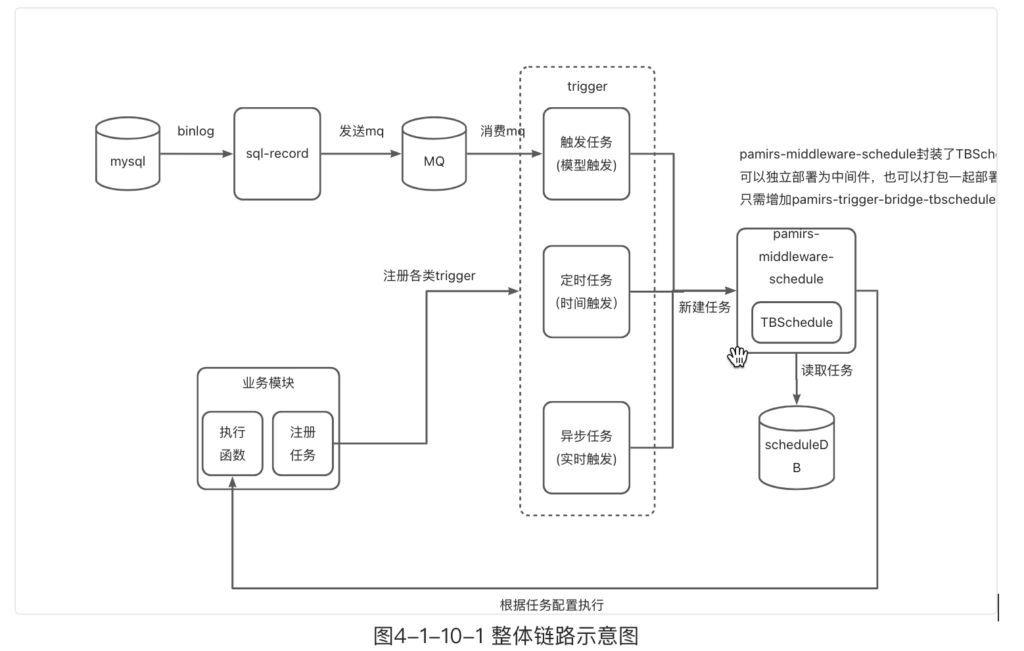
函数的触发和定时在很多场景中会用到,也是一个oinone的基础能力。比如我们的流程产品中在定义流程触发时就会让用户选择模型触发还是时间触发,就是用到了函数的触发与定时能力。
函数之触发与定时配置和示例

触发任务TriggerTaskAction

  • 触发任务的创建,使用sql-record模块监听mysql的binlog事件,通过rocketmq发送变更数据消息,收到MQ消息后,创建TriggerAutoTask。
  • 触发任务的执行,使用TBSchedule拉取触发任务后,执行相应函数。

项目中引入依赖

1、项目的API工程引入依赖pamirs-core-trigger模块

<dependency>
        <groupId>pro.shushi.pamirs.core</groupId>
        <artifactId>pamirs-trigger-api</artifactId>
</dependency>

2、DemoModule在模块依赖定义中增加@Module(dependencies={TriggerModule.MODULE_MODULE})

@Component
@Module(
        name = DemoModule.MODULE_NAME,
        displayName = "oinoneDemo工程",
        version = "1.0.0",
        dependencies = {ModuleConstants.MODULE_BASE, CommonModule.MODULE_MODULE, UserModule.MODULE_MODULE, TriggerModule.MODULE_MODULE}
)
@Module.module(DemoModule.MODULE_MODULE)
@Module.Advanced(selfBuilt = true, application = true)
@UxHomepage(PetShopProxy.MODEL_MODEL)
public class DemoModule implements PamirsModule {
    ……其他代码
}

3、项目的boot工程引入依赖

<dependency>
        <groupId>pro.shushi.pamirs.core</groupId>
        <artifactId>pamirs-trigger-core</artifactId>
</dependency>
<dependency>
        <groupId>pro.shushi.pamirs.core</groupId>
        <artifactId>pamirs-trigger-bridge-tbschedule</artifactId>
</dependency>
<dependency>
    <groupId>pro.shushi.pamirs.core</groupId>
    <artifactId>pamirs-sql-record-core</artifactId>
</dependency>

yml文件修改(applcation-xxx.yml)

a. 修改pamris.event.enabled和pamris.event.schedule.enabled为true
b. pamirs_boot_modules增加启动模块:trigger、sql_record

pamirs:
  record:
    sql:
      #改成自己路径
      store: /opt/pamirs/logs
  ...
  event:
    enabled: true
    schedule:
      enabled: true
    rocket-mq:
      namesrv-addr: 127.0.0.1:9876
  boot:
    init: true
    sync: true
    modules:
      - base
      -……
      - trigger
      - sql_record
      -……

新建触发任务

新建PetTalentTrigger类,当PetTalent模型的数据记录被新建时触发系统做一些事情

  package pro.shushi.pamirs.demo.core.trigger;

import pro.shushi.pamirs.demo.api.model.PetTalent;
import pro.shushi.pamirs.meta.annotation.Fun;
import pro.shushi.pamirs.meta.annotation.Function;
import pro.shushi.pamirs.meta.annotation.fun.extern.Slf4j;
import pro.shushi.pamirs.trigger.annotation.Trigger;
import pro.shushi.pamirs.trigger.enmu.TriggerConditionEnum;

@Fun(PetTalent.MODEL_MODEL)
@Slf4j
public class PetTalentTrigger {
    @Function
    @Trigger(displayName = "PetTalent创建时触发",name = "PetTalent#Trigger#onCreate",condition = TriggerConditionEnum.ON_CREATE)
    public PetTalent onCreate(PetTalent data){
        log.info(data.getName() + ",被创建");
        //可以增加逻辑
        return data;
    }
}

定时任务

定时任务是一种非常常见的模式,这里就不介绍概念了,直接进入示例环节

新建PetTalentAutoTask实现ScheduleAction

  1. getInterfaceName()需要跟taskAction.setExecuteNamespace定义保持一致,都是函数的命名空间
  2. taskAction.setExecuteFun("execute");跟执行函数名“execute”一致
  3. TaskType需配置为CYCLE_SCHEDULE_NO_TRANSACTION_TASK,把定时任务的schedule线程分开,要不然有一个时间长的任务会导致普通异步或触发任务全部延时。
 package pro.shushi.pamirs.demo.core.task;

import org.springframework.beans.factory.annotation.Autowired;
import org.springframework.stereotype.Component;
import pro.shushi.pamirs.core.common.enmu.TimeUnitEnum;
import pro.shushi.pamirs.demo.api.model.PetTalent;
import pro.shushi.pamirs.meta.annotation.Fun;
import pro.shushi.pamirs.meta.annotation.Function;
import pro.shushi.pamirs.meta.annotation.fun.extern.Slf4j;
import pro.shushi.pamirs.meta.domain.fun.FunctionDefinition;
import pro.shushi.pamirs.middleware.schedule.api.ScheduleAction;
import pro.shushi.pamirs.middleware.schedule.common.Result;
import pro.shushi.pamirs.middleware.schedule.domain.ScheduleItem;
import pro.shushi.pamirs.middleware.schedule.eunmeration.TaskType;
import pro.shushi.pamirs.trigger.enmu.TriggerTimeAnchorEnum;
import pro.shushi.pamirs.trigger.model.ScheduleTaskAction;
import pro.shushi.pamirs.trigger.service.ScheduleTaskActionService;

@Slf4j
@Component
@Fun(PetTalent.MODEL_MODEL)
public class PetTalentAutoTask implements ScheduleAction {

    @Autowired
    private ScheduleTaskActionService scheduleTaskActionService;

    public void initTask(){
        ScheduleTaskAction taskAction = new ScheduleTaskAction();
        taskAction.setDisplayName("定时任务测试"); //定时任务描述
        taskAction.setDescription("定时任务测试");
        taskAction.setTechnicalName(PetTalent.MODEL_MODEL+"#"+PetTalentAutoTask.class.getSimpleName()+"#"+"testAutoTask");       //设置定时任务技术名
        taskAction.setLimitExecuteNumber(-1);   //设置执行次数
        taskAction.setPeriodTimeValue(1);       //设置执行周期规则
        taskAction.setPeriodTimeUnit(TimeUnitEnum.MINUTE);
        taskAction.setPeriodTimeAnchor(TriggerTimeAnchorEnum.START);
        taskAction.setLimitRetryNumber(1);      //设置失败重试规则
        taskAction.setNextRetryTimeValue(1);
        taskAction.setNextRetryTimeUnit(TimeUnitEnum.MINUTE);
        taskAction.setExecuteNamespace(PetTalent.MODEL_MODEL);
        taskAction.setExecuteFun("execute");
        taskAction.setExecuteFunction(new FunctionDefinition().setTimeout(5000));
        taskAction.setTaskType(TaskType.CYCLE_SCHEDULE_NO_TRANSACTION_TASK.getValue()); //设置定时任务,执行任务类型
        taskAction.setContext(null);            //用户传递上下文参数
        taskAction.setActive(true);             //定时任务是否生效
        taskAction.setFirstExecuteTime(System.currentTimeMillis());
        scheduleTaskActionService.submit(taskAction);//初始化任务,幂等可重复执行
    }

    @Override
    public String getInterfaceName() {return PetTalent.MODEL_MODEL;}

    @Override
    @Function
    public Result execute(ScheduleItem item) {
        log.info("testAutoTask,上次执行时间"+item.getLastExecuteTime());
        return new Result<>();
    }
}

修改DemoModuleBizInit,进行定时任务初始化

模块更新的时候调用 petTalentAutoTask.initTask(),initTask本身是幂等的所以多掉几次没有关系。在【模块之生命周期】一文介绍过InstallDataInit、UpgradeDataInit、ReloadDataInit

```java
package pro.shushi.pamirs.demo.core.init;

import org.springframework.beans.factory.annotation.Autowired;
import org.springframework.stereotype.Component;
import pro.shushi.pamirs.boot.common.api.command.AppLifecycleCommand;
import pro.shushi.pamirs.boot.common.api.init.InstallDataInit;
import pro.shushi.pamirs.boot.common.api.init.ReloadDataInit;
import pro.shushi.pamirs.boot.common.api.init.UpgradeDataInit;
import pro.shushi.pamirs.demo.api.DemoModule;
import pro.shushi.pamirs.demo.api.enumeration.DemoExpEnumerate;
import pro.shushi.pamirs.demo.core.task.PetTalentAutoTask;
import pro.shushi.pamirs.meta.common.exception.PamirsException;

import java.util.Collections;
import java.util.List;

@Component
public class DemoModuleBizInit implements InstallDataInit,
    UpgradeDataInit, ReloadDataInit {

    @Autowired
    private PetTalentAutoTask petTalentAutoTask;

    @Override
    public boolean init(AppLifecycleCommand command, String version) {
        //安装指令执行逻辑
        initTask();
        return Boolean.TRUE;
    }

    @Override
    public boolean reload(AppLifecycleCommand command, String version) {
        //重启指令执行逻辑
        initTask();
        return Boolean.TRUE;
    }

    @Override
    public boolean upgrade(AppLifecycleCommand command, String version, String existVersion) {
        //升级指令执行逻辑
        initTask();
        return Boolean.TRUE;
    }

    @Override
    public List<String> modules() {
        return Collections.singletonList(DemoModule.MODULE_MODULE);
    }

    @Override
    public int priority() {return 0;}

    private void initTask() {
        petTalentAutoTask.initTask(); //初始化petTalent的定时任务
    }
}

Oinone社区 作者:望闲原创文章,如若转载,请注明出处:https://doc.oinone.top/backend/11475.html

访问Oinone官网:https://www.oinone.top获取数式Oinone低代码应用平台体验

Like (0)
望闲's avatar望闲数式管理员
Previous 2024年5月25日 pm7:50
Next 2024年5月25日 pm8:53

相关推荐

  • 项目中排除掉特定的Hook和扩展点

    总体介绍 在共库共Redis的情况下,某些场景存在需要过滤掉特定Hook和扩展点(extpoint)的情况。本文介绍排除掉的配置方法 1. Oinone如何排除特定的Hook 配置: pamirs: framework: hook: excludes: – 排除的扩展点列表 示例: pamirs: framework: hook: excludes: – pro.shushi.pamirs.timezone.hook.TimezoneHookBefore – pro.shushi.pamirs.timezone.hook.TimezoneHookAfter – pro.shushi.pamirs.timezone.hook.TimezoneSessionInitHook – pro.shushi.pamirs.translate.hook.TranslateAfterHook 2. Oinone如何排除特定的扩展点 配置 pamirs: framework: extpoint: excludes: – 排除的扩展点列表 示例: pamirs: framework: extpoint: excludes: – pro.shushi.pamirs.demo.core.extpoint.PetCatTypeExtPoint

    2024年5月13日
    2.1K00
  • 平台配置日志输出和推送到APM与LogStash

    场景描述 目前设计器镜像启动后日志文件为out.log,是启动脚本中定向输出了(>>)out.log文件。实际项目可能: 日志输出到特定目录的特定文件名中 指定以日志保留策略(单个文件大小和文件保留个数) 日志输出到APM工具中(如skywalking) 日志推送到LogStash 日志自定义输出 不定向输出,采用自己配置的方式,与标准的SpringBoot工程配置日志一样。两种方式(都是Spring提供的方式): 方式一 bootstrap.yml 里面可以按profiles指定logback的配置文件,具体文件名和文件输入在logback里面进行配置,跟通用的logback配置一致. 例如: logging: config: classpath:logback-pre.xml 方式二 resources的根目录,直接配置 logback-spring.xml, 启动会自动加载。 日志自定义场景 配置日志推送到LogStash <!–配置日志推送到LogStash–> <contextListener class="pro.shushi.pamirs.demo.core.config.DemoLogbackFiledConfig"/> <appender name="LogStash" class="net.logstash.logback.appender.LogstashTcpSocketAppender"> <destination>127.0.0.1:4560</destination> <!– encoder必须配置,有多种可选 –> <encoder charset="UTF-8" class="net.logstash.logback.encoder.LogstashEncoder"> <!– SkyWalking插件, log加tid–> <provider class="org.apache.skywalking.apm.toolkit.log.logback.v1.x.logstash.TraceIdJsonProvider" /> <!–在生成的json中会加这些字段–> <customFields> {"app.name":"pamirs-demo", "app.type":"Microservice", "platform":"pamirs", "env":"dev"} </customFields> <timeZone>Asia/Shanghai</timeZone> <writeVersionAsInteger>true</writeVersionAsInteger> <providers> <pattern> <pattern> <!–动态的变量–> { "ip": "%{ip}", "server.name": "%{server.name}", "logger_name": "%logger" } </pattern> </pattern> </providers> </encoder> </appender> skywalking的日志rpc上传 <!– skywalking的日志rpc上传 –> <appender name="SkyWalkingLogs" class="org.apache.skywalking.apm.toolkit.log.logback.v1.x.log.GRPCLogClientAppender"> <encoder class="ch.qos.logback.core.encoder.LayoutWrappingEncoder"> <layout class="org.apache.skywalking.apm.toolkit.log.logback.v1.x.mdc.TraceIdMDCPatternLogbackLayout"> <Pattern>${CONSOLE_LOG_PATTERN}</Pattern> </layout> </encoder> </appender> 完整的代码示例 Logback自定义字段 package pro.shushi.pamirs.demo.core.config; import ch.qos.logback.classic.Level; import ch.qos.logback.classic.Logger; import ch.qos.logback.classic.LoggerContext; import ch.qos.logback.classic.spi.LoggerContextListener; import ch.qos.logback.core.Context; import ch.qos.logback.core.spi.ContextAwareBase; import ch.qos.logback.core.spi.LifeCycle; import java.net.InetAddress; import java.net.UnknownHostException; /** * Logback自定义字段 * * @author wx@shushi.pro * @date 2024/4/17 */ public class DemoLogbackFiledConfig extends ContextAwareBase implements LoggerContextListener, LifeCycle { private boolean started = false; @Override public boolean isResetResistant() { return false; } @Override public void onStart(LoggerContext loggerContext) { } @Override public void onReset(LoggerContext loggerContext) { } @Override public void onStop(LoggerContext loggerContext) { } @Override public void onLevelChange(Logger logger, Level level) { } @Override public void start() { if (started) { return; } Context context = getContext();…

    2024年5月18日
    2.0K00
  • Oinone离线部署设计器镜像

    概述 Oinone平台为合作伙伴提供了多种部署方式,这篇文章将介绍如何在私有云环境部署Oinone平台Docker镜像。 本文以5.2.20.1版本为例进行介绍,使用amd64架构的体验镜像进行部署。具体版本号以数式提供的为准 部署环境要求 包含全部中间件及设计器服务的环境要求 CPU:8 vCPU 内存(RAM):16G以上 硬盘(HDD/SSD):60G以上 仅设计器服务的环境要求 CPU:8 vCPU 内存(RAM):8G以上 硬盘(HDD/SSD):40G以上 部署准备 一台安装了Docker环境的服务器(私有云环境);以下简称部署环境; 一台安装了Docker环境的电脑(可访问公网);以下简称本地环境; 部署清单 下面列举了文章中在本地环境操作结束后的全部文件: 设计器镜像:oinone-designer-full-v5-5.2.20.1-amd64.tar 离线部署结构包:oinone-designer-full-standard-offline.zip Oinone许可证:****-trial.lic(实际文件名以Oinone颁发的许可证为准) 第三方数据库驱动包(非MySQL数据库必须) PS:如需一次性拷贝所有部署文件到部署环境,可以将文档步骤在本地环境执行后,一次性将所有文件进行传输。 在部署环境创建部署目录 mkdir -p /home/admin/oinone-designer-full mkdir -p /home/admin/oinone-designer-full/images 检查部署环境服务器架构 确认部署环境是amd64还是arm64架构,若本文提供的查看方式无法正确执行,可自行搜索相关内容进行查看。 使用uname命令查看 uname -a PS:此步骤非常重要,如果部署环境的服务器架构与本地环境的服务器架构不一致,将导致镜像无法正确启动。 在本地环境准备镜像 在Oinone发布版本一览中选择最新版本的发布日志,找到需要部署的镜像版本。 登录Oinone镜像仓库(若已登录,可忽略此步骤) docker login https://harbor.oinone.top # input username # input password 获取Oinone平台镜像 docker pull harbor.oinone.top/oinone/oinone-designer-full-v5.2:5.2.20.1-amd64 保存镜像到.tar文件 docker save -o oinone-designer-full-v5-5.2.20.1-amd64.tar oinone-designer-full-v5.2:5.2.20.1-amd64 若报错`Error response from daemon: reference does not exist`脚本改成下面这个: docker save -o oinone-designer-full-v5-5.2.20.1-amd64.tar harbor.oinone.top/oinone/oinone-designer-full-v5.2:5.2.20.1-amd64 # docker save [OPTIONS] IMAGE [IMAGE…] 上传.tar到部署环境 scp ./oinone-designer-full-v5-5.2.20.1-amd64.tar admin@127.0.0.1:/home/admin/oinone-full/images/ PS:若无法使用scp方式上传,可根据部署环境的具体情况将镜像文件上传至部署环境的部署目录。 在部署环境加载镜像 加载镜像文件到Docker中 cd /home/admin/oinone-full/images docker load -i oinone-designer-full-v5-5.2.20.1-amd64.tar 查看镜像是否正确加载 docker images 查看输出内容,对比REPOSITORY、TAG、IMAGE ID与本地环境完全一致即可。 设计器服务部署 为了方便起见,服务器操作文件显得不太方便,因此,我们可以在本地环境将部署脚本准备妥善后,传输到部署环境进行部署结构包(oinone-designer-full-standard-offline.)需上传到要部署的服务器中,后面的操作均在这个目中进行 下载离线部署结构包(以数式发出的为准) oinone-designer-full-standard-offline.zip 将Pamirs许可证移动到config目录下,并重命名为****-trial.lic(实际文件名以Oinone颁发的许可证为准) mv ****-trial.lic config/****-trial.lic 加载非MySQL数据库驱动(按需) 将驱动jar文件移动到lib目录下即可。 以KDB8数据库驱动kingbase8-8.6.0.jar为例 mv kingbase8-8.6.0.jar lib/ PS:lib目录为非设计器内置包的外部加载目录(外部库),可以添加任何jar包集成到设计器中。 修改脚本中的配置 修改启动脚本startup.sh 修改对应的镜像版本号, 将IP从192.168.0.121改成宿主机IP configDir=$(pwd) version=5.1.16 IP=192.168.0.121 修改mq/broker.conf 修改其中brokerIP1的IP从192.168.0.121改成宿主机IP brokerClusterName = DefaultCluster namesrvAddr=127.0.0.1:9876 brokerIP1=192.168.0.121 brokerName = broker-a brokerId = 0 deleteWhen = 04 fileReservedTime = 48 brokerRole = ASYNC_MASTER flushDiskType = ASYNC_FLUSH autoCreateTopicEnable=true listenPort=10991 transactionCheckInterval=1000 #存储使用率阀值,当使用率超过阀值时,将拒绝发送消息请求 diskMaxUsedSpaceRatio=98 #磁盘空间警戒阈值,超过这个值则停止接受消息,默认值90 diskSpaceWarningLevelRatio=99 #强制删除文件阈值,默认85 diskSpaceCleanForciblyRatio=97 执行startup.sh脚本启动 sh startup.sh 访问服务 使用http://127.0.0.1:88访问服务

    2024年11月1日
    1.6K00
  • 后端代码规范

    前言 虽然oinone框架减少了很多的代码,但是低代码部分的代码质量也需要高度关注,不管是写的代码bug多,或者说被吐槽代码不行,还是说写的代码经常被重构,核心点还是没有代码规范的意识和技巧,下面摘录了一些常见的规范要求,去提高后端的代码质量,代码质量提高后,自然效率也会提升。 常见代码规范 **1、规范命名** 命名是写代码中最频繁的操作,比如类、属性、方法、参数等。好的名字应当能遵循以下几点: **见名知意** 比如需要定义一个变量需要来计数 int i = 0; 名称 i 没有任何的实际意义,没有体现出数量的意思,所以我们应当指明数量的名称 int count = 0; **能够读的出来** 如下代码: private String sfzh; private String dhhm; 这些变量的名称,根本读不出来,更别说实际意义了。 所以我们可以使用正确的可以读出来的英文来命名 private String idCardNo; private String phone; **2、规范代码格式** 好的代码格式能够让人感觉看起来代码更加舒适。 好的代码格式应当遵守以下几点: 合适的空格 代码对齐,比如大括号要对齐 及时换行,一行不要写太多代码 好在现在开发工具支持一键格式化,可以帮助美化代码格式,大家统一使用idea的规范即可。 **3、写好代码注释** 在《代码整洁之道》这本书中作者提到了一个观点,注释的恰当用法是用来弥补我们在用代码表达意图时的失败。换句话说,当无法通过读代码来了解代码所表达的意思的时候,就需要用注释来说明。 书的作者之所以这么说,是因为作者觉得随着时间的推移,代码可能会变动,如果不及时更新注释,那么注释就容易产生误导,偏离代码的实际意义。而不及时更新注释的原因是,程序员不喜欢写注释。😒 但是这不意味着可以不写注释,当通过代码如果无法表达意思的时候,就需要注释,比如如下代码: for (Integer id : ids) { if (id == 0) { continue; } //做其他事 } 为什么 id == 0 需要跳过,代码是无法看出来了,就需要注释了。 好的注释应当满足一下几点: 解释代码的意图,说明为什么这么写,用来做什么 对参数和返回值注释,入参代表什么,出参代表什么 有警示作用,比如说入参不能为空,或者代码是不是有坑 当代码还未完成时可以使用 todo 注释来标记 代码review发现漏洞时 可以使用 fixme 注释来标记 **4、try catch 内部代码抽成一个方法** try catch代码有时会干扰我们阅读核心的代码逻辑,这时就可以把try catch内部主逻辑抽离成一个单独的方法 如下图是Eureka服务端源码中服务下线的实现中的一段代码 整个方法非常长,try中代码是真正的服务下线的代码实现,finally可以保证读锁最终一定可以释放。 所以这段代码其实就可以对核心的逻辑进行抽取。 protected boolean internalCancel(String appName, String id, boolean isReplication) { try { read.lock(); doInternalCancel(appName, id, isReplication); } finally { read.unlock(); } // 剩余代码 } private boolean doInternalCancel(String appName, String id, boolean isReplication) { //真正处理下线的逻辑 } **5、方法别太长** 方法别太长就是字面的意思。一旦代码太长,给人的第一眼感觉就很复杂,让人不想读下去; 同时方法太长的代码可能读起来容易让人摸不着头脑,不知道哪一些代码是同一个业务的功能。 比如代码中有那种2000+行大类,各种if else判断,光理清代码思路就需要用很久时间。🤷🏻‍♀️ 所以一旦方法过长,可以尝试将相同业务功能的代码单独抽取一个方法,最后在主方法中调用即可。 **6、抽取重复代码** 当一份代码重复出现在程序的多处地方,就会造成程序又臭又长,当这份代码的结构要修改时,每一处出现这份代码的地方都得修改,导致程序的扩展性很差。 所以一般遇到这种情况,可以抽取成一个工具类,还可以抽成一个公共的父类。 **7、多用return** 在有时我们平时写代码的情况可能会出现if条件套if的情况,当if条件过多的时候可能会出现如下情况: if (条件1) { if (条件2) { if (条件3) { if (条件4) { if (条件5) { System.out.println("11111"); } } } } } 面对这种情况,可以换种思路,使用return来优化 if (!条件1) { return; } if (!条件2) { return; } if (!条件3) { return; } if (!条件4) { return; } if (!条件5) { return; } System.out.println("11111"); 这样优化就感觉看起来更加直观 **8、if条件表达式不要太复杂**…

    2024年12月11日
    3.2K00
  • Dubbo配置详解

    概述 Dubbo是一款高性能、轻量级的开源Java RPC框架,它提供了三大核心能力:面向接口的远程方法调用,智能容错和负载均衡,以及服务自动注册和发现。 Oinone平台默认使用dubbo-v2.7.22版本,本文以该版本为例进行描述。 基本概念 Dubbo在注册provider/consumer时使用Netty作为RPC调用的核心服务,其具备客户端/服务端(C/S)的基本特性。即:provider作为服务端,consumer作为客户端。 客户端通过服务中心发现有服务可被调用时,将通过服务中心提供的服务端调用信息,连接服务端并发起请求,从而实现远程调用。 服务注册(绑定Host/Port) JAVA程序启动时,需要将provider的信息注册到服务中心,并在当前环境为Netty服务开启Host/Port监听,以实现服务注册功能。 在下文中,我们通过绑定Host/Port表示Netty服务的访问地址,通过注册Host/Port表示客户端的访问地址。 使用yaml配置绑定Host/Port PS:该配置可在多种环境中通用,改变部署方式无需修改此配置。 dubbo: protocol: name: dubbo # host: 0.0.0.0 port: -1 假设当前环境的可用IP为192.168.1.100 以上配置将使得Netty服务默认绑定在0.0.0.0:20880地址,服务注册地址为192.168.1.100:20880 客户端将通过192.168.1.100:20880调用服务端服务 若发生20880端口占用,则自动向后查找可用端口。如20881、20882等等 若当前可用端口为20881,则以上配置将使得Netty服务默认绑定在0.0.0.0:20881地址,服务注册地址为192.168.1.100:20881 使用环境变量配置注册Host/Port 当服务端被放置在容器环境中时,由于容器环境的特殊性,其内部的网络配置相对于宿主机而言是独立的。因此为保证客户端可以正常调用服务端,还需在容器中配置环境变量,以确保客户端可以通过指定的注册Host/Port进行访问。 以下示例为体现无法使用20880端口的情况,将宿主机可访问端口从20880改为20881。 DUBBO_IP_TO_REGISTRY=192.168.1.100 DUBBO_PORT_TO_REGISTRY=20881 假设当前宿主机环境的可用IP为192.168.1.100 以上配置将使得Netty服务默认绑定在0.0.0.0:20881地址,服务注册地址为192.168.1.100:20881 客户端将通过192.168.1.100:20881调用服务端服务 使用docker/docker-compose启动 需添加端口映射,将20881端口映射至宿主机20881端口。(此处容器内的端口发生变化,若需要了解具体原因,可参考题外话章节) docker-run IP=192.168.1.100 docker run -d –name designer-allinone-full \ -e DUBBO_IP_TO_REGISTRY=$IP \ -e DUBBO_PORT_TO_REGISTRY=20881 \ -p 20881:20881 \ docker-compose services: backend: container_name: designer-backend image: harbor.oinone.top/oinone/designer-backend-v5.0 restart: always environment: DUBBO_IP_TO_REGISTRY: 192.168.1.100 DUBBO_PORT_TO_REGISTRY: 20881 ports: – 20881:20881 # dubbo端口 使用kubernetes启动 工作负载(Deployment) kind: Deployment apiVersion: apps/v1 spec: replicas: 1 template: spec: containers: – name: designer-backend image: harbor.oinone.top/oinone/designer-backend-v5.0 ports: – name: dubbo containerPort: 20881 protocol: TCP env: – name: DUBBO_IP_TO_REGISTRY value: "192.168.1.100" – name: DUBBO_PORT_TO_REGISTRY value: "20881" 服务(Services) kind: Service apiVersion: v1 spec: type: NodePort ports: – name: dubbo protocol: TCP port: 20881 targetPort: dubbo nodePort: 20881 PS:此处的targetPort为对应Deployment#spec. template.spec.containers.ports.name配置的端口名称。若未配置,可使用20881直接指定对应容器的端口号。 使用kubernetes其他暴露服务方式 在Kubernetes中部署服务,有多种配置方式均可用暴露服务。上述配置仅用于通过Service/NodePort将20881端口暴露至宿主机,其他服务可用通过任意Kubernetes节点IP进行调用。 若其他服务也在Kubernetes中进行部署,则可以通过Service/Service方式进行调用。将DUBBO_IP_TO_REGISTRY配置为${serviceName}.${namespace}即可。 若其他服务无法直接访问Kubernetes的master服务,则可以通过Ingress/Service方式进行调用。将DUBBO_IP_TO_REGISTRY配置为Ingress可解析域名即可。 Dubbo调用链路图解 PS: Consumer的绑定Host/Port是其作为Provider使用的,下面所有图解仅演示单向的调用链路。 名词解释 Provider: 服务提供者(JVM) Physical Machine Provider: 服务提供者所在物理机 Provider Container: 服务提供者所在容器 Kubernetes Service: Kubernetes Service资源类型 Consumer: 服务消费者(JVM) Registration Center: 注册中心;可以是zookeeper、nacos等。 bind: 服务绑定Host/Port到指定ip:port。 registry: 服务注册;注册Host/Port到注册中心的信息。 discovery: 服务发现;注册Host/Port到消费者的信息。 invoke: 服务调用;消费者通过注册中心提供的提供者信息向提供者发起服务调用。 forward: 网络转发;通常在容器环境需要进行必要的网络转发,以使得服务调用可以到达服务提供者。 物理机/物理机调用链路 “` mermaidsequenceDiagram participant p as Provider<br>(bind 0.0.0.0:20880)participant m as Physical Machine Provider<br>(bind 192.168.1.100:20881)participant…

    2024年8月10日
    3.0K00

Leave a Reply

Please Login to Comment