
技术精要:数据导出与固化实用指南

数据被认为是企业发展和决策的重要资产。随着业务的不断发展和数据量的不断增加,企业通常需要将数据从不同的源头导出,并将其固化到产品中,以便进行进一步的分析、处理和利用。数据导出与固化的过程涉及到数据的提取、清洗、整合和存储,是确保数据长期有效性和可用性的关键步骤。

了解数据导出与固化的流程和方法对于企业具有重要意义。通过有效的数据导出和固化,企业可以更好地管理和利用数据资源,提升决策的准确性和效率,实现业务的持续发展和创新。本次讨论将重点探讨数据导出与固化的流程和关键步骤,帮助参与者深入了解如何将数据从导出到产品中,为企业数据管理和应用提供有力支持。

1. 数据导出与固化:将数据从导出到产品中的流程

1.1. pom依赖:

<dependency>
 <groupId>pro.shushi.pamirs.metadata.manager</groupId>
 <artifactId>pamirs-metadata-manager</artifactId>
</dependency>

1.2 将第⼆步下载后的⽂件放⼊项⽬中(注意⽂件放置的位置)。放置⼯程的resources

下⾯。例如:
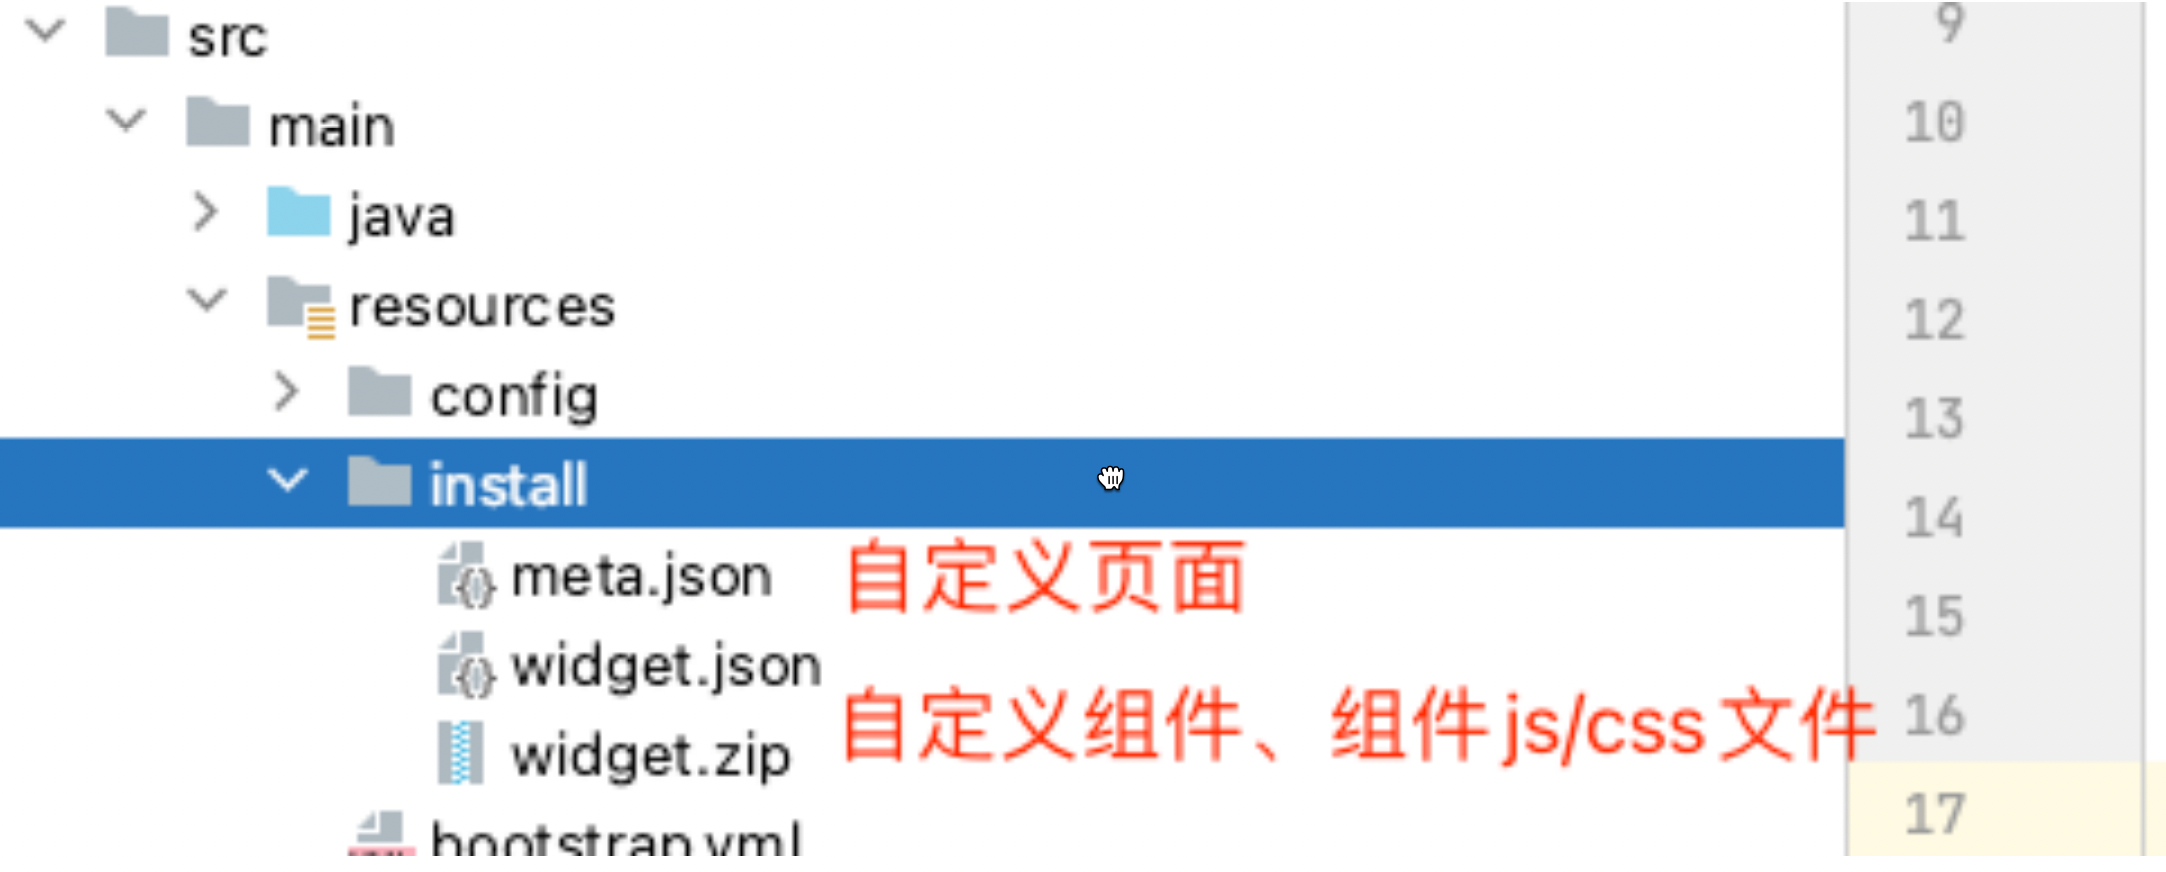
技术精要:数据导出与固化实用指南

1.3 项⽬启动过程中,将⽂件中的数据导⼊(通常放在core模型的init包下

⾯)。⽰例代码:

package pro.shushi.pamirs.sys.setting.enmu;
import com.google.common.collect.Lists;
import org.apache.commons.collections4.CollectionUtils;
import 
org.springframework.beans.factory.annotation.Autowired;
import org.springframework.context.ApplicationContext;
import org.springframework.stereotype.Component;
import 
pro.shushi.pamirs.boot.common.api.command.AppLifecycleCom
mand;
import 
pro.shushi.pamirs.boot.common.api.init.LifecycleCompleted
AllInit;
import 
pro.shushi.pamirs.boot.common.extend.MetaDataEditor;
import pro.shushi.pamirs.core.common.InitializationUtil;
import 
pro.shushi.pamirs.meta.annotation.fun.extern.Slf4j;
import pro.shushi.pamirs.meta.api.dto.meta.Meta;
import 
pro.shushi.pamirs.meta.domain.module.ModuleDefinition;
import 
pro.shushi.pamirs.metadata.manager.core.helper.DesignerIn
stallHelper;
import 
pro.shushi.pamirs.metadata.manager.core.helper.WidgetInst
allHelper;
import java.util.List;
import java.util.Map;
@Slf4j
@Component
public class DemoAppMetaInstall implements 
MetaDataEditor, LifecycleCompletedAllInit {
 @Autowired
 private ApplicationContext applicationContext;
 @Override
 public void edit(AppLifecycleCommand command, 
Map<String, Meta> metaMap) {
 if (!doImport()) {
 return;
 }
 log.info("[设计器业务元数据导⼊]");
 InitializationUtil bizInitializationUtil = 
InitializationUtil.get(metaMap, DemoModule.MODULE_MODULE/
***改成⾃⼰的Module*/, DemoModule.MODULE_NAME/***改成⾃⼰的
Module*/);

DesignerInstallHelper.mateInitialization(bizInitializatio
nUtil, "install/meta.json");
 log.info("[⾃定义组件元数据导⼊]");
// 写法1: 将组件元数据导⼊到⻚⾯设计器. 只有在安装设计器的
服务中执⾏才有效果
 WidgetInstallHelper.mateInitialization(metaMap, 
"install/widget.json");
// 写法2: 与写法1相同效果
 InitializationUtil uiInitializationUtil = 
InitializationUtil.get(metaMap, "ui_designer", 
"uiDesigner");
 if (uiInitializationUtil != null) {

DesignerInstallHelper.mateInitialization(uiInitialization
Util, "install/widget.json");
 }
// 写法3: 业务⼯程和设计器分布式部署,且希望通过业务⼯程导⼊
⾃定义组件元数据. 业务模块需要依赖⻚⾯设计器模块,然后指定业务模块导
⼊

DesignerInstallHelper.mateInitialization(bizInitializatio
nUtil, "install/widget.json");
 }
 @Override
 public void process(AppLifecycleCommand command, 
Map<String, ModuleDefinition> runModuleMap) {
 if (!doImport()) {
 return;
 }
 log.info("[设计器业务数据导⼊]");
// ⽀持远程调⽤,但是执⾏的⽣命周期必须是
LifecycleCompletedAllInit或之后. 本地如果安装了设计器,则没有要
求
 DesignerInstallHelper.bizInitialization("install/
meta.json");
 log.info("[⾃定义组件业务数据导⼊]");
// 当开发环境和导⼊环境的⽂件服务不互通时, 可通过指定js和
css的⽂件压缩包,⾃动上传到导⼊环境,并替换导⼊组件数据中的⽂件url
// WidgetInstallHelper.bizInitialization("install/
widget.json", "install/widget.zip");
 WidgetInstallHelper.bizInitialization("install/
widget.json");
 return;
 }
 private boolean doImport() {
 // ⾃定义导⼊判断. 避免⽤于设计的开发环境执⾏导⼊逻辑
 String[] envs = 
applicationContext.getEnvironment().getActiveProfiles();
 List<String> envList = Lists.newArrayList(envs);
 return CollectionUtils.isNotEmpty(envList) && 
(envList.contains("prod"));
 }
}

2. 设计器数据导出

简介
通过调⽤导出接口,将设计器的设计数据与运动数据打包导出到⽂件中。
提供了download/export两类接⼜。
export
导出到OSS。导出的⽂件会上传到⽂件服务,通过返回的url下载导出⽂件。
请求⽰例:

mutation {
    uiDesignerExportReqMutation {
        export(
            data: { module: "gemini_core", fileName: "meta", moduleBasics: true }
        ) {
            jsonUrl
        }
    }
}

响应⽰例:

{
          "data":  {
                    "uiDesignerExportReqMutation":  {
                              "export":  {
                                        "jsonUrl":  "https://xxx/meta.json"
                              }
                    }
          },
          "errors":  [

          ],
          "extensions":  {

          }
}

download
直接返回导出数据。适⽤于通过浏览器直接下载⽂件。
请求⽰例:

mutation {
    uiDesignerExportReqMutation {
        download(
            data: { module: "gemini_core", fileName: "meta", moduleBasics: true }
        ) {
            jsonUrl
        }
    }
}

如何构造url
protocol :// hostname[:port] / path ?
query=URLEncode(GraphQL)
例:

http://127.0.0.1:8080/pamirs/base?
query=mutation%20%7B%0A%09uiDesignerExportReqMutation%20%
7B%0A%09%09download(%0A%09%09%09data%3A%20%7B%20module%3A
%20%22gemini_core%22%2C%20fileName%3A%20%22meta%22%2C%20m
oduleBasics%3A%20true%20%7D%0A%09%09)%20%7B%0A%09%09%09js
onUrl%0A%09%09%7D%0A%09%7D%0A%7D

在浏览器中访问构造后的url,可直接下载⽂件
接口列表

2.1 模型设计器

指定模块导出

#生成json
query {
    modelMetaDataExporterQuery {
        export(query: { module: "模块编码" }) {
            module
            url
        }
    }
}
#生成json文件下载
query {
    modelMetaDataExporterQuery {
        download(query: { module: "模块编码" }) {
            module
            url
        }
    }
}

module参数:指定导出的模块编码
url返回结果:export⽅式导出的⽂件url

2.2 页⾯设计器-导出页⾯

2.2.1 指定模块导出

#生成json
mutation {
    uiDesignerExportReqMutation {
        export(
            data: { module: "gemini_core", fileName: "meta", moduleBasics: true }
        ) {
            jsonUrl
        }
    }
}
#生成json文件下载
mutation {
    uiDesignerExportReqMutation {
        download(
            data: { module: "gemini_core", fileName: "meta", moduleBasics: true }
        ) {
            jsonUrl
        }
    }
}

module参数:模块编码
fileName参数:指定⽣成的json⽂件名称
moduleBasics参数:指定是否只导出模块基础数据,如果为true,只导出内置布局、模
块菜单、菜单关联的动作。 如果为false,还会导出模块内的所有页⾯,以及页⾯关联
的动作元数据、页⾯设计数据 等等。 默认值为false。

2.2.2 指定菜单导出

#生成json
mutation {
    uiDesignerExportReqMutation {
        export(
            data: {
                menu: { name: "uiMenu0000000000048001" }
                fileName: "meta"
                relationViews: true
            }
        ) {
            jsonUrl
        }
    }
}
#生成json文件下载
mutation {
    uiDesignerExportReqMutation {
        download(
            data: {
                menu: { name: "uiMenu0000000000048001" }
                fileName: "meta"
                relationViews: true
            }
        ) {
            jsonUrl
        }
    }
}

menu参数:菜单对象,指定菜单的name。只会导出该菜单及其绑定页⾯,不会递归查
询⼦菜单
fileName参数:指定⽣成的json⽂件名称
relationViews参数:指定是否导出关联页⾯,默认为false,只导出菜单关联的页⾯。如
果为true,还会导出该页⾯通过跳转动作关联的⾃定义页⾯。

2.2.3 指定页⾯导出

#生成json
mutation {
    uiDesignerExportReqMutation {
        export(
            data: {
                view: {
                    name: "xx_TABLE_0000000000119001"
                    model: "ui.designer.TestUiDesigner"
                }
                fileName: "meta"
                relationViews: true
            }
        ) {
            jsonUrl
        }
    }
}
#生成json文件下载
mutation {
    uiDesignerExportReqMutation {
        download(
            data: {
                view: {
                    name: "xx_TABLE_0000000000119001"
                    model: "ui.designer.TestUiDesigner"
                }
                fileName: "meta"
                relationViews: true
            }
        ) {
            jsonUrl
        }
    }
}

view参数:视图对象,指定视图的name和model
fileName参数:指定⽣成的json⽂件名称
relationViews参数:指定是否导出关联页⾯,默认为false,只导出菜单关联的页⾯。如
果为true,还会导出该页⾯通过跳转动作关联的⾃定义页⾯。

2.3 导出组件

2.3.1 导出全部组件数据

#生成json
mutation {
    uiDesignerExportReqMutation {
        exportWidget(data: { fileName: "meta" }) {
            jsonUrl
        }
    }
}
#生成json文件下载
mutation {
    uiDesignerExportReqMutation {
        downloadWidget(data: { fileName: "meta" }) {
            jsonUrl
        }
    }
}

fileName参数:指定⽣成的json⽂件名称
注意:⾃定义组件的元数据归属于页⾯设计器(ui_designer) 因此导⼊元数据的模块
(module)并不是业务模块。组件导⼊建议使⽤
pro.shushi.pamirs.metadata.manager.core.helper.WidgetInstallHelper

2.3.2 导出全部组件⽂件

当开发环境,和导⼊环境的oss不互通时,可通过⼀下⽅法导出⾃定义组件的css和
js⽂件压缩包,在导⼊时⽀持指定zip⽂件上传到oss,并替换导⼊组件数据中的css和js
⽂件路径。

#生成json
mutation {
    uiDesignerExportReqMutation {
        exportWidgetFile(data: { fileName: "widget" }) {
            jsonUrl
        }
    }
}
#生成json文件下载
mutation {
    uiDesignerExportReqMutation {
        downloadWidgetFile(data: { fileName: "widget" }) {
            jsonUrl
        }
    }
}

2.4 流程设计器

2.4.1 指定模块导出

参数说明:

  • module参数:模块编码

接口示例:

#生成json
mutation {
    workflowDesignerExportReqMutation {
        export(data: { module: "resource", fileName: "meta" }) {
            jsonUrl
        }
    }
}
#生成json文件下载
mutation {
    workflowDesignerExportReqMutation {
        download(data: { module: "resource", fileName: "meta" }) {
            jsonUrl
        }
    }
}

2.4.2 指定流程编码导出

参数说明:

  • workflowCode参数:流程编码

接口示例:

#生成json
mutation {
    workflowDesignerExportReqMutation {
        export(data: { workflowCode: "WF0000000000132500", fileName: "meta" }) {
            jsonUrl
        }
    }
}
#生成json文件下载
mutation {
    workflowDesignerExportReqMutation {
        download(data: { workflowCode: "WF0000000000132500", fileName: "meta" }) {
            jsonUrl
        }
    }
}

2.4 数据可视化

2.4.1全部导出

接口示例:

#生成json
mutation {
    dataDesignerExportReqMutation {
        export(data: { fileName: "meta" }) {
            jsonUrl
        }
    }
}
#生成json文件下载
mutation {
    dataDesignerExportReqMutation {
        download(data: { fileName: "meta" }) {
            jsonUrl
        }
    }
}

2.4.2 指定图表导出

参数说明:

  • chartCode参数:图表编码

接口示例:

#生成json
mutation {
    dataDesignerExportReqMutation {
        export(data: { chartCode: "CT00000000002000", fileName: "meta" }) {
            jsonUrl
        }
    }
}
#生成json文件下载
mutation {
    dataDesignerExportReqMutation {
        download(data: { chartCode: "CT00000000002000", fileName: "meta" }) {
            jsonUrl
        }
    }
}

2.4.3指定报表导出

参数说明:

  • reportCode参数:报表编码

接口示例:

#生成json
mutation {
    dataDesignerExportReqMutation {
        export(data: { reportCode: "RP00001000", fileName: "meta" }) {
            jsonUrl
        }
    }
}
#生成json文件下载
mutation {
    dataDesignerExportReqMutation {
        download(data: { reportCode: "RP00001000", fileName: "meta" }) {
            jsonUrl
        }
    }
}

2.4.4 指定业务⼤屏导出

参数说明:

  • screenCode参数:业务⼤屏

接口示例:

#生成json
mutation {
    dataDesignerExportReqMutation {
        export(data: { screenCode: "DS00001000", fileName: "meta" }) {
            jsonUrl
        }
    }
}
#生成json文件下载
mutation {
    dataDesignerExportReqMutation {
        download(data: { screenCode: "DS00001000", fileName: "meta" }) {
            jsonUrl
        }
    }
}

以上方式通过有效的数据导出和固化,企业可以建立可靠的数据基础设施,支持数据驱动的决策和业务发展。

Oinone社区 作者:数式-海波原创文章,如若转载,请注明出处:https://doc.oinone.top/backend/5785.html

访问Oinone官网:https://www.oinone.top获取数式Oinone低代码应用平台体验

Like (2)
数式-海波's avatar数式-海波数式管理员
Previous 2024年2月26日 pm5:47
Next 2024年2月28日 pm3:11

相关推荐

  • 如何自定义SQL(Mapper)语句

    场景描述 在实际业务场景中,存在复杂SQL的情况,具体表现为: 单表单SQL满足不了的情况下 有复杂的Join关系或者子查询 复杂SQL的逻辑通过程序逻辑难以实现或实现代价较大 在此情况下,通过原生的mybatis/mybatis-plus, 自定义Mapper的方式实现业务功能 1、编写所需的Mapper SQL Mapper写法无限制,与使用原生的mybaits/mybaits-plus用法一样; Mapper(DAO)和SQL可以写在一个文件中,也分开写在两个文件中。 package pro.shushi.pamirs.demo.core.map; import org.apache.ibatis.annotations.Mapper; import org.apache.ibatis.annotations.Param; import org.apache.ibatis.annotations.Select; import java.util.List; import java.util.Map; @Mapper public interface DemoItemMapper { @Select("<script>select sum(item_price) as itemPrice,sum(inventory_quantity) as inventoryQuantity,categoryId from ${demoItemTable} as core_demo_item ${where} group by category_id</script>") List<Map<String, Object>> groupByCategoryId(@Param("demoItemTable") String pamirsUserTable, @Param("where") String where); } 2.调用mapper 调用Mapper代码示例 package pro.shushi.pamirs.demo.core.map; import com.google.api.client.util.Lists; import org.springframework.stereotype.Component; import pro.shushi.pamirs.demo.api.model.DemoItem; import pro.shushi.pamirs.framework.connectors.data.api.datasource.DsHintApi; import pro.shushi.pamirs.meta.api.core.orm.convert.DataConverter; import pro.shushi.pamirs.meta.api.session.PamirsSession; import pro.shushi.pamirs.meta.common.spring.BeanDefinitionUtils; import java.util.List; import java.util.Map; @Component public class DemoItemDAO { public List<DemoItem> customSqlDemoItem(){ try (DsHintApi dsHint = DsHintApi.model(DemoItem.MODEL_MODEL)) { String demoItemTable = PamirsSession.getContext().getModelCache().get(DemoItem.MODEL_MODEL).getTable(); DemoItemMapper demoItemMapper = BeanDefinitionUtils.getBean(DemoItemMapper.class); String where = " where status = 'ACTIVE'"; List<Map<String, Object>> dataList = demoItemMapper.groupByCategoryId(demoItemTable,where); DataConverter persistenceDataConverter = BeanDefinitionUtils.getBean(DataConverter.class); return persistenceDataConverter.out(DemoItem.MODEL_MODEL, dataList); } return Lists.newArrayList(); } } 调用Mapper一些说明 启动类需要配置扫描包MapperScan @MapperScan(value = "pro.shushi", annotationClass = Mapper.class) @SpringBootApplication(exclude = {DataSourceAutoConfiguration.class, FreeMarkerAutoConfiguration.class}) public class DemoApplication { 调用Mapper接口的时候,需要指定数据源;即上述示例代码中的 DsHintApi dsHint = DsHintApi.model(DemoItem.MODEL_MODEL), 实际代码中使用 try-with-resources语法。 从Mapper返回的结果中获取数据 如果SQL Mapper中已定义了resultMap,调用Mapper(DAO)返回的就是Java对象 如果Mapper返回的是Map<String, Object>,则通过 DataConverter.out进行转化,参考上面的示例 其他参考:Oinone连接外部数据源方案:https://doc.oinone.top/backend/4562.html

    2023年11月27日
    2.3K00
  • 【KDB】后端部署使用Kingbase数据库(人大金仓/电科金仓)

    KDB数据库配置 驱动配置 Maven配置 点击查看官方驱动说明 PS:官方驱动说明中的9.0.0版本目前并未推送至公共仓库,因此使用8.6.0版本替代。 <kdb.version>8.6.0</kdb.version> <dependency> <groupId>cn.com.kingbase</groupId> <artifactId>kingbase8</artifactId> <version>${kdb.version}</version> </dependency> 离线驱动下载 kingbase8-8.6.0.jar JDBC连接配置 pamirs: datasource: base: type: com.alibaba.druid.pool.DruidDataSource driverClassName: com.kingbase8.Driver url: jdbc:kingbase8://127.0.0.1:4321/pamirs?currentSchema=base&autosave=always&cleanupSavepoints=true username: xxxxxx password: xxxxxx initialSize: 5 maxActive: 200 minIdle: 5 maxWait: 60000 timeBetweenEvictionRunsMillis: 60000 testWhileIdle: true testOnBorrow: false testOnReturn: false poolPreparedStatements: true asyncInit: true validConnectionCheckerClassName: com.alibaba.druid.pool.vendor.PGValidConnectionChecker PS:validConnectionCheckerClassName配置非常重要,连接存活检查是连接池可以保持连接的重要配置。Druid连接池可以自动识别大多数的数据库类型,由于jdbc:kingbase8协议属于非内置识别的类型,因此需要手动配置。 连接url配置 点击查看官方JDBC连接配置说明 url格式 jdbc:kingbase8://${host}:${port}/${database}?currentSchema=${schema}&autosave=always&cleanupSavepoints=true 在jdbc连接配置时,${database}和${schema}必须配置,不可缺省。autosave=always、cleanupSavepoints=true属于必须配置的事务参数,否则事务回滚行为与其他数据库不一致,会导致部分操作失败。 其他连接参数如需配置,可自行查阅相关资料进行调优。 方言配置 pamirs方言配置 pamirs: dialect: ds: base: type: KDB version: 9 major-version: V009R001C001B0030 pamirs: type: KDB version: 9 major-version: V009R001C001B0030 数据库版本 type version majorVersion V009R001C001B0030 KDB 9 V009R001C001B0030 V008R006C008B0020 KDB 9 V009R001C001B0030 PS:由于方言开发环境为V009R001C001B0030版本,其他类似版本原则上不会出现太大差异,如出现其他版本无法正常支持的,可在文档下方留言。 schedule方言配置 pamirs: event: enabled: true schedule: enabled: true dialect: type: PostgreSQL version: 14 major-version: 14.3 type version majorVersion PostgreSQL 14 14.3 PS:由于schedule的方言与PostgreSQL数据库并无明显差异,Kingbase数据库可以直接使用PostgreSQL数据库方言。 其他配置 逻辑删除的值配置 pamirs: mapper: global: table-info: logic-delete-value: (EXTRACT(epoch FROM CURRENT_TIMESTAMP) * 1000000 + EXTRACT(MICROSECONDS FROM CURRENT_TIMESTAMP))::bigint KDB数据库关键参数检查 PS:以下参数为Oinone平台接入KDB时使用的数据库参数,参数不一致时可尝试启动。 数据库模式 推荐配置:DB_MODE=oracle 数据库安装/初始化时配置 是否大小写敏感 推荐配置:enable_ci=off 是否启用语句级回滚 推荐配置:ora_statement_level_rollback = off show ora_statement_level_rollback; set ora_statement_level_rollback=off; 此参数在Oinone平台接入时使用的版本中未体现出应有的效果。从官方提供的文档来看,此参数与数据库连接串上的autosave=always&cleanupSavepoints=true配置结果应该是一致的,由于此参数配置无效,因此在数据库连接串上必须指定这两个参数。 Oinone平台在最初开发时使用的是基于mysql数据库的事务特性,即不支持语句级回滚的事务行为。因此,为了保证Oinone平台功能正常,需要使得事务行为保持一致。 如不一致,则可能出现某些功能无法正常使用的情况。如:流程设计器首次发布定时触发的工作流时会出现报错;导入/导出任务出现异常无法正常更新任务状态等。 是否将空字符串视为NULL 推荐配置:ora_input_emptystr_isnull = off show ora_input_emptystr_isnull; set ora_input_emptystr_isnull=off; KDB数据库用户初始化及授权 — init root user (user name can be modified by oneself) CREATE USER root WITH PASSWORD 'password'; — if using automatic database and schema creation, this is…

    2024年10月29日
    2.8K00
  • 导出导入翻译

    http://168.138.179.151/pamirs/file 导出翻译项: mutation { excelExportTaskMutation { createExportTask( data: { workbookDefinition: { model: "file.ExcelWorkbookDefinition" name: "excelLocationTemplate" } } ) { name } } } { "path": "/file", "lang": "en-US" } 导入翻译项: mutation { excelImportTaskMutation { createImportTask( data: { workbookDefinition: { model: "file.ExcelWorkbookDefinition" name: "excelLocationTemplate" } file: { url: "https://minio.oinone.top/pamirs/upload/zbh/test/2024/06/03/导出国际化配置模板_1717390304285_1717391684633.xlsx" } } ) { name } } } PS:导入自行修改url进行导入

    2024年6月28日
    2.6K00
  • 工作流审核撤回/回退/拒绝/同意/反悔钩子使用

    目录 1. 流程撤回、拒绝和回退调用自定义函数1.1 工作流【撤销】回调钩子1.2 撤销【回退】回调钩子1.3 工作流【拒绝】回调钩子1.4 工作流【同意】回调钩子1.4 工作流【反悔】回调钩子1.4 回调钩子在业务系统中的调用示例2. 自定义审批方式、自定义审批节点名称 1.流程撤回、拒绝和回退调用自定义函数 1.1工作流【撤销】回调钩子 使用方式:把该方法放置到XXX模型的Action下面,或@Fun(XXX.MODEL_MODEL)触发方式:当流程实例被撤销时调用入口:pro.shushi.pamirs.workflow.app.core.service.impl.WorkflowInstanceServiceImpl#undoInstance /** * XXX为当前流程触发方式为模型触发时对应的触发模型、 * 对应返回不影响流程上下文 * @param data 入参为触发时的业务数据,数据的JsonString * @return */ @Function public XXX recall(String data) { // TODO: 根据实际的业务逻辑把data转换为对象 WorkRecord workRecord = JsonUtils.parseObject(data, new TypeReference<WorkRecord>(){}); // TODO: 增加自定义业务逻辑 return new XXX(); } 1.2撤销【回退】回调钩子 使用方式:把该方法放置到XXX模型的Action下面,或@Fun(XXX.MODEL_MODEL)触发方式:流程待办进行回退操作时调用入口:pro.shushi.pamirs.workflow.app.core.service.operator.ApprovalFallbackOperatorService /** * XXX为当前流程触发方式为模型触发时对应的触发模型 * 对应返回不影响流程上下文 * @param data 入参为触发时的业务数据,数据的JsonString * @return */ @Function public XXX fallBack(String data) { // TODO: 根据实际的业务逻辑把data转换为对象 WorkRecord workRecord = JsonUtils.parseObject(data, new TypeReference<WorkRecord>(){}); // TODO: 增加自定义业务逻辑 return new XXX(); } 1.3工作流【拒绝】回调钩子 使用方式:把该方法放置到XXX模型的Action下面,或@Fun(XXX.MODEL_MODEL)触发方式:流程待办进行拒绝操作时调用入口:pro.shushi.pamirs.workflow.app.core.service.operator.ApprovalFallbackOperatorService /** * XXX为当前流程触发方式为模型触发时对应的触发模型 * 对应返回不影响流程上下文 * @param data 入参为触发时的业务数据,数据的JsonString * @return */ @Function public XXX reject(String data) { // TODO: 根据实际的业务逻辑把data转换为对象 WorkRecord workRecord = JsonUtils.parseObject(data, new TypeReference<WorkRecord>(){}); // TODO: 增加自定义业务逻辑 return new XXX(); } 1.4 工作流【同意】回调钩子 使用方式:把该方法放置到XXX模型的Action下面,或@Fun(XXX.MODEL_MODEL)触发方式:流程待办进行同意操作时调用入口:pro.shushi.pamirs.workflow.app.core.util.ArtificialTaskUtils @Function(summary = "发起的审批同意时会自动调用此方法") @Function.Advanced(displayName = "审批同意") public Teacher agree(String data) { // TODO: 根据实际的业务逻辑把data转换为对象 // WorkRecord workRecord = JsonUtils.parseObject(data, new TypeReference<WorkRecord>(){}); // TODO: 增加自定义业务逻辑 return new Teacher(); } 1.4 工作流【反悔】回调钩子 使用方式:把该方法放置到XXX模型的Action下面,或@Fun(XXX.MODEL_MODEL)触发方式:流程待办进行反悔操作时使用场景:流程待办进行反悔操作时,需要额外更改其他的业务数据逻辑时可用该回调钩子。 注意:该函数的namespace需要设置为流程触发模型。 调用入口:pro.shushi.pamirs.workflow.app.core.service.operator.ArtificialRetractOperatorService @Function @Function.fun(WorkflowBizCallConstants.retract) public void retract(WorkflowUserTask workflowUserTask) { // 获取流程实例 workflowUserTask.fieldQuery(WorkflowUserTask::getInstance); WorkflowInstance instance = workflowUserTask.getInstance(); // 获取用户任务实例 WorkflowUserInstance userInstance = new WorkflowUserInstance() .setId(workflowUserTask.getWorkflowUserInstanceId()) .queryById(); // 反悔的用户id…

    2023年11月15日
    2.1K00
  • 后端代码规范

    前言 虽然oinone框架减少了很多的代码,但是低代码部分的代码质量也需要高度关注,不管是写的代码bug多,或者说被吐槽代码不行,还是说写的代码经常被重构,核心点还是没有代码规范的意识和技巧,下面摘录了一些常见的规范要求,去提高后端的代码质量,代码质量提高后,自然效率也会提升。 常见代码规范 **1、规范命名** 命名是写代码中最频繁的操作,比如类、属性、方法、参数等。好的名字应当能遵循以下几点: **见名知意** 比如需要定义一个变量需要来计数 int i = 0; 名称 i 没有任何的实际意义,没有体现出数量的意思,所以我们应当指明数量的名称 int count = 0; **能够读的出来** 如下代码: private String sfzh; private String dhhm; 这些变量的名称,根本读不出来,更别说实际意义了。 所以我们可以使用正确的可以读出来的英文来命名 private String idCardNo; private String phone; **2、规范代码格式** 好的代码格式能够让人感觉看起来代码更加舒适。 好的代码格式应当遵守以下几点: 合适的空格 代码对齐,比如大括号要对齐 及时换行,一行不要写太多代码 好在现在开发工具支持一键格式化,可以帮助美化代码格式,大家统一使用idea的规范即可。 **3、写好代码注释** 在《代码整洁之道》这本书中作者提到了一个观点,注释的恰当用法是用来弥补我们在用代码表达意图时的失败。换句话说,当无法通过读代码来了解代码所表达的意思的时候,就需要用注释来说明。 书的作者之所以这么说,是因为作者觉得随着时间的推移,代码可能会变动,如果不及时更新注释,那么注释就容易产生误导,偏离代码的实际意义。而不及时更新注释的原因是,程序员不喜欢写注释。😒 但是这不意味着可以不写注释,当通过代码如果无法表达意思的时候,就需要注释,比如如下代码: for (Integer id : ids) { if (id == 0) { continue; } //做其他事 } 为什么 id == 0 需要跳过,代码是无法看出来了,就需要注释了。 好的注释应当满足一下几点: 解释代码的意图,说明为什么这么写,用来做什么 对参数和返回值注释,入参代表什么,出参代表什么 有警示作用,比如说入参不能为空,或者代码是不是有坑 当代码还未完成时可以使用 todo 注释来标记 代码review发现漏洞时 可以使用 fixme 注释来标记 **4、try catch 内部代码抽成一个方法** try catch代码有时会干扰我们阅读核心的代码逻辑,这时就可以把try catch内部主逻辑抽离成一个单独的方法 如下图是Eureka服务端源码中服务下线的实现中的一段代码 整个方法非常长,try中代码是真正的服务下线的代码实现,finally可以保证读锁最终一定可以释放。 所以这段代码其实就可以对核心的逻辑进行抽取。 protected boolean internalCancel(String appName, String id, boolean isReplication) { try { read.lock(); doInternalCancel(appName, id, isReplication); } finally { read.unlock(); } // 剩余代码 } private boolean doInternalCancel(String appName, String id, boolean isReplication) { //真正处理下线的逻辑 } **5、方法别太长** 方法别太长就是字面的意思。一旦代码太长,给人的第一眼感觉就很复杂,让人不想读下去; 同时方法太长的代码可能读起来容易让人摸不着头脑,不知道哪一些代码是同一个业务的功能。 比如代码中有那种2000+行大类,各种if else判断,光理清代码思路就需要用很久时间。🤷🏻‍♀️ 所以一旦方法过长,可以尝试将相同业务功能的代码单独抽取一个方法,最后在主方法中调用即可。 **6、抽取重复代码** 当一份代码重复出现在程序的多处地方,就会造成程序又臭又长,当这份代码的结构要修改时,每一处出现这份代码的地方都得修改,导致程序的扩展性很差。 所以一般遇到这种情况,可以抽取成一个工具类,还可以抽成一个公共的父类。 **7、多用return** 在有时我们平时写代码的情况可能会出现if条件套if的情况,当if条件过多的时候可能会出现如下情况: if (条件1) { if (条件2) { if (条件3) { if (条件4) { if (条件5) { System.out.println("11111"); } } } } } 面对这种情况,可以换种思路,使用return来优化 if (!条件1) { return; } if (!条件2) { return; } if (!条件3) { return; } if (!条件4) { return; } if (!条件5) { return; } System.out.println("11111"); 这样优化就感觉看起来更加直观 **8、if条件表达式不要太复杂**…

    2024年12月11日
    3.3K00

Leave a Reply

Please Login to Comment