自定义数据权限拦截处理

业务场景

公司给员工对哪些模块有访问权限,这个时候就需要在员工访问模块表的时候做数据过滤,

解决方案

我们可以通过平台提供的数据过滤占位符解决这个问题,新建一条数据行权限,过滤语句条件是占位符,再编写占位符的解析逻辑

1.初始化权限基础数据

package pro.shushi.pamirs.demo.core.init;

import com.google.common.collect.Lists;
import org.springframework.core.annotation.Order;
import org.springframework.stereotype.Component;
import pro.shushi.pamirs.auth.api.constants.AuthConstants;
import pro.shushi.pamirs.auth.api.enmu.AuthGroupTypeEnum;
import pro.shushi.pamirs.auth.api.enmu.PermissionDataSourceEnum;
import pro.shushi.pamirs.auth.api.enmu.PermissionTypeEnum;
import pro.shushi.pamirs.auth.api.model.AuthGroup;
import pro.shushi.pamirs.auth.api.model.AuthRole;
import pro.shushi.pamirs.auth.api.model.ResourcePermission;
import pro.shushi.pamirs.boot.base.model.UeModule;
import pro.shushi.pamirs.boot.common.api.command.AppLifecycleCommand;
import pro.shushi.pamirs.boot.common.api.init.InstallDataInit;
import pro.shushi.pamirs.boot.common.api.init.UpgradeDataInit;
import pro.shushi.pamirs.demo.api.DemoModule;
import pro.shushi.pamirs.demo.core.placeholder.EmployeeModulePlaceholder;
import pro.shushi.pamirs.framework.common.utils.ObjectUtils;
import pro.shushi.pamirs.meta.annotation.fun.extern.Slf4j;
import pro.shushi.pamirs.meta.domain.module.ModuleDefinition;

import java.util.Collections;
import java.util.List;

@Slf4j
@Component
@Order(0)
public class DemoModuleBizInit implements InstallDataInit, UpgradeDataInit {

    @Override
    public List<String> modules() {
        return Collections.singletonList(DemoModule.MODULE_MODULE);
    }

    @Override
    public int priority() {
        return 0;
    }

    @Override
    public boolean init(AppLifecycleCommand command, String version) {
        this.initAuth();
        return true;
    }

    @Override
    public boolean upgrade(AppLifecycleCommand command, String version, String existVersion) {
        this.initAuth();
        return true;
    }

    private void initAuth() {
        AuthGroup authGroup = new AuthGroup();
        authGroup.setName("测试权限组")
                .setDisplayName("测试权限组")
                .setType(AuthGroupTypeEnum.RUNTIME)
                .setActive(true);
        authGroup.createOrUpdate();

        AuthRole authRole = new AuthRole();
        authRole.setCode("TEST_ROLE_1")
                .setName("测试角色")
                .setRoleTypeCode(AuthConstants.ROLE_SYSTEM_TYPE_CODE)
                .setPermissionDataSource(PermissionDataSourceEnum.CUSTOM)
                .setActive(true);
        authRole.createOrUpdate();

        authRole.setGroups(Lists.newArrayList(authGroup));
        authRole.fieldSave(AuthRole::getGroups);

        ResourcePermission authPermission = new ResourcePermission();
        authPermission.setName("测试模块权限过滤")
                .setDomainExp(EmployeeModulePlaceholder.PLACEHOLDER)
                .setModel(ModuleDefinition.MODEL_MODEL)
                .setPermRead(true)
                .setPermRun(true)
                .setPermissionType(PermissionTypeEnum.ROW)
                .setPermissionDataSource(PermissionDataSourceEnum.CUSTOM)
                .setCanShow(true)
                .setActive(true);

        ResourcePermission authPermission2 = ObjectUtils.clone(authPermission);
        authPermission2.setName("测试ue模块权限过滤").setModel(UeModule.MODEL_MODEL);

        authGroup.setPermissions(Lists.newArrayList(authPermission, authPermission2));
        authGroup.fieldSave(AuthGroup::getPermissions);
    }
}

这里演示的module表比较特殊,需要同时设置ModuleDefinition和UeModule这2个模型做数据过滤

2.编写占位符拦截替换逻辑

package pro.shushi.pamirs.demo.core.placeholder;

import org.springframework.stereotype.Component;
import pro.shushi.pamirs.user.api.AbstractPlaceHolderParser;

@Component
public class EmployeeModulePlaceholder extends AbstractPlaceHolderParser {
    public static final String PLACEHOLDER = "${employeeModulePlaceholder}";

    protected String value() {
        // TODO 可以根据业务数据动态拼写rsql条件,这里只是示例,请改成自己的查询条件
        return "module != 'hidden_module'";
    }

    public Integer priority() {
        return -this.namespace().length();
    }

    public Boolean active() {
        return true;
    }

    public String namespace() {
        return EmployeeModulePlaceholder.PLACEHOLDER;
    }
}

3.在"用户管理"应用内给用户绑定新建的角色
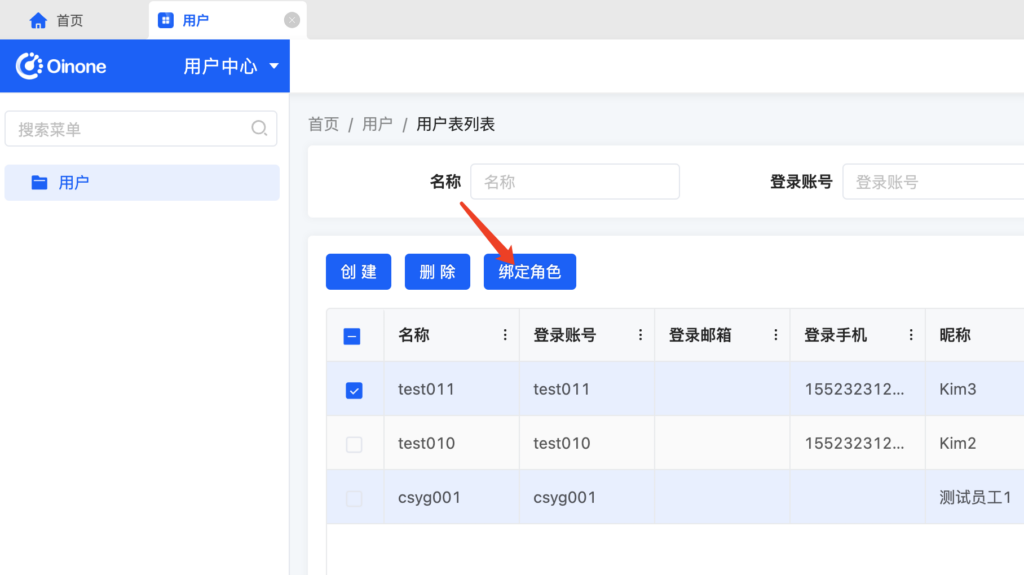
自定义数据权限拦截处理

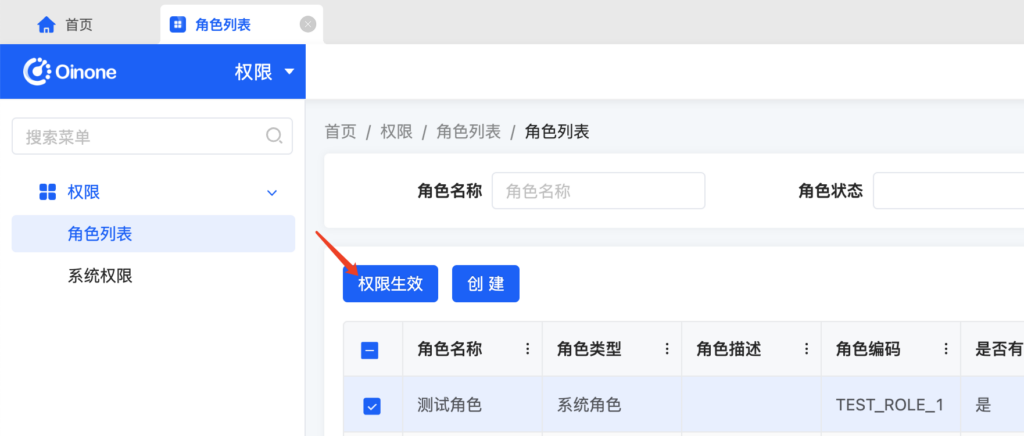
4.如权限未生效,可在"权限"应用的角色管理处刷新权限

自定义数据权限拦截处理

如何通过sql语句查看配置是否生效?

修改启动工程内的application-dev.xml配置开启sql日志,将日志级别从error改成debug后重启应用

logging:
  level:
    root: info
    pro.shushi.pamirs.framework.connectors.data.mapper.GenericMapper: debug # mybatis sql日志

通过gql工具发起请求,以上面的逻辑示例

{
    moduleQuery {
        queryPage(
            page: { size: 200, currentPage: 1 }
            queryWrapper: { }
        ) {
            content {
                module
                displayName
            }
        }
    }
}
查看效果
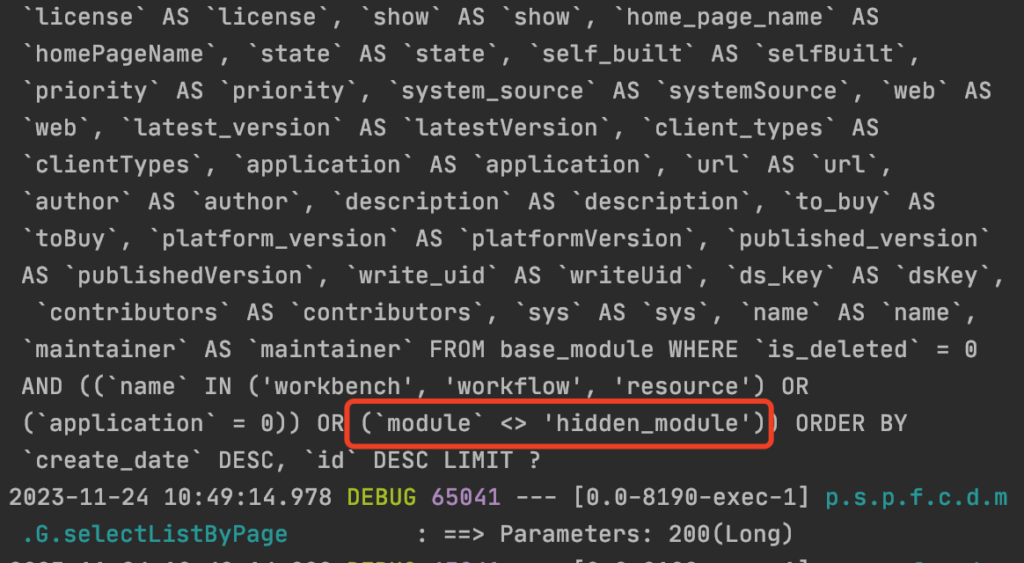
自定义数据权限拦截处理

Oinone社区 作者:nation原创文章,如若转载,请注明出处:https://doc.oinone.top/backend/4737.html

访问Oinone官网:https://www.oinone.top获取数式Oinone低代码应用平台体验

Like (0)
nation's avatarnation数式员工
Previous 2023年11月23日
Next 2023年11月24日

相关推荐

  • 项目中工作流引入和流程触发

    目录 1. 使用工作流需要依赖的包和设置2. 触发方式2.1 自动触发方式2.2 触发方式 1.使用工作流需要依赖的包和设置 1.1 工作流需要依赖的模块 需在pom.xml中增加workflow、sql-record和trigger相关模块的依赖 workflow:工作流运行核心模块 sql-record:监听流程发布以后对应模型的增删改监听 trigger:异步任务调度模块 <dependency> <groupId>pro.shushi.pamirs.workflow</groupId> <artifactId>pamirs-workflow-api</artifactId> </dependency> <dependency> <groupId>pro.shushi.pamirs.workflow</groupId> <artifactId>pamirs-workflow-core</artifactId> </dependency> <dependency> <groupId>pro.shushi.pamirs.core</groupId> <artifactId>pamirs-sql-record-core</artifactId> </dependency> <dependency> <groupId>pro.shushi.pamirs.core</groupId> <artifactId>pamirs-trigger-core</artifactId> </dependency> <dependency> <groupId>pro.shushi.pamirs.core</groupId> <artifactId>pamirs-trigger-bridge-tbschedule</artifactId> </dependency> 在application.yml中增加对应模块的依赖以及sql-record路径以及其他相关设置 pamirs: … record: sql: #改成自己路径 store: /opt/pamirs/logs … boot: init: true sync: true modules: … – sql_record – trigger – workflow … sharding: define: data-sources: ds: pamirs models: "[trigger.PamirsSchedule]": tables: 0..13 event: enabled: true schedule: enabled: true # ownSign区分不同应用 ownSign: demo rocket-mq: # enabled 为 false情况不用配置 namesrv-addr: 192.168.6.2:19876 trigger: auto-trigger: true 2.触发方式 2.1自动触发方式 在流程设计器中设置触发方式,如果设置了代码触发方式则不会自动触发 2.2代码调用方式触发 2.2.1.再流程设计器中触发设置中,设置为是否人工触发设置为是 2.2.2.查询数据库获取该流程的编码 2.2.3.在代码中调用 /** * 触发⼯作流实例 */ private Boolean startWorkflow(WorkflowD workflowD, IdModel modelData) { WorkflowDefinition workflowDefinition = new WorkflowDefinition().queryOneByWrapper( Pops.<WorkflowDefinition>lambdaQuery() .from(WorkflowDefinition.MODEL_MODEL) .eq(WorkflowDefinition::getWorkflowCode, workflowD.getCode()) .eq(WorkflowDefinition::getActive, 1) ); if (null == workflowDefinition) { // 流程没有运⾏实例 return Boolean.FALSE; } String model = Models.api().getModel(modelData); //⼯作流上下⽂ WorkflowDataContext wdc = new WorkflowDataContext(); wdc.setDataType(WorkflowVariationTypeEnum.ADD); wdc.setModel(model); wdc.setWorkflowDefinitionDefinition(workflowDefinition.parseContent()); wdc.setWorkflowDefinition(workflowDefinition); wdc.setWorkflowDefinitionId(workflowDefinition.getId()); IdModel copyData = KryoUtils.get().copy(modelData); // ⼿动触发创建的动作流,将操作⼈设置为当前⽤户,作为流程的发起⼈ copyData.setCreateUid(PamirsSession.getUserId()); copyData.setWriteUid(PamirsSession.getUserId()); String jsonData = JsonUtils.toJSONString(copyData.get_d()); //触发⼯作流 新增时触发-onCreateManual 更新时触发-onUpdateManual Fun.run(WorkflowModelTriggerFunction.FUN_NAMESPACE, "onCreateManual", wdc, msgId, jsonData); return Boolean.TRUE; }

    2023年11月7日
    2.4K00
  • 如何把平台功能菜单加到项目中?

    概述 在使用Oinone低代码平台进行项目开发的过程中,会存在把平台默认提供的菜单加到自己的项目中。这篇文章介绍实现方式,以角色管理为例。 1. 低代码情况 即项目是通过后端代码初始化菜单的方式。 通常在 XXXMenu.java类通过@UxMenu注解的方式,代码片段如下: 此种情况与添加项目本地的菜单无区别,具体代码: @UxMenu(value = "账号管理", icon = "icon-yonghuguanli") class AccountManage { @UxMenu("用户管理") @UxRoute(value = CustomerCompanyUserProxy.MODEL_MODEL, title = "用户管理") class CompanyUserManage { } @UxMenu("角色管理") @UxRoute(value = AuthRole.MODEL_MODEL, module = AdminModule.MODULE_MODULE, title = "角色管理") class RoleManage { } @UxMenu("操作日志") @UxRoute(value = OperationLog.MODEL_MODEL, module = AdminModule.MODULE_MODULE/***菜单所挂载的模块**/) class OperateLog { } } 2. 无代码情况 在界面设计器中,新建菜单–>选择绑定已有页面,进行发布即可。

    2024年4月19日
    2.1K00
  • 函数之异步执行

    总体介绍 异步任务是非常常见的一种开发模式,它在分布式的开发模式中有很多应用场景如: 高并发场景中,我们一般采用把长流程切短,用异步方式去掉可以异步的非关键功能,缩小主流程响应时间,提升用户体验 异构系统的集成调用,通过异步任务完成解耦与自动重试 分布式系统最终一致性的可选方案 本文将介绍oinone是如何结合Spring+TbSchedule来完成异步任务 构建第一个异步任务 新建PetShopService和PetShopServiceImpl 1、 新建PetShopService定义updatePetShops方法 package pro.shushi.pamirs.demo.api.service; import pro.shushi.pamirs.demo.api.model.PetShop; import pro.shushi.pamirs.meta.annotation.Fun; import pro.shushi.pamirs.meta.annotation.Function; import java.util.List; @Fun(PetShopService.FUN_NAMESPACE) public interface PetShopService { String FUN_NAMESPACE = "demo.PetShop.PetShopService"; @Function void updatePetShops(List<PetShop> petShops); } 2、PetShopServiceImpl实现PetShopService接口并在updatePetShops增加@XAsync注解 package pro.shushi.pamirs.demo.core.service; import org.springframework.stereotype.Component; import pro.shushi.pamirs.demo.api.model.PetShop; import pro.shushi.pamirs.demo.api.service.PetShopService; import pro.shushi.pamirs.meta.annotation.Fun; import pro.shushi.pamirs.meta.annotation.Function; import pro.shushi.pamirs.trigger.annotation.XAsync; import java.util.List; @Fun(PetShopService.FUN_NAMESPACE) @Component public class PetShopServiceImpl implements PetShopService { @Override @Function @XAsync(displayName = "异步批量更新宠物商店",limitRetryNumber = 3,nextRetryTimeValue = 60) public void updatePetShops(List<PetShop> petShops) { new PetShop().updateBatch(petShops); } } a. displayName = "异步批量更新宠物商店",定义异步任务展示名称b. limitRetryNumber = 3,定义任务失败重试次数,,默认:-1不断重试c. nextRetryTimeValue = 60,定义任务失败重试的时间数,默认:3d. nextRetryTimeUnit,定义任务失败重试的时间单位,默认:TimeUnitEnum.SECONDe. delayTime,定义任务延迟执行的时间数,默认:0f. delayTimeUnit,定义任务延迟执行的时间单位,默认:TimeUnitEnum.SECOND 修改PetShopBatchUpdateAction调用异步任务 引入PetShopService 修改conform方法,调用petShopService.updatePetShops方法 package pro.shushi.pamirs.demo.core.action; @Model.model(PetShopBatchUpdate.MODEL_MODEL) @Component public class PetShopBatchUpdateAction { @Autowired private PetShopService petShopService; @Action(displayName = "确定",bindingType = ViewTypeEnum.FORM,contextType = ActionContextTypeEnum.SINGLE) public PetShopBatchUpdate conform(PetShopBatchUpdate data){ List<PetShop> shops = ArgUtils.convert(PetShopProxy.MODEL_MODEL, PetShop.MODEL_MODEL,proxyList); // 调用异步任务 petShopService.updatePetShops(shops); }); return data; } } 不同应用如何隔离执行单元 在schedule跟模块部署一起的时候,多模块独立boot的情况下,需要做必要的配置。如果schedule独立部署则没有必要,因为全部走远程,不存在类找不到的问题 通过配置pamirs.zookeeper.rootPath,确保两组机器都能覆盖所有任务分片,这样不会漏数据 通过pamirs.event.schedule.ownSign来隔离。确保两组机器只取各自产生的数据,这样不会重复执行数据 pamirs: zookeeper: zkConnectString: 127.0.0.1:2181 zkSessionTimeout: 60000 rootPath: /demo event: enabled: true schedule: enabled: true ownSign: demo rocket-mq: namesrv-addr: 127.0.0.1:9876

    2024年5月25日
    2.1K00
  • Oinone引入搜索引擎(增强模型)

    场景描述 在碰到大数据量并且需要全文检索的场景,我们在分布式架构中基本会架设ElasticSearch来作为一个常规解决方案。在oinone体系中增强模型就是应对这类场景,其背后也是整合了ElasticSearch; 使用前你应该 了解ElasticSearch,包括不限于:Index(索引)、分词、Node(节点)、Document(文档)、Shards(分片) & Replicas(副本)。参考官方网站:https://www.elastic.co/cn/ 有一个可用的ElasticSearch环境(本地项目能引用到) 前置约束 增强模型增量依赖数据变更实时消息,因此确保项目的event是开启的,mq配置正确。 项目引入搜索步骤 1、boot工程加入相关依赖包 boot工程需要指定ES客户端包版本,不指定版本会隐性依赖顶层spring-boot依赖管理指定的低版本 boot工程加入pamris-channel的工程依赖 <dependency> <groupId>org.elasticsearch.client</groupId> <artifactId>elasticsearch-rest-client</artifactId> <version>8.4.1</version> </dependency> <dependency> <groupId>jakarta.json</groupId> <artifactId>jakarta.json-api</artifactId> <version>2.1.1</version> </dependency> <dependency> <groupId>pro.shushi.pamirs.core</groupId> <artifactId>pamirs-sql-record-core</artifactId> </dependency> <dependency> <groupId>pro.shushi.pamirs.core</groupId> <artifactId>pamirs-channel-core</artifactId> </dependency> 2、api工程加入相关依赖包 在XXX-api中增加入pamirs-channel-api的依赖 <dependency> <groupId>pro.shushi.pamirs.core</groupId> <artifactId>pamirs-channel-api</artifactId> </dependency> 3、yml文件配置 在pamirs-demo-boot的application-dev.yml文件中增加配置pamirs.boot.modules增加channel,即在启动模块中增加channel模块。同时注意es的配置,是否跟es的服务一致 pamirs: record: sql: #改成自己本地路径(或服务器路径) store: /Users/oinone/record boot: modules: – channel ## 确保也安装了sql_record – sql_record channel: packages: # 增强模型扫描包配置 – com.xxx.xxx elastic: url: 127.0.0.1:9200 4、项目的模块增加模块依赖 XXXModule增加对ChannelModule的依赖 @Module(dependencies = {ChannelModule.MODULE_MODULE}) 5、增加增强模型(举例) package pro.shushi.pamirs.demo.api.enhance; import pro.shushi.pamirs.channel.enmu.IncrementEnum; import pro.shushi.pamirs.channel.meta.Enhance; import pro.shushi.pamirs.channel.meta.EnhanceModel; import pro.shushi.pamirs.demo.api.model.ShardingModel; import pro.shushi.pamirs.meta.annotation.Model; import pro.shushi.pamirs.meta.enmu.ModelTypeEnum; @Model(displayName = "测试EnhanceModel") @Model.model(ShardingModelEnhance.MODEL_MODEL) @Model.Advanced(type = ModelTypeEnum.PROXY, inherited = {EnhanceModel.MODEL_MODEL}) @Enhance(shards = "3", replicas = "1", reAlias = true,increment= IncrementEnum.OPEN) public class ShardingModelEnhance extends ShardingModel { public static final String MODEL_MODEL="demo.ShardingModelEnhance"; } 6、重启系统看效果 1、进入【传输增强模型】应用,访问增强模型列表我们会发现一条记录,并点击【全量同步】初始化ES,并全量dump数据 2、再次回到Demo应用,进入增强模型页面,可以正常访问并进增删改查操作 个性化dump逻辑 通常dump逻辑是有个性化需求,那么我们可以重写模型的synchronize方法,函数重写特性在“面向对象-继承与多态”部分中已经有详细介绍。 重写ShardingModelEnhance模型的synchronize方法 重写后,如果针对老数据记录需要把新增的字段都自动填充,可以进入【传输增强模型】应用,访问增强模型列表,找到对应的记录并点击【全量同步】 package pro.shushi.pamirs.demo.api.enhance; import pro.shushi.pamirs.channel.enmu.IncrementEnum; import pro.shushi.pamirs.channel.meta.Enhance; import pro.shushi.pamirs.channel.meta.EnhanceModel; import pro.shushi.pamirs.demo.api.model.ShardingModel; import pro.shushi.pamirs.meta.annotation.Field; import pro.shushi.pamirs.meta.annotation.Function; import pro.shushi.pamirs.meta.annotation.Model; import pro.shushi.pamirs.meta.enmu.FunctionTypeEnum; import pro.shushi.pamirs.meta.enmu.ModelTypeEnum; import java.util.List; @Model(displayName = "测试EnhanceModel") @Model.model(ShardingModelEnhance.MODEL_MODEL) @Model.Advanced(type = ModelTypeEnum.PROXY, inherited = {EnhanceModel.MODEL_MODEL}) @Enhance(shards = "3", replicas = "1", reAlias = true,increment= IncrementEnum.OPEN) public class ShardingModelEnhance extends ShardingModel { public static final String MODEL_MODEL="demo.ShardingModelEnhance"; @Field(displayName = "nick") private String nick;…

    2024年5月14日
    2.9K00
  • 工作流引入流程概览与流程监控

    流程概览依赖说明 使用 流程概览 功能前,需要在项目中引入 pamirs-workflow-datavi-core、 pamirs-data-visualization-core依赖,并启动datavi模块: <dependency> <groupId>pro.shushi.pamirs.workflow</groupId> <artifactId>pamirs-workflow-datavi-core</artifactId> </dependency> <dependency> <groupId>pro.shushi.pamirs.data.visualization</groupId> <artifactId>pamirs-data-visualization-core</artifactId> </dependency> 警告: 在 oinone 平台启用「流程概览」能力时,应用启动模块一旦引入 pamirs-workflow-api/core,必须同时引入 pamirs-workflow-datavi-api/core。在多启动模块架构下,严禁出现仅部分启动模块引入 pamirs-workflow-core 而未引入 pamirs-workflow-datavi-core 的情况,否则将导致流程概览相关元数据计算异常,出现删表等情况。 流程概览配置项 流程概览页面内置缓存机制,可通过配置项调整缓存刷新周期及图表展示的数据条数: pamirs: workflow: dashboard: cache-time: 10 # 流程概览缓存刷新时间(单位:分钟),默认 10 分钟 page-size: 10 # 流程运行分析中 4 个图表的展示数量,默认查询前 10 条数据 统计指标说明 引入 pamirs-workflow-datavi-core 依赖后,系统会按照以下规则进行数据同步: 当日数据同步:每小时同步一次当日数据; 昨日数据同步:次日凌晨同步前一日数据。 由于在引入依赖后才会开始执行数据同步,统计指标页提供了「同步」按钮,可用于对历史数据进行补采。即使不执行历史同步,也不会影响核心业务流程,仅会影响统计数据和图表的展示效果。 统计指标数据主要用于 支撑 流程概览 和 流程监控 中的统计图表展示; 为数据分析与可视化提供基础数据。 上述统计数据对工作流的审批、流转等核心业务无任何影响。如有需要,也可以基于流程监控的数据,配合数据可视化设计器,自定义构建符合业务需求的展示页面。

    2025年11月17日
    68600

Leave a Reply

Please Login to Comment