Oinone引入搜索引擎(增强模型)

场景描述

在碰到大数据量并且需要全文检索的场景,我们在分布式架构中基本会架设ElasticSearch来作为一个常规解决方案。在oinone体系中增强模型就是应对这类场景,其背后也是整合了ElasticSearch;

使用前你应该

  • 了解ElasticSearch,包括不限于:Index(索引)、分词、Node(节点)、Document(文档)、Shards(分片) & Replicas(副本)。参考官方网站:https://www.elastic.co/cn/
  • 有一个可用的ElasticSearch环境(本地项目能引用到)

前置约束

增强模型增量依赖数据变更实时消息,因此确保项目的event是开启的,mq配置正确。

项目引入搜索步骤

1、boot工程加入相关依赖包

  • boot工程需要指定ES客户端包版本,不指定版本会隐性依赖顶层spring-boot依赖管理指定的低版本
  • boot工程加入pamris-channel的工程依赖
<dependency>
    <groupId>org.elasticsearch.client</groupId>
    <artifactId>elasticsearch-rest-client</artifactId>
    <version>8.4.1</version>
</dependency>
<dependency>
    <groupId>jakarta.json</groupId>
    <artifactId>jakarta.json-api</artifactId>
    <version>2.1.1</version>
</dependency>

<dependency>
    <groupId>pro.shushi.pamirs.core</groupId>
    <artifactId>pamirs-sql-record-core</artifactId>
</dependency>
<dependency>
    <groupId>pro.shushi.pamirs.core</groupId>
    <artifactId>pamirs-channel-core</artifactId>
</dependency>

2、api工程加入相关依赖包

在XXX-api中增加入pamirs-channel-api的依赖

<dependency>
    <groupId>pro.shushi.pamirs.core</groupId>
    <artifactId>pamirs-channel-api</artifactId>
</dependency>

3、yml文件配置

在pamirs-demo-boot的application-dev.yml文件中增加配置pamirs.boot.modules增加channel,即在启动模块中增加channel模块。同时注意es的配置,是否跟es的服务一致

pamirs:
  record:
    sql:
      #改成自己本地路径(或服务器路径)
      store: /Users/oinone/record
  boot:
    modules:
      - channel
      ## 确保也安装了sql_record
      - sql_record
  channel:
    packages:
      # 增强模型扫描包配置
      - com.xxx.xxx
  elastic:
    url: 127.0.0.1:9200

4、项目的模块增加模块依赖

XXXModule增加对ChannelModule的依赖

@Module(dependencies = {ChannelModule.MODULE_MODULE})

5、增加增强模型(举例)

package pro.shushi.pamirs.demo.api.enhance;

import pro.shushi.pamirs.channel.enmu.IncrementEnum;
import pro.shushi.pamirs.channel.meta.Enhance;
import pro.shushi.pamirs.channel.meta.EnhanceModel;
import pro.shushi.pamirs.demo.api.model.ShardingModel;
import pro.shushi.pamirs.meta.annotation.Model;
import pro.shushi.pamirs.meta.enmu.ModelTypeEnum;

@Model(displayName = "测试EnhanceModel")
@Model.model(ShardingModelEnhance.MODEL_MODEL)
@Model.Advanced(type = ModelTypeEnum.PROXY, inherited = {EnhanceModel.MODEL_MODEL})
@Enhance(shards = "3", replicas = "1", reAlias = true,increment= IncrementEnum.OPEN)
public class ShardingModelEnhance extends ShardingModel {
    public static final String MODEL_MODEL="demo.ShardingModelEnhance";
}

6、重启系统看效果

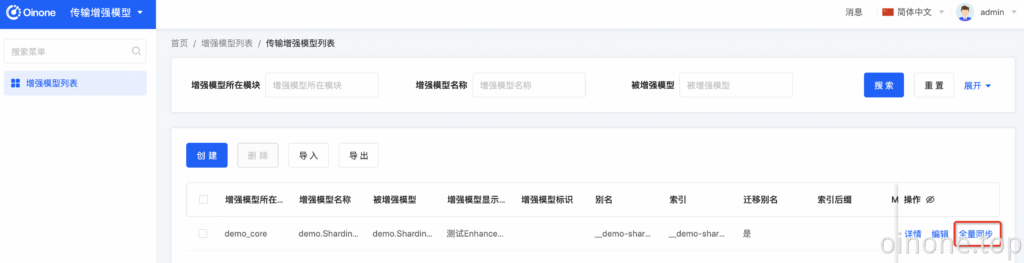
1、进入【传输增强模型】应用,访问增强模型列表我们会发现一条记录,并点击【全量同步】初始化ES,并全量dump数据
Oinone引入搜索引擎(增强模型)

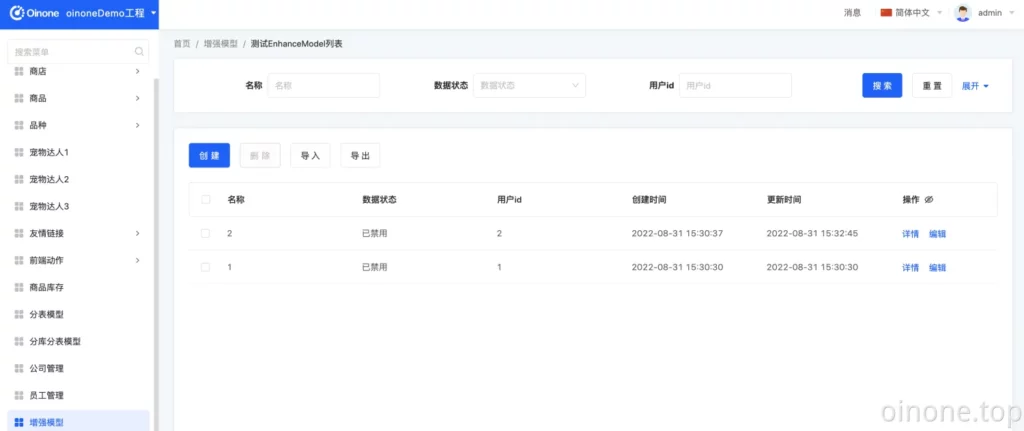
2、再次回到Demo应用,进入增强模型页面,可以正常访问并进增删改查操作
Oinone引入搜索引擎(增强模型)

个性化dump逻辑

通常dump逻辑是有个性化需求,那么我们可以重写模型的synchronize方法,函数重写特性在“面向对象-继承与多态”部分中已经有详细介绍。

重写ShardingModelEnhance模型的synchronize方法

重写后,如果针对老数据记录需要把新增的字段都自动填充,可以进入【传输增强模型】应用,访问增强模型列表,找到对应的记录并点击【全量同步】

package pro.shushi.pamirs.demo.api.enhance;

import pro.shushi.pamirs.channel.enmu.IncrementEnum;
import pro.shushi.pamirs.channel.meta.Enhance;
import pro.shushi.pamirs.channel.meta.EnhanceModel;
import pro.shushi.pamirs.demo.api.model.ShardingModel;
import pro.shushi.pamirs.meta.annotation.Field;
import pro.shushi.pamirs.meta.annotation.Function;
import pro.shushi.pamirs.meta.annotation.Model;
import pro.shushi.pamirs.meta.enmu.FunctionTypeEnum;
import pro.shushi.pamirs.meta.enmu.ModelTypeEnum;

import java.util.List;

@Model(displayName = "测试EnhanceModel")
@Model.model(ShardingModelEnhance.MODEL_MODEL)
@Model.Advanced(type = ModelTypeEnum.PROXY, inherited = {EnhanceModel.MODEL_MODEL})
@Enhance(shards = "3", replicas = "1", reAlias = true,increment= IncrementEnum.OPEN)
public class ShardingModelEnhance extends ShardingModel {
    public static final String MODEL_MODEL="demo.ShardingModelEnhance";

    @Field(displayName = "nick")
    private String nick;

    @Function.Advanced(displayName = "同步数据", type = FunctionTypeEnum.UPDATE)
    @Function(summary = "数据同步函数")
    public List<ShardingModelEnhance> synchronize(List<ShardingModelEnhance> data) {
        for(ShardingModelEnhance shardingModelEnhance:data){
            shardingModelEnhance.setNick(shardingModelEnhance.getName());
        }
        return data;
    }
}

给搜索增加个性化逻辑

如果我们需要在查询方法中增加逻辑,在前面的教程中一般是重写queryPage函数,但对于增强模型我们需要重写的是search函数。

个性化search函数

@Function(
        summary = "搜索函数",
        openLevel = {FunctionOpenEnum.LOCAL, FunctionOpenEnum.REMOTE, FunctionOpenEnum.API}
)
@pro.shushi.pamirs.meta.annotation.Function.Advanced(
        type = {FunctionTypeEnum.QUERY},
        category = FunctionCategoryEnum.QUERY_PAGE,
        managed = true
)
public  Pagination<ShardingModelEnhance> search(Pagination<ShardingModelEnhance> page, IWrapper<ShardingModelEnhance> queryWrapper) {
    System.out.println("您的个性化搜索逻辑");
    // return ((IElasticRetrieve) CommonApiFactory.getApi(IElasticRetrieve.class)).search(page, queryWrapper);
    return ((ElasticSearchApi) CommonApiFactory.getApi(ElasticSearchApi.class)).search(page, queryWrapper);
}

个性化search函数示例

    @Override
    @SuppressWarnings({"rawtypes"})
    public <T> Pagination<T> search(Pagination<T> page, IWrapper<T> queryWrapper) {
        String modelModel = queryWrapper.getModel();
        if (null == modelModel || modelModel.isEmpty()) {
            return page;
        }
        ModelConfig modelCfg = PamirsSession.getContext().getModelConfig(modelModel);
        if (null == modelCfg) {
            return page;
        }
        String rsql = queryWrapper.getOriginRsql();
        if (StringUtils.isBlank(rsql)) {
            rsql = "id>0";
        }
        BoolQuery.Builder queryBuilder = ElasticRSQLHelper.parseRSQL(modelCfg, rsql);
        TermQuery isDeletedTerm = QueryBuilders.term()
                .queryName(IS_DELETED)
                .field(IS_DELETED).value(0)
                .build();
        BoolQuery.Builder builder = QueryBuilders.bool().must(new Query(queryBuilder.build()));
        builder.must(new Query(isDeletedTerm));
        String alias = IndexNaming.aliasByModel(modelModel);
        Query query = new Query(builder.build());
        log.info("{}", query);

        List<Order> orders = Optional.ofNullable(page.getSort()).map(Sort::getOrders).orElse(new ArrayList<>());
        int currentPage = Optional.ofNullable(page.getCurrentPage()).orElse(1);
        Long size = Optional.ofNullable(page.getSize()).orElse(10L);
        int pageSize = size.intValue();
        List<SortOptions> sortOptions = new ArrayList<>();
        if (CollectionUtils.isEmpty(orders)) {
            orders.add(new Order(SortDirectionEnum.DESC, ID));
            orders.add(new Order(SortDirectionEnum.DESC, CREATE_DATE));
        }
        for (Order order : orders) {
            sortOptions.add(new SortOptions.Builder()
                    .field(SortOptionsBuilders.field()
                            .field(order.getField())
                            .order(SortDirectionEnum.DESC.equals(order.getDirection()) ? SortOrder.Desc : SortOrder.Asc)
                            .build())
                    .build());
        }

        SearchRequest request = new SearchRequest.Builder()
                .index(alias)
                .from((currentPage - 1) * pageSize)
                .size(pageSize)
                .sort(sortOptions)
                .query(query)
                .highlight(_builder ->
                        _builder.numberOfFragments(4)
                                .fragmentSize(50)
                                .type(HighlighterType.Unified)
                                .fields("name", HighlightField.of(_fieldBuilder -> _fieldBuilder.preTags(ElasticsearchConstant.HIGH_LIGHT_PREFIX).postTags(ElasticsearchConstant.HIGH_LIGHT_POSTFIX)))
                                .fields("documentNo", HighlightField.of(_fieldBuilder -> _fieldBuilder.preTags(ElasticsearchConstant.HIGH_LIGHT_PREFIX).postTags(ElasticsearchConstant.HIGH_LIGHT_POSTFIX)))
                                .fields("keywords", HighlightField.of(_fieldBuilder -> _fieldBuilder.preTags(ElasticsearchConstant.HIGH_LIGHT_PREFIX).postTags(ElasticsearchConstant.HIGH_LIGHT_POSTFIX))))
                .build();

        SearchResponse<HashMap> response = null;
        try {
            log.info("ES搜索请求参数:{}", request.toString());
            response = elasticsearchClient.search(request, HashMap.class);
        } catch (ElasticsearchException e) {
            log.error("索引异常", e);
            PamirsSession.getMessageHub()
                    .msg(Message.init()
                            .setLevel(InformationLevelEnum.WARN)
                            .msg("索引异常"));
            return page;
        } catch (IOException e) {
            log.error("ElasticSearch运行状态异常", e);
            PamirsSession.getMessageHub()
                    .msg(Message.init()
                            .setLevel(InformationLevelEnum.WARN)
                            .msg("ElasticSearch运行状态异常"));
            return page;
        }

        if (null == response || response.timedOut()) {
            return page;
        }

        HitsMetadata<HashMap> hits = response.hits();
        if (null == hits) {
            return page;
        }

        TotalHits totalHits = hits.total();
        long total = Optional.ofNullable(totalHits).map(TotalHits::value).orElse(0L);

        List<HashMap> dataMapList = Optional.of(hits)
                .map(HitsMetadata<HashMap>::hits)
                .map(hitsMap ->{
                    hitsMap.stream().forEach(highlightForEach -> {
                        highlightForEach.highlight().forEach((key, value) -> {
                            if(highlightForEach.source().containsKey(key)){
                                highlightForEach.source().put(key,value.get(0));
                            }
                        });

                    });
                    return hitsMap;
                })
                .map(List::stream)
                .orElse(Stream.empty())
                .map(Hit::source)
                .collect(Collectors.toList());

        List<T> context = persistenceDataConverter.out(modelModel, dataMapList);

        page.setSize(size);
        page.setTotalElements(total);
        page.setContent(context);
        log.info("ES搜索请求参数返回total,{}", total);
        return page;
    }

Oinone社区 作者:望闲原创文章,如若转载,请注明出处:https://doc.oinone.top/backend/7235.html

访问Oinone官网:https://www.oinone.top获取数式Oinone低代码应用平台体验

Like (0)
望闲's avatar望闲数式管理员
Previous 2024年5月14日 pm5:10
Next 2024年5月14日 pm10:15

相关推荐

  • 【后端】项目开发后端知识要点地图

    大类 明细 文档链接 平台基础 如何开发Action,理解前后端协议 如何开发Action,理解前后端协议 CDN配置及文件操作相关 OSS(CDN)配置和文件系统的一些操作 MINIO无公网访问地址下OSS的配置 MINIO无公网访问地址下OSS的配置 分库分表与自定义分表规则 分库分表与自定义分表规则 Oinone引入搜索引擎(增强模型) Oinone引入搜索引擎(增强模型) 引入搜索/增强模型Channel)常见问题解决办法 引入搜索(增强模型Channel)常见问题解决办法 框架之MessageHub(信息提示) 框架之MessageHub(信息提示) DsHint和BatchSizeHint的使用 DsHint(指定数据源)和BatchSizeHint(查询批次数量) Oinone连接外部数据源方案 Oinone连接外部数据源方案 如何自定义SQL(Mapper)语句 如何自定义SQL(Mapper)语句 IWrapper、QueryWrapper和LambdaQueryWrapper使用 IWrapper、QueryWrapper和LambdaQueryWrapper使用 如何在代码中使用自增ID、手动方式获取CODE 如何在代码中使用自增ID、手动方式获取CODE 函数之触发与定时配置和示例 函数之触发与定时配置和示例 函数之异步执行 函数之异步执行 查询时自定义排序字段和排序规则 查询时自定义排序字段和排序规则 非存储字段搜索 非存储字段搜索,适应灵活的搜索场景 枚举/二进制枚举/多值枚举 如何使用位运算的数据字典 全局首页及应用首页配置方法(homepage) 全局首页及应用首页配置方法(homepage) 缓存连接由Jedis切换为Lettuce 缓存连接由Jedis切换为Lettuce GraphQL请求:后端接口实现逻辑解析 GraphQL请求:后端接口实现逻辑解析 Nacos支持 Nacos作为注册中心 Oinone项目引入Nacos作为注册中心 Nacos作为配置中心 Oinone项目引入Nacos作为配置中心 Nacos做为注册中心调用SpringCloud服务 Nacos做为注册中心调用SpringCloud服务 分布式相关 如何构建分布式项目 Oinone如何支持构建分布式项目 构建分布式项目一些要点(dubbo日志关闭等) Oinone构建分布式项目一些注意点 信创支持 后端部署使用达梦数据库 【达梦】后端使用达梦数据库 后端部署使用PostgreSQL数据库 【PostgreSQL】后端使用PostgreSQL数据库 后端部署使用OpenGauss数据库 【OpenGauss】后端使用OpenGauss数据库 后端部署使用MSSQL数据库(SQLServer) 【MSSQL】后端部署使用MSSQL数据库(SQLServer) 东方通Web和Tomcat部署Oinone项目 东方通Web和Tomcat部署Oinone项目 常见扩展 如何增加用户中心的菜单 如何增加用户中心的菜单 导入导出 如何批量导入 如何批量导入 如何支持多Excel多个Sheet导入功能 如何支持多Excel多个Sheet导入功能 如何自定义Excel导入功能 如何自定义Excel导入功能 如何自定义Excel导出功能 如何自定义Excel导出功能 如何自定义表达式 如何自定义表达式 登录扩展 对接外部SSO Oinone登录扩展:对接SSO(4.7.8及之后的版本) 自定义占位符 自定义RSQL占位符及在权限中使用 自定义RSQL占位符(placeholder)及在权限中使用 自定义数据权限拦截处理 自定义数据权限拦截处理 设计器公共 后端无代码设计器Jar包启动方法 后端无代码设计器Jar包启动方法 界面设计器 页面跳转时增加跳转参数 页面跳转时增加跳转参数 界面设计器的导入导出 界面设计器的导入导出 流程设计器 项目中工作流引入和流程触发 项目中工作流引入和流程触发 流程扩展自定义函数示例代码汇总 工作流-流程扩展自定义函数示例代码汇总 工作流-流程代办等页面自定义 工作流-流程代办等页面自定义 审核撤回/回退/拒绝钩子使用 工作流审核撤回/回退/拒绝钩子使用 流程设计器的导入导出 流程设计器的导入导出 如何添加工作流运行时依赖 如何添加工作流运行时依赖 数据可视化 项目中图表设计器引入 数据可视化-项目中数据可视化的实现引入 自定义图表模版 数据可视化中图表的低无一体 图表设计器数据获取示例 数据可视化-数据可视化数据获取示例 如何添加数据可视化运行时依赖 如何添加数据可视化运行时依赖 图表设计器的设计数据导入导出 图表设计器的设计数据导入导出

    2024年5月21日
    3.2K00
  • 【Oracle】后端部署使用Oracle数据库

    Oracle数据库配置 驱动配置 jdbc仓库 https://mvnrepository.com/artifact/com.oracle.database.jdbc/ojdbc8 Maven配置(11g版本可用) <ojdbc.version>23.2.0.0</ojdbc.version> <dependency> <groupId>com.oracle.database.jdbc</groupId> <artifactId>ojdbc8</artifactId> <version>${ojdbc.version}</version> </dependency> JDBC连接配置 pamirs: datasource: base: type: com.alibaba.druid.pool.DruidDataSource driverClassName: oracle.jdbc.OracleDriver url: jdbc:oracle:thin:@//127.0.0.1:1521/orcl username: YOUR_SCHEMA_NAME password: xxxxxx Oracle默认为每个用户创建了一个与当前用户名同名的模式,每个用户应该只使用该模式(DBA用户除外),因此平台使用Oracle时应该通过username处指定与该模式同名的用户名来指定模式。(Oracle多数据源时每一个数据库创建一个用户) 创建用户时用户名应全大写。 连接url配置 官方文档 https://odbc.postgresql.org/docs/config-opt.html url格式 jdbc:oracle:thin:@//ip:端口号/服务名或SID 每一个Oracle进程默认为一个Oracle数据库实例,使用服务名或sid登录该Oralce数据库实例。一个Oracle sid 对应一个数据库实例,而一个服务名可以标识多个数据库实例。远程连接时推荐使用服务名进行连接。可以在安装Oracle的机器上打开SQLPlus,用SYSTEM用户登录上去后使用SELECT SYS_CONTEXT('USERENV', 'INSTANCE_NAME') AS SID FROM DUAL;查询登录使用的sid;也可以使用SELECT VALUE AS SERVICE_NAME FROM V$PARAMETER WHERE NAME = 'service_names';查询登录使用的服务名。 其他连接参数如需配置,可自行查阅相关资料进行调优。 方言配置 pamirs方言配置 pamirs: dialect: ds: base: type: Oracle version: 11.2 major-version: 11g pamirs: type: Oracle version: 11.2 major-version: 11g plus: configuration: jdbc-type-for-null: "NULL" using-model-as-property: true using-statement-handler-dialect: true mapper: batch: useAffectRows global: table-pattern: '${table_30}' column-pattern: '${column_30}' 数据库版本 type version majorVersion 11g – 11.2.0.1.0 Oracle 11.2 11g 12c – 12.2.0.1.0 Oracle 12.2 12c PS:由于方言开发环境为Oracle Database 11g Enterprise Edition Release 11.2.0.1.0版本,其他类似版本(11.2.x)原则上不会出现太大差异,如出现其他版本无法正常支持的,可在文档下方留言。 schedule方言配置 pamirs: event: enabled: true schedule: enabled: true dialect: type: Oracle version: 11.2 major-version: 11g 其他配置 逻辑删除的值配置 pamirs: mapper: global: table-info: logic-delete-value: (CAST(SYSTIMESTAMP AS DATE) – TO_DATE('1970-01-01 08:00:00', 'YYYY-MM-DD HH24:MI:SS')) * 8640000000000 Oracle数据库用户初始化及授权 — 以下命令均使用dba账户执行 — 创建用户 ONE_TEST (用户名需全大写) 密码 123456 CREATE USER ONE_TEST IDENTIFIED BY 123456; — 解锁用户 ALTER USER ONE_TEST ACCOUNT UNLOCK; — 将用户的默认表空间设置为USERS,临时表空间设置为TEMP ALTER USER ONE_TEST DEFAULT TABLESPACE USERS; ALTER USER ONE_TEST TEMPORARY TABLESPACE TEMP; — 可以用以下命令查询某用户的表空间: SELECT…

    2025年7月10日
    91900
  • IWrapper、QueryWrapper和LambdaQueryWrapper使用

    条件更新updateByWrapper 通常我们在更新的时候new一个对象出来在去更新,减少更新的字段 Integer update = new DemoUser().updateByWrapper(new DemoUser().setFirstLogin(Boolean.FALSE), Pops.<DemoUser>lambdaUpdate().from(DemoUser.MODEL_MODEL).eq(IdModel::getId, userId) 使用基础模型的updateById方法更新指定字段的方法: new 一下update对象出来,更新这个对象。 WorkflowUserTask userTaskUp = new WorkflowUserTask(); userTaskUp.setId(userTask.getId()); userTaskUp.setNodeContext(json); userTaskUp.updateById(); 条件删除updateByWrapper public List<T> delete(List<T> data) { List<Long> petTypeIdList = new ArrayList(); for(T item:data){ petTypeIdList.add(item.getId()); } Models.data().deleteByWrapper(Pops.<PetType>lambdaQuery().from(PetType.MODEL_MODEL).in(PetType::getId,petTypeIdList)); return data; } 构造条件查询数据 示例1: LambdaQueryWrapper拼接查询条件 private void queryPetShops() { LambdaQueryWrapper<PetShop> query = Pops.<PetShop>lambdaQuery(); query.from(PetShop.MODEL_MODEL); query.setSortable(Boolean.FALSE); query.orderBy(true, true, PetShop::getId); List<PetShop> petShops2 = new PetShop().queryList(query); System.out.printf(petShops2.size() + ""); } 示例2: IWrapper拼接查询条件 private void queryPetShops() { IWrapper<PetShop> wrapper = Pops.<PetShop>lambdaQuery() .from(PetShop.MODEL_MODEL).eq(PetShop::getId,1L); List<PetShop> petShops4 = new PetShop().queryList(wrapper); System.out.printf(petShops4.size() + ""); } 示例3: QueryWrapper拼接查询条件 private void queryPetShops() { //使用Lambda获取字段名,防止后面改字段名漏改 String nameField = LambdaUtil.fetchFieldName(PetTalent::getName); //使用Lambda获取Clumon名,防止后面改字段名漏改 String nameColumn = PStringUtils.fieldName2Column(nameField); QueryWrapper<PetShop> wrapper2 = new QueryWrapper<PetShop>().from(PetShop.MODEL_MODEL) .eq(nameColumn, "test"); List<PetShop> petShops5 = new PetShop().queryList(wrapper2); System.out.printf(petShops5.size() + ""); } IWrapper转为LambdaQueryWrapper @Function.Advanced(type= FunctionTypeEnum.QUERY) @Function.fun(FunctionConstants.queryPage) @Function(openLevel = {FunctionOpenEnum.API}) public Pagination<PetShopProxy> queryPage(Pagination<PetShopProxy> page, IWrapper<PetShopProxy> queryWrapper) { LambdaQueryWrapper<PetShopProxy> wrapper = ((QueryWrapper<PetShopProxy>) queryWrapper).lambda(); // 非存储字段从QueryData中获取 Map<String, Object> queryData = queryWrapper.getQueryData(); if (null != queryData && !queryData.isEmpty()) { String codes = (String) queryData.get("codes"); if (org.apache.commons.lang3.StringUtils.isNotBlank(codes)) { wrapper.in(PetShopProxy::getCode, codes.split(",")); } } return new PetShopProxy().queryPage(page, wrapper); }

    2024年5月25日
    3.3K00
  • Oinone离线部署设计器JAR包

    概述 Oinone平台为合作伙伴提供了多种部署方式,这篇文章将介绍如何在私有云环境部署Oinone平台JAR包。 本文以5.2.6版本为例进行介绍。 部署环境要求 包含全部中间件及设计器服务的环境要求 CPU:8 vCPU 内存(RAM):16G以上 硬盘(HDD/SSD):60G以上 仅设计器服务的环境要求 CPU:8 vCPU 内存(RAM):8G以上 硬盘(HDD/SSD):40G以上 部署准备 在部署环境创建部署目录 mkdir -p /home/admin/oinone-designer PS:为方便管理,所有Oinone部署所需文件都应该在该目录下存放。 服务器需要安装的中间件 JDK:jdk_1.8_221版本以上 下载地址 MySQL:8.0.26版本以上 下载地址 Redis:5.0.2版本以上 下载地址 安装教程 Zookeeper:3.5.8版本以上 下载地址 安装教程 Nginx:任意版本(推荐使用源码编译安装方式,并开启rewrite、https等功能模块) Linux安装教程 下载地址 使用Docker启动所有中间件 点击下载一键部署所有中间件套件包 middleware-kits.zip 部署清单 下面列举了文章中在本地环境操作结束后的全部文件: 设计器JAR包:pamirs-designer-boot-v5.2-5.2.6.jar 离线部署结构包:oinone-designer-jar-offline.zip 第三方数据库驱动包(非MySQL数据库必须) PS:如需一次性拷贝所有部署文件到部署环境,可以将文档步骤在本地环境执行后,一次性将所有文件进行传输。 在本地环境准备部署文件 下载离线部署结构包 oinone-designer-jar-offline.zip 下载部署JAR包 5.2.6版本发布日志 查看更多版本 找到独立部署所有设计器JAR标题,下面有对应的JAR包提供下载。 例如:https://oinone-jar.oss-cn-zhangjiakou.aliyuncs.com/install/oinone-designer/pamirs-designer-boot-v5.2-5.2.6.jar 后端服务部署 将部署JAR包移动到backend目录下,并重命名为oinone-designer.jar mv pamirs-designer-boot-v5.2-5.2.6.jar backend/oinone-designer.jar PS:该名称为startup.sh脚本的默认值,可根据实际情况自行修改 将Pamirs许可证移动到backend/config目录下,并重命名为license.lic mv oinone-demo_1730163770607.lic backend/config/license.lic 加载非MySQL数据库驱动(按需) 将驱动jar文件移动到backend/lib目录下即可。 以KDB8数据库驱动kingbase8-8.6.0.jar为例 mv kingbase8-8.6.0.jar backend/lib/ PS:backend/lib目录为非设计器内置包的外部加载目录(外部库),可以添加任何jar包集成到设计器中。 修改backend/startup.sh脚本 IP:修改为可被外部访问的IP地址 DB_BASE_:base库相关数据库连接配置 DB_PAMIRS_:pamirs库相关数据库连接配置 REDIS_:Redis相关配置 MQ_NAME_SERVER:RocketMQ的name-server连接地址 ZOOKEEPER_:Zookeeper相关配置 PS:若需要配置方言或其他参数,可直接修改backend/config/application.yml配置文件,变量仅用于简单配置场景 执行startup.sh脚本启动 sh startup.sh 执行完成后会打印三个路径 后端路径:backend root path: /path/to/backend 前端路径:frontend root path: /path/to/frontend Nginx配置路径:nginx services path: /path/to/nginx Nginx配置 在本地nginx服务中找到nginx.conf,并添加Nginx配置路径为加载目录 http { … include /path/to/nginx/*.conf; } 修改结构包中的default.conf第7行root配置为前端路径到dist目录下 server { … root /path/to/frontend/dist; } 修改结构包中的oss.conf第30行alias配置为前端路径到static目录下 server { … location /static { … alias /path/to/frontend/static; } } 访问服务 使用http://127.0.0.1:9090访问服务

    2024年11月1日
    1.9K00
  • 如何选择适合的模型类型?

    介绍 通过Oinone 7天从入门到精通的模型的类型章节我们可以知道模型有抽象模型、存储模型、代理模型、传输模型这四种。但是在在定义模型的时候我们可能不知道该如何选择类型,下面结合业务场景为大家讲解几种模型的典型使用场景。 抽象模型 抽象模型往往是提供公共能力和字段的模型,它本身不会直接用于构建协议和基础设施(如表结构等)。 场景:猫、鸟都继承自动物这个抽象模型 package pro.shushi.pamirs.demo.api.model; import pro.shushi.pamirs.meta.annotation.Field; import pro.shushi.pamirs.meta.annotation.Model; import pro.shushi.pamirs.meta.annotation.sys.Base; import pro.shushi.pamirs.meta.base.IdModel; import pro.shushi.pamirs.meta.enmu.ModelTypeEnum; @Base @Model.model(AbstractAnimal.MODEL_MODEL) @Model.Advanced(type = ModelTypeEnum.ABSTRACT) @Model(displayName = "动物") public abstract class AbstractAnimal extends IdModel { public static final String MODEL_MODEL = "demo.AbstractAnimal"; @Field.String @Field(displayName = "名称") private String name; @Field.String @Field(displayName = "颜色") private String color; } package pro.shushi.pamirs.demo.api.model; import pro.shushi.pamirs.meta.annotation.Field; import pro.shushi.pamirs.meta.annotation.Model; @Model.model(Cat.MODEL_MODEL) @Model(displayName = "猫") public class Cat extends AbstractAnimal { private static final long serialVersionUID = -5104390780952634397L; public static final String MODEL_MODEL = "demo.Cat"; @Field.Integer @Field(displayName = "尾巴长度") private Integer tailLength; } package pro.shushi.pamirs.demo.api.model; import pro.shushi.pamirs.meta.annotation.Field; import pro.shushi.pamirs.meta.annotation.Model; @Model.model(Bird.MODEL_MODEL) @Model(displayName = "鸟") public class Bird extends AbstractAnimal { private static final long serialVersionUID = -5144390780952634397L; public static final String MODEL_MODEL = "demo.Bird"; @Field.Integer @Field(displayName = "翼展宽度") private Integer wingSpanWidth; } 存储模型 存储模型用于定义数据表结构和数据的增删改查(数据管理器)功能,是直接与连接器进行交互的数据容器。 场景:存储模型对应传统开发模式中的数据表,上面例子中的Cat和Birdd都属于传输模型,由于模型定义的注解@Model.Advanced(type = ModelTypeEnum.STORE)默认值就是存储模型,所以一般不用手动指定 代理模型 代理模型是用于代理存储模型的数据管理器能力,同时又可以扩展出非存储数据信息的交互功能的模型。 场景一:隔离数据权限 场景二:增强列表的搜索项 场景三:导入导出的时候增加其他特殊信息 场景四:重写下拉组件的查询逻辑做数据过滤 传输模型 传输模型不会在数据库生成的表,只是作为数据的传输使用,跟传统开发模式中的DTO有一点相似。 场景一:批量处理数据 场景二:处理一些跟数据表无关的操作,如:清理指定业务的缓存、查看一些系统监控信息,可以根据业务信息建立对应的传输模型,在传输模型上创建action动作 场景三:通过传输模型完成复杂页面数据传输

    2024年4月7日
    2.0K00

Leave a Reply

Please Login to Comment