
Oinone协同开发使用手册

概述

Oinone平台为开发人员提供了本地环境 - 测试环境之间的协同开发模式,可以使得开发人员在本地环境中设计的模型、函数等元数据实时被测试环境使用并设计。开发人员开发完成对应页面和功能后,可以部署至测试环境直接进行测试。

本篇文章将详细介绍协同开发模式在实际开发中的应用及相关内容。

名词解释

  • 本地环境: 开发人员的本地启动环境
  • 测试环境: 在测试服务器上部署的业务测试环境,业务工程服务和设计器服务共用中间件
  • 业务工程服务:在测试服务器上部署的业务工程
  • 设计器服务: 在测试服务器上部署的设计器镜像
  • 一套环境:以测试环境为例,业务工程服务和设计器服务共同组成一套环境
  • 生产环境: 在生产服务器上部署的业务生产环境

环境准备

  1. 部署了一个可用的设计器服务,并能正常访问。(需参照下文启动设计器环境内容进行相应修改)
  2. 准备一个用于开发的java工程。
  3. 准备一个用于部署测试环境的服务器。

协同参数介绍

用于测试环境的参数

-PmetaProtected=${value}

启用元数据保护,只有配置相同启动参数的服务才允许对元数据进行更新。通常该命令用于设计器服务和业务工程服务,并且两个环境需使用相同的元数据保护标记(value)进行启动。本地环境不使用该命令,以防止本地环境在协同开发时意外修改测试环境元数据,导致元数据混乱。

用法

java -jar boot.jar -PmetaProtected=pamirs

用于本地环境的配置

  • 使用命令配置ownSign(推荐)
java -jar boot.jar --pamirs.distribution.session.ownSign=demo
  • 使用yaml配置ownSign
pamirs:
  distribution:
    session:
      allMetaRefresh: false # 启用元数据全量刷新(备用配置,如遇元数据错误或混乱,启用该配置可进行恢复,使用一次后关闭即可)
      ownSign: demo # 协同开发元数据隔离标记,用于区分不同开发人员的本地环境,其他环境不允许使用

启动设计器环境

docker-run启动

-e PROGRAM_ARGS=-PmetaProtected=pamirs

docker-compose启动

services:
  backend:
    container_name: designer-backend
    image: harbor.oinone.top/oinone/designer-backend-v5.0
    restart: always
    environment:
      # 指定spring.profiles.active
      ARG_ENV: dev
      # 指定-Plifecycle
      ARG_LIFECYCLE: INSTALL
      # jvm参数
      JVM_OPTIONS: ""
      # 程序参数
      PROGRAM_ARGS: "-PmetaProtected=pamirs"

PS: java [JVM_OPTIONS?] -jar boot.jar [PROGRAM_ARGS?]

开发流程示例图
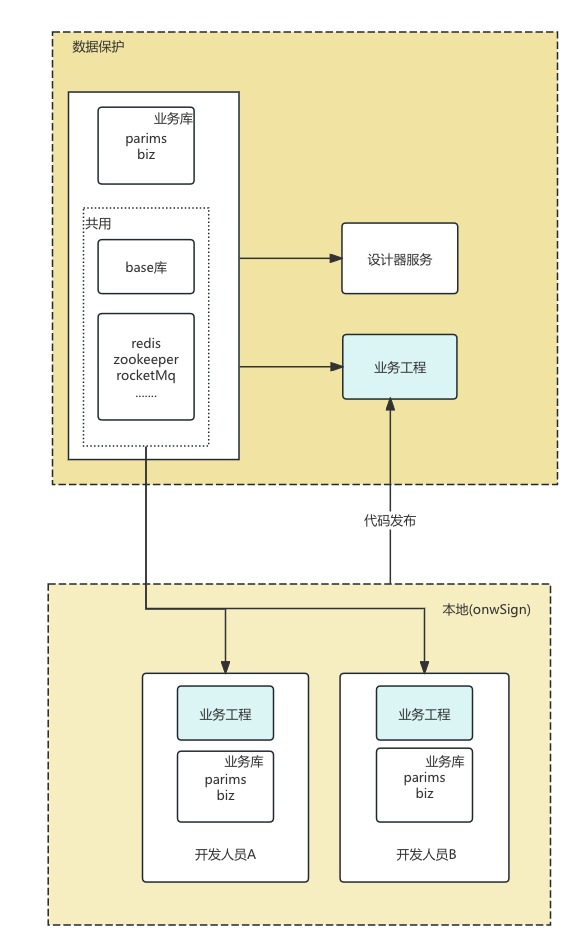
Oinone协同开发使用手册

具体使用步骤详见协同开发支持

Oinone社区 作者:张博昊原创文章,如若转载,请注明出处:https://doc.oinone.top/backend/14878.html

访问Oinone官网:https://www.oinone.top获取数式Oinone低代码应用平台体验

Like (0)
张博昊's avatar张博昊数式管理员
Previous 2024年7月23日 pm5:41
Next 2024年7月24日 pm1:49

相关推荐

  • Excel导入扩展点-整体导入(批量导入)

    1、【导入】在有些场景,需要获取Excel导入的整体数据,进行批量的操作或者校验 可以通过实现导入扩展点的方式实现,入参data是导入Excel的数据列表;业务可以根据实际情况进行数据校验 1)Excel模板定义,需要设置setEachImport(false) 2)导入扩展点API定义 pro.shushi.pamirs.file.api.extpoint.ExcelImportDataExtPoint#importData 3)示例代码参考: pro.shushi.pamirs.translate.extpoint.ResourceTranslationImportExtPoint#importData @Slf4j @Component @Ext(ExcelImportTask.class) public class ResourceTranslationImportExtPoint extends AbstractExcelImportDataExtPointImpl<List<ResourceTranslationItem>> { @Override //TODO 表达式,可以自定义,比如可以支持1个模型的多个【导入名称】的不同模板 @ExtPoint.Implement(expression = "importContext.definitionContext.model==\"" + ResourceTranslation.MODEL_MODEL + "\"") public Boolean importData(ExcelImportContext importContext, List<ResourceTranslationItem> dataList) { //TODO dataList就是excel导入那个sheet的所有内容 return true; } } 2、【导入】逐行导入的时候做事务控制 在模板中定义中增加事务的定义,并设置异常后回滚。参加示例代码: excel模板定义 @Component public class DemoItemImportTemplate implements ExcelTemplateInit { public static final String TEMPLATE_NAME = "商品导入模板"; @Override public List<ExcelWorkbookDefinition> generator() { //定义事务(导入处理中,只操作单个表的不需要事务定义。) //是否定义事务根据实际业务逻辑确定。比如:有些场景在导入前需要删除数据后在进行导入就需要定义事务 InitializationUtil.addTxConfig(DemoItem.MODEL_MODEL, ExcelDefinitionContext.EXCEL_TX_CONFIG_PREFIX + TEMPLATE_NAME); return Collections.singletonList( ExcelHelper.fixedHeader(DemoItem.MODEL_MODEL, TEMPLATE_NAME) .setType(ExcelTemplateTypeEnum.IMPORT) .createSheet("商品导入-sheet1") .createBlock(DemoItem.MODEL_MODEL) .addUnique(DemoItem.MODEL_MODEL,"name") .addColumn("name","名称") .addColumn("description","描述") .addColumn("itemPrice","单价") .addColumn("inventoryQuantity","库存") .build().setEachImport(true) //TODO 设置异常后回滚的标识,这个地方会回滚事务 .setHasErrorRollback(true) .setExcelImportMode(ExcelImportModeEnum.SINGLE_MODEL) ); } } 导入逻辑处理 @Slf4j @Component @Ext(ExcelImportTask.class) public class DemoItemImportExtPoint extends AbstractExcelImportDataExtPointImpl<DemoItem> implements ExcelImportDataExtPoint<DemoItem> { @Autowired private DemoItemService demoItemService; @Override @ExtPoint.Implement(expression = "importContext.definitionContext.model == \"" + DemoItem.MODEL_MODEL + "\"") public Boolean importData(ExcelImportContext importContext, DemoItem data) { ExcelImportTask importTask = importContext.getImportTask(); try { DemoItemImportTask hrExcelImportTask = new DemoItemImportTask().queryById(importTask.getId()); String publishUserName = Optional.ofNullable(hrExcelImportTask).map(DemoItemImportTask::getPublishUserName).orElse(null); data.setPublishUserName(publishUserName); demoItemService.create(data); } catch(PamirsException e) { log.error("导入异常", e); } catch (Exception e) { log.error("导入异常", e); } return Boolean.TRUE; } }

    2023年12月7日
    2.2K00
  • 问题排查调试工具使用手册

    当前端发起对应用的访问时,如果出现错误,那么我们可以通过以下方式进行简易排查,如果排查不出来,则也可以把排查工具给出的信息发送给Oinone官方售后进行进一步分析。本文将通过模拟异常信息,来介绍排查工具,提供了哪些辅助信息帮我们来快速定位问题。 排查工具基础介绍 通过前端页面的 /debug 路由路径访问调试工具的页面,假设我们的前端页面访问地址为http://localhost:6800,那么我们的排查工具请求路径就是 http://localhost:6800/debug排查工具可以帮我们排查前端页面元数据异常和后端接口的异常 排查前端页面元数据 将问题页面浏览器地址栏内 page 后的部分复制到调试工具的 debug 路由后重新发起请求,如图可以看到调试工具展示的信息,可以根据这些信息排查问题。 排查后端接口 后端接口出现问题后,打开(在原页面)浏览器的调试工具,切换到“网络”的标签页,在左侧的历史请求列表中找到需要调试的请求,右键会弹出菜单,点击菜单中的 “复制”,再次展开该菜单,点击二级菜单中的“以 fetch 格式复制”,这样可以复制到调试所需要的信息 2.复制调试信息到“接口调试”标签页内的文本框内,点击“发起请求”按钮获取调试结果 我们可以看到页面展示了该接口的各种调试信息,我们可以据此排查问题。 场景化的排查思路 业务代码中存在代码bug 报错后发起调试请求,我们可以看到,调试工具直接给出了异常抛出的具体代码所在位置,此时再切换到“全部堆栈”下,可以看到是业务类的233行导致的空指针异常,查看代码后分析可得是data.getName().eqauls方法在调用前未做条件判断补全该判断后代码可以正常执行 业务代码中没有直接的错误,异常在平台代码中抛出 报错后发起调试请求可以看到异常不在业务代码内再切换到“全部堆栈”,可以看到具体异常信息,提示core_demo_item表出现了重复的主键,该表是DemoItem模型的我们还可以切换到“sql调试”的标签页,可以看到出错的具体sql语句经过分析可以得知是240行的data.create()�重复创建数据导致的。 三、排查工具无法定位怎么办 当我们通过排查工具还是没有定位到问题的时候,可以通过调试页面的“下载全部调试数据”和“下载调试数据”按钮将调试信息的数据发送给官方售后人员帮助我们定位排查问题。 点击页面最顶部的“下载全部调试数据”按钮,可以下载页面调试数据和接口调试数据点击“调试接口”标签页内的“下载调试数据”按钮,可以下载接口调试数据 四、排查工具细节

    2024年5月21日
    3.2K00
  • Oinone环境保护(v5.2.3以上)

    概述 Oinone平台为合作伙伴提供了环境保护功能,以确保在一套环境可以在较为安全前提下修改配置文件,启动多个JVM等部署操作。 本章内容主要介绍与环境保护功能相关的启动参数。 名词解释 本地开发环境:开发人员在本地启动业务工程的环境 公共环境:包含设计器镜像和业务工程的环境 环境保护参数介绍 【注意】参数是加在程序实参 (Program arguments)上,通常可能错误的加在Active Profiles上了 -PenvProtected=${value} 是否启用环境保护,默认为true。 环境保护是通过与最近一次保存在数据库的base_platform_environment表中数据进行比对,并根据每个参数的配置特性进行判断,在启动时将有错误的内容打印在启动日志中,以便于开发者进行问题排查。 除此之外,环境保护功能还提供了一些生产配置的优化建议,开发者可以在启动时关注这些日志,从而对生产环境的配置进行调优。 -PsaveEnvironments=${value} 是否将此次启动的环境参数保存到数据库,默认为true。 在某些特殊情况下,为了避免公共环境中的保护参数发生不必要的变化,我们可以选择不保存此次启动时的配置参数到数据库中,这样就不会影响其他JVM启动时发生校验失败而无法启动的问题。 -PstrictProtected=${value} 是否使用严格校验模式,默认为false 通常我们建议在公共环境启用严格校验模式,这样可以最大程度的保护公共环境的元数据不受其他环境干扰。 PS:在启用严格校验模式时,需避免内外网使用不同连接地址的场景。如无法避免,则无法启用严格校验模式。 常见问题 需要迁移数据库,并更换了数据库连接地址该如何操作? 将原有数据库迁移到新数据库。 修改配置文件中数据库的连接地址。 在启动脚本中增加-PenvProtected=false关闭环境保护。 启动JVM服务可以看到有错误的日志提示,但不会中断本次启动。 移除启动脚本中的-PenvProtected=false或将值改为true,下次启动时将继续进行环境保护检查。 可查看数据库中base_platform_environment表中对应数据库连接配置已发生修改,此时若其他JVM在启动前未正确修改,则无法启动。 本地开发时需要修改Redis连接地址到本地,但希望不影响公共环境的使用该如何操作? PS:由于Redis中的元数据缓存是根据数据库差量进行同步的,此操作会导致公共环境在启动时无法正确刷新Redis中的元数据缓存,需要配合pamirs.distribution.session.allMetaRefresh参数进行操作。如无特殊必要,我们不建议使用该形式进行协同开发,多次修改配置会导致出错的概率增加。 本地环境首次启动时,除了修改Redis相关配置外,还需要配置pamirs.distribution.session.allMetaRefresh=true,将本地新连接的Redis进行初始化。 在本地启动时,增加-PenvProtected=false -PsaveEnvironments=false启动参数,以确保本地启动不会修改公共环境的配置,并且可以正常通过环境保护检测。 本地环境成功启动并正常开发功能后,需要发布到公共环境进行测试时,需要先修改公共环境中业务工程配置pamirs.distribution.session.allMetaRefresh=true后,再启动业务工程。 启动一次业务工程后,将配置还原为pamirs.distribution.session.allMetaRefresh=false。

    2024年10月21日
    2.4K00
  • 后端代码规范

    前言 虽然oinone框架减少了很多的代码,但是低代码部分的代码质量也需要高度关注,不管是写的代码bug多,或者说被吐槽代码不行,还是说写的代码经常被重构,核心点还是没有代码规范的意识和技巧,下面摘录了一些常见的规范要求,去提高后端的代码质量,代码质量提高后,自然效率也会提升。 常见代码规范 **1、规范命名** 命名是写代码中最频繁的操作,比如类、属性、方法、参数等。好的名字应当能遵循以下几点: **见名知意** 比如需要定义一个变量需要来计数 int i = 0; 名称 i 没有任何的实际意义,没有体现出数量的意思,所以我们应当指明数量的名称 int count = 0; **能够读的出来** 如下代码: private String sfzh; private String dhhm; 这些变量的名称,根本读不出来,更别说实际意义了。 所以我们可以使用正确的可以读出来的英文来命名 private String idCardNo; private String phone; **2、规范代码格式** 好的代码格式能够让人感觉看起来代码更加舒适。 好的代码格式应当遵守以下几点: 合适的空格 代码对齐,比如大括号要对齐 及时换行,一行不要写太多代码 好在现在开发工具支持一键格式化,可以帮助美化代码格式,大家统一使用idea的规范即可。 **3、写好代码注释** 在《代码整洁之道》这本书中作者提到了一个观点,注释的恰当用法是用来弥补我们在用代码表达意图时的失败。换句话说,当无法通过读代码来了解代码所表达的意思的时候,就需要用注释来说明。 书的作者之所以这么说,是因为作者觉得随着时间的推移,代码可能会变动,如果不及时更新注释,那么注释就容易产生误导,偏离代码的实际意义。而不及时更新注释的原因是,程序员不喜欢写注释。😒 但是这不意味着可以不写注释,当通过代码如果无法表达意思的时候,就需要注释,比如如下代码: for (Integer id : ids) { if (id == 0) { continue; } //做其他事 } 为什么 id == 0 需要跳过,代码是无法看出来了,就需要注释了。 好的注释应当满足一下几点: 解释代码的意图,说明为什么这么写,用来做什么 对参数和返回值注释,入参代表什么,出参代表什么 有警示作用,比如说入参不能为空,或者代码是不是有坑 当代码还未完成时可以使用 todo 注释来标记 代码review发现漏洞时 可以使用 fixme 注释来标记 **4、try catch 内部代码抽成一个方法** try catch代码有时会干扰我们阅读核心的代码逻辑,这时就可以把try catch内部主逻辑抽离成一个单独的方法 如下图是Eureka服务端源码中服务下线的实现中的一段代码 整个方法非常长,try中代码是真正的服务下线的代码实现,finally可以保证读锁最终一定可以释放。 所以这段代码其实就可以对核心的逻辑进行抽取。 protected boolean internalCancel(String appName, String id, boolean isReplication) { try { read.lock(); doInternalCancel(appName, id, isReplication); } finally { read.unlock(); } // 剩余代码 } private boolean doInternalCancel(String appName, String id, boolean isReplication) { //真正处理下线的逻辑 } **5、方法别太长** 方法别太长就是字面的意思。一旦代码太长,给人的第一眼感觉就很复杂,让人不想读下去; 同时方法太长的代码可能读起来容易让人摸不着头脑,不知道哪一些代码是同一个业务的功能。 比如代码中有那种2000+行大类,各种if else判断,光理清代码思路就需要用很久时间。🤷🏻‍♀️ 所以一旦方法过长,可以尝试将相同业务功能的代码单独抽取一个方法,最后在主方法中调用即可。 **6、抽取重复代码** 当一份代码重复出现在程序的多处地方,就会造成程序又臭又长,当这份代码的结构要修改时,每一处出现这份代码的地方都得修改,导致程序的扩展性很差。 所以一般遇到这种情况,可以抽取成一个工具类,还可以抽成一个公共的父类。 **7、多用return** 在有时我们平时写代码的情况可能会出现if条件套if的情况,当if条件过多的时候可能会出现如下情况: if (条件1) { if (条件2) { if (条件3) { if (条件4) { if (条件5) { System.out.println("11111"); } } } } } 面对这种情况,可以换种思路,使用return来优化 if (!条件1) { return; } if (!条件2) { return; } if (!条件3) { return; } if (!条件4) { return; } if (!条件5) { return; } System.out.println("11111"); 这样优化就感觉看起来更加直观 **8、if条件表达式不要太复杂**…

    2024年12月11日
    3.2K00
  • 标品实施:从标品构建到定制(扩展)包的开发

    总体描述 Oinone有一个非常重要的特性:通过平台承载标准化产品(标品)。针对不同客户的个性化需求,不再直接修改标准产品代码,而是以扩展包的形式进行扩展和定制化,通过继承和重写标准产品的能力来满足客户需求。 本文讲解述怎么通过标品构建扩展工程的过程。 构建标品 按照Oinone的规范构建标品工程 构建扩展包 在定制模块中指定上游模块 上游依赖模块upstreams,模块定义如下: @Target({ElementType.TYPE}) @Retention(RetentionPolicy.RUNTIME) public @interface Module { // 显示名称 @AliasFor("displayName") String value() default ""; // 依赖模块名列表 String[] dependencies() default ModuleConstants.MODULE_BASE; // 上游模块名列表 String[] upstreams() default {}; …… 扩展模块示例 @Component @Module( name = SecondModule.MODULE_NAME, displayName = "DEMO扩展", version = "1.0.0", // 指定上游模块(标品模块,可以为多个) upstreams = DemoModule.MODULE_MODULE, priority = 1, dependencies = {ModuleConstants.MODULE_BASE, CommonModule.MODULE_MODULE, UserModule.MODULE_MODULE, AuthModule.MODULE_MODULE, BusinessModule.MODULE_MODULE, // 上游模块(标品模块,可以为多个) DemoModule.MODULE_MODULE, } ) @Module.module(SecondModule.MODULE_MODULE) @Module.Advanced(selfBuilt = true, application = true) @UxHomepage(@UxRoute(model = WorkRecord.MODEL_MODEL)) public class SecondModule implements PamirsModule { public static final String MODULE_MODULE = "demo_core_ext"; public static final String MODULE_NAME = "DemoCoreExt"; @Override public String[] packagePrefix() { return new String[]{ "pro.shushi.pamirs.second" }; } } application.yml配置文件 pamirs: boot: modules: ….. – demo_core // 加标准工程 – demo_core_ext maven配置 父工程依赖 <dependencyManagement> <dependencies> ….. <dependency> <groupId>pro.shushi.pamirs.demo</groupId> <artifactId>pamirs-demo-api</artifactId> <version>1.0.0-SNAPSHOT</version> </dependency> <dependency> <groupId>pro.shushi.pamirs.demo</groupId> <artifactId>pamirs-demo-core</artifactId> <version>1.0.0-SNAPSHOT</version> </dependency> ….. </dependencies> </dependencyManagement> api子工程加入依赖 <dependency> <groupId>pro.shushi.pamirs.demo</groupId> <artifactId>pamirs-demo-api</artifactId> </dependency> boot子工程加入依赖 <dependency> <groupId>pro.shushi.pamirs.demo</groupId> <artifactId>pamirs-demo-core</artifactId> </dependency> 数据库设置 base数据库要跟标品工程一致 注意事项 标品工程的第三方依赖,在扩展工程都要有,否则启动会报错 扩展模块功能开发 菜单扩展 1、可以按需隐藏标品的菜单; 2、可以根据扩展包的实际情况增加菜单; 模型扩展 1、扩展包可继承标品已有模型; 新增字段、覆盖字段,不继承 2、扩展包可根据实际情况新增自有模型; 函数扩展 1、扩展包可根据实际情况【覆写】标品中的函数; 2、扩展包可根据实际情况【新增】自有函数; 3、扩展包可通过Hook机制实现业务的个性化; 4、扩展包可根据自身业务情况实现标品中的扩展点; 5、……

    2024年6月1日
    3.2K00

Leave a Reply

Please Login to Comment