环境运行时Jar版本控制

环境运行时Jar版本控制

前景

为了避免基于低代码定义产生的元数据错乱。因此产生了运行时Jar版本检查功能。

现象

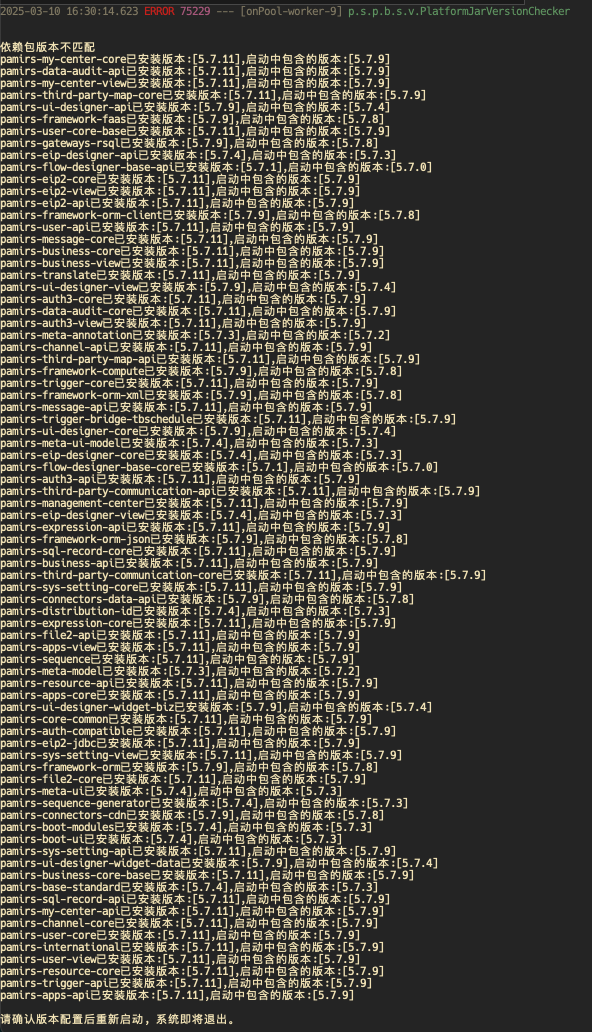
如果当前运行时依赖的Ja版本低于已安装版本,启动时会有如下类似信息提示:
环境运行时Jar版本控制

解决

  1. 按照提示升级依赖Jar版本
  2. 通过启动参数 -PgoBack=true 强制覆盖安装当前运行时版本
    • java -jar 方式
      java -jar xxx.jar -PgoBack=true [其他参数]
    • mvn spring-boot run 方式
      mvn clean compile spring-boot:run -Dspring-boot.run.arguments="-PgoBack=true [其他参数]"

Oinone社区 作者:yakir原创文章,如若转载,请注明出处:https://doc.oinone.top/backend/20619.html

访问Oinone官网:https://www.oinone.top获取数式Oinone低代码应用平台体验

Like (0)
yakir's avataryakir数式员工
Previous 2025年3月6日 pm3:48
Next 2025年3月11日 pm6:47

相关推荐

  • IWrapper、QueryWrapper和LambdaQueryWrapper使用

    条件更新updateByWrapper 通常我们在更新的时候new一个对象出来在去更新,减少更新的字段 Integer update = new DemoUser().updateByWrapper(new DemoUser().setFirstLogin(Boolean.FALSE), Pops.<DemoUser>lambdaUpdate().from(DemoUser.MODEL_MODEL).eq(IdModel::getId, userId) 使用基础模型的updateById方法更新指定字段的方法: new 一下update对象出来,更新这个对象。 WorkflowUserTask userTaskUp = new WorkflowUserTask(); userTaskUp.setId(userTask.getId()); userTaskUp.setNodeContext(json); userTaskUp.updateById(); 条件删除updateByWrapper public List<T> delete(List<T> data) { List<Long> petTypeIdList = new ArrayList(); for(T item:data){ petTypeIdList.add(item.getId()); } Models.data().deleteByWrapper(Pops.<PetType>lambdaQuery().from(PetType.MODEL_MODEL).in(PetType::getId,petTypeIdList)); return data; } 构造条件查询数据 示例1: LambdaQueryWrapper拼接查询条件 private void queryPetShops() { LambdaQueryWrapper<PetShop> query = Pops.<PetShop>lambdaQuery(); query.from(PetShop.MODEL_MODEL); query.setSortable(Boolean.FALSE); query.orderBy(true, true, PetShop::getId); List<PetShop> petShops2 = new PetShop().queryList(query); System.out.printf(petShops2.size() + ""); } 示例2: IWrapper拼接查询条件 private void queryPetShops() { IWrapper<PetShop> wrapper = Pops.<PetShop>lambdaQuery() .from(PetShop.MODEL_MODEL).eq(PetShop::getId,1L); List<PetShop> petShops4 = new PetShop().queryList(wrapper); System.out.printf(petShops4.size() + ""); } 示例3: QueryWrapper拼接查询条件 private void queryPetShops() { //使用Lambda获取字段名,防止后面改字段名漏改 String nameField = LambdaUtil.fetchFieldName(PetTalent::getName); //使用Lambda获取Clumon名,防止后面改字段名漏改 String nameColumn = PStringUtils.fieldName2Column(nameField); QueryWrapper<PetShop> wrapper2 = new QueryWrapper<PetShop>().from(PetShop.MODEL_MODEL) .eq(nameColumn, "test"); List<PetShop> petShops5 = new PetShop().queryList(wrapper2); System.out.printf(petShops5.size() + ""); } IWrapper转为LambdaQueryWrapper @Function.Advanced(type= FunctionTypeEnum.QUERY) @Function.fun(FunctionConstants.queryPage) @Function(openLevel = {FunctionOpenEnum.API}) public Pagination<PetShopProxy> queryPage(Pagination<PetShopProxy> page, IWrapper<PetShopProxy> queryWrapper) { LambdaQueryWrapper<PetShopProxy> wrapper = ((QueryWrapper<PetShopProxy>) queryWrapper).lambda(); // 非存储字段从QueryData中获取 Map<String, Object> queryData = queryWrapper.getQueryData(); if (null != queryData && !queryData.isEmpty()) { String codes = (String) queryData.get("codes"); if (org.apache.commons.lang3.StringUtils.isNotBlank(codes)) { wrapper.in(PetShopProxy::getCode, codes.split(",")); } } return new PetShopProxy().queryPage(page, wrapper); }

    2024年5月25日
    3.3K00
  • 如何选择适合的模型类型?

    介绍 通过Oinone 7天从入门到精通的模型的类型章节我们可以知道模型有抽象模型、存储模型、代理模型、传输模型这四种。但是在在定义模型的时候我们可能不知道该如何选择类型,下面结合业务场景为大家讲解几种模型的典型使用场景。 抽象模型 抽象模型往往是提供公共能力和字段的模型,它本身不会直接用于构建协议和基础设施(如表结构等)。 场景:猫、鸟都继承自动物这个抽象模型 package pro.shushi.pamirs.demo.api.model; import pro.shushi.pamirs.meta.annotation.Field; import pro.shushi.pamirs.meta.annotation.Model; import pro.shushi.pamirs.meta.annotation.sys.Base; import pro.shushi.pamirs.meta.base.IdModel; import pro.shushi.pamirs.meta.enmu.ModelTypeEnum; @Base @Model.model(AbstractAnimal.MODEL_MODEL) @Model.Advanced(type = ModelTypeEnum.ABSTRACT) @Model(displayName = "动物") public abstract class AbstractAnimal extends IdModel { public static final String MODEL_MODEL = "demo.AbstractAnimal"; @Field.String @Field(displayName = "名称") private String name; @Field.String @Field(displayName = "颜色") private String color; } package pro.shushi.pamirs.demo.api.model; import pro.shushi.pamirs.meta.annotation.Field; import pro.shushi.pamirs.meta.annotation.Model; @Model.model(Cat.MODEL_MODEL) @Model(displayName = "猫") public class Cat extends AbstractAnimal { private static final long serialVersionUID = -5104390780952634397L; public static final String MODEL_MODEL = "demo.Cat"; @Field.Integer @Field(displayName = "尾巴长度") private Integer tailLength; } package pro.shushi.pamirs.demo.api.model; import pro.shushi.pamirs.meta.annotation.Field; import pro.shushi.pamirs.meta.annotation.Model; @Model.model(Bird.MODEL_MODEL) @Model(displayName = "鸟") public class Bird extends AbstractAnimal { private static final long serialVersionUID = -5144390780952634397L; public static final String MODEL_MODEL = "demo.Bird"; @Field.Integer @Field(displayName = "翼展宽度") private Integer wingSpanWidth; } 存储模型 存储模型用于定义数据表结构和数据的增删改查(数据管理器)功能,是直接与连接器进行交互的数据容器。 场景:存储模型对应传统开发模式中的数据表,上面例子中的Cat和Birdd都属于传输模型,由于模型定义的注解@Model.Advanced(type = ModelTypeEnum.STORE)默认值就是存储模型,所以一般不用手动指定 代理模型 代理模型是用于代理存储模型的数据管理器能力,同时又可以扩展出非存储数据信息的交互功能的模型。 场景一:隔离数据权限 场景二:增强列表的搜索项 场景三:导入导出的时候增加其他特殊信息 场景四:重写下拉组件的查询逻辑做数据过滤 传输模型 传输模型不会在数据库生成的表,只是作为数据的传输使用,跟传统开发模式中的DTO有一点相似。 场景一:批量处理数据 场景二:处理一些跟数据表无关的操作,如:清理指定业务的缓存、查看一些系统监控信息,可以根据业务信息建立对应的传输模型,在传输模型上创建action动作 场景三:通过传输模型完成复杂页面数据传输

    2024年4月7日
    2.0K00
  • 平台配置日志输出和推送到APM与LogStash

    场景描述 目前设计器镜像启动后日志文件为out.log,是启动脚本中定向输出了(>>)out.log文件。实际项目可能: 日志输出到特定目录的特定文件名中 指定以日志保留策略(单个文件大小和文件保留个数) 日志输出到APM工具中(如skywalking) 日志推送到LogStash 日志自定义输出 不定向输出,采用自己配置的方式,与标准的SpringBoot工程配置日志一样。两种方式(都是Spring提供的方式): 方式一 bootstrap.yml 里面可以按profiles指定logback的配置文件,具体文件名和文件输入在logback里面进行配置,跟通用的logback配置一致. 例如: logging: config: classpath:logback-pre.xml 方式二 resources的根目录,直接配置 logback-spring.xml, 启动会自动加载。 日志自定义场景 配置日志推送到LogStash <!–配置日志推送到LogStash–> <contextListener class="pro.shushi.pamirs.demo.core.config.DemoLogbackFiledConfig"/> <appender name="LogStash" class="net.logstash.logback.appender.LogstashTcpSocketAppender"> <destination>127.0.0.1:4560</destination> <!– encoder必须配置,有多种可选 –> <encoder charset="UTF-8" class="net.logstash.logback.encoder.LogstashEncoder"> <!– SkyWalking插件, log加tid–> <provider class="org.apache.skywalking.apm.toolkit.log.logback.v1.x.logstash.TraceIdJsonProvider" /> <!–在生成的json中会加这些字段–> <customFields> {"app.name":"pamirs-demo", "app.type":"Microservice", "platform":"pamirs", "env":"dev"} </customFields> <timeZone>Asia/Shanghai</timeZone> <writeVersionAsInteger>true</writeVersionAsInteger> <providers> <pattern> <pattern> <!–动态的变量–> { "ip": "%{ip}", "server.name": "%{server.name}", "logger_name": "%logger" } </pattern> </pattern> </providers> </encoder> </appender> skywalking的日志rpc上传 <!– skywalking的日志rpc上传 –> <appender name="SkyWalkingLogs" class="org.apache.skywalking.apm.toolkit.log.logback.v1.x.log.GRPCLogClientAppender"> <encoder class="ch.qos.logback.core.encoder.LayoutWrappingEncoder"> <layout class="org.apache.skywalking.apm.toolkit.log.logback.v1.x.mdc.TraceIdMDCPatternLogbackLayout"> <Pattern>${CONSOLE_LOG_PATTERN}</Pattern> </layout> </encoder> </appender> 完整的代码示例 Logback自定义字段 package pro.shushi.pamirs.demo.core.config; import ch.qos.logback.classic.Level; import ch.qos.logback.classic.Logger; import ch.qos.logback.classic.LoggerContext; import ch.qos.logback.classic.spi.LoggerContextListener; import ch.qos.logback.core.Context; import ch.qos.logback.core.spi.ContextAwareBase; import ch.qos.logback.core.spi.LifeCycle; import java.net.InetAddress; import java.net.UnknownHostException; /** * Logback自定义字段 * * @author wx@shushi.pro * @date 2024/4/17 */ public class DemoLogbackFiledConfig extends ContextAwareBase implements LoggerContextListener, LifeCycle { private boolean started = false; @Override public boolean isResetResistant() { return false; } @Override public void onStart(LoggerContext loggerContext) { } @Override public void onReset(LoggerContext loggerContext) { } @Override public void onStop(LoggerContext loggerContext) { } @Override public void onLevelChange(Logger logger, Level level) { } @Override public void start() { if (started) { return; } Context context = getContext();…

    2024年5月18日
    2.0K00
  • 灵活敏捷开发,高效交付项目的6个关键

    项目工程管理 项目工程顶层分层 项目分层设计,划分出 CDM层、 标准业务层 、定制业务层; 沉淀领域业务模型至CDM层; 沉底业内通用功能至标准业务层; 客户定制化功能在定制业务层; 项目内部的层级划分 项目包结构管理及规范 pamirs-demo-api constant【常量的包路径】 enums【枚举类的包路径】 model【该领域核⼼模型的包路径】 pmodel【该领域代理模型的包路径】 tmodel【该领域传输模型的包路径】 service【存放该领域的⾮存储模型如:⽤于传输的临时模型】 utils【工具类】 XXModule【该类是Demo模块的定义】 pamirs-demo-core service【接口实现类】 init【模块初始化⼯作的包路径】 manager 【manager是 service的⼀些公共逻辑,不会定义为独⽴的function的类】 pamirs-demo-view(可选) action【模型对外交互的⾏为的包路径】 项目中模块间依赖 禁止出现api模块依赖core模块的情况,api模块只允许依赖api模块; 根据当前项目结构进行模块划分,避免循环依赖; 规划项目模块 项目阶段,代码开发前,业务架构师需充分的理解需求和蓝图,对系统进行业务域, 功能域的划分;例如:对一个电商系统: 提高系统的可维护性:通过将系统拆分为不同的业务域,每个业务域都有清晰的边界和职责,可以独立开发、测试和维护; 提升开发效率:业务域划分可以使开发团队更加专注于自己负责的业务,减少不必要的沟通和协调,提升开发效率; 促进团队合作:通过业务域划分,每个团队可以负责一个或多个业务域,团队成员之间可以有更高效的合作和协同。 支持系统的扩展和演化:业务域划分可以使系统更加灵活和可扩展。当需要新增一个新的业务功能或调整现有的业务逻辑时,只需要修改对应的业务域,而不需要对整个系统进行改动。 项目文档管理 项目文档管理对于项目的实施,项目进度管理,项目后期维护等都是至关重要的。系统详细的产品文档,测试文档,运维文档,开发文档,项目管理文档等。 协同合作:团队成员可以共享和访问项目文档,促进协同合作和信息共享,避免信息孤岛和重复工作。 知识管理:项目中所获得的知识,对项目的成功和后续的知识积累至关重要。通过良好的文档管理,可以确保项目知识的保存和传承,提高组织的知识管理能力。 问题解决:项目文档中记录了项目的需求、决策、问题和解决方案等信息。当出现问题或需要做决策时,可以通过查阅文档来获取相关信息,加快问题解决的速度,并减少错误和重复。 项目追踪:通过文档管理,可以跟踪项目的进展和状态。可以记录项目的里程碑、任务分配、进度更新等信息,帮助团队了解项目的整体情况,及时发现和解决问题。 知识共享:好的文档管理可以促进知识共享和传播。通过将项目文档进行分类、索引和存档,可以使团队成员更容易找到所需的信息,并从中学习和借鉴经验,提高工作效率和质量。 数据库和事务 多表联合查询 减少需要join的操作出现 用多次查询替代 索引相关 核心业务访问DB的Sql 要命中或者覆盖索引,保存核心业务的响应时间; 控制单表的索引数量,注意联合索引 数据一致性:乐观锁控制,unique�等 事务代码示例 事务相关注意点参考【Oinone如何支持构建分布式项目】:https://doc.oinone.top/kai-fa-shi-jian/5572.html

    2024年2月20日
    1.5K00
  • Nacos做为注册中心:如何调用其他系统的SpringCloud服务?

    Oinone项目引入Nacos作为注册中心,调用外部的SpringCloud服务 Nacos可以做为注册中心,提供给Dubbo和SpringCloud等微服务框架使用。 目前Oinone的底层使用的是Dubbo进行微服务的默认协议调用,但是我们项目如果存在需要调用其他系统提供的SpringCloud服务,Oinone其实并没有限制大家去这么写代码。 可以参考Nacos或SpringCloud的官方文档,只要不存在Jar包冲突等场景,很多的扩展其实大家都可以使用。 注意!!!Nacos、SpringCloud、SpringCloudAlibaba是有依赖版本严格要求的:点击查看 具体示例: 一、项目中增加依赖 主pom引入兼容的版本: <dependencyManagement> <dependency> <groupId>com.alibaba.cloud</groupId> <artifactId>spring-cloud-alibaba-dependencies</artifactId> <version>2.2.7.RELEASE</version> <!– 目前兼容的版本 –> <type>pom</type> <scope>import</scope> </dependency> </dependencyManagement> 使用模块的pom引入依赖: <dependency> <groupId>com.alibaba.cloud</groupId> <artifactId>spring-cloud-starter-alibaba-nacos-discovery</artifactId> </dependency> <dependency> <groupId>org.springframework.cloud</groupId> <artifactId>spring-cloud-starter-openfeign</artifactId> </dependency> 二、 配置 application.yml spring: cloud: nacos: discovery: server-addr: localhost:8848 username: nacos password: nacos 三、启动类添加注解 @EnableDiscoveryClient @EnableFeignClients public class NacosConsumerApplication { public static void main(String[] args) { SpringApplication.run(NacosConsumerApplication.class, args); } } 四、验证 创建 Feign Client 接口 import org.springframework.cloud.openfeign.FeignClient; import org.springframework.web.bind.annotation.GetMapping; @FeignClient(name = "nacos-demo") // 指定目标服务的名称 public interface ProviderClient { @GetMapping("/hello") String hello(); } 创建 Controller 调用 Feign Client @RestController public class ConsumerController { private final ProviderClient providerClient; public ConsumerController(ProviderClient providerClient) { this.providerClient = providerClient; } @GetMapping("/hello") public String hello() { return providerClient.hello(); } } 在浏览器中访问 http://localhost:8082/hello你应该会看到服务提供者返回的响应。

    2024年6月4日
    3.6K00

Leave a Reply

Please Login to Comment