
Oinone如何支持构建分布式项目

分布式调用下的[强制]约束

1、[强制]分布式调用情况下base库和redis需共用;
2、[强制]如果环境有设计器,设计器的base库和redis保持一致也需与项目中的保持一致;
3、[强制]相同base库下,不同应用的相同模块的数据源需保持一致;
4、[强制]项目中需引入分布式缓存包。参考下文的分布式包依赖

分布式支持

1、分布式包依赖

1) 父pom的依赖管理中先加入pamirs-distribution的依赖

<dependency>
    <groupId>pro.shushi.pamirs</groupId>
    <artifactId>pamirs-distribution</artifactId>
    <version>${pamirs.distribution.version}</version>
    <type>pom</type>
    <scope>import</scope>
</dependency>

2) 启动的boot工程中增加pamirs-distribution相关包

<!-- 分布式服务发布 -->
<dependency>
    <groupId>pro.shushi.pamirs.distribution</groupId>
    <artifactId>pamirs-distribution-faas</artifactId>
</dependency>
<!-- 分布式元数据缓存 -->
<dependency>
    <groupId>pro.shushi.pamirs.distribution</groupId>
    <artifactId>pamirs-distribution-session</artifactId>
</dependency>
<dependency>
    <groupId>pro.shushi.pamirs.distribution</groupId>
    <artifactId>pamirs-distribution-gateway</artifactId>
</dependency>

3)启动工程的Application中增加类注解@EnableDubbo

@EnableDubbo
public class XXXStdApplication {

    public static void main(String[] args) throws IOException {
        StopWatch stopWatch = new StopWatch();
        stopWatch.start();
        // ………………………………
        log.info("XXXX Application loading...");
    }
}

2、修改bootstrap.yml文件

注意序列化方式:serialization: pamirs

以下只是一个示例(zk为注册中心),注册中心支持zk和Nacos;
Nacos作为注册中心参考:https://doc.oinone.top/kai-fa-shi-jian/5835.html

spring:
  profiles:
    active: dev
  application:
    name: pamirs-demo
  cloud:
    service-registry:
      auto-registration:
        enabled: false
pamirs:
  default:
    environment-check: true
    tenant-check: true

---
spring:
  profiles: dev
  cloud:
    service-registry:
      auto-registration:
        enabled: false
    config:
      enabled: false
      uri: http://127.0.0.1:7001
      label: master
      profile: dev
    nacos:
      server-addr: http://127.0.0.1:8848
      discovery:
        enabled: false
        namespace:
        prefix: application
        file-extension: yml
      config:
        enabled: false
        namespace:
        prefix: application
        file-extension: yml
dubbo:
  application:
    name: pamirs-demo
    version: 1.0.0
  registry:
    address: zookeeper://127.0.0.1:2181
  protocol:
    name: dubbo
    port: -1
    serialization: pamirs
  scan:
    base-packages: pro.shushi
  cloud:
    subscribed-services:
  metadata-report:
    disabled: true

3、模块启动的最⼩集

pamirs:
boot:
 init: true
 sync: true
 modules:
 - base
 - sequence
 - 业务工程的Module

4、业务模型间的依赖关系

  1. 服务调用方(即Client端),在启动yml中modules不安装服务提供方的Module
  2. 服务调用方(即Client端),项目的pom中只依赖服务提供方的API(即模型和API的定义)
  3. 服务调用方(即Client端),项目模块定义(即模型Module定义),dependencies中增加服务提供方的Modeule. 如下面示例代码中的FileModule
    @Module(
        name = DemoModule.MODULE_NAME,
        displayName = "oinoneDemo工程",
        version = "1.0.0",
        dependencies = {ModuleConstants.MODULE_BASE, CommonModule.MODULE_MODULE, 
                FileModule.MODULE_MODULE, SecondModule.MODULE_MODULE/**服务提供方的模块定义*/
        }
    )
  4. 服务调用方(即Client端),启动类的ComponentScan需要配置服务提供方API定义所在的包. 如下面示例中的:pro.shushi.pamirs.second
    @ComponentScan(
        basePackages = {"pro.shushi.pamirs.meta",
                "pro.shushi.pamirs.framework",
                "pro.shushi.pamirs",
                "pro.shushi.pamirs.demo",
                "pro.shushi.pamirs.second" /**服务提供方API定义所在的包*/
        },
        excludeFilters = {
                @ComponentScan.Filter(
                        type = FilterType.ASSIGNABLE_TYPE,
                        value = {RedisAutoConfiguration.class, RedisRepositoriesAutoConfiguration.class,
                                RedisClusterConfig.class}
                )
        })
    @Slf4j
    @EnableTransactionManagement
    @EnableAsync
    @EnableDubbo
    @MapperScan(value = "pro.shushi.pamirs", annotationClass = Mapper.class)
    @SpringBootApplication(exclude = {DataSourceAutoConfiguration.class, FreeMarkerAutoConfiguration.class})
    public class DemoApplication {

5、模块启动顺序

服务提供方的模块需先启动。原因:模块在启动过程中,会校验依赖模块是否存在。

6、Dubbo日志相关

关闭Dubbo元数据上报

dubbo:  
    metadata-report:
            disabled: true

关闭元数据上报,还有错误日志打印出来的话,可以在log中配置

logging:
      level:
        root: info
        pro.shushi.pamirs.framework.connectors.data.mapper.PamirsMapper: info
        pro.shushi.pamirs.framework.connectors.data.mapper.GenericMapper: info # mybatis sql日志
        RocketmqClient: error
        # Dubbo相关的日志
        org.apache.dubbo.registry.zookeeper.ZookeeperRegistry: error
        org.apache.dubbo.registry.integration.RegistryDirectory: error
        org.apache.dubbo.registry.client.metadata.store.RemoteMetadataServiceImpl: off
        org.apache.dubbo.metadata.store.zookeeper.ZookeeperMetadataReport: off
        org.apache.dubbo.metadata.store.nacos.NacosMetadataReport: off

更详细的教程参考:https://shushi.yuque.com/yoxz76/oio3/deaa1p

分布式支持-事务相关

1、分布式事务解决方案

完成某一个业务功能可能需要横跨多个服务,操作多个数据库。这就涉及到到了分布式事务,分布式事务就是为了保证不同资源服务器的数据一致性。典型的分布式事务场景:
1、跨库事务, 补充具体场景
2、微服务拆分带来的跨内部服务;
3、微服务拆分带来的跨外部服务;

2、事务策略

采用微服务架构,需考虑分布式事务问题(即平台各子系统之间的数据一致性)。
1)对于单个系统/模型内部, 比如:库存中心、账户中心等,采用强事务的方式。比如:在扣减库存的时候,库存日志和库存数列的变化在一个事务中,保证两个表的数据同时成功或者失败。
强事务管理采用编码式,Oinone事务管理兼容Spring的事务管理方式;
2)为了提高系统的可用性、可扩展性和性能,对于某些关键业务和数据一致性要求特别高的场景,采用强一致性外,其他的场景建议采用最终一致性的方案;
对于分布式事务采用最终数据一致性,借助可靠消息和 Job 等方式来实现。

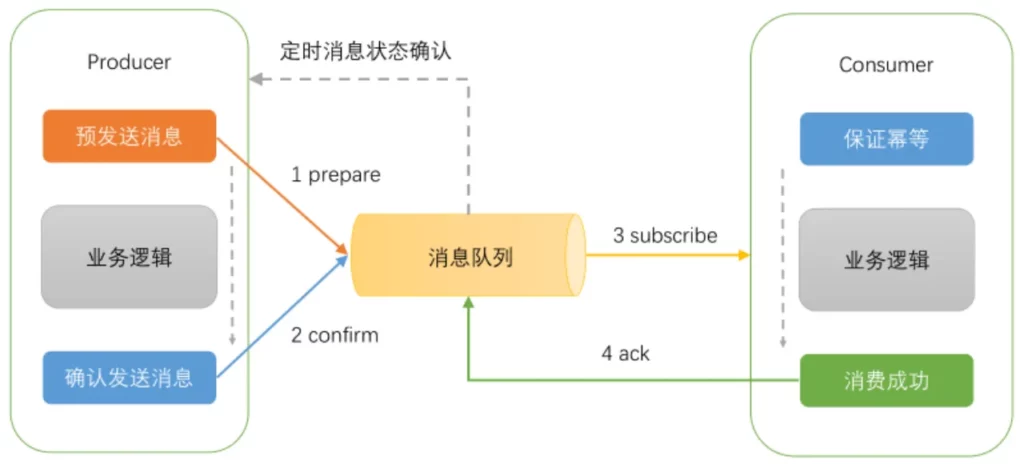
2.1 基于MQ的事务消息
Oinone如何支持构建分布式项目

采用最终一致性方案,基于MQ的事务消息的方式。
事务消息的逻辑由发送端 Producer进行保证(消费端无需考虑)。基于MQ事务消息的实现步骤:
1)首先,发送一个事务消息,MQ将消息状态标记为Prepared,注意此时这条消息消费者是无法消费到的。
2)接着,执行业务代码逻辑,可能是一个本地数据库事务操作
3)确认发送消息,这个时候,MQ将消息状态标记为可消费,这个时候消费者,才能真正的保证消费到这条数据。

2.2 基于JOB的补偿

定期校对:业务活动的被动方,根据定时策略,向业务活动主动方查询(主动方提供查询接口),恢复丢失的业务消息。

2.3 数据一致性

  • 对RPC超时和重试机制设计的检查,是否会带来重复数据
  • 对数据幂等、去重机制的设计是否有考虑到
  • 对事务、数据(最终)一致性设计是否有考虑到
  • 数据缓存时,当数据发生变化时,是否有相应的机制保证缓存数据的一致性和有效性

Oinone构建分布式项目一些注意点

参考文档:https://doc.oinone.top/kai-fa-shi-jian/6475.html

Oinone社区 作者:shao原创文章,如若转载,请注明出处:https://doc.oinone.top/kai-fa-shi-jian/5572.html

访问Oinone官网:https://www.oinone.top获取数式Oinone低代码应用平台体验

Like (0)
shao's avatarshao数式管理员
Previous 2024年2月20日 pm6:37
Next 2024年2月20日 pm6:46

相关推荐

  • OSS(CDN)配置和文件系统的一些操作

    目前Oinone支持的OSS类型 类型 服务 OSS 阿里云OSS UPYUN 又拍云 MINIO MinIO HUAWEI_OBS 华为云OBS LOCAL 本地NGINX文件存储 TENCENT_COS 腾讯云COS CTYUN_ZOS 天翼云ZOS OSS通用yaml配置 cdn: oss: name: # 名称 type: # 类型 bucket: uploadUrl: # 上传URL downloadUrl: # 下载URL accessKeyId: accessKeySecret: mainDir: # 主目录 validTime: 3600000 timeout: 600000 active: true referer: localFolderUrl: others: [key]: name: # 名称 type: # 类型 bucket: uploadUrl: # 上传URL downloadUrl: # 下载URL accessKeyId: accessKeySecret: mainDir: # 主目录 validTime: 3600000 timeout: 600000 active: true referer: localFolderUrl: PS:others中使用自定义key来指定OSS服务进行文件上传/下载功能。上传/下载必须匹配,否则无法正常使用。 OSS配置示例 阿里云OSS cdn: oss: name: 阿里云 type: OSS bucket: pamirs(根据实际情况修改) uploadUrl: oss-cn-hangzhou.aliyuncs.com downloadUrl: oss-cn-hangzhou.aliyuncs.com accessKeyId: 你的accessKeyId accessKeySecret: 你的accessKeySecret # 根据实际情况修改 mainDir: upload/ validTime: 3600000 timeout: 600000 active: true imageResizeParameter: referer: 华为云OBS cdn: oss: name: 华为云 type: HUAWEI_OBS bucket: pamirs(根据实际情况修改) uploadUrl: obs.cn-east-2.myhuaweicloud.com downloadUrl: obs.cn-east-2.myhuaweicloud.com accessKeyId: 你的accessKeyId accessKeySecret: 你的accessKeySecret # 根据实际情况修改 mainDir: upload/ validTime: 3600000 timeout: 600000 active: true allowedOrigin: http://192.168.95.31:8888,https://xxxx.xxxxx.com referer: 华为云OBS需要在启动工程增加以下依赖 <okhttp3.version>4.9.3</okhttp3.version> <dependency> <groupId>com.squareup.okhttp3</groupId> <artifactId>okhttp</artifactId> <version>${okhttp3.version}</version> </dependency> 注意事项华为云OBS的防盗链配置,仅允许携带特定referer的才可以,而excel导入后端处理的逻辑匿名读的时候是不带referer的,所以会被拒绝 MINIO 文件系统,mino的配置: cdn: oss: name: minio type: MINIO bucket: pamirs(根据实际情况修改) uploadUrl: http://192.168.243.6:32190(根据实际情况修改) downloadUrl: http://192.168.243.6:9000(根据实际情况修改) accessKeyId: 你的accessKeyId accessKeySecret: 你的accessKeySecret # 根据实际情况修改 mainDir: upload/ validTime: 3600000 timeout: 600000 active: true referer: localFolderUrl: MINIO无公网访问地址下OSS的配置方式: https://doc.oinone.top/yun-wei-shi-jian/7112.html 又拍云 cdn: oss: name: 又拍云…

    后端 2023年11月1日
    2.4K00
  • 函数之异步执行

    总体介绍 异步任务是非常常见的一种开发模式,它在分布式的开发模式中有很多应用场景如: 高并发场景中,我们一般采用把长流程切短,用异步方式去掉可以异步的非关键功能,缩小主流程响应时间,提升用户体验 异构系统的集成调用,通过异步任务完成解耦与自动重试 分布式系统最终一致性的可选方案 本文将介绍oinone是如何结合Spring+TbSchedule来完成异步任务 构建第一个异步任务 新建PetShopService和PetShopServiceImpl 1、 新建PetShopService定义updatePetShops方法 package pro.shushi.pamirs.demo.api.service; import pro.shushi.pamirs.demo.api.model.PetShop; import pro.shushi.pamirs.meta.annotation.Fun; import pro.shushi.pamirs.meta.annotation.Function; import java.util.List; @Fun(PetShopService.FUN_NAMESPACE) public interface PetShopService { String FUN_NAMESPACE = "demo.PetShop.PetShopService"; @Function void updatePetShops(List<PetShop> petShops); } 2、PetShopServiceImpl实现PetShopService接口并在updatePetShops增加@XAsync注解 package pro.shushi.pamirs.demo.core.service; import org.springframework.stereotype.Component; import pro.shushi.pamirs.demo.api.model.PetShop; import pro.shushi.pamirs.demo.api.service.PetShopService; import pro.shushi.pamirs.meta.annotation.Fun; import pro.shushi.pamirs.meta.annotation.Function; import pro.shushi.pamirs.trigger.annotation.XAsync; import java.util.List; @Fun(PetShopService.FUN_NAMESPACE) @Component public class PetShopServiceImpl implements PetShopService { @Override @Function @XAsync(displayName = "异步批量更新宠物商店",limitRetryNumber = 3,nextRetryTimeValue = 60) public void updatePetShops(List<PetShop> petShops) { new PetShop().updateBatch(petShops); } } a. displayName = "异步批量更新宠物商店",定义异步任务展示名称b. limitRetryNumber = 3,定义任务失败重试次数,,默认:-1不断重试c. nextRetryTimeValue = 60,定义任务失败重试的时间数,默认:3d. nextRetryTimeUnit,定义任务失败重试的时间单位,默认:TimeUnitEnum.SECONDe. delayTime,定义任务延迟执行的时间数,默认:0f. delayTimeUnit,定义任务延迟执行的时间单位,默认:TimeUnitEnum.SECOND 修改PetShopBatchUpdateAction调用异步任务 引入PetShopService 修改conform方法,调用petShopService.updatePetShops方法 package pro.shushi.pamirs.demo.core.action; @Model.model(PetShopBatchUpdate.MODEL_MODEL) @Component public class PetShopBatchUpdateAction { @Autowired private PetShopService petShopService; @Action(displayName = "确定",bindingType = ViewTypeEnum.FORM,contextType = ActionContextTypeEnum.SINGLE) public PetShopBatchUpdate conform(PetShopBatchUpdate data){ List<PetShop> shops = ArgUtils.convert(PetShopProxy.MODEL_MODEL, PetShop.MODEL_MODEL,proxyList); // 调用异步任务 petShopService.updatePetShops(shops); }); return data; } } 不同应用如何隔离执行单元 在schedule跟模块部署一起的时候,多模块独立boot的情况下,需要做必要的配置。如果schedule独立部署则没有必要,因为全部走远程,不存在类找不到的问题 通过配置pamirs.zookeeper.rootPath,确保两组机器都能覆盖所有任务分片,这样不会漏数据 通过pamirs.event.schedule.ownSign来隔离。确保两组机器只取各自产生的数据,这样不会重复执行数据 pamirs: zookeeper: zkConnectString: 127.0.0.1:2181 zkSessionTimeout: 60000 rootPath: /demo event: enabled: true schedule: enabled: true ownSign: demo rocket-mq: namesrv-addr: 127.0.0.1:9876

    2024年5月25日
    2.3K00
  • DsHint(指定数据源)和BatchSizeHint(指定批次数量)

    概述和使用场景 DsHintApi ,强制指定数据源, BatchSizeHintApi ,强制指定查询批量数量 API定义 DsHintApi public static DsHintApi model(String model/**模型编码*/) { // 具体实现 } public DsHintApi(Object dsKey/***数据源名称*/) { // 具体实现 } BatchSizeHintApi public static BatchSizeHintApi use(Integer batchSize) { // 具体实现 } 使用示例 1、【注意】代码中使用 try-with-resources语法; 否则可能会出现数据源错乱 2、DsHintApi使用示例包裹在try里面的所有查询都会强制使用指定的数据源 // 使用方式1: try (DsHintApi dsHintApi = DsHintApi.model(PetItem.MODEL_MODEL)) { List<PetItem> items = demoItemDAO.customSqlDemoItem(); PetShopProxy data2 = data.queryById(); data2.fieldQuery(PetShopProxy::getPetTalents); } // 使用方式2: try (DsHintApi dsHintApi = DsHintApi.use("数据源名称")) { List<PetItem> items = demoItemDAO.customSqlDemoItem(); PetShopProxy data2 = data.queryById(); data2.fieldQuery(PetShopProxy::getPetTalents); } 3、BatchSizeHintApi使用示例包裹在try里面的所有查询都会按照指定的batchSize进行查询 // 查询指定每次查询500跳 try (BatchSizeHintApi batchSizeHintApi = BatchSizeHintApi.use(500)) { PetShopProxy data2 = data.queryById(); data2.fieldQuery(PetShopProxy::getPetTalents); } // 查询指定不分页(batchSize=-1)查询。 请注意,你必须在明确不需要分页查询的情况下使用;如果数据量超大不分页可能会卡死。默认不指定分页数的情况下下平台会进行分页查询 try (BatchSizeHintApi batchSizeHintApi = BatchSizeHintApi.use(-1)) { PetShopProxy data2 = data.queryById(); data2.fieldQuery(PetShopProxy::getPetTalents); }

    2024年5月18日
    2.3K00
  • 模型字段之序列化方式

    本文核心是带大家全面了解oinone的序列方式,包括支持的序列化类型、注意点、如果新增客户化序列化方式以及字段默认值的反序列化。 字段序列化方式说明 序列化方式 说明 备注 JSON JSON序列化 主要用于模型相关类型字段的序列化,是@Field.serialize默认选项 DOT 点拼接集合元素 COMMA 逗号拼接集合元素 BIT 按位与,2次幂数求和 非@Field.serialize可选项列表,用于二进制枚举序列化不需要配置,由oinone自动推断 字段序列化方式举例 1、给模型PetItemDetail 增加两个字段:petItemDetails类型为List 和 tags类型为List,并设置为不同的序列化方式,petItemDetails为JSON(缺省就是JSON,可不配),tags为COMMA。2、同时设置 @Field.Advanced(columnDefinition = "varchar(1024)"),防止序列化后存储过长。 @Model.model(PetItem.MODEL_MODEL) @Model(displayName = "宠物商品",summary="宠物商品",labelFields = {"itemName"}) public class PetItem extends AbstractDemoCodeModel{ public static final String MODEL_MODEL="demo.PetItem"; @Field(displayName = "品种") @Field.many2one @Field.Relation(relationFields = {"typeId"},referenceFields = {"id"}) private PetType type; @Field(displayName = "品种类型",invisible = true) private Long typeId; @Field(displayName = "详情", serialize = Field.serialize.JSON, store = NullableBoolEnum.TRUE) @Field.Advanced(columnDefinition = "varchar(1024)") private List<PetItemDetail> petItemDetails; @Field(displayName = "商品标签",serialize = Field.serialize.COMMA,store = NullableBoolEnum.TRUE,multi = true) @Field.Advanced(columnDefinition = "varchar(1024)") private List<String> tags; } 字段序列化注意点 必须使用Field#store属性将字段存储设置为NullableBoolEnum.TRUE。 使用Field#serialize属性指定序列化方式,默认为JSON。 如把PetItemDetail设置为存储模型,须在PetItem的petItemDetails字段上使用Field.Relation#store属性将关联关系存储设置为false。不然会同时存储petItemDetails字段和对应的PetItemDetail表记录 注册自己的序列化器 注册自己的序列化器(实现pro.shushi.pamirs.meta.api.core.orm.serialize.Serializer接口), 如oinone的DOT的序列化方式,用type()方法返回值做匹配,serialize和deserialize分别对应序列化和反序列化方法。 package pro.shushi.pamirs.framework.compute.serialize; import org.apache.commons.lang3.StringUtils; import org.springframework.stereotype.Component; import pro.shushi.pamirs.meta.annotation.fun.extern.Slf4j; import pro.shushi.pamirs.meta.api.core.orm.serialize.Serializer; import pro.shushi.pamirs.meta.common.constants.CharacterConstants; import pro.shushi.pamirs.meta.enmu.SerializeEnum; import pro.shushi.pamirs.meta.util.TypeUtils; import java.util.ArrayList; import java.util.Collections; import java.util.List; /** * 点表达式序列生成处理器实现 * @author shushi@shushi.pro * @version 1.0.0 */ @SuppressWarnings("rawtypes") @Slf4j @Component public class DotSerializeProcessor implements Serializer<Object, String> { @Override public String serialize(String ltype, Object value) { if (null == value) { return null; } if (List.class.isAssignableFrom(value.getClass())) { return StringUtils.join((List) value, CharacterConstants.SEPARATOR_DOT); } else { return StringUtils.join(Collections.singletonList(value), CharacterConstants.SEPARATOR_DOT); } } @SuppressWarnings("unchecked") @Override public Object deserialize(String ltype, String ltypeT, String value,…

    2024年5月24日
    2.4K00
  • 灵活敏捷开发,高效交付项目的6个关键

    项目工程管理 项目工程顶层分层 项目分层设计,划分出 CDM层、 标准业务层 、定制业务层; 沉淀领域业务模型至CDM层; 沉底业内通用功能至标准业务层; 客户定制化功能在定制业务层; 项目内部的层级划分 项目包结构管理及规范 pamirs-demo-api constant【常量的包路径】 enums【枚举类的包路径】 model【该领域核⼼模型的包路径】 pmodel【该领域代理模型的包路径】 tmodel【该领域传输模型的包路径】 service【存放该领域的⾮存储模型如:⽤于传输的临时模型】 utils【工具类】 XXModule【该类是Demo模块的定义】 pamirs-demo-core service【接口实现类】 init【模块初始化⼯作的包路径】 manager 【manager是 service的⼀些公共逻辑,不会定义为独⽴的function的类】 pamirs-demo-view(可选) action【模型对外交互的⾏为的包路径】 项目中模块间依赖 禁止出现api模块依赖core模块的情况,api模块只允许依赖api模块; 根据当前项目结构进行模块划分,避免循环依赖; 规划项目模块 项目阶段,代码开发前,业务架构师需充分的理解需求和蓝图,对系统进行业务域, 功能域的划分;例如:对一个电商系统: 提高系统的可维护性:通过将系统拆分为不同的业务域,每个业务域都有清晰的边界和职责,可以独立开发、测试和维护; 提升开发效率:业务域划分可以使开发团队更加专注于自己负责的业务,减少不必要的沟通和协调,提升开发效率; 促进团队合作:通过业务域划分,每个团队可以负责一个或多个业务域,团队成员之间可以有更高效的合作和协同。 支持系统的扩展和演化:业务域划分可以使系统更加灵活和可扩展。当需要新增一个新的业务功能或调整现有的业务逻辑时,只需要修改对应的业务域,而不需要对整个系统进行改动。 项目文档管理 项目文档管理对于项目的实施,项目进度管理,项目后期维护等都是至关重要的。系统详细的产品文档,测试文档,运维文档,开发文档,项目管理文档等。 协同合作:团队成员可以共享和访问项目文档,促进协同合作和信息共享,避免信息孤岛和重复工作。 知识管理:项目中所获得的知识,对项目的成功和后续的知识积累至关重要。通过良好的文档管理,可以确保项目知识的保存和传承,提高组织的知识管理能力。 问题解决:项目文档中记录了项目的需求、决策、问题和解决方案等信息。当出现问题或需要做决策时,可以通过查阅文档来获取相关信息,加快问题解决的速度,并减少错误和重复。 项目追踪:通过文档管理,可以跟踪项目的进展和状态。可以记录项目的里程碑、任务分配、进度更新等信息,帮助团队了解项目的整体情况,及时发现和解决问题。 知识共享:好的文档管理可以促进知识共享和传播。通过将项目文档进行分类、索引和存档,可以使团队成员更容易找到所需的信息,并从中学习和借鉴经验,提高工作效率和质量。 数据库和事务 多表联合查询 减少需要join的操作出现 用多次查询替代 索引相关 核心业务访问DB的Sql 要命中或者覆盖索引,保存核心业务的响应时间; 控制单表的索引数量,注意联合索引 数据一致性:乐观锁控制,unique�等 事务代码示例 事务相关注意点参考【Oinone如何支持构建分布式项目】:https://doc.oinone.top/kai-fa-shi-jian/5572.html

    2024年2月20日
    1.5K00

Leave a Reply

Please Login to Comment